发现基础模型:迈向开放式发现智能 Discovery Foundation Models: Toward Open-Ended Discovery Intelligence
提出“发现基础模型”(DFM)框架,让AI从解决给定问题跃迁到自主发现、验证并改写新知识
前置知识
基础模型与模型系统
在海量数据上预训练、经后训练适配多种任务的大型神经网络(如 GPT 类大模型)及其工具调用、智能体执行等扩展。本文强调评估对象是“模型系统” $D=(\pi_\theta,S,M,T,E,V,H)$:策略、显式状态、记忆、工具、环境、验证器与人的整体,而非单个检查点。
DFM 的能力声明归属于整个声明的系统:若决定性的一步由人类完成,就不能归功于模型。理解系统边界是把握其能力定义、归因与治理讨论的前提。
研究结构的任务抽象 Q=(P,R,G,T,V)
论文将传统模型任务形式化为五元组:问题 $P$、表征 $R$、目标 $G$、工具 $T$、评估器 $V$ 全部由外部给定,系统只需在给定结构内求解。搜索、强化学习、智能体工作流无论多强,都不保证这些给定变量和评估器在科学上是充分的。
全文论证都建立在“固定结构内优化”与“改写结构本身”这一区分之上:DFM 的定义正是哪些原本固定的输入(问题、表征、评估器)变成模型可操作、可修正的对象。
可辨识性与判别性干预
当两个候选机制在所有可行动的观测量下给出相同预测时,称该观测是“不可辨识的”:此时增加样本量毫无用处,必须设计能让两者产生分歧的干预——扰动、反例、边界测试、替代测量或重复实验。论文用 $x^*=\arg\max_x \mathbb{E}[\Delta I(H\mid o_x)]$ 形式化干预选择。
干预设计 $C_{int}$ 与失败归因 $C_{rev}$ 是 DFM 七项能力的核心,而“何时该换表征/测量而非继续搜答案”正是本文与普通优化范式的分水岭。
干湿实验闭环
干实验指计算与推理活动(文献综合、代码实验、仿真、协议设计),其输出只是预测;湿实验指物理实验(机器人合成、表型测量、电生理)。闭环指湿实验返回的测量作为外部证据回流到研究状态,改变目标置信、检测选择与机制假设,而不是只充当最终答案的验证器。
Zetema 的接地设计与 GALILEO 实证案例都围绕此闭环展开:“外部证据改变后续科学决策”是论文区分真实发现与概念 agent 循环的关键判据。
研究世界模型与动作门控
预测动作后果的模块 $W_t:(S_t,a)\to p(o,\Delta S,c,r\mid S_t,a)$,在动作产生真实代价前做反事实筛选:哪些假设会被区分、成本与风险多大;配合资格判据 $V_j(a)\ge\tau_j$ 决定放行、拒绝或升级给人。
这是 Zetema 防止“流畅但冗余/不可区分/危险”的开放生成候选浪费实验预算的关键机制,也引出世界模型误差的“选择效应”这一独特风险。
过程监督、偏好优化与强化学习
过程监督对中间研究决策逐步打标签而非只看最终答案;偏好优化(DPO 风格)在同一状态下比较一好一坏两个动作训练策略;强化学习用科学奖励 $r_t^{\mathrm{sci}}$(知识进展+信息增益+修正质量−成本−风险)做 KL 正则策略梯度。
第 6 章的组合训练目标 $\mathcal{L}_{DFM}$ 由这三种信号(外加世界模型与技能检索损失)构成,不理解它们的直觉就看不懂“如何训练发现能力”这一贡献。
研究动机
现有基础模型已能在蛋白质与材料建模、天气预测、数学与程序推理、文献分析和自动化实验中大显身手,但它们几乎都从人类已选定的研究结构出发:问题已陈述、变量已给定、目标固定、工具经接口暴露、评估器就位。论文指出这种“结构内优化”有结构性天花板:固定表征无法表达它遗漏的变量;搜索目标无法恢复评估器系统性忽略的属性;当观测量不可辨识时,增加样本也无法区分两种机制;自动化工作流只会把被错误框定的问题执行得更高效,却不会变得更善于识别错误框定。这些不是假设——论文引用科学智能体评测的现状:长研究工作流可以被顺利执行,但证据整合、反驳驱动的修正与长时程可靠性依然脆弱。当研究卡壳时——两个机制在现有观测下等价、性能增益换个数据划分就消失、每个解释都需要同一区域的局部补丁——瓶颈在研究结构本身,而不是优化器不够强。
本文的目标是本文的目标是把“发现智能”从修辞变成一个可训练、可执行、可评估的能力类别。具体而言:定义发现基础模型(DFM)这一通用模型系统类别,它能识别有价值的未知、把未知表述成可研究的问题、构建并修正表征、生成机制上可区分的可检验解释、设计有信息量的干预、从外部证据中修正研究状态,并跨任务持续改进这些操作。配套地,论文要给出四层内容:发现过程的操作化规范(哪些研究对象可以被改写、修订如何组合);系统实例 Zetema(显式研究状态、验证与实验门控、干/湿接地、跨任务 Discovery Skill 演化);能力形成的训练目标(状态条件化的多信号组合优化 $\mathcal{L}_{DFM}$);以及以过程为中心的评估协议(同时度量当期外部验证的知识进展 $\Delta K_{val}$ 与未来发现能力的提升 $\Delta C_{future}$),最终让“发现”成为基础模型系统的可观测能力。
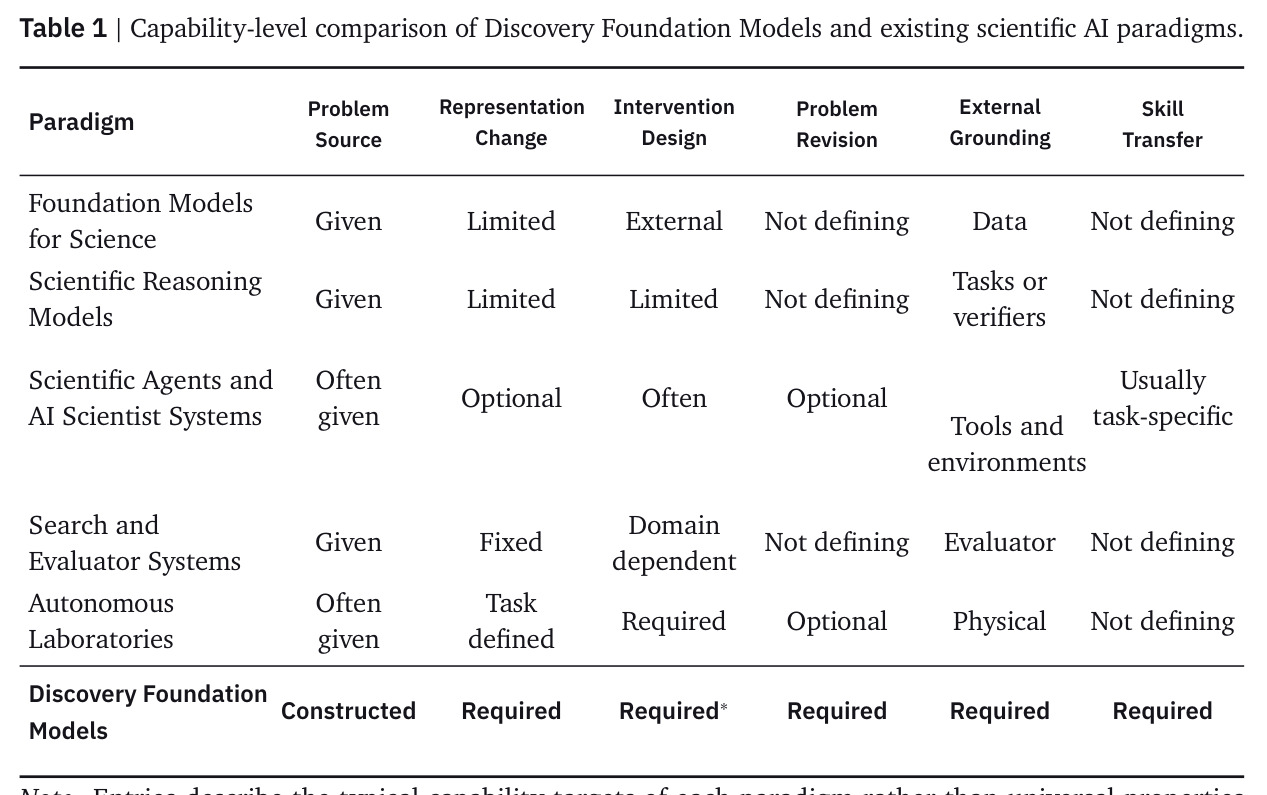
与已有工作不同的是,本文的独特切入是以“能力”而非“架构或自主程度”来定义类别,并以“哪些知识生产环节从固定输入变为模型可操作对象”为判据。对照 Table 1:科学基础模型提供领域表征但问题来源给定;科学推理模型的验证局限于任务或验证器,问题修正不定义;AI Scientist 系统串联工具与工作流,但问题常仍由人给出、技能迁移通常局限于任务内;搜索系统表征固定、评估器给定;自主实验室提供物理接地但目标与设计空间仍由人指定。只有 DFM 把问题源“构造”、表征修改、干预设计、问题修正、外部接地与技能迁移全部列为必需。此外本文强调系统边界与归因:若决定性的改写由人类提供且未被记录,不能把发现归功于模型;GALILEO 干湿闭环提供真实实证锚点,但作者刻意把通用 DFM 主张与单一领域系统区分开。
核心方法
直觉上,科学发现不是“假设→实验→结果”的固定流水线,而是在一个可修正的研究状态上不断改写:证据随时可能把调查打回到问题表述、表征甚至干预设计的更早阶段。论文据此给出三层构造。其一,形式化:发现回合建模为映射 $\Phi_{\mathrm{disc}}:(W,K_0,B)\to(\Delta K,\Xi)$——从部分理解的世界、初始知识与约束出发,产出外部验证的知识进展 $\Delta K$ 与携带证据的状态转移记录 $\Xi$;与任务抽象 $Q=(P,R,G,T,V)$ 的本质区别是问题、表征、假设空间、干预策略和验证程序都可改变。其二,能力分解:$C_{DFM}=\{C_{find},C_{form},C_{repr},C_{hyp},C_{int},C_{rev},C_{cont}\}$,前六项作用于单次调查内部,第七项是跨任务更新机制。其三,系统实例 Zetema:以显式研究状态为中心,耦合干实验推理、湿实验接地、研究世界模型门控与 Discovery Skill 演化,GALILEO 案例提供物理闭环实证。
核心创新是“科学上有后果的操作必须留下可检查的状态转移”。Zetema 把研究状态实例化为 $S_t=(P_t,R_t,H_t,E_t,X_t,B_t,\mathcal{M}_t)$——活动问题表述、当前表征、假设与前提、带出处的证据与反证、候选与已执行的干预、预算与风险、以及可用的知识与技能记忆——并且按科学角色给操作分型:表征修正不会被存成又一条假设,模型预测不会与实测混同,被拒绝的分支不会被删除。分支是一等公民:当对一次失败有多种合理解释时,系统无需把它们压缩成一段含混叙事,而可并行维护分支、各配诊断动作,直到干预区分它们。跨任务层面,Discovery Skill 被定义为 $m_i=(c_i,o_i,e_i,v_i)$:状态条件触发器、操作、预期效果与验证证据缺一不可——预期效果防止记忆退化为泛泛建议,验证证据把“世界事实积累”“情节记忆”与“可迁移研究操作”三种积累区分开,只有最后一类才算发现能力提升。这与把成功轨迹存档回放的 agent 记忆方案有本质区别。
方法步骤详情
发现过程四步(非固定流水线)。(1)问题发现与表述:从残差、矛盾、失败复现中筛选真未知,形式化为 $P=(O,\Omega,\ell,C,Y,Q)$——对象、范围、尺度、条件、观测量与未解机制,表述可被拒绝或重构。(2)表征与竞争解释:构建 $R=(O,V,R,A,L)$,操作含加隐变量、删代理、换尺度、分区制;解释 $H_i=(\mu_i,A_i,D_i,\hat{Y}_i,F_i)$ 须在机制、假设、效度域、预测与证伪条件上彼此不同。(3)干预与证据修正:按 $x^*=\arg\max_x\mathbb{E}[\Delta I(H\mid o_x)]$ 选择干预,执行后修订被牵连的研究对象并做失败归因——理论失败、测量误差、混杂等对应不同后续动作。(4)回合输出领域知识加候选教训,教训经回放与影子模式验证才晋升为 Discovery Skill。Zetema 以 $S_{t+1}=F(S_t,a_t,o_t)$ 推进状态,有代价动作先过世界模型门控,记忆经验证式更新;训练用模仿、状态转移、偏好、验证器、世界模型、科学反馈 RL 与技能检索七项组合损失,按算法 1 分阶段执行。
技术新颖性
技术新颖性体现在四点。第一,把“可修正研究状态”作为计算单元,取代最终文本答案,使表述改写、表征替换、分支回滚都能被归因和训练——现有 agent 框架普遍把长流程压缩成不可区分的叙事。第二,验证门控与研究世界模型的组合:开放生成产生的流畅但不可区分、不可行或不安全的候选,在被赋予真实代价前先做反事实筛选(式 13–14),并显式保留模型分歧、校准与分布外信号,以对抗世界模型误差的“选择效应”(保守模型压制罕见但有效的干预,过信模型反复选中自身错设暗示的动作)。第三,Discovery Skill 的结构化定义在 Buffer of Thoughts/ReasonFlux 的思维模板与 Recuris 的验证门控记忆之上,加入外部科学证据归因与严格的行为迁移判据:只有在控制额外领域事实、近重复检索、提示复用与额外算力后未来决策仍改善,才承认跨任务改进。第四,过程级 scaling:预算 $B=B_P+B_R+B_H+B_X+B_F+B_V$ 按状态依赖分配,证伪获得显式预算份额,避免候选生成与确认垄断算力。
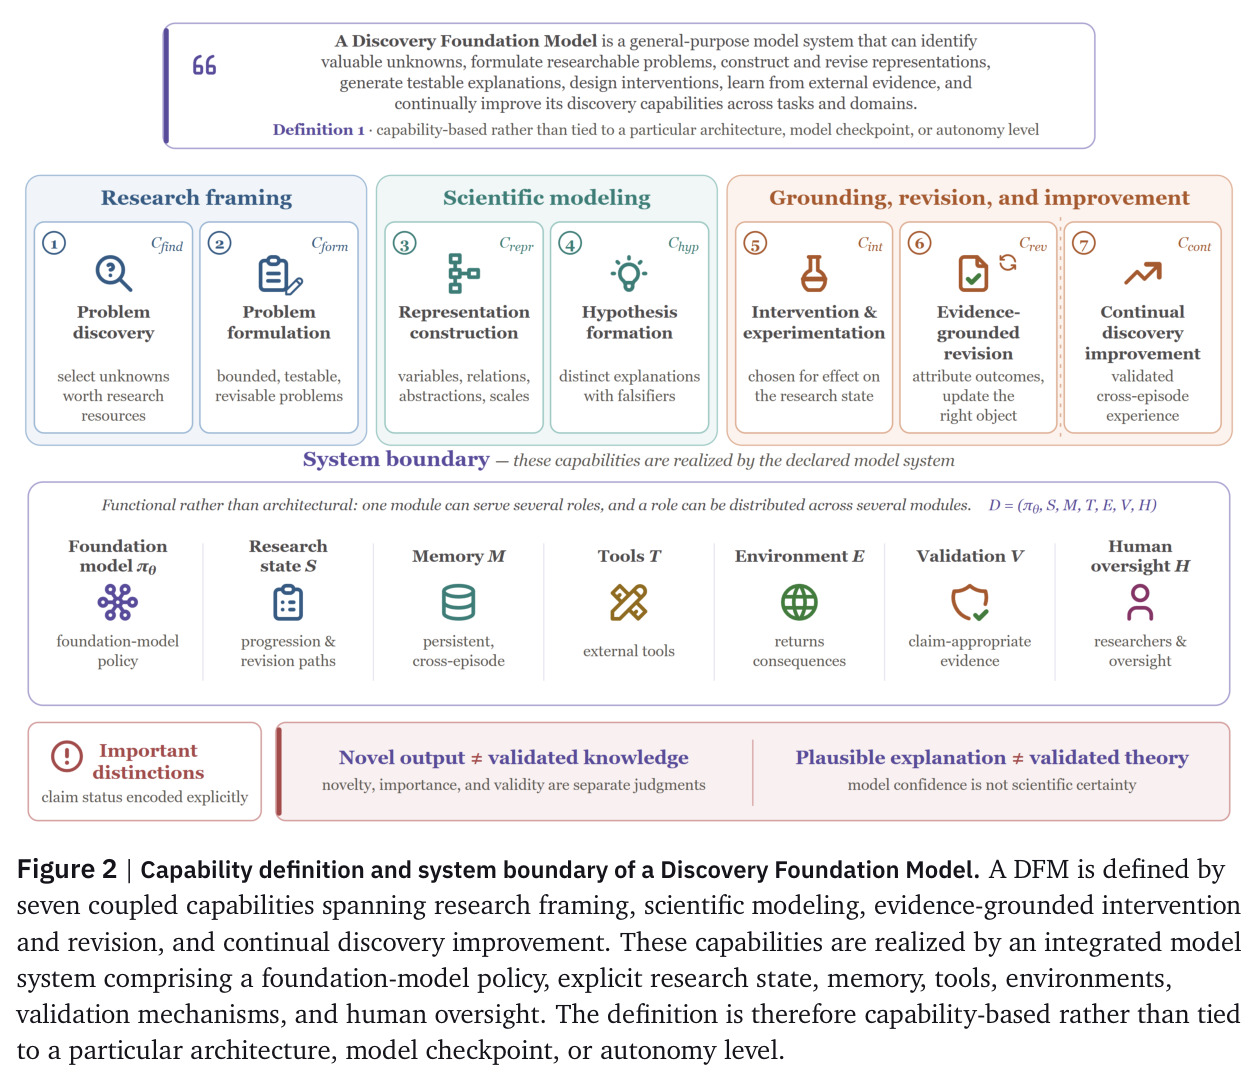
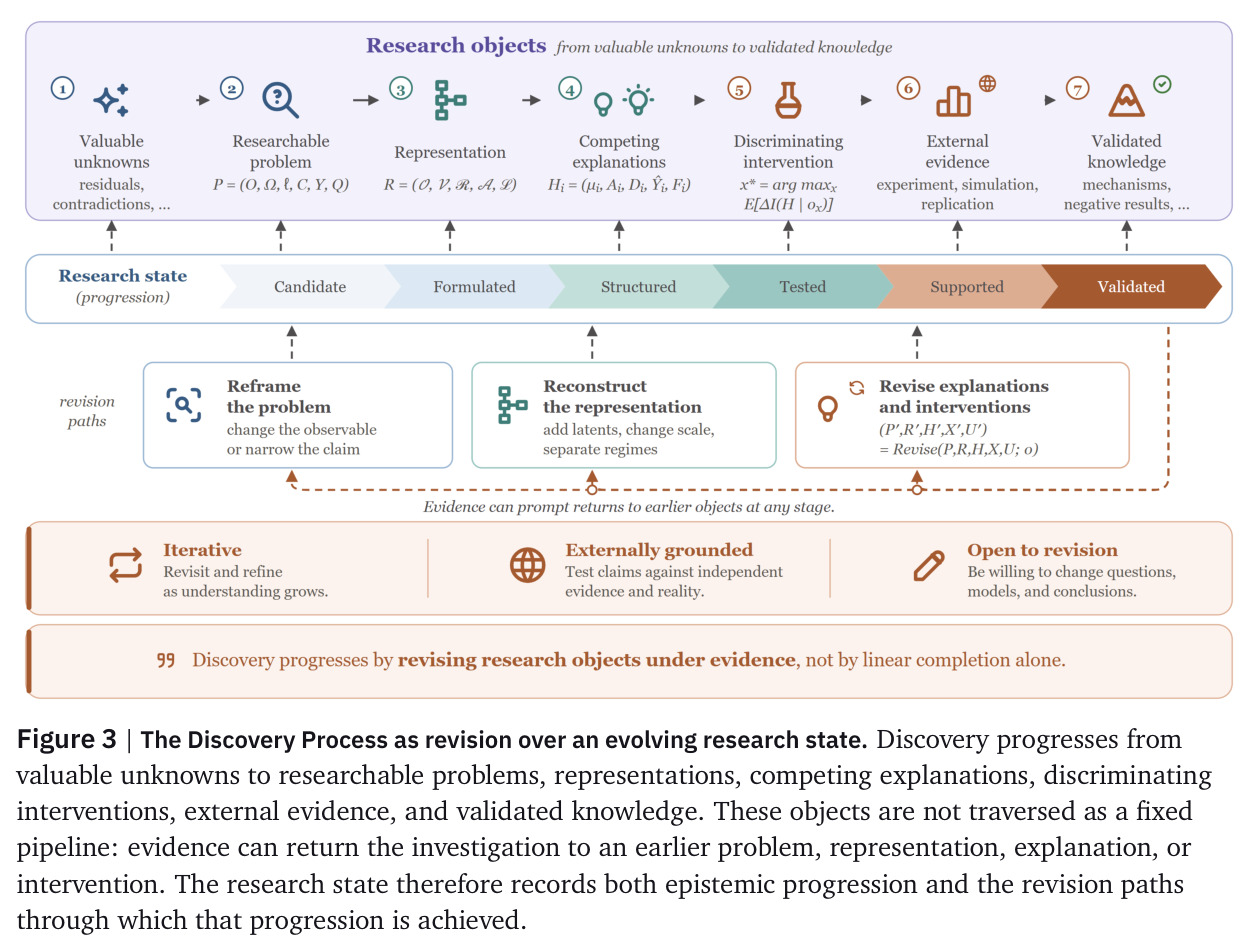
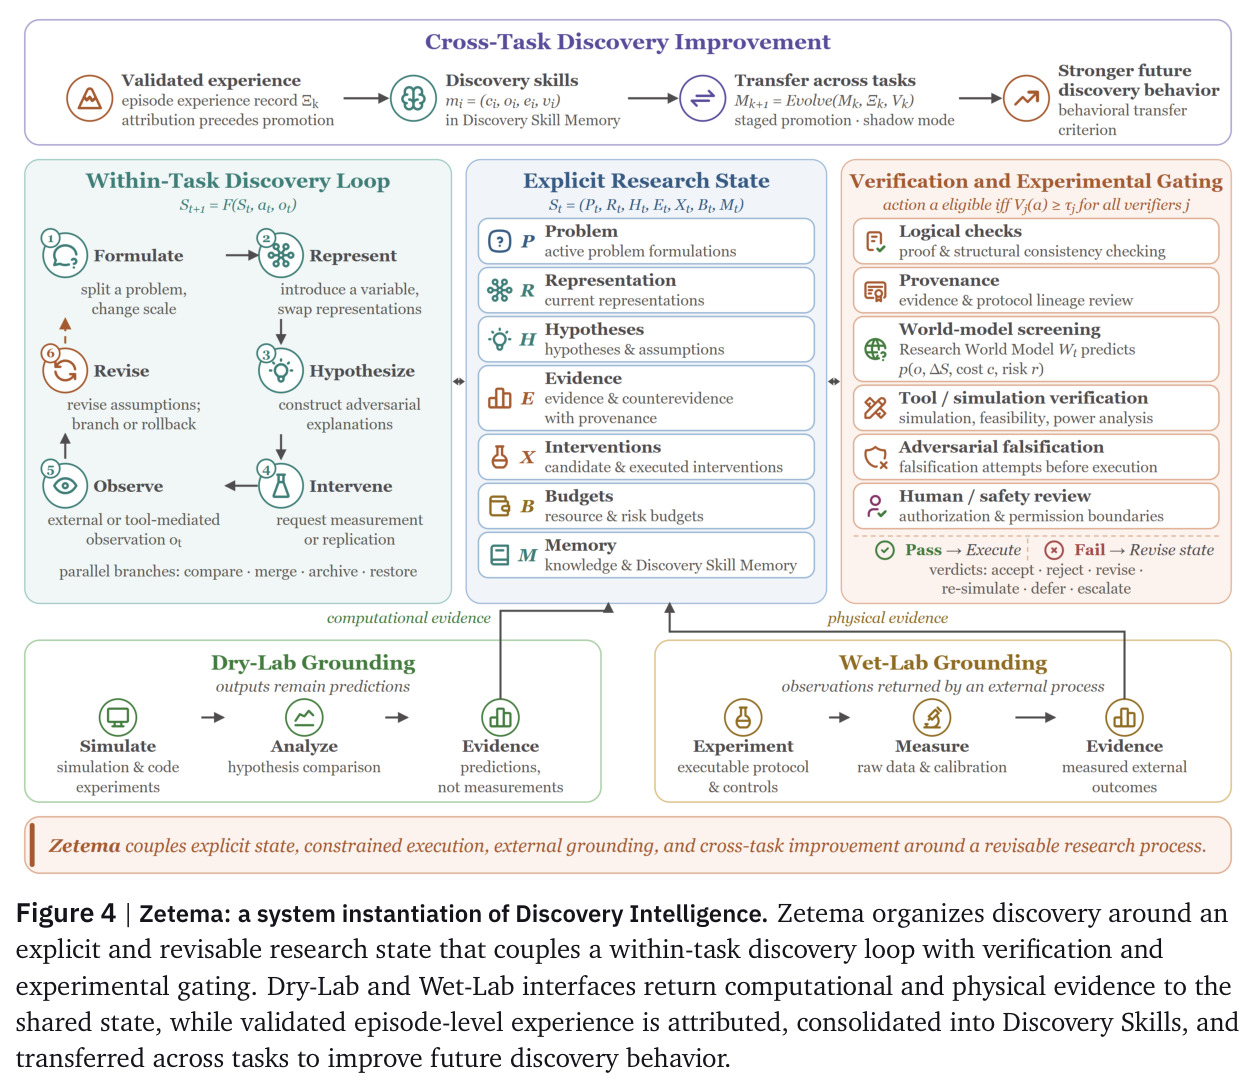
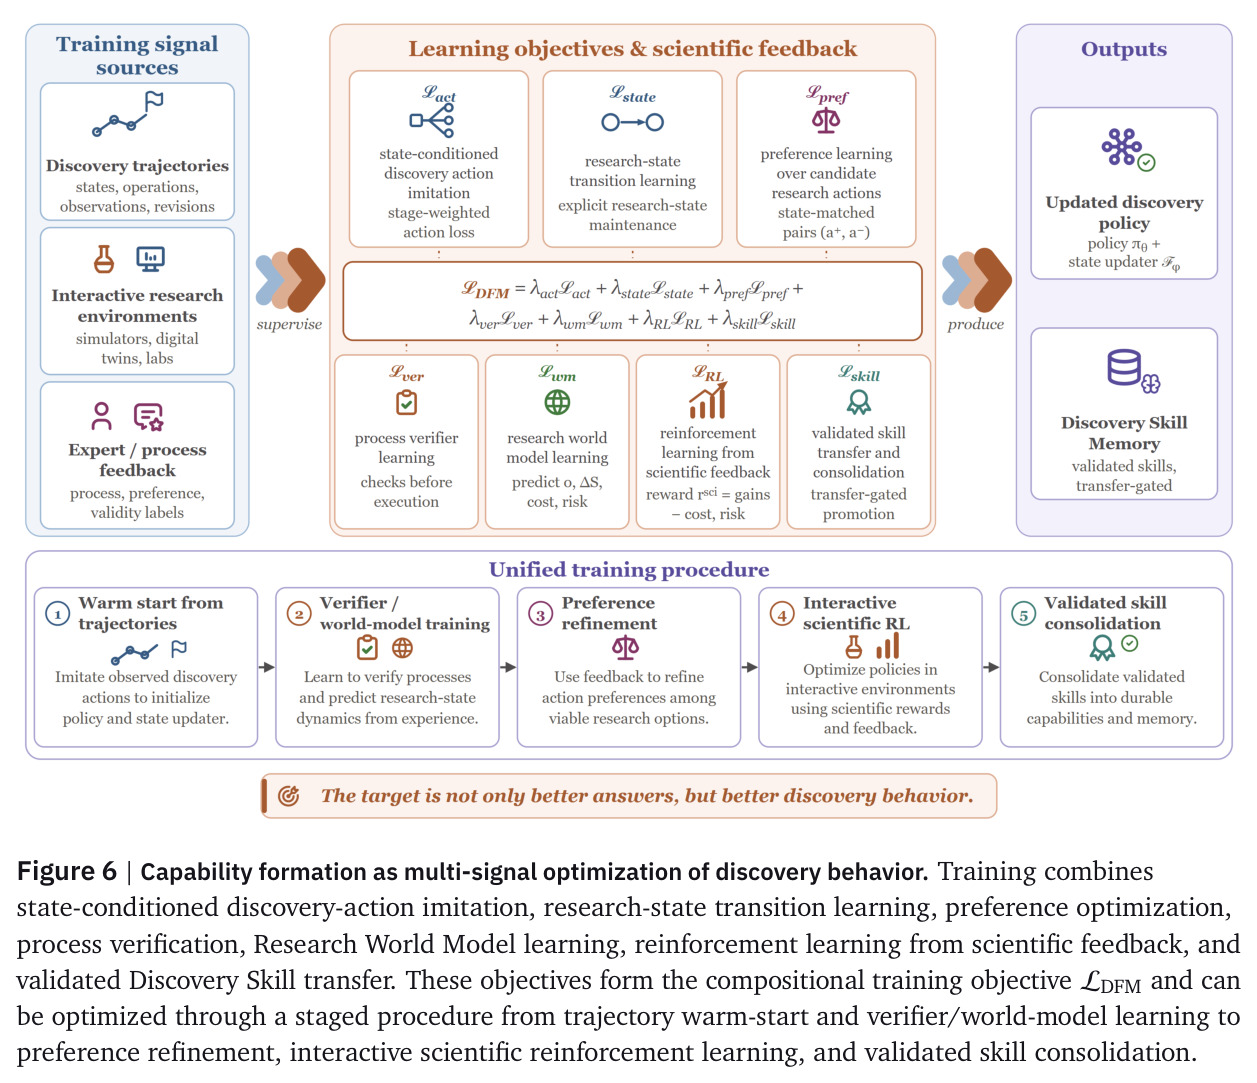
实验结果
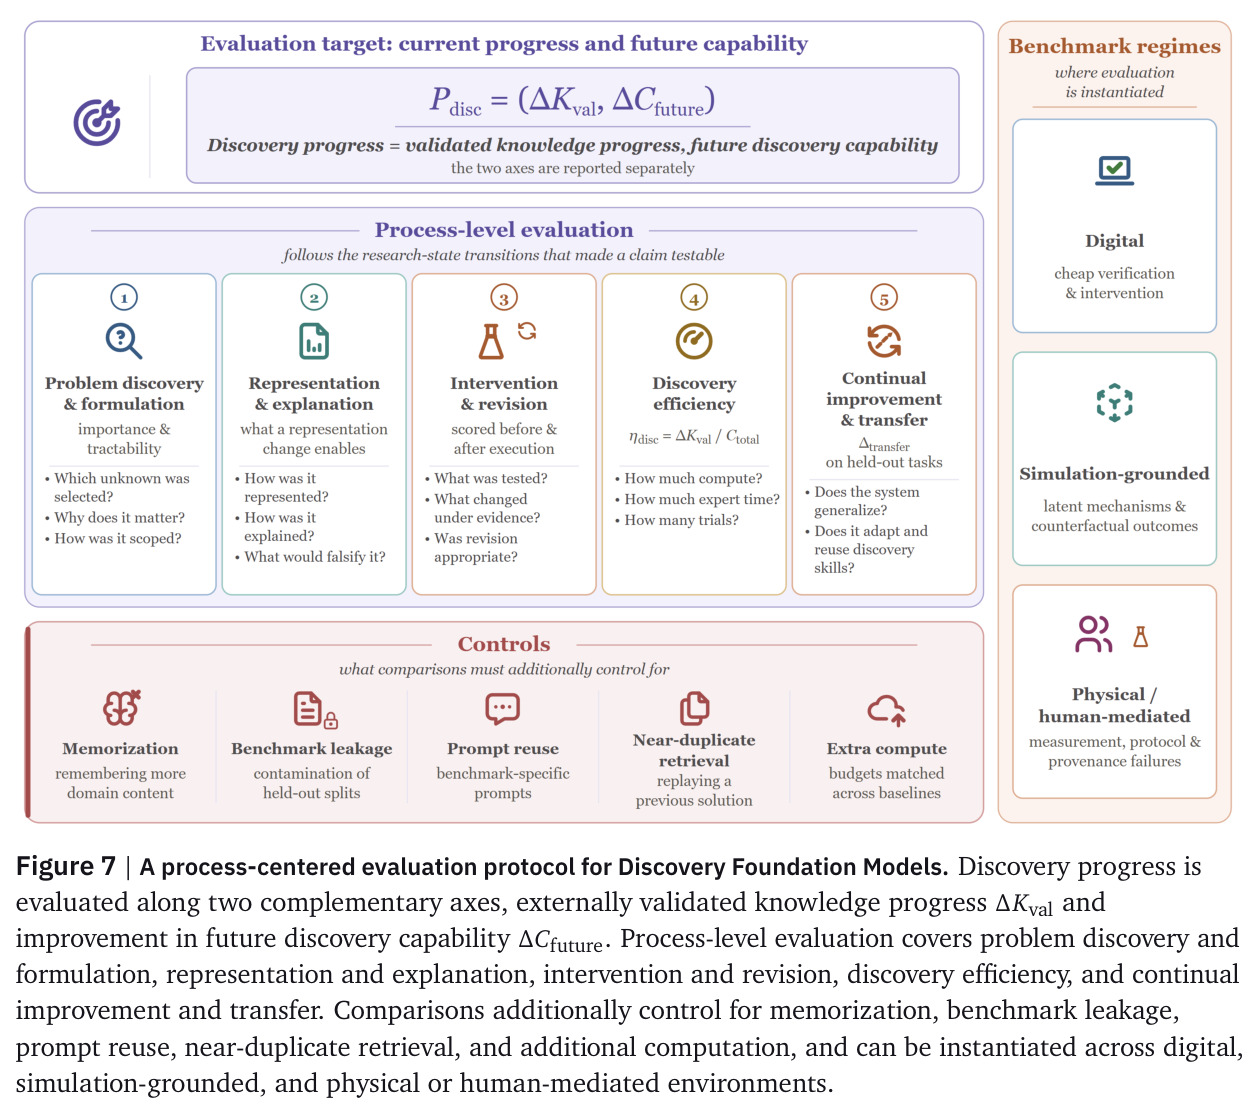
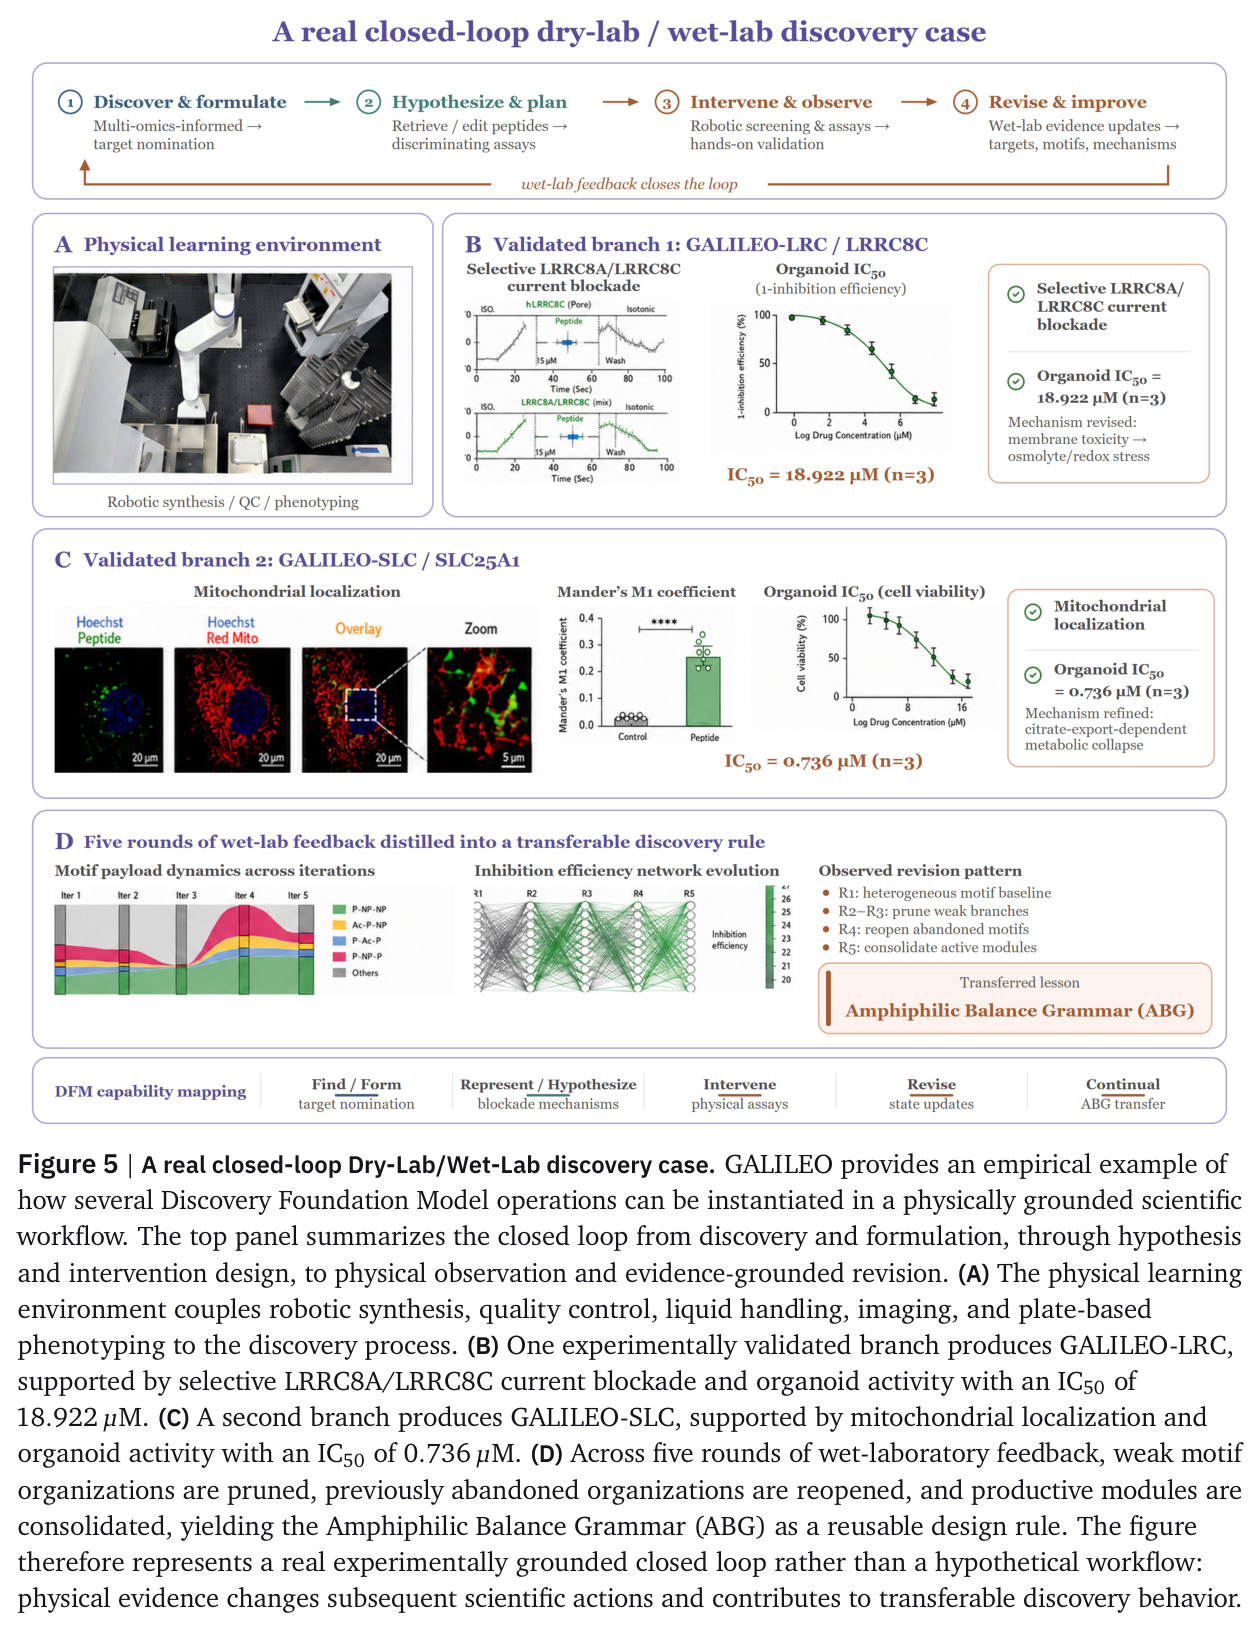
作为定位/框架论文,本文无传统基准,实证锚点是 GALILEO 治疗性多肽发现闭环(引自 Jiang et al.):机器人合成与表型测量耦合,物理反馈改变目标信念与机制假设。LRRC8C 分支产出 GALILEO-LRC:电生理显示对 LRRC8A/LRRC8C 电流的选择性抑制,LRRC8C-high 类器官中 IC50=18.922 $\mu$M,组学实验把机制解释从泛膜毒性推向渗透物/氧化应激与先天信号机制。SLC25A1 分支产出 GALILEO-SLC:线粒体定位,SLC25A1-high 类器官中 IC50=0.736 $\mu$M,沉默与乙酸拯救把解释收敛到柠檬酸外运依赖的代谢崩塌。5 轮湿实验反馈非单调:第 2–3 轮剪除弱分支,第 4 轮重启被放弃的酸性/极性/非极性 motif 组织,第 5 轮蒸馏出两亲平衡语法(ABG)并迁移到外部肽设计流程。评估协议定义双轴进展 $(\Delta K_{val},\Delta C_{future})$、效率 $\eta_{disc}$ 与迁移增益 $\Delta_{transfer}$,并要求对照组资源匹配比较。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 治疗性多肽发现:LRRC8C 靶点分支(动态膜系统) | 患者来源类器官活性 IC50 + 电生理选择性 | GALILEO-LRC:选择性抑制 LRRC8A/LRRC8C 电流,LRRC8C-high 类器官 IC50 = 18.922 μM | 无直接对照候选;机制解释从泛膜毒性修正为 LRRC8C 相关渗透物/氧化应激与先天信号机制 | 首个经正交物理验证(电生理+类器官+代谢/转录组)的 LRRC8C 选择性抑制多肽,且证据链驱动了机制假设更新 |
| 治疗性多肽发现:SLC25A1 靶点分支 | 患者来源类器官剂量响应 IC50 + 亚细胞定位 | GALILEO-SLC:线粒体区室定位,SLC25A1-high 类器官 IC50 = 0.736 μM | 无直接对照候选;经沉默/乙酸拯救等机制实验确认 citrate-export 依赖代谢崩塌机制 | IC50 比 LRC 分支低约 25.7 倍,且展示了异质外部观测支持不同类型研究状态更新的分支策略 |
| 跨轮回发现技能形成(多肽 motif 优化策略) | 5 轮湿实验反馈后的可复用设计规则及外部迁移效果 | 蒸馏出两亲平衡语法(ABG);源自物理优化分支的 motif 迁移到外部肽设计流程,改善几何与能量分布 | 静态候选排序(被拒绝的分支被永久遗忘、策略单调收缩) | 展示“在何种研究状态下应生成/拒绝/恢复某组织”的条件化策略:弱分支可被重启,经验可跨工作流迁移 |
局限与改进
作者明确承认:GALILEO 的问题域、分子模态、实验接口和科学目标仍高度结构化,更广的跨领域发现迁移仍是开放问题;Table 1 只描述各范式的典型能力目标而非每个系统的普适性质,“DFM”标签本身不赋予未展示的能力;GALILEO 中电生理、代谢谱、患者组织实验等仍由 agent 指定但人类执行,能力主张属于耦合系统而非全自动模型。我的补充观察:(1)Zetema 是功能规范而非实现,论文没有给出任何定量对照实验证明该架构相对简单 agent 记忆方案的优势;(2)第 6 章的训练目标全部停留在公式层面,没有实验验证、消融或权重 $\lambda$ 的敏感性分析;(3)科学奖励 $r_t^{sci}$ 中的 $\delta K_t$、信息增益与修正质量在实践中如何可靠估计,是比公式难得多的难题,论文未给出可操作方案;(4)评估协议高度依赖尚未存在的基准实例,对照组设计复杂,短期难以落地;(5)案例证据全部来自单一引用工作,通用框架与实证之间的 gap 由读者自行脑补。
独立分析的弱点
独立分析有五点弱点。(1)框架过于重量级:七能力+显式类型化状态+多层验证+分阶段技能晋升,对工程与组织要求极高,缺少“最小可行 DFM”;改进方向是先在数字发现视界(代码、调试、ML 实验复现)实现裁剪版,用 $\Delta_{transfer}$ 对照组证明价值后再扩展。(2)Discovery Skill 的触发依赖“研究状态条件”,但状态本身是文本/图结构,触发的可靠匹配与负迁移控制机制未给出;可引入检索不确定性校准与保守晋升阈值。(3)研究世界模型的误差选择效应作者自己指出,但其缓解手段(有界 pilot、分歧驱动更新)完全未验证,应在仿真环境中量化“筛选误差→资源错配”的传导。(4)人类执行的实验环节(电生理、代谢组、体内验证)意味着当前物理视界的吞吐瓶颈仍在人,端到端自动化叙事打折;需要更深度的实验室自动化集成。(5)偏好数据 $\mathcal{D}_{pref}$ 要求“同一状态下比较两个动作”,真实科研轨迹极少提供这种反事实对,目前只能靠仿真器或单操作差异的分支对比生成,数据来源是训练落地的最大短板。
未来方向
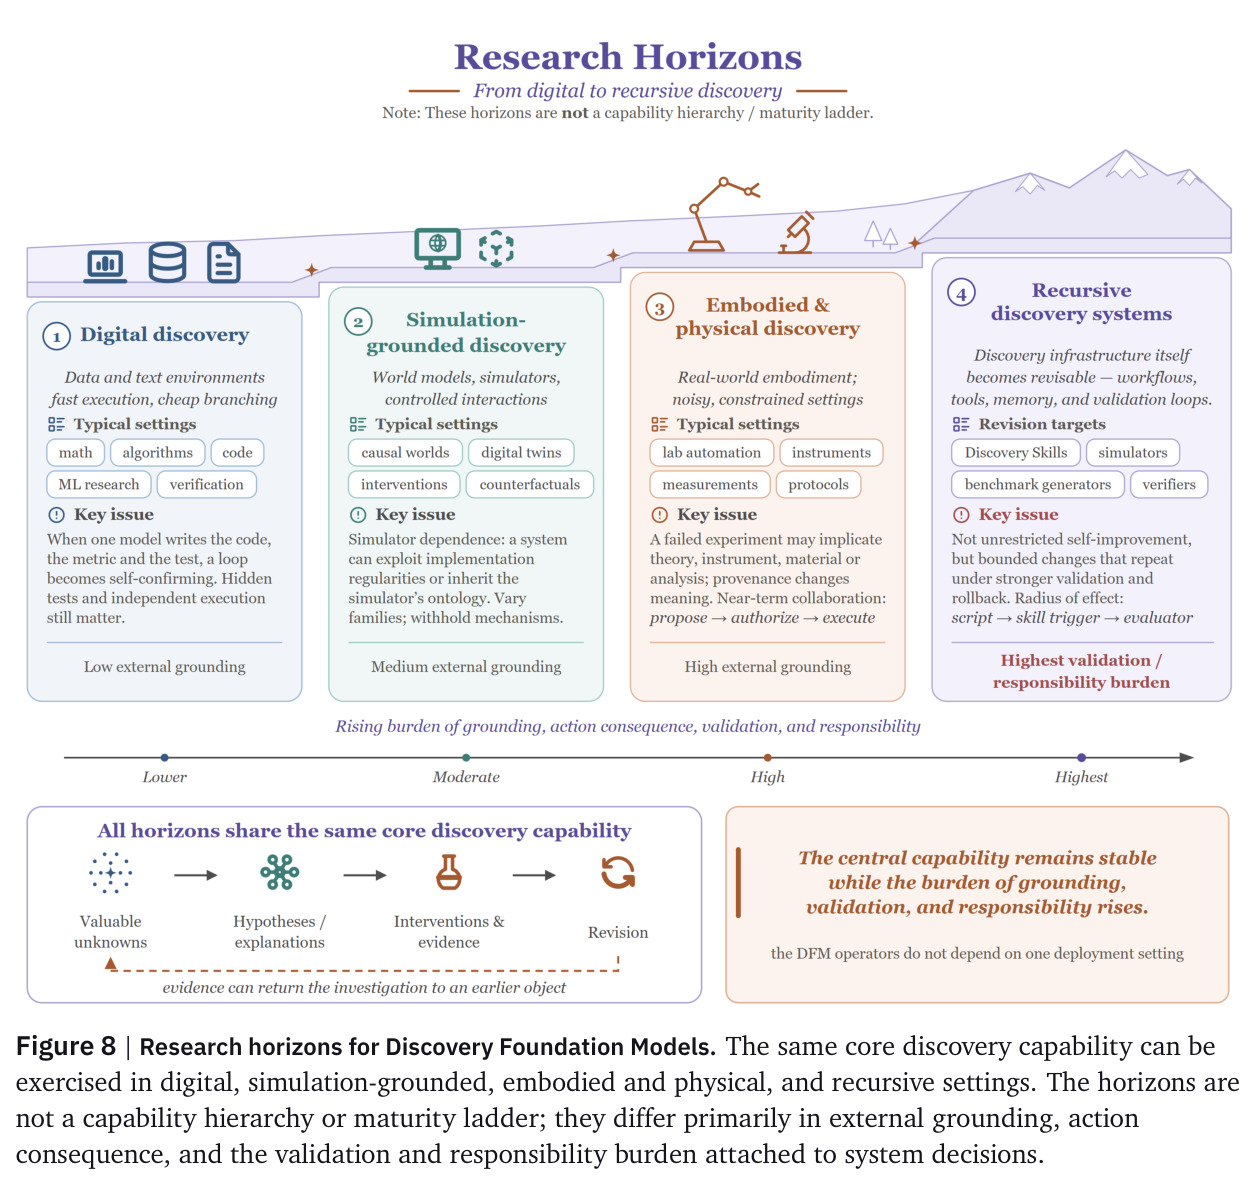
作者提出的方向:四个接地视界各有研究议程——数字发现要警惕自确认循环(同一模型写代码、选指标、做测试、下结论),需隐藏测试与独立执行;仿真接地要对抗仿真器依赖(继承本体、利用实现规律),需跨仿真器族测试迁移;物理发现的近期形态是“协作型 DFM”(模型表述仿真、验证器过滤、专家授权、实验室执行、独立组复现);递归发现系统可修订技能、工具、评估器、记忆组织甚至基准生成器,但需要随“影响半径”缩放的版本化、沙箱、影子模式、金丝雀任务、回滚与外部审计。基于本文成果可延伸:在因果仿真环境中实例化 $\Delta_{transfer}$ 曲线,首次定量检验 Discovery Skill 假设;把过程级预算分配 $B=B_P+B_R+B_H+B_X+B_F+B_V$ 做成可学习策略,研究“发现版 test-time scaling law”;将 $\mathcal{L}_{skill}$ 的对比检索与现有 agent 记忆系统对接做系统消融;以及按论文的基准构建原则(扣留隐藏变量、植入观测等价机制与评估器捷径)发布首个过程中心发现基准。
复现评估
作为框架论文,概念部分(定义、公式、协议)完全可复现:所有关键对象——任务抽象、发现映射、七能力、状态元组、技能四元组、七项损失——都有明确形式化定义。但系统层面复现困难:Zetema 只是功能接口规范,论文未发布实现代码;GALILEO 案例引自 Jiang et al.(2026),本文未附带其代码、数据或协议细节,复现湿实验闭环需要机器人合成平台、类器官培养、电生理与代谢组学等专业设施和湿实验室团队,门槛极高;论文给出的仓库 github.com/Gen-Verse/DFM-Plans 是合作计划入口而非可运行系统。可行的降级复现路径是数字/仿真视界:用因果模拟器构造含隐藏变量与观测等价机制的数据集,实现 $S_t$ 状态、门控与技能记忆的最小版本,按第 7 章对照组验证 $\Delta_{transfer}$——大约需要单机多卡微调 7B 级模型加数周工程量,难度中等偏难;完整复现物理闭环则属于机构级课题。
论文图表
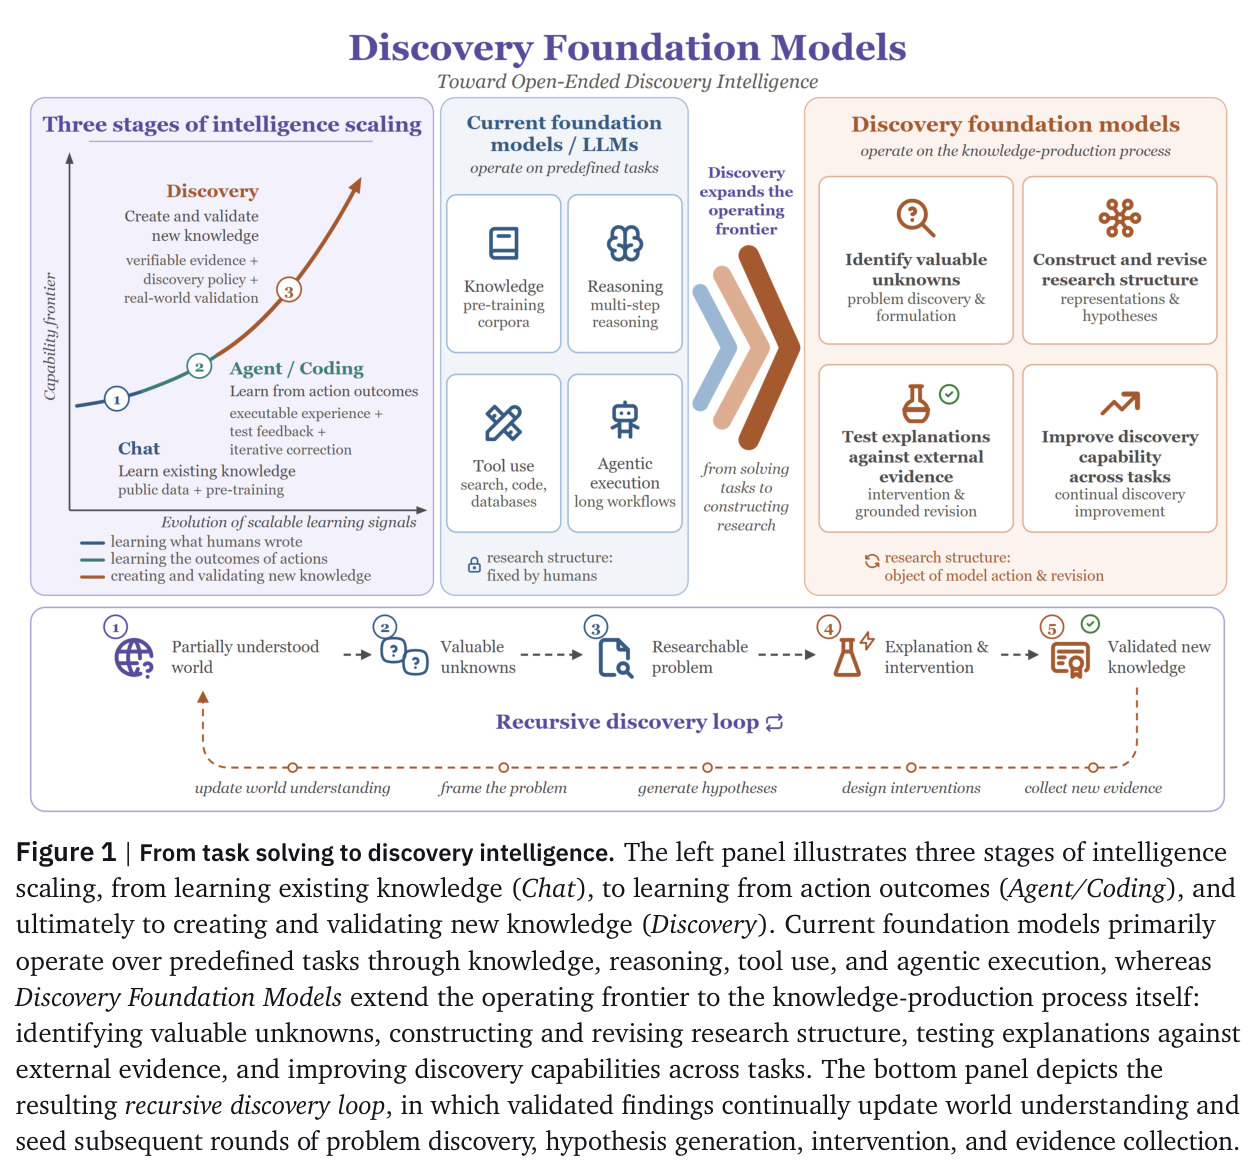
上 panel 展示智能规模化的三阶段:学习既有知识(Chat)→ 从动作结果中学习→ 创造并验证新知识;下 panel 画出递归发现循环:被验证的发现持续更新世界理解,并播种下一轮问题发现、假设生成、干预与证据收集。
一张图讲清论文的核心主张与历史定位:为什么现有基础模型停在第三阶段门口、DFM 要补的是什么,是理解全文动机的入口。
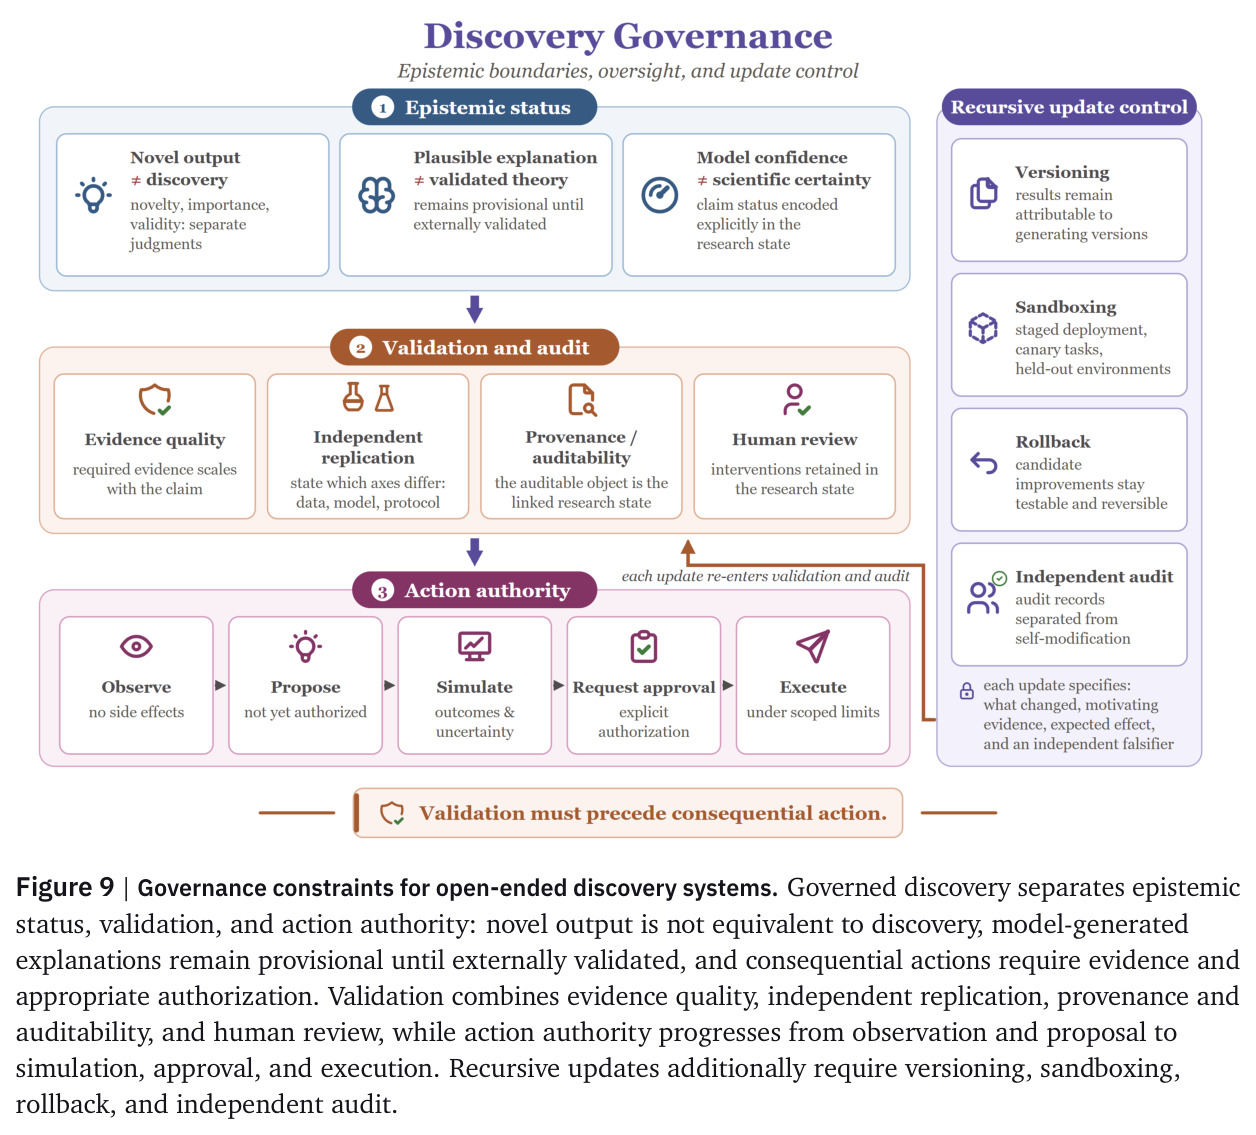
治理约束图:分离认知地位、验证与行动权限三个变量——新颖输出不等于发现,模型生成的解释在外部验证前保持暂定,有后果的动作需要证据与相应授权;验证组合证据质量、独立复现、来源可审计性与人类审查;行动权限从观察、提议到仿真、批准、执行逐级开放;递归更新额外要求版本化、沙箱、回滚与独立审计。
论文风险讨论的核心图:当系统能修订自己的评估器和记忆时,治理成为认知架构的一部分,此图给出最小治理清单。
参考训练流程:初始化策略 $\pi_\theta$、状态更新器 $F_\phi$、世界模型 $W_\omega$、验证器 $V_\psi$ 与技能选择器 $q_\eta$;离线用 $\mathcal{L}_{act}+\lambda_{state}\mathcal{L}_{state}$ 热启动,训练验证器与世界模型,用状态匹配动作对做偏好精修;交互回合中提出候选操作→世界模型预测后果与风险→门控选择合格动作→执行并更新状态、计算科学奖励 $r^{sci}_t$→用 $\mathcal{L}_{RL}$ 更新策略;从归因的成功/失败/分支对比推断候选 Discovery Skill,只有在留出/回放/影子模式下于资源匹配条件改善迁移并通过验证,才晋升进记忆。
把第 6 章的公式化目标落成可执行伪代码,最关键的设计是第 16–20 行:记忆更新被置于迁移验证门控之后,这是防止经验污染的核心机制。