LynnReal-Omni:面向智能体视觉工作流的原生多模态视频生成 LynnReal-Omni: Native multi-modal Video Generation for Agentic Visual Workflows
统一七类视频任务的32B多模态扩散模型,540p视频377毫秒生成
前置知识
扩散 Transformer(DiT)与视频潜空间
扩散模型通过逐步去噪学习数据分布,把生成过程分解为多步神经网络预测。DiT 用 Transformer 替代 U-Net 作为去噪骨干,将视频经 VAE 压缩成时空潜 token 后在其上做去噪。本文标准模型有 50 个 transformer 块、残差宽度 5376、56 个 128 维注意力头、前馈宽度 14336,视频潜变量 24 通道、按 1×2×2 分块,音频流 32 输入通道,文本条件维度 5120,整体规模 32B。
论文的一切设计(任务布局、双噪声时钟、蒸馏、解码器加速)都建立在这个共享 DiT 与 VAE 潜空间之上,不了解骨干结构就无法理解各组件如何拼装与加速。
流匹配与速度预测
流匹配是扩散的一类参数化:模型直接预测把噪声输运到干净数据的速度场。本文采用 clean-time 约定 $z_t = t z + (1-t)\epsilon$、$v^\star = z - \epsilon$,$t\in[0,1]$ 越大越接近干净数据。视频噪声水平从移位 logistic-normal 分布采样:$s_v = 3u/(1+2u)$,$t_v = 1-s_v$;音频再经 $s_b = s_v/(12-11 s_v)$ 映射到自己的时钟 $s_a$,两模态共享同一随机数但噪声进度不同。
论文的损失函数(式 5)、视频-音频双时钟(式 3-4)和蒸馏时间步全部围绕这套参数化展开,是读懂方法章的前提。
分布匹配蒸馏(DMD/TDM)
蒸馏把多步扩散教师压缩为一步或几步学生。DMD 用分布匹配损失让学生输出分布逼近教师;TDM(轨迹分布匹配)进一步对学生轨迹上的短转移做监督,配合冻结教师与一个可训练的 fake-score critic。本文标准模型用低秩 TDM 做 4 次函数求值(NFE)推理,Flash 用 3 次,并引入 Reward Forcing 的动态视觉奖励为视频损失项重加权。
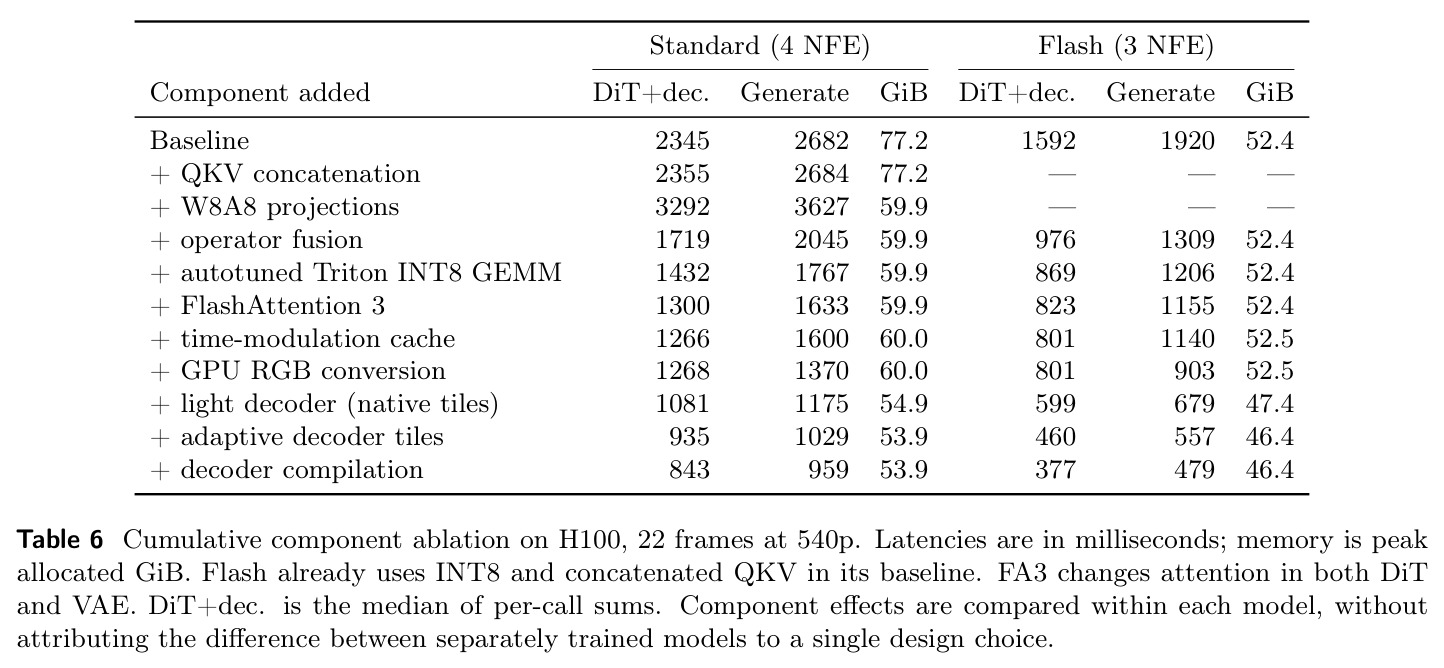
843ms/377ms 的延迟直接来自 4/3 步蒸馏;同时少步化把推理瓶颈从去噪器转移到 VAE 解码器,这正是论文做轻量解码器蒸馏的动机。
VAE 与解码器瓶颈
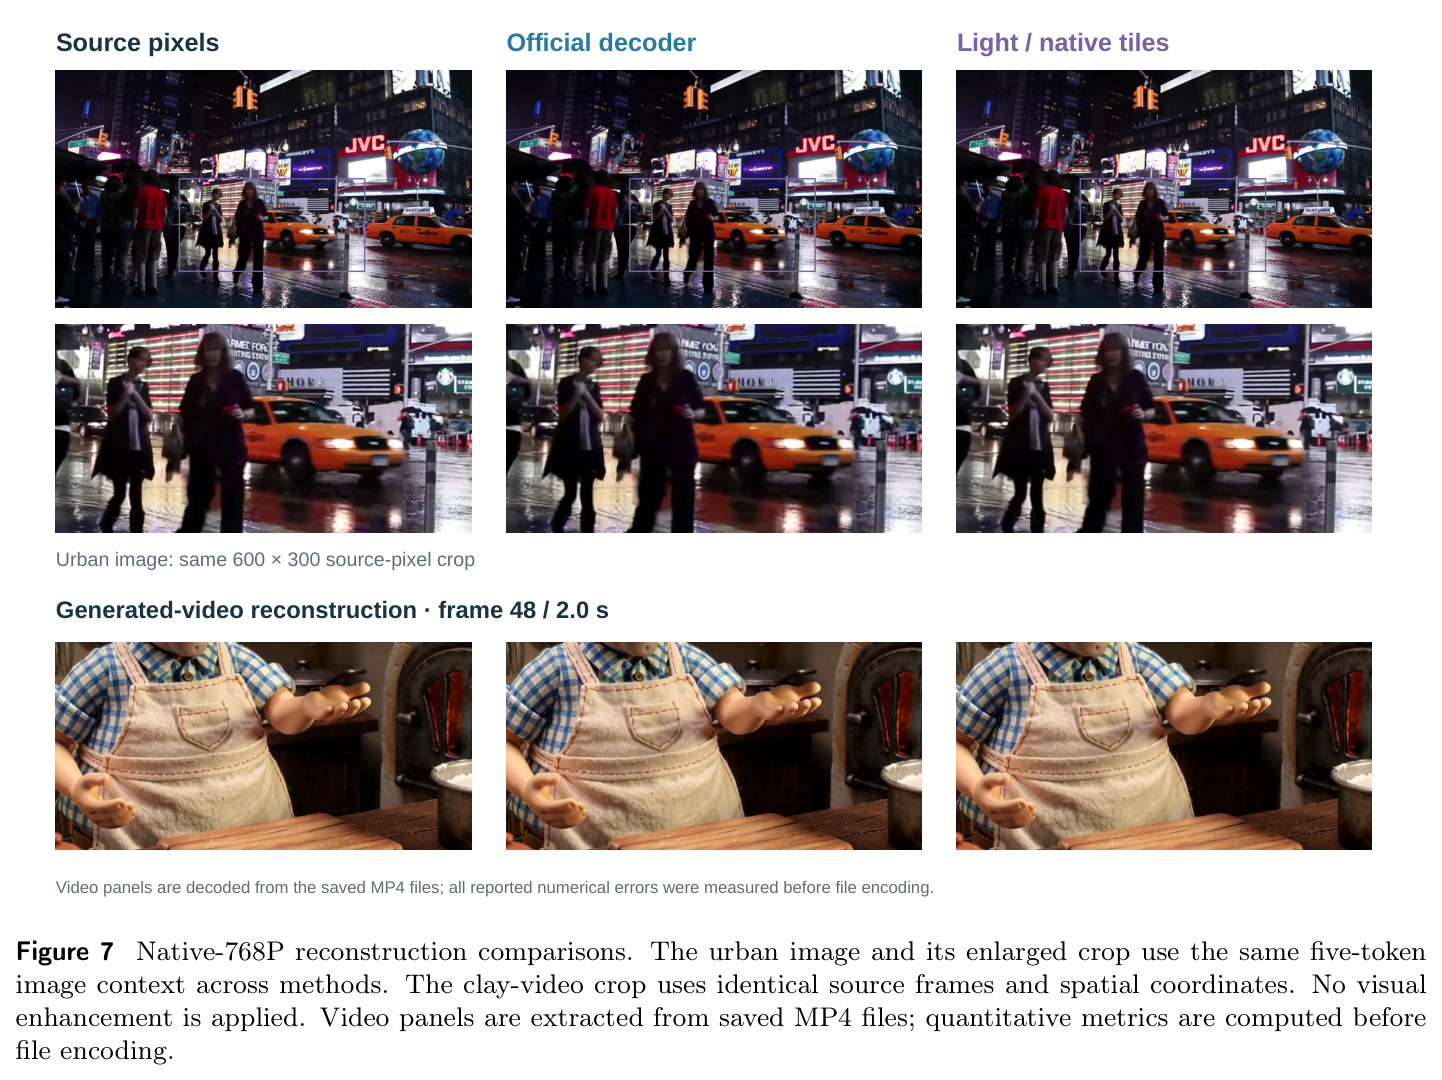
视频潜空间模型用 VAE 编码器把像素压成潜变量,生成后再由解码器还原 RGB。当去噪被蒸馏到 3-4 步后,36 块解码器反而成为主要耗时。本文把解码器从 36 块蒸馏到 26 块学生(宽度 2048、MLP 扩展 4 不变),潜接口完全不变可直接替换,配合瓦片调度与编译把 22 帧 540p 解码从 469ms 降到 340ms。
轻量解码器是本文效率主张的关键一环,理解解码器瓶颈才能读懂 Table 6 的组件消融逻辑和『参数量减少不等于整条流水线延迟下降』的论证。
智能体视觉创作
指让 LLM 智能体主动构造视觉控制信号:生成参考图、写代码搭建可编辑 3D 场景(几何、材质、灯光、相机轨迹),甚至编写带碰撞规则和状态更新的可执行游戏,从而显式确定场景几何与运动。它保证控制稳定、可检查、可修改,但本身不保证物体和角色的高保真外观。
本文把智能体产出的 3D 渲染、游戏录像作为模型的原生输入条件,这正是标题中 Agentic Visual Workflows 的含义,也是它区别于普通文生视频模型的定位。
研究动机
视频扩散模型虽然视觉保真度很高,但本质上难以精确控制:生成是随机的,想要特定内容往往需要反复采样且不保证成功;长时程生成还会出现外观漂移、身份变化、交互错误和时序连贯性退化,使其难以充当要求显式、可重复控制的渲染引擎。工程层面,文本生成视频、图像条件生成、参考引导生成、结构控制、编辑、长视频生成等任务长期由各自独立的专用流水线承担,智能体必须拼装多个模型和临时接口,成本高且跨任务行为不一致。评测也不完善:VBench、VideoPhy 等协议只覆盖部分维度,没有在单一框架下同时覆盖多镜头连续性、动作绑定、物理合理性、可控性与音频质量,且常把不可比的度量尺度直接聚合,掩盖了具体维度的失败。此外,少步蒸馏大幅压缩去噪成本后,VAE 解码器反而成为推理瓶颈,而解码加速必须与去噪联合评估,因为削减解码计算可能影响时间相位或重建质量。
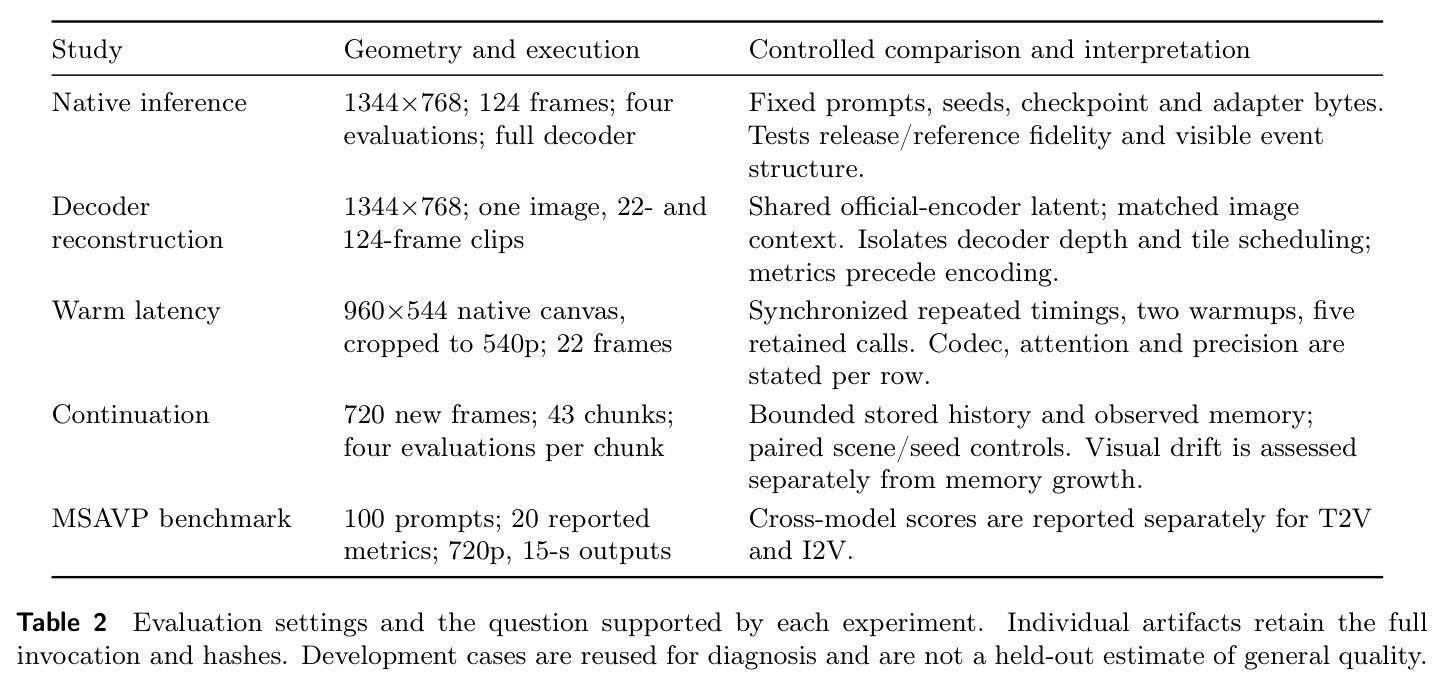
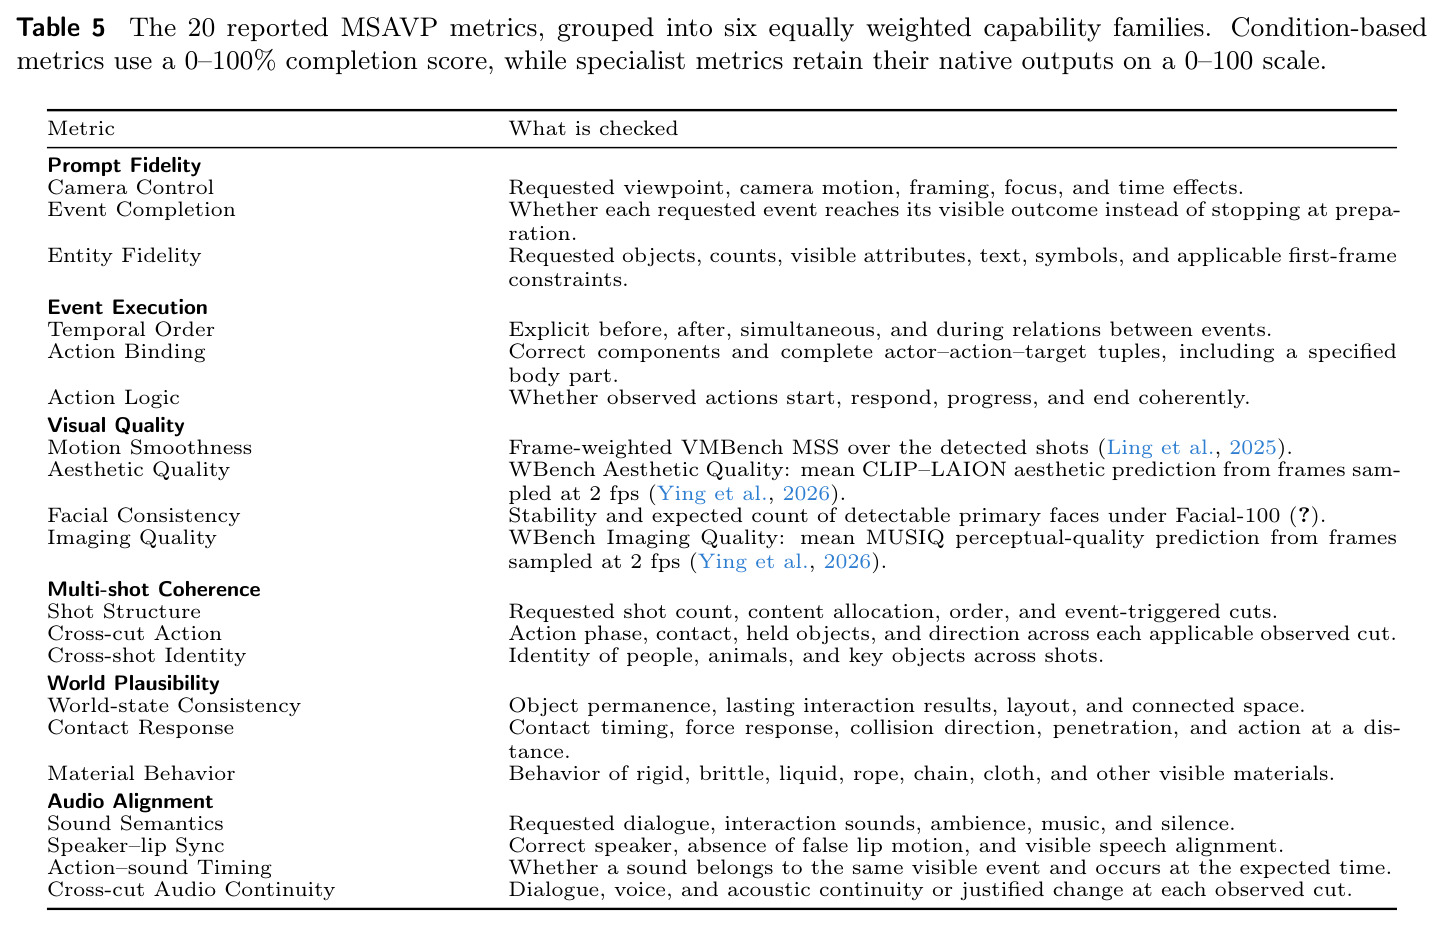
本文的目标是本文的目标是构建一个统一、可控、高效的原生多模态视频生成框架 LynnReal-Omni,作为智能体视觉创作的渲染引擎。具体包括五个方面:(1) 用一个共享多模态扩散 Transformer(标准版 32B)统一文本生成视频、图像条件生成、参考引导生成、结构控制、编辑、退化视频修复和长视频生成等任务,用共享去噪器加任务专用输入布局取代碎片化的专用堆栈;(2) 训练 27B 的 Flash 版本实现准实时渲染;(3) 建立系统的数据流水线,把公开视频加工成带主体关联、多模态标注与对齐控制信号的多镜头音视频语料;(4) 提出 MSAVP 基准,用 100 个提示、20 个指标把语义遵循、生成合理性、视觉质量、时序行为与音频协调分开评估;(5) 通过模型加速与轻量解码器把单张 H100 上 540p 22 帧视频的温热生成+解码时间压到 843ms(标准版)和 377ms(Flash)。
与已有工作不同的是,本文的独特切入是把『智能体视觉创作』与『视频扩散』互补结合:智能体产出参考图、可编辑 3D 场景或可执行游戏状态,提供显式、可检查的几何与运动控制;扩散模型补充高保真外观与细节,二者结合才同时获得稳定控制与高保真。技术上它不用外挂适配器堆任务,而是设计『原生任务表示』——每个任务用 token 打包布局显式编码模态身份、行索引、3D 旋转位置和逐行噪声时间,让外观参考、逐帧对齐控制、3D 渲染、游戏录像和因果历史在同一 Transformer 内保持各自角色。另一个差异化点是罕见的方法论克制:每个实验只回答一个问题(重载保真、压缩质量、温热延迟、续写漂移),坚持配对比较与组件级消融,明确拒绝把重建指标当生成分数、把小画布时序外推到大画布、把量化等数值改动与纯调度收益混为一谈。
核心方法
先说直觉:作者想要一个『什么条件都能吃、什么任务都会做、还足够快』的视频生成引擎,供智能体工作流直接调用。技术路线分五块。第一,原生多模态骨干:50 块共享 DiT 一次前向同时预测视频和音频速度,每个任务用不同 token 打包布局(文本到视频、参考/编辑、图像/续写等),对齐控制行与目标行满足 $\tau_i^{target}-\tau_i^{control}=\Delta,\ \Delta>0$ 的常数正时间偏移,以此把『参考域』与『生成域』分开——若把二者的绝对旋转坐标设为相等,条件化语义就会改变。第二,多任务流训练加少步蒸馏:标准版 4 次、Flash 版 3 次评估完成去噪。第三,有界历史的长视频:按固定长度分块生成、每块 17 新帧、固定头帧重叠,历史上下文的 token 预算不超过 2 个稠密潜帧,注意力成本与视频长度无关。第四,轻量解码器蒸馏:36 块教师压到 26 块学生,潜接口不变。第五,智能体生成的 3D 场景与可执行游戏提供可检验的空间与运动控制,经原生参考接口进入同一模型。
核心创新是『共享去噪器 + 原生任务布局』的统一范式:不训练多个专用模型,而是一个 DiT 通过任务特定输入布局同时服务七类任务,每个 token 携带模态身份、行索引、3D 旋转坐标和逐行噪声时间。两个精妙设计值得强调。其一,视频-音频双噪声时钟:同一 4 次去噪评估中,视频在 clean-time 约 $(0, 0.0270, 0.0769, 0.2000)$ 处求值,音频在 $(0, 0.1000, 0.2500, 0.5000)$ 处求值,这些时间步由各模态自己的行-时间映射决定,第四次更新后直接推进到干净端点,无需第五次前向。其二,引导感知拟合:训练时同一去噪器额外输出无字幕、停梯度的预测 $v_\emptyset$,损失改用 $\hat{v}_e=(v_c+(w-1)\,\mathrm{sg}(v_\emptyset))/w$(记录尺度 $w=3$)回归,使条件分支的回归最优解逼近 $w v^\star-(w-1)v_\emptyset$;推理时直接用条件预测,不为每步去噪附加无分类器引导的额外前向。这两点共同让一个权重同时做到音视频联合、多任务、少步高效推理。
方法步骤详情
步骤一,数据处理:TransNetV2 切分镜头并剔除闪光误检,PP-OCR 清理水印字幕;Qwen3.5 大模型做场景分组与主体跨镜头链接,专用检测器跟踪姿态并对齐语音;最终仅 0.6% 存储留存、每段不超过 1 分钟。步骤二,多任务训练:损失 $L=\mathrm{MSE}_V+0.1\mathbb{1}_{valid}\mathrm{MSE}_A$,缺失音频不算静音。步骤三,标准版以低秩轨迹分布匹配蒸馏到 4 次评估,冻结教师加 fake-score critic。步骤四,Flash 裁到 42/50 块:中间 26 块 stride-2 空间压缩并以残差回填,末 14 块全分辨率精修,3 步蒸馏加 W4A8 量化。步骤五,长视频分块:固定边界帧潜变量、5 个未来潜帧联合解码去重交付 17 新帧;历史为 1 帧全分辨率加至多 8 帧 stride-4 采样,预算不超 2 个稠密潜帧。步骤六,解码器 36 块蒸馏到 26 块:混合两类潜变量训练,损失含教师重建、时空正则、特征蒸馏、DINOv2 感知与后验 KL。步骤七,逐帧修复伪影,智能体构建 3D 场景与可执行游戏提供运动控制。
技术新颖性
与已有工作的本质区别有五点。(1) 相对 VACE 等统一条件接口的工作,本文把音视频联合生成、编辑、退化修复、长视频、结构控制全部收进一个权重里,任务切换只改 token 布局不改模型。(2) 双噪声时钟设计承认『同一次去噪求值对两个模态意味着不同噪声水平』,比共享时间步向量更诚实,是音视频联合少步蒸馏的干净解法。(3) Flash 的 token 压缩保留边界行列、保留原始时空旋转坐标,并用最近保留 token 的更新回填被丢弃 token(式 7),把中间序列长度从 $N_v+N_t+N_a$ 降到约 $N_v/4+N_t+N_a$,是对『压缩不破坏多模态结构』的明确工程承诺;消融显示关闭压缩会使 DiT 时间从 263ms 涨到 453ms。(4) 解码器蒸馏以教师重建而非真值为主要监督目标,生成潜变量没有配对像素也能被监督,再用冻结编码器的后验 KL 把学生输出锚定在教师的潜分布上,且 26 块学生可直接替换 36 块教师而不动上游生成模型。(5) 方法论新颖性同样突出:把量化、算子融合、注意力后端、解码器替换的延迟收益与数值影响分开报告,明确『延迟收益不等于视觉质量等价』。
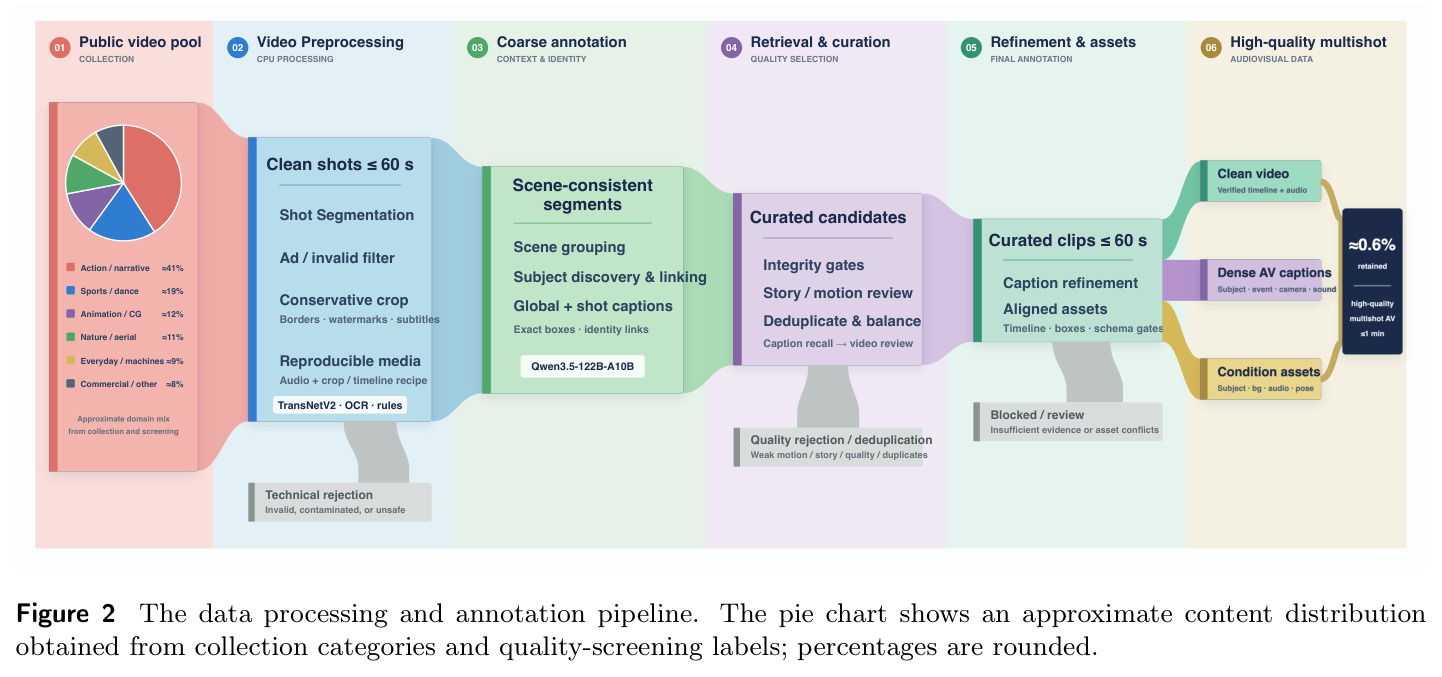
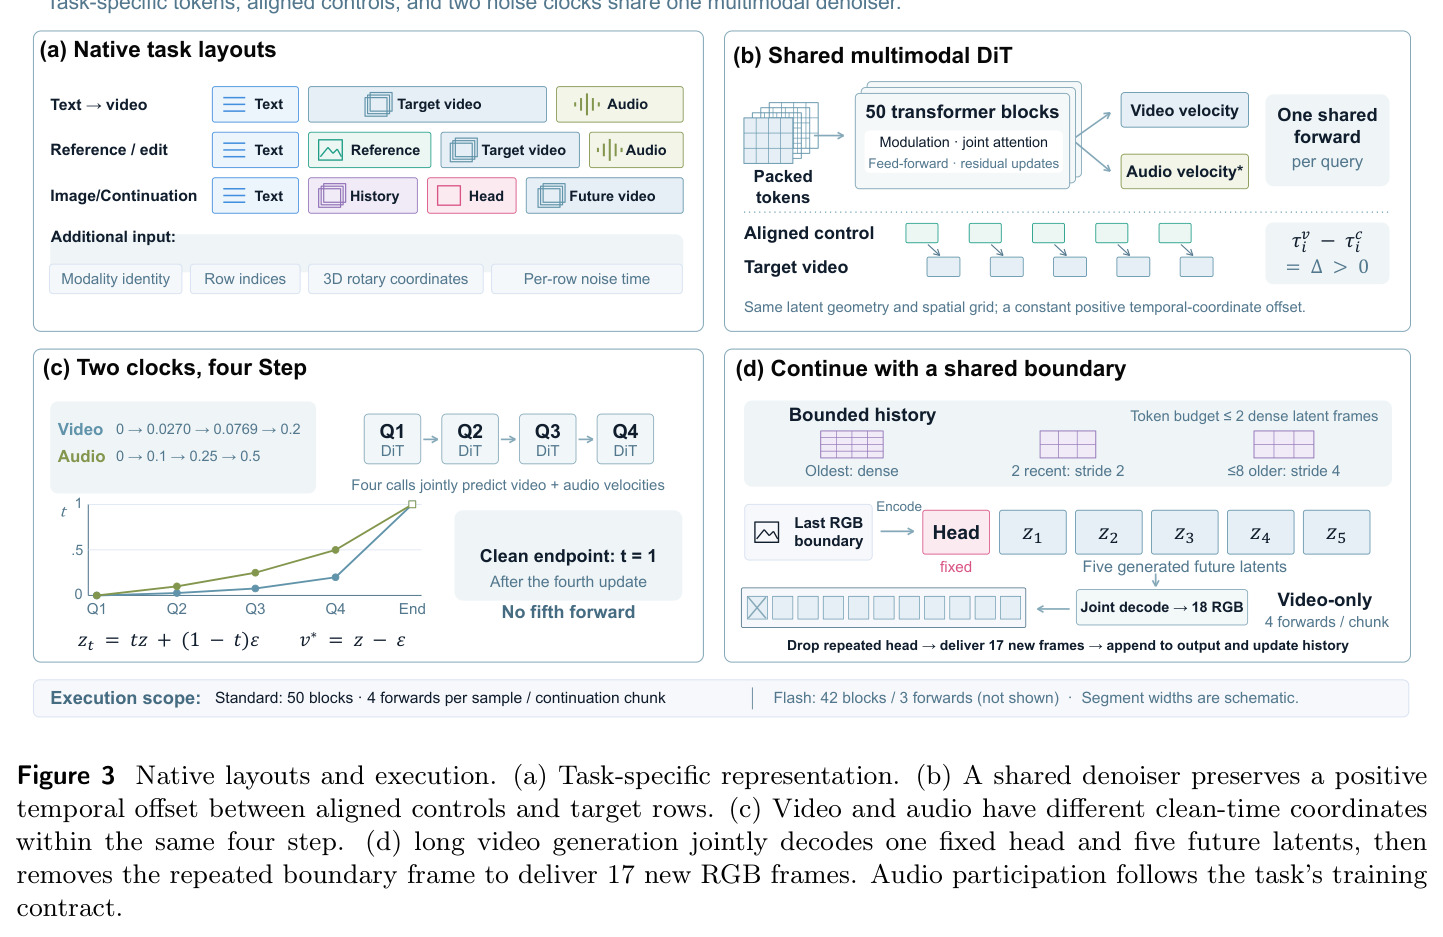
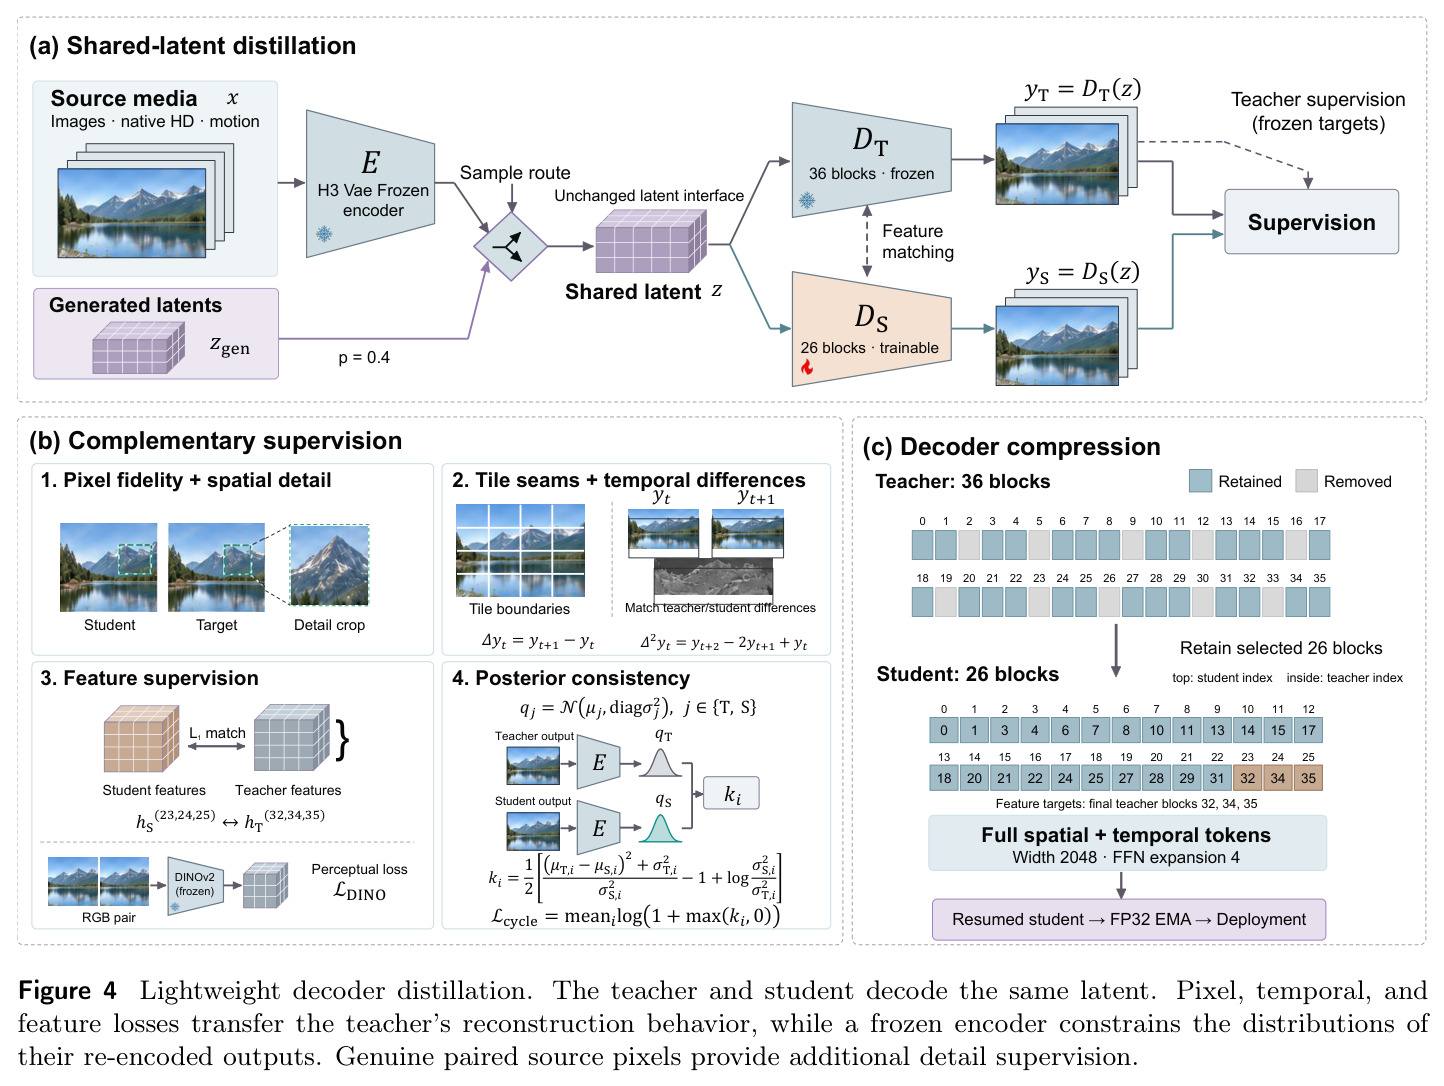
实验结果
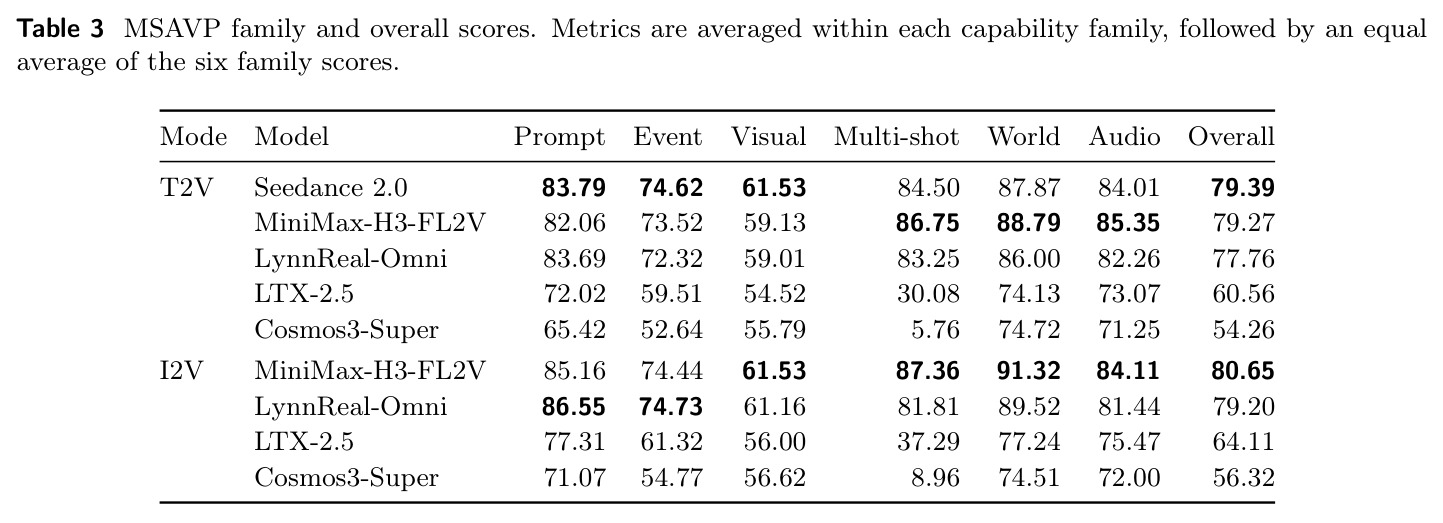
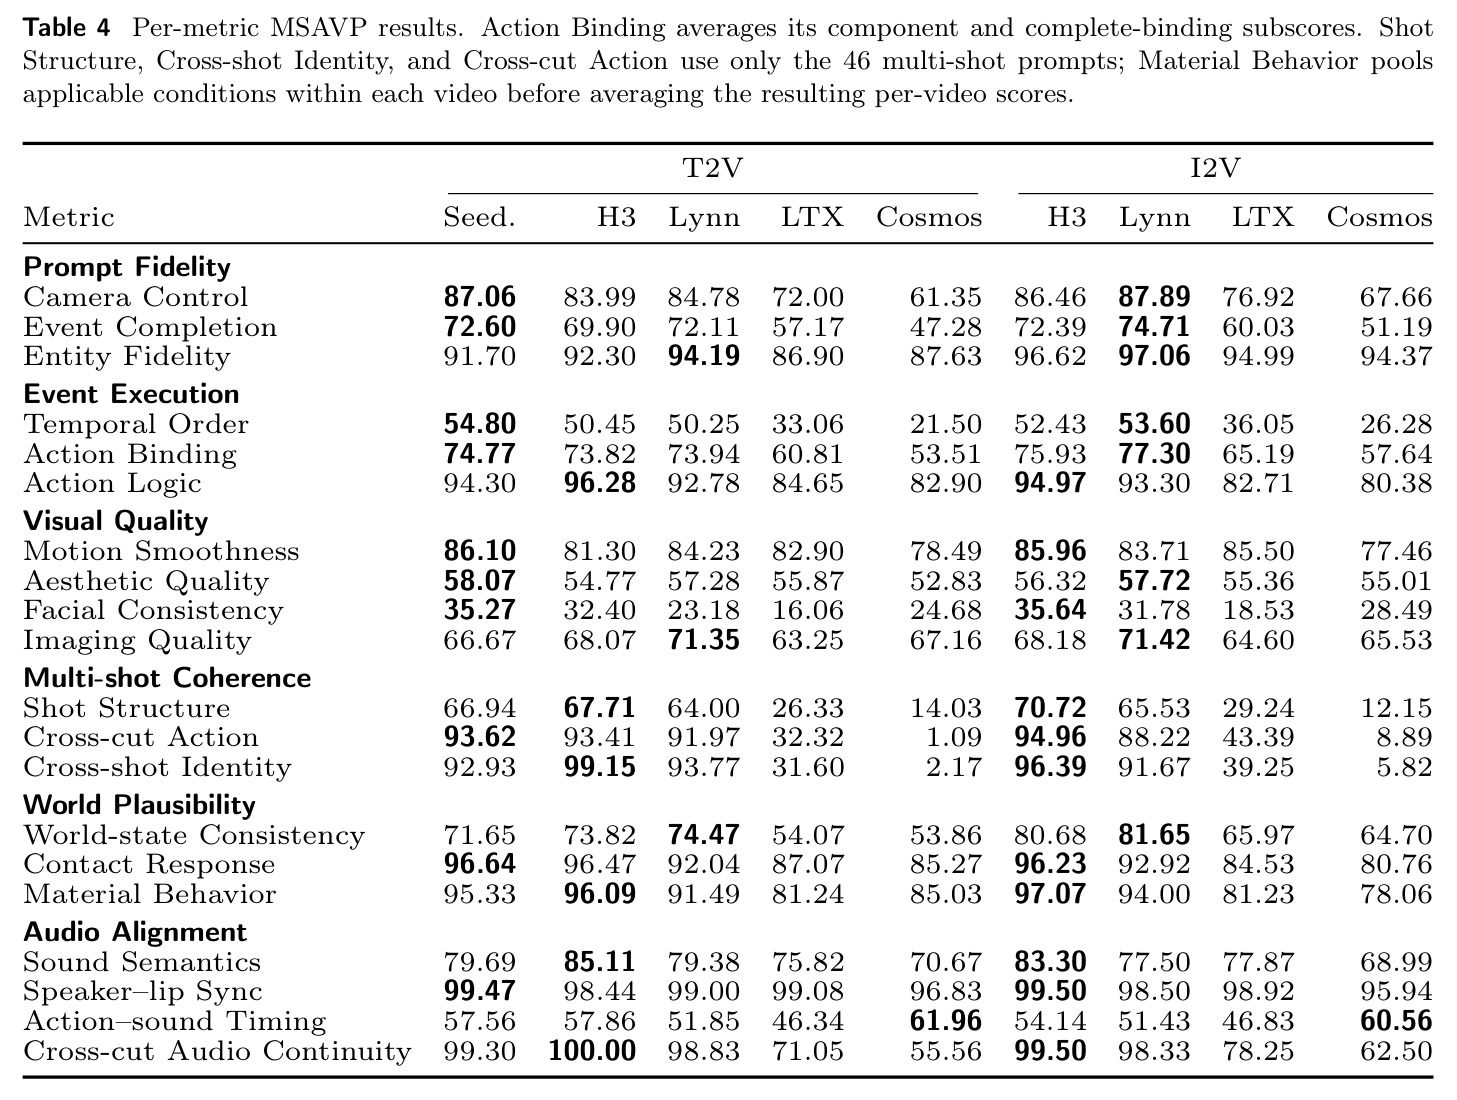
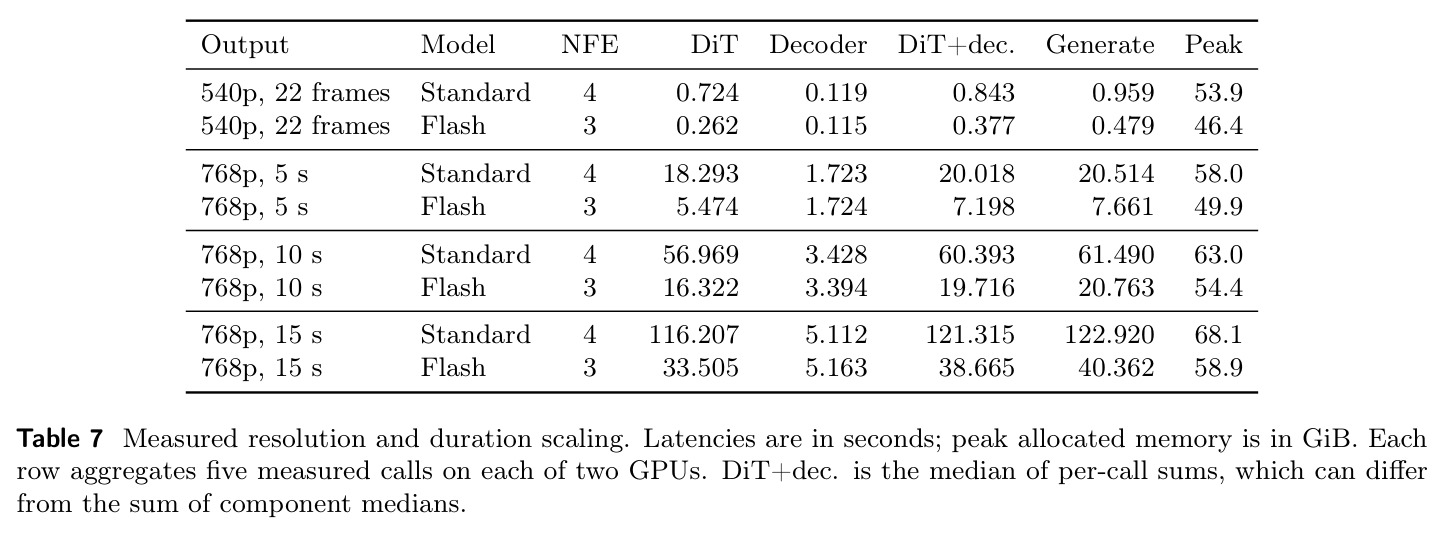
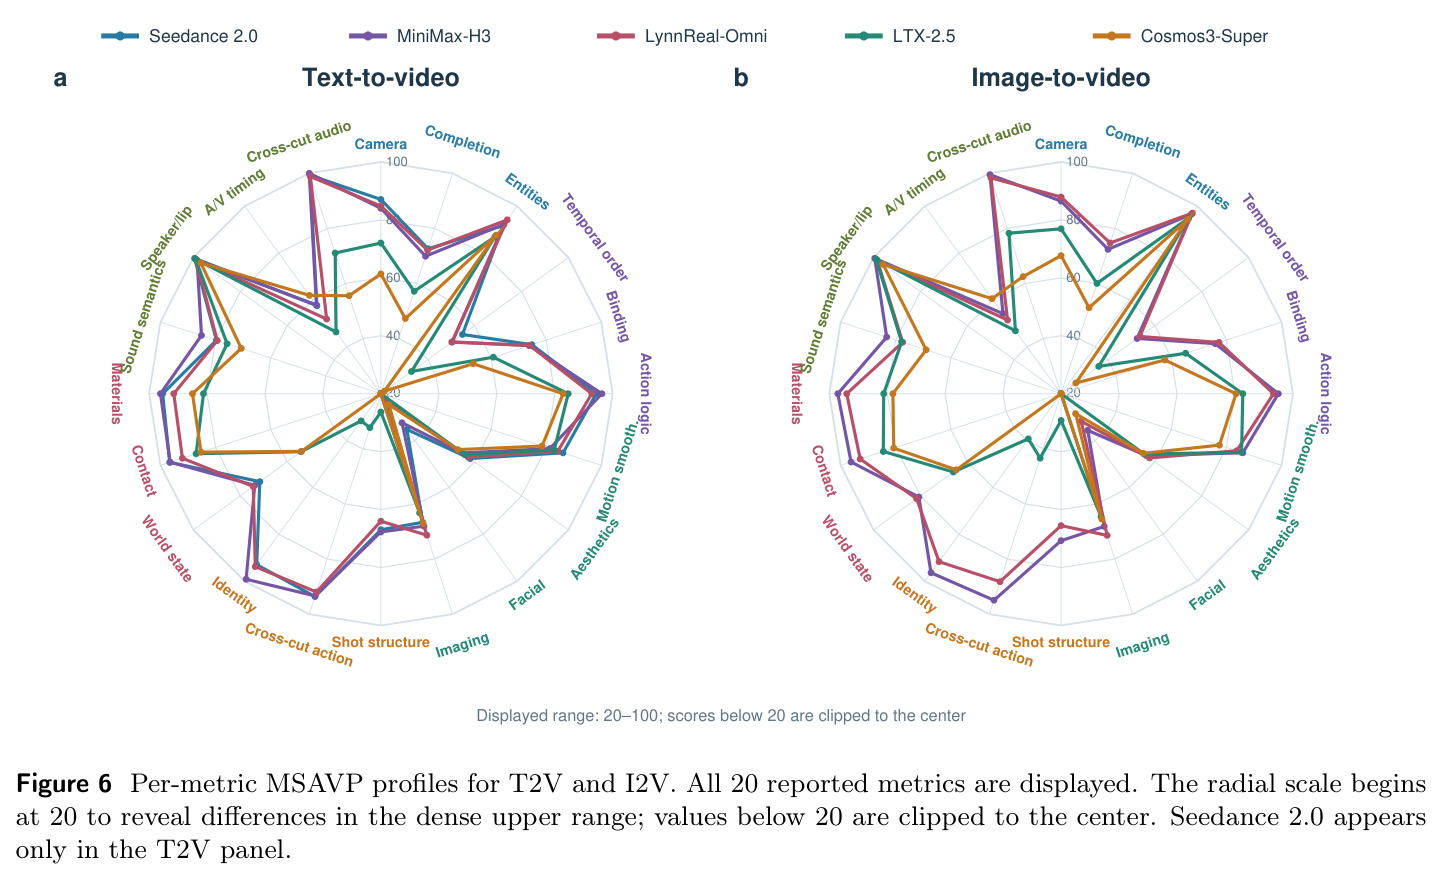
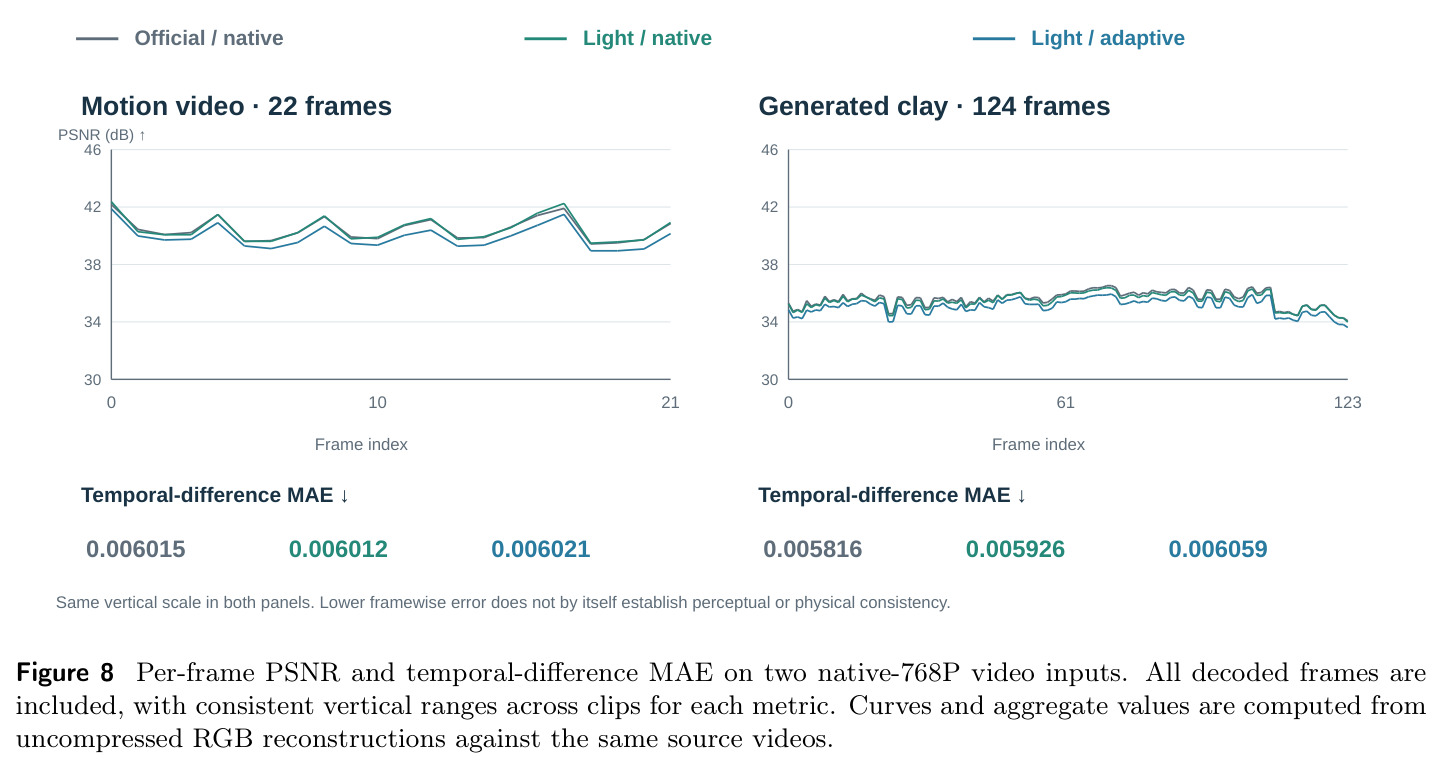
核心发现分三块。MSAVP 评测(100 提示):T2V 总分 Seedance 2.0 最高 79.39,MiniMax-H3 79.27,LynnReal-Omni 77.76(落后 1.63 分),LTX-2.5 60.56、Cosmos3-Super 54.26;I2V 中 H3 80.65 最高、LynnReal-Omni 79.20 次之。它拿下 I2V Prompt Fidelity 第一(86.55)与 Entity Fidelity 双模式最佳(94.19/97.06),实时化未牺牲指令与视觉保真;短板是 T2V 人脸一致性仅 23.18、动作-声音时机 51.85。轻量 VAE 时间差分 MAE 几乎持平官方解码器(运动片段 0.006012 对 0.006015)。延迟(单 H100、540p 22 帧):Standard 共 843ms,Flash 3 次评估仅 377ms;但 768p 15 秒 Standard 需 121.3s、Flash 需 38.7s,实时性只在 540p 成立。长视频续写 720 新帧、43 分块在固定历史预算下内存不随长度增长。
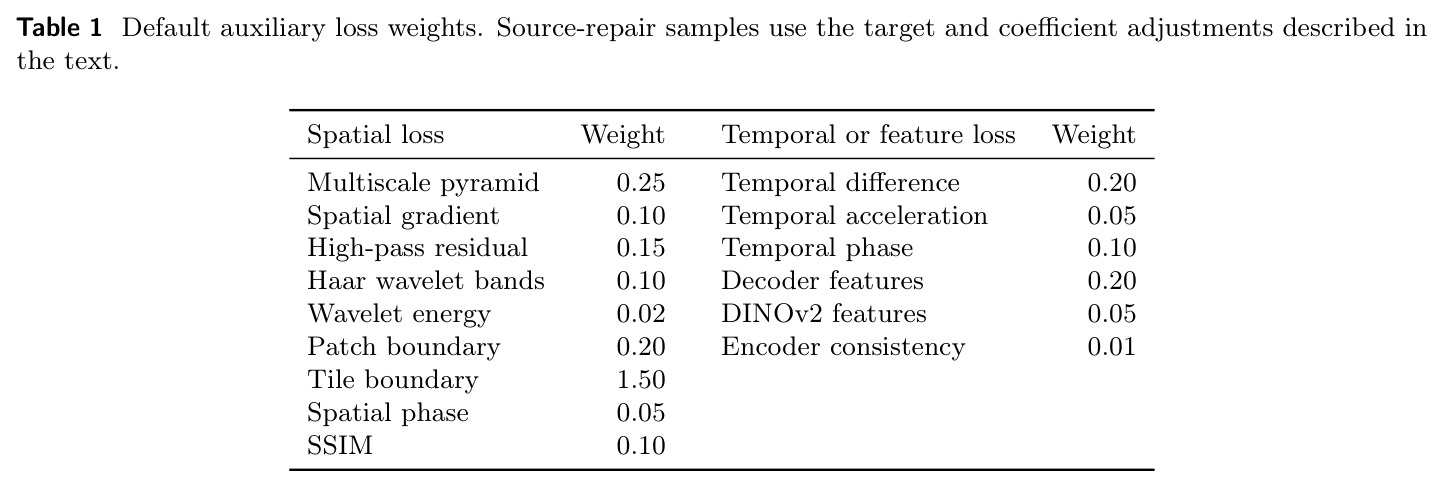
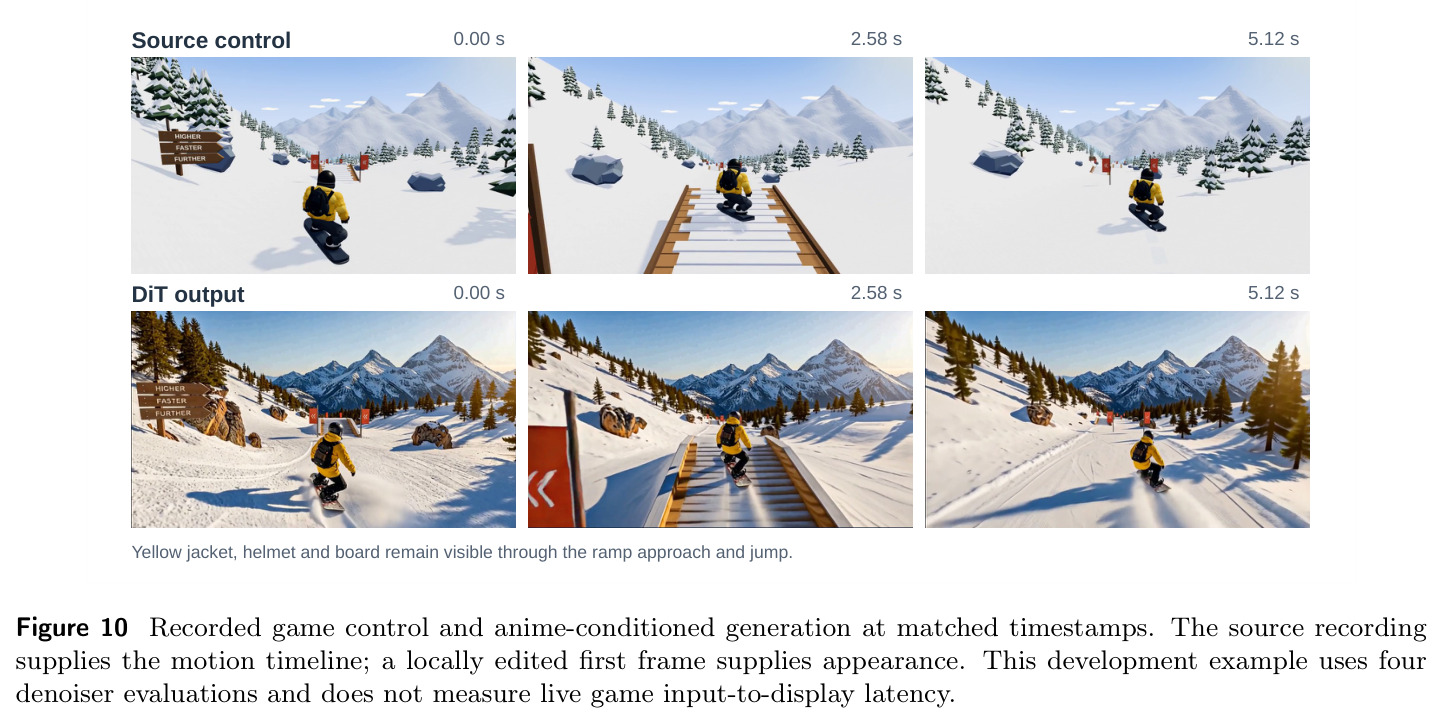
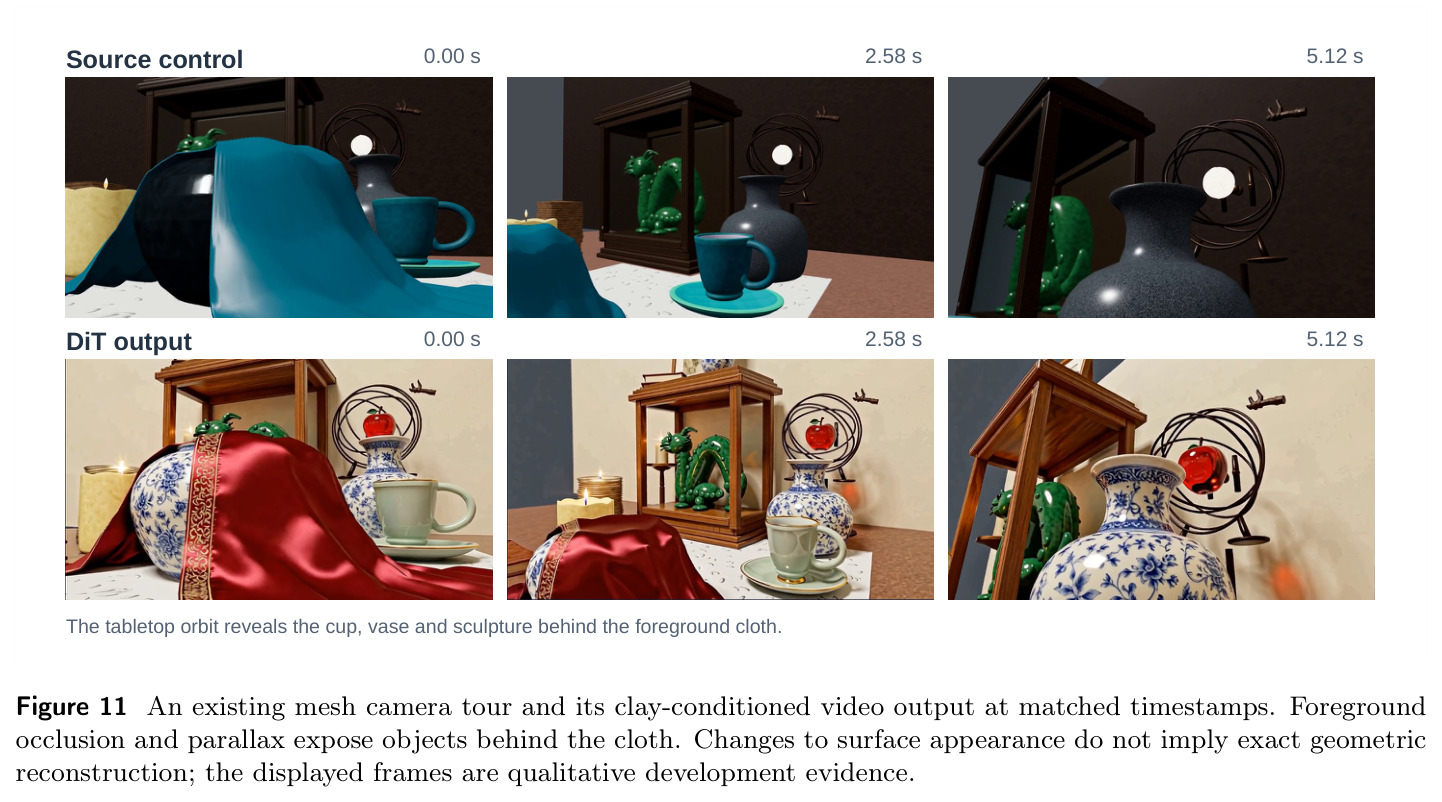
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多镜头音视频生成 T2V(MSAVP,100 提示) | 六族等权总分(0-100) | LynnReal-Omni 77.76 | Seedance 2.0 79.39;LTX-2.5 60.56;Cosmos3-Super 54.26 | 落后最佳 1.63 分,显著领先 LTX-2.5 与 Cosmos3-Super |
| 多镜头音视频生成 I2V(MSAVP) | 六族等权总分 | 79.20 | MiniMax-H3 80.65 | 落后 1.45 分,居第二且在实时设计下取得 |
| I2V 指令遵循 | Prompt Fidelity | 86.55 | MiniMax-H3 85.16;LTX-2.5 77.31;Cosmos3-Super 71.07 | +1.39 分,全场最佳 |
| 实体保真 | Entity Fidelity(I2V) | 97.06 | MiniMax-H3 96.62 | 全场最佳(T2V 94.19 亦最佳) |
| 540p 22 帧温热推理(单 H100) | DiT+解码耗时 | Flash 377 ms(3 NFE) | Standard 843 ms(4 NFE);未加速基线 2345 ms | 相对未加速基线约 2.8 倍,Flash 相对 Standard 2.2 倍 |
| 768p 15 秒视频生成 | DiT+解码耗时 | Flash 38.7 s | Standard 121.3 s | 约 3.1 倍加速,但均非实时 |
| 轻量解码器重建(运动片段) | 时间差分 MAE(越低越好) | 0.006012(原生瓦片) | 官方 36 块解码器 0.006015 | 持平(略优);黏土片段 0.005926 vs 0.005816 略差 |
| 人脸一致性 | Facial Consistency(T2V) | 23.18 | Seedance 2.0 35.27;MiniMax-H3 32.40 | 落后 12.09 分,为明显短板 |
局限与改进
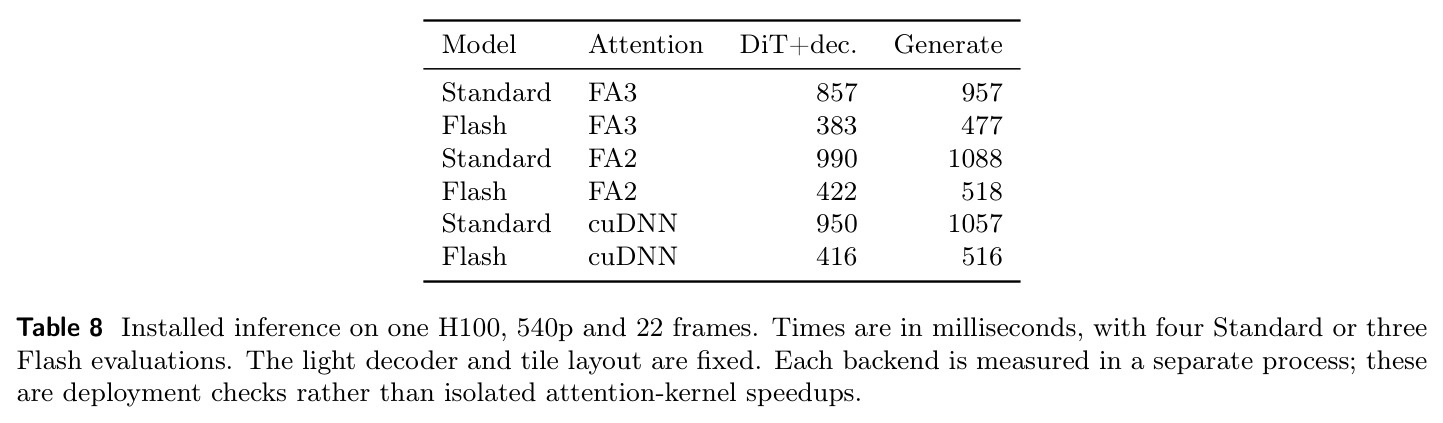
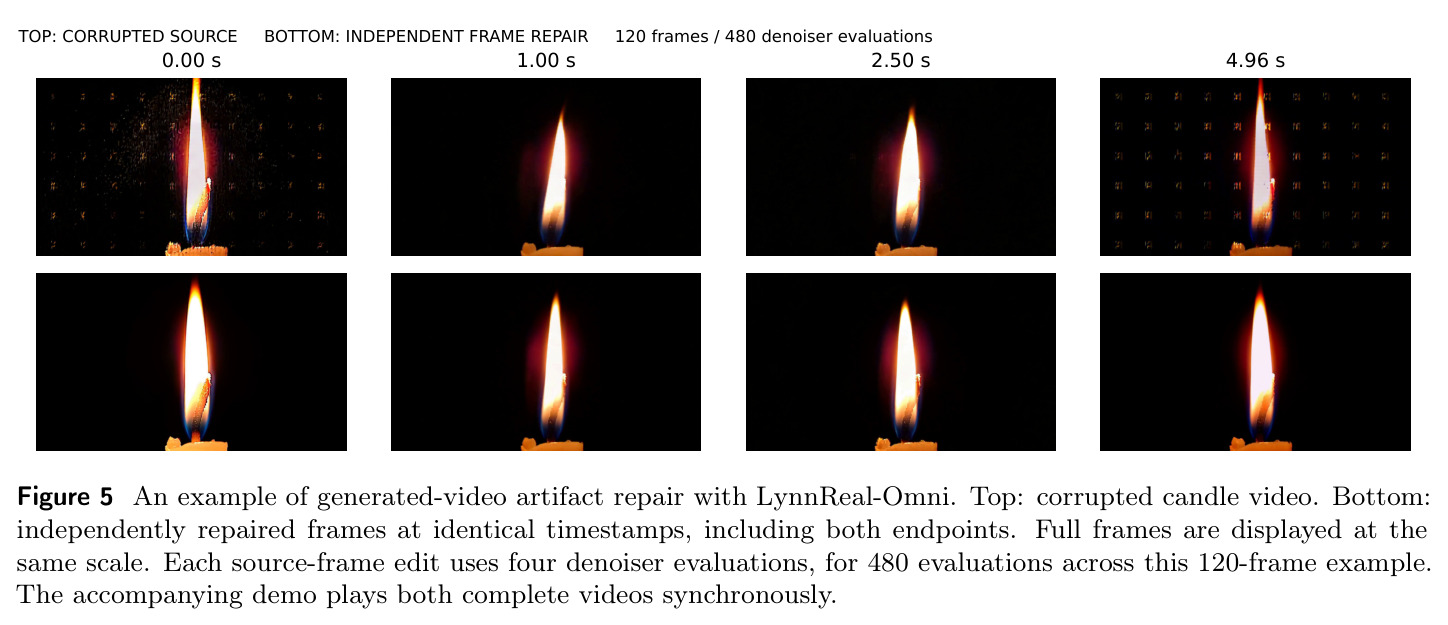
作者明确承认的限制:温热 540p 的加速数据不能外推为原生 768p 的实时性(768p 15 秒 Flash 仍需 38.7 秒),也不能证明达到 live 交互延迟;逐帧修复保留帧序与播放时序,但每帧编辑相互独立、无显式跨帧一致性约束,120 帧蜡烛示例只是无真值的定性证据,不证明像素级恢复或跨场景修复质量;合理的图像编辑不等于修复了视频物理;MSAVP 的独立跨模型评分、评委与人类判断的一致性尚未完成。我自己的观察:其一,自动评委用 GPT-6 Astra 构建清单并打分,而本文模型参赛,存在同源自评的潜在偏置;其二,人脸一致性(T2V 23.18)与动作-声音时机(51.85)显著落后,对以持续角色为核心的智能体工作流是硬伤;其三,多镜头身份保持不敌 MiniMax-H3(T2V Cross-shot Identity 93.77 vs 99.15);其四,数据管线虽保留约 0.6% 高质量数据,但论文未给出最终语料规模、训练算力与训练时长,难以评估数据规模。其五,实时性声明严格依赖 FA3、INT8 GEMM 与编译调优的部署栈,跨后端无逐位等价保证。
独立分析的弱点
独立弱点分析:(1) 角色保真不足——Facial-100 仅 23.18,智能体创作常以持续出现的角色为核心,跨镜头人脸漂移会直接破坏工作流可用性,可引入人脸专用奖励模型、身份保持微调或跨镜头身份注意力约束;(2) 音画时机弱——动作-声音时机 51.85,且蒸馏中奖励模型不感知音频(音频项只拿固定权重),容易『看到动作就有声』,可训练音频感知奖励或对比式音画对齐头,并在 MSAVP 中加大时机类指标权重;(3) 768p 长视频仍是离线速度——15 秒 38.7 秒生成,游戏控制示例(Figure 10)也只测了离线渲染而未测输入到显示延迟,需要流式分块、因果生成或投机解码类方案才能支撑交互;(4) 逐帧修复成本高且无跨帧约束——120 帧需 480 次去噪评估,亮度与火焰形状仍有波动,可改为带时间一致性的视频到视频修复或滑窗关键帧传播;(5) 评测闭环依赖 GPT-6 Astra,成本高、可复现性弱,应公开清单生成与评委提示,并补充人工评分一致性实验;(6) 多镜头身份与结构分(Shot Structure 64.00)低于竞品,边界帧重叠机制在镜头切换场景下的表现值得专项改进。
未来方向
作者提出的后续方向:完成独立的跨模型 MSAVP 评分,测量自动评委与人类判断的一致性;测试带记录动作-显示时序的更长交互轨迹;改进强风格迁移下的时间稳定性与物理接触保持——这是让快速视频生成器成为可控视觉渲染器的两大核心挑战。基于其成果可自然延伸的方向:把 MSAVP 协议推广为社区标准并纳入更多物理与音频指标;把智能体 3D 场景/游戏控制闭环做成标准 agent 工具链,实现『场景构建-渲染-视频生成-回看-修改』的全自动迭代;训练音频感知的奖励与蒸馏目标以修复音画时机;将 Flash 的 token 压缩与 W4A8 量化思路推广到更高分辨率的流式生成;探索有界历史机制支持任意长度续写时的世界记忆与遗忘策略;以及把解码器蒸馏中『教师监督+冻结编码器后验一致性』的配方迁移到音频编解码器加速。
复现评估
复现评估:代码与模型部分开源——GitHub 仓库 LynnReal-AI/LynnReal-Omni,HuggingFace 提供 Flash beta-0.1、Standard beta-0.1 与 light-vae 权重(均 beta 版),并有 YouTube 演示;骨干基于 MiniMax-H3 构建,需遵守其许可证。数据流水线每步(TransNetV2、PP-OCR、Qwen3.5-122B-A10B、Detectron2/ViTDet、MOSS-Transcribe-Diarize 0.9B、Big-LaMA)的工具与参数描述完备,原则上可重建,但最终训练语料未发布且依赖多个大模型,重建成本极高。评测依赖 GPT-6 Astra(经 Codex)做清单构建与打分,属专有付费 API,清单与评委提示未完全公开;基线对比需 1-4 张 H100 80GB。延迟复现要求 FA3、Triton INT8 GEMM、W4A8 量化与编译调优的特定部署栈,首次编译耗时另计。总体:推理复现难度中等(权重公开、配置完整),训练与数据全流程复现困难。
论文图表
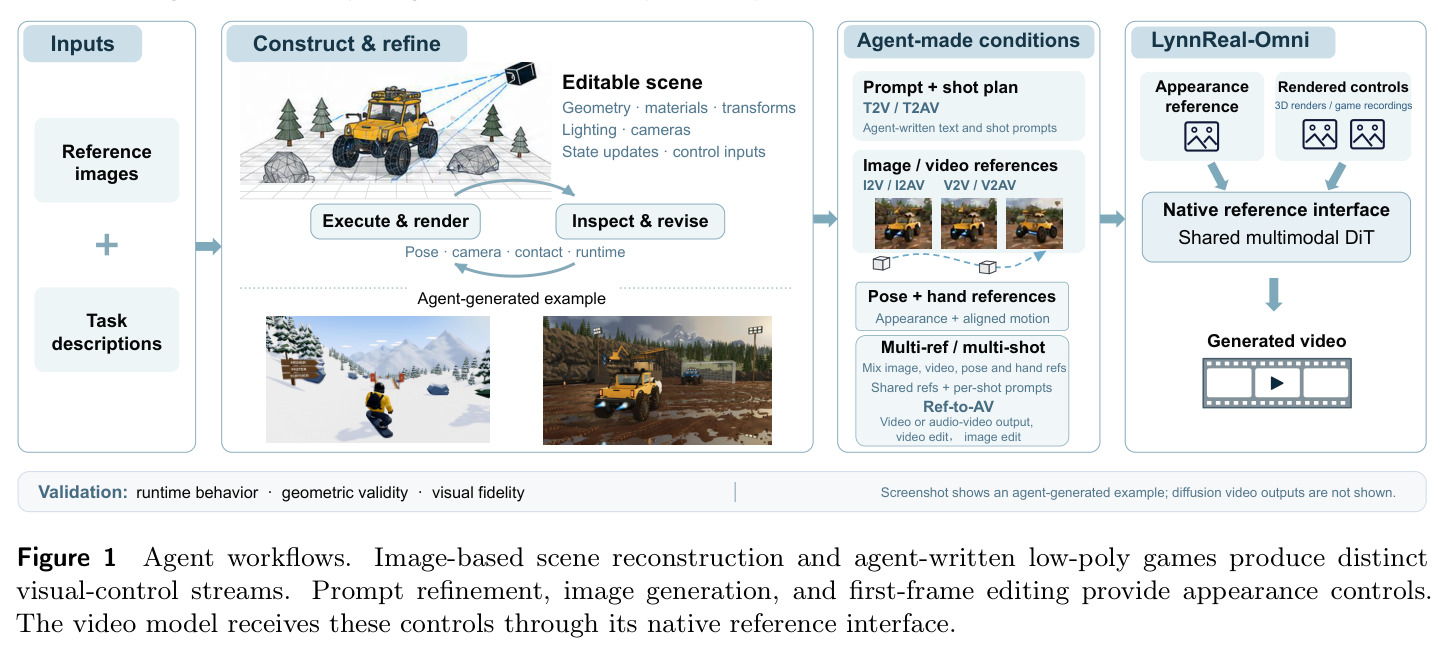
展示智能体视觉创作与 LynnReal-Omni 的整体工作流:参考图像与任务描述经过『构建与精修』得到可编辑场景(几何、材质、变换、灯光、相机、状态更新与控制输入),执行与渲染产出 3D 渲染或游戏录像;提示词精修、图像生成与首帧编辑提供外观控制;最终视频模型通过原生参考接口接收这些异构控制,输出视频或音视频。
这是全文的定位图:解释了为什么需要统一多模态模型——智能体产出的多种控制流(渲染、录像、参考图、姿态)都必须被同一个模型原生消化,其余章节都是这张图各环节的落地。