无损投机解码的数值精度边界:Orthrus 独立复现研究 How Lossless Is Lossless Speculative Decoding? The Role of Numerical Precision in Orthrus
投机解码的“无损”取决于精度:BF16 仅45%轨迹一致,FP32 则完全一致。
前置知识
投机解码
投机解码是一类加速自回归大模型推理的技术:由草稿机制一次提出多个候选 token,再由目标大模型用一次前向并行验证,接受的部分直接采纳,被拒绝的部分回退重新生成。与逐 token 串行解码相比,每次前向可以确认多个 token,从而在保持输出分布的前提下减少前向次数。Orthrus 属于其中用模型内部共识做验证的一支。
Orthrus 就是一种投机解码方案,本文检验的正是它“严格无损”这一核心声明,理解其提出-验证机制是读懂全文的前提。
贪心解码与生成轨迹
贪心解码指每一步都选概率最大的 token(argmax),不引入随机采样,因此给定 prompt 后输出完全确定。本文的解码配置为 do_sample=False、temperature=0.0、max_new_tokens=128。所谓轨迹就是模型对一条 prompt 贪心生成的完整 token 序列,两条轨迹可以逐 token 比较是否恒等。
只有确定性解码才能定义“轨迹精确匹配”这一无损判据;若用采样解码,不同序列可能都合法,无法做逐 token 等价比较。
扩散语言模型与并行多 token 预测
扩散语言模型借鉴图像扩散模型的迭代去噪思想,可并行生成一段文本,从而突破自回归逐 token 生成的串行限制。Orthrus 是混合方案:冻结的 AR 骨干负责构建上下文表示,轻量扩散视图并行预测多个未来 token,再由模型内部共识机制用 AR 视图验证提案,作者声称这样能严格保持原模型的预测行为。
理解 Orthrus 的混合架构才能明白加速来源在哪里,以及为什么其原始论文敢于声称共识机制能保证严格无损。
BF16 与 FP32 数值精度
BF16(bfloat16)用 8 位指数、7 位尾数表示浮点数,尾数精度约为 FP32(23 位尾数)的 1/256,是 LLM 推理最常用的半精度格式。不同精度下矩阵乘法等运算的舍入误差不同:连续激活值上的微小差异通常无害,但经 argmax 离散化后可能在决策边界处翻转被选中的 token,并使后续轨迹整体偏离。
本文的核心结论就是“无损性取决于精度”:BF16 下约 55% 轨迹发散,FP32 下 100% 匹配,不理解精度差异就无法理解这一反差。
响应条件困惑度(PPL)
困惑度衡量模型对一段文本的预测难度,定义为平均负对数似然的指数:$\mathrm{PPL}(y|x)=\exp\left(-\frac{1}{|y|}\sum_{t=1}^{|y|}\log p(y_t|x,y_{<t})\right)$。响应条件版本指用参考模型在给定 prompt 下评估生成响应,数值越低说明该响应越符合参考模型自身的分布偏好。
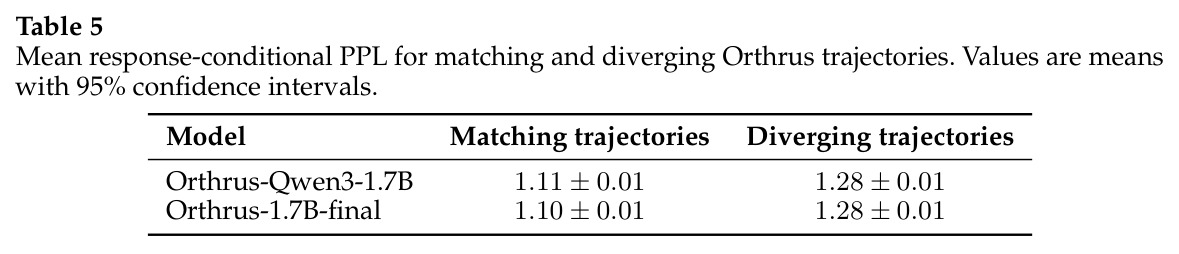
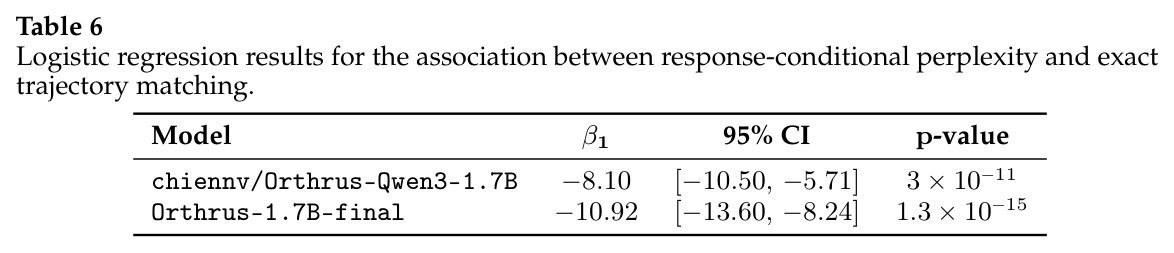
论文用逻辑回归发现发散轨迹的 PPL 显著更高(1.28 对 1.11),这是理解“哪些序列容易发散”这一关键结果的基础。
lm-eval-harness 基准评测
lm-eval-harness 是 EleutherAI 维护的标准 LLM 评测框架,统一实现了几十个基准的数据加载、提示构造与指标计算。本文使用其中 GSM8K(数学应用题,exact match)、HumanEval(代码生成,pass@1)、IFEval(指令遵循,prompt-level loose/strict accuracy)三个基准来度量任务级性能。
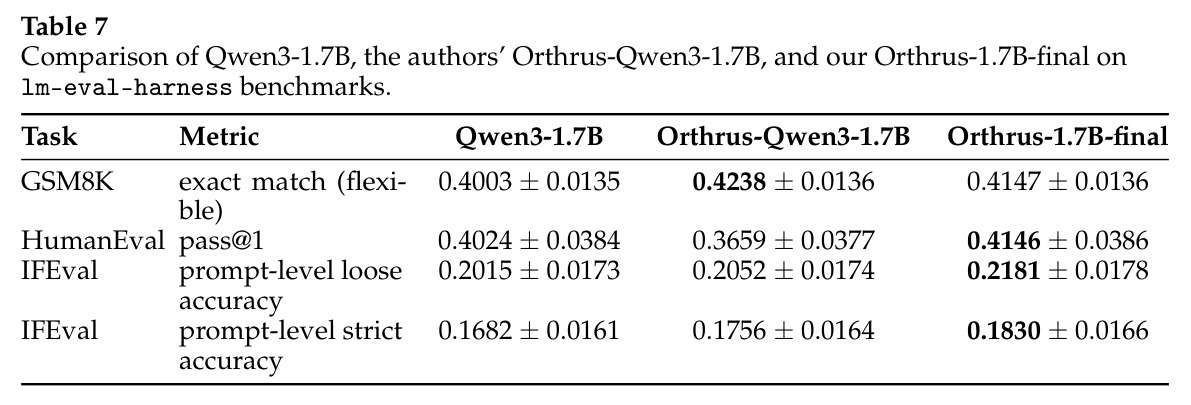
论文用它验证“轨迹发散但任务无退化”这一解耦现象,了解这些基准的指标含义才能正确解读 Table 7 的分数。
研究动机
自回归(AR)语言模型的解码是严格串行的:生成 N 个 token 需要执行 N 次前向并反复读写不断增长的 KV cache,随模型和上下文规模增大,推理成本成为瓶颈。Orthrus(Nguyen et al., 2026)用冻结的 AR 骨干加一个轻量扩散视图并行预测多个未来 token,再由共识机制筛选,据称在大幅加速的同时“严格无损”——输出序列与原 AR 模型逐 token 完全一致。这一强声明在算法层面依赖理想化的算术模型,而真实推理使用 BF16 等有限精度浮点运算和有状态的 KV cache:连续值上微小的舍入差异一旦让某步 argmax 翻转,离散生成就会把误差放大为整条轨迹的发散。因此“无损”在实践中究竟是否成立,此前缺乏直接的序列级实证检验。
本文的目标是本文的目标是对 Orthrus 的无损性声明做一次独立的、可操作的实证审计,具体包含三件事。其一,独立实现 Orthrus 的架构与训练流程,构建可配置的训练框架,既评估作者发布的 chiennv/Orthrus-Qwen3-1.7B checkpoint,也用不同数据与超参训练自己的 Orthrus-1.7B-final,以排除结论依赖特定训练设置的可能。其二,在 12 个领域共 1,190 条提示上,以贪心解码直接比较 Orthrus 与冻结 Qwen3-1.7B 的生成轨迹,统计序列精确匹配率和 Tokens Per Forward。其三,把数值精度作为受控变量,在 BF16 与 FP32 下重复同一轨迹评测,并用逻辑回归分析发散与响应条件困惑度 $PPL(y|x)$ 的关联,同时在 GSM8K、HumanEval、IFEval 上检查任务级性能是否受损。
与已有工作不同的是,已有研究(Yuan et al., 2025)表明浮点精度和硬件配置会改变 LLM 在贪心解码下的输出,但那关注的是“同一模型在不同推理配置下能否复现自身”。本文的切入角度不同:问的不是模型是否可复现,而是加速模型能否逐 token 复现其 AR 参考模型——这正是“无损投机解码”声明应有的操作定义。此外作者发现训练数据分布是被忽视的因素:扩散视图在 teacher forcing 下训练,若用人类写的通用文本训练,并不能覆盖 AR 模型自身生成时遇到的状态分布,因此他们改用冻结 AR 模型贪心解码产生的 teacher 蒸馏语料,让训练数据跟随模型自身的预测轨迹。“轨迹级无损判据 + 数值精度受控消融”的组合审计在既有投机解码文献中是缺位的,这构成了本文的独特贡献点。
核心方法
本文不提出新模型,而是一套严谨的评测方法论。整体流程是:先独立实现并训练一个 Orthrus 变体作为对照,与作者发布的 chiennv/Orthrus-Qwen3-1.7B checkpoint 并列评估;然后在固定解码配置(贪心解码、do_sample=False、temperature=0.0、max_new_tokens=128、eager attention、单张 RTX 3090)下,让两个 Orthrus 变体与冻结的 Qwen3-1.7B 参考模型对同一批提示各生成一条轨迹,逐条比较 token 序列是否完全一致,得到序列匹配率与 TPF(Tokens Per Forward,每次前向平均确认的 token 数)。随后以精确匹配为因变量、$\log \mathrm{PPL}(y|x)$、响应长度和领域为自变量做逻辑回归,检验发散是否系统性偏向高困惑度响应;再用 lm-eval-harness 跑 GSM8K、HumanEval、IFEval 检查任务级性能;最后只把精度从 BF16 换成 FP32、其余一切不变,重复整个轨迹评测,形成一次干净的精度消融。
核心思想是把“无损”从口头声明变成可操作、可测量的判据:在贪心解码下,无损意味着加速系统的输出序列必须与 AR 参考模型逐 token 恒等,即轨迹精确匹配率等于 1。本文有两个关键洞察。第一,离散生成会把微小浮点误差放大成质变:连续激活值上 $10^{-3}$ 量级的差异通常无害,但一旦某步 argmax 在决策边界附近翻转,后续整条轨迹都会偏离参考路径,因此“数值上近似”不等于“输出上等价”。第二,无损性与任务性能是正交的两个维度——两条不同的轨迹可以在基准上得到统计上不可区分的分数,甚至因偶然偏向标准答案而略高,所以任务分数相等不能证明推理等价,序列级评测必须单独做。FP32 下 1,190 条轨迹全部精确匹配的实验,正是利用这一判据把发散干净地归因于有限精度算术,而非共识机制本身失效。
方法步骤详情
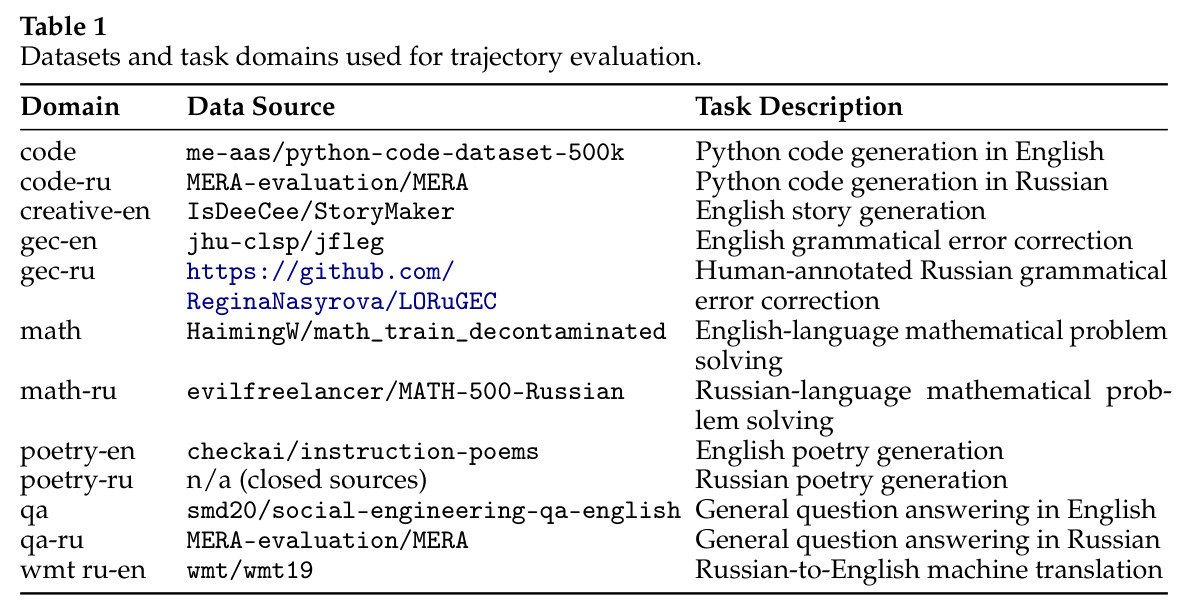
第一步,蒸馏数据:从公开数据集取 prompt,仅保留 50–1000 字符的提示,用冻结的 Qwen3-1.7B 贪心解码生成响应,得到 4,113,358 条样本,使训练分布贴合模型自身生成轨迹。第二步,独立训练 Orthrus-1.7B-final:8 张 H100,1 个 epoch,学习率 $2\times10^{-4}$,batch size 10,block size 8、32 个 block,最大序列长度 3072。第三步,搭建评测集:12 个领域各 100 条提示。第四步,轨迹评测:BF16 + eager attention,贪心解码 max_new_tokens=128,在 RTX 3090 上逐条比对各模型生成序列,计算精确匹配率与 TPF 及 95% 置信区间。第五步,统计分析:计算响应条件困惑度 $\mathrm{PPL}(y|x)$,拟合含 $\log\mathrm{PPL}$、长度与领域效应的逻辑回归。第六步,用 lm-eval-harness 评测 GSM8K/HumanEval/IFEval。第七步,仅把精度换成 FP32,重复全部轨迹评测。
技术新颖性
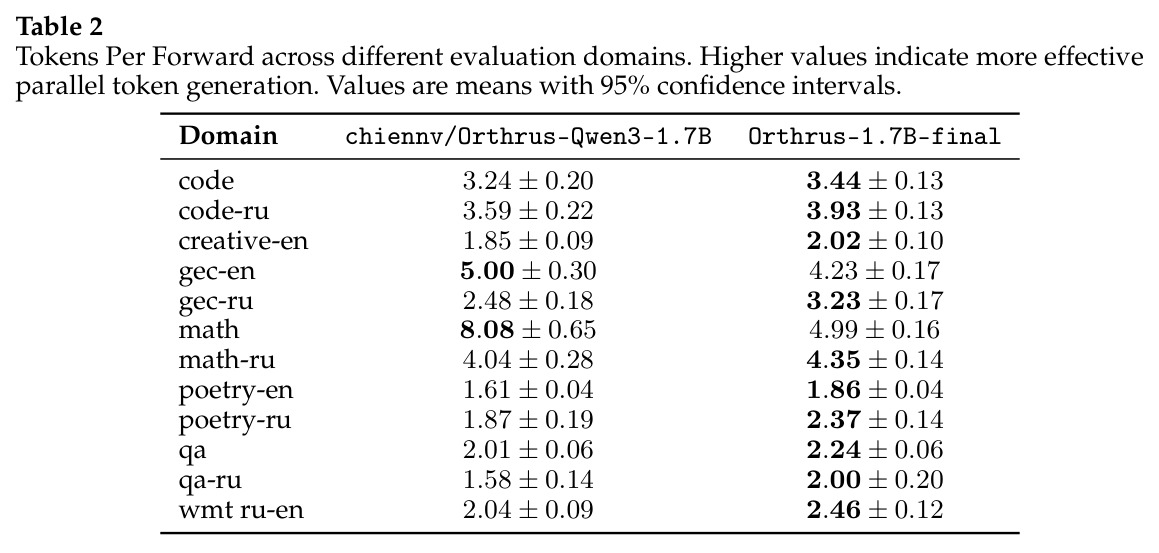
技术新颖性有三点。其一,首次对一个具体的“无损加速”声明做精度受控的序列级审计,并得出“操作等价判据与数值精度必须同时报告”的方法论结论,这与只看下游分数的传统评测方式有本质区别。其二,训练侧的 teacher 生成蒸馏:用冻结 AR 模型自身的贪心输出而非人类文本做监督,使扩散视图的训练分布对齐推理时的 on-policy 状态,自训模型在 12 个领域中的 10 个 TPF 超过官方 checkpoint(如 gec-ru 3.23 对 2.48、poetry-ru 2.37 对 1.87),说明数据分布是并行解码效率的关键杠杆,这是对 Orthrus 训练方法的实质性改进而非简单复刻。其三,用逻辑回归把“哪些轨迹会发散”与参考模型的困惑度定量联系起来,揭示出发散并非均匀随机,而是系统性地集中在高 $\mathrm{PPL}(y|x)$ 的响应上($p<10^{-10}$ 量级的强关联),为理解精度敏感现象提供了统计学刻画。
实验结果
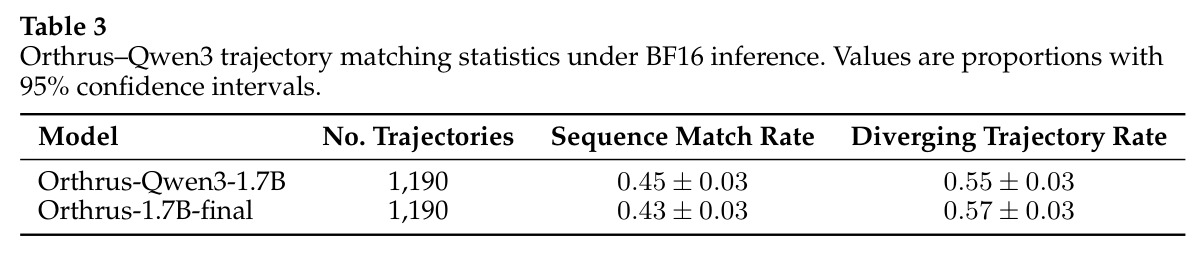
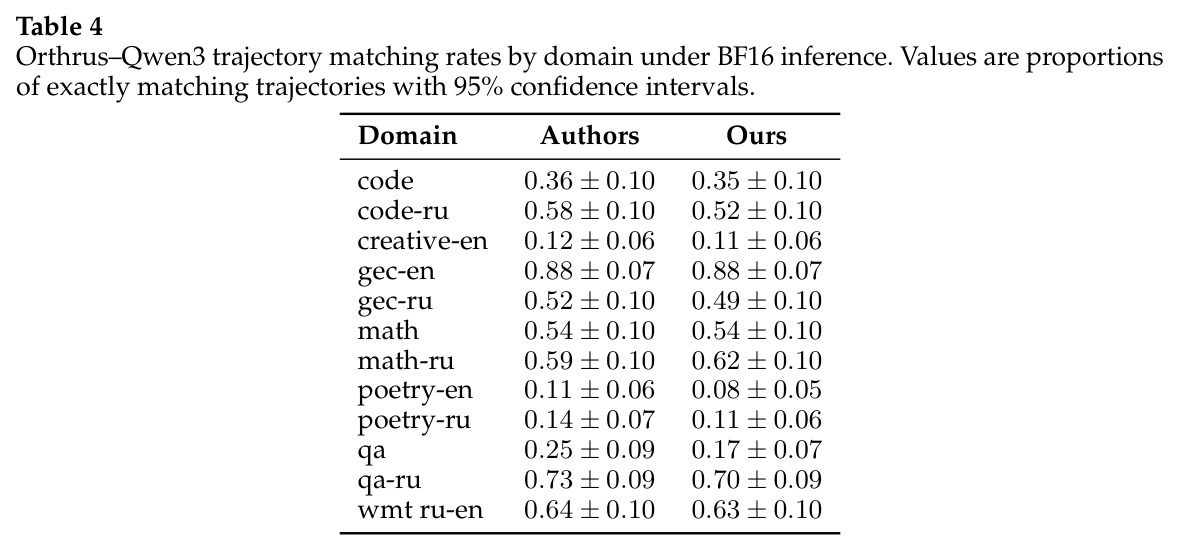
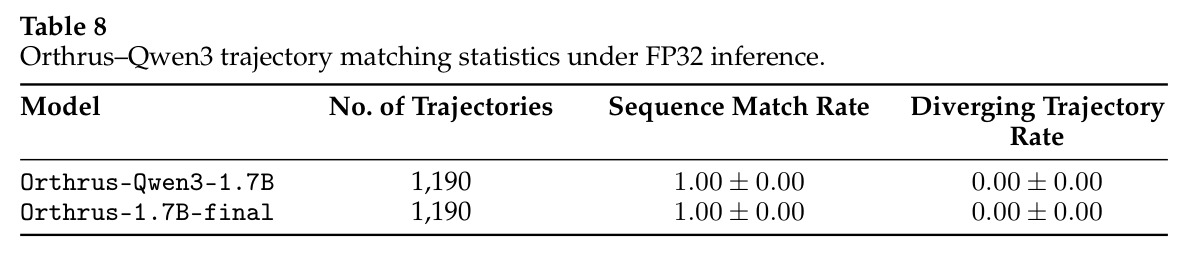
核心发现有四条。(1)BF16 下无损声明不成立:作者 checkpoint 的序列精确匹配率仅 0.45±0.03,自训模型 0.43±0.03,即 55%–57% 轨迹存在分歧;分领域 gec-en 最高(0.88),creative-en(0.12/0.11)、poetry-en(0.11/0.08)最低。(2)发散与困惑度强相关:匹配轨迹平均 $\mathrm{PPL}(y|x)$ 为 1.11/1.10,发散轨迹升至 1.28/1.28;控制长度与领域后 $\beta_1=-8.10$($p=3\times10^{-11}$)与 $\beta_1=-10.92$($p<10^{-14}$),困惑度越高越难被精确复现。(3)任务级无退化:GSM8K 基线 0.4003 对 0.4238/0.4147;HumanEval 0.4024 对 0.3659/0.4146;IFEval strict 0.1682 对 0.1756/0.1830,差异均在噪声内甚至略正。(4)FP32 下完全无损:两变体在全部 1,190 条提示上匹配率 1.00±0.00,发散纯源于有限精度算术。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 轨迹匹配(BF16 推理,1,190 条提示) | 序列精确匹配率 | 0.45 ± 0.03(官方 checkpoint)/ 0.43 ± 0.03(自训模型) | “严格无损”声明隐含的 1.00 | 负向发现:55%–57% 轨迹发散,证伪 BF16 下的无损声明 |
| 轨迹匹配(FP32 推理,1,190 条提示) | 序列精确匹配率 | 1.00 ± 0.00(两个 Orthrus 变体均全部匹配) | BF16 下为 0.45 / 0.43 | 提升至 100%,将发散归因于有限精度算术 |
| GSM8K(数学推理) | exact match (flexible) | 0.4238 ± 0.0136(官方 Orthrus)/ 0.4147 ± 0.0136(自训) | Qwen3-1.7B 0.4003 ± 0.0135 | 约 +1.4–2.4 个百分点,在噪声范围内,无退化 |
| HumanEval(代码生成) | pass@1 | 0.4146 ± 0.0386(自训 Orthrus) | Qwen3-1.7B 0.4024 ± 0.0384 | 约 +1.2 个百分点(官方 Orthrus 反而降至 0.3659) |
| IFEval(指令遵循) | prompt-level strict accuracy | 0.1830 ± 0.0166(自训 Orthrus) | Qwen3-1.7B 0.1682 ± 0.0161 | 约 +1.5 个百分点,轨迹发散未带来任务退化 |
| 并行解码效率(12 个领域) | Tokens Per Forward(TPF) | 自训模型 10/12 领域更高,如 gec-ru 3.23±0.17 对 2.48±0.18、poetry-ru 2.37±0.14 对 1.87±0.19 | 官方 chiennv/Orthrus-Qwen3-1.7B | teacher 蒸馏数据提升多数领域加速比,但 gec-en(4.23 对 5.00)与 math(4.99 对 8.08)落后 |
局限与改进
作者明确承认的局限:他们只把发散归因于“有限精度数值效应”这一黑箱,没有定位具体是哪些层或哪些算子引入精度敏感的偏差,明确将其留作未来工作。我的补充观察有五点。其一,实验只覆盖 Qwen3-1.7B 单一骨干和两个 Orthrus 变体,结论能否外推到更大模型或其他投机解码方法尚不清楚。其二,只测了贪心解码和 BF16/FP32 两档精度,采样解码、FP16、TF32、KV cache 量化下的表现完全缺失。其三,任务级基准的所有差异都落在 95% 置信区间内,“无退化”严格说只是“未检测到退化”,更严谨应做等价性检验。其四,论文未报告端到端加速比或延迟,TPF 高不完全等于实际推理更快。其五,poetry-ru 域的数据来源封闭,影响该领域的完全复现。
独立分析的弱点
独立分析后我认为还有几个弱点。第一,逻辑回归只建立了困惑度与发散的相关性,无法回答因果方向:是高困惑度 token 本身处于决策边界附近更易被浮点噪声翻转,还是发散导致响应偏离参考分布从而推高了 $\mathrm{PPL}(y|x)$?可通过人为注入 $\pm\epsilon$ 量级扰动的受控实验来区分。第二,论文未测量各层激活值的数值裕度,无法指导工程实践中的量化与精度分配决策。第三,math 领域 TPF 差距巨大(官方 8.08 对自训 4.99)说明领域结构对并行度影响极强,但论文只陈述现象未解释机制。第四,“55% 轨迹发散但任务无退化”是在静态评测下的结论,若发散发生在对分布偏移敏感的场景(如 RLHF rollout、self-distillation 数据生成),同一现象可能造成训练信号污染,这一风险未被讨论。第五,仅评估 1.7B 规模,精度敏感性随模型规模、注意力实现(FlashAttention vs eager)的变化未知。每个弱点都可沿“定位根源—扩展精度档位—测试采样与训练内场景”方向改进。
未来方向
作者提出的方向:定位导致精度敏感偏差的具体计算阶段——哪些层、哪些算子、注意力实现方式是主要误差源;更一般地,为“无损加速”建立标准化评测协议,要求同时报告操作等价判据和测量精度。基于本文成果可延伸的方向包括:把轨迹审计扩展到 EAGLE、Medusa、 lookahead 风格等其它投机解码家族以及 INT8/FP8 量化推理;研究精度与 batch size、序列长度、KV cache 布局的交互;在采样解码下定义统计意义上的“分布级无损”,例如用总变差距离度量提议分布与目标分布的偏差并给出可容忍阈值;把 FP32 全匹配现象理论化——验证是否等价于共识机制在无限精度下重构了与参考模型完全相同的计算图;以及检验发散对下游训练(蒸馏语料、RL rollout)而非仅静态评测的影响。
复现评估
复现难度中等偏低,且分层清晰。推理评测部分门槛很低:被审计的 chiennv/Orthrus-Qwen3-1.7B 公开托管在 HuggingFace,参考模型 Qwen/Qwen3-1.7B 同样开源,单张 24GB 显卡(论文用 RTX 3090 23GB)即可跑完 1,190 条提示的轨迹评测,核心结论不依赖大规模算力。12 个评测域的数据集几乎全部有公开来源(python-code-dataset-500k、jfleg、MERA、MATH-500-Russian、wmt19 等),仅 poetry-ru 标注为闭源。独立训练 Orthrus-1.7B-final 则需要 8 张 H100 和约 411 万条蒸馏样本,一般实验室难以负担,但该部分并非验证主结论所必需。不确定性在于:论文未明确说明评测脚本与训练框架是否开源,复现者可能需要按文中超参数(lr $2\times10^{-4}$、batch 10、block 8×32、seq len 3072、Transformers 5.8.x)自行搭建。
论文图表