PhysBrain 1.5:从视觉语言模型到物理基础模型 PhysBrain 1.5: From Vision-Language Models to Physical Foundation Models
统一具身理解、动作生成与未来状态预测,8B模型以72.5分刷新28项具身基准开源纪录
前置知识
视觉语言模型(VLM)与自回归下一词预测
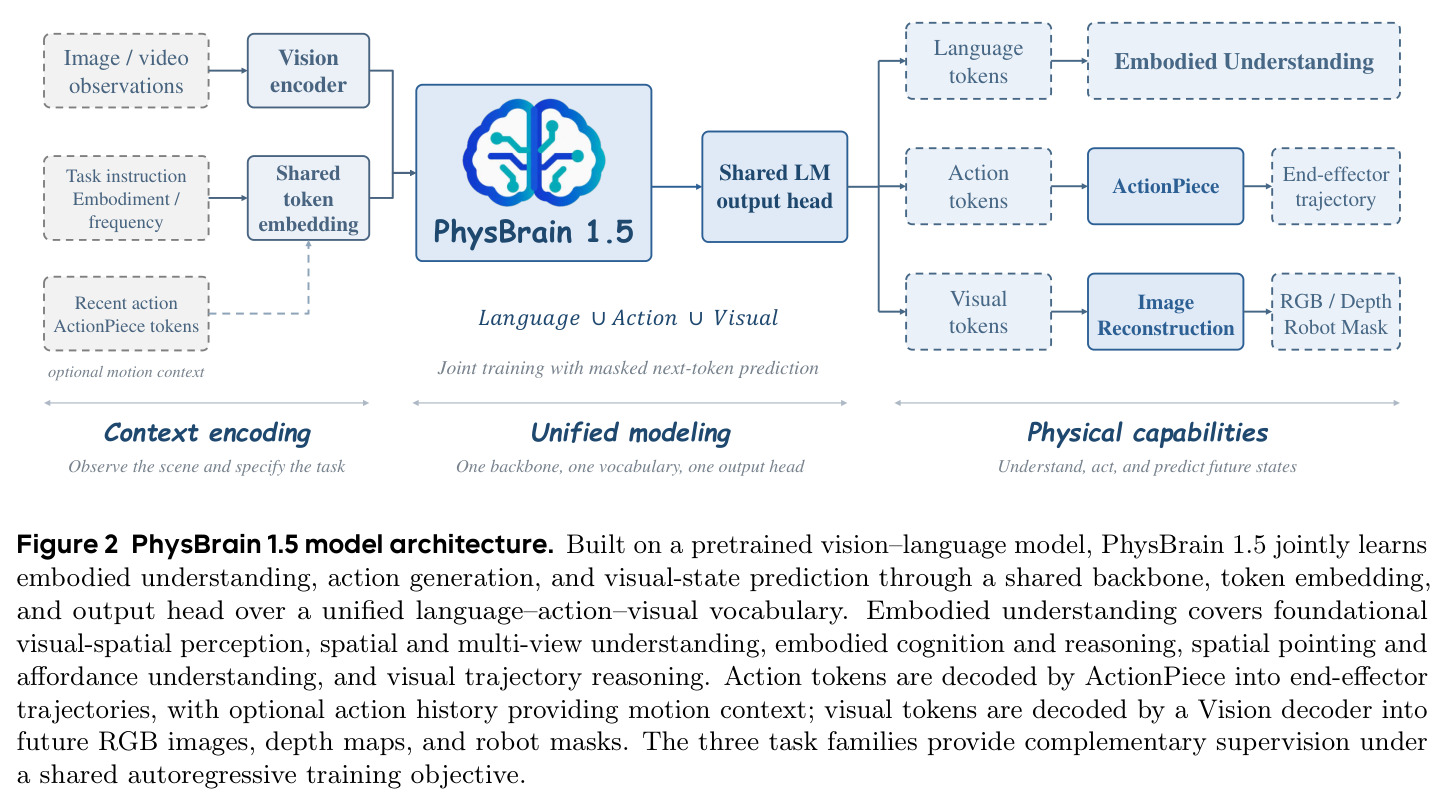
VLM 把图像/视频经视觉编码器转成视觉 token,与文本 token 拼接后送入 Transformer 解码器,按条件概率 $p_\theta(y_i \mid x, y_{<i})$ 逐 token 生成输出。训练目标是下一词预测:最大化序列似然或最小化其负对数。本文以 Qwen3-VL-Instruct (8B) 为基座,语言、动作、未来画面全部被表达为 token 序列,共用同一个 backbone、词嵌入和 LM 输出头。
全文的核心机制就是把动作轨迹和未来视觉状态'塞进'VLM 的 token 接口。不理解 VLM 的 token 化与自回归目标,就无法理解论文的统一训练方案(公式 (1)(2))。
视觉-语言-动作模型(VLA)
在 VLM 基础上让模型直接输出机器人动作(通常是末端执行器位姿序列)的模型家族,代表工作有 π 系列、GR00T、Qwen-VLA。由于语言模型只能输出离散符号,VLA 的常见做法是把连续动作离散化为 token,再由解码器或轻量头还原成连续控制量。
PhysBrain 1.5 的动作生成本质上就是 VLA 能力,但它的卖点是把 VLA 与具身理解、世界模型预测统一进同一个 8B 模型和同一套训练目标,这是与既有 VLA 工作的关键区别。
动作分块与 6D 旋转表示
动作分块(action chunking)指一次预测未来 $H$ 步动作而非单步递归,可缓解误差累积。旋转用 6D 连续表示:取旋转矩阵 $R$ 的前两列展平为 $\rho_6(R)=\mathrm{vec}(R[:,1{:}2])\in\mathbb{R}^6$,解码时经 Gram-Schmidt 正交化恢复旋转矩阵,避免欧拉角的万向锁和不连续。本文每个动作目标为 $a_{t,k}=[\,p_{t+k}-p_t,\ \rho_6(R_t^\top R_{t+k}),\ g_{t+k}\,]\in\mathbb{R}^{10}$,$H=16$,含 3 维平移、6 维旋转、1 维夹爪开合。
论文所有动作 token 都建立在这个 10 维表示之上,这是读懂 2.3 节动作生成与 ActionPiece 分词的前提。
VQ-VAE 离散视觉 token
向量量化自编码器(VQ-VAE)用编码器把图像映射到网格,每个位置量化为码本(codebook)中最近的向量索引,从而把连续图像压缩成离散索引矩阵;解码器可从索引还原图像。图像由此变成'另一种语言',可被语言模型逐 token 生成。本文用共享 VQ-VAE(输入 $128\times128$、8 倍下采样、码本 $K=16{,}384$)把未来 RGB、深度图、机器人掩码各变成 $16\times16=256$ 个码。
本文的未来状态预测正是通过这套共享 VQ 词表生成 770 个离散 token 完成的,理解 VQ 机制才能明白'用 LM 生成图像'在本工作里的具体含义。
自我中心视频与 Human-as-Humanoid 运动迁移
自我中心(egocentric)视频由头戴相机拍摄,记录人执行日常任务时的第一视角。Human-as-Humanoid 管线从这类视频中恢复人体运动学链,把手腕位置与朝向提取为类人形'末端执行器'轨迹(忽略手指),从而无需任何真机数据即可获得动作监督,并与画面中的任务描述、视觉观测建立时间对应。
这是本文数据引擎的核心:预训练的全部具身监督(感知、动作、未来状态)都来自约 3 万小时人类交互视频。理解它才能明白'为什么人类视频能教机器人'这一路线。
损失掩码多任务训练
在统一自回归目标 $\mathcal{L}_{AR}=-\sum_{i=1}^{|y|} m_i \log p_\theta(y_i \mid x, y_{<i})$ 中,二值掩码 $m_i$ 决定哪些 token 计入损失:语言问答只对答案 token 置 1,动作任务只对动作 token 置 1,未来预测只对 VQ token 置 1。这样多任务共享同一模型与目标,仅靠任务格式、模态分隔符和掩码区分。
论文所说的'统一训练'就是靠任务格式 + 损失掩码实现的(公式 (2)),这是理解三种异构监督如何合为一个优化问题的关键。
研究动机
物理智能所需的能力长期分散在两类系统中:通用 VLM(如 Qwen3-VL)具备视觉理解、语义知识与指令遵循,但不与物理环境交互;专用模型则各管一段——空间推理、grounding 与 affordance、规划、VLA 动作执行、DreamZero/Qwen-RobotWorld 式预测世界模型。即便较新的具身基础模型 HY-Embodied、RynnBrain 1.1、MiMo-Embodied,也主要覆盖'理解'侧。要联合学习三大能力还面临监督异构的现实困难:理解任务输出语言和空间坐标,动作生成需要时序结构化的运动表示,未来状态预测需要稠密视觉输出;不同数据源的本体构型、坐标系、标注惯例、控制频率与时间粒度互不一致(各机器人数据集的坐标轴与运动尺度差异巨大,部分还缺标定元数据),导致跨本体联合训练代价高、易出错。结果是单一模型很难在一次前向中完成'观察—理解—行动—预测环境如何改变'的完整物理闭环。
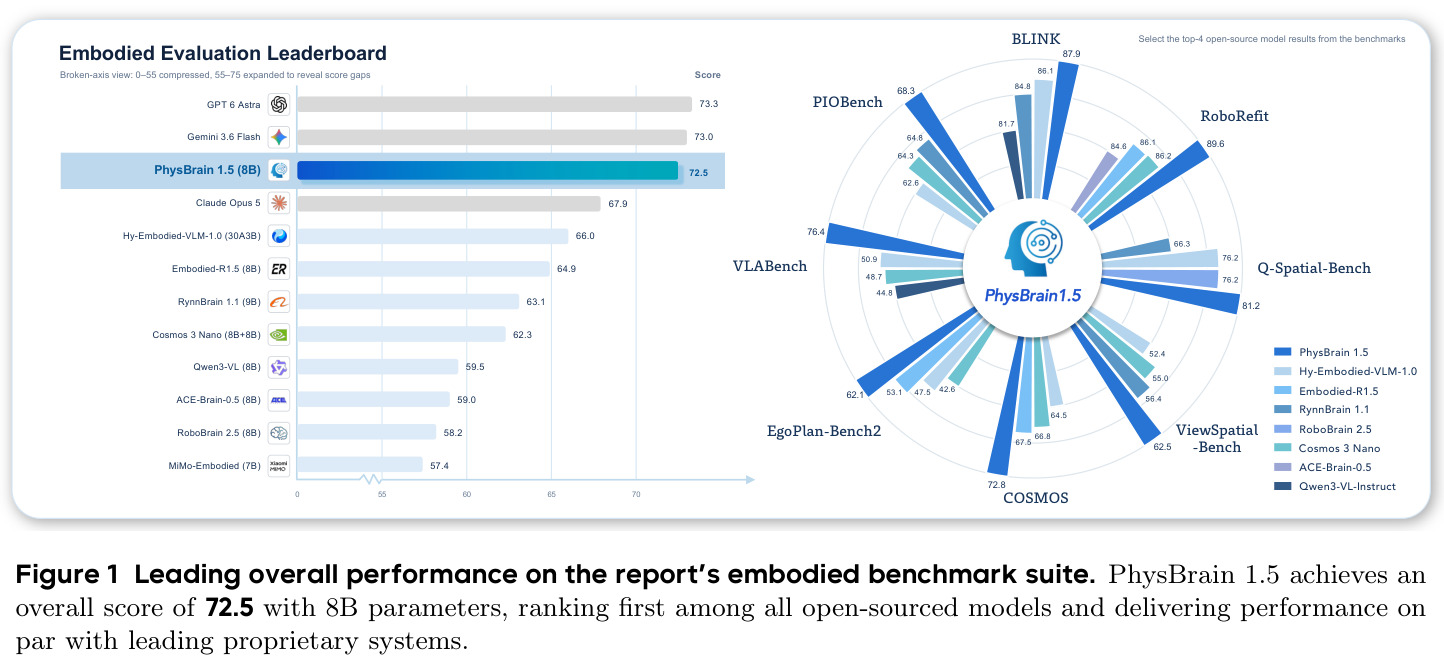
本文的目标是本文目标是构建统一的物理基础模型 PhysBrain 1.5:从通用 VLM(Qwen3-VL-Instruct 8B)出发,用同一个自回归骨干、同一张扩展词表 $V=V_{lang}\cup V_{act}\cup V_{vis}$ 和同一个输出头,同时学会三件事——具身理解(视觉空间感知、多视角理解、具身推理规划、grounding 与 affordance、视觉轨迹推理)、末端执行器动作生成(左右腕各预测 16 步轨迹)、未来物理状态预测(空间对齐的 RGB + 深度 + 机器人掩码)。同时验证一条数据路线:预训练的全部具身监督可以只从约 30,000 小时人类交互视频中自动构造,再经人类演示、真机轨迹与仿真经验混合 SFT,在 28 个具身基准上以 8B 参数达到开源第一(平均 72.5 分)、逼近 GPT-6-Astra 与 Gemini 3.6 Flash,并且不损失通用多模态能力。
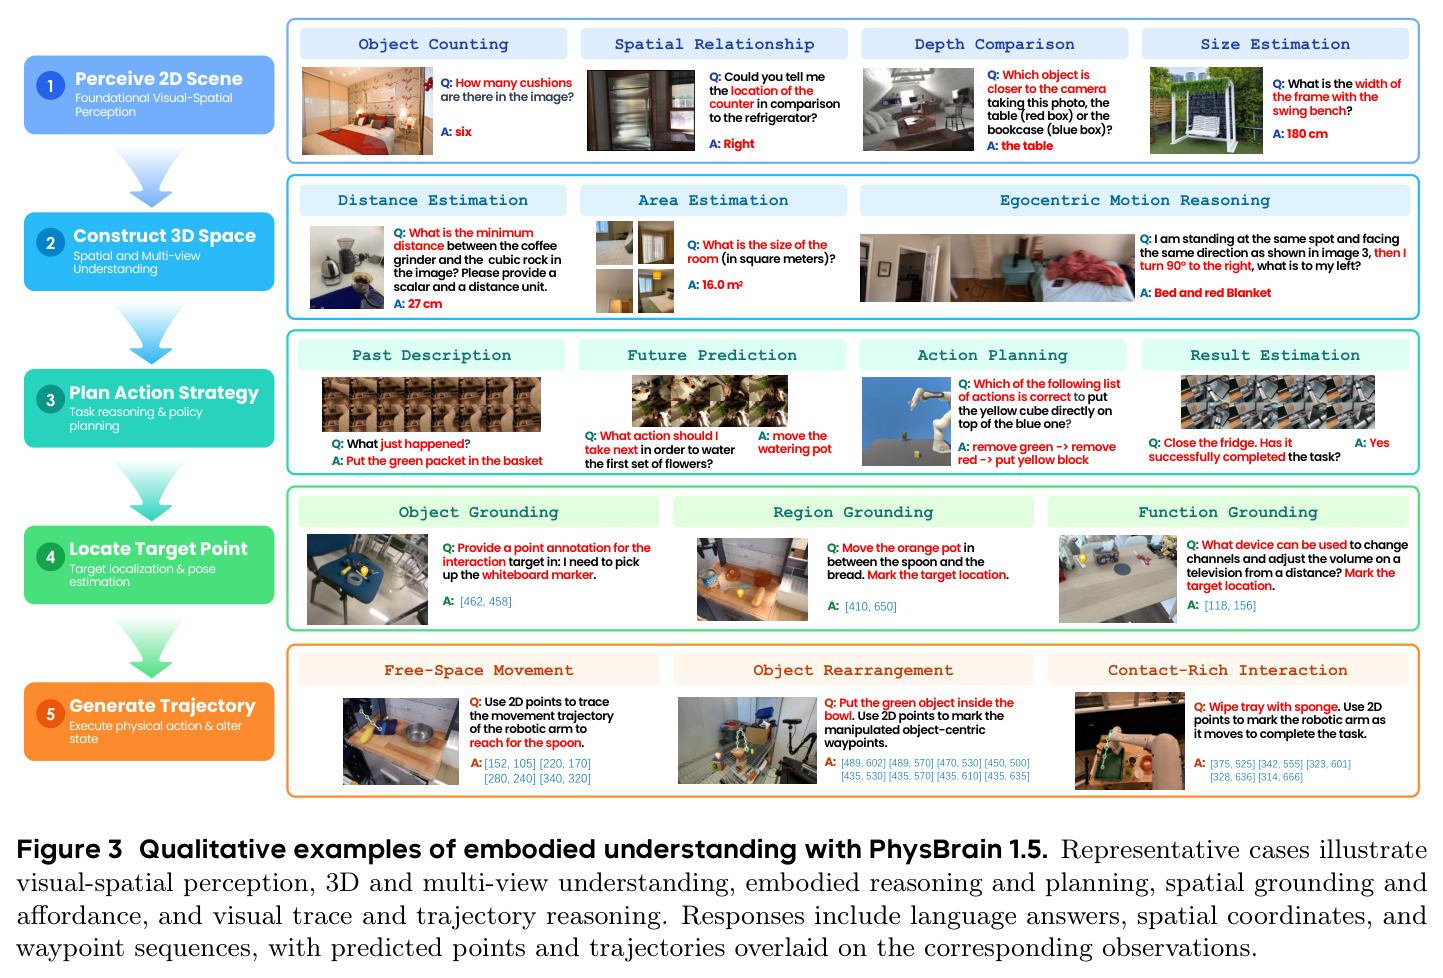
与已有工作不同的是,独特切入角度有三点。其一,以'物理循环'(观察场景→构建空间表征→规划→定位目标→生成轨迹→执行并观察状态改变)作为能力组织与评测框架,把 28 个基准映射到循环的前五个阶段,而不是罗列能力清单。其二,把语言、动作、视觉三类异构监督全部转化为离散 token 序列,用 masked next-token prediction 一个目标联合训练,任务间只差格式与损失掩码:动作 token 用 ActionPiece(512 词,16 步轨迹编成 32 token),视觉 token 用共享 VQ-VAE(RGB-深度-掩码按空间位置交错),且不引入任何模态专属头或像素级重建损失。其三,坚持 PhysBrain 1.0 延续的'理解优先 + 人类经验优先'路线,并用'同源动作延续'机制(把前一动作块作为运动上下文输入,让模型隐式推断当前数据源的坐标约定与运动节奏)绕开跨本体全局坐标系统一这一工程深坑。
核心方法
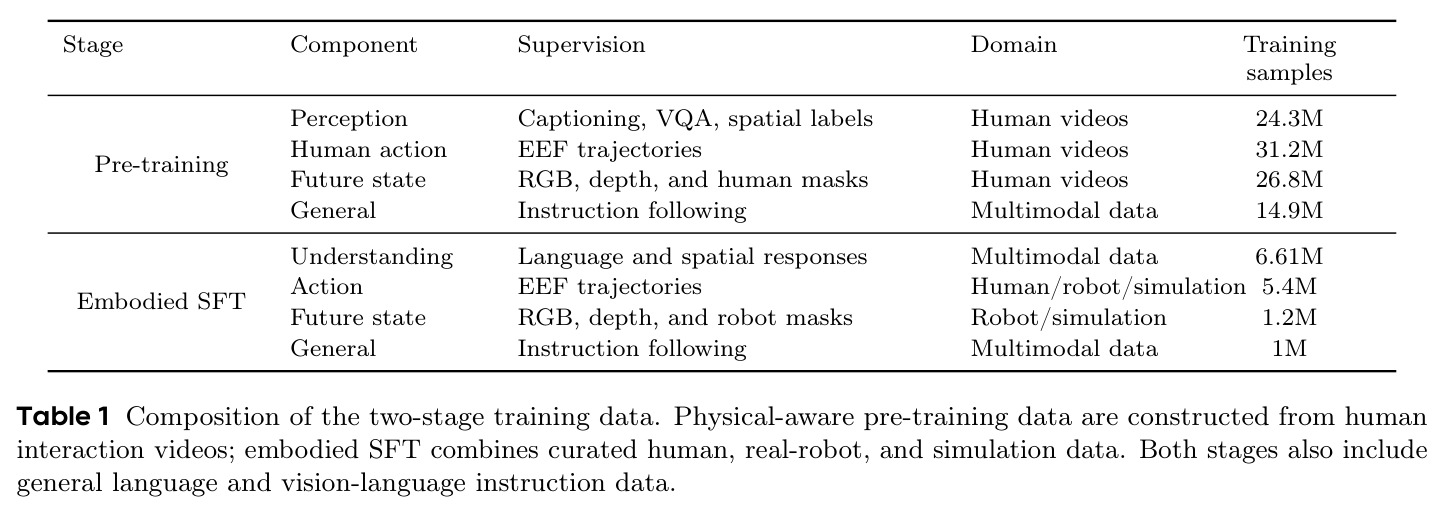
直觉上,本文把机器人模型当成'会说话、会画未来、会写动作'的语言模型:理解是文字回答,动作是另一种'外语'写成的句子,未来画面是第三种'外语'的句子;三种句子共用同一个 8B 大脑(Qwen3-VL)和同一张嘴(LM 输出头),通过下一 token 预测一起学会。技术路线为:扩展词表 $V=V_{lang}\cup V_{act}\cup V_{vis}$;动作侧以 10 维末端执行器表示加 ActionPiece 分词,把每个手腕 16 步轨迹编成 32 个离散 token,输入侧可选提供前一动作块作为运动上下文,模型条件生成下一块;视觉侧用共享 VQ-VAE($128\times128$ 输入、8 倍下采样、码本 $K=16{,}384$)把未来 RGB/深度/掩码各变成 256 个码,按'RGB-深度-掩码逐空间位置交错'序列化为 770 个 token 一次生成;训练分两阶段——物理感知预训练(24.3M 感知 + 31.2M 动作 + 26.8M 未来状态 + 14.9M 通用指令样本)与具身 SFT(6.61M 理解 + 5.4M 动作 + 1.2M 未来状态 + 1M 通用样本),统一优化 $\mathcal{L}_{AR}=-\sum_i m_i\log p_\theta(y_i\mid x, y_{<i})$。
核心创新一是'同源动作延续'(homogeneous action continuation):作者刻意不做跨数据集的全局坐标系规范化,因为不同机器人的相机、控制惯例差异大且常缺标定元数据,强行统一不可靠、不可扩展。他们保留每个数据源的原生坐标轴,把紧邻当前观测的前一 16 步动作块编码为 $z^-=T_{AP}(A^-)$ 作为输入,让条件概率变为 $p_\theta(z^+\mid I, u, e, f, z^-)$($I$ 为观测、$u$ 为指令、$e$ 为本体、$f$ 为控制频率)。近期动作历史像'隐式系统辨识'信号,让模型自行推断当前本体的局部坐标约定、运动尺度与节奏,把动作预测从孤立块回归变成条件轨迹续写,还能保持跨块边界连续。这与常规 VLA 把全部数据硬变换到统一动作空间的做法本质不同。创新二是空间对齐的联合视觉序列:三个模态按同一空间位置交错(RGB-深度-掩码顺序),自回归生成时每个位置都有跨模态局部上下文,天然促使未来预测在三个模态间空间一致,而非把各模态当独立图像分别生成。
方法步骤详情
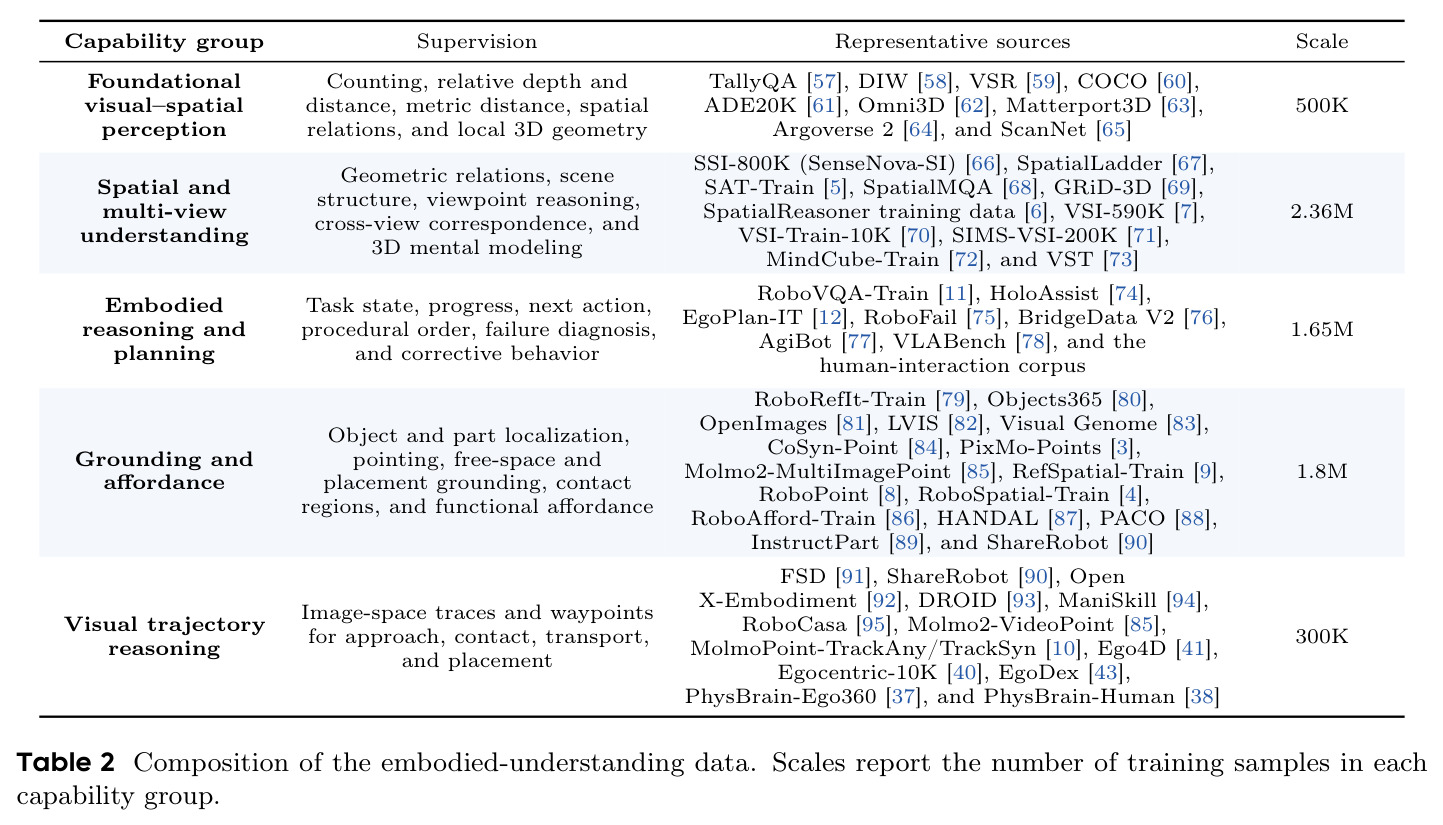
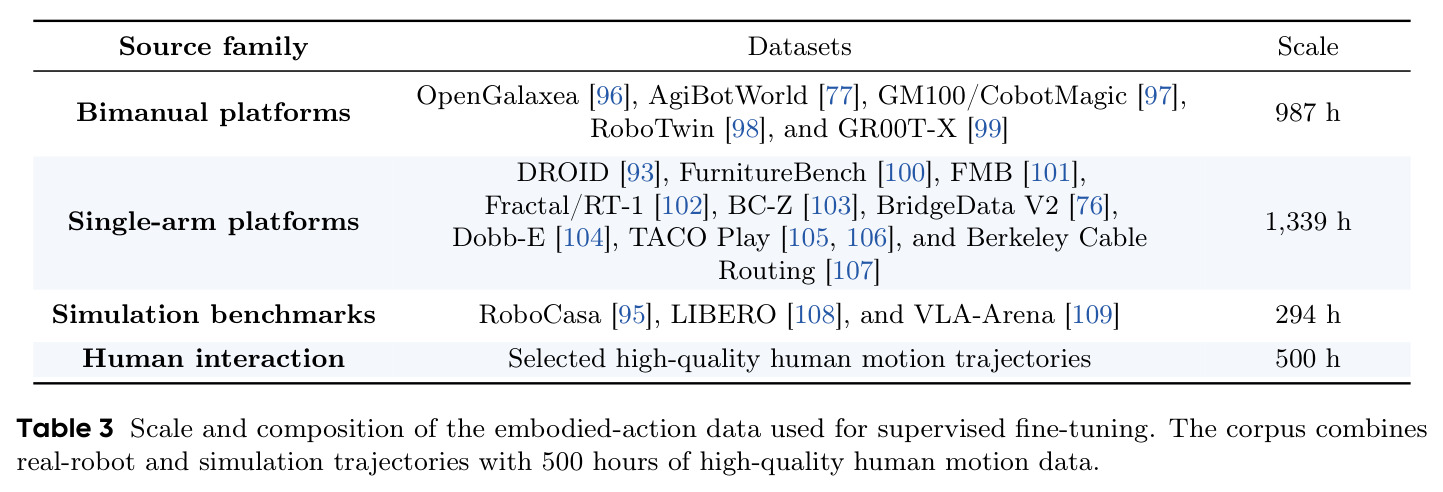
第一步(动作表示与分词):用 Human-as-Humanoid 从人类视频恢复手腕轨迹(保留双腕位姿、去除手指),真机数据做同样处理;动作目标 $a_{t,k}=[\,p_{t+k}-p_t,\ \rho_6(R_t^\top R_{t+k}),\ g_{t+k}\,]\in\mathbb{R}^{10}$,$H=16$,全部锚定当前位姿 $(p_t,R_t)$ 不逐步累积,物理单位标准化、平移做语料级归一化;ActionPiece 在 2,870 万段 16 步轨迹(共 4.592 亿动作时间步)上训练出 512 词动作码本,每条手腕轨迹编成 32 个 token,左右腕共用同一码本。第二步(视觉 token 化):共享 VQ-VAE 以 $128\times128$ 输入输出 $16\times16=256$ 码($K=16{,}384$),深度线性映射到 $[-1,1]$、单通道复制成三通道;未来状态序列 = 起始符 + 三模态逐位置交错 + 结束符,共 770 token;推理时去交错后用冻结 VQ 解码器分别还原 RGB/深度/掩码。第三步(数据构建):预训练聚合 Ego4D、Ego-Exo4D、EgoDex、EgoLife 及自建 PhysBrain-Human、PhysBrain-Ego360 等约 3 万小时人类视频,切分为任务级片段后产出 24.3M 感知样本(伪标签+字幕+VQA)、31.2M 动作样本、26.8M 未来状态样本(RGB+深度+手臂数字掩码),另加 14.9M 通用指令数据;SFT 加入 17 个真机/仿真来源(双臂 987h、单臂 1,339h、仿真 294h)与 500h 高质量人类动作共 5.4M 动作样本、6.61M 理解样本(500K 基础感知 + 2.36M 空间多视角 + 1.65M 推理规划 + 1.8M grounding/affordance + 300K 轨迹)、1.2M 未来状态样本(深度用 MoGe-2 生成、掩码用 RoboEngine),并混 1M 通用数据防遗忘。第四步(训练):ms-swift + Megatron-Core,两阶段各 1 epoch,第二阶段从第一阶段 checkpoint 初始化;Adam($\beta_1=0.9$、$\beta_2=0.95$、$\epsilon=10^{-8}$、权重衰减 0.1),峰值学习率 $2\times10^{-5}$、前 3% 步 warmup 后余弦衰减,序列长度 32,768、启用 packing、全局 batch 约 2K 样本,梯度裁剪 1.0,bf16。第五步(推理):理解任务直接文本回答;动作任务自回归生成 32 个动作 token 后由 ActionPiece 解码为左右腕轨迹;未来预测生成 770 个 VQ token 后解码为三种模态。
技术新颖性
第一,统一性做到'一词表、一头、一目标':多数工作给动作加扩散头或回归头、给世界模型加像素重建损失,而本文动作与视觉完全走 LM 输出头,训练全程不引入模态专属预测头或像素级损失,$\mathcal{L}_{AR}$ 一个公式覆盖三种任务;ActionPiece 的 512 词与 VQ 的 16,386 词以原子 token 直接并入语言词表。第二,动作分词器的训练规模空前:2,870 万段轨迹、4.592 亿动作时间步,为跨本体动作离散化提供了共享接口。第三,RGB/深度/掩码逐空间位置交错的序列化设计直接服务于'空间一致的未来状态'这一目标,是少见的做法。第四,数据路线上,预训练具身监督 100% 来自约 3 万小时人类交互视频,把 PhysBrain 1.0 的'理解优先'扩展为覆盖全物理循环的联合学习;'动作历史当隐式标定'机制优雅地回避了跨本体坐标统一的难题。需要指出的是,理解+动作+预测的联合学习在 UniVLA、RynnVLA-002、Cosmos 3 中已有探索,本文的差异化主要体现在执行彻底度、数据规模与同源动作延续机制,而非单一算法层面的发明。
实验结果
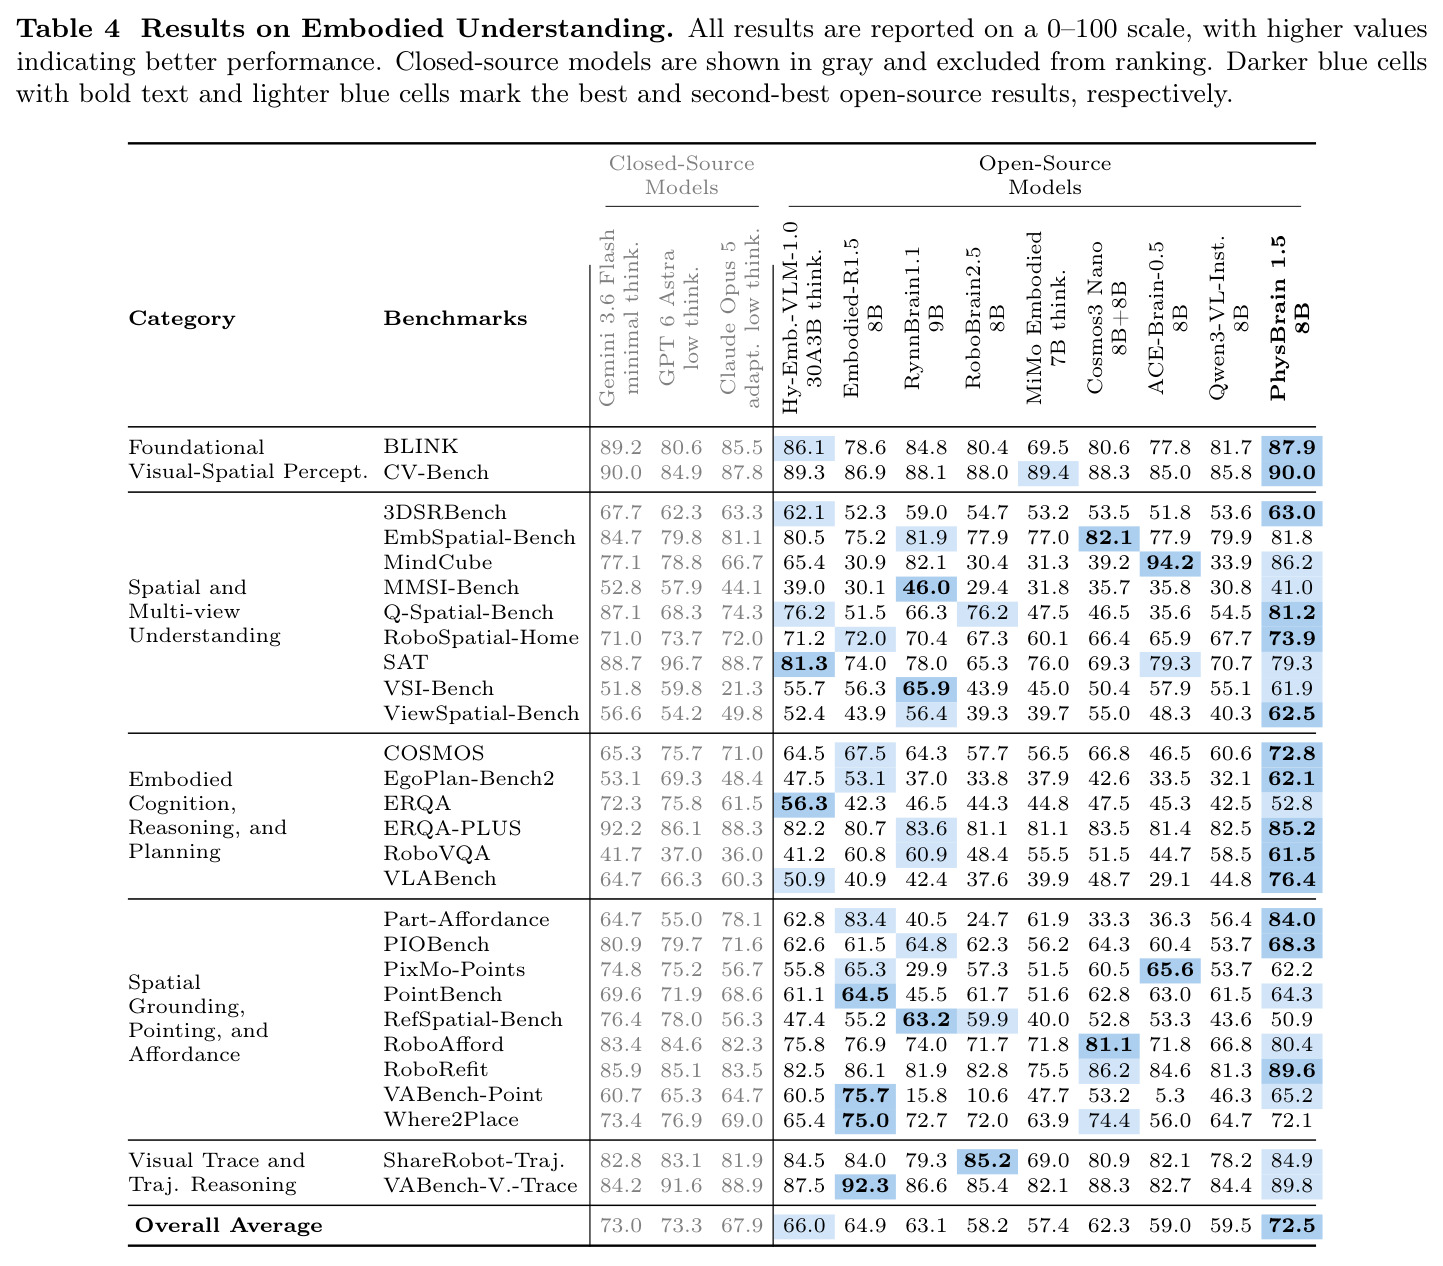
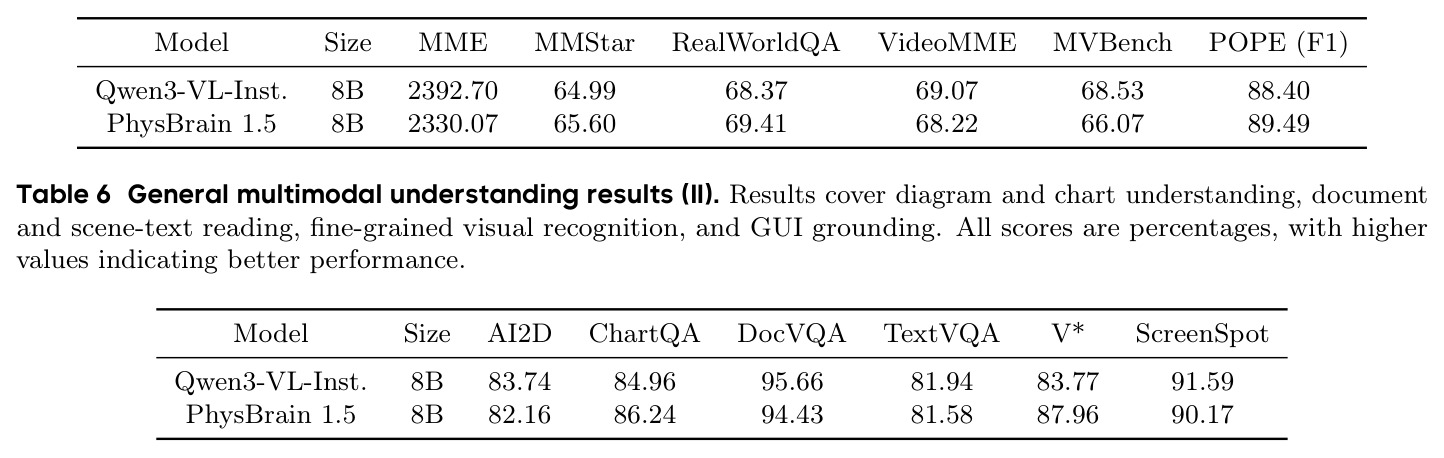
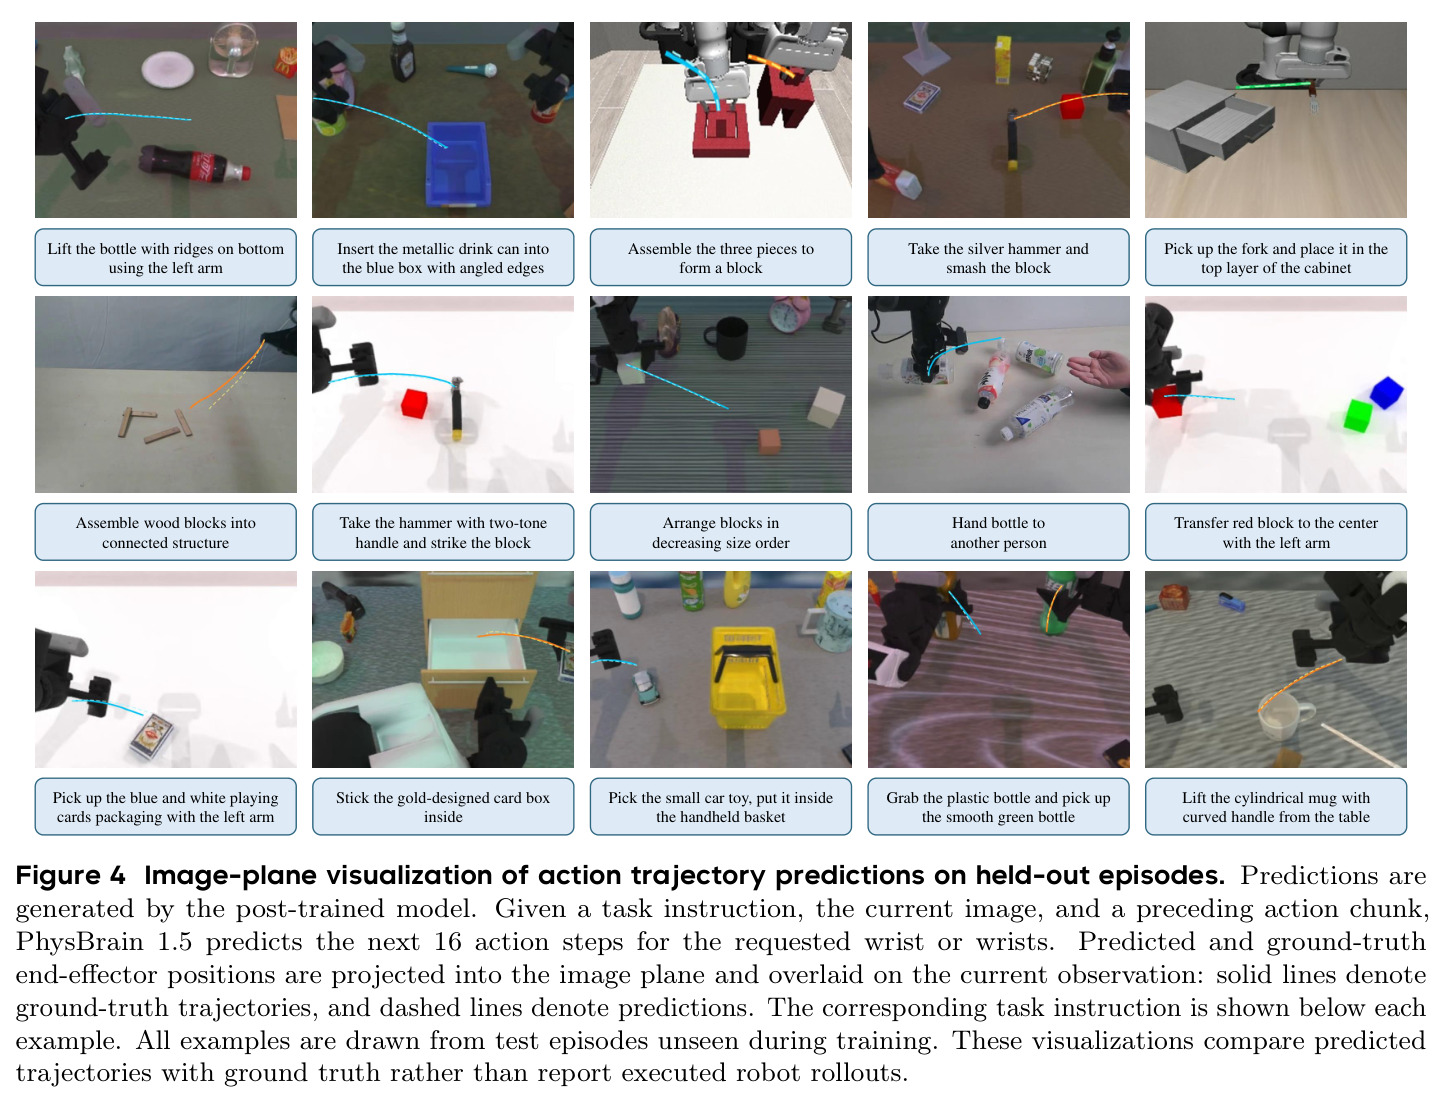
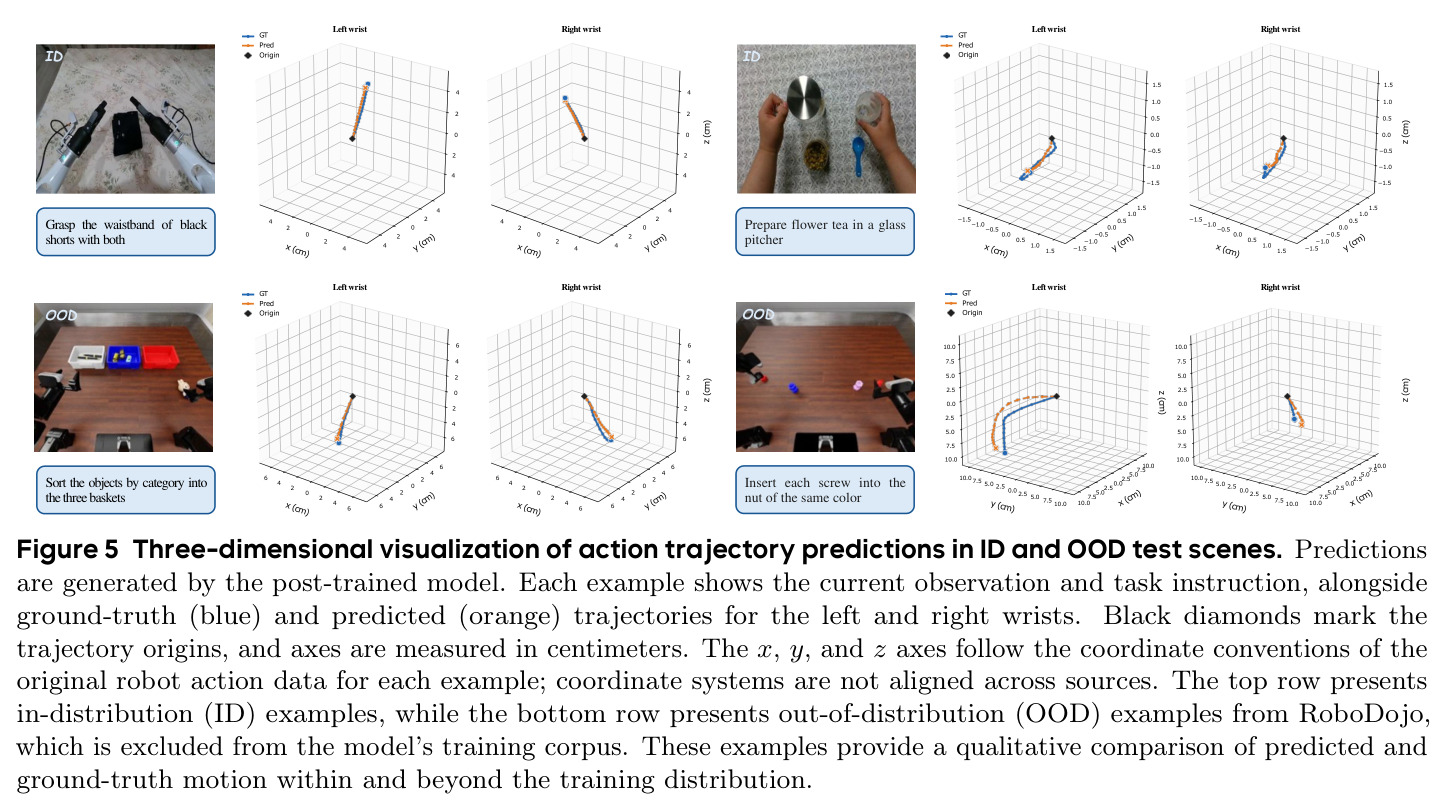
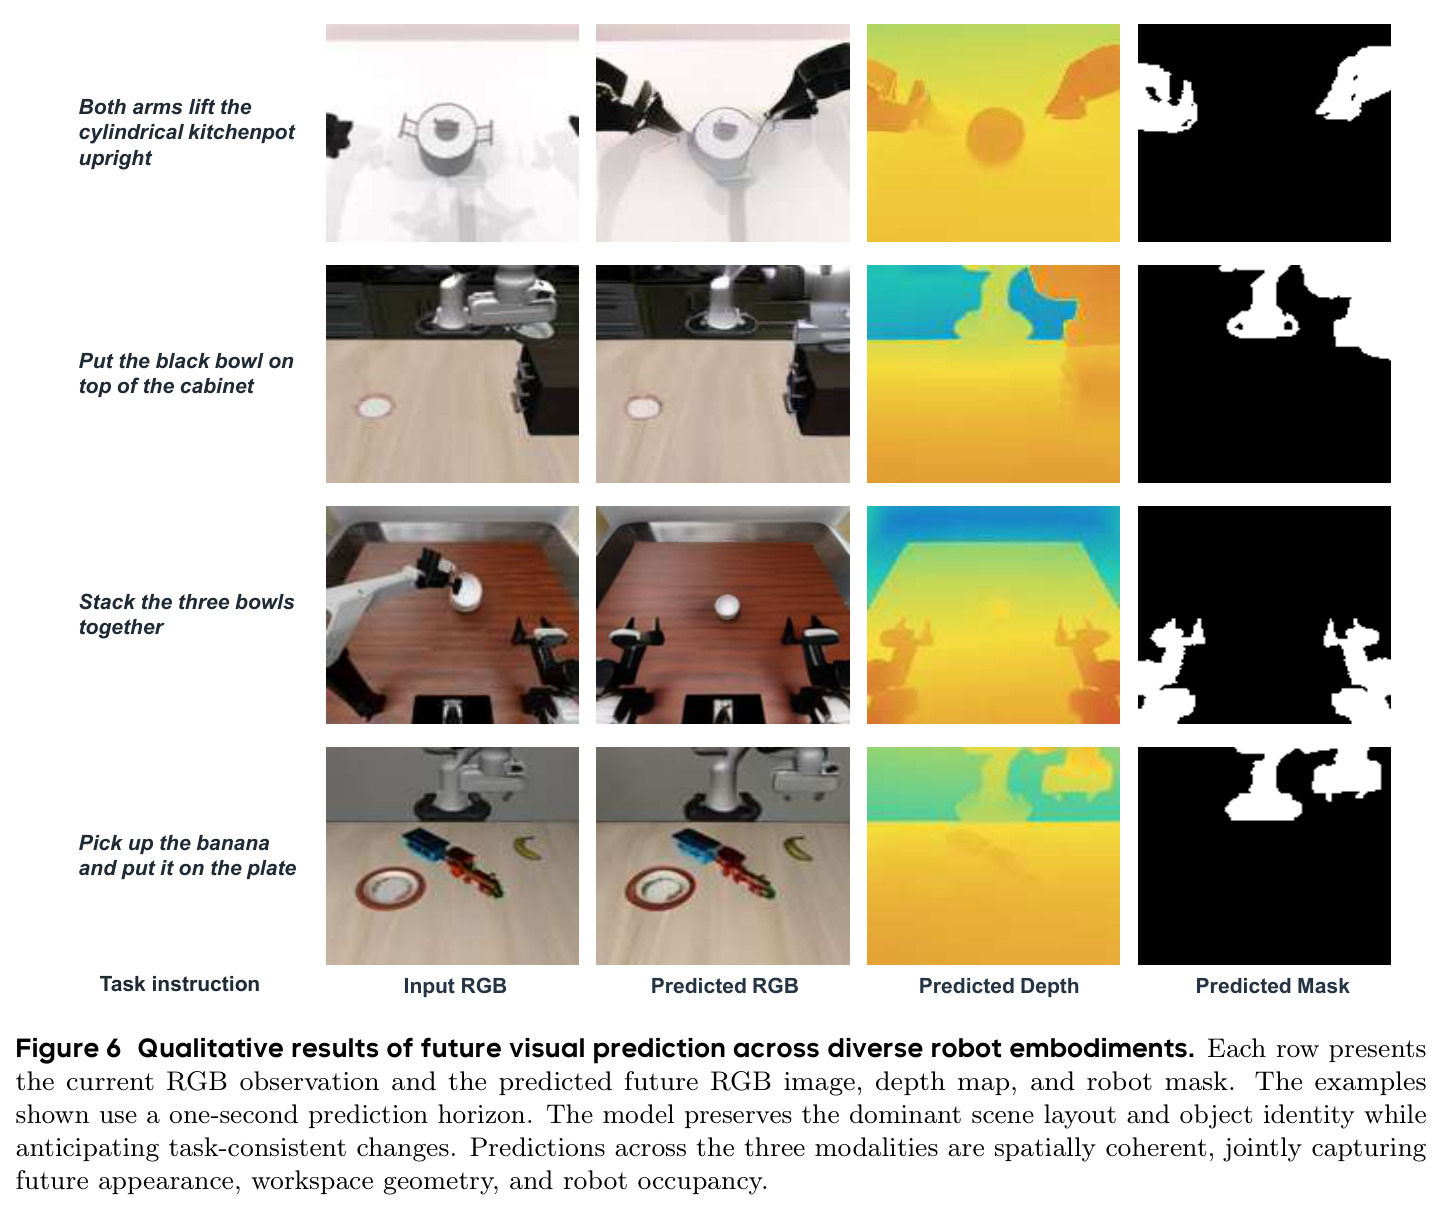
主实验(Table 4):在覆盖五大能力组的 28 个具身理解基准上,PhysBrain 1.5 (8B) 平均 72.5 分,居开源第一——超过最强开源基线 Hy-Embodied-VLM-1.0(30A3B,66.0)6.5 分,较基座 Qwen3-VL-Instruct(59.5)高 13.0 分并在全部 28 个基准上超过基座;同时逼近闭源 GPT-6-Astra(73.3)与 Gemini 3.6 Flash(73.0),超 Claude Opus 5(67.9)4.6 分。开源模型中 14 个基准第一、24 个进入前二。亮点包括:VLABench 76.4(全场第一,超最佳开源 50.9 达 25.5 分)、EgoPlan-Bench2 62.1(全场第一)、RoboVQA 61.5(全场第一)、Part-Affordance 84.0(全场第一)、RoboRefit 89.6、BLINK 87.9、Q-Spatial-Bench 81.2、MindCube 86.2、VABench-Visual-Trace 89.8。评测协议上作者用统一指标独立复测了所有对比模型(统一图像分辨率与视频帧数,闭源模型用最低思考档),避免各家自报数字不可比。通用能力(Table 5/6):与基座基本持平——MMStar 65.60 vs 64.99、RealWorldQA 69.41 vs 68.37、POPE 89.49 vs 88.40、V* 87.96 vs 83.77(+4.19)、ChartQA 86.24 vs 84.96;MME 2330.07 vs 2392.70、MVBench 66.07 vs 68.53、DocVQA 94.43 vs 95.66 略降,说明具身特化未明显牺牲通用多模态能力。动作生成(Figure 4/5):给定当前帧、指令和前 16 步真值动作块,模型自回归生成下一 16 步;在留出集上,图像平面投影与 3D 轨迹可视化显示预测与真值的方向和形状大体吻合;对训练集中完全排除的 RoboDojo OOD 场景(分类整理、拧螺丝),预测仍能复现大致运动趋势但存在可见位置偏差。未来预测(Figure 6):1 秒预测时域下,跨双臂/单臂本体生成空间对齐的 RGB+深度+掩码,保持场景布局与物体身份,双臂抬锅等例子中三个模态对机械臂空间占用的刻画一致。注意:动作与未来预测均为离线定性结果,论文未报告闭环真机成功率或定量误差指标。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 28 项具身理解基准总平均 | 统一复测后的平均分(0–100) | 72.5 | 最佳开源 Hy-Embodied-VLM-1.0 (30A3B) 66.0;基座 Qwen3-VL-Instruct 8B 59.5;闭源最高 GPT-6-Astra 73.3 | 较最佳开源 +6.5,较基座 +13.0,距闭源最高仅差 0.8,开源 SOTA |
| VLABench(具身认知与规划) | 准确率 | 76.4 | 最佳开源 Hy-Embodied 50.9;闭源最佳 GPT-6-Astra 66.3 | 较最佳开源 +25.5,全场第一(含闭源) |
| EgoPlan-Bench2(自我中心任务规划) | 准确率 | 62.1 | 最佳开源(Embodied-R1.5)53.1;GPT-6-Astra 69.3 | 开源第一 +9.0,超过除 GPT-6-Astra 外所有闭源模型 |
| RoboVQA(机器人视频问答与规划) | 准确率 | 61.5 | 次优 RynnBrain 1.1 60.9;Gemini 3.6 Flash 41.7 | 全场第一,较最佳闭源 +19.8 |
| Part-Affordance(部件可供性理解) | 准确率 | 84.0 | 最佳开源 Embodied-R1.5 83.4;Claude Opus 5 78.1 | +0.6,全场第一 |
| Q-Spatial-Bench(空间距离问答) | 准确率 | 81.2 | 最佳开源 Hy-Embodied 76.2;Gemini 3.6 Flash 87.1 | 开源第一 +5.0 |
| MindCube(3D 心理建模/多视角) | 准确率 | 86.2 | 最佳开源 ACE-Brain-0.5 94.2;多数对手 30–40 | 开源第二,显著高于除两三家外的全部对手(基座仅 33.9) |
| MMStar(通用多模态理解) | 准确率 | 65.60 | 基座 Qwen3-VL-Instruct 8B 64.99 | +0.61,具身特化后通用能力不降 |
| V*(细粒度视觉识别) | 准确率 | 87.96 | 基座 Qwen3-VL-Instruct 8B 83.77 | +4.19 |
局限与改进
作者明确承认:动作生成与未来预测的证据'限于离线轨迹预测与定性可视化,而非闭环执行或全任务成功率'(5.3.1 节原文);全文没有在 LIBERO、RoboTwin 等标准仿真或真机控制评测上报告成功率;Figure 5 显示 OOD(RoboDojo)场景下动作预测存在明显位置偏差。我补充的观察:(1) 全文没有任何消融实验——动作历史条件、交错序列化、三任务联合训练各自的贡献均未量化,无法判断哪个组件真正带来增益;(2) 未来视觉预测分辨率仅 $128\times128$(VQ 网格 $16\times16$、每模态 256 码)、时域仅 1 秒,细节与预测范围都有限;(3) 保留各源原生坐标轴虽规避了标定难题,但意味着模型对'约定'的推断可能在新本体上失效,论文未测未见本体的动作泛化;(4) 动作表示去除手指自由度,灵巧操作不在能力范围;(5) 数据管线大量依赖伪标签(姿态恢复、MoGe-2 深度、RoboEngine 掩码、感知模型生成的 QA),误差会沿教师链级联传播且未定量评估噪声率;(6) 闭源对比模型被限制在最低思考档位而部分开源对手开启 thinking,跨模型对比的公平性可商榷;(7) 混入 1M 通用数据防遗忘有效但未给出配比敏感性分析。
独立分析的弱点
弱点一:缺少闭环验证。动作与预测只有离线定性图,无法判断真实控制回路中的累积误差、漂移与鲁棒性——改进方向是接入 LIBERO/RoboTwin/RoboCasa 仿真评测并补充小规模真机 rollout,报告任务成功率、轨迹 MSE 与碰撞率。弱点二:零消融。核心设计(前一动作块条件 $z^-$、三模态交错序列、联合训练 vs 分阶段训练、ActionPiece 词表大小 512)都值得 leave-one-out 消融——例如去掉动作历史或改为逐模态序列化,量化对轨迹误差与三模态一致性的影响。弱点三:生成分辨率与时域受限($128\times128$、1 秒、256 码/模态),难以支撑长时域规划——可引入多尺度 VQ 或扩散解码器提升保真度,并扩展到多秒 rollout。弱点四:动作表示无手指自由度,无法覆盖灵巧手任务——可将手部关节角纳入扩展表示或引入独立手指 token 组。弱点五:对数据源坐标约定的隐式依赖使向全新本体的零样本迁移存疑——可在历史条件之外增加显式标定元数据输入,并系统评测未见本体。弱点六:伪标签链路长(视频→姿态恢复→轨迹→伪标签 QA→MoGe-2 深度→RoboEngine 掩码),误差级联——可引入置信度加权损失或人工校验子集估计各环节噪声率。弱点七:评测协议虽统一,但闭源模型被限思考档位,结论对档位选择敏感——建议同时报告最低档与默认档两套结果。
未来方向
作者提出的方向:继续扩大训练数据量、扩展模态覆盖、纳入更丰富的交互经验。基于其成果可延伸的方向:(1) 闭环化与规划结合——把未来状态预测当作'想象-验证'模块,对候选动作序列做 rollout 评分,形成 model-based 规划环;(2) 长时域分层——当前 16 步/1 秒的短时域之上叠加子目标级 token 层级或时序扩散,实现分钟级任务 rollout;(3) 强化学习后训练——在 SFT 之上用仿真或真机回报对动作 token 生成做 RL(如 GRPO/GRPO 类偏好优化),弥补离线监督的天花板;(4) 显式 vs 隐式坐标约定的系统研究——对比'动作历史隐式辨识'与'标定元数据显式注入'随数据规模的变化规律;(5) 灵巧手与触觉——把手指关节、力/触觉 token 纳入统一词表;(6) 更高保真生成——扩散头或分层 VQ 提升未来预测分辨率,向视频级长时程世界模型演进;(7) 数据引擎自我改进——用训练好的模型反向审计伪标签质量,做 self-training 式数据清洗与定向补采。
复现评估
开源情况较好:项目页(deepcybo-physai.github.io/PhysBrain-1.5)、HuggingFace 模型集合(DeepCybo/physbrain-15)与评测套件(PhysBrainEvalKit)均已公开;基座 Qwen3-VL-Instruct 8B 公开,训练框架 ms-swift + Megatron-Core 开源,论文给出了完整超参(Adam $\beta_1=0.9/\beta_2=0.95$、学习率 $2\times10^{-5}$、3% warmup、余弦衰减、序列 32,768、bf16 等)和各数据源的样本数统计。但完整复现门槛仍高:(1) 预训练关键数据为私有/自建(PhysBrain-Human、PhysBrain-Ego360、Xperience-10M 等),约 3 万小时视频无法完整获取,SFT 的 2,620 小时真机+仿真轨迹需要整理 17 个第三方数据集并复刻清洗与过滤管线;(2) 两阶段全量训练 8B 模型、32K 序列、packing,估计需要数百张 A100/H800 级算力;(3) ActionPiece 与 VQ-VAE 的训练代码及词表是否随模型发布需在仓库确认。总体判断:推理与 28 基准评测的可复现性好(单卡即可跑 8B 推理,EvalKit 提供统一协议),从零复训属于'可用难训'型,适合在其开源 checkpoint 上做下游研究与微调,而非完整重训。
论文图表
通用图像/视频理解与幻觉鲁棒性:PhysBrain 1.5 与基座 Qwen3-VL 相比 MME 2330.07 vs 2392.70、MMStar 65.60 vs 64.99、RealWorldQA 69.41 vs 68.37、VideoMME 68.22 vs 69.07、MVBench 66.07 vs 68.53、POPE 89.49 vs 88.40。
验证具身特化没有以通用多模态能力为代价,是'物理基础模型而非窄域模型'主张的支撑证据。