AlayaVista:从全景状态到透视视频的流式世界建模 AlayaVista: Streaming World Modeling from Panoramic States to Perspective Video
用全景潜状态保存世界上下文,按需渲染高保真透视视频的流式世界模型
前置知识
ERP(等距柱状投影)
把 360° 球面展开成 2:1 宽高比矩形图像的标准全景表示:经度映射为横轴、纬度映射为纵轴。优点是覆盖完整球面,代价是极点严重拉伸、左右边缘本应无缝相接。本文所有全景计算都在 ERP 潜空间进行。
论文的『全景状态』就是 ERP 格式的视频潜变量,理解接缝周期性、极点畸变如何被 SpheRoPE 和经度循环 padding 处理,是读懂方法部分的前提。
流匹配
一类生成范式:训练速度场 $v_\theta$ 学习把高斯噪声沿线性插值路径 $Z_\sigma=(1-\sigma)Z+\sigma\epsilon$ 搬运到干净数据,推理时从噪声出发积分速度场。Wan2.2 等视频扩散模型即采用此参数化。
本文全部四个生成模块(全景生成器、渲染模块、上采样器、精修器)都建立在 Wan 的流匹配目标之上,所有损失公式(如 $\mathcal{L}_{FM}$)都是它的变体。
块自回归生成
把长视频切成若干潜变量块,块内用双向注意力、块间用因果注意力,配合 KV 缓存逐块生成。这样每个新块能复用已生成历史的特征而无需重算全部上下文,是实现流式低延迟推演的主流方案。
AlayaVista 的全景状态按 4 潜片一块(约 16 个 RGB 帧)流式演化,透视精修同样按 4 块滑窗进行,块因果注意力是整条流式管线的骨架。
载体条件精修
先用确定性算子(如最近邻/插值上采样)得到一张高分辨率但缺细节的『载体』潜变量,对其重新加噪 $X_{\sigma_0}=(1-\sigma_0)C+\sigma_0\epsilon$ 作为采样起点,并把干净载体拼接为条件,让生成模型只负责补高频纹理。
这是论文把 512×288 视口潜变量变成 1024×576 高清视频的核心机制:上采样器出结构、精修器出细节,低频被 $\mathcal{L}_{str}$ 锚定在载体上不漂移。
少步蒸馏(一致性蒸馏与 DMD)
把 50 步教师采样器压缩成 4 步学生的技术:一致性蒸馏让学生在 EMA 低噪目标上对齐跳步轨迹;分布匹配蒸馏(DMD)用冻结的真评分模型与可训练的假评分模型之差构造归一化更新方向 $g$,把学生 rollout 的分布拉向真实分布。
流式世界模型必须低延迟,论文对全景生成器和透视精修器各做一次四步蒸馏(含 Self-Forcing++/Self-Forcing 在线 rollout),是理解训练第三阶段的关键。
UCPE(统一相机位置编码)
一种把相机位姿注入注意力的机制:为每个空间 token 构造其视线的局部射线坐标系 $T_i$,用 $\Gamma_i=I\otimes T_i$ 对 $q,k,v$ 做相似变换,注意力得分自然只依赖相对位姿 $T_iT_j^{-1}$,以零初始化旁路融合进主干。
论文把 UCPE 改造成 ERP 专属的球面射线版本,作为相机轨迹 $\Pi$ 进入全景生成器的通路,是『相机条件化』能精确控制视角的原因。
研究动机
交互式视频世界模型要求在相机持续运动下维持广域场景上下文,同时以低延迟输出高保真画面,但现有方法陷入表示上的两难。以透视帧序列为主的模型(如 AlayaWorld、ReWorld、Wonder)每帧只覆盖用户眼前的局部视野,内容一旦滚出画面就必须依赖长上下文注意力、有界 KV 缓存、位姿索引地标库或显式空间记忆来『记住』,世界演化、记忆维护与观测合成被紧紧耦合,长 rollout 下难以兼顾。另一类方法把全景视频当作最终输出:为保证全向覆盖,高保真生成与修复必须覆盖整个球面,而交互用户每次只注视一个透视视口,大量算力被浪费在看不见的方向上;基于高斯泼溅、点云、网格的显式 3D 方法(如 MoVerse、HY-World 2.0)虽然几何持久性和回访一致性更好,却要额外引入几何提升、场景构建、记忆维护与渲染等阶段。数据层面同样有缺口:WEB360、PanoVid 等生成导向数据集缺乏分钟级时长、4K 分辨率与连续相机轨迹的组合,感知导向数据集又无法支撑可控生成。作者由此提出核心质疑:能否既保留广域视觉上下文,又不必对每个方向做显示级合成、也不必先构建显式 3D 世界?
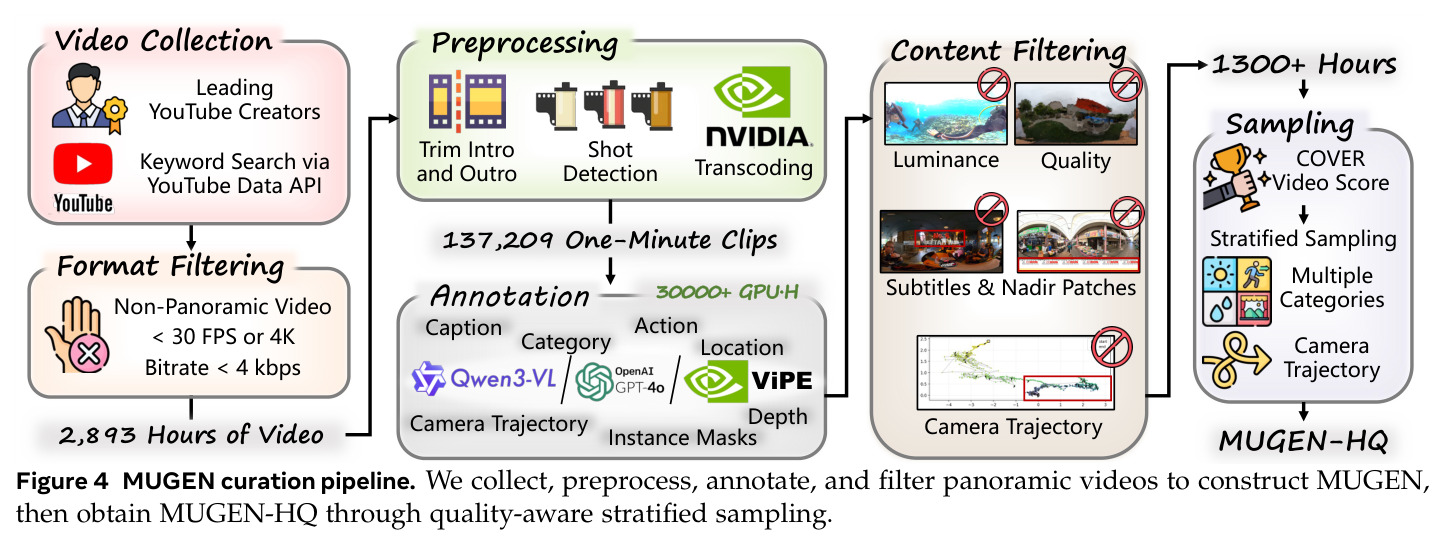
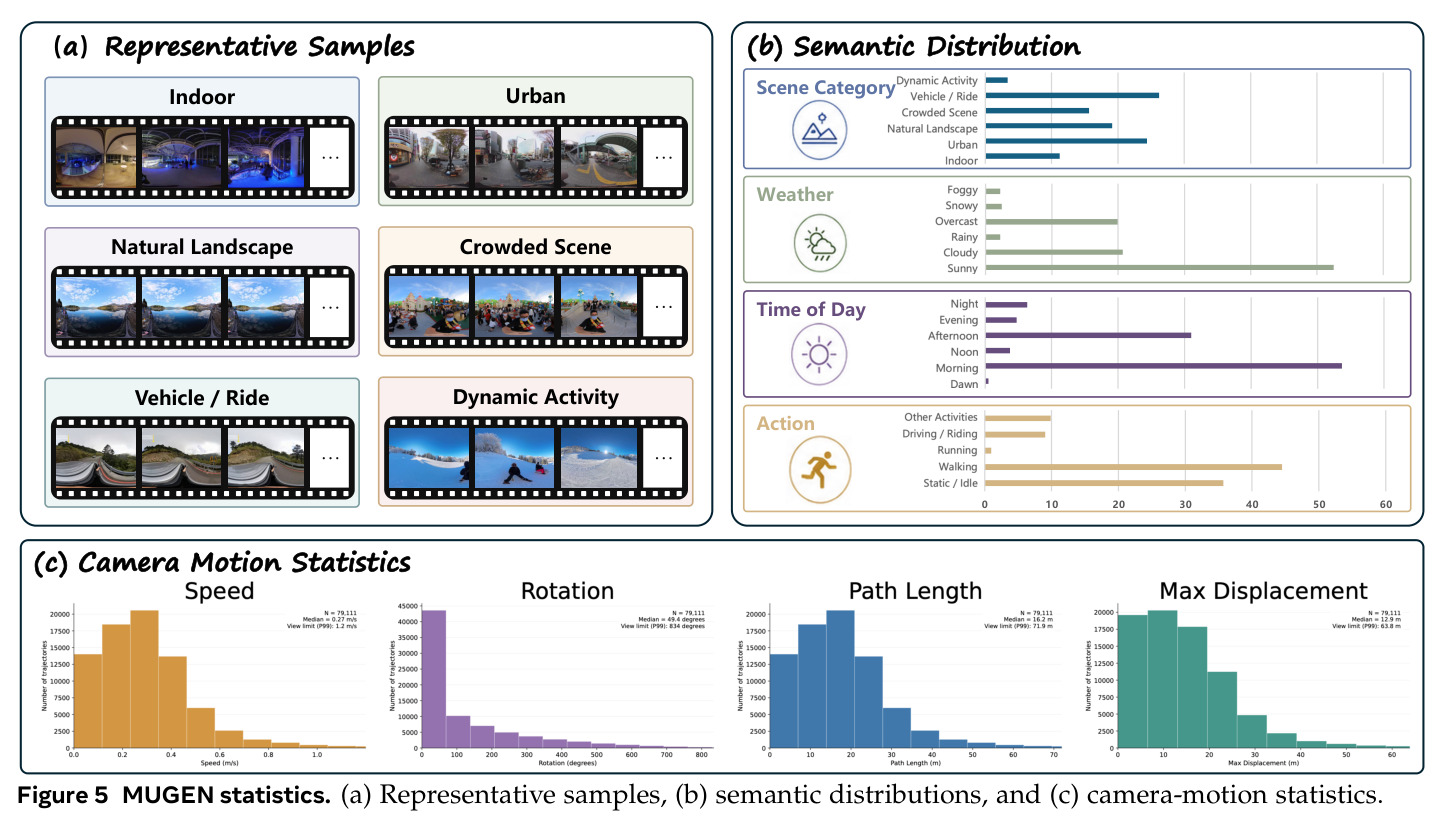
本文的目标是本文的目标是构建一个单图输入、相机可控、可流式推演的视频世界模型 AlayaVista:给定一张透视图像 $I_0$ 和目标相机轨迹 $\Pi$,模型应能揭示未见区域、在视角变化中保持场景一致,并持续给出低延迟的视觉反馈。目标被拆成三件具体的事:其一,把『世界内部状态』与『用户可见观测』解耦——让世界以相机条件化的全景潜状态 $Z_{pan}^{1:T}$ 演化,只对被查询的透视视口做高保真合成;其二,设计潜空间视口渲染与透视精修两级结构,把 960×480 ERP 视频的潜变量(30×60 网格)映射为 1024×576 高清透视视频(36×64 潜网格);其三,构建 MUGEN 数据集——1,318 小时、分辨率至少 4K、带分层语义与几何标注的真实全景视频,外加 300 小时精选子集 MUGEN-HQ——为全景外观、真实动态、长时上下文与可控相机运动的联合监督提供数据基础。最终系统要在视觉质量、相机可控性、长时稳定性、回访一致性与端到端流式效率上得到实验验证。
与已有工作不同的是,本文的独特切入来自 Gibson『视野有界而视觉世界无界』的知觉哲学与视觉心理物理学证据:人类能从低空间频率、外周的信息快速推断粗略场景布局与全局生态属性,精细细节则由高敏锐度的中央凹视觉『按需、即时』采样。这暗示一种非对称的全局-局部计算结构:用紧凑表示维持广域上下文,把高保真处理只分配给当前被查询的观测,而非维持一张像素级完美的全景图。与已有工作的本质差异在于对全景视频潜变量的定位——全景生成方法(PanoWorld-X、CamPVG、OmniRoam、Pantheon360 等)把全景 RGB 当作最终输出,即使之后用于探索或重建;显式 3D 方法(MoVerse 的持续高斯脚手架、HY-World 2.0 的可导航高斯/网格、各类生成式渲染)要先建资产再渲染。AlayaVista 则把全景潜序列当作内部动态『世界状态』:在视角选定之前不做任何显示级合成,也不构建显式 3D 表示,从而在『透视帧序列』与『显式 3D 世界』之间开辟了第三条中间路线。
核心方法
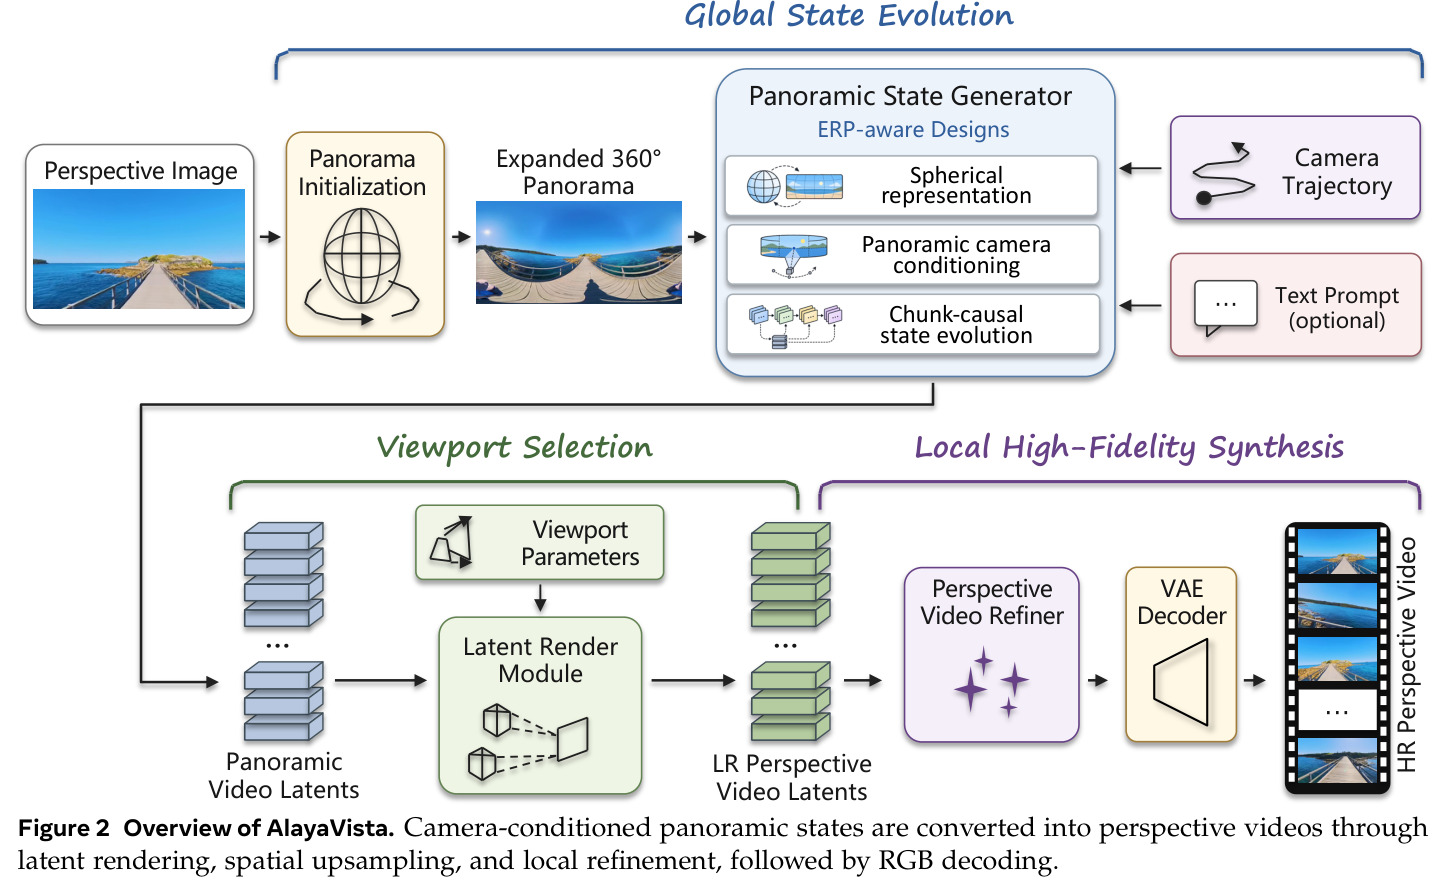
先讲直觉:整个系统像一个『上帝视角的全局沙盘 + 用户眼前的取景器』。模型先用预训练全景扩展模型把单张透视图补全为 360° 场景先验,再让一个相机条件化的全景生成器在潜空间按轨迹推演世界,最后只把用户想看的视口从全景潜变量中『投影』出来、放大并精修成高清透视视频。技术上是四个模块的流水线(Eq. 1):$P_0=O(I_0)$ 用 HY-World 2.0 的预训练模型做全景初始化;$Z_{pan}^{1:T}=G_\theta(Z_{init},\Pi,c)$ 是 ERP 感知的全景状态生成器,初始化自 Wan2.2-TI2V-5B,操作 WanVideoVAE38 的 48 通道潜变量;$Z_{view,LR}^{1:T}=R_\psi(Z_{pan}^{1:T},\kappa)$ 是几何引导的潜渲染模块;随后确定性上采样器 $U_\omega$ 产生高分辨率结构载体 $C$,生成式精修网络 $F_\phi$ 合成细节,经冻结的 Wan 解码器 $D_{Wan}$ 输出 RGB。为支持流式,全景生成与透视精修均被改造为块因果推理并各自蒸馏成四步模型,全景状态全程不解码为显示级全景 RGB。
核心创新是把『全景视频潜变量』重新定位为内部动态世界状态而非最终输出,由此实现空间覆盖、输出质量与计算效率的再平衡,包含三个环环相扣的设计。第一,视角选定之前世界演化只发生在 48 通道潜空间:960×480 的 ERP 潜变量从不解码成全分辨率全景,昂贵的显示级合成只作用于被查询视口——这与把全景 RGB 当输出的 PanoWorld-X、OmniRoam 一类方法有本质区别。第二,潜渲染模块用可学习的潜空间映射逼近『解码-投影-再编码』参考算子 $Z_{view,*}=E_{Wan}W_\kappa D_{pan}(Z_{pan})$,既保留解析几何采样先验 $S_\kappa$,又只学 VAE 非线性校正,部署时完全绕开全全景 RGB 路径。第三,透视精修采用载体条件机制:确定性上采样产生承载布局与运动的载体 $C$,对其重加噪并以干净载体为条件做生成式修复,低频由 $\mathcal{L}_{str}=\|H_{LL}(\hat Z_n)-H_{LL}(C_n)\|_1$ 锚定、高频由 $\mathcal{L}_{hf}$ 向目标恢复。这同时区别于透视世界模型『演化即输出』的紧耦合范式与 3D 方法『先建世界再渲染』的两段式范式。
方法步骤详情
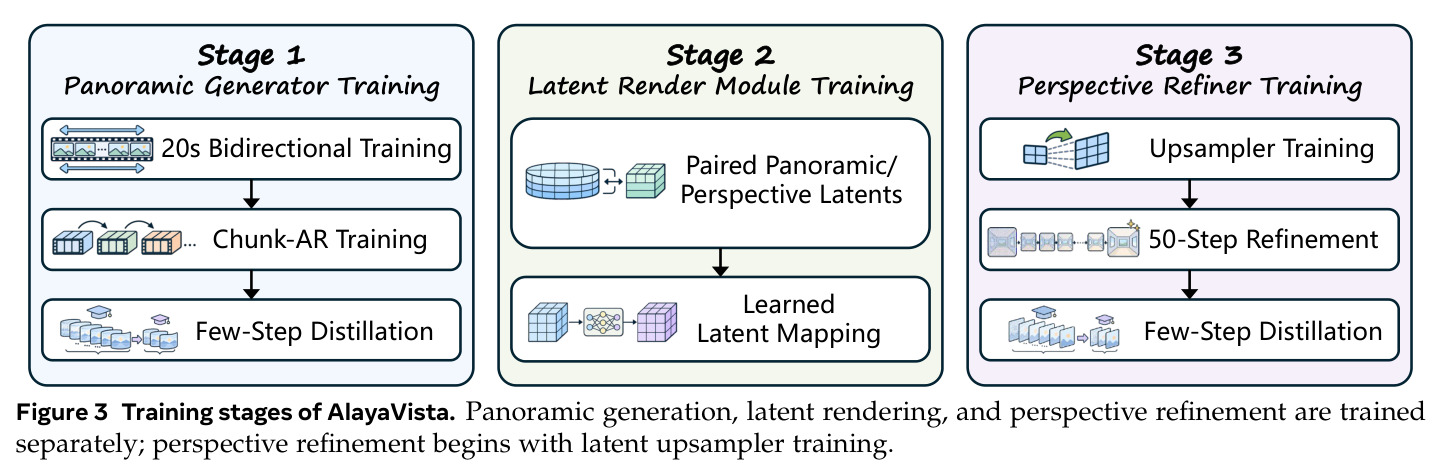
第一步,全景初始化:冻结的 HY-World 2.0 扩展模型 $O$ 把输入 $I_0$ 补全为 2:1 ERP 全景 $P_0$,再按重复图像编码(重复 13 个 RGB 帧)写入 Wan VAE,得到干净的 4 潜片初始化块 $Z_{init}$。第二步,全景状态推演:生成器 $G_\theta$ 以 $Z_{init}$、轨迹 $\Pi$、可选文本 $c$ 为条件做块自回归生成(每块 4 潜片约 16 帧),块内双向、块间因果,原生自注意力与 UCPE 相机通路各持 KV 缓存;几何上把宽轴 RoPE 换成球面构造(高频通道取整数经度谐波保证跨接缝周期性,低频通道用连续坐标 $\cos\phi\cos\lambda$、$\cos\phi\sin\lambda$),VAE 卷积加经度循环填充,相机通路用 $\Gamma_i=I\otimes T_i$ 变换 $q,k,v$ 且输出投影零初始化。第三步,潜视口渲染:视口参数 $\kappa$ 给出每帧 yaw/pitch/hFOV,把 30×60 的 ERP 潜网格映射为 18×32 透视网格——解析采样点加球面畸变特征构造查询,交叉注意力带投影足迹软几何偏置,输出 $Z_{view,LR}=S_\kappa(Z_{pan})+\Delta Z_{global}+\Delta Z_{local}$;每个非初始潜片保留 4 个视口位姿锚。第四步,确定性上采样:3D 残差块加 PixelShuffle 把网格放大到 36×64(512×288→1024×576),输出 $C=NN_{2\times}(Z_{view,LR})+\Delta Z_{raw}\oslash s$,末层零初始化,训练目标是 VAE 解码-双立方放大-再编码的 $Z_{car}$。第五步,载体条件精修:以 $\sigma_0$ 重加噪 $X_{n,\sigma_0}=(1-\sigma_0)C_n+\sigma_0\epsilon_n$,拼接干净载体与上一精修块前缀 $[\hat Z_{n-1},X_{n,\sigma},C_n]$,蒸馏后每块四步去噪。第六步,三组训练:全景生成器走『双向适配(10 秒→20 秒,掩码流匹配 $\mathcal{L}_{FM}$)→ 块自回归(扰动/回放历史再加自采样 rollout)→ 一致性蒸馏 + Self-Forcing++ 与 DMD 少步蒸馏』;渲染模块在冻结参考算子产生的缓存潜变量对上先训全局 transformer、冻结后再拟合局部适配器;透视精修器依次训上采样器、50 步质量训练 $\mathcal{L}_{Q}=\mathcal{L}_{FM}+\lambda_{str}\mathcal{L}_{str}+\lambda_{hf}\mathcal{L}_{hf}+\lambda_{perc}\mathcal{L}_{perc}+\lambda_{temp}\mathcal{L}_{temp}+\lambda_{bnd}\mathcal{L}_{bnd}$,最后四步 Self-Forcing 蒸馏 $\mathcal{L}_{SF}=\lambda_{DMD}\mathcal{L}_{refDMD}+\lambda_{str}\mathcal{L}_{str}+\lambda_{bnd}\mathcal{L}_{bnd}+\lambda_{rel}\mathcal{L}_{rel}$。
技术新颖性
技术新颖性体现在四个层面。架构层面,『全景潜状态 + 潜视口渲染 + 载体条件精修』的三级解耦是新的:先前工作要么把全景生成为主输出(PanoWorld-X、CamPVG、OmniRoam),要么先构建显式 3D 资产再渲染(MoVerse 的高斯脚手架、HY-World 2.0 的高斯/网格世界),AlayaVista 不需要几何提升与场景维护阶段,全景潜变量成为介于两者之间的中间表示。几何层面,SpheRoPE 球面 RoPE、经度循环 VAE 填充与 ERP 特化的 UCPE 射线注意力把 Wan2.2-TI2V-5B 的透视先验迁移到球面几何,渲染模块按『一个 Wan 潜片对应 4 个 RGB 帧』保留每片 4 个视口位姿锚,避免把相机运动坍缩成单一位姿。训练层面,渐进式策略把长窗口动力学、块自回归 rollout、独立训练的潜渲染、少步蒸馏分开优化,用 teacher-forced 加扰动历史暴露部署式不完美上下文,用 on-policy Self-Forcing++、DMD 和稀疏频谱锚稳定长时 rollout。数据层面,MUGEN 以 1,318 小时 ≥4K 真实全景视频加统一分层标注(视频级六属性、四轨道段级动态、16 类相机路径、ViPE 轨迹/深度/实例掩码)填补了生成导向全景数据的空白。
实验结果
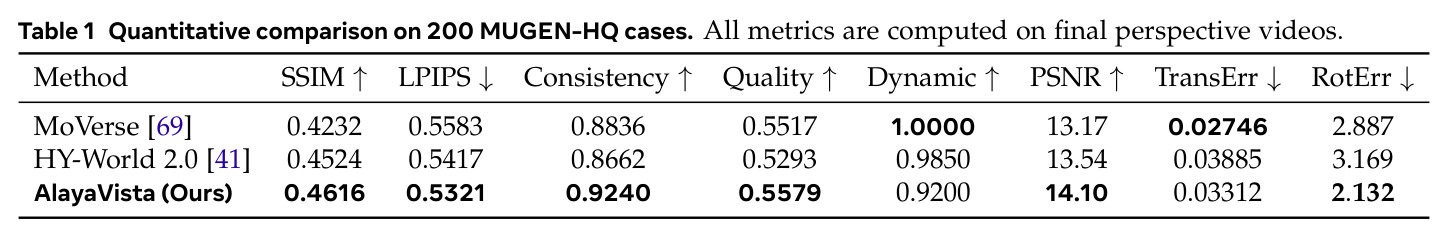
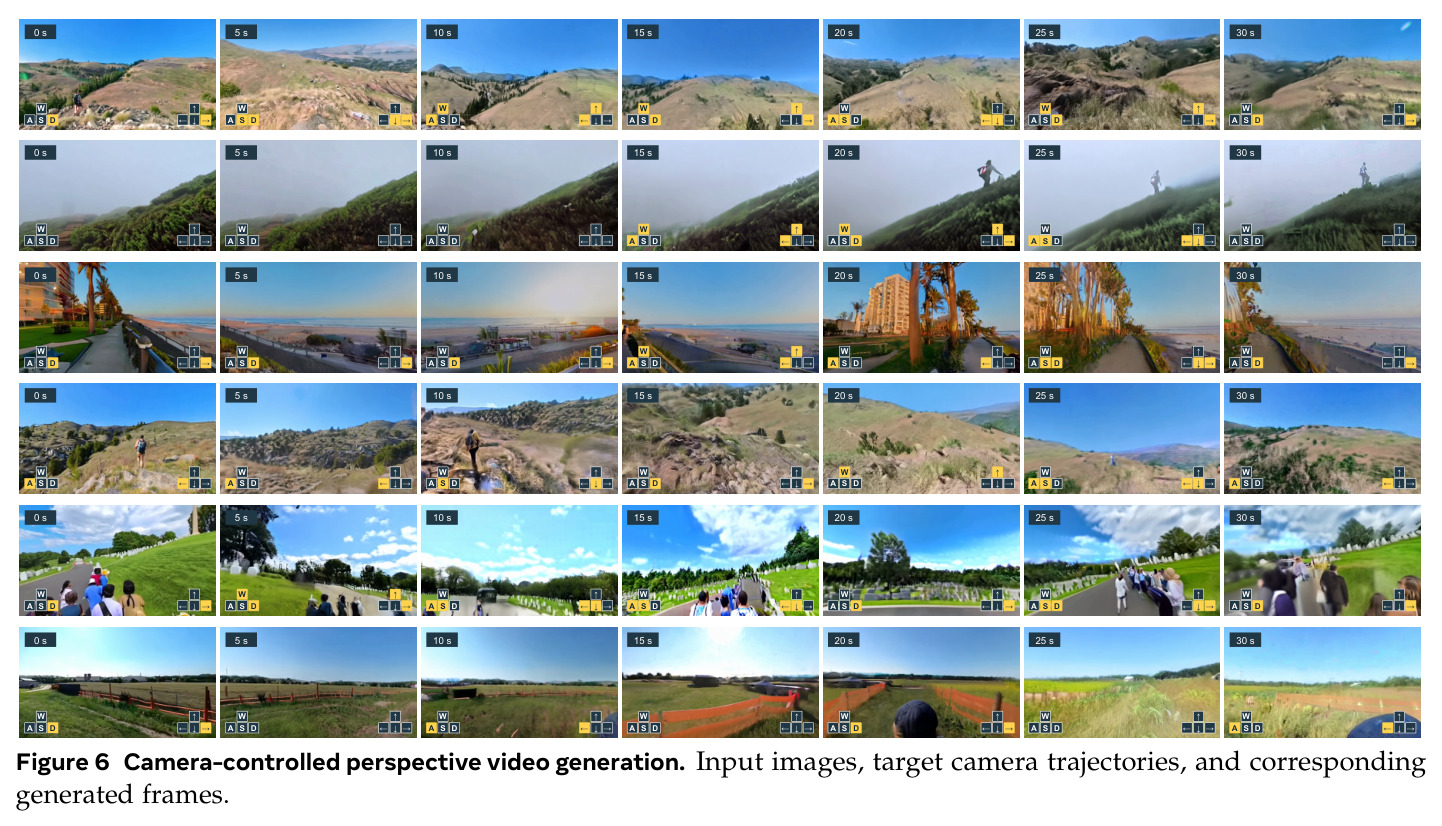
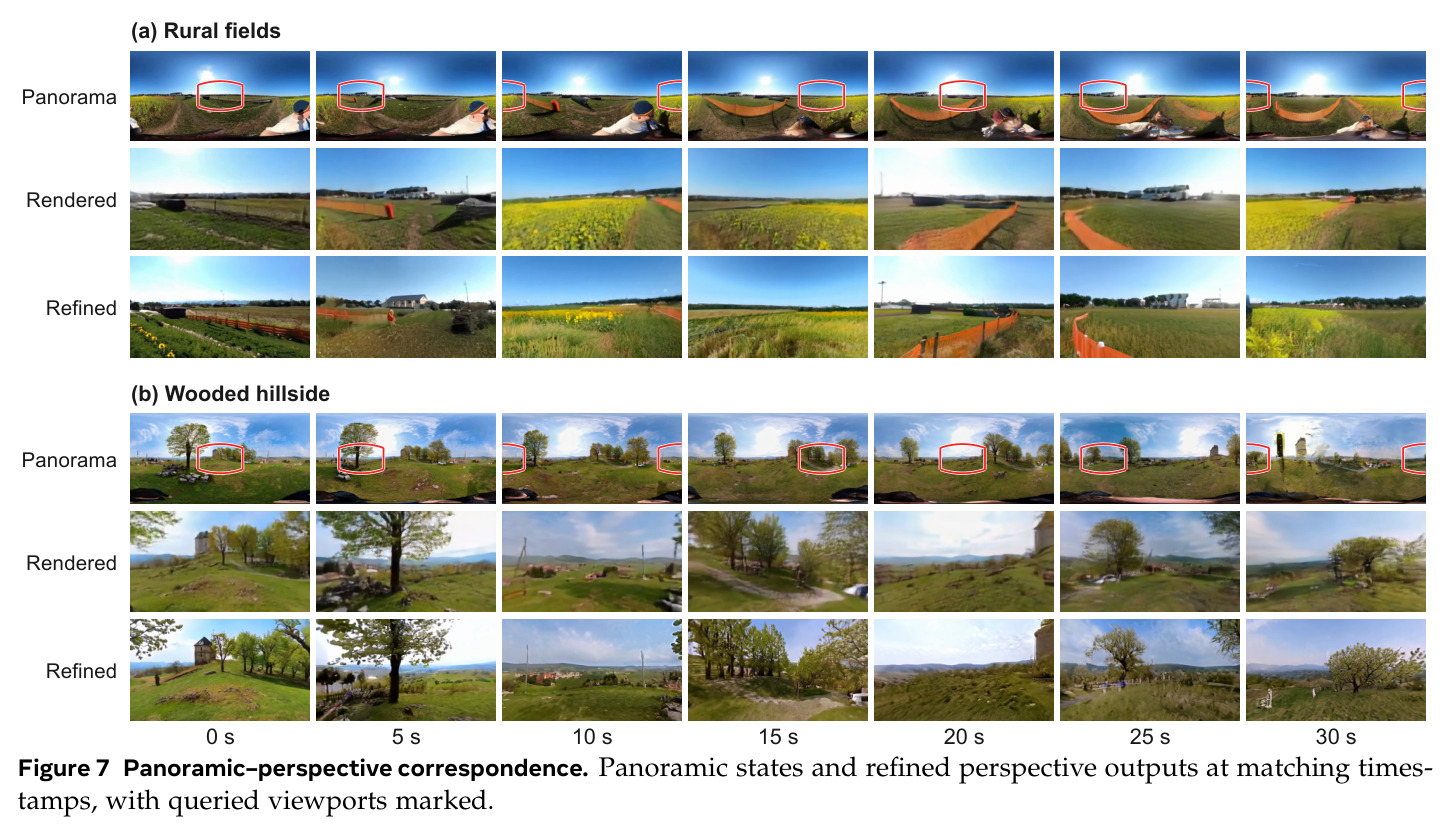
定量评测在 200 个 MUGEN-HQ 案例上进行:以 ERP 参考序列的透视投影为参考、首帧为输入,所有方法输出 81 帧、1024×576 的最终透视 RGB,与 MoVerse(取最终合成视频)和 HY-World 2.0(沿目标轨迹渲染 3DGS 场景)在同一观测空间对齐比较。AlayaVista 在 8 项指标中 6 项领先:SSIM 0.4616(HY-World 2.0 为 0.4524、MoVerse 为 0.4232)、LPIPS 0.5321(0.5417/0.5583)、PSNR 14.10 dB(13.54/13.17),与参考视频的重建一致性最好;VBench++ 时序一致性 0.9240 明显高于基线(0.8662/0.8836),质量分 0.5579 略优;相机可控性上旋转误差 RotErr 2.132 最低(3.169/2.887),对目标朝向跟踪最准。两个短板也有明确数字:Dynamic 分 0.9200 低于 MoVerse 的 1.0000 与 HY-World 2.0 的 0.9850,作者归因于潜渲染与精修对局部运动的衰减,是运动活跃度与时序一致性的折中;平移误差 TransErr 0.03312 优于 HY-World 2.0 的 0.03885 但差于 MoVerse 的 0.02746,显式 3D 高斯脚手架在合成期提供了更强的几何引导。定性上,Figure 6 展示 30 秒相机控制序列,Figure 7 在匹配时间戳上配对全景状态与精修输出,验证两表示的对应关系。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 透视视频重建一致性(200 例 MUGEN-HQ) | SSIM ↑ | 0.4616 | HY-World 2.0:0.4524;MoVerse:0.4232 | 较最优基线 +2.0% |
| 透视视频感知差异(200 例 MUGEN-HQ) | LPIPS ↓ | 0.5321 | HY-World 2.0:0.5417;MoVerse:0.5583 | 较最优基线 -1.8% |
| 透视视频像素保真(200 例 MUGEN-HQ) | PSNR ↑ (dB) | 14.10 | HY-World 2.0:13.54;MoVerse:13.17 | 较最优基线 +0.56 dB |
| 时序一致性(VBench++,200 例) | Consistency ↑ | 0.9240 | MoVerse:0.8836;HY-World 2.0:0.8662 | 较最优基线 +4.6% |
| 感知质量(VBench++,200 例) | Quality ↑ | 0.5579 | MoVerse:0.5517;HY-World 2.0:0.5293 | 较最优基线 +1.1% |
| 相机旋转可控性(ViPE 轨迹估计) | RotErr ↓ (度) | 2.132 | MoVerse:2.887;HY-World 2.0:3.169 | 较最优基线 -26.1% |
| 相机平移可控性(ViPE 轨迹估计) | TransErr ↓ | 0.03312 | MoVerse:0.02746;HY-World 2.0:0.03885 | 优于 HY-World 2.0,落后最优基线 MoVerse 20.6% |
| 运动活跃度(VBench++,200 例) | Dynamic ↑ | 0.9200 | MoVerse:1.0000;HY-World 2.0:0.9850 | 落后基线(运动衰减的折中) |
局限与改进
作者明确承认三点局限:其一,相机中心的全景状态本身不保证大位移相机运动下的持久空间记忆,相机走远之后回访区域的存储与一致性没有机制保障;其二,在高度动态的场景中缺乏严格几何一致性;其三,全景扩展阶段引入的错误(幻觉区域、伪影)会顺着生成管线传播放大。从指标和实验设计看还有额外问题:Dynamic 分数降至 0.9200(基线为 1.0000/0.9850)暴露了潜渲染的几何采样先验加精修低频锚定对快速运动的平滑倾向,对高动态交互应用可能是硬伤;TransErr 0.03312 劣于 MoVerse 的 0.02746,说明纯潜变量表示的几何精度仍不及显式 3D 表示;评测全部来自与训练数据同源的 MUGEN-HQ 的 200 个案例,缺乏跨域(游戏引擎、室内扫描等)检验;协议中提到 FVD 但结果表未报告该指标;『流式效率』只有定性描述,未给出端到端延迟与吞吐的具体数字;全文也没有人类偏好评测。
独立分析的弱点
弱点一:全景扩展误差传播。$P_0$ 中被幻觉补全的内容会被当作『事实』持续演化,初始化失真可能在长 rollout 中放大成整片区域漂移。改进方向:给生成器加入对 $P_0$ 的不确定性加权,或训练一致性判别器在 rollout 中修正与输入图像证据冲突的区域。弱点二:运动衰减。渲染模块的几何双线性采样先验偏好静态对齐,精修的 $\mathcal{L}_{str}$ 又把低频锚定在载体上,快速运动物体易被抹平(Dynamic 0.9200 vs MoVerse 1.0000);可引入运动感知损失或在载体中显式保留运动残差通道。弱点三:缺乏持久空间记忆。全景状态只携带当前位姿附近的上下文,长距离平移后的回访一致性无机制支撑;可借鉴 ReWorld 的位姿索引地标库,为全景状态附加稀疏空间记忆。弱点四:六个训练子阶段互不联调,误差在模块边界累积、训练成本高;可探索对渲染-精修接口做端到端微调。弱点五:评测生态单薄——仅在自有 MUGEN-HQ 上评 200 例、无人类评测、无延迟数字;应补充跨域基准、实时性基准与人因实验。
未来方向
作者在结论中提出三个方向:持久空间记忆(支撑大范围相机平移下的回访一致)、更强的几何感知目标(用显式深度或点轨迹约束潜状态)、更紧耦合的端到端训练以减少模块边界误差。基于本文成果还可以延伸:把视口选择从预设轨迹扩展为用户实时输入——Figure 6 已经展示 WASD 键位,可进一步做成真正的交互式系统并测交互延迟;把全景状态扩展为多尺度金字塔,让远处的低频布局与近处的中频结构分层维护;利用 MUGEN 的 16 类相机路径词表和四轨道段级标注训练语言可控的世界编辑(『绕过这栋楼』『回到刚才的路口』);将管线与音频流结合构建视听一致的世界模型;在蒸馏端追求更少步数(1–2 步)与更高视口分辨率(如 4K),并探索把上采样器换成单步前馈网络以进一步压缩延迟。
复现评估
代码与项目页已给出(github.com/AlayaLab/AlayaVista、alaya-lab.github.io/AlayaVista),但论文未明确承诺开源模型权重与 MUGEN 数据本体。数据方面风险较大:MUGEN 从 YouTube 爬取(9,544 个候选源筛到 6,446 个),完整再分发可能涉及版权,更可能只放出标注、切分与下载脚本;好在所有依赖组件都是公开的——Wan2.2-TI2V-5B、HY-World 2.0 全景扩展、ViPE、TransNetV2、COVER,Sekai2 全景子集也已公开。算力方面,标注管线耗 30,000+ GPU·小时,模型训练算力未披露,但考虑到 5B 级视频扩散 transformer 的六阶段训练加 1,318 小时语料,估计需要数百张 A100/H100 级别的卡。复现难度高:一致性蒸馏、EMA 目标、Self-Forcing++/Self-Forcing、DMD、稀疏频谱锚、扰动历史等技巧环环相扣,任何一环偏差都会损害长时稳定性;评测还需复刻 200 案例 MUGEN-HQ 协议并用 ViPE 重估轨迹。对多数读者,等待官方权重与 demo 是最现实的路径。
论文图表
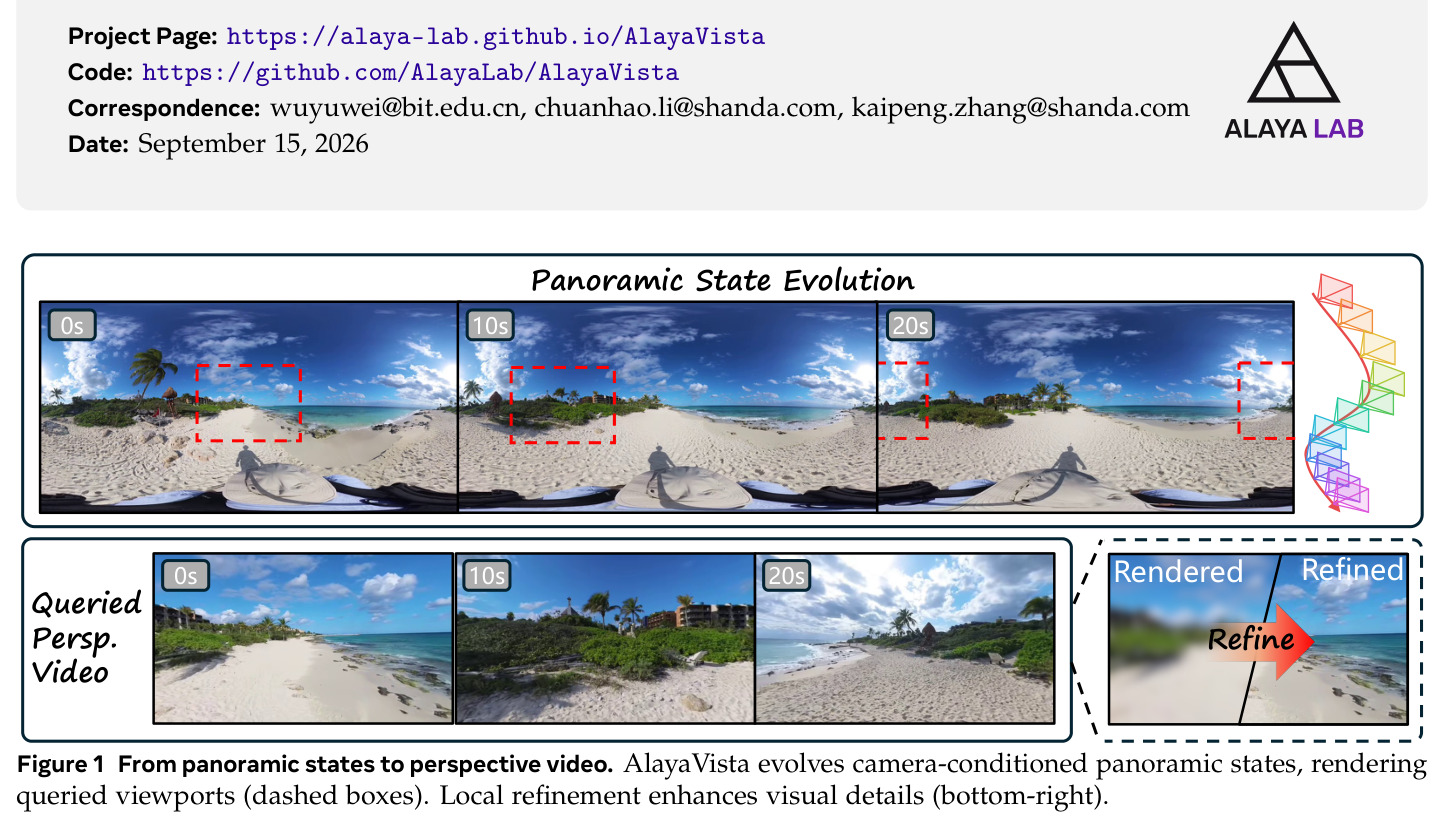
开篇效果图:上排展示全景状态随时间(0s/10s/20s)的演化,下排展示同一时间段内根据查询视口(虚线框)渲染出的透视视频帧,右下角对比渲染结果与局部精修后的细节差异。
一图道破全文核心思想:世界以全景潜状态全局演化,用户视角只是其中的一个查询视口,且只有视口才做高保真精修。看懂这张图就理解了『全局-局部解耦』的直观含义。