SpectralShift:基于谱重参数化的 Gated DeltaNet 高效上下文窗口扩展 SpectralShift: Effective Context Window Extension of Gated DeltaNet via Spectral Reparameterization
谱重参数化 GDN 门控衰减谱并缩放其学习率,高效扩展线性注意力模型的上下文窗口
前置知识
Gated DeltaNet(GDN,门控增量网络)
线性注意力循环架构:每头维护矩阵状态 $S_t$,按 $S_t = A_t S_{t-1} + \Delta_t$ 更新,遗忘门 $\alpha_t$ 控制旧状态保留比例,写入门 $\beta_t$ 控制写入强度,写入量取当前值与旧状态预测之差。训练可并行、推理循环执行,复杂度随长度线性增长。
本文的一切分析和干预都建立在 GDN 的转移矩阵 $A_t$ 之上,方法直接重参数化产生 $\alpha_t$ 的 α 投影。不懂这个更新规则就无法理解慢/快谱带的来源和 SpectralShift 改的是什么。
转移矩阵的谱(奇异值)分析与衰减率
跨越距离 $\ell$ 的信息存活由转移矩阵 $\Phi_{i\to j}$ 决定:其奇异值 $\sigma_r$ 给出衰减率 $\gamma_r$,倒数即记忆时间尺度。满足 $\sigma_r \ge e^{-1}$ 的方向构成慢谱带,可携带信息;其余方向快速衰减,负责清空过时状态。
论文的核心概念慢谱带、方法的理论推导(Lemma 1、Theorem 1/2)与诊断指标 $H_{\text{slow}}$、$M_{\text{slow}}$、$E_{\text{write}}$ 全部由这套谱语言定义,是读懂全文的钥匙。
长上下文持续预训练与位置编码扩展(CPT / ABF / YaRN / DroPE)
做法是把短上下文(如 8K)训练好的模型在更长序列上继续预训练(CPT),同时调整 softmax 注意力的位置编码:ABF 放大 RoPE 基频,YaRN 做插值并缩放注意力温度,DroPE 丢弃位置嵌入。基线即「调位置编码 + 长序列 CPT」,对线性注意力层不做专门处理。
这是本文的对照基线和出发点:作者指出线性注意力层被盲目直接扩展,而 SpectralShift 正是补上这一环,且需证明与各种位置编码方案兼容可叠加。
NIAH(大海捞针)探针
长上下文检索测试:在长文本某位置插入关键信息(针),在末尾提问,考察能否取回。本文用 Single-1/2/3 探针做谱分析,针放于 0.2–0.8 相对位置,针-查询距离 1619–26195 token;RULER 含多键/多查询/多值 NIAH、词频抽取、变量追踪与 QA 等 13 个子任务。
作者用 NIAH 成绩定义高/低检索模型对,并从针位置到查询位置的转移矩阵上计算慢谱带与写入对齐度,把检索好坏归因到谱性质,实验验证也以 NIAH/RULER 为主。
研究动机
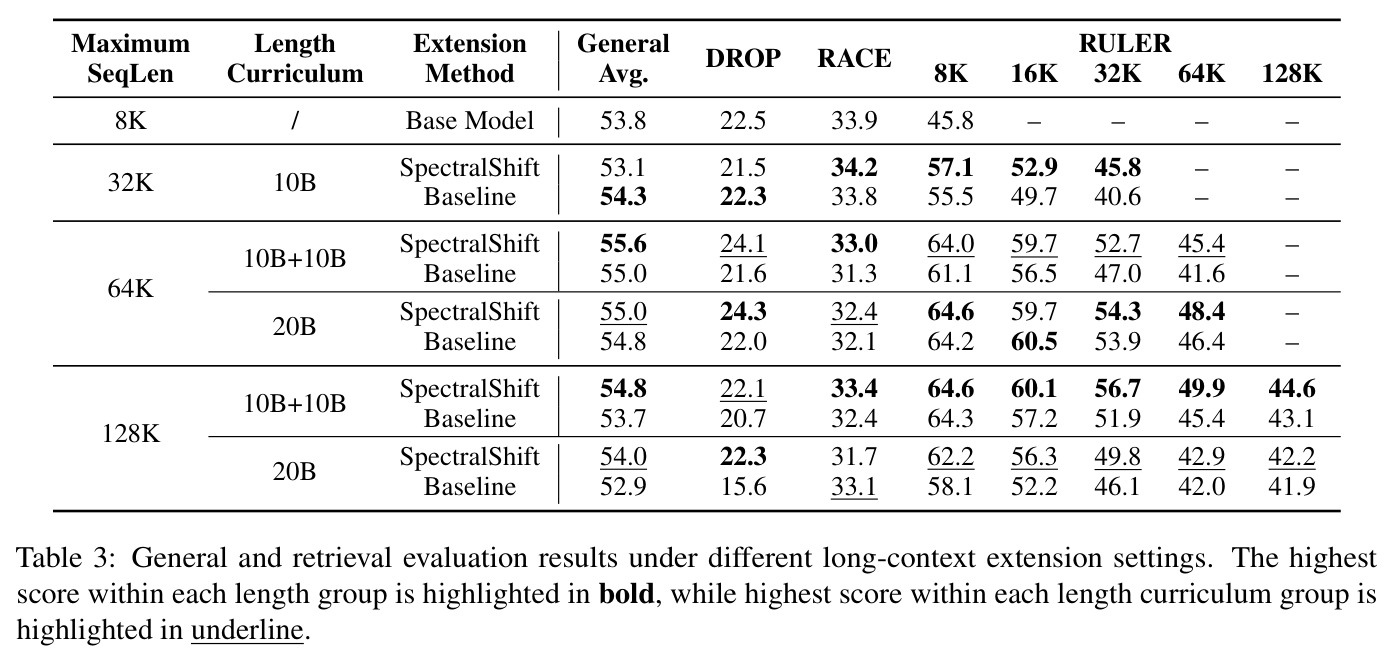
混合架构已成为长上下文大模型的主流:MiniMax-01、Nemotron-H、Qwen3.5、Kimi Linear 等都在部分层用线性注意力(如 Gated DeltaNet)替换 softmax 注意力,宣称支持高达 1M token 的上下文。但现有上下文扩展技术几乎全部围绕 softmax 注意力的位置编码展开(PI、ABF、YaRN 等),线性注意力层只是被按新长度直接继续预训练,循环状态动力学从未被针对性调整。与全注意力保留所有历史 token 不同,循环模型必须把全部历史压缩进有限维状态 $S_t \in \mathbb{R}^{d_k \times d_v}$,长程能力受制于状态转移能否在所需依赖距离上保留信息。作者观察到明显失配:在 8K 学到的遗忘/写入动力学不适合更长上下文——基线从 8K 直接扩到 32K 时 RULER-32K 只有 40.6 分,低于其原生 8K 的 45.8 分;扩到 128K 时 RULER-128K 仅 43.1 分。可见「换位置编码再训练」对线性注意力层并不足够,存在明确的方法空白。
本文的目标是本文目标分两层。分析层面:从谱动力学搞清 GDN 的长程检索由什么决定——用有限时间转移矩阵 $\Phi_{i\to j} = A_j \cdots A_{i+1}$ 的奇异值刻画各状态方向在依赖距离 $\ell$ 上的衰减率 $\gamma_r = -\frac{1}{\ell}\log \sigma_r(\Phi_{i\to j})$,定义慢谱带 $S_\ell = \{r : \sigma_r \ge e^{-1}\}$(时间尺度覆盖 $\ell$ 的方向),并检验两个量与大海捞针成绩的关系:慢谱带宽度($H_{\text{slow}}$ 个层-头、$M_{\text{slow}}$ 个模式)与写入键对慢输入子空间的对齐度 $E_{\text{write}}$。方法层面:设计只在 CPT 阶段生效、近零开销的重参数化方法 SpectralShift,在把上下文从 8K 扩到 32K/64K/128K 时选择性放大慢衰减模式、保留快衰减模式,使长上下文检索持续优于朴素扩展基线,同时不损害 MMLU 等通用能力,并兼容不同位置编码方案与纯线性注意力模型。
与已有工作不同的是,已有线性循环架构的扩展研究集中在 Mamba 系:Universal Position Interpolation、Mamba Modulation 通过插值或调制改变状态演化,LongMamba、DeciMamba、ReMamba 通过滤波或状态冻结控制状态幅值;而已进入 Qwen3.5、Kimi Linear 等主流模型的 DeltaNet/GDN 系此前基本无人系统研究。本文独特切入有三点。第一,把衰减率精确分解为 $\gamma_r = \gamma^\alpha + \gamma^{R,r}$:头内共享的标量门控项与增量规则方向项 $\gamma^{R,r}$,后者同时依赖转移矩阵与写入键 $k_t$、难以直接修改,从而把干预点锁定在 α 投影上。第二,提出「宽度 + 利用率」双条件:只有慢谱带足够宽、且写入方向落在慢子空间内(高 $E_{\text{write}}$)时检索才好,二者缺一不可。第三,给出带理论证明的初始化重参数化与学习率缩放规则(最优指数 $k = 0.5$ 可推导),而非启发式的状态幅值控制。
核心方法
直觉上,把上下文从 $L_{\text{ref}}$ 扩到 $L_{\text{tar}}$ 需要让更多方向的时间尺度覆盖新距离,即加宽慢谱带 $S_\ell$,同时不破坏负责快速清空状态的快衰减模式。SpectralShift 分两步。第一步谱初始化:遗忘门由 α 投影产生,按权重全局均值分解为 $a_t = c_t + \xi_t$,$c_t$ 是头共享幅值成分,$\xi_t$ 是输入相关偏差成分;重参数化为 $a_t(s_1) = c_t + s_1 \xi_t$,权重上即 $W^*_\alpha = \mu_\alpha^{\text{ref}} J + s(W_\alpha^{\text{ref}} - \mu_\alpha^{\text{ref}} J)$,最优因子 $s = (L_{\text{ref}}/L_{\text{tar}})^{0.5}$ 由尺度匹配推导。第二步长度缩放 CPT:只把 α 投影学习率乘以同一因子,防止整个头的共享衰减被集体推向过快或过慢区域,而 β、键、值投影按原学习率适应新长度数据。两步合成 Algorithm 1:加载时重参数化再正常训练。
核心创新是把「改哪个参数才能改谱」精确化。衰减率可分解为 $\gamma_r = \gamma^\alpha + \gamma^{R,r}$:方向项 $\gamma^{R,r}$ 由增量规则定向部分 $R_{i\to j}$ 决定、同时受写入键影响,编码「写什么、往哪写」,动它容易破坏已学到的 Delta 写入行为;而 $\gamma^\alpha$ 是头内所有奇异模共享的标量衰减,只由 α 门控制。SpectralShift 因此只动 α:把门控输出拆成共享成分 $c_t$ 与偏差成分 $\xi_t$,只缩放偏差。Lemma 1 证明对 $0 < s_1' < s_1 \le 1$:若 $\xi_t > 0$ 则 $\alpha_t(s_1') > \alpha_t(s_1)$(遗忘变慢),若 $\xi_t < 0$ 则反之(遗忘变快)——缩小 $s_1$ 会按输入内容异质地重新分配遗忘速度,让偏差为正占优的头整体偏向慢传播,而方向转移在重参数化瞬间完全不变。这与已有方法「整体缩放状态幅值」有本质区别:它是有符号、内容依赖、方向保持的谱整形,快慢两种动力学可同时被照顾。
方法步骤详情
完整流程(Algorithm 1):第一步,计算缩放因子 $s = (L_{\text{ref}}/L_{\text{tar}})^{1/2}$,8K→128K 时 $s = 0.25$。第二步,从检查点提取所有 GDN 层的 α 投影权重,计算其全局均值,输出 $W^*_\alpha = \mu_\alpha J + s(W_\alpha - \mu_\alpha J)$,其余参数原样保留。第三步,单独设置 α 投影学习率 $\eta_\alpha^{\text{tar}} = s\,\eta^{\text{tar}}$,其他模块不变。第四步,在目标长度数据上做标准 CPT(每步 8M token),64K/128K 用两阶段课程(先到 32K,各 10B token)。实验配置:基座为 1.5B/0.6B 激活的 GDN-MoE,16 层,12 个 GDN 层 × 8 键头共 96 个分析层-头;基座以 500B token、Muon、lr 8.6e-4、8192 上下文从头预训练。
技术新颖性
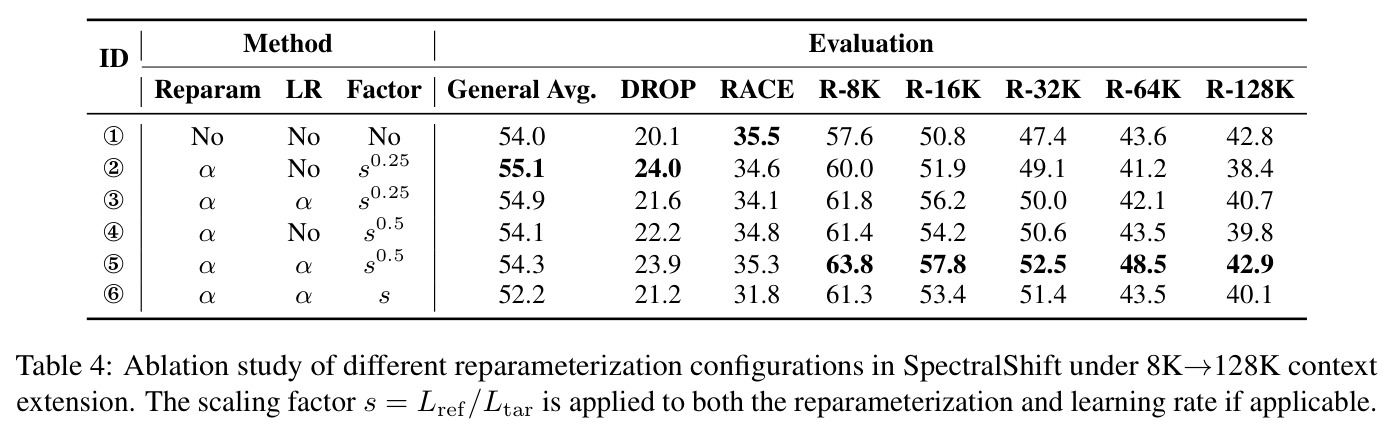
新颖性体现在理论与工程两层。理论上:Lemma 1 证明缩放偏差对 α 的逐点单调影响由 $\xi_t$ 符号决定;Appendix C 通过尺度匹配条件证明幂律族 $s_k = (L_{\text{ref}}/L_{\text{tar}})^k$ 中最优指数为 $k = 0.5$(表 4 消融证实 $s^{0.5}$ 优于 $s^{0.25}$ 与满缩放);Theorem 1 给出 α 学习率缩放后头级共享衰减的一阶漂移上界 $\le C_\alpha s^2 \eta_\alpha$;Theorem 2 把最终谱位移写作 $D_r = \delta_r^{\text{init}} + \delta_r^{\text{CPT}}$,证明在可验证充分条件下整个 CPT 保持 $D_r \ge g^\star/(2\ell) > 0$,即参考慢模式保留、近边界模式进入慢带、快头保持快。工程上,方法只需改一个投影的初始化和一个学习率,成本几乎为零,却是首个针对 GDN/DeltaNet 系、从有限时间转移矩阵谱出发的长上下文扩展方案,与位置编码方法正交可叠加,并能推广到纯线性注意力模型。
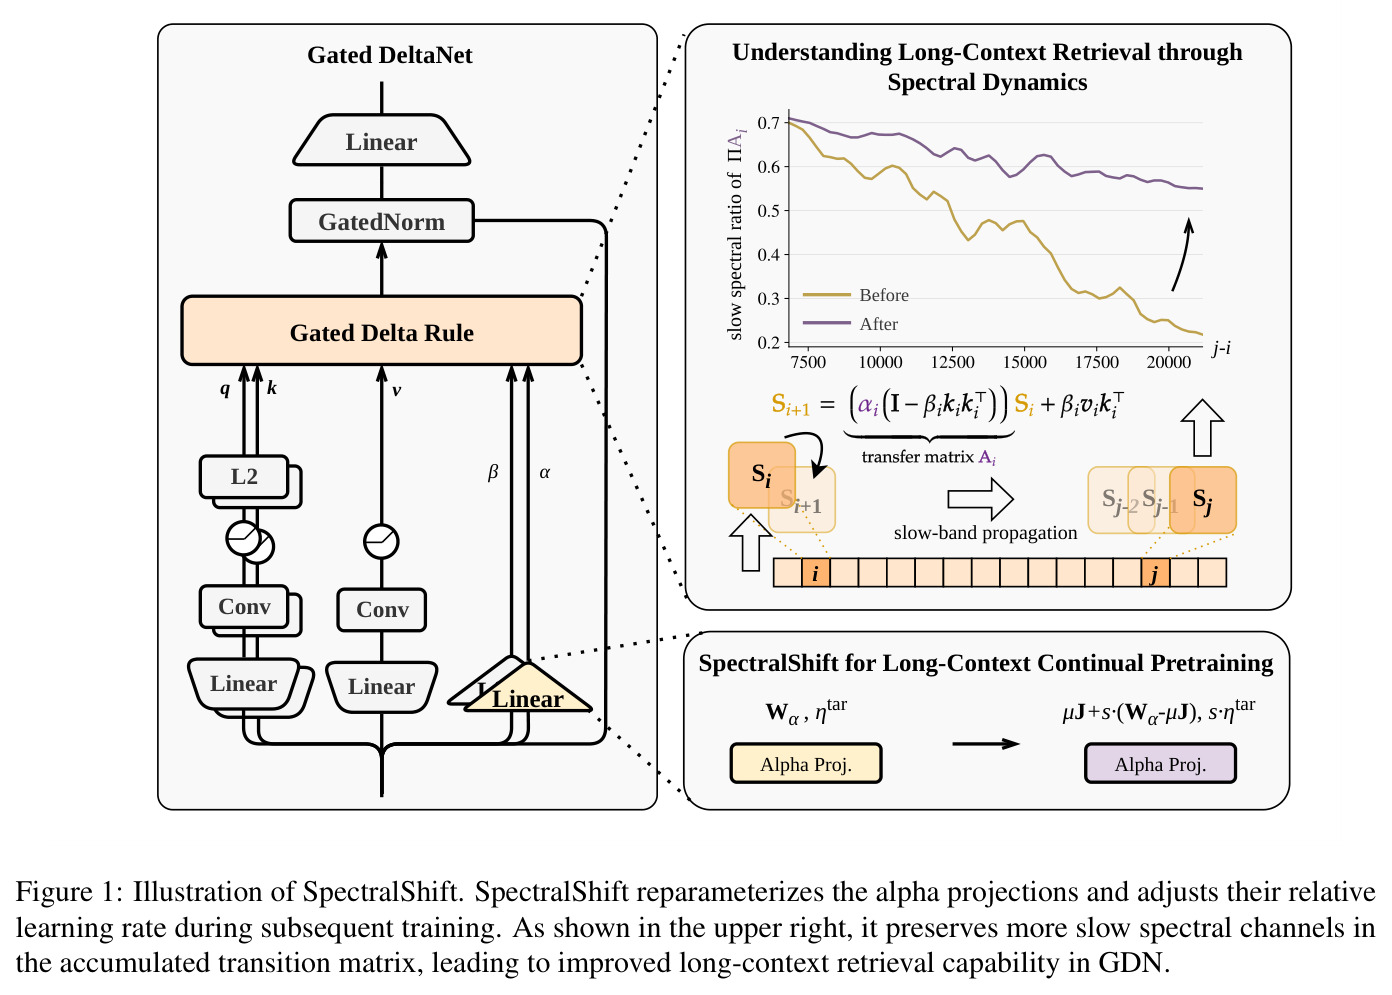
实验结果
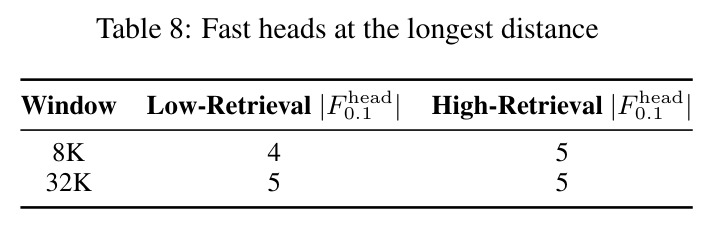
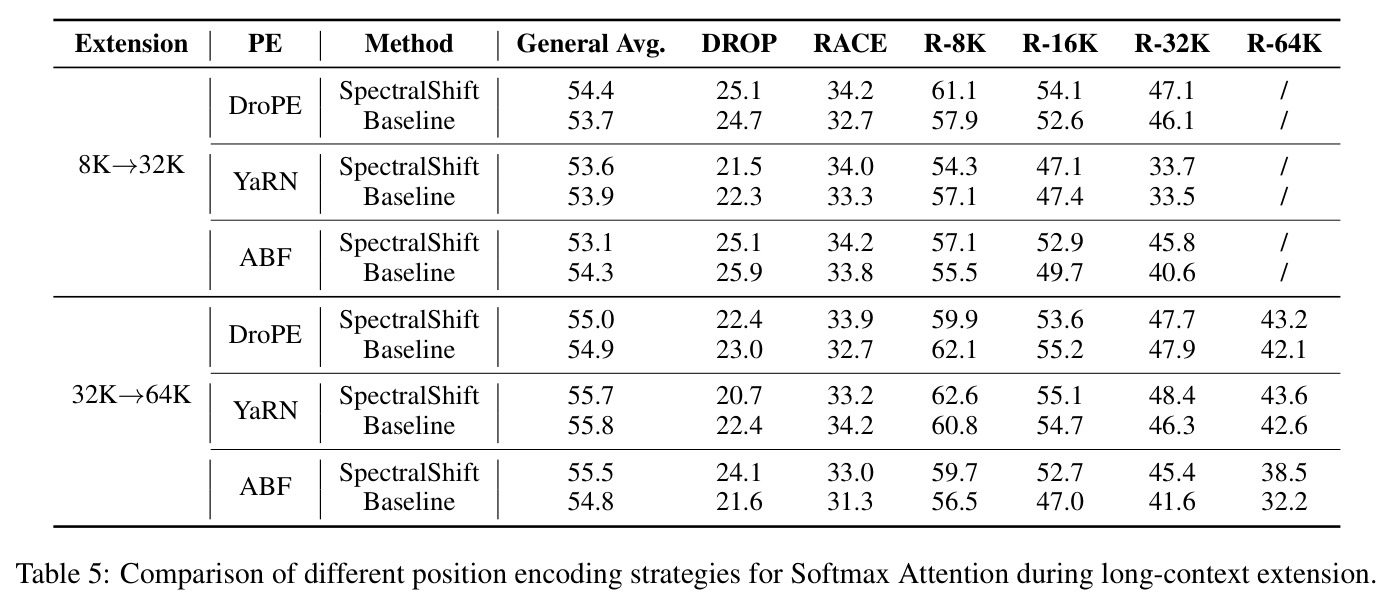
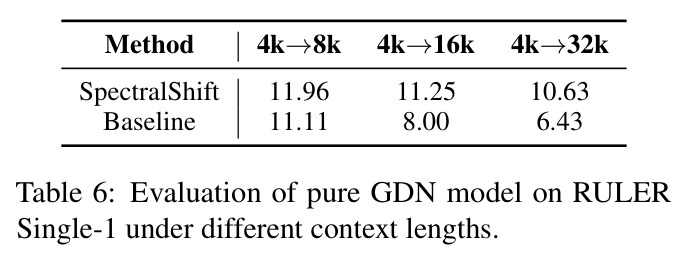
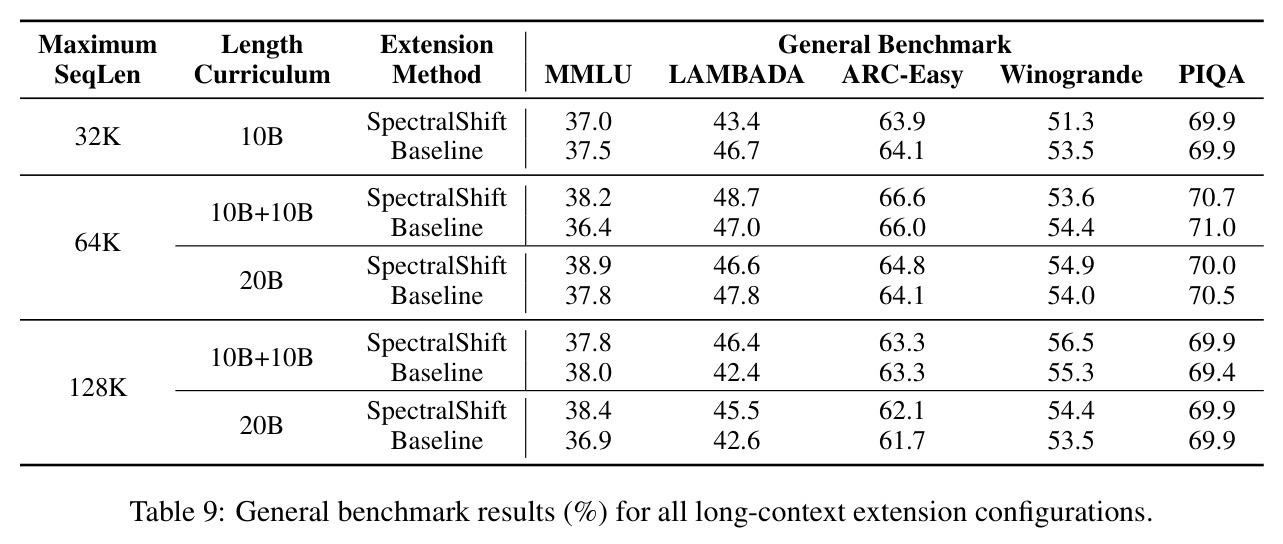
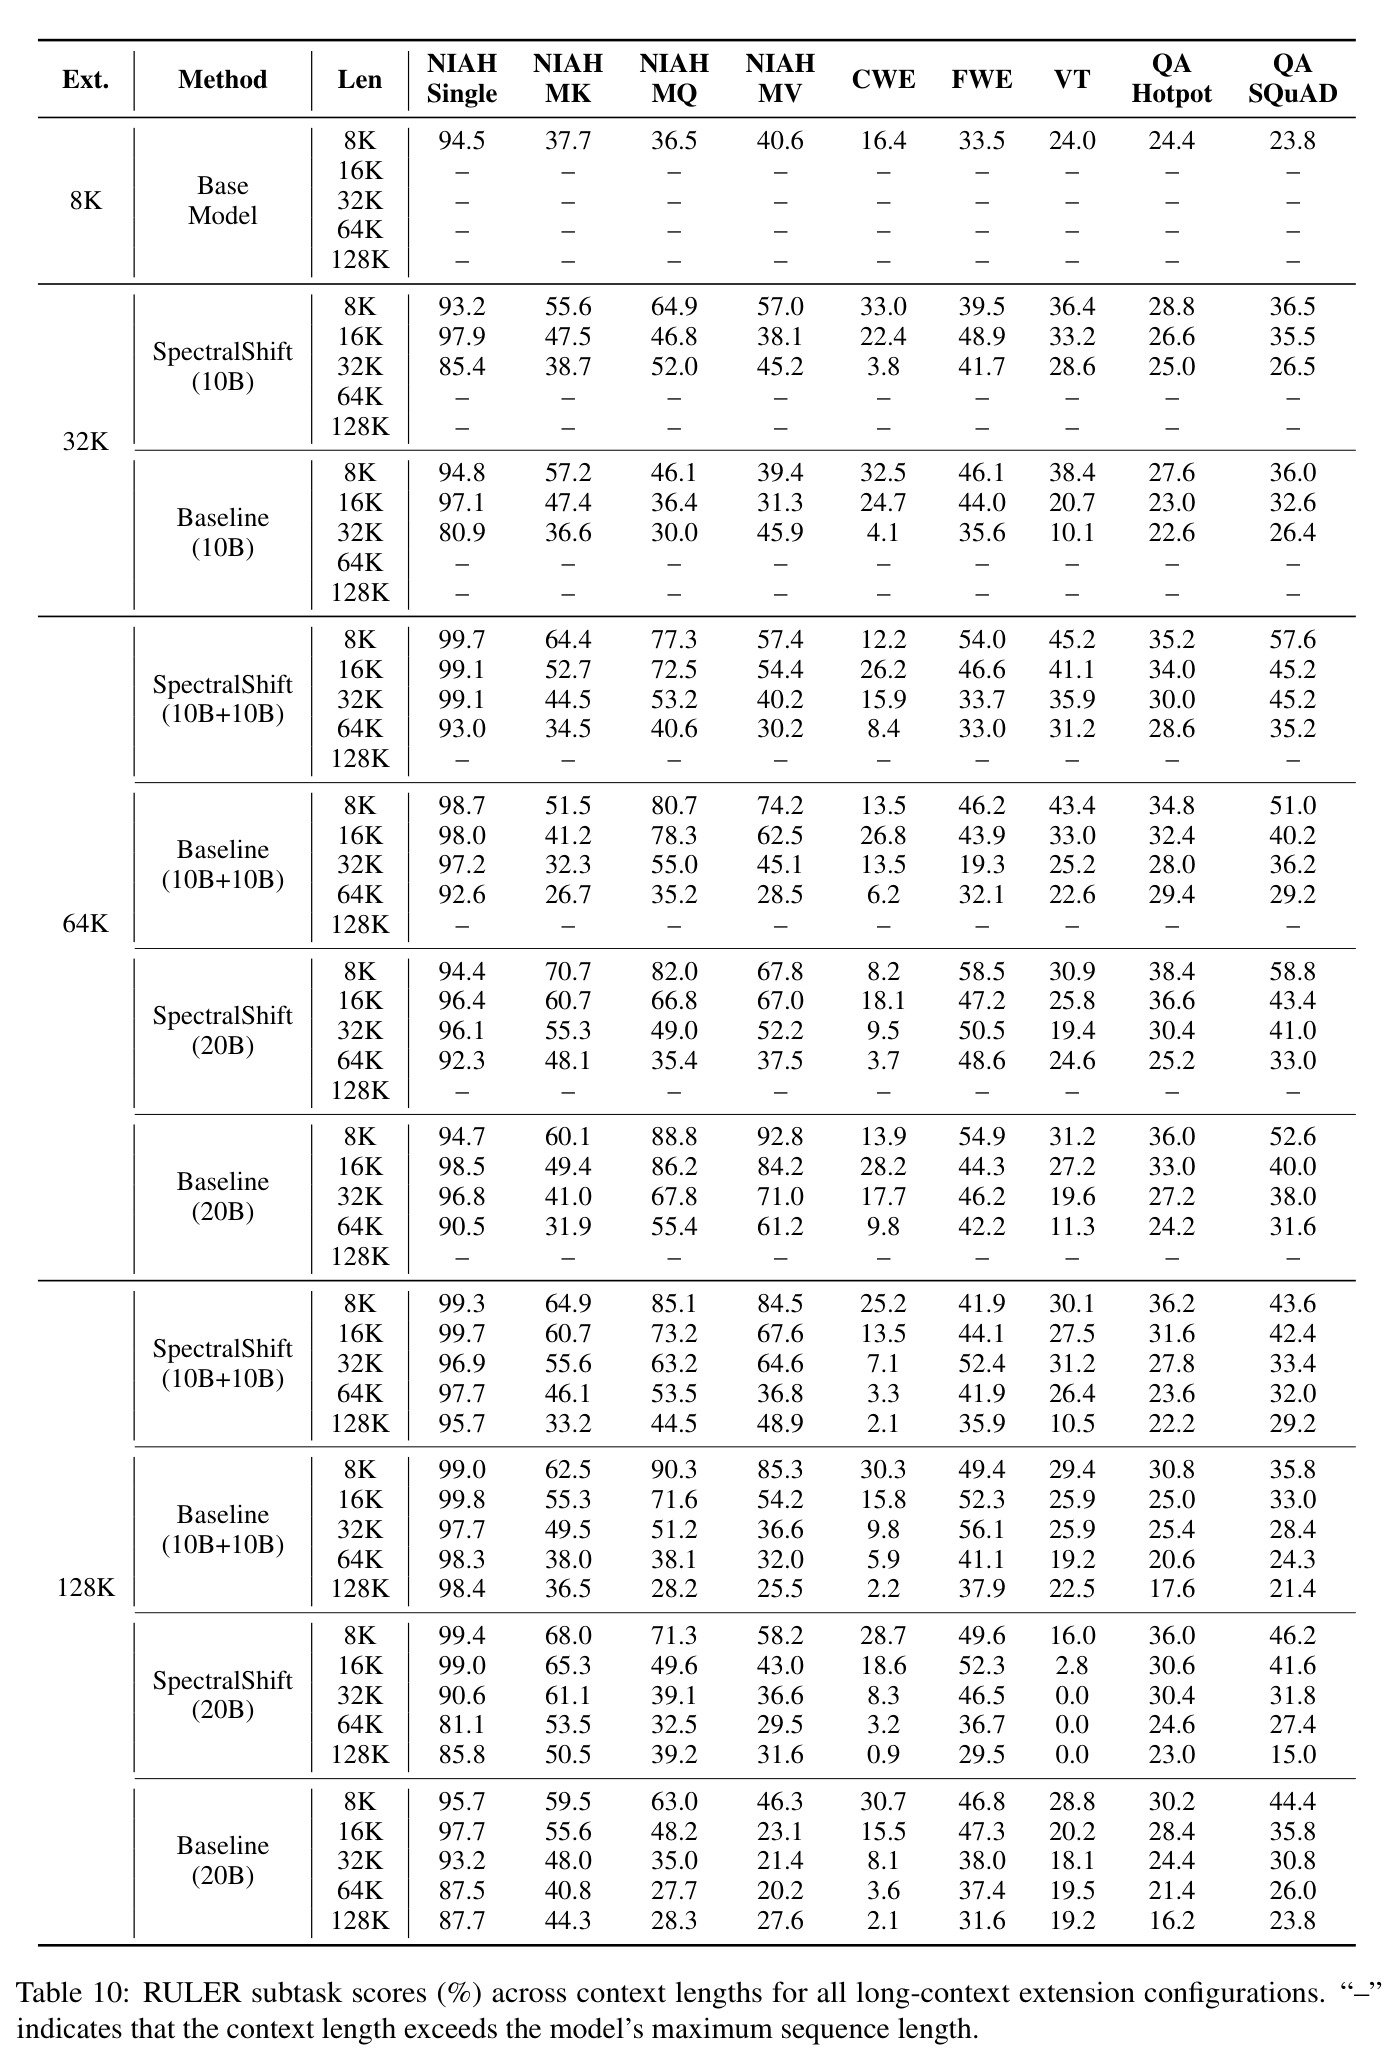
分析证实「宽度+利用率」假说:表 1 中高检索模型在最长距离上有 1308 vs 1036 个慢模、分布在 22 vs 18 个层-头(32K:1109 vs 984);表 2 中写入对齐度 $E_{\text{write}}$ 为 0.1503/0.1819,高于低检索 0.1006/0.0964,NIAH 均分 32.93/30.47 vs 8.60/10.07;表 8 显示快头不变。主结果(表 3):128K 两阶段下 RULER 五长度平均 55.18 vs 52.38(相对提升 5.35%),RULER-64K 49.9 vs 45.4,通用平均 54.8 vs 53.7 持平;32K 扩展 RULER-32K 45.8 vs 40.6。消融(表 4):重参数化+学习率缩放 $s^{0.5}$ 最优(RULER-64K 48.5 vs 43.6);仅重参数化 43.5,满缩放 $s$ 令通用分降至 52.2。表 5:三种位置编码下最长评估均占优(ABF 8K→32K 45.8 vs 40.6)。表 6 纯 GDN 上增益随长度扩大(4k→32k:10.63 vs 6.43)。
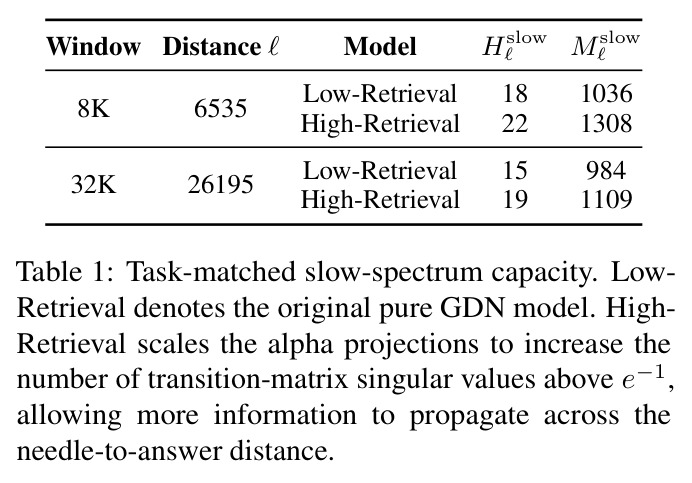
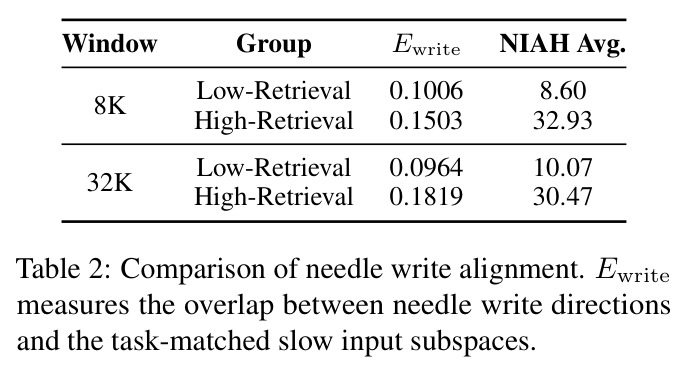
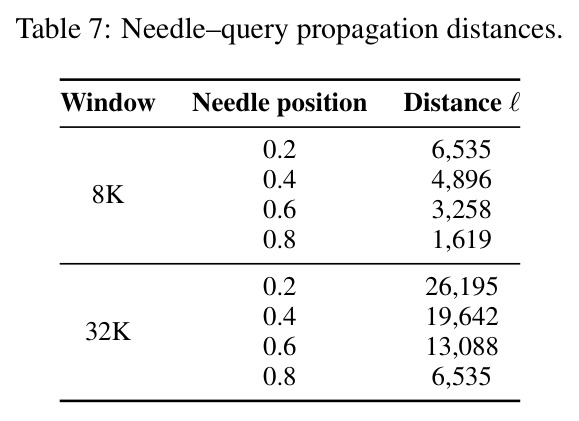
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 长上下文检索(8K→128K 两阶段 10B+10B 扩展) | RULER 五长度平均分 | 55.18 | 52.38 | +2.80 分(相对提升约 5.35%) |
| 长上下文检索(8K→128K,评估长度 64K) | RULER-64K | 49.9 | 45.4 | +4.5 分 |
| 长上下文检索(8K→32K 单阶段 10B 扩展) | RULER-32K | 45.8 | 40.6 | +5.2 分 |
| 通用短上下文能力(128K 扩展,10B+10B 课程) | MMLU/LAMBADA/ARC-Easy/WinoGrande/PIQA 平均 | 54.8 | 53.7 | +1.1 分(长上下文提升同时通用不降) |
| 消融:α 重参数化 + 学习率缩放 $s^{0.5}$(8K→128K) | RULER-64K | 48.5 | 43.6(无干预配置①) | +4.9 分;只用重参数化(④)仅 43.5,证明两组件互补 |
| 位置编码兼容性(32K→64K,ABF) | RULER-64K | 38.5 | 32.2 | +6.3 分 |
| 纯 GDN 模型上下文扩展(4k→32k) | RULER Single-1 | 10.63 | 6.43 | +4.20 分,且增益随目标长度增大(8k 时仅 +0.85) |
局限与改进
作者承认的局限:方法专为 GDN 设计,未在 DeltaNet 之外的其他线性注意力变体上验证;所有实验只在 1.5B-A0.6B 规模的 MoE 基座上进行,由于算力限制无法在 Qwen3.5 这类已开源超长上下文的大型混合模型规模上验证。我的补充观察:第一,部分设置收益有限甚至为负——YaRN 8K→32K 时通用平均 53.6 略低于基线 53.9、RULER-32K 33.7 vs 33.5;32K 10B 设置下 LAMBADA 43.4 低于基线 46.7,说明收益与位置编码方案和数据混合存在交互。第二,RULER 绝对分数仍低(32K 扩展模型在 32K 评估仅约 45 分),表 10 中 CWE 子任务在 32K 评估跌到 3.8–4.1 分,长上下文能力离实用尚远,方法只是减缓而非解决状态容量瓶颈。第三,理论依赖固定轨迹、有界雅可比等局部正则条件,只是「局部初始化机制」而非全局保证;慢带阈值 $e^{-1}$ 和快头阈值 $\tau_0 = 0.1$ 均为启发式常数。第四,谱分析仅用 NIAH 探针构造结论,未覆盖真实长文档、代码库或 agentic 任务。
独立分析的弱点
独立分析几点弱点。其一,全局统一缩放因子:所有层、所有头共用同一个 $(L_{\text{ref}}/L_{\text{tar}})^{0.5}$,但慢带分布高度不均(96 个层-头中仅 15–22 个拥有任务匹配慢模),按实测 $\tau_1$ 或 $\gamma^\alpha$ 逐头自适应设定 $s_h$ 与 $\eta_{\alpha,h}$ 可能更高效。其二,方法仍依赖完整 CPT(10B–20B token),无法零训练成本扩展;若能结合推理时谱校正或仅微调 α 投影的短程适配会更实用。其三,评估集中在合成检索(NIAH/RULER),缺少长文档问答、仓库级代码理解、agentic 任务等下游验证,「慢带变宽→下游收益」的因果链未在真实任务上闭合。其四,绝对检索能力仍低(RULER-32K 约 45 分、CWE 接近随机),说明 α 谱整形只解决保留侧瓶颈,写入侧与状态维度容量并未扩容,需与增大状态、Mixture-of-Memories 等手段结合。其五,理论只有一阶/局部条件,$k = 0.5$ 依赖中心化二阶色散的长度标度律假设,在其他数据混合上的普适性未检验。
未来方向
作者提出:谱洞察与方法有望推广到现代混合架构的上下文扩展,助力构建更强长上下文基础模型。可延伸方向包括:把 SpectralShift 应用到 Kimi Delta Attention、Mamba-2 等其他门控循环层,检验谱分解框架 $\gamma_r = \gamma^\alpha + \gamma^{R,r}$ 的普适性;在 7B–100B 级混合模型(如 Qwen3.5、Kimi Linear)上验证规模效应,观察慢带宽度是否随规模与训练 token 数自然增长;发展逐头自适应缩放,用 $\tau_1$、$\gamma^\alpha$ 等可观测量在线设定每头的缩放因子,甚至把慢带宽度作为训练早期的长上下文潜力预测指标(scaling-law 式诊断);与写入侧改进结合,如在训练目标中加入慢子空间写入对齐正则直接优化 $E_{\text{write}}$;建立与 Mamba 系方法(Mamba Modulation、LongMamba、DeciMamba)的统一谱位移理论框架;在 Mixture-of-Memories 等多状态架构上定义多状态慢带并做选择性扩容。
复现评估
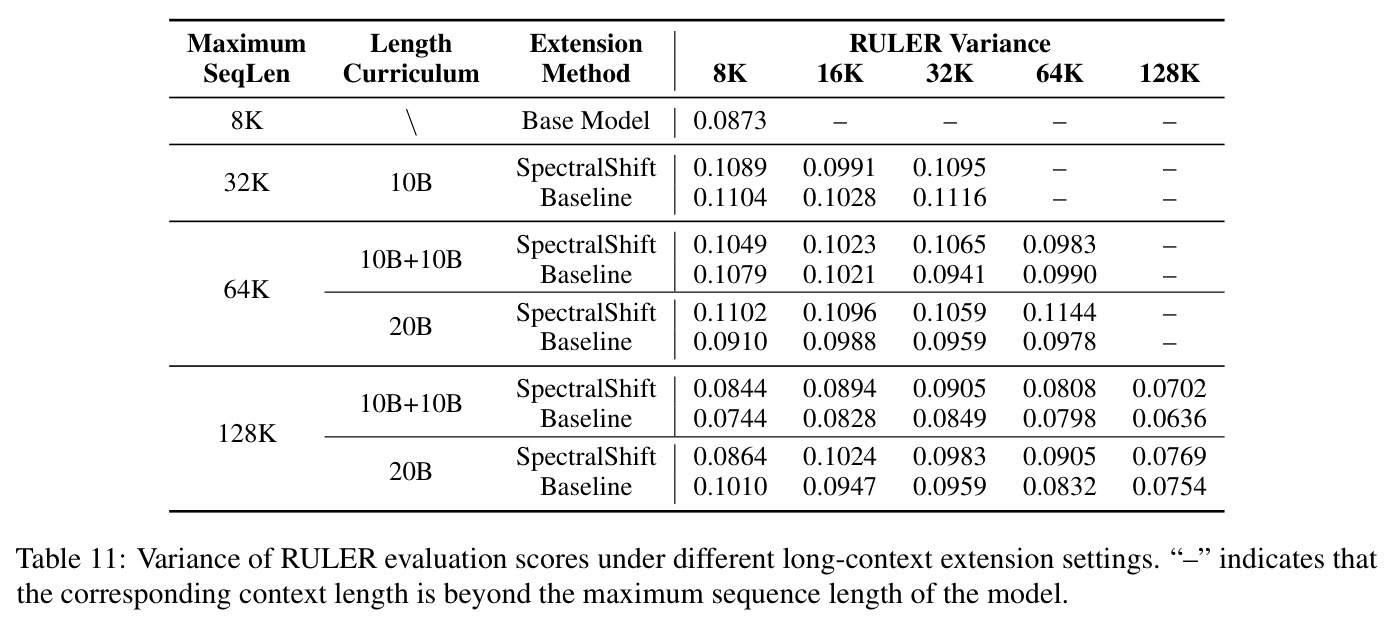
复现条件较好。代码已开源(github.com/RUCAIBox/GDN-SpectralShift),方法本体实现极轻:按分拆 state dict 加载权重、对 α 投影施加 $W^*_\alpha = \mu_\alpha J + s(W_\alpha - \mu_\alpha J)$ 并单独设置学习率即可,提供完整超参。主要门槛在基座:1.5B-A0.6B GDN-MoE 需在 Dolma3 上以 500B token 从头预训练(Muon、batch 1024、lr 8.6e-4),个人难以承担;但若拿到 8K 检查点,扩展实验只需 10B–20B token 的 CPT,中等集群可完成。谱分析成本很低:前向记录实测 $\alpha_t, \beta_t, k_t$,FP64 做 SVD,在 96 个层-头上计算 $H_{\text{slow}}$、$M_{\text{slow}}$、$E_{\text{write}}$。评测协议清晰、方差很低(表 11)。综合:方法复现难度低,完整流水线复现难度中等偏高(需数百 B token 预训练算力)。
论文图表