构建生产级希腊语-英语双语语音识别系统 Building a Production Greek-English Speech Recognizer
单模型无法同时满足九道生产关卡,团队以模型族、解码期干预与集成攻克双语ASR
前置知识
词错误率(WER)
语音识别的标准精度指标,计算为 $\mathrm{WER}=(S+D+I)/N$,即替换数加删除数加插入数除以参考总词数,越低越好。本文所有生产关卡都以WER上限定义,例如希腊语嘈杂环境要求 $\le 25.25\%$。
论文里每一个数字结论都围绕WER展开;文中还展示逆文本归一化(ITN)如何让WER失真——一个电话号码片段让某基准从4.46跳到8.42。
语言识别(LID)
在没有语言提示时判断音频说的是哪种语言。双语系统在句中混说两语时依赖LID决定解码语言。本文要求无提示音频上准确率 $\ge 95\%$,并发现希腊语嘈杂暴露每250步训练会拉低英语LID约3.5点。
LID下限与希腊语嘈杂WER上限的冲突正是全文核心不可行性结果的两翼,理解它才能理解为什么要放弃单模型。
ROVER 混淆网络投票
1997年提出的集成方法:把 $K$ 个识别器的假设对齐进词转移网络,在每个对齐位置 $i$ 取跨识别器票数最多的候选词 $\hat{w}_i=\arg\max_w \sum_{k=1}^{K}\mathbb{1}(w_k^i=w)$,平票时按平均逐词置信度打破。本文将其用于三个架构迥异的冻结模型。
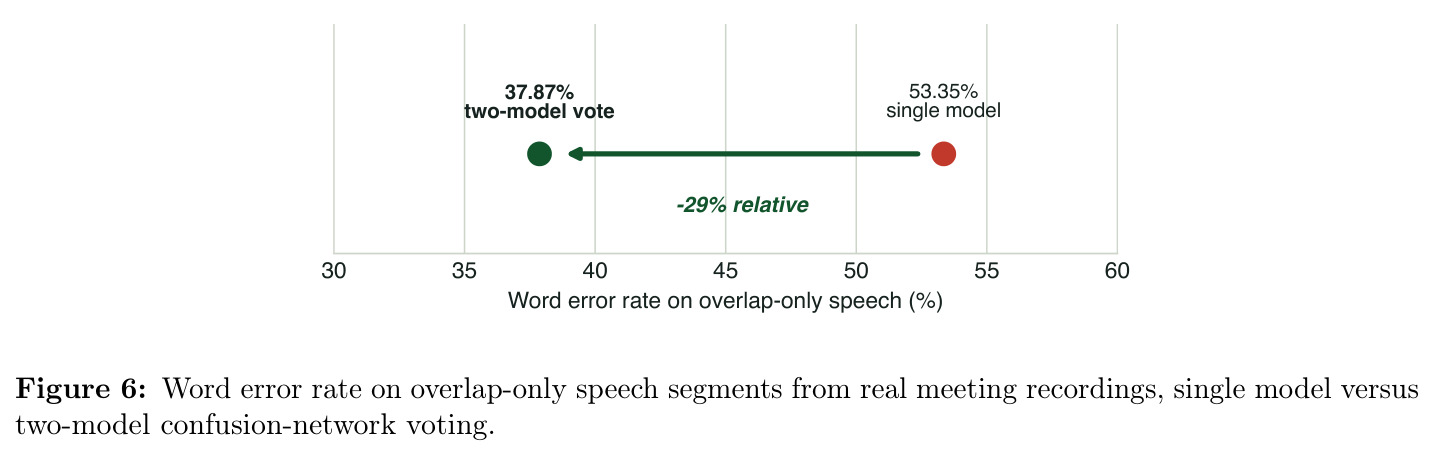
第6节集成的基础方法,9/9关卡达成和重叠语音53.35%→37.87%的改善都由它实现。
UTMOS 音频质量预测
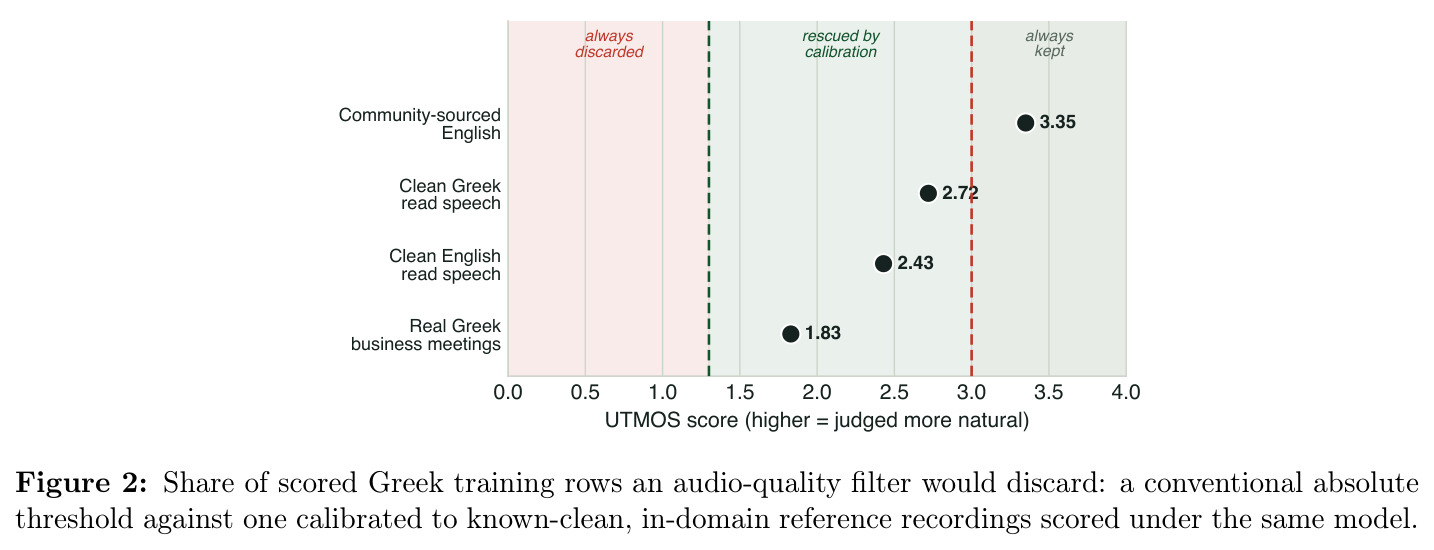
自动预测语音自然度平均意见分(MOS,约0–5分)的模型。它为英语合成语音调校,对真实世界与希腊语语音系统性压分,其教科书绝对阈值3.0会误删98.7%的希腊语训练音频,连干净的FLEURS基准音频都在删除之列。
按域锚定校准的故事(阈值3.0→1.30,丢弃率98.7%→10.6%)是本文最重要的单点修复,理解UTMOS的偏差才能看懂Figure 2。
Whisper 架构
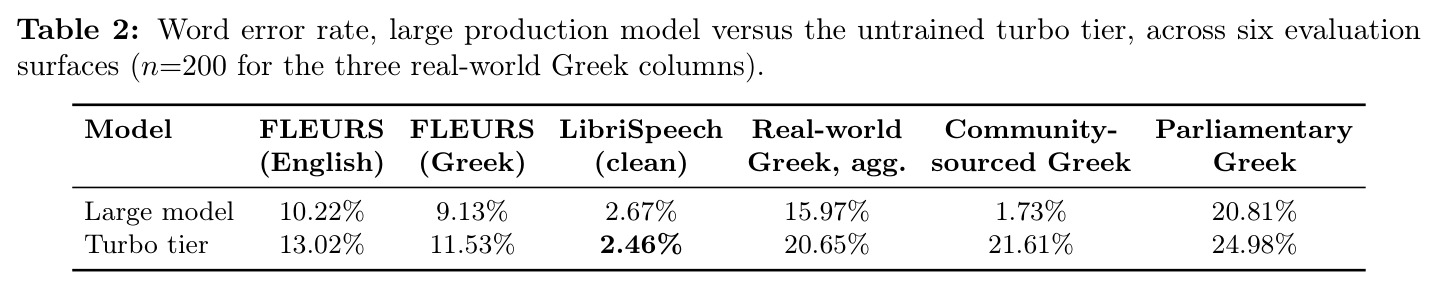
OpenAI的编码器-解码器语音识别架构,用大规模弱监督多语言音频-转写对训练。本文的大模型线(L1–L7)、turbo低延迟档(四个解码层的变体)以及一个集成成员都基于它,作者还扩展了其文本归一化器构建希腊语感知版本。
公开榜单上的K1与多数对外可比数字都建立在Whisper系模型上,是理解模型族构成的必要背景。
代码切换(Code-switching)
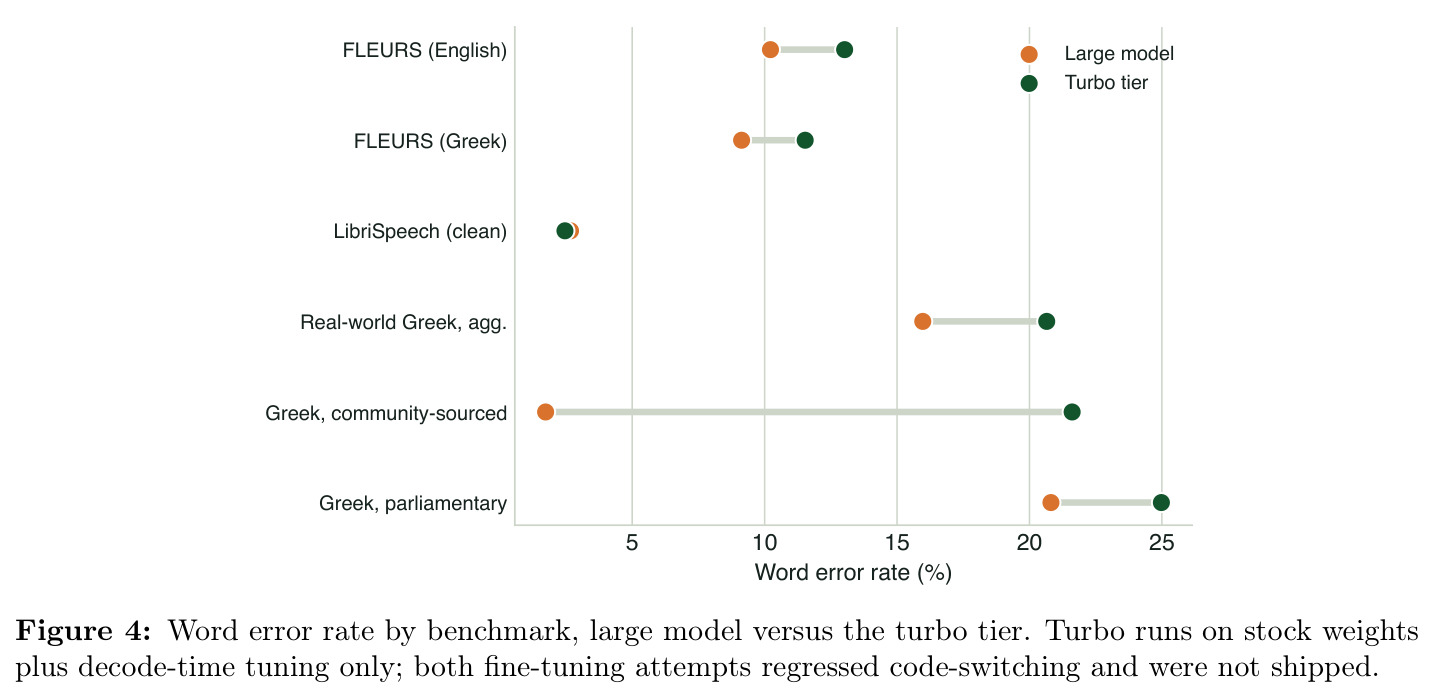
同一句话内自然混用两种语言的现象,希腊语-英语场景中极常见。它对ASR是双重挑战:模型须实时判定每段属于哪种语言并正确切换解码,否则两语互相污染,turbo档两次微调都败在这里。
代码切换WER是独立评测面:三模型投票把59.74%(单模型)降到23.84%,是集成收益最戏剧性的体现。
预注册消融实验
在动手实验前固定分析计划:声明全部超参、候选原因和判据,再运行只切换单一成分的多臂消融。即使测量代码事后发现bug,预注册设计也能让『哪个成分是毒素』这一结论保持可信。
第4.4节用它把幻觉bug定罪到单一数据包(移除短语句+负样本包后模板话术从24降到20,回到健康区间17–18),是本文方法论的招牌。
研究动机
对英语等大语种,商用语音识别已接近纯工程问题;但对希腊语——仅约1100万人使用、在句子中间随机混入英语、录音多来自电话线路和嘈杂会议室而非录音棚——并非如此。作者的商用服务Sophea须同时满足九道独立测量的生产关卡:四个希腊语基准与三个英语基准的WER上限、无语言提示时95%的语言识别准确率下限、以及1500条静音/噪声片段上零幻觉的硬性要求,因为每道关卡都对应客户可实际感知的故障。现有单模型方案的失败模式很具体:生产模型遇到重叠语音时不是误识别而是整段删除——对后锁定的说话人召回率仅约18%;非语音音频上会生成流畅但完全虚构的希腊语文本;早期训练池中约4万条转写与音频不匹配的样本曾把内部幻觉基准推过100。
本文的目标是本文的目标是把一个商用双语希腊语-英语识别系统做到『通过全部九道生产关卡』,并把这一状态作为生产就绪的操作性定义。具体包括四件事:(1)在1.7B参数紧凑双语模型(C1–C7)和更大的Whisper系会议模型(L1–L7)两条线上迭代训练,逐一攻关九道关卡;(2)弄清在小模型规模与固定训练配置下,能否仅靠调整训练数据配比让单一模型同时满足希腊语嘈杂WER $\le 25.25$ 与英语LID $\ge 95$ 这两条互相冲突的要求;(3)构建可信的测量基础设施——六阶段数据管线、按域校准的音频质量过滤、希腊语感知归一化器、227片段的污染检测——使每个决策都建立在被二次验证过的数字上;(4)若单模型不可行,则交付模型族加路由服务层加解码期干预的组合方案。
与已有工作不同的是,与典型只报正面结果的ASR论文相比,本文的独特切入有三点。其一,把多语言容量竞争转化为可测量的离散『训练步数预算边界』:希腊语嘈杂关卡需要 $s\ge 1500$ 步密集暴露,英语LID只容忍 $s\le 250$ 步,两个区间不重叠——作者明确指出这是首次在ASR中以这种离散形式报告该权衡,此前文献只笼统讨论『多语言诅咒』。其二,坚持报告负面结果:七项大型训练/架构尝试被测量后放弃,五种内部测量工具曾给出貌似合理却错误的数字(如损失被32×误报、污染检测制造数千假重复),全部如实披露成案例。其三,方法论核心是『锚定校准』:不信任教科书阈值,而是用同域干净参考音频在同一评分器下的分布重新定标,UTMOS阈值从3.0改为1.30,丢弃率从98.7%降到10.6%。
核心方法
整体方案是『模型族+服务层路由+解码期干预+集成』。数据侧是六阶段管线:UTMOS音频质量分、每分钟词数合理性过滤、转写置信度过滤、多教师交叉校验、强制对齐检查、以及把语言配比作为显式构建目标的装配阶段——某次构建装配1169565行,最终1073294行希腊语对1079148行英语,配比差0.55%。模型侧两条线并行:紧凑双语模型(1.7B参数,C1–C7)与更大的Whisper系会议模型(L1–L7),另有四解码层Whisper变体的turbo低延迟档。训练完成后,服务层按预期语言和领域路由到专用checkpoint,对希腊语为主的领域施加强制语言解码。集成侧有两条路:其一是三模型ROVER混淆网络投票(自有双语模型、Canary希腊语微调、LoRA适配Whisper large-v3),在每个对齐位置取 $\hat{w}_i=\arg\max_w\sum_{k=1}^{K}\mathbb{1}(w_k^i=w)$;其二是K1系统——梯度提升分类器按整段路由,$p(x)\ge 0.5$ 时选Canary,否则选Qwen远场变体。
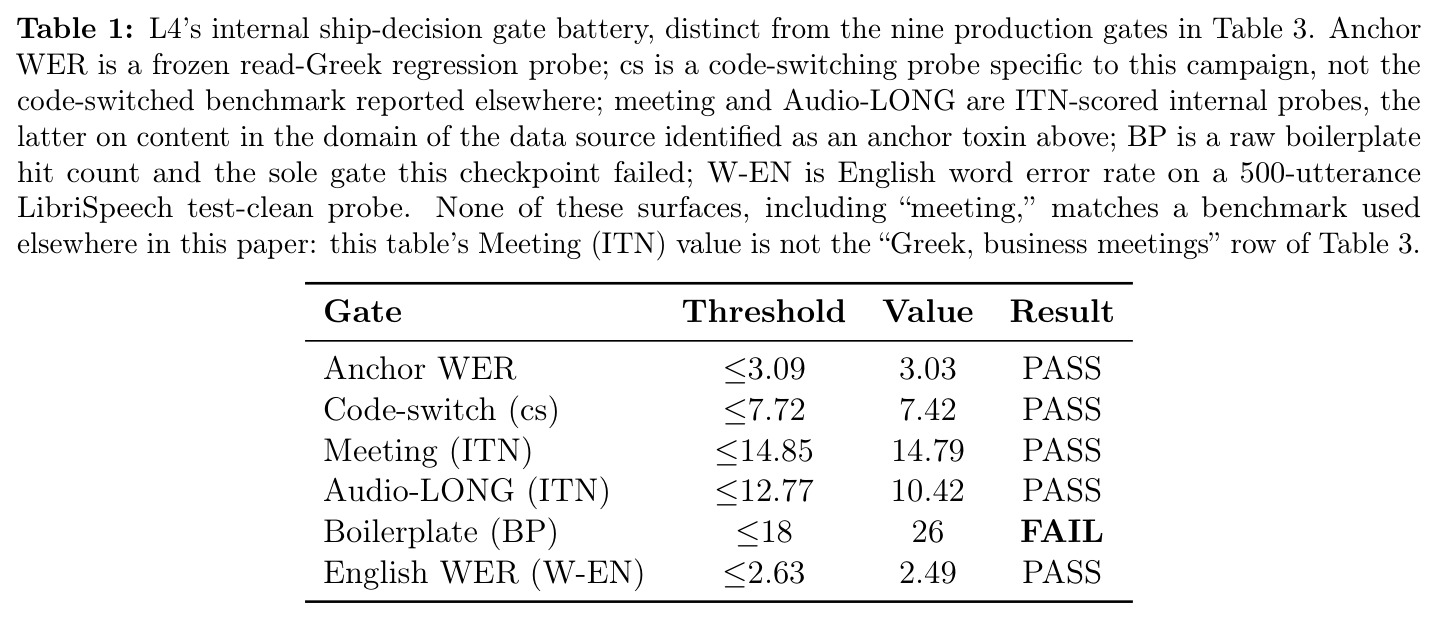
核心洞察有三。第一,双语竞争的本质是声学邻域而非语言体量:加入835小时干净录音棚英语『防守』毫无作用,真实嘈杂音频上的英语准确率照样崩溃;只加577小时(约三分之一量)嘈杂重叠会议风格英语却守住了同样步数内的准确率——数据只有共享干扰实际来源的声学邻域才能保护关卡。第二,自动评分器必须按域锚定校准:UTMOS在英语合成数据上调校,对真实希腊语系统性压分(干净希腊语朗读中位数2.72、真实会议1.83,远低于教科书阈值3.0);强制对齐同理,丢弃阈值按锚定分布定义为 $\tau=1.5\times P95(X_{anchor})$。第三,『先试解码期修复再考虑重训』:静音幻觉、代码切换弱项、模板话术三个问题最初都用重训攻克,最终全部由VAD加双置信阈值、自动LID加beam 5加1.1重复惩罚、短语过滤器等零训练手段解决——L7把模板话术从26降到0且其他指标在两位小数内不变。
方法步骤详情
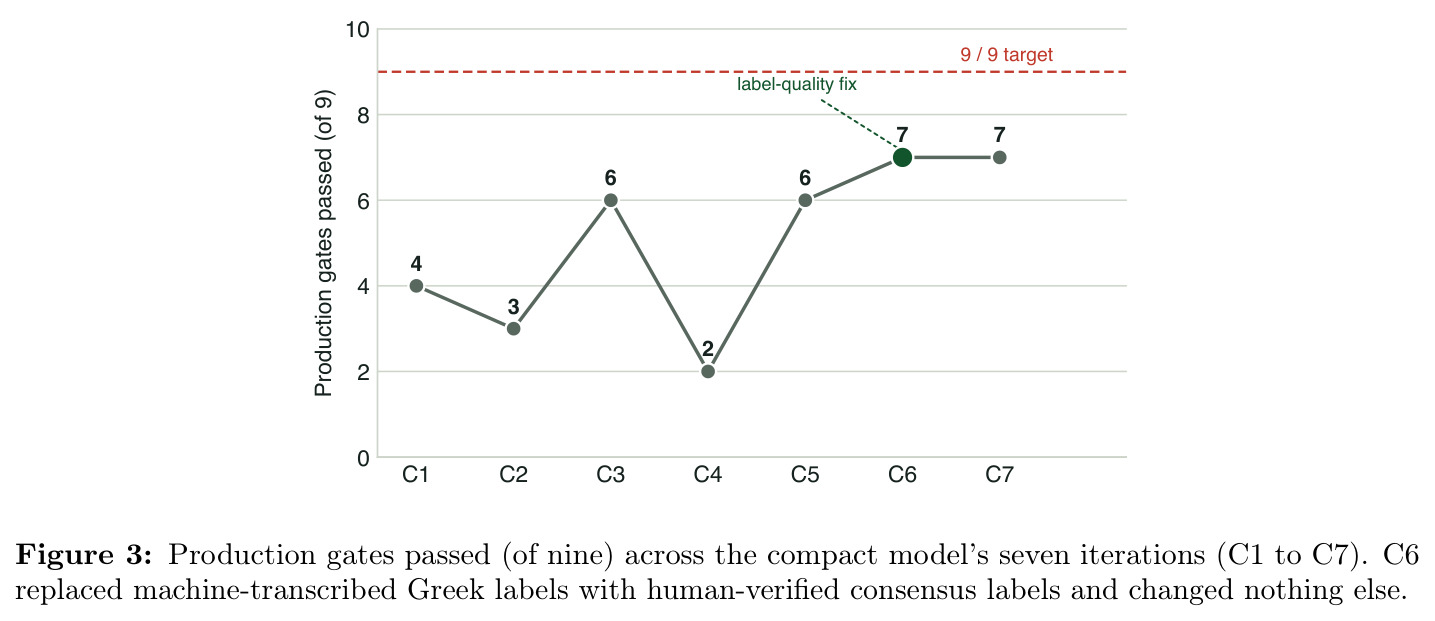
流程分四步。第一步数据构建:六阶段过滤,其中UTMOS按锚定中位数(社区英语3.35、干净希腊语朗读2.72、干净英语朗读2.43、真实希腊语会议1.83)把丢弃阈值定为1.30;词数合理性带加强制对齐专治『转写与音频不匹配』这一幻觉源头(曾致约4万条坏样本)。第二步训练迭代:紧凑线C1–C5五连败,最好仅6/9;C6的唯一变量是把机器转写的希腊语电话标签换成约230小时多引擎共识标签,首个checkpoint即7/9;C7最优checkpoint在第50步达26.32%仍差约1点,得出『150步定律』——增益几乎都落在前100到200步。大模型线L4移除两个致希腊语朗读回归的数据源后首发,六道硬关卡过五道,唯模板话术BP=26超 $\le 18$;L7移除误删『ok/okay』的两词后BP从26到0。第三步集成:三模型ROVER把覆盖从4–7/9提到9/9;K1在公开开发池验证集上拟合逐段仲裁器,留一集验证仍全面胜出。第四步线上验证:K1在单张B200、24并发下实测希腊语嘈杂25.88%。
技术新颖性
技术新颖性集中在四处。(1)以『步数预算区间不重叠』的形式陈述不可行性:$s\ge 1500$ 与 $s\le 250$(基线配比)或 $s\le 1250$(重配比,代价是希腊语卡在约26、距自身关卡差约0.75点),两个预算相差近6倍——作者声明未见过ASR中以这种离散形式报告该权衡。(2)逐段学习式路由仲裁器:不同于ROVER的词级投票,K1用GBDT按整段特征(双方token置信度、空/填充输出标志、语音存在概率、片段时长、词率、假设长度比、跨模型一致率)硬性二选一,作者称未见过该机制针对ASR集成的公开基线,且留一集验证表明增益可泛化。(3)预注册消融:修复前固定超参、只切换候选成分,把幻觉毒素定位到单一数据包,甚至事后发现评测竞态损坏一个臂的数据后重跑仍不改变结论。(4)把负面结果账本化——七项努力逐条给出预注册计划、测量结果和关闭判定的报告文化在ASR文献中罕见。
实验结果
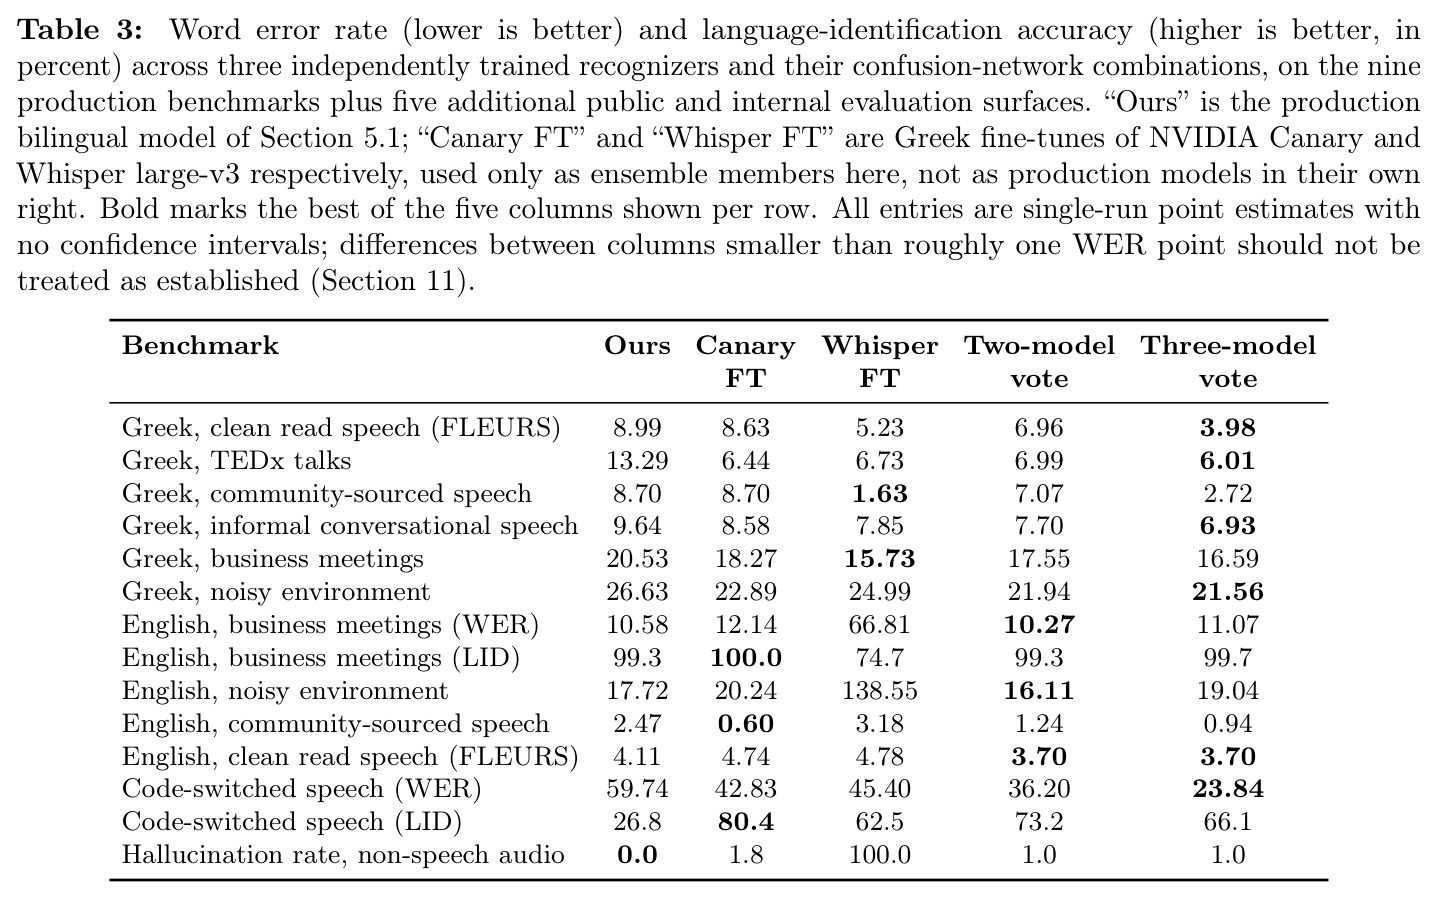
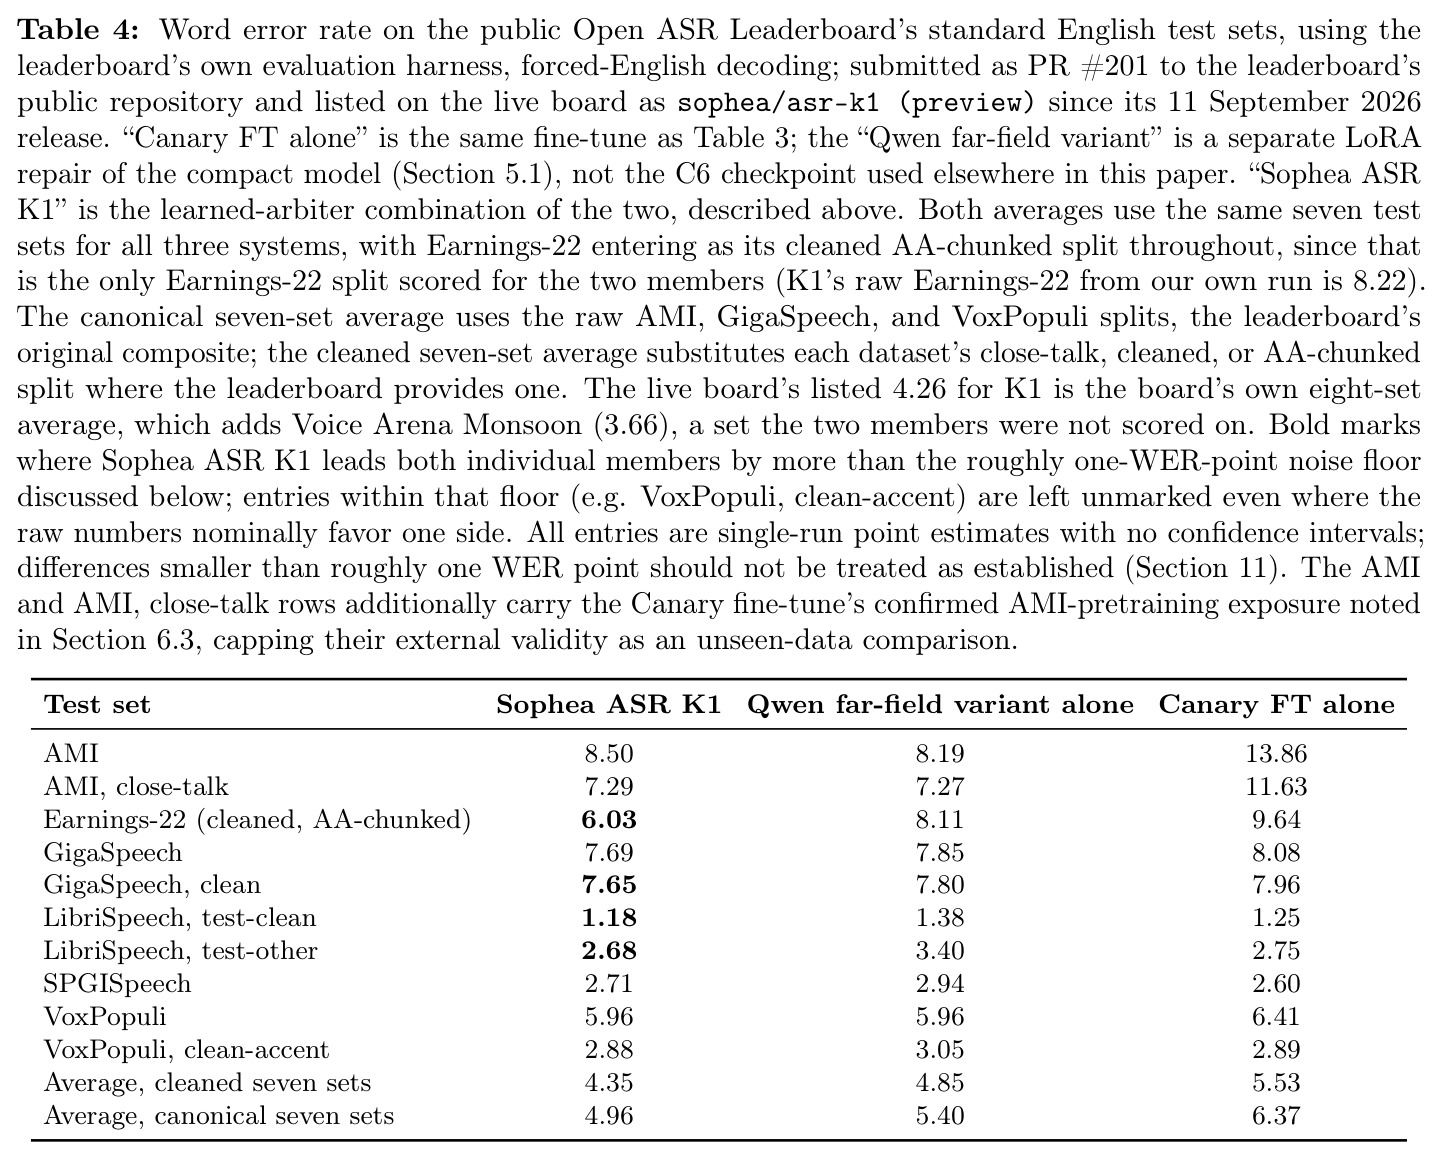
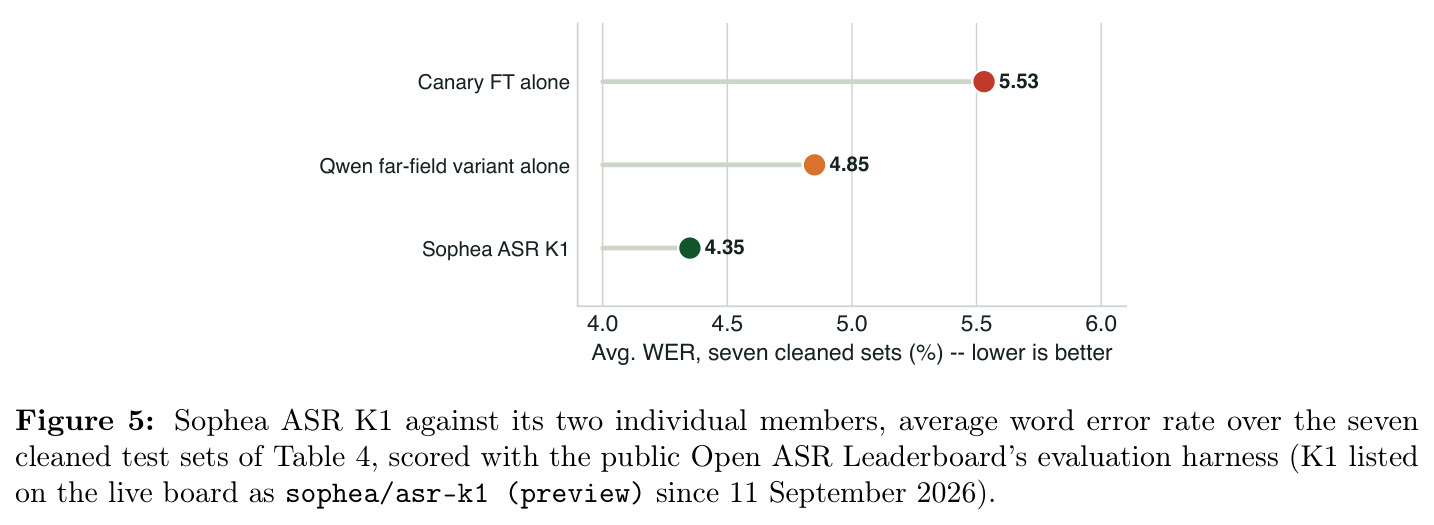
核心发现逐一列举。(1)不可行性:希腊语嘈杂WER从26.8改善到1750步的25.21,需 $\ge 1500$ 步;英语LID基线配比每250步降约3.5点(容忍 $\le 250$ 步),重配比降0.9点(容忍 $\le 1250$ 步但希腊语停滞在约26),联合可行点在实测边界外约1个WER点。(2)紧凑线:C6凭230小时共识标签达7/9(嘈杂26.63%),C7最佳26.32%未破25.25。(3)三模型ROVER:覆盖从单模型4–7/9到9/9;代码切换WER从59.74%降到23.84%;希腊语FLEURS从8.99%到3.98%。(4)K1:榜单八集平均WER 4.26%(列第11),七清理集4.35%优于成员4.85%/5.53%;线上希腊语嘈杂25.88%(95% CI 24.44–27.19,n=1325),首个单服务模型过26关卡;英语嘈杂15.14%→14.21%。(5)重叠语音:两模型投票把仅重叠段WER从53.35%降到37.87%(相对−29%,bootstrap 95% CI 11.0–19.5绝对点)。(6)turbo档:解码期调整把代码切换WER从10.78降到9.79,两次微调均回退未上线。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 公开英文基准平均WER(Open ASR Leaderboard八集) | 平均词错误率 | 4.26%(K1,榜单第11名,2026-09-11) | 成员单独:Qwen远场变体4.85% / Canary FT 5.53%(七清理集口径) | 较最强成员相对降低约10% |
| 希腊语嘈杂环境语音(线上真实流量) | WER(n=1325片段) | 25.88%(95% CI 24.44–27.19,首个单服务模型过26关卡) | C6 checkpoint 26.63%;此前仅多系统投票曾低于26 | 绝对降低0.75点,首次跨过26%门槛 |
| 仅重叠语音段(AMI真实会议) | WER(18场会议) | 37.87%(两模型投票) | 单模型53.35% | 相对−29%,bootstrap 95% CI 11.0–19.5绝对点 |
| 代码切换语音 | WER | 23.84%(三模型投票) | 自有单模型59.74% | 绝对降低35.9点 |
| 希腊语干净朗读(FLEURS) | WER | 3.98%(三模型投票) | 自有单模型8.99% | 绝对降低5.01点 |
| 非语音音频幻觉率 | 幻觉率(1500片段静音/噪声电池) | 0%(自有模型)/ 1.0%(集成,加静音抑制规则后达9/9关卡) | Whisper FT单独100% | 从全程幻觉到基本清零 |
局限与改进
作者坦承的局限:所有表格都是单次运行点估计、无置信区间,差距小于约1个WER点的差异不应视为成立;Figure 1和Figure 3的两条轨迹来自无重复种子的单次训练运行,区间端点带有未量化的方差;不可行性结论只在1.7B规模和该训练配置下测量,更大容量、辅助LID损失或训练日程变化能否移动边界均未测试;会议与嘈杂环境基准均为私有,外部读者无法复现;重叠语音结论只在英语会议音频上成立,且Canary成员确认在AMI上有预训练暴露;集成与K1使用早期大模型线的Whisper checkpoint而非现役L4,替换影响未测;榜单默认视图平均含两个私有集、不可公开复算。我的补充观察:K1仲裁器只用英语池校准,希腊语侧退化为单一远场变体加强制语言解码,混合语言真实流量下的路由收益未被验证;解码期规则(短语过滤器、置信阈值)的数量会随时间增长,论文未讨论这类规则的回归测试与维护策略。
独立分析的弱点
独立分析的弱点:(1)统计严谨性——『6×步数差』这一关键结论建立在无重复种子的单次运行上,改进方向是对边界两端各跑3–5个种子并报告bootstrap置信区间;(2)评测主权偏斜——最关键的会议与嘈杂基准私有,『9/9关卡』对外部读者是黑盒,可发布匿名化评测子集或接入公开希腊语基准增强外部可校验性;(3)重叠语音的工程价值存疑——作者自证重叠仅占真实会议音频约3.2%,即使检测完美,整场会议WER的相对改善也不足1%,投入产出比偏低;(4)Sortformer重叠定位精度仅0.30–0.39(要求0.85),若流式检测器不突破,该集成永远进不了线上实时路径,只能留在离线批处理;(5)删除型欠生成(假设/参考长度比钉在0.93)的三种修复全部失败——删除目标微调恶化比值、长度感知奖励越过配比却未缩误差、三编码器融合只动−0.37还让会议基准回退+3.9——说明强化学习奖励设计仍不成熟,缺乏既保长度又保内容的联合目标。
未来方向
作者列出的开放方向与可延伸工作:(1)辅助训练目标——把语言识别从转写目标中分离为独立损失头,可能直接移动前沿而非沿前沿滑动,这是『不可行性是否随目标函数消失』的关键实验;(2)更大容量模型与训练日程/课程顺序实验——第7节案例1显示课程排序本身可引发损失6×跳变,调度可能是独立于配比的自变量;(3)用现役L4替换集成与K1中的旧checkpoint并重测;(4)为仲裁器构建希腊语开发池,把K1的逐段路由从英语扩展到希腊语侧;(5)等待流式重叠检测器精度达标后,把重叠集成推入实时服务并补建流式延迟测量;(6)录制真实重叠希腊语音语料填补评测空白。我的延伸:解码期修复政策可系统化为『修复-回归测试』框架并量化其适用边界;光谱图-图像转录的否定结论(空白灰图反而优于真实光谱图、频带置换竟改善WER)值得在多模态社区复现,以划清『听觉先验背诵vs视觉读取』的边界;榜单PR #201合入后,默认视图排名也可获得可复算的外部锚点。
复现评估
复现评估:作者明确不发布任何模型权重、训练数据、评测集或内部工具,逐数完全复现不可行。可复现部分有三:(1)Table 4完全公开——所有测试集、评分器与解码条件与Open ASR Leaderboard相同,任何人可用榜单评测管线复算,对应GitHub PR #201仍开放;(2)K1经公共API可测试(HF Space:KIEFERSA/sophea-asr-k1-docs);(3)Figure 5完全由Table 4的公开数字导出。不可复现:Figure 1、3纯属内部测量,私有希腊语会议/嘈杂基准贯穿全文。算力参考:单张B200支撑24并发线上验证(往返RTF希腊语12.2、英语31.8),内部评测曾用8 GPU并行(该并行本身引入过一次竞态损坏数据的教训)。方法论层面——锚定校准、预注册消融、九关卡式验收、负面结果账本——在任何系统上都可独立复刻,这也是作者声明的发布意图:让另一支为其他低资源语言对构建ASR的团队复用定律、校准方法与失败清单。
论文图表
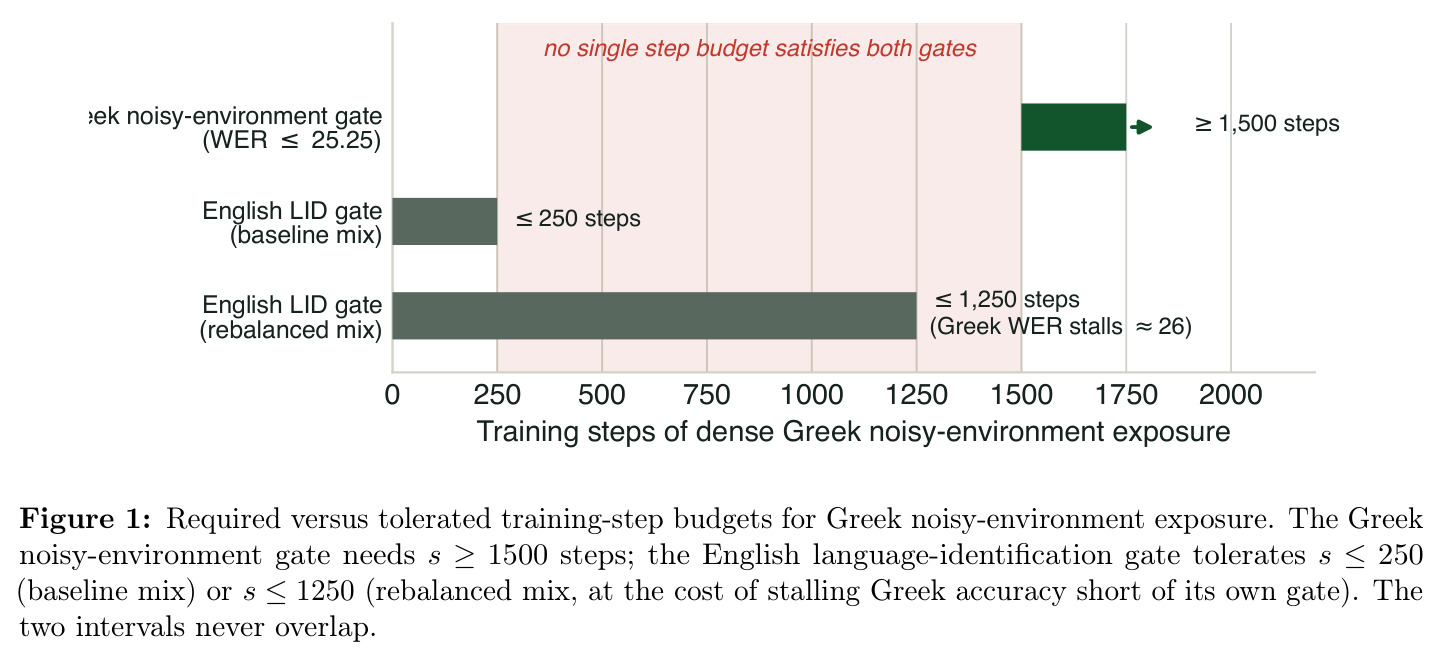
横轴为希腊语嘈杂环境密集暴露的训练步数(0–2000),图上标出三条水平区间:希腊语嘈杂关卡要求 $\ge 1500$ 步(WER $\le 25.25$);英语LID关卡在基线配比下容忍 $\le 250$ 步、在重配比下容忍 $\le 1250$ 步(代价是希腊语WER停滞在约26)。两个必需与容忍区间从不重叠,直观呈现『无单一训练步数能同时满足两道关卡』的不可行性。
这是全文核心论断的视觉证据:一张图解释了为什么必须放弃单模型路线、转向模型族加路由的架构决策。