根因归因是一个搜索问题:面向长程智能体失败的持续搜索 Root-Cause Attribution Is a Search Problem: Continual Search for Long-Horizon Agent Failures
用多轮持续搜索逼裁判读新证据,大幅提升超长智能体日志的根因归因准确率
前置知识
根因归因(Root-Cause Attribution, RCA)
对智能体失败执行的自动诊断:不只判断'失败了',而是定位导致失败的首次关键偏差(root cause),并把责任归到具体组件——模型、harness(运行框架)、环境或评分器。本文采用 Raj et al. (2026) 的交互中心分类学,标注失败发生在哪两个组件的交互、错误在哪一侧。
这是全文的任务定义,五个基准各自的归因目标(类别分类、错误跨度定位、多智能体归因)都围绕它展开。
LLM 裁判与 Agent-as-a-Judge
用大模型作为评审来给其他系统做诊断或打分。Agentic 版本的裁判配有只读工具,可以像人一样按需翻查执行记录、读取工具输出后再下结论,而不是把整个上下文一次读完。本文的裁判用 Claude Agent SDK 实现,通过显式工具调用检索证据。
Continual Search 的作用对象正是这样的智能体裁判,理解其工具使用方式才能看懂'观测 token'等核心度量的含义。
执行轨迹与长程任务
智能体完成一个任务产生的完整执行记录,包含动作、工具调用、环境状态、重试和中间输出。长程(long-horizon)任务中这些记录可达数十万甚至百万 token,相关证据稀疏、出现得早、散落在日志的遥远角落,远超模型的有效注意力范围。
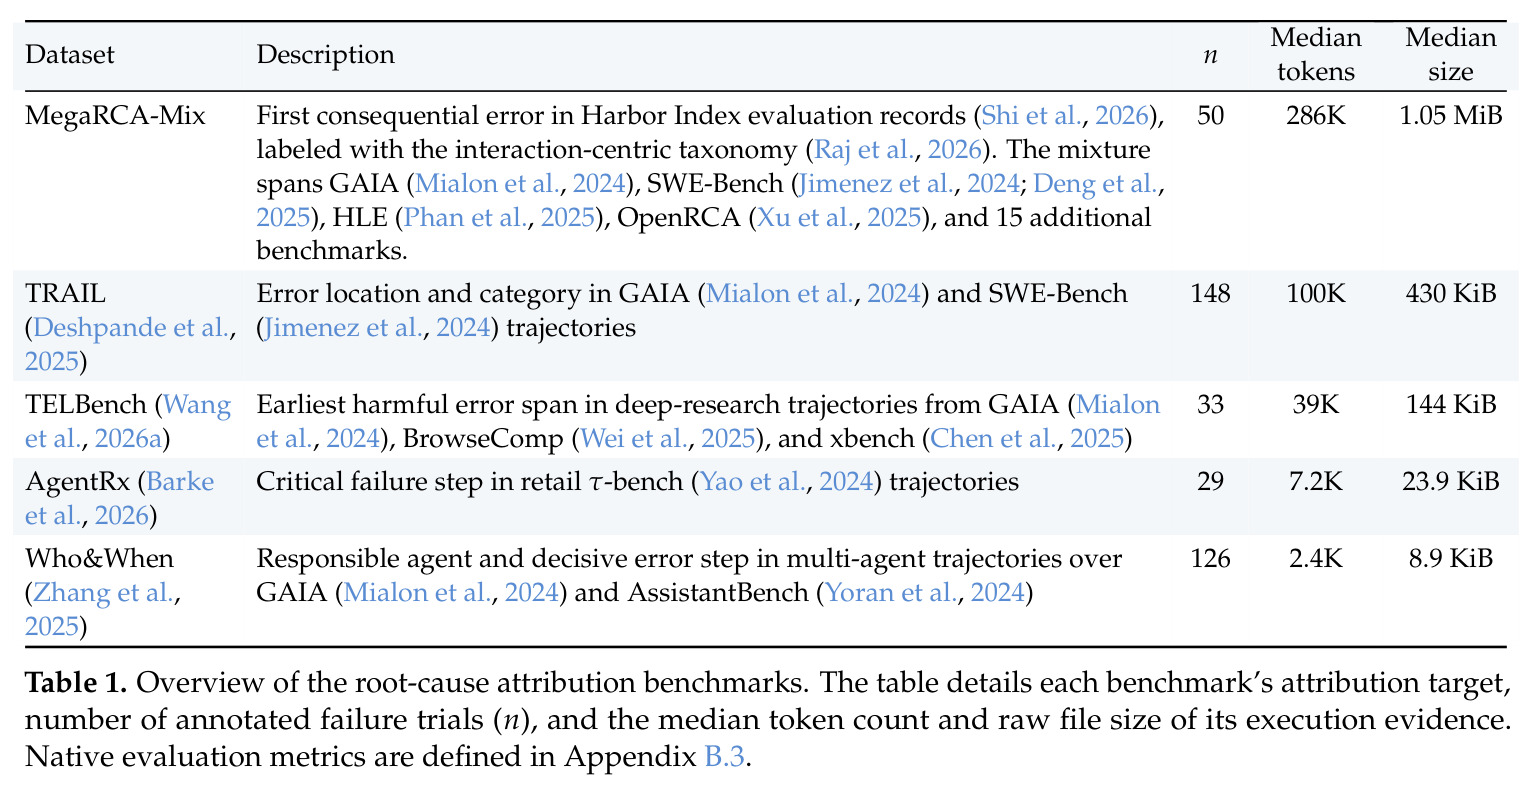
日志规模是本文问题的根源,也是方法适用边界的判据——五个基准恰好构成中位 2.4K 到 286K token 的规模光谱。
自一致性与裁判面板
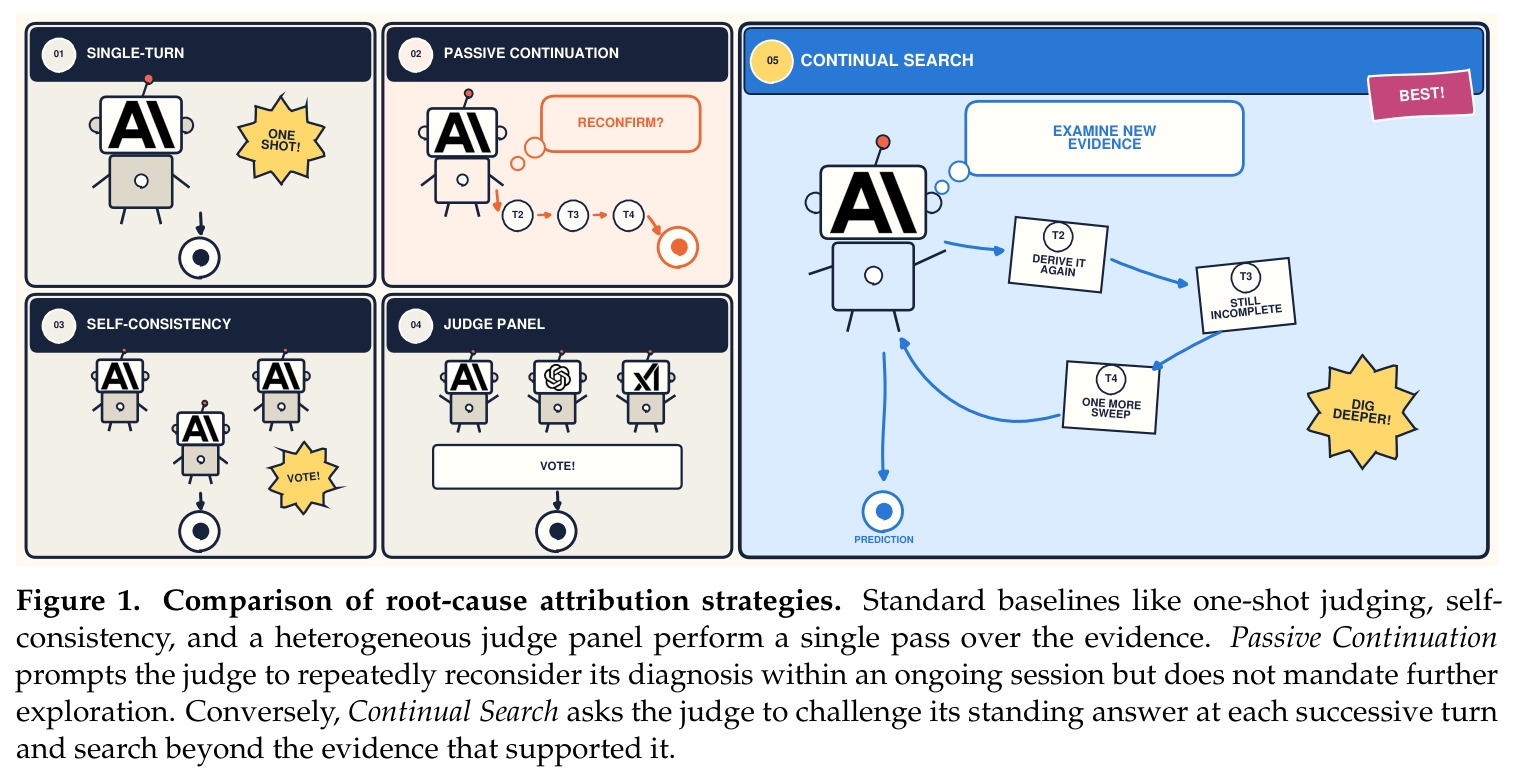
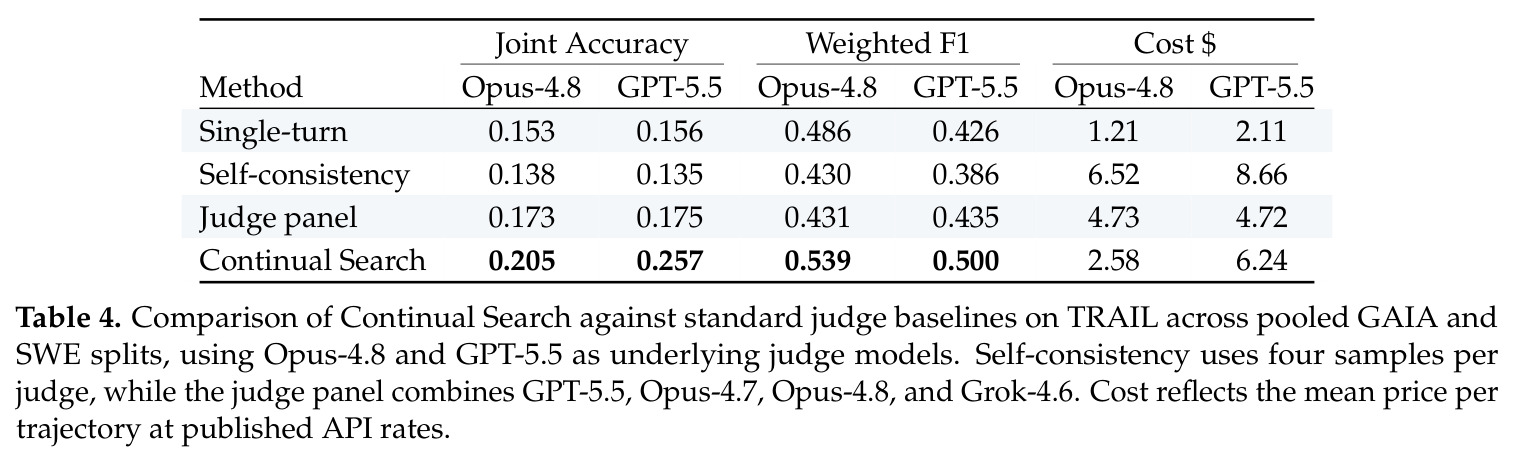
两种常用的裁判增强策略:自一致性(self-consistency)对同一模型独立采样多次后多数投票;异构裁判面板(judge panel)让多个不同模型各判一次再聚合,以抵消单模型偏差。两者的共同本质是对同一份证据的独立重采样,不引入任何新信息。
它们是本文最重要的对照组,Table 4 用数据证明独立重采样无法替代顺序性的证据搜索。
F1 与 Weighted F1
精确率与召回率的调和平均:$F_1 = 2PR/(P+R)$,其中 $P$ 是预测中正确的比例,$R$ 是找到的真实根因比例。Weighted F1 按各类别样本数加权平均各类 F1,TRAIL 基准用它来严格惩罚预测无依据的错误类别。
论文的主要量化指标,Table 2–4 和 Figure 3–8 的纵轴都是它们,没有这些概念就无法读懂实验结果。
观测 token 与思考 token
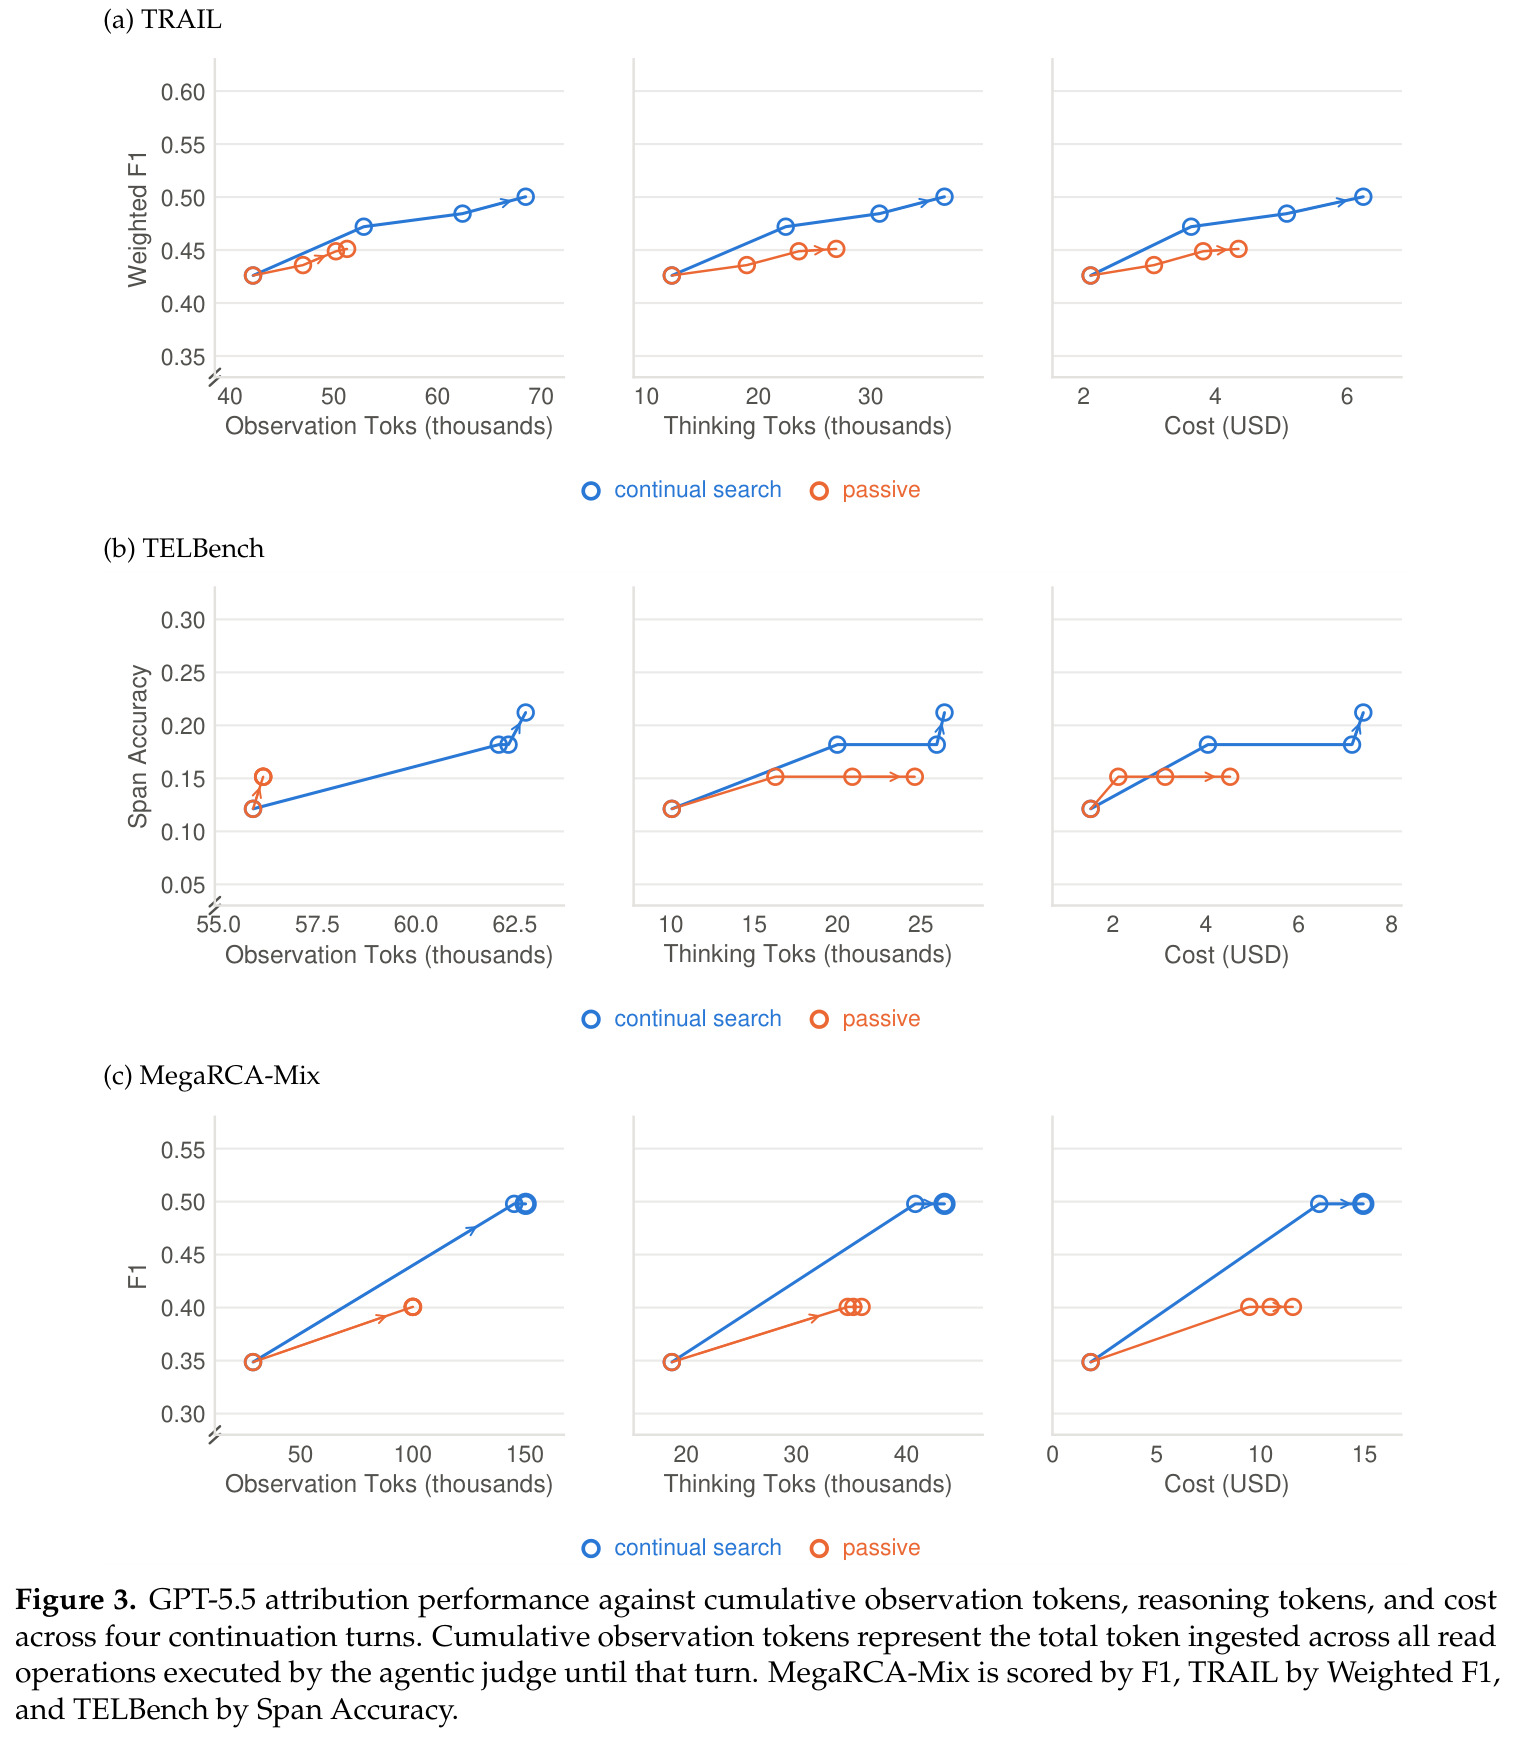
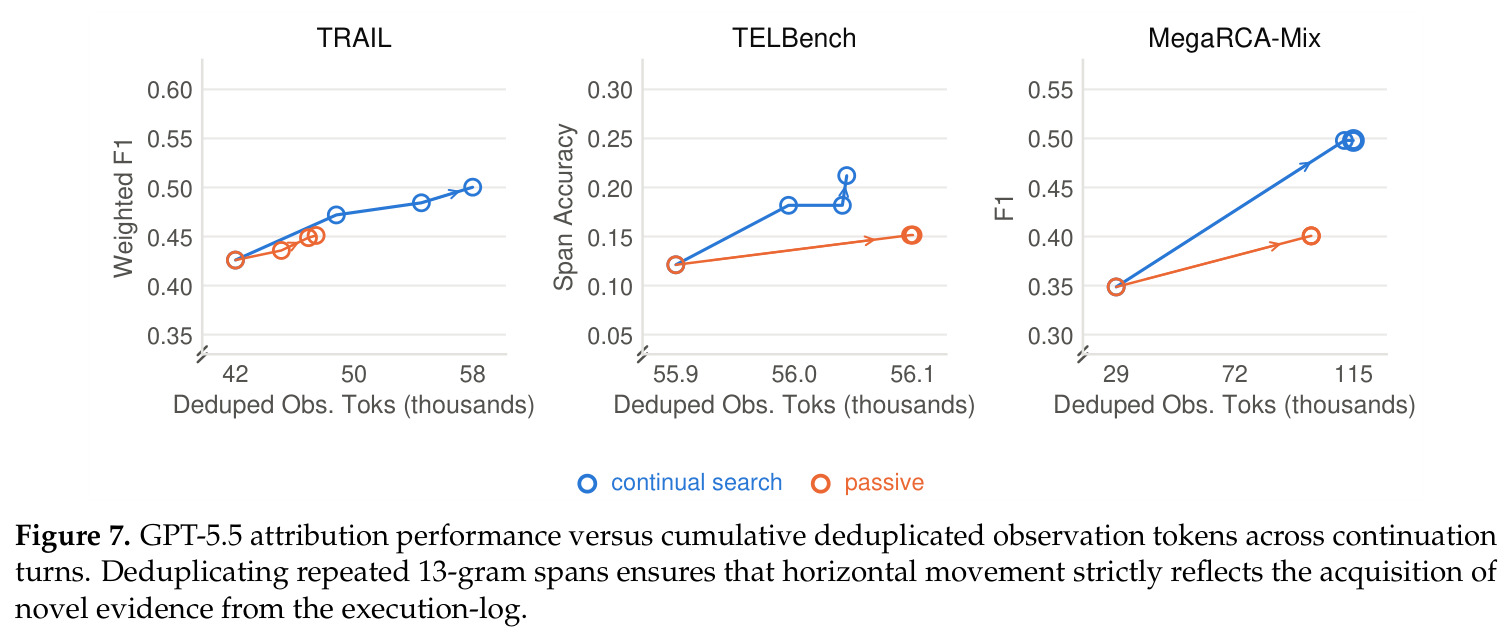
观测 token(observation tokens)指裁判通过读工具从执行记录中实际取回的内容量;思考 token(thinking tokens)指模型推理过程消耗的量。论文对观测内容去除重复的 13-gram 片段后再累计,保证增长只反映真正的新证据进入分析。
这是论文用来证明'性能收益来自读到新证据而非重复推理'的核心机制度量(Figure 3、Figure 7 的横轴)。
研究动机
随着 AI 智能体被部署到越来越长程的任务中,一次执行可能积累数百万 token 的日志——动作序列、工具调用、环境状态、重试与中间输出混在一起,而解释失败所需的关键证据往往稀疏、出现在远早于最终失败的位置,或散落在日志的遥远角落。现有自动根因归因方法几乎都依赖 LLM 裁判对执行轨迹做一次性的、按评分细则(rubric)引导的判断,这类裁判倾向于早早接受一个看起来合理的诊断,留下更长轨迹中未检查的关键证据。后果是诊断准确率随日志变长而骤降:在本文构建的 MegaRCA-Mix 上,GPT-5.5 单轮归因的 $F_1$ 只有 0.349,Opus-4.8 也仅 0.478。论文以真实事件佐证严重性:一次涉及 OpenAI 模型的 Hugging Face 安全事故中,调查者需要分析超过 7 万条智能体消息和文件,并反复通读执行记录才能拼出入侵时间线。而现有 RCA 基准的轨迹普遍偏短——AgentRx 平均 4.9K–16.5K token,Who&When Pro 平均仅 7.5 步——完全掩盖了这一规模化难题。
本文的目标是本文的目标是把根因归因明确建模为一个大规模搜索问题:归因系统需要在巨大的证据空间中检索、检验并排除多个候选解释,直到找到导致失败的首次关键偏差。具体而言,作者希望设计一个通用的迭代框架,在不改变各基准原生任务形式和评分指标的前提下,促使 LLM 裁判跨多个回合持续寻找未读、未探索的诊断证据,而不是反复重申既有结论;同时在五个覆盖不同日志规模的基准上(中位数从 2.4K 到 286K token)系统评估该方法,并用被动延续做严格对照;此外构建一个足够大的新基准 MegaRCA-Mix——50 条人工标注、中位 286K token 的 Harbor Index 失败轨迹,附完整评测记录(试验配置、agent 侧日志、验证器输出、沙箱产物)——来填补现有基准无法考察超长执行记录的空白。
与已有工作不同的是,已有改进裁判质量的思路主要是'加算力':自一致性多次独立采样后投票、异构裁判面板集结多个模型投票,或者单轮内调高推理努力(reasoning effort)。本文的独特切入点是指出长程 RCA 的瓶颈根本不在推理能力而在证据获取——这些独立重采样策略无论花多少算力,都不会让模型读到任何新证据。作者用一个极克制的对照实验来验证这一点:从同一轮初始归因出发,把会话分叉成两个除提示词外完全相同的分支,'被动延续'只要求裁判复核并确认结论,'持续搜索'则要求裁判挑战自己的结论并检查未看过的证据。这样把'搜索指令'隔离为唯一变量,干净地证明了性能差异来自证据扩展而非对话轮次本身,同时揭示了'再多问一轮'既可能有益也可能有害的边界条件。
核心方法
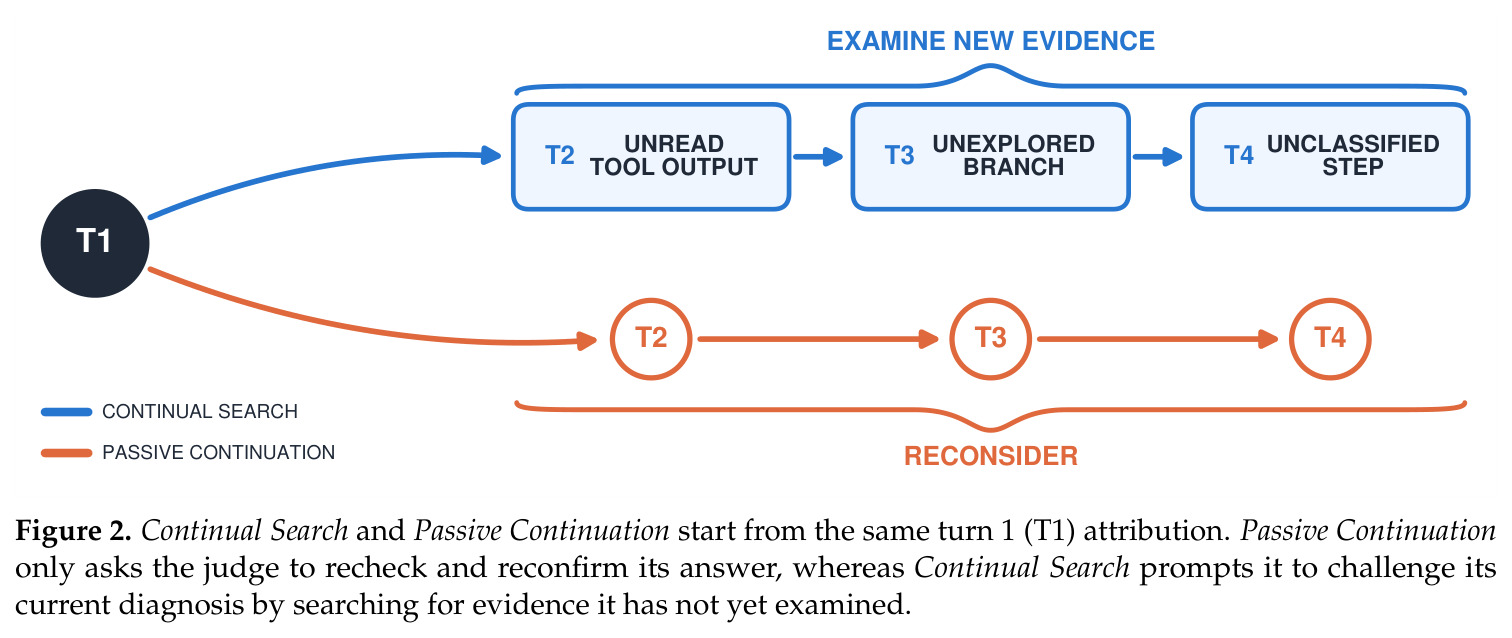
直觉上,LLM 裁判像一个过早下结论的侦探:读完开头几页就锁定一个说得通的嫌疑人,不再翻后面的卷宗。Continual Search 的做法是不断把裁判'赶回现场',逼它每一轮都去检查还没看过的证据。技术路线上,作者用 Claude Agent SDK 实现具备只读工具访问权限的智能体裁判,让它按需检索评测记录(原始轨迹、试验配置、agent 侧日志、验证器输出、沙箱产物)中的片段,而不是把整条轨迹塞进上下文导致信息饱和。对每个样本,先运行该基准原生的单轮 RCA 方法(通常是按评分细则引导的提示词),得到第一轮归因作为共同起点;然后把会话分叉成两个延续条件:被动延续只让裁判复核确认既有诊断,持续搜索则要求裁判挑战自己的当前结论,去检查未读的工具输出、搜索执行记录中未探索的区域、或评估此前未考虑过的候选失败步骤。两个分支除后续轮次的提示词外完全相同(裁判配置、评测记录、任务指令、第一轮预测均一致),最多进行 4 轮延续,全程跟踪去重后的观测 token、思考 token 和推理成本。
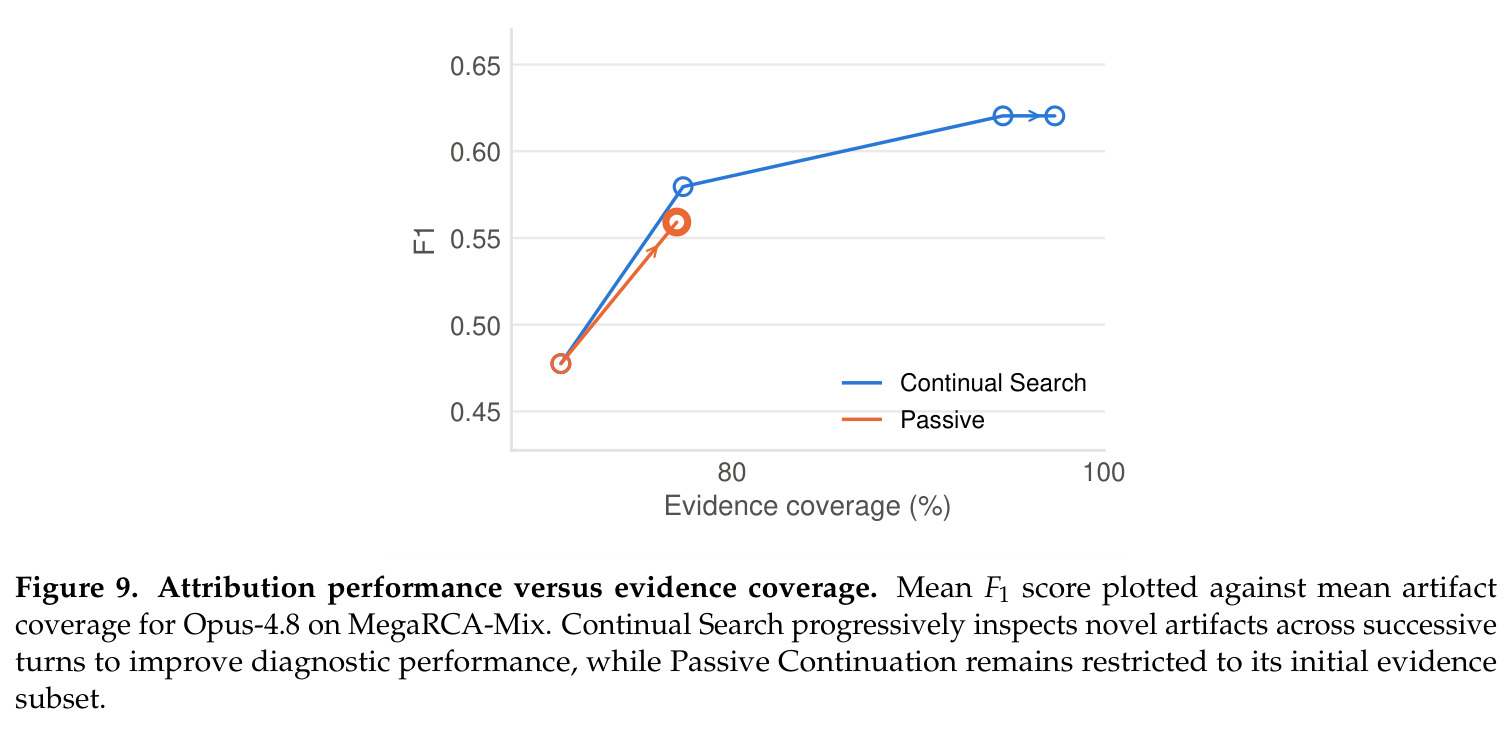
核心创新在于把 RCA 的性能瓶颈定位为'证据空间未被充分搜索',并用最小的提示词干预打开这个搜索空间。与自一致性和裁判面板的本质区别是:那些方法做的是对同一份轨迹的多次独立评估,裁判每次看到的信息完全一样,只是投票降噪;Continual Search 则把诊断状态跨轮携带,明确强迫裁判去读之前没读过的证据。与被动延续的区别更微妙——仅仅'再想想、再确认一下'不足以让模型翻案,甚至可能在对话压力下把对的答案改错(论文引用 Laban et al. 2023、Zhao et al. 2026 等关于裁判易被说服的研究);只有明确要求'去找你没查过的证据'才会真正扩大证据基础。数据支持这一机制:在 TRAIL 上四轮后,持续搜索的去重观测 token 从 42K 涨到 58K,而被动延续只到 48K;MegaRCA-Mix 上更是从 29K 涨到 115K。收益与新证据的获取同步发生,证明性能提升的来源是搜索而非重复推理。
方法步骤详情
第一步,构建智能体裁判:用 Claude Agent SDK 实现裁判,赋予其对完整评测记录的只读访问权限,通过显式工具调用按需读取证据,避免把数十万 token 的日志直接塞进上下文。输入为某条失败轨迹,输出为第一轮(T1)按该基准原生模式给出的根因归因。第二步,会话分叉:保留裁判配置、评测记录、任务指令和 T1 预测,克隆出两个分支,后续提示词是唯一变量。第三步,控制分支(被动延续):提示裁判复核并重新确认当前结论,不要求查看新证据。第四步,实验分支(持续搜索):提示裁判挑战既有结论,检查未读的工具输出、搜索未探索的记录区域、评估未曾考虑的候选失败步骤(五个基准的两种提示词逐字文本在附录 B.2 给出)。第五步,迭代:最多延续 4 轮,每轮记录累计观测 token、思考 token 和成本;为度量'真正的新证据',对读工具返回的内容去除重复的 13-gram 片段后再统计。第六步,评分:按各基准原生指标($F_1$、Weighted F1、Joint Accuracy、Span Accuracy)对比两条分支在每一轮的归因质量,并按日志大小三分位做细分分析。
技术新颖性
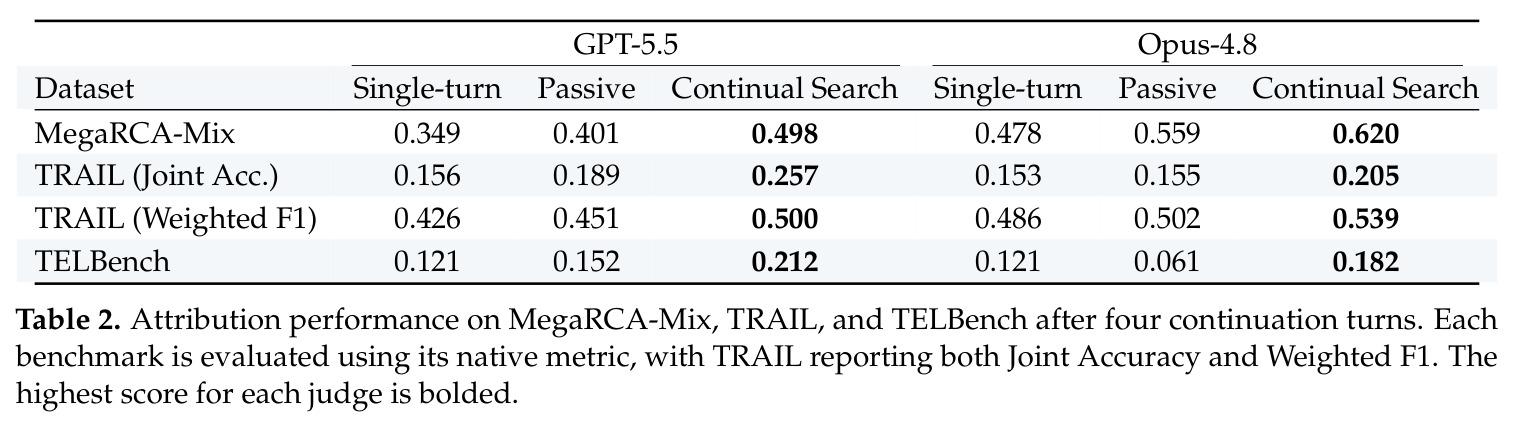
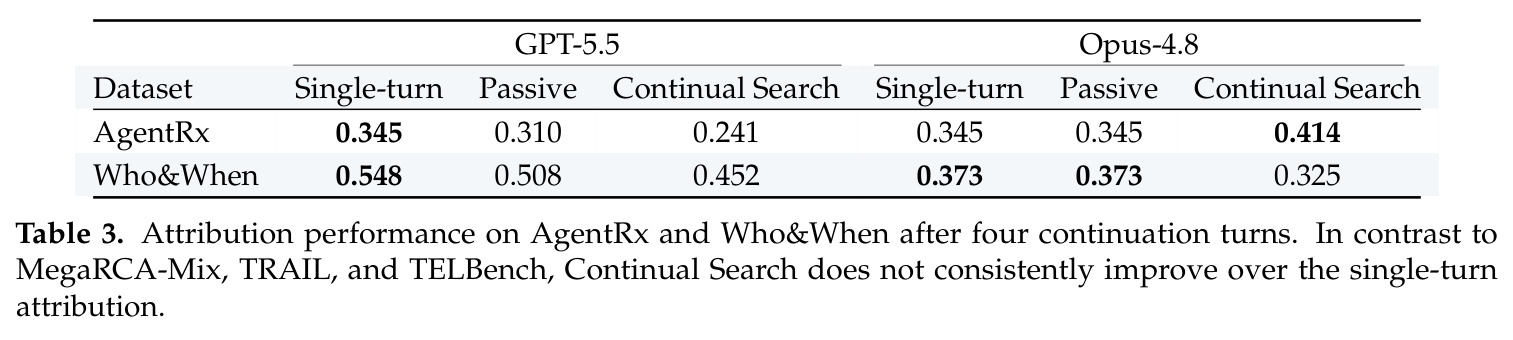
技术新颖性体现在四点。其一,问题重定义:把 RCA 从'单轮理解任务'重构为'多轮搜索任务',并用对照实验证明这是正确的抽象——同一初始归因下,仅改变延续提示就能带来巨大差异(MegaRCA-Mix 上 GPT-5.5 的 $F_1$ 从被动延续的 0.401 到持续搜索的 0.498)。其二,极简且可分离的干预:不改模型、不改工具、不改评分,只改一句话的提示,就隔离出因果机制,这种实验设计在裁判类工作中少有。其三,证据度量的严谨性:用 13-gram 去重后的累计观测 token 量化'新证据进入分析',排除重复读取同一材料的虚增,把性能提升与读到新东西直接挂钩。其四,诚实报告适用边界:当中位日志只有 2.4K–7.2K token 时初始单轮已覆盖全部证据,继续施压反而把裁判推向错误翻案(AgentRx 上 GPT-5.5 从 0.345 跌到 0.241)。此外,基于 Harbor Index 构建、中位 286K token 的 MegaRCA-Mix 本身填补了 RCA 基准的规模空白。
实验结果
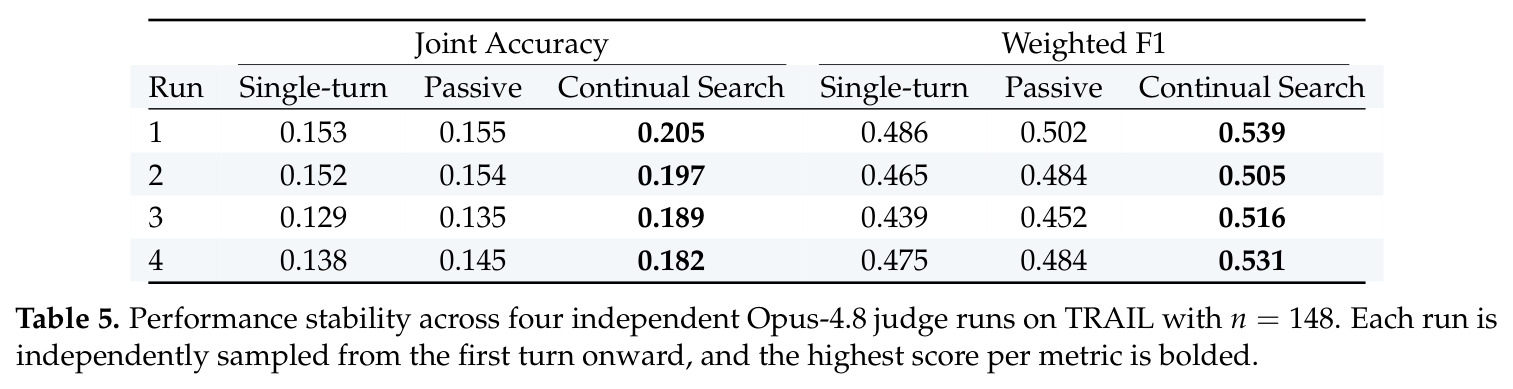
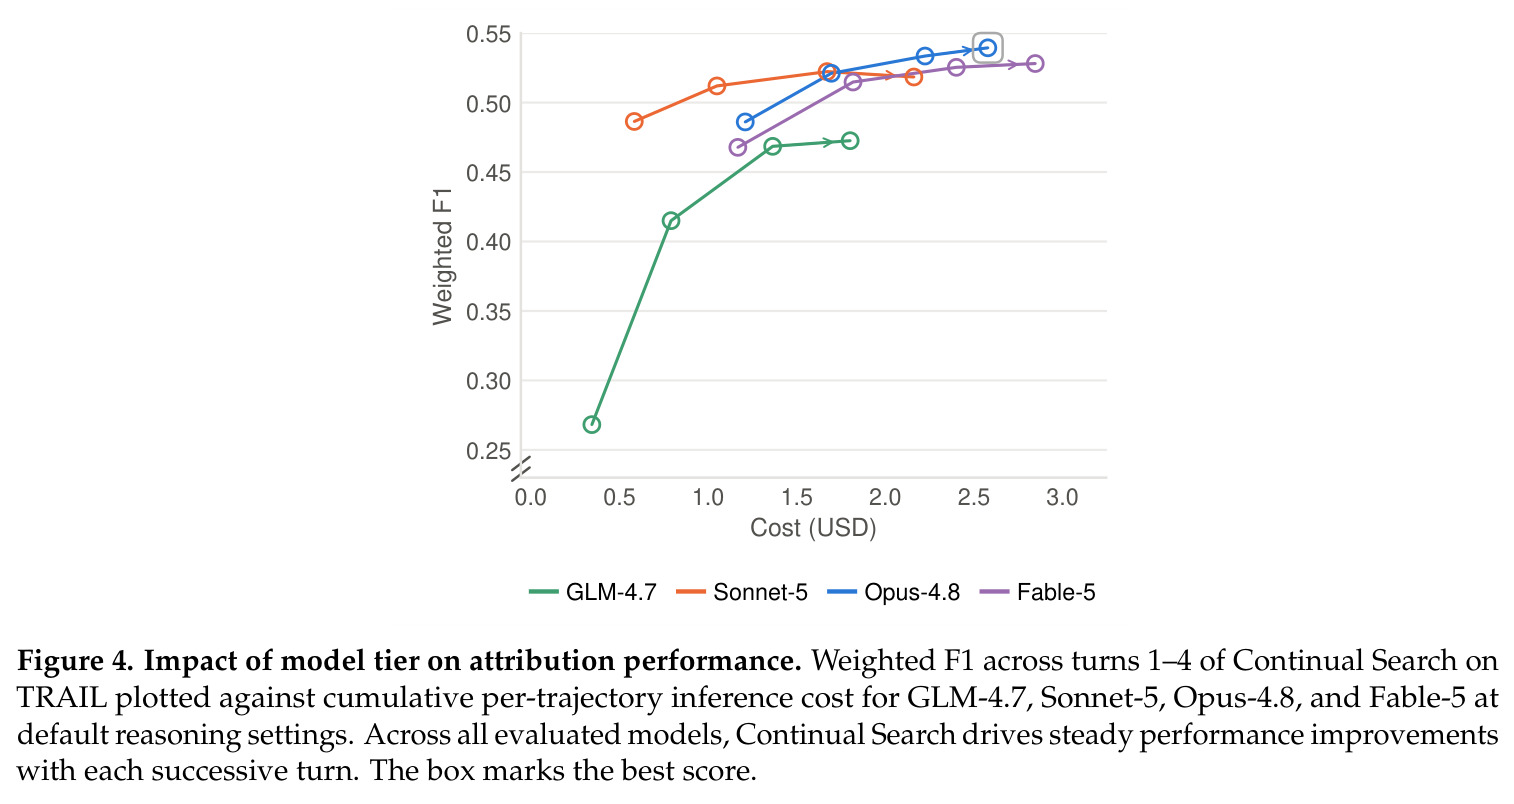
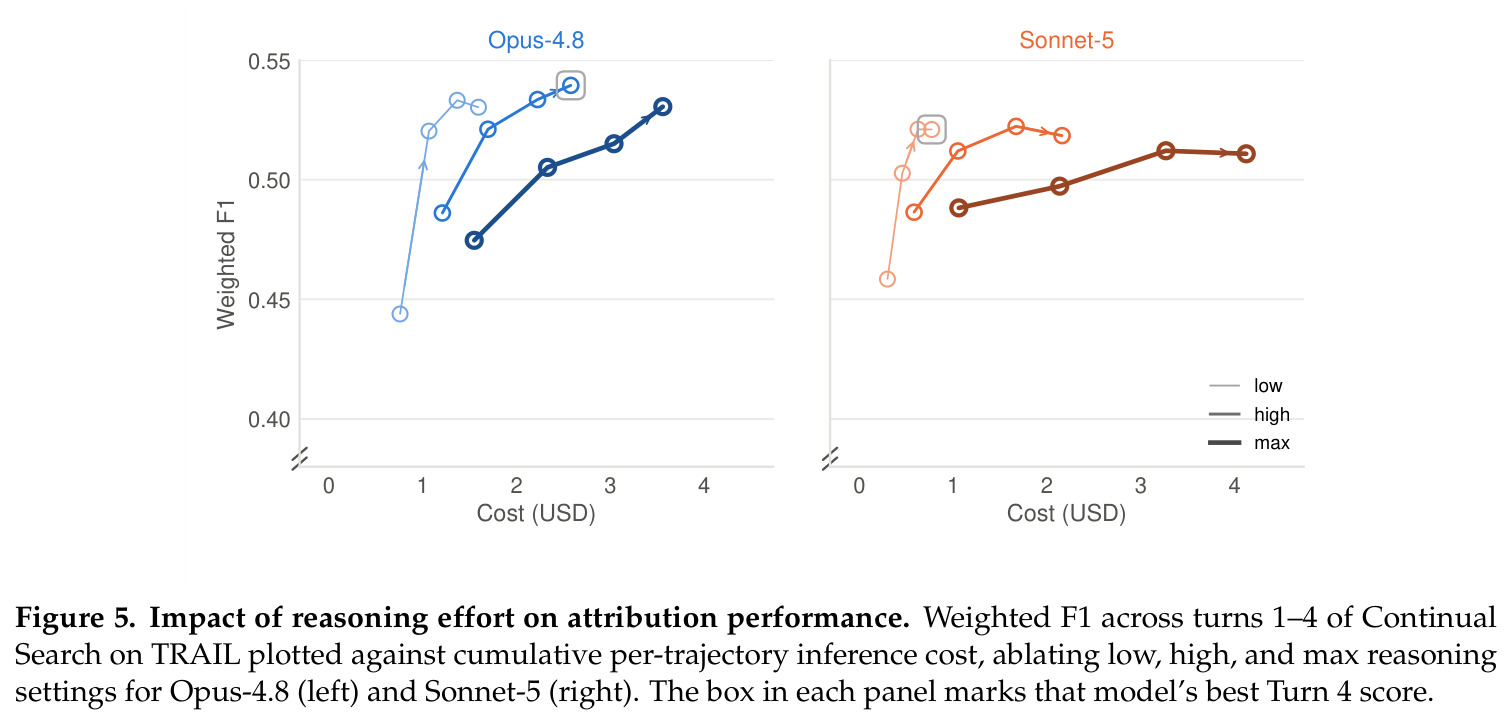
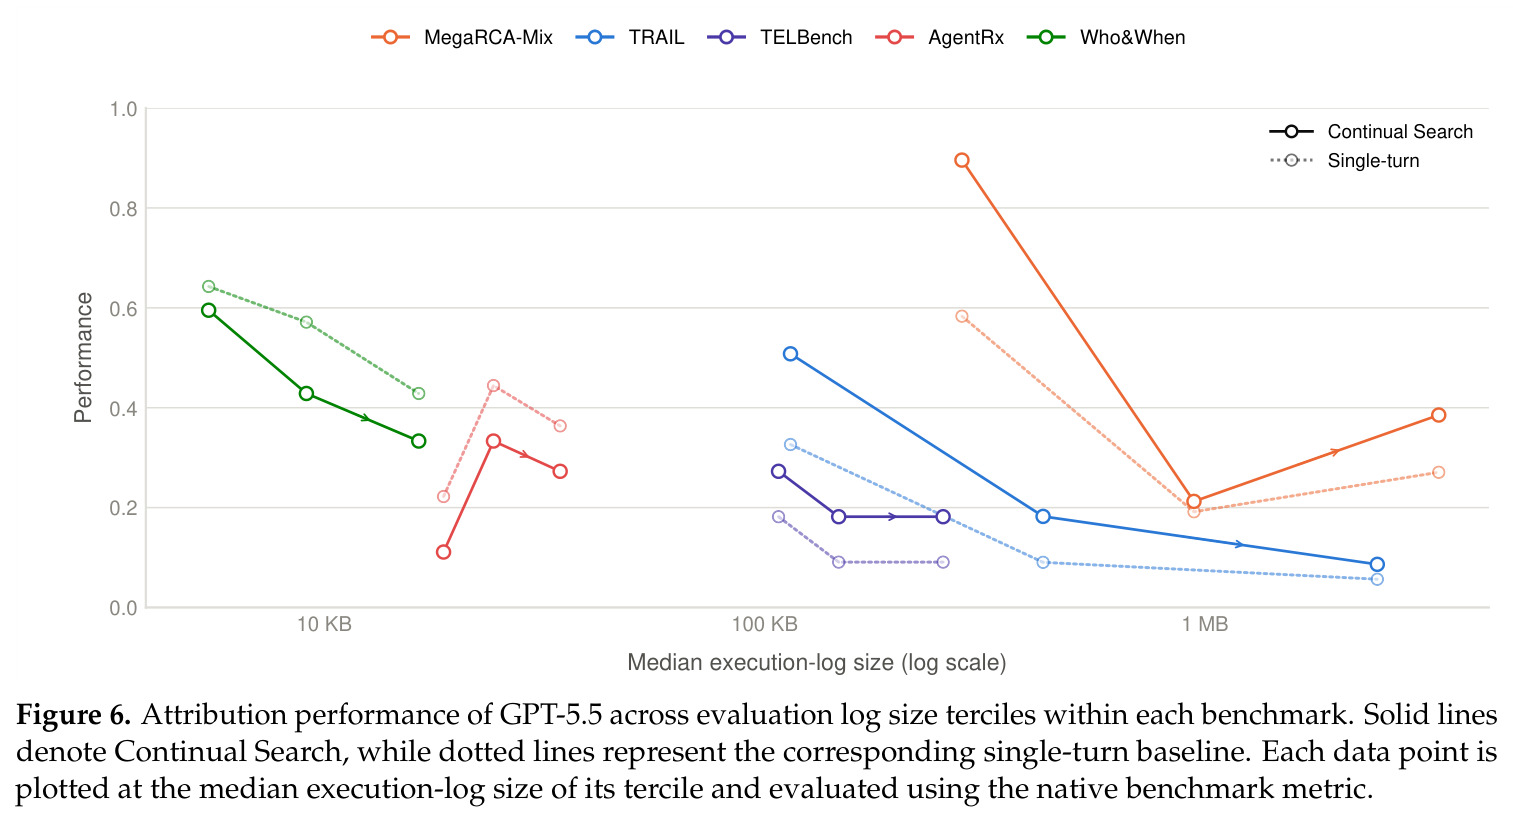
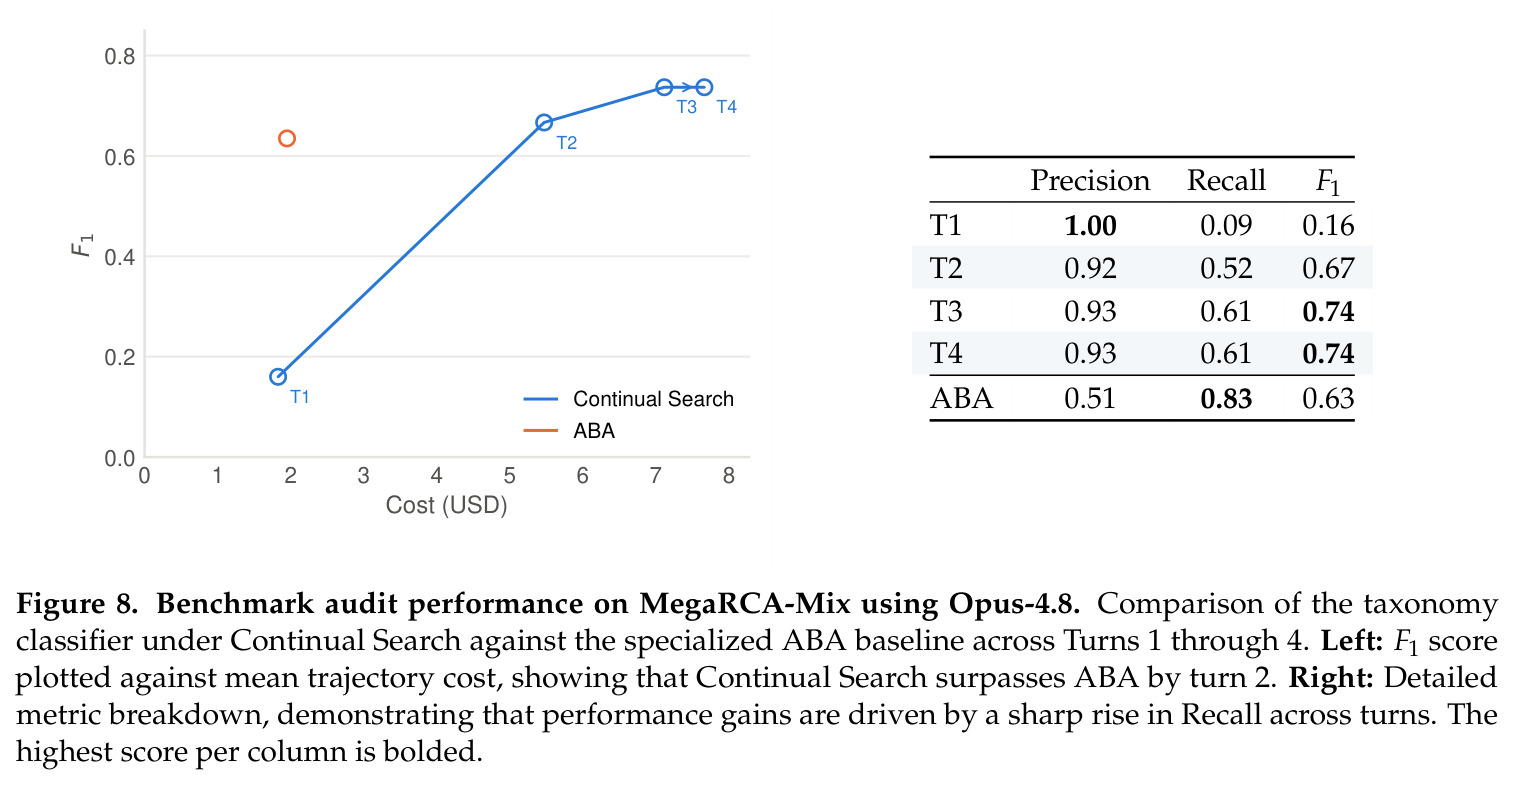
主结果集中在三个长日志基准(Table 2):MegaRCA-Mix 上 GPT-5.5 从单轮 $F_1$ 0.349 升到 0.498(相对提升超 40%),被动延续仅 0.401;Opus-4.8 从 0.478 到 0.620,被动延续 0.559。TRAIL 上 GPT-5.5 的 Joint Accuracy 0.156→0.257、Weighted F1 0.426→0.500;Opus-4.8 为 0.153→0.205 和 0.486→0.539。TELBench 上 GPT-5.5 从 0.121 到 0.212。模型规模实验(Figure 4)显示 GLM-4.7 四轮内从 0.268 升到 0.473;Sonnet-5 达 0.518,与 Fable-5 相当但只耗约 76% 算力,Opus-4.8 反超 Fable-5。推理努力消融(Figure 5)表明单轮内加大思考预算收益递减:Opus-4.8 低努力第 3 轮达 0.533,以约 62% token 开销追平高努力;Sonnet-5 低努力第 4 轮取得全场最高 0.521。与集成方法对比(Table 4),自一致性反而低于单轮(Opus Joint Acc 0.153→0.138),裁判面板仅 0.173/0.175,均远逊于持续搜索的 0.205/0.257,且自一致性更贵(GPT-5.5 每条轨迹 8.66 美元 vs 6.24 美元)。按日志大小分箱(Figure 6),三个长日志基准的所有三分位(最高分位中位 3.40 MB / 2.46 MB)持续搜索都优于单轮;而短轨迹的 AgentRx 和 Who&When 上(Table 3),GPT-5.5 反而从 0.345 降到 0.241、从 0.548 降到 0.452。基准缺陷检测应用(Figure 8)中,Opus-4.8 分类器 $F_1$ 从 T1 的 0.16 升至 T3 的 0.74(召回率 0.09→0.61、精确率保持 0.9 以上),超过专用管线 ABA 的 0.63。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MegaRCA-Mix 根因归因(GPT-5.5) | F1 | 0.498(4 轮持续搜索) | 单轮 0.349;被动延续 0.401 | +0.149,相对单轮提升约 42.7% |
| MegaRCA-Mix 根因归因(Opus-4.8) | F1 | 0.620(4 轮持续搜索) | 单轮 0.478;被动延续 0.559 | +0.142,相对单轮提升约 29.7% |
| TRAIL 归因(GPT-5.5) | Joint Accuracy / Weighted F1 | 0.257 / 0.500 | 单轮 0.156 / 0.426;被动延续 0.189 / 0.451 | Joint Accuracy +64.7%,Weighted F1 +17.4% |
| TRAIL 归因(Opus-4.8) | Joint Accuracy / Weighted F1 | 0.205 / 0.539 | 自一致性 0.138 / 0.430;裁判面板 0.173 / 0.431 | 显著超过两种集成基线,且成本($2.58/条)低于自一致性($6.52/条) |
| TELBench 归因(GPT-5.5) | Span Accuracy | 0.212(4 轮持续搜索) | 单轮 0.121;被动延续 0.152 | +75.2% |
| MegaRCA-Mix 基准缺陷检测(Opus-4.8) | F1(精确率 0.93 / 召回率 0.61) | 0.74(第 3 轮持续搜索) | 专用审计管线 ABA 0.63;单轮分类器仅 0.16 | 比 ABA 高 17.5%,第 2 轮即完成反超 |
局限与改进
作者承认两点局限。第一,轨迹可见性不完整:许多被评估的轨迹来自不暴露思考 token 的专有模型,真正的因果失败可能发生在不可观察的内部步骤里、只在下游留下痕迹,因此结果应理解为'对可观察记录的根因归因'。第二,前沿模型的绝对分数仍然很低(MegaRCA-Mix 上最好的 $F_1$ 也只有 0.620),作者怀疑现有失败分类学存在类别重叠、以及在巨型日志上建立可靠人工真值本身就会引入标签噪声。我自己的观察还有几点:MegaRCA-Mix 只有 50 条样本,单一指标点的波动会很大,结论的统计功效有限;固定 4 轮延续缺乏自适应停止准则,在短轨迹上继续追问是有害的,说明需要一个'还有没有未读证据'的停止信号;方法依赖精心设计的提示词,跨措辞的鲁棒性未系统测试;另外持续搜索成本不低(GPT-5.5 在 TRAIL 上每条轨迹约 6.24 美元),且收益随日志变大而增长,最需要它的场景恰恰是推理开销最大的场景。
独立分析的弱点
第一个弱点是停止机制缺位:框架固定跑 4 轮,而 AgentRx/Who&When 的结果表明无新证据可读时额外轮次会主动破坏正确判断(GPT-5.5 在 Who&When 上从 0.548 掉到 0.452),改进方向是让裁判每轮先自评'是否存在未读证据',没有就终止,或用去重观测 token 的增量作为停止信号。第二个弱点是证据检索仍是朴素阅读:裁判用只读工具顺序翻日志,面对中位 286K token 的记录没有检索、摘要索引或异常定位等结构性先验,可以把日志预解析成结构化时间线或语义索引来引导搜索方向。第三个弱点是评估面窄:MegaRCA-Mix 仅 50 条且全部来自 Harbor Index 生态、由 Claude Code 的 Opus-4.8 和 GPT-5.5 两个特定配置生成,可能带系统性偏差,应扩大多智能体框架和失败类型的覆盖。第四个弱点是提示词敏感性未报告:'挑战你的结论'这类措辞的效力可能高度依赖模型的对齐风格,需要跨措辞、跨温度的消融。第五,分类学本身的类别重叠问题未解决,作者也怀疑这压低了绝对分数,可对分类学做聚类或层级化重构后再评估。
未来方向
作者在引言中铺垫但未展开的方向包括:把根因归因接入智能体自我改进闭环——归因信号分别喂给后训练目标(模型侧失败)、harness 设计(harness 侧失败)和基准修复(环境/评分器侧失败),使 RCA 成为失败执行与系统持续改进之间的反馈层。基于本文成果可以自然延伸的研究有:其一,自适应搜索调度,学习何时继续搜、何时停止,把短轨迹上的性能倒挂变成可控开关;其二,把 Continual Search 与检索增强结合,用语义索引先缩小疑似区域再深挖,进一步压低成本;其三,从提示走向训练——用持续搜索产生的轨迹数据微调模型,使其内化'先穷尽证据再下结论'的策略;其四,把该框架迁移到其他长文档诊断任务,如长代码库的 bug 定位、生产系统事故复盘;其五,构建比 50 条更大的 MegaRCA 基准,并研究失败分类学的去重叠;其六,探索在多智能体系统中跨多个 agent 的日志做分布式根因搜索。
复现评估
复现的透明度较高但也有明显门槛。有利的一面:论文给出了完整实验设置——裁判用 Claude Agent SDK 实现、只读工具访问、各基准原生评分公式、以及两套延续提示词的逐字文本(附录 B.1/B.2),证据度量的 13-gram 去重方法写明了出处,被动延续对照的设计可以直接照搬,方法本身(提示词+多轮对话)极易复刻,工程难度低。不利的一面:MegaRCA-Mix 依赖 Harbor Index 的评测记录和 50 条人工根因标注,文中未见明确开源承诺,数据可得性存疑;实验涉及 GPT-5.5、Opus-4.8、Sonnet-5、GLM-4.7、Fable-5 等多个商业 API,成本不低——TRAIL 上持续搜索每条轨迹平均 2.58–6.24 美元,自一致性高达 6.52–8.66 美元,完整复现 Table 2/3/4 规模的实验预计需要数千美元量级;若要自建 MegaRCA 级别的标注数据,还需领域专家在巨型日志上做人工归因,耗时且易引入噪声。总体难度中等偏高:复刻方法框架容易,复现论文数字需要 API 预算和数据访问权限。
论文图表