UFO:面向多模态图像生成全条件对齐的原子化评估链框架 UFO: Chain-of-Evaluation for Omni-Condition Alignment in Multi-Modal Image Generation
把多模态生成评估拆成原子单元链式打分,与人类判断相关性提升15.25%
前置知识
主体驱动定制(Subject-Driven Customization)
多模态图像生成的一类核心任务:模型同时接收一段文本提示和特定主体的参考图,要求生成的新图像既符合文本语义,又保留参考图中主体未被文本要求修改的视觉属性。与图像编辑不同,主体允许以自由形态重新生成——姿态、位置、构图都可变化,因此"什么算保持一致"本身就难以判定。
本文的评估框架和 UFO-Bench 完全围绕这一任务构建;理解其自由生成特性,才能明白为什么逐模态孤立评估会产生假阳性/假阴性。
嵌入相似度指标(CLIP / DINO)
用预训练视觉-语言编码器分别提取生成图与参考图(或文本)的特征向量,以余弦相似度衡量一致性:CLIP-I 度量图像间概念保持,CLIP-T 度量图文一致,DINO 特征对物体级语义差异更敏感。这类指标计算便宜、无需大模型,但只反映全局特征相似度,无法判断细粒度属性是否真的被执行。
它们是论文实验中的传统基线,其与人类判断的弱相关甚至负相关(CLIP-T 为 -0.1996)正是论证"孤立评估已失效"的关键证据。
MLLM 评估器(VIEScore / DreamBench++)
让多模态大语言模型(如 GPT-4o)直接审图打分:VIEScore 把评估分解为语义一致性(SC)与感知质量(PQ)两个维度;DreamBench++ 则拆成概念保持与提示遵循两条独立链路,用 VLM 近似人类判断。相比嵌入指标更接近人类偏好,但评估对象仍是整图或孤立的单条维度,缺乏对图文条件交互的显式推理。
UFO 与这类方法是直接竞争对手;理解其"整体打分/孤立评估"范式,才能体会 UFO 原子化分解 + 模态分类的差异所在。
Spearman 秩相关系数
衡量两组排序一致性的非参数统计量:对每个测试案例,把 6 个模型的输出分别按指标得分和人类评分排序,计算两个排名向量的相关,取值范围 $[-1,1]$。论文逐案例计算后取平均,并用 Fisher Z 变换估计总体相关。该指标只关心相对次序,不关心分值绝对大小。
论文所有"与人类偏好对齐"的结论(表2、表3)都用它量化,是读懂实验数字的前提。
ArcFace 人脸识别
基于 Additive Angular Margin 损失训练的人脸识别模型,把人脸映射到角度间隔极大的嵌入空间,特征余弦相似度能可靠判断两张脸是否为同一人,广泛用于身份验证任务。其归一化特征距离可以转成 $[0,1]$ 的连续一致性分数。
UFO 把它作为"专用函数调用"的代表:识别出面部身份类评估单元时自动改用 ArcFace 而非 VLM 问答,是方法中专家工具弥补 VLM 短板的关键示例。
研究动机
多模态图像生成(尤其主体驱动定制)的评估严重滞后于生成模型本身。现有评估器分两类:CLIP、DINO 等嵌入相似度指标,以及 VIEScore、DreamBench++ 等 MLLM 打分器,共同缺陷是把文本条件与视觉条件分开、各自孤立评估,这与"多模态生成要求同时满足双模态条件"的目标本质冲突。直接后果是大量假阳性与假阴性:参考图中的人物按提示应被改造成红发海边钓鱼,若生成图忽略"红发"但仍与参考图相似,DINO/VIE-Score 仍判 Good(假阳性);漏画参考图中的辫子也查不出来;反之,正确执行文本编辑、保留身份的图却因视觉相似度下降被扣分(假阴性)。实验数据印证失效程度:CLIP-T 与人类判断的 Spearman 相关为 $-0.1996$,DINO 仅 $0.3084$,即便最强的 MLLM 基线 DreamBench++ 也只有 $0.5977$。此外现有基准(如 DreamEditBench、ImagenHub)图文条件交互类型少、冲突条件对稀缺,难以暴露这些失效模式。
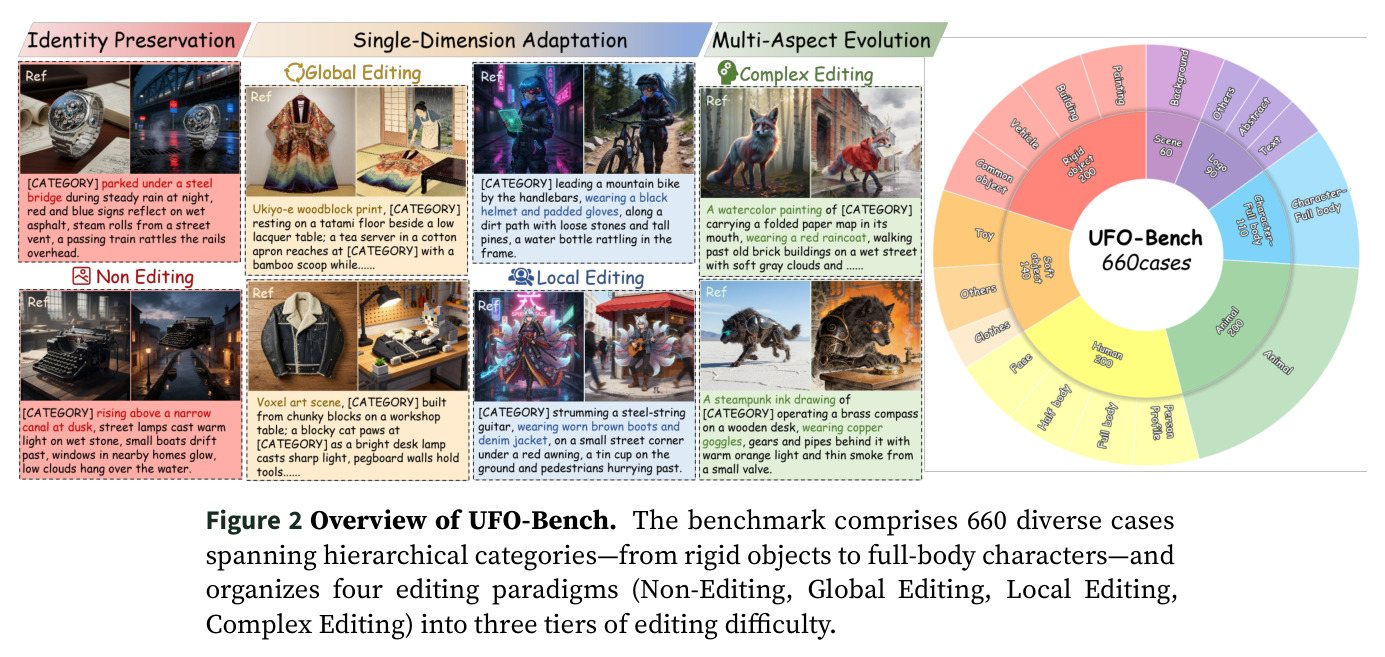
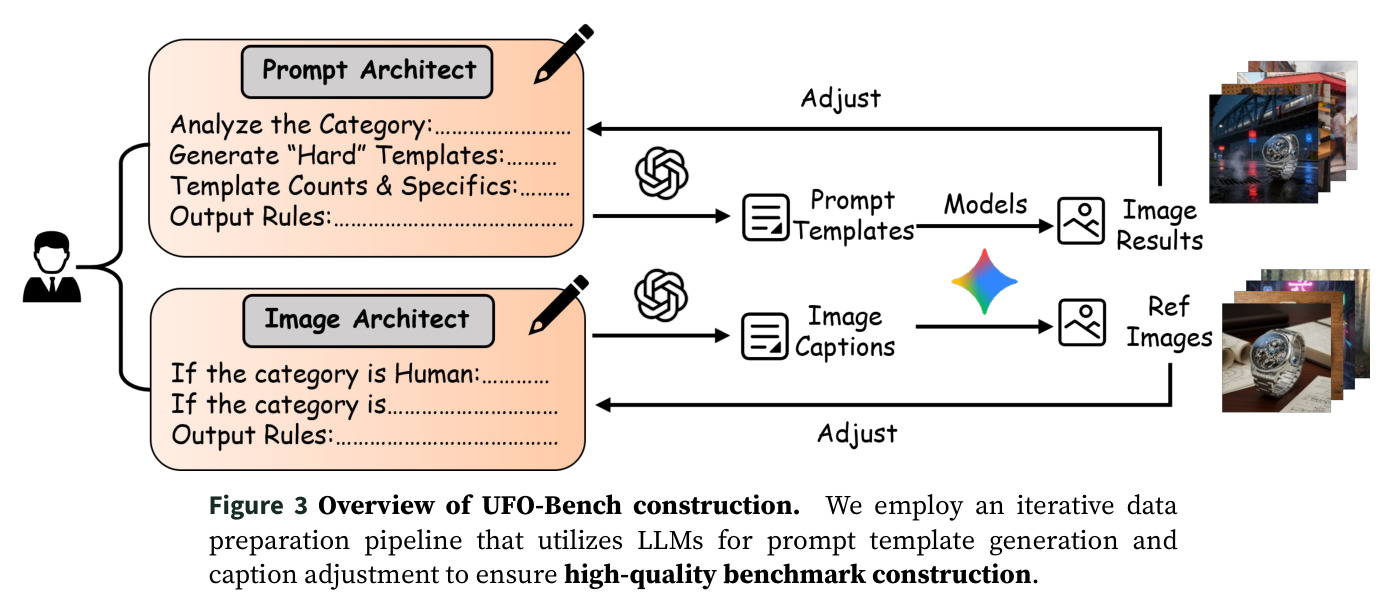
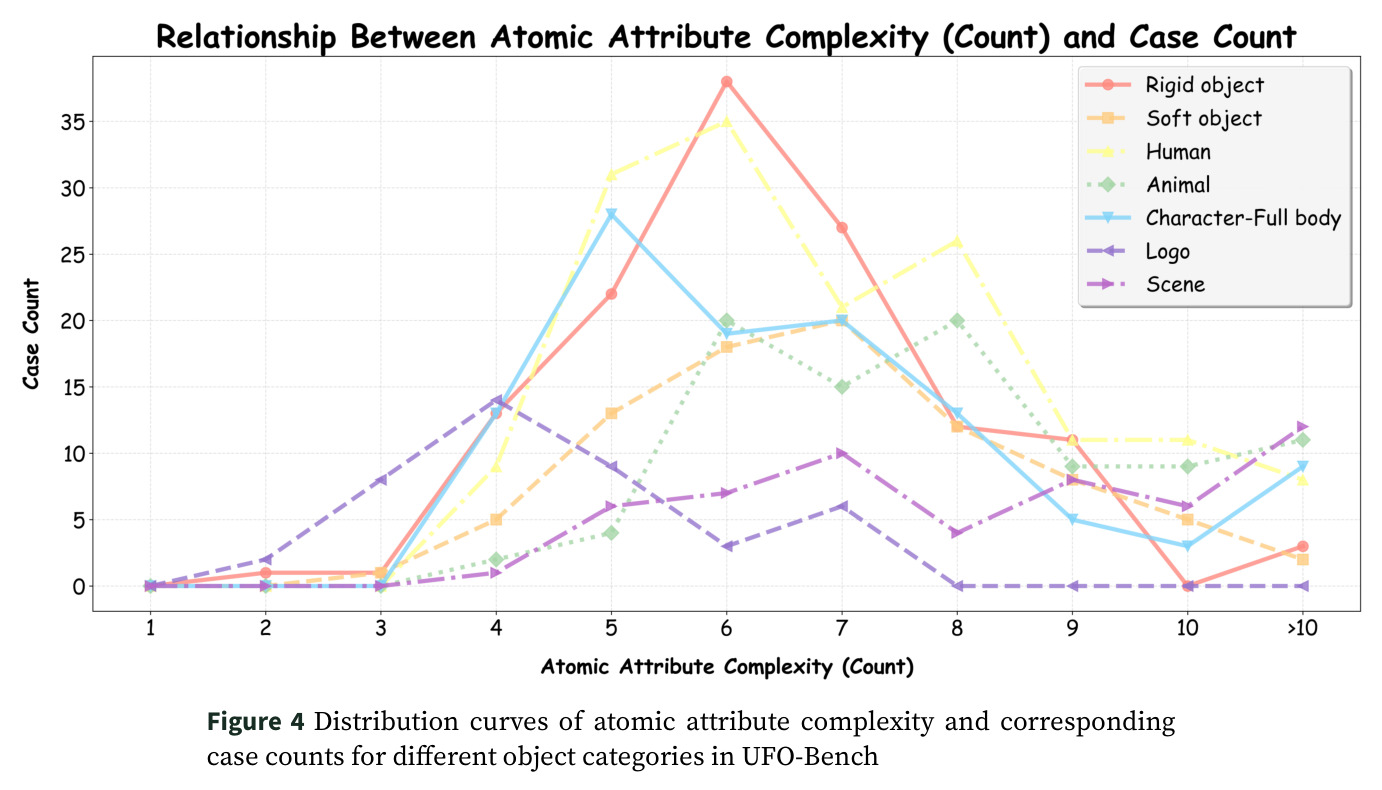
本文的目标是本文要建立一个可靠、自动、可复用的主体驱动生成评估范式,具体目标有三。其一,提出 UFO——首个面向 omni-condition 对齐同时评估的统一框架,通过"原子化评估链"把全条件对齐分解为细粒度、解耦的原子评估单元(AEU)并逐链验证,使自动指标与人类偏好高度一致(目标提升 15% 以上)。其二,构建 UFO-Bench:86 张参考图、7 大主体类别(刚体、软体、人物、全身角色、动物、Logo、场景)、660 个案例、Non-Editing/Local/Global/Complex 四种编辑范式、三层编辑难度,冲突条件对占 81.97%,专门弥补现有基准图文交互不足的缺陷。其三,用该框架系统评测 Doubao、Nano-Banana、Qwen-Image、UNO、OmniGen2、BAGEL 六个闭源与开源定制模型,输出可解释的总分与分维度诊断。
与已有工作不同的是,独特切入角度是"先拆解、再分类、后验证、终聚合"的原子化评估链范式。不同于 VIEScore 的图像级双维度打分或 DreamBench++ 的两条独立维度,UFO 先把对齐目标分解为局部具体组件(clothing、accessories、face 等)与全局抽象属性(gender、age group 等)两层的 AEU,再为每个 AEU 判定模态相关性类别(仅图像/仅文本/图文联合),把"该对照参考图还是该对照文本"显式编码进评估流程,从机制上消除孤立评估的假阳性与假阴性;验证环节创新性地混用通用 VQA 与专用函数调用(如 ArcFace 验证人脸身份),用专家模型补 VLM 之短;最后以自适应重要性加权聚合成可解释总分。这是对孤立评估范式的正面重构,而非简单堆叠多个指标。
核心方法
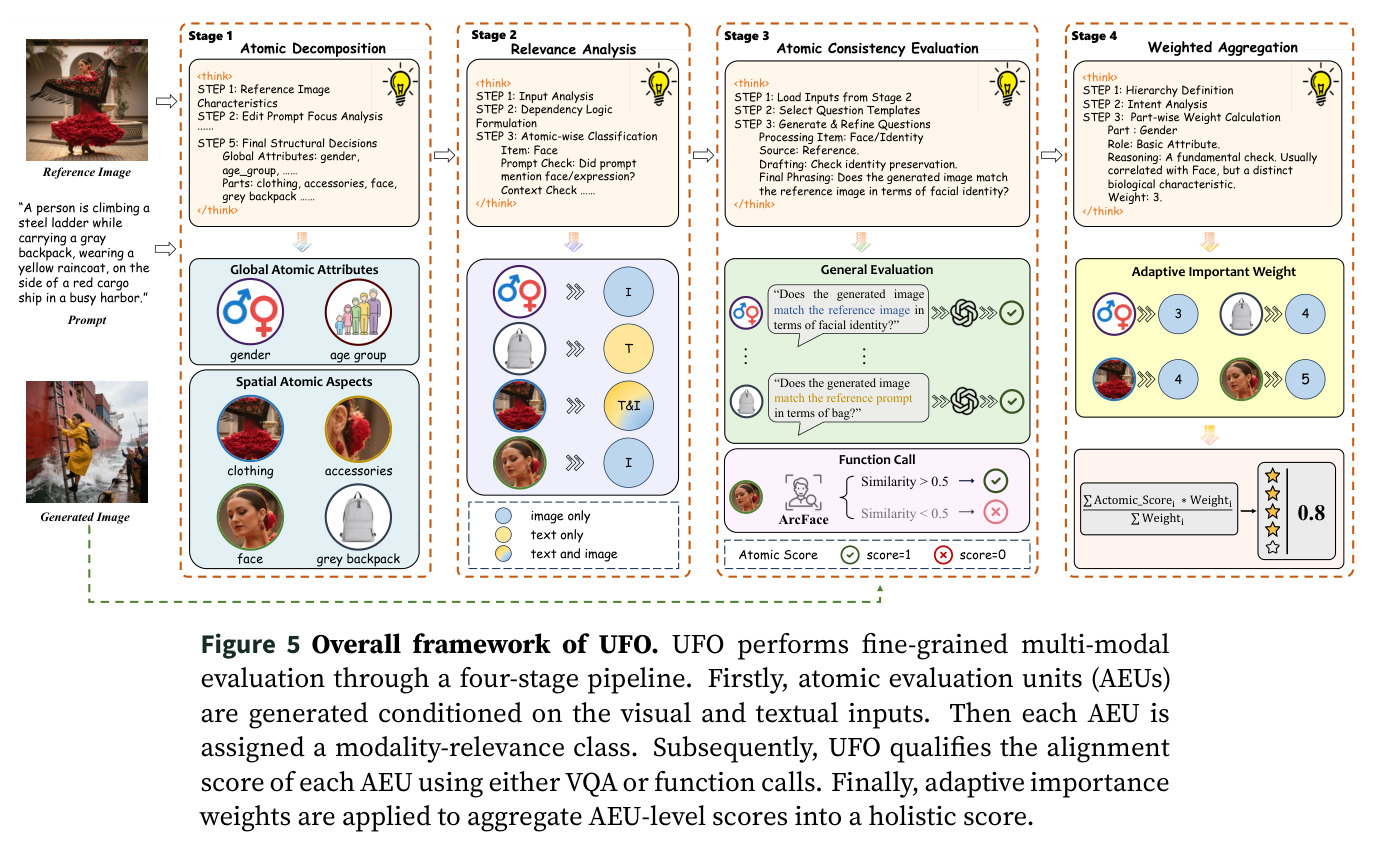
直觉上,评估“参考图+文本→生成图”应像人类评审:先弄清属性该对照参考图还是文本,逐条核对后按重要性汇总。UFO 将其工程化为四阶段。阶段 1 原子分解:把参考图 $I_{\mathrm{ref}}$ 与文本 $T_{\mathrm{ref}}$ 送入 VLM,联合推理主体特征与编辑约束,把对齐目标拆成局部具体组件与全局抽象属性两层、解耦的原子评估单元。阶段 2 模态相关性分类:为每个 AEU 赋予 image-only / text-only / text-and-image 三类之一,确保对照正确的条件评估。阶段 3 打分:通用 AEU 转成 VQA 问题,Yes/No 映射为 $s_i \in \{0,1\}$;身份类 AEU 调用专用函数,如 ArcFace 得 $s_i = 1-d_{\mathrm{ArcFace}}(I_{\mathrm{ref}},I_{\mathrm{gen}})$。阶段 4 加权聚合:按 $Score=\sum_i w_i s_i/\sum_i w_i$ 输出总分,权重 $w_i \in \{1,\dots,5\}$ 由 VLM 依重要性推理给出。
核心创新是把一致性评估形式化为"自由形态多模态条件下的原子化、条件感知推理"。与已有方法的本质区别有三。第一,评估对象从"整图得分"变为"原子评估单元链":每个 AEU 只回答一个可判定的问题,避免 VLM 整体打分时遗漏细粒度细节——消融显示去掉分解后人类相关性从 $0.6889$ 跌至 $0.5752$。第二,模态相关性分类让每个属性对照正确的条件类型:如面部身份归 image-only(只看与参考图是否同人)、新增背包归 text-only(只看提示是否满足)、颜色修改归 text-and-image,从机制上消除孤立评估的假阳性(漏检文本要求的修改)与假阴性(惩罚正确编辑)。第三,通用 VQA 与专用函数调用混合:VLM 擅长语义判断但身份验证精度不足,UFO 在 AEU 分类为面部身份时自动改用 ArcFace 高精度计算 $s_i = 1 - d_{\text{ArcFace}}(I_{\text{ref}}, I_{\text{gen}})$。消融进一步证明自适应加权不可缺(去掉后降至 $0.6253$):次要属性违规不应过度惩罚总分,关键指令执行应被充分奖励。
方法步骤详情
以图 5 案例说明:输入人物参考图与文本“穿黄雨衣爬钢梯、背灰背包、站在港口红色货船旁”。阶段 1 原子分解:VLM 做输入分析(识别 gender、clothing、face 等属性与部件)与意图分析(提示是否涉及面部修改),输出两层 AEU 列表,如“面部身份”“灰背包”等。阶段 2 模态相关性分析:对每个 AEU 推理依赖逻辑并分类——面部身份为 image-only,背包/雨衣为 text-only,带属性修改的部件为 text-and-image。阶段 3 原子一致性评估:生成 VQA 问题逐个询问“生成图是否满足 X”,Yes 记 $s_i=1$、No 记 $s_i=0$;面部身份类调用 ArcFace,按 $s_i = 1-d_{\mathrm{ArcFace}}(I_{\mathrm{ref}},I_{\mathrm{gen}})$ 归一化到 $[0,1]$。阶段 4 加权聚合:VLM 计算部件级权重(如面部身份权重 3),按总述中的公式加权平均,输出可解释总分。评测时每案例采样 4 次、共 2640 实例/模型,判决模型为 GPT-4o(2024-05-13)。
技术新颖性
技术新颖性体现在三个层面。概念层:首次提出 omni-condition 对齐的同时评估这一问题的形式化,把一致性评估定义为"自由形态多模态条件下的原子化、条件感知推理",而非图像级相似度回归或整体打分。技术层:Atomized Chain-of-Evaluation 是一条四步链式推理范式——分解、分类、验证、聚合各自可插拔;验证环节创新性混用通用 VQA 与专家函数调用(ArcFace),让 VLM 的语义推理能力与专用判别模型的精度互补,这与 DreamBench++ 全靠 VLM 绝对打分、VIEScore 只拆 SC/PQ 两个维度的做法有本质差异;模态相关性分类(image-only/text-only/text-and-image)则是首个把"条件来源"显式建模进自动评估器的设计。基准层:UFO-Bench 用分层提示策略构造出 81.97% 冲突条件对,刻意制造"身份保持 vs 语义修改"的张力,专为暴露孤立评估的失效模式而设计。15.25% 的平均相关性提升与消融分解(分解贡献 0.1137、加权贡献 0.0636)共同验证了每个组件的独立价值。
实验结果
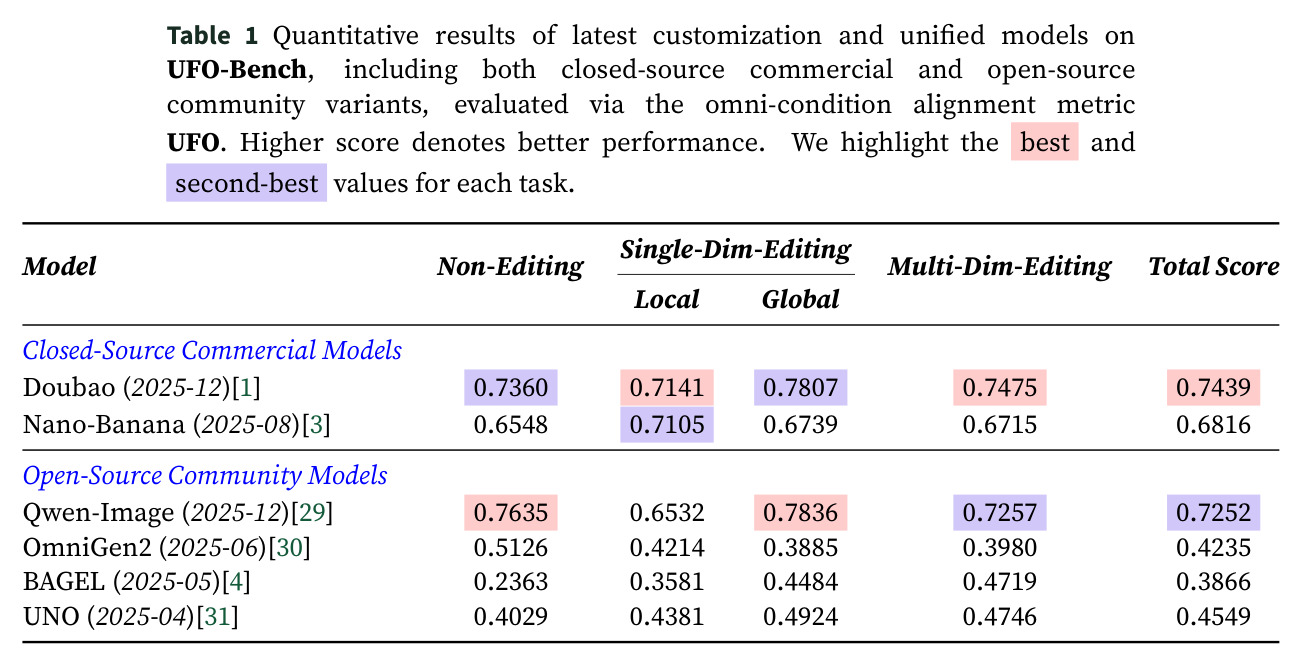
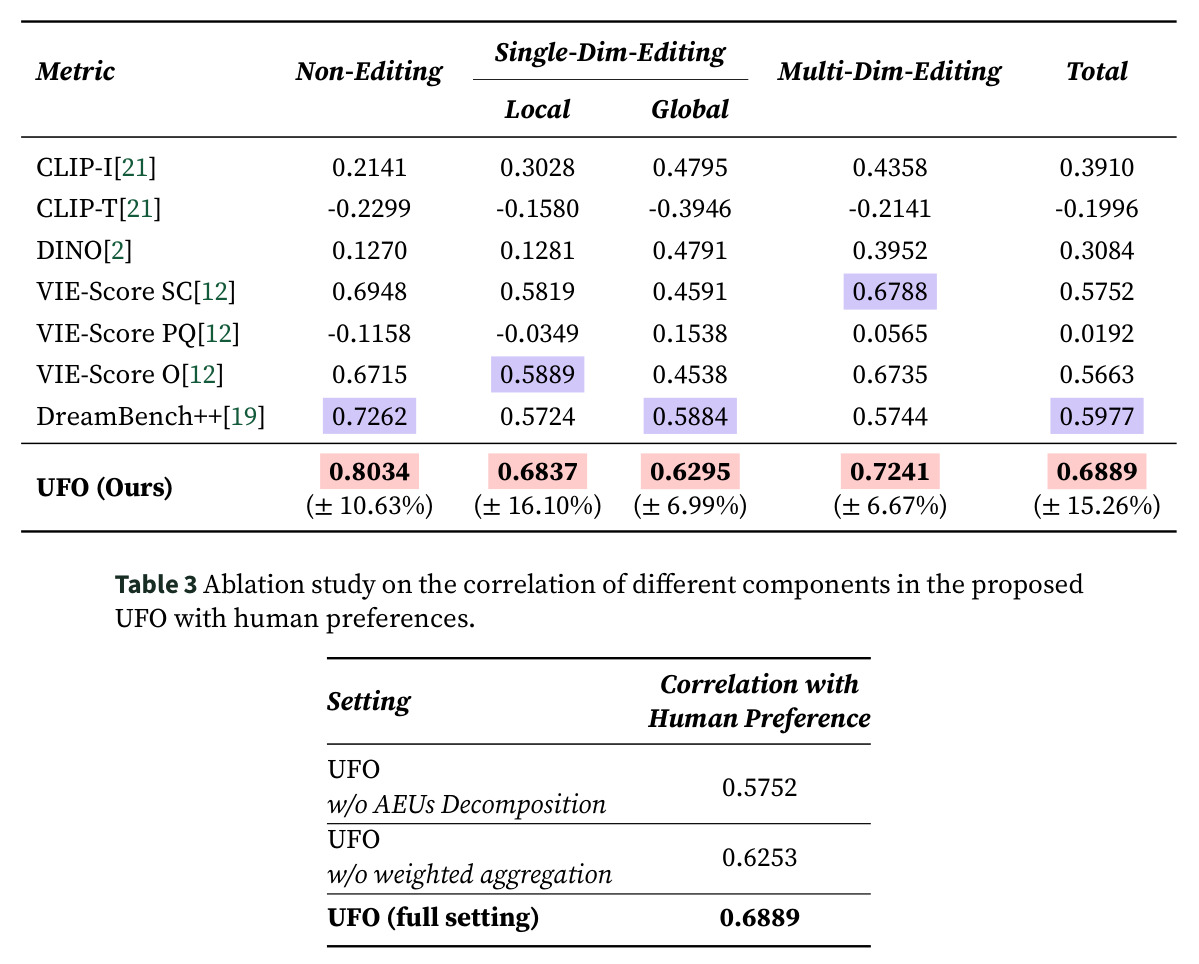
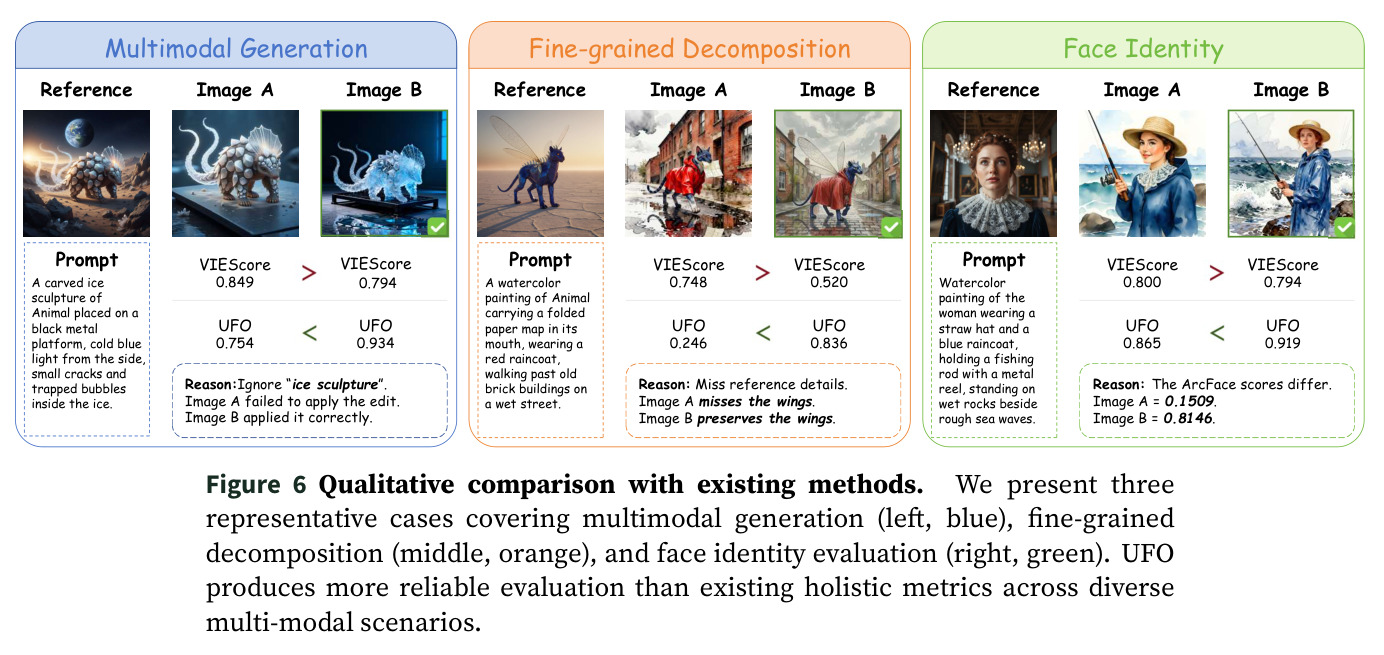
人类对齐实验在 100 个随机案例(6 模型共 600 图)上进行,逐案例计算与人类排序的 Spearman 相关后取平均。UFO 总相关 $0.6889$,比次优 DreamBench++($0.5977$)高 15.26%,四个维度全部第一(最高 $0.8034$)。传统指标严重失灵:CLIP-T 为 $-0.1996$,DINO 仅 $0.3084$。消融证实两组件缺一不可:权重全置 1 降至 $0.6253$,去掉原子分解(整图打分)暴跌至 $0.5752$。UFO 评测 6 个模型(每模型 2640 实例):闭源 Doubao 以 $0.7439$ 居首;开源 Qwen-Image $0.7252$ 超过闭源 Nano-Banana($0.6816$),在 Non-Editing 与 Global 上反超 Doubao($0.7635/0.7836$),但 Local 掉到 $0.6532$,暴露精细编辑短板;UNO、OmniGen2、BAGEL 垫底($0.4549$/$0.4235$/$0.3866$)。图 6 定性案例还显示 UFO 能识别编辑忽略与身份错换。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 与人类偏好对齐(UFO-Bench 全任务总体) | 平均 Spearman 秩相关 | UFO 0.6889 | DreamBench++ 0.5977 / VIE-Score SC 0.5752 | +15.26%(相对次优基线) |
| Non-Editing 与人类偏好对齐 | Spearman 秩相关 | 0.8034 | DreamBench++ 0.7262 | +10.63% |
| Local Editing(局部编辑)与人类偏好对齐 | Spearman 秩相关 | 0.6837 | DreamBench++ 0.5724 / VIE-Score O 0.5889 | +16.10% |
| Global Editing(全局编辑)与人类偏好对齐 | Spearman 秩相关 | 0.6295 | DreamBench++ 0.5884 | +6.99% |
| Multi-Dim Editing(复杂编辑)与人类偏好对齐 | Spearman 秩相关 | 0.7241 | VIE-Score SC 0.6788 / DreamBench++ 0.5744 | +6.67% |
| 消融:完整 UFO vs 去掉原子分解(整图直接打分) | Spearman 秩相关 | 0.6889 | w/o AEUs Decomposition 0.5752 | +0.1137(约 +19.8%) |
| 消融:完整 UFO vs 均匀权重聚合 | Spearman 秩相关 | 0.6889 | w/o weighted aggregation 0.6253 | +0.0636(约 +10.2%) |
局限与改进
作者坦承本文聚焦"基础且良定义"的单参考图 + 单文本个性化生成设定,作为更复杂多图、多轮生成场景的必要基础,尚未覆盖开放式多模态生成。可观察到的其他局限:判决模型绑定 GPT-4o 特定版本(2024-05-13),跨版本可复现性与长期可用性存疑;VQA 得分是二值 $\{0,1\}$,对"部分满足"的连续质量差异不敏感;权重限制在离散 $\{1,\dots,5\}$ 且由 VLM 主观推理给出,可能引入噪声;专用函数调用目前主要示例是人脸身份(ArcFace),对 Logo、软物体、动物等非人脸主体缺少同等精度的专家工具;人类评估仅基于 100 案例 600 张图的子集,统计功效有限;UFO 总相关 $0.6889$ 意味着仍有约三成模型排序与人类不一致;基准仅 86 张参考图、660 案例,规模偏小,且 81.97% 的高冲突条件对占比可能使评测偏向难例分布。
独立分析的弱点
第一,二值 VQA 打分丢失细粒度:一条 Yes/No 问答无法区分"背景对了但光影穿帮"与"完全符合",改进方向是把关键 AEU 升级为连续分数或引入多子问题投票。第二,专家工具覆盖面窄:只有人脸身份走 ArcFace,服装款式、材质、姿态、文字渲染等同样存在专用模型(如 DWPose、属性分类器、OCR),当前缺少系统化的"函数调用注册表"与路由机制。第三,自适应权重是 VLM 主观输出的 1-5 整数,缺乏校准与不确定性估计,在边界案例上可能误判重要性,可改为从人类偏好数据中学习连续权重。第四,评估成本高:每张图需多轮 VLM 调用(分解 + 分类 + 逐 AEU 问答 + 权重),2640 实例/模型的评测开销可观,可蒸馏为轻量评估器或缓存跨模型共享的 AEU 分解结果。第五,判决模型单一(GPT-4o 单一版本),结论可能受特定判决偏差影响,宜用多判决模型集成做敏感性分析。
未来方向
作者明确提出本框架面向"更复杂的多图与多轮生成场景"的基础定位,自然延伸是把 AEU 分解扩展到多参考图(换装、多主体组合)与多轮编辑对话,处理条件间的时序依赖与累积冲突。基于本文成果还可延伸:其一,把 UFO 分数作为奖励信号用于强化学习或 DPO 微调生成模型,形成"评估即训练信号"的闭环;其二,构建可插拔的专家函数库(姿态、深度、材质、文字、多人脸身份),让模态相关性分类直接路由到对应工具;其三,将 1-5 离散权重替换为从人类两两偏好中学习的连续权重模型,并把二值 VQA 换成校准的概率输出;其四,扩大基准规模并纳入视频与 3D 定制任务;其五,蒸馏 UFO 为小型开源判决模型,降低对 GPT-4o 的依赖与调用成本。
复现评估
开源情况较好:代码在 github.com/UFOTeamwork/UFO,UFO-Bench 数据在 Hugging Face(UFOTeamwork/UFO-Bench),含 86 张参考图与 660 个案例可直接下载。复现评估流程的主要依赖是 GPT-4o API(论文锁定 2024-05-13 版本以保证公平比较)与 ArcFace 预训练模型,全程无需训练、纯推理即可。算力瓶颈在生成环节:每个模型需对 660 个参考-提示对各采样 4 次、共 2640 张图,跑开源模型(Qwen-Image、UNO、OmniGen2、BAGEL)需要单卡到多卡 A100 级别资源,GPT-4o 每图多次调用也产生持续 API 费用。人类评估部分(100 案例、600 图的 6 图排序)普通团队难以完全复刻,但可用小规模众包近似。总体难度中等:流程与超参描述清晰、数据代码公开,主要门槛是 API 成本与被评模型的生成算力。
论文图表
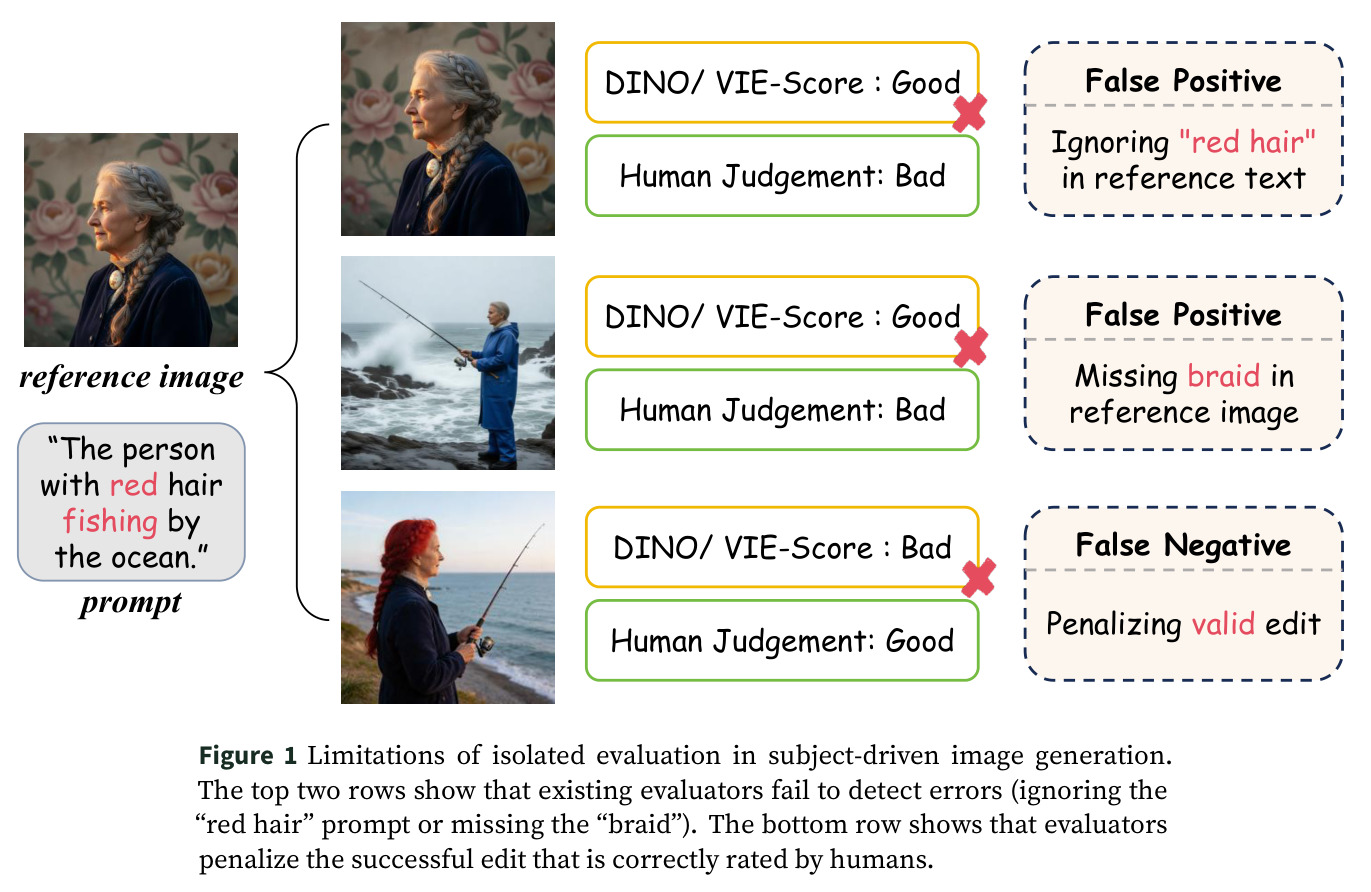
三组对照示例:给定一张红发人物参考图与"红发人物在海边钓鱼"的提示,上两行中生成图分别忽略了"红发"提示与参考图中的辫子细节,DINO/VIE-Score 都给出 Good 评分(假阳性),而人类判为 Bad;最后一行中正确执行了文本编辑、保留主体身份的生成图,却因与参考图视觉相似度下降被打 Bad(假阴性),人类反而判为 Good。
这是全文动机的浓缩:用最直观的假阳性/假阴性案例说明孤立评估范式的失效机制,理解这张图就理解了 UFO 为什么必须做条件感知的原子化评估。
UFO 与 7 个自动指标的人类对齐对比(Spearman 秩相关):CLIP-I 0.3910、CLIP-T -0.1996、DINO 0.3084、VIE-Score SC 0.5752、VIE-Score PQ 0.0192、VIE-Score O 0.5663、DreamBench++ 0.5977,UFO 总相关 0.6889(比次优高 15.26%),且在 Non-Editing 0.8034(+10.63%)、Local 0.6837(+16.10%)、Global 0.6295(+6.99%)、Multi-Dim 0.7241(+6.67%)四个维度全部领先。
这是论文最核心的实验表:直接量化"UFO 更接近人类判断"的中心主张,传统嵌入指标为负/弱相关的数据也是全文动机的实证支撑。