HuRo:机器人化人类视频构建大规模VLA预训练数据集 HuRo: Robotizing Human Videos for Scalable VLA Pretraining
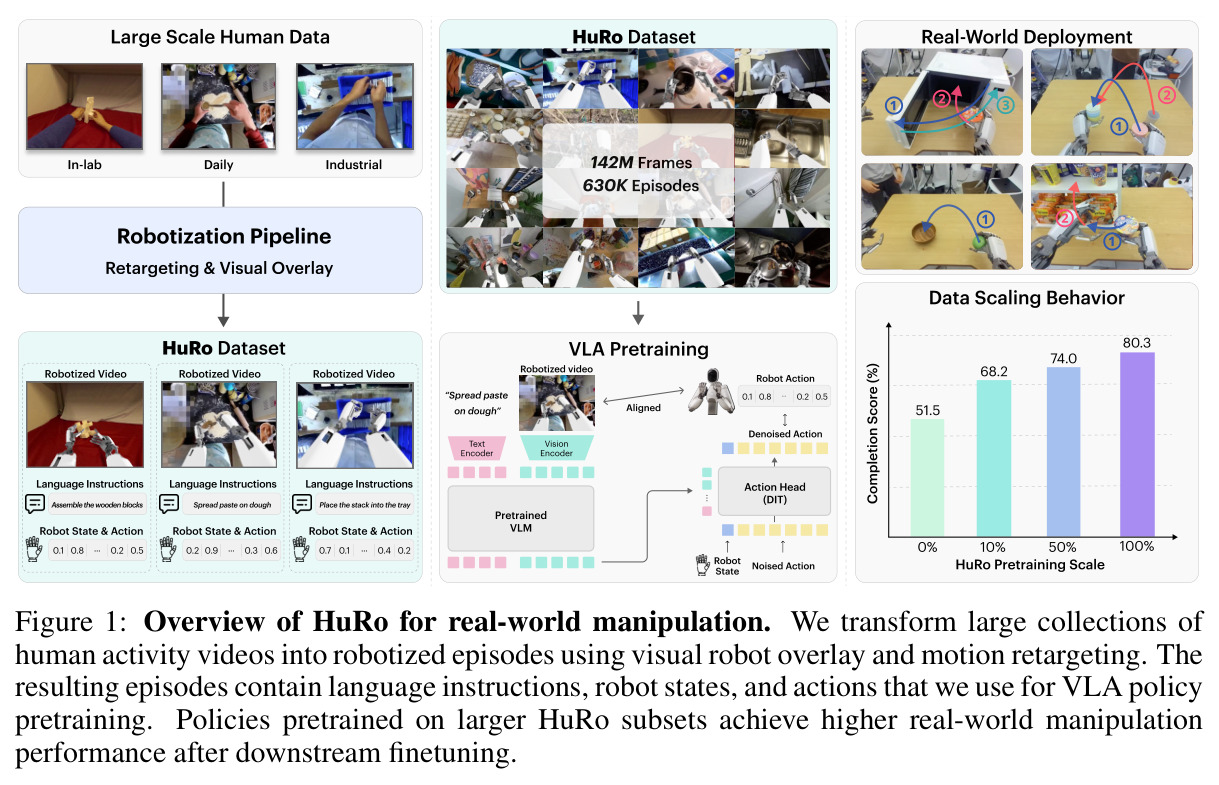
把63万条人类视频改造成机器人演示,VLA真机完成率从51.5%升至80.3%
前置知识
VLA(视觉-语言-动作)模型
VLA 是机器人操作的主流框架:视觉语言骨干(VLM)把当前图像和语言指令编码为嵌入,动作头(常见为扩散或流匹配式 DiT)在该嵌入与机器人状态的条件下输出未来 H 步动作块。GR00T N1、π0 等系列工作表明预训练数据越多,下游真机表现越好。
本文的核心问题就是能否用机器人化的人类视频替代昂贵的真机数据做 VLA 预训练,并系统衡量预训练数据规模对下游真机性能的影响。
具身鸿沟(Embodiment Gap)
指人类与目标机器人在观察与动作两层的不一致:外观上人手与机械臂+灵巧手形态迥异,运动学上人手自由度与机器人关节空间完全不同。要用人类视频训练机器人策略,必须同时把观察(画面)和动作(轨迹)都对齐到目标机器人上。
论文整条流水线都围绕弥合该鸿沟设计:视觉机器人化处理观察差异,运动重定向处理动作差异,两者各自贡献正是实验要解耦的重点。
运动重定向(Motion Retargeting)
把一种身体(如人手)的运动映射到另一种身体(如机械臂+灵巧手)关节空间的过程。通常先提取人手关键点(腕部、指尖),再通过逆运动学求解使机器人末端跟踪这些目标,并施加运动学正则与时间平滑约束以获得可行轨迹。
HuRo 用 PyRoKi 分两阶段把 MANO 手部姿态重定向为 ALLEX 关节轨迹,动作标签 $a_t = s_{t+1}$ 正是从重定向后的状态序列推导出来的。
自我中心视频(Egocentric Video)
由头戴相机拍摄的第一人称视角视频,代表数据集有 Ego4D、EPIC-Kitchens 等。它天然记录人类日常操作物体时手与场景的交互,视角接近机器人头部相机,因此被视为最接近机器人第一视角的廉价数据来源。
HuRo 的五个数据源(EgoDex、EgoVerse、Ego4D、Ego10K、EPIC-Kitchens)全部是自我中心视频,相机轨迹估计与机器人叠加渲染都依赖这一视角假设。
MANO 与 3D 手部姿态估计
MANO 是参数化人手网格模型,用少量关节角与形状参数即可生成含 20 余个关节的 3D 手部网格。HAWOR 等方法从单目视频逐帧估计 MANO 姿态,从而恢复腕部轨迹、指尖位置等 3D 运动线索。
论文用 HAWOR 从人类视频提取手部姿态:手腕轨迹供 VLM 生成指令时参考,指尖位置与手部结构线索则是重定向为机器人动作的直接输入。
流匹配(Flow Matching)
一种生成式训练目标:学习向量场把简单分布(如高斯噪声)沿近似直线的概率路径输运到数据分布,相比扩散模型训练更稳定、采样步数更少。在 VLA 动作头中用于从噪声生成连续动作块。
HuRo 的动作头沿用 GR00T-N1.6-3B 的流匹配目标做端到端预训练与微调,理解该目标有助于明白重定向动作监督是如何进入训练损失的。
逆动力学模型(IDM)
给定相邻帧或一段观测、预测其间所执行动作的模型,常用于给无动作标签的视频打伪动作标签。DreamGen 等生成式数据管线即由图像到视频模型(I2V)生成画面、再用 IDM 标注伪动作。
第 4.5 节将 HuRo 与 DreamGen 式 I2V+IDM 基线在匹配帧预算下对比,IDM 是理解这条生成式数据路线及其瓶颈的关键组件。
研究动机
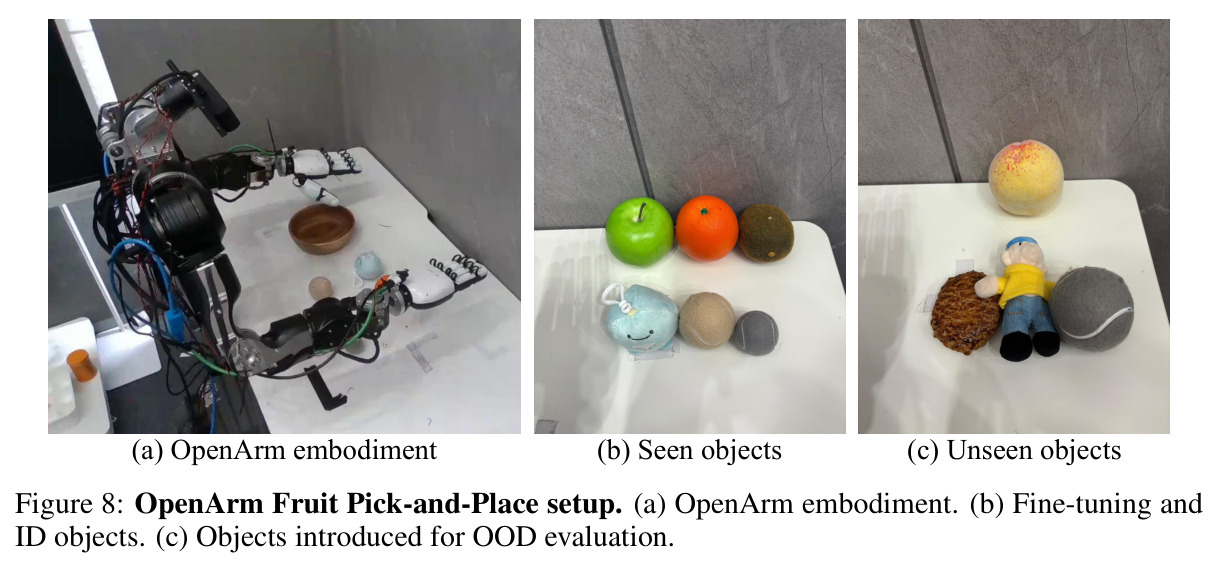
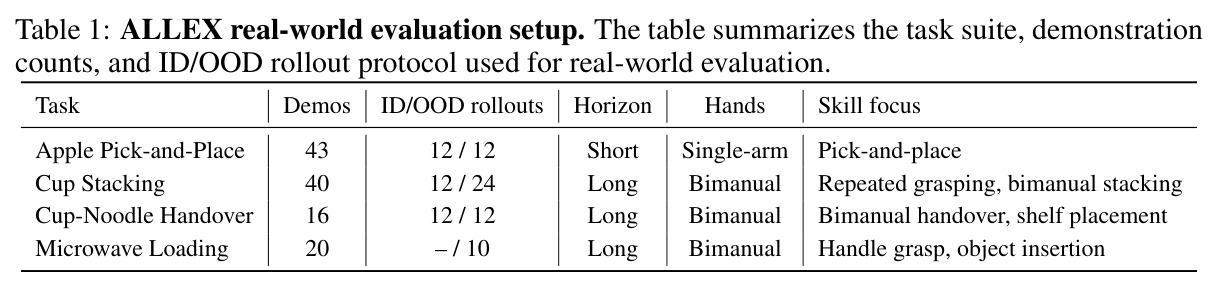
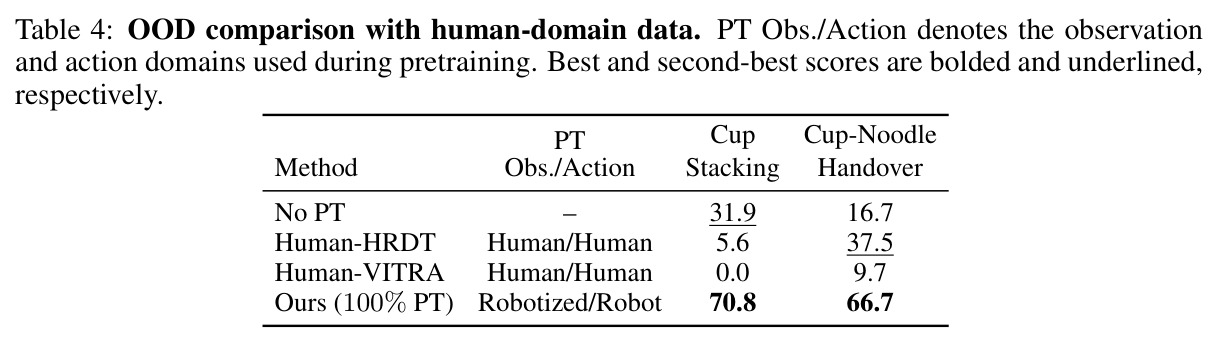
VLA 策略的性能高度依赖预训练数据规模,但真机交互数据采集成本极高:本文 4 个下游任务仅收集 119 条演示(苹果抓放 43 条、叠杯 40 条、泡面传递 16 条、微波炉装载 20 条)就需大量人工与设备时间。相比之下人类视频便宜且多样,Ego4D、EPIC-Kitchens 等数据集覆盖海量物体、场景、视角与操作行为。然而直接用人类视频训练机器人策略面临具身鸿沟:画面里是人手而非机械臂,动作也没有机器人关节标签。已有方案局限明确:Phantom、DexUMI、WARPED、RwoR、MimicDreamer 等联合对齐观察与动作的方法都在任务匹配设置下工作——为特定下游任务专门采集或转换人类演示,无法作为可扩展数据源;H2R、Masquerade 只做视觉机器人化,用于 MAE/R3M 视觉表征或未来末端预测等辅助目标;VITRA、EgoScale 只重定向动作却保留人类中心观察。换言之,异构人类视频能否作为大规模、观察-动作联合对齐的机器人监督来源,此前没有系统性答案。
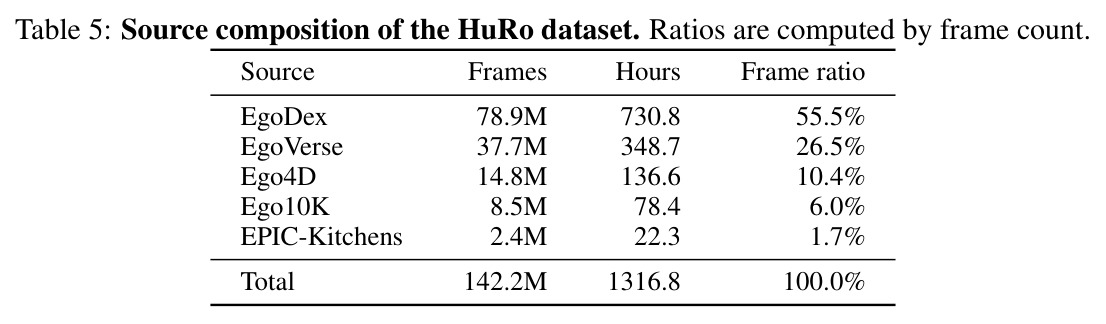
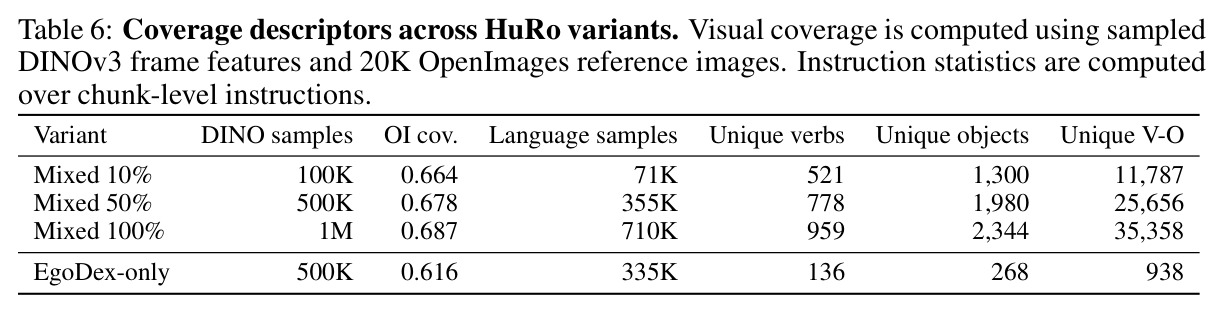
本文的目标是本文的目标是构建并系统评估一条"人类视频→机器人化数据"的可扩展数据引擎。具体分三层:第一,开发一条机器人化流水线,把标注水平参差不齐的异构自我中心视频转换成统一的机器人观察-动作格式,按需自动推断缺失的中间信号(相机内参、米制尺度、重力方向、手部姿态、语言指令);第二,用该流水线构建 HuRo 数据集,规模远超以往同类工作:约 63 万条机器人化 episode、1.42 亿处理帧,来自 5 个人类视频源,并实例化到 ALLEX 双臂灵巧机器人;第三,在 4 个真机任务上系统回答三个问题——下游性能是否随机器人化数据量增加而提升(0%/10%/50%/100% 子集)、视觉机器人化(渲染叠加机器人)是否必要、重定向动作的端到端监督是否优于纯视觉迁移,并与 DreamGen 式视频生成数据(I2V+IDM)在 0.7M/3.5M/7.0M 帧匹配预算下正面对比。
与已有工作不同的是,本文的独特切入是把机器人化从"一次性任务转换"重新定位为"可规模化的数据引擎"。已有联合机器人化工作(Phantom、DexUMI、WARPED、MimicDreamer)要求人类演示与下游任务紧密匹配,本质仍是定制化数据采集;本文面向任意异构自我中心视频,允许各源缺失不同标注、由流水线按需推断补齐,从而把五个标注水平不同的数据源统一为同一机器人格式,规模比以往机器人化视频预训练工作(H2R、Masquerade)所用数据高一个数量级以上。此外,此前没有工作系统解耦并量化视觉机器人化与动作监督的各自贡献(no-overlay 变体与 visual-only 消融),也没有在匹配算力预算下与生成式视频数据做过缩放对比——HuRo 用 0.7M 帧就超过 I2V+IDM 用 7.0M 帧的效果,直接回答了"真实人类视频与生成数据哪个更值得投资"这一数据策略问题。
核心方法
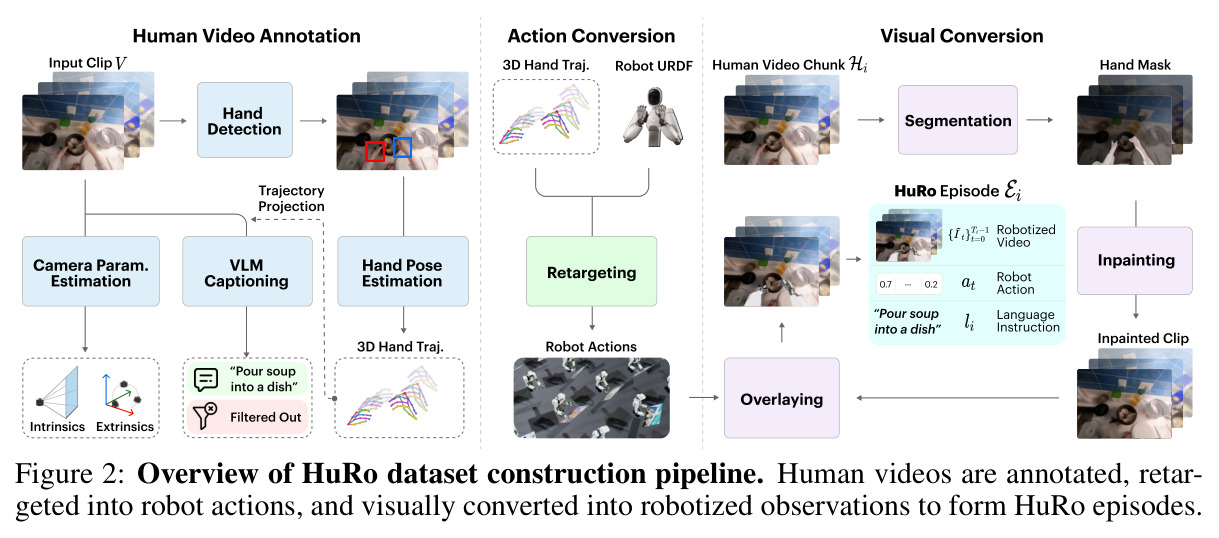
直觉上,一条人类操作视频离机器人演示只差两样东西:正确的"身体"和正确的"动作标签"。HuRo 的做法就是给人视频"换装":把画面中的人手抹掉、渲染叠加一个机器人,同时把手部运动重定向成机器人关节轨迹,从而同时合成对齐的观察与动作。技术上分三个阶段:(1)人类视频标注——估计每个片段的相机内参 $K$、逐帧 MANO 手部姿态、带米制尺度的相机位姿 $T^t_{W\leftarrow C_{\text{src}}}$,并把操作段切块、由 VLM 生成语言指令;(2)动作转换——把世界系下的手部运动经块级基座对齐变换 $T^\xi_{B\leftarrow W}$ 后,用逆运动学重定向为 ALLEX 的关节轨迹,再导出状态与动作序列;(3)视觉转换——分割并修补掉可见人臂,用 Isaac Sim 按对齐后的相机轨迹渲染机器人叠加回画面。最终每个片段输出 $E_i=\{(\tilde{I}_t, s_t, a_t, l_i)\}$:机器人化观察、状态、动作与语言指令四元组,可直接作为 VLA 预训练样本,在 GR00T-N1.6-3B 底座上以流匹配目标端到端训练。
核心创新是"联合观察-动作机器人化"的规模化实现,关键在于让视觉转换与动作转换共享同一套几何,并用伪动作 $a_t=s_{t+1}$ 免费获得动作标签。具体而言:块级基座对齐变换 $T^\xi_{B\leftarrow W}$(3D 平移+偏航)既用于把人类手部轨迹投到机器人基座系做重定向,又用于把人类相机轨迹变换成观测相机位姿 $T^t_{B\leftarrow C_{\text{obs}}}=T^\xi_{B\leftarrow W}T^t_{W\leftarrow C_{\text{src}}}$,保证叠加渲染的机器人与重定向动作在每个像素上自洽——这是纯视觉(H2R)或纯动作(VITRA、EgoScale)方法都不具备的性质。另一关键设计是"缺失信号按需推断":不同源标注水平不同,流水线用 droidcalib/AnyCalib 估内参、MoGe-2 定米制尺度、GeoCalib 对齐重力、Qwen3.5 生成指令,使异构源进入统一格式,这是规模化的前提。与任务匹配式方法(Phantom、DexUMI 等)的本质区别在于:HuRo 不为下游任务定制演示,而是把任意人类视频批量转成通用预训练资产。
方法步骤详情
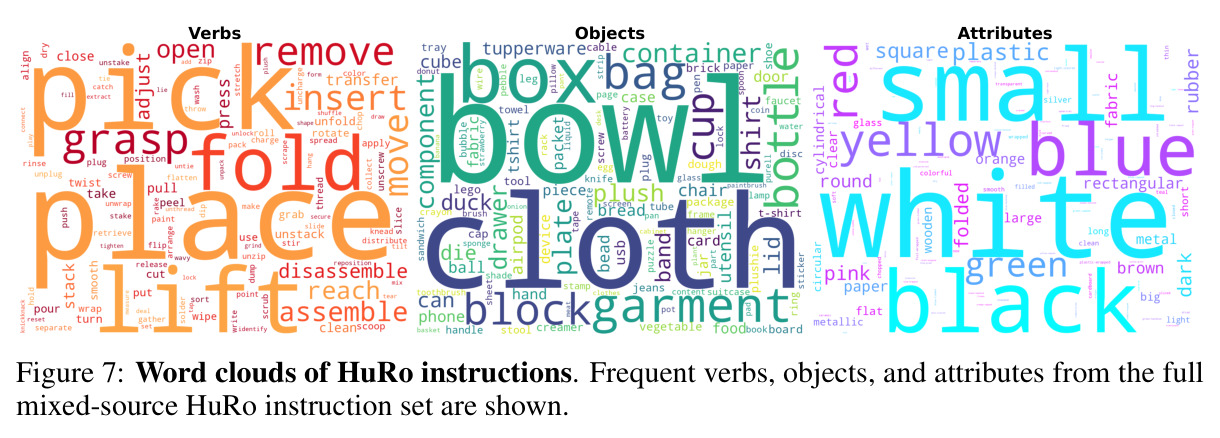
输入自我中心视频 $V=\{I_t\}$,输出 HuRo episode。阶段一,标注:droidcalib 估内参 $K$(近静态回退 AnyCalib)并矫正;100DoH 检测手部、BOT-SORT 跟踪手侧;HAWOR 估 MANO 手部姿态 $P^t_h$,导出手腕与指尖轨迹;掩码 DROID-SLAM 加 MoGe-2 恢复米制位姿 $T^t_{W\leftarrow C_{\text{src}}}$,GeoCalib 对齐重力;有效帧聚成操作段并切定长 chunk,Qwen3.5 依据画出手腕投影的采样帧生成指令 $l_i$ 并过滤无交互块。阶段二,动作转换:PyRoKi 先在稀疏时刻联合优化块级对齐 $T^\xi_{B\leftarrow W}$(3D 平移+偏航)与关节角 $q_t$,再加时间平滑优化全轨迹;正运动学得状态 $\{s_t\}$,动作取 $a_t=s_{t+1}$。阶段三,视觉转换:SAM2 加 Detectron2 提示分割手臂、ProPainter 修补得 $\bar{I}_t$;Isaac Sim 依 $K$、$q_t$ 与相机轨迹 $T^t_{B\leftarrow C_{\text{obs}}}=T^\xi_{B\leftarrow W}T^t_{W\leftarrow C_{\text{src}}}$ 渲染叠加 ALLEX 得 $\tilde{I}_t$。阶段四,组装与训练:五源共 63 万 episode、1.42 亿帧;GR00T-N1.6-3B 底座、动作头从零训练,输出 $H=40$ 动作块,腕部为相对 3D 平移+6D 旋转、手部关节为绝对值;预训练 8 万步、batch 2048、lr $1\times10^{-4}$ 流匹配目标,微调 3 万步、batch 128 余弦退火。
技术新颖性
与已有工作相比,HuRo 的新颖性有四点。其一,规模:以往机器人化视频预训练(H2R 用 MAE/R3M 预训练视觉编码器、Masquerade 预训练未来 2D 末端预测)所用数据比 HuRo 小一个数量级以上,142M 帧才第一次让"数据缩放行为"可被系统研究。其二,异构性:Phantom、DexUMI、WARPED、RwoR、MimicDreamer 都在任务匹配设置下工作,本文流水线对五个标注水平不同的源统一处理、按需推断缺失信号,是"数据引擎"而非"任务转换器"。其三,观察-动作联合且几何自洽:动作重定向与视觉叠加共享对齐变换 $T^\xi_{B\leftarrow W}$,与把两者分开处理的工作(H2R 只管视觉、VITRA/EgoScale 只管动作)有本质区别,附录 B 的对照也证实端到端联合预训练更优。其四,方法论贡献:通过 no-overlay 变体、visual-only 消融与 I2V+IDM 对照,首次把"视觉机器人化的价值""动作监督的价值""真实人类视频 vs 生成视频"三组问题放进同一实验框架量化,给出可迁移的数据策略结论。
实验结果
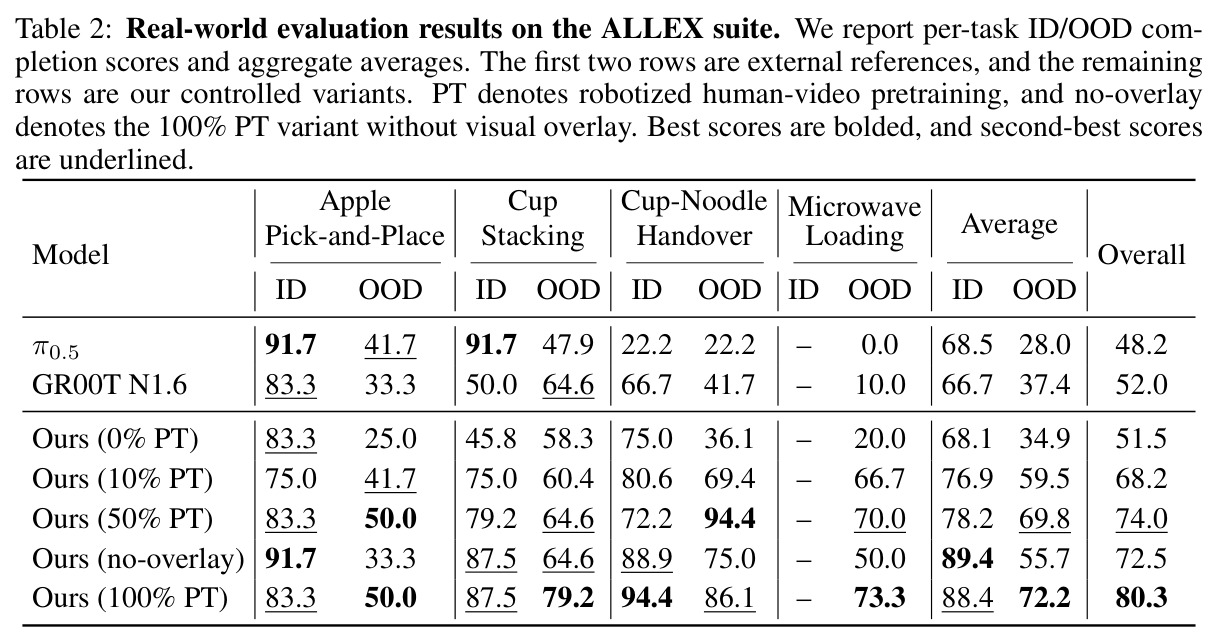
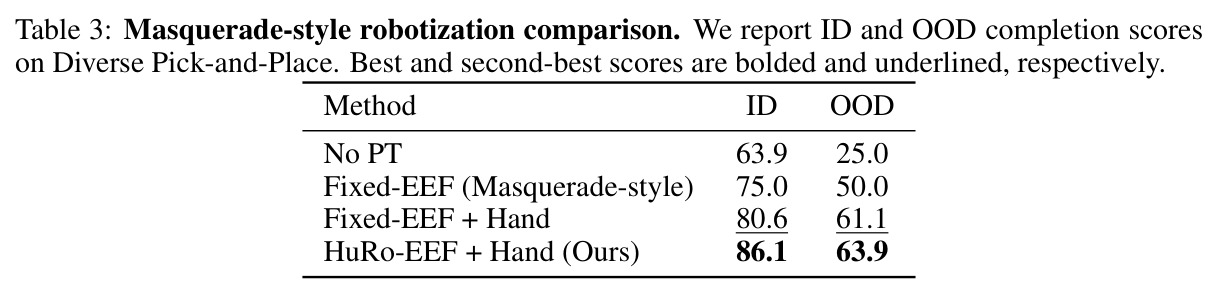
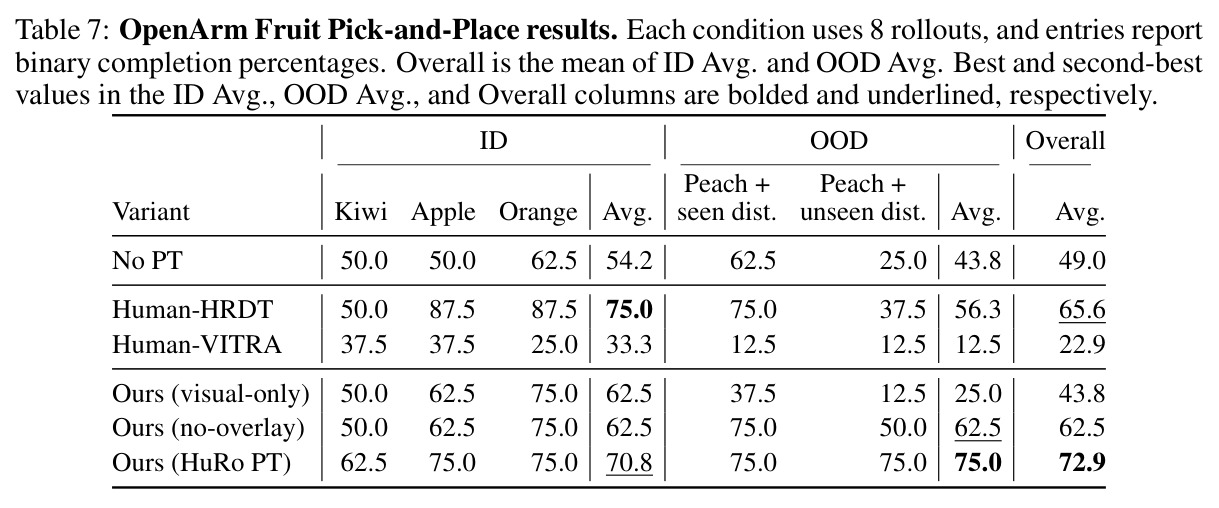
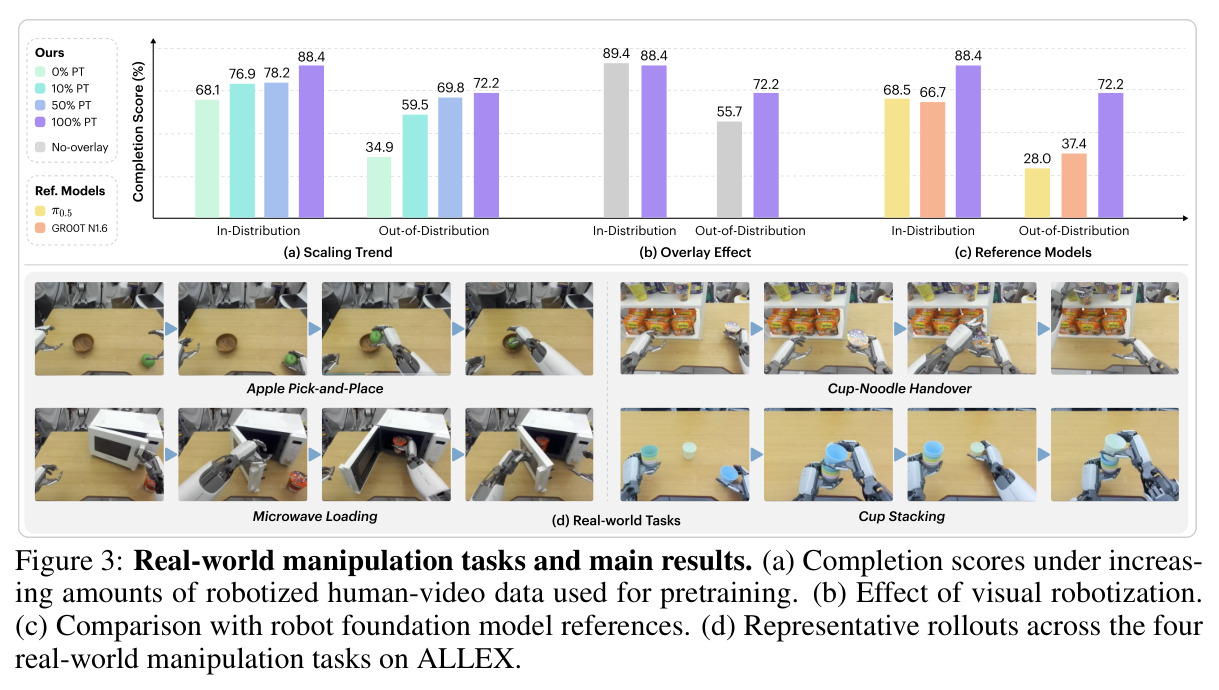
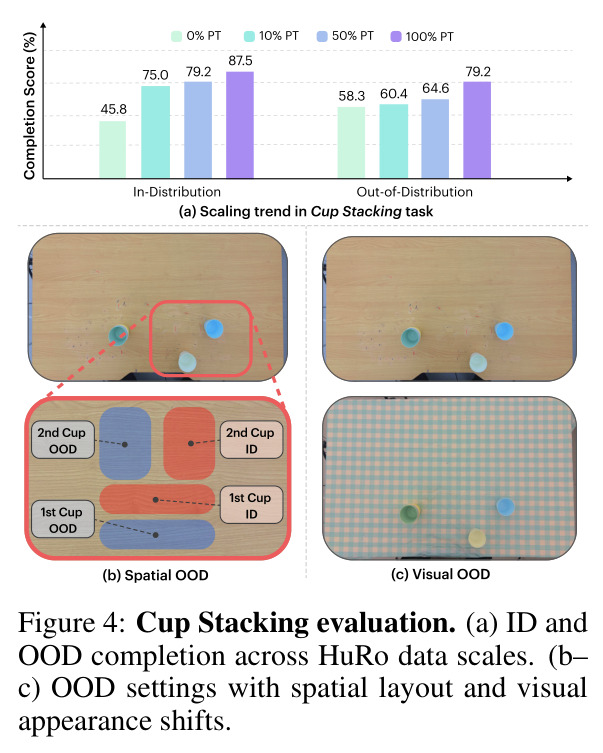
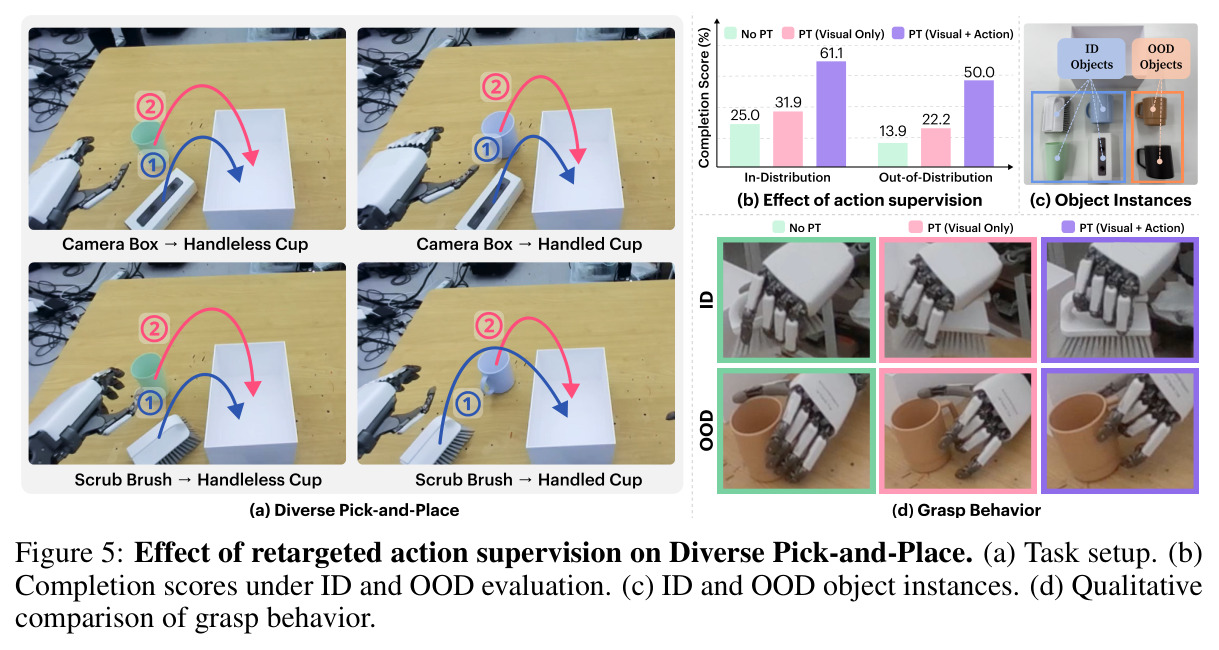
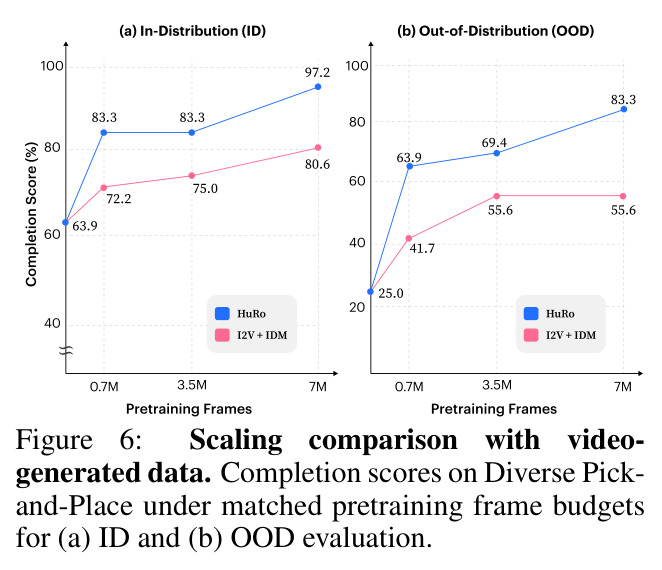
实验在 ALLEX 机器人 4 个真机任务上进行(苹果抓放 43 条演示、二值成功率;叠杯 40 条、泡面传递 16 条、微波炉装载 20 条,为分阶段完成分;OOD 含空间位移与格纹桌布视觉变化)。(1) 数据缩放:预训练数据从 0% 增至 100%,平均完成率从 51.5% 升至 80.3%,ID 从 68.1% 升至 88.4%,OOD 从 34.9% 升至 72.2%——OOD 提升 37.3 个点约为 ID 提升 20.3 个点的两倍,说明机器人化数据主要买到泛化能力;叠杯任务 ID 从 45.8% 升至 87.5%、OOD 从 58.3% 升至 79.2%。(2) 视觉机器人化:no-overlay 变体 ID 与完整 HuRo 相当(89.4% vs 88.4%),但 OOD 大幅落后(55.7% vs 72.2%),甚至不如只用 10% 数据的叠加版(59.5%)。(3) 动作监督:多样化抓放上 PT(Visual Only) 相对 No PT 提升有限,端到端 PT(Visual+Action) 达 ID 61.1%、OOD 50.0%,定性上学会沿手柄抓刷、手指穿杯柄等演示一致的抓取。(4) 全量 HuRo 预训练在 ID 与 OOD 上均超过直接微调官方权重的 π0.5 与 GR00T N1.6。(5) 生成数据对比:0.7M/3.5M/7.0M 帧匹配预算下 HuRo 每个点都领先;HuRo@0.7M 帧已超 I2V+IDM@7.0M 帧,且后者 OOD 从 3.5M 到 7.0M 帧不再提升而 HuRo 持续改善。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 4 个真机任务平均(苹果抓放/叠杯/泡面传递/微波炉装载) | 平均完成率(ID+OOD 合并) | 80.3%(100% HuRo 预训练) | 51.5%(0% PT,跳过 HuRo 预训练直接微调) | +28.8 个百分点 |
| 同上,域内(ID)评估 | ID 平均完成率 | 88.4%(100% PT) | 68.1%(0% PT) | +20.3 个百分点 |
| 同上,分布外(OOD:空间位移+视觉外观变化) | OOD 平均完成率 | 72.2%(100% PT) | 34.9%(0% PT) | +37.3 个百分点,OOD 增益约为 ID 的两倍 |
| 叠杯 Cup Stacking(代表性案例) | ID / OOD 完成率 | 87.5% / 79.2%(100% PT) | 45.8% / 58.3%(0% PT;10% PT 时 OOD 为 60.4%) | ID +41.7、OOD +20.9 个百分点 |
| 视觉机器人化消融(全量数据) | OOD 平均完成率 | 72.2%(完整视觉叠加) | 55.7%(no-overlay:保留人类画面、仅重定向动作) | +16.5 个百分点;no-overlay 甚至低于 10% PT 叠加版的 59.5% |
| 多样化抓放(动作监督消融,36 次 ID + 18 次 OOD 试验) | ID / OOD 完成率 | 61.1% / 50.0%(PT Visual+Action,端到端) | No PT 与 PT Visual Only(仅小幅提升,图中约在 13.9%–31.9% 区间) | 端到端重定向动作监督显著优于纯视觉迁移 |
| 对比机器人基础模型(4 任务) | ID / OOD 平均完成率 | 88.4% / 72.2%(HuRo 100% PT) | π0.5 与 GR00T N1.6 直接微调官方预训练权重(ID 与 OOD 均更低,见图 3c) | ID 与 OOD 双双超越两个参考模型 |
| 与视频生成数据对比(多样化抓放,独立物理环境重做) | ID / OOD 完成率@匹配预训练帧预算(0.7M/3.5M/7.0M) | HuRo@0.7M 帧,每个预算点均领先且随规模持续提升 | DreamGen 式 I2V+IDM@7.0M 帧(I2V 生成视频+逆动力学伪动作) | 约 10 倍数据效率;I2V+IDM 的 OOD 从 3.5M 到 7.0M 帧不再提升 |
局限与改进
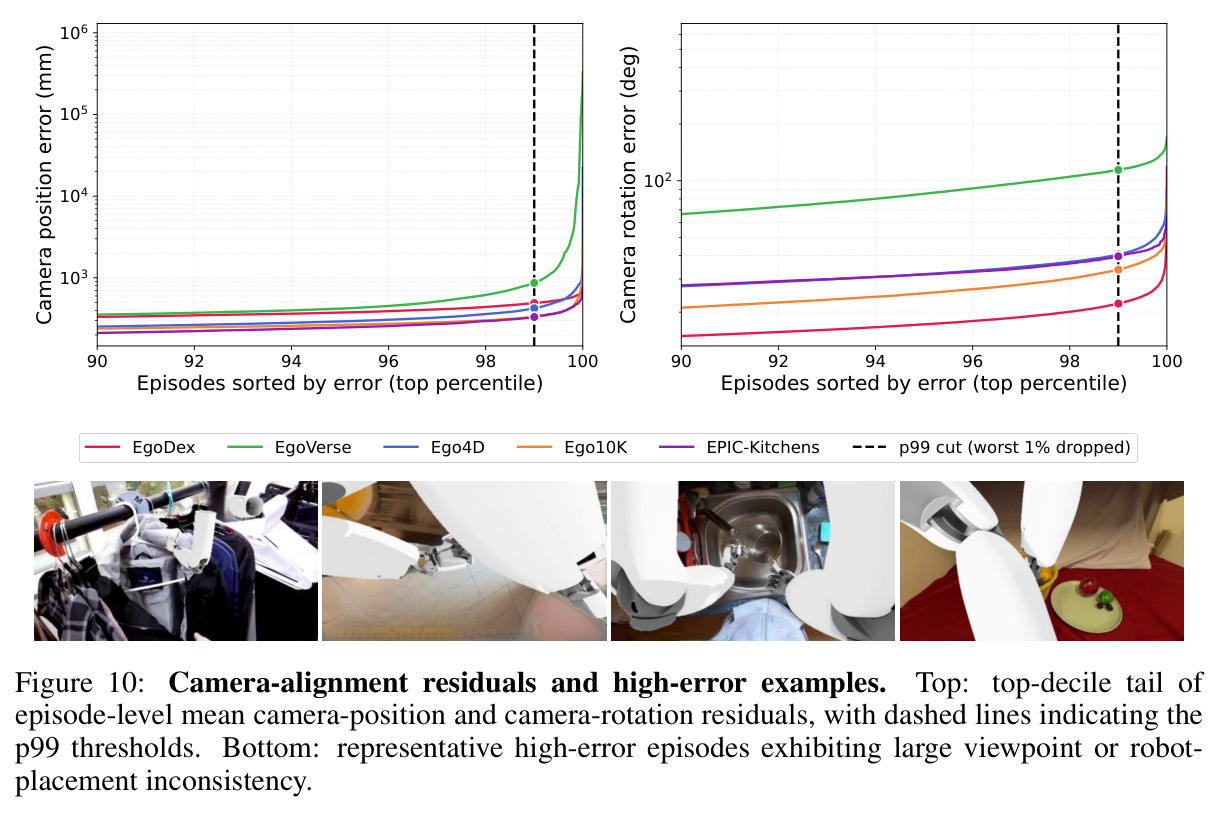
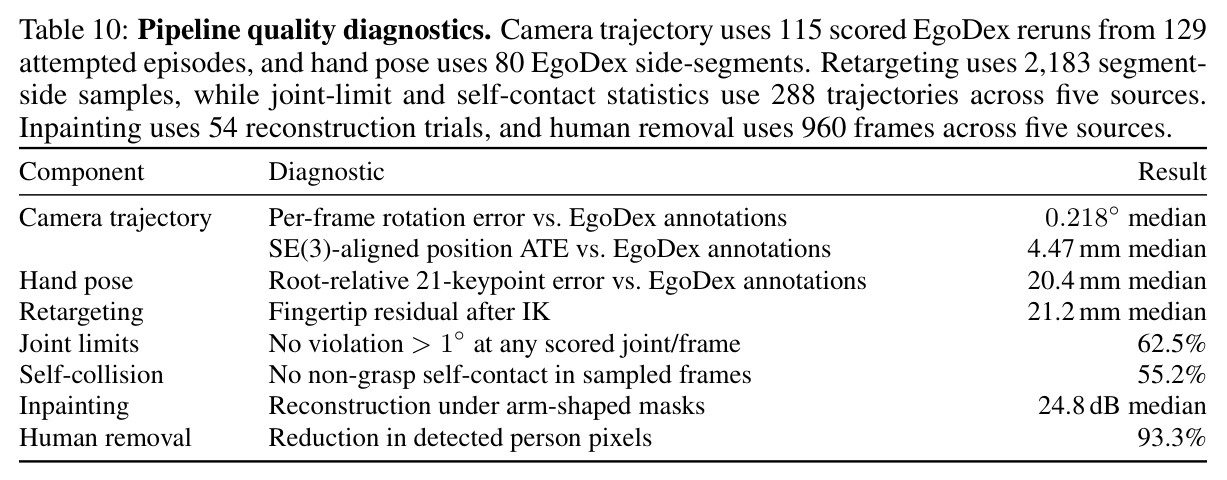
作者承认三点局限:其一,机器人化观察的保真度受重建与视觉转换质量限制,当前渲染不显式建模机器人与场景几何间的遮挡,修补残影与渲染伪影可能造成视觉不一致,不同保真度水平对下游策略学习的影响尚未刻画;其二,HuRo 只提供视觉与运动学监督,不含力/触觉信号,难以支撑接触密集操作;其三,运动学重定向不建模自碰撞与物理接触,五源审计中仅 55.2% 的轨迹未检测到非抓取自接触,因此产物只能作为预训练监督而非可直接执行的真机演示。我的补充观察:动作定义为状态差分 $a_t=s_{t+1}$ 隐含"完美执行"假设,忽略动力学、摩擦与延迟,策略可能学出开环不可行的轨迹;主实验只在 ALLEX 一个本体、4 个任务上验证(跨本体仅在附录 E 实例化);数据全部来自自我中心视频,第三人称与固定机位场景未覆盖;VLM 生成指令的质量缺乏定量评估;预训练 8 万步 × batch 2048 的算力开销对中小团队不友好;数据集与代码的公开程度正文亦未明确承诺。
独立分析的弱点
独立分析四个弱点。第一,遮挡与物理不合理性:叠加渲染不处理机器人与真实物体间的遮挡,机器人"贴"在物体前面的画面违背物理常识,策略可能学到虚假视觉捷径并在 OOD 视觉下暴露——改进方向是引入深度感知渲染(例如用 MoGe-2 深度做前后排序)或神经渲染。第二,约 44.8% 的轨迹存在非抓取自接触:这些运动学不可行的监督会污染策略与价值函数,改进方向是在重定向 IK 中加入自碰撞约束做硬过滤,或对不可行段降权采样。第三,伪动作缺失力觉与动力学:$a_t=s_{t+1}$ 的状态差分在接触时刻误差最大(如开微波炉门、叠杯受压),且不含速度/加速度一致性约束,改进方向是从视频推断接触与力线索,或与带力觉的真机数据联合预训练。第四,评估外部效度有限:单一本体、4 个任务;参考模型 π0.5、GR00T N1.6 只是直接微调官方权重,未在相同数据量下重新预训练,对比略占便宜;I2V+IDM 对照也只在一个任务、更换后的物理环境中进行——改进方向是在更多本体(附录 E 的其他实例化)与更多生成式基线(世界模型 rollout 等)上重复缩放实验,并报告统计显著性。
未来方向
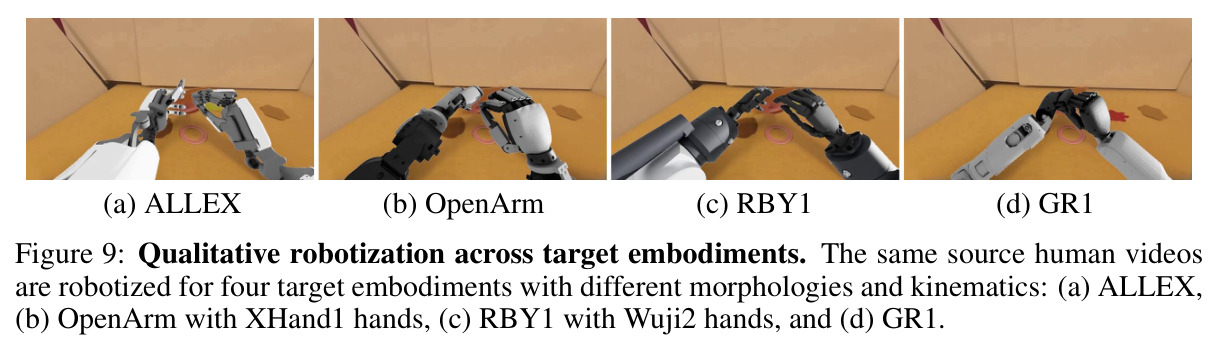
作者提出的方向:系统刻画机器人化保真度与下游策略学习的关系,例如按修补/渲染质量分层训练并量化收益曲线;为机器人化人类视频增补推断的接触或力线索,或与传感器丰富的真机数据联合预训练,以支撑接触密集操作;在重定向中加入自碰撞与物理接触建模,使轨迹更接近可执行演示。基于本文成果可自然延伸的方向:其一,混合数据策略——本文显示 HuRo 与 I2V+IDM 缩放行为互补(HuRo 持续增益、生成数据早期见效),两者的最优配比与课程式混合值得探索;其二,跨本体规模化,用同一流水线为其他机械臂批量造数据(附录 E 已给实例化路径),验证"一次造数据、多本体复用";其三,引入第三人称与多视角视频源打破自我中心偏置,配合视角变换生成更多样的观测相机轨迹;其四,把 55.2% 无自碰撞审计升级为流水线内置的自动质检与过滤闭环,形成可信赖的数据引擎;其五,研究机器人化数据与真机数据的混合缩放律,回答"多少真机数据可被机器人化数据替代"这一对从业者最有价值的问题。
复现评估
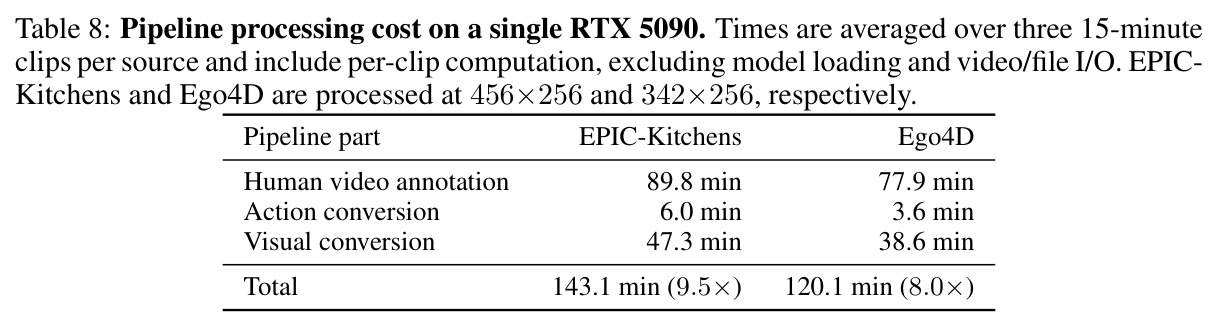
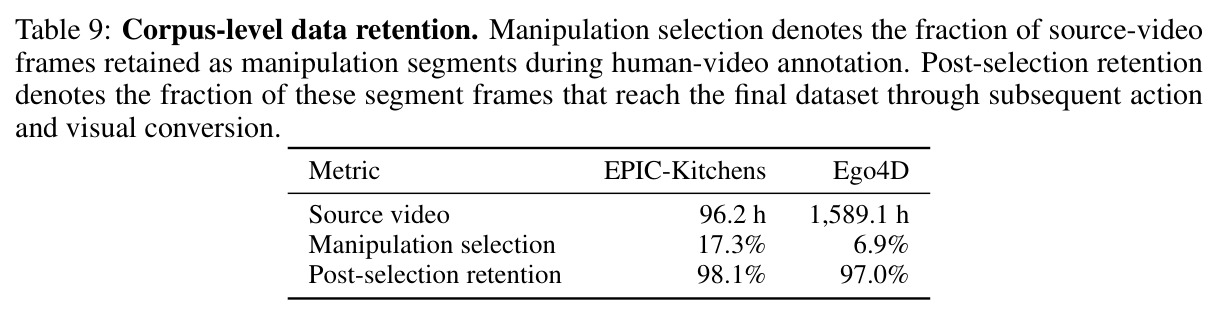
复现难度总体偏高。有利条件:流水线各组件基本都是公开工具(droidcalib、AnyCalib、100DoH、BOT-SORT、HAWOR、掩码 DROID-SLAM、MoGe-2、GeoCalib、Qwen3.5、SAM2、Detectron2、ProPainter、Isaac Sim、PyRoKi),VLA 底座 GR00T-N1.6-3B 有官方权重,项目页 https://3587jjh.github.io/HuRo/ 提供方法概览。不利条件:五个数据源中 Ego4D、EPIC-Kitchens 需签许可协议;目标本体 ALLEX 是商业双臂灵巧手平台,一般实验室难以获得;预训练为 8 万步 × 全局 batch 2048、约 1.6 亿样本吞吐,估计需数十张高端 GPU 数天;真机评估需采集 119 条演示并做数百次 ID/OOD rollout;正文未明确承诺开源 HuRo 数据集与流水线代码,第三方复现需自行拼装十余个模型并处理环节间误差传播(内参→SLAM→重定向→渲染),任一环失准都会逐级放大。小规模验证(单源少量 chunk 加渲染结果人工检查)可行,完整复现建议先联系作者获取数据与配置。
论文图表