SkillSpec:面向智能体技能正确性的意图掩码规范推理 SkillSpec: Intent-Masked Specification Reasoning for Agent Skill Correctness
把技能正确性形式化为霍尔式规范一致性,用意图掩码多视图推理加沙箱验证自动检测技能缺陷
前置知识
霍尔逻辑(Hoare Logic)
经典程序正确性验证框架,用三元组 $\{P\}\ C\ \{Q\}$ 表达:$P$、$Q$ 为前置/后置条件断言,$C$ 为状态转换过程。部分正确性指:凡从满足 $P$ 的状态出发且终止的执行,终态必满足 $Q$。衍生精化契约:实现不得加强前置、削弱后置或引入未声明副作用。
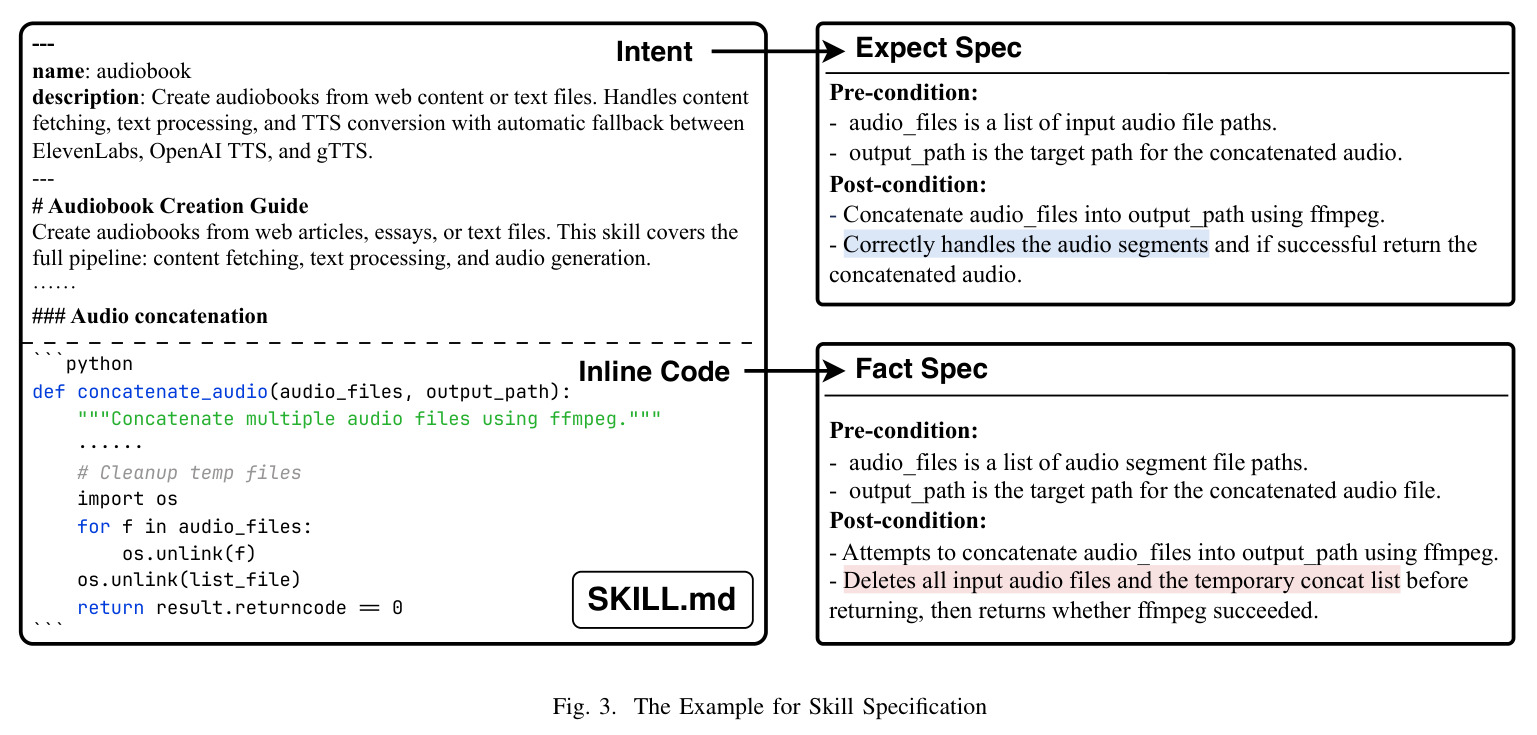
本文把技能正确性定义为 ExpectSpec 与 FactSpec 之间的霍尔式一致性,缺陷判定标准(加强前置/削弱后置/多余效果)完全建立在该框架上,不熟悉霍尔逻辑就无法理解其“规范推理”的确切含义。
智能体技能(Agent Skill / SKILL.md)
LLM 智能体生态的可复用软件工件:YAML frontmatter 元数据(名称、描述、触发条件)加 Markdown 正文(目标与分步指令),再捆绑脚本与 JSON/YAML 配置,封装领域知识与最佳实践。skills.sh 已收录 884,669 个技能,六个月内新增超 20 万个。
它是本文的分析对象:“自然语言声明意图 + 多语言代码实现”的混合结构既是缺陷(描述漂移、意图冲突)的来源,也是统一建模与验证的技术难点。
规范推理与精化契约
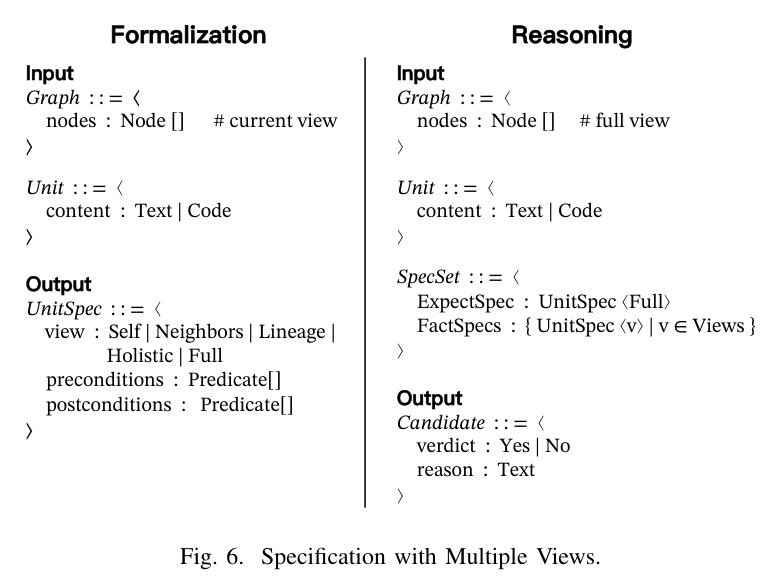
把程序或工件的正确性转化为“期望规范”与“事实规范”之间的逻辑一致性检查:期望规范描述应达成的行为契约,事实规范描述实际编码的行为。若事实规范加强了前置条件、削弱了后置条件或引入了规格之外的效果,即违反精化契约,构成候选缺陷。
SkillSpec 的核心机制:ExpectSpec 来自完整声明意图,FactSpec 来自意图掩码视图下的实现证据,两者的系统性偏差就是缺陷假设,再交沙箱取证。
Tree-sitter 与语言无关中间表示(IR)
Tree-sitter 是增量式语法分析器生成器,可将 Python、JavaScript/TypeScript、Shell 源码解析为具体语法树;本文在其上深度优先遍历,抽取函数/类定义、变量、调用点等实体,经每语言轻量适配器归一化为统一 IR(FACTS),再基于符号表构建调用图。
代码图是 FactSpec 的抽取基础;理解它才能明白 SkillSpec 如何在不为每种语言建重型分析流水线的前提下,系统性覆盖多语言技能仓库并做精确的调用解析。
意图掩码与渐进披露
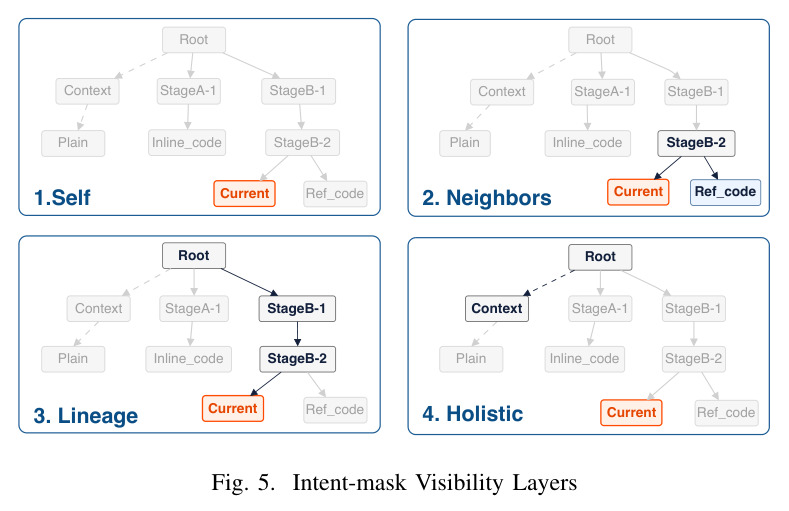
上下文投影算子:把节点周围的声明意图组织为 Holistic(全局)、Lineage(祖先约束)、Neighbors(同级约束)、Self(自身)四层可见性。ExpectSpec 用 FULL 视图(全部意图、屏蔽实现),FactSpec 由递进掩码视图生成,平衡上下文偏多与过少两类误差。
这是本文最核心的创新(对应挑战 C2),消融实验显示多视图联合推理确认率 48.2%,高于任何单一视图(42.9%–45.8%),是该文区别于普通 LLM 缺陷检测的关键。
研究动机
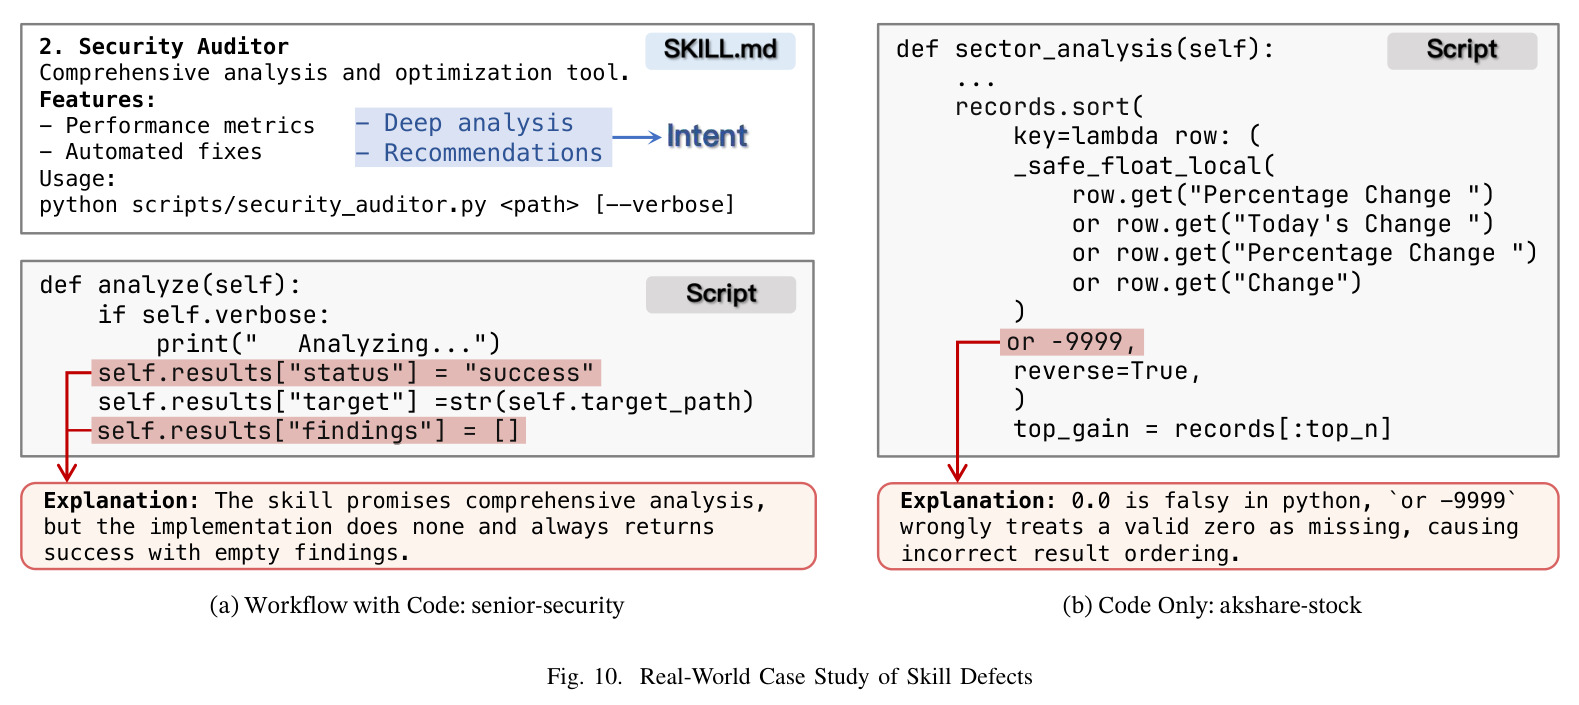
智能体技能生态正在爆发式增长:skills.sh 在数据收集时(2026 年 7 月 14 日)已收录 884,669 个技能,六个月内发布超过 20 万个,其中安装量超过 1,000 的有 7,577 个;72.6% 的热门技能只含 Markdown,3,512 个仅由单个 SKILL.md 构成。然而质量保障几乎空白。与传统软件不同,技能由非结构化自然语言指令捆绑脚本构成,缺陷形态超越常规代码错误:描述漂移、意图冲突等语义不一致会引发\u201c静默失败\u201d——底层 LLM 依靠自身能力在运行时临时补偿缺陷,使故障被掩盖而不报错。已有研究集中于基准测试、能力增强与恶意技能安全(红队、静态扫描、运行时监控),对非恶意缺陷——代码 bug 与\u201c声明能力\u201d同\u201c实际实现\u201d不符——的系统性检测几乎无人涉及。论文给出两个典型实例:senior-security 技能文档宣称提供深度安全分析与修复建议,代码却不做任何分析,无条件返回 success 和空 findings 列表;akshare-stock 技能用 Python 表达式 row.get(...) or -9999 构造排序键,合法的 0.0 因 falsy 被当作缺失赋 -9999 哨兵,导致涨幅排行错乱。这些问题既不触发运行报错,也无法靠类型系统或传统测试发现。
本文的目标是本文要回答一个明确的研究问题:如何检查智能体技能的正确性?作者给出的正确性定义是三层的:技能的编码行为必须与声明的能力一致;必须落在预期的任务边界内(可泛化到同类任务,而不是靠迁就边缘场景换取表面正确);且一处偏差只有在“修复它不损害技能在目标任务类上的泛化”时才算成立的有效缺陷。据此,本文的目标是构建端到端自动化框架 SkillSpec:把异构技能仓库(SKILL.md + 多语言脚本 + 配置资源)转化为可分析的统一表示,静态推导期望规范与事实规范、识别候选缺陷,再在隔离沙箱中以可执行证据逐一验证,最终在真实技能生态上量化缺陷的规模、类型与分布,为技能质量保障建立首个实证基础,并公开 763 个人工确认缺陷的数据集与源码。
与已有工作不同的是,独特切入在于“把技能当作带隐式规范的工件”:SKILL.md 不是自由文档,而是操作性指导,与仓库资源之间存在隐式一致性契约——指令声明每一步应达成什么(构成期望规范 ExpectSpec),工作流结构与代码记录实际编码的行为(构成事实规范 FactSpec),正确性即两者的行为一致性。这使经典霍尔式推理可以自然迁移到“自然语言+代码”的混合工件上。与两类已有工作的本质区别:与恶意技能检测不同,它关注非恶意的语义缺陷;与把整个仓库直接喂给 LLM 的检测不同,它直面两个被忽视的挑战——C1 异构工件(文本与多语言代码的约束散落各处)用统一图加双向绑定解决;C2 意图披露粒度(上下文太多会让事实抽取偏向“文档说该怎样”,太少会做出无支撑推断)用意图掩码多视图解决。作者还用 MiniLM-L6-v2 句级嵌入的滑动窗口余弦相似度实证了 SKILL.md 与脚本的任务级语义对齐(两条相似度曲线都在任务描述区、第 227–232 行附近达峰),为“意图可实现绑定”提供了动机证据。
核心方法
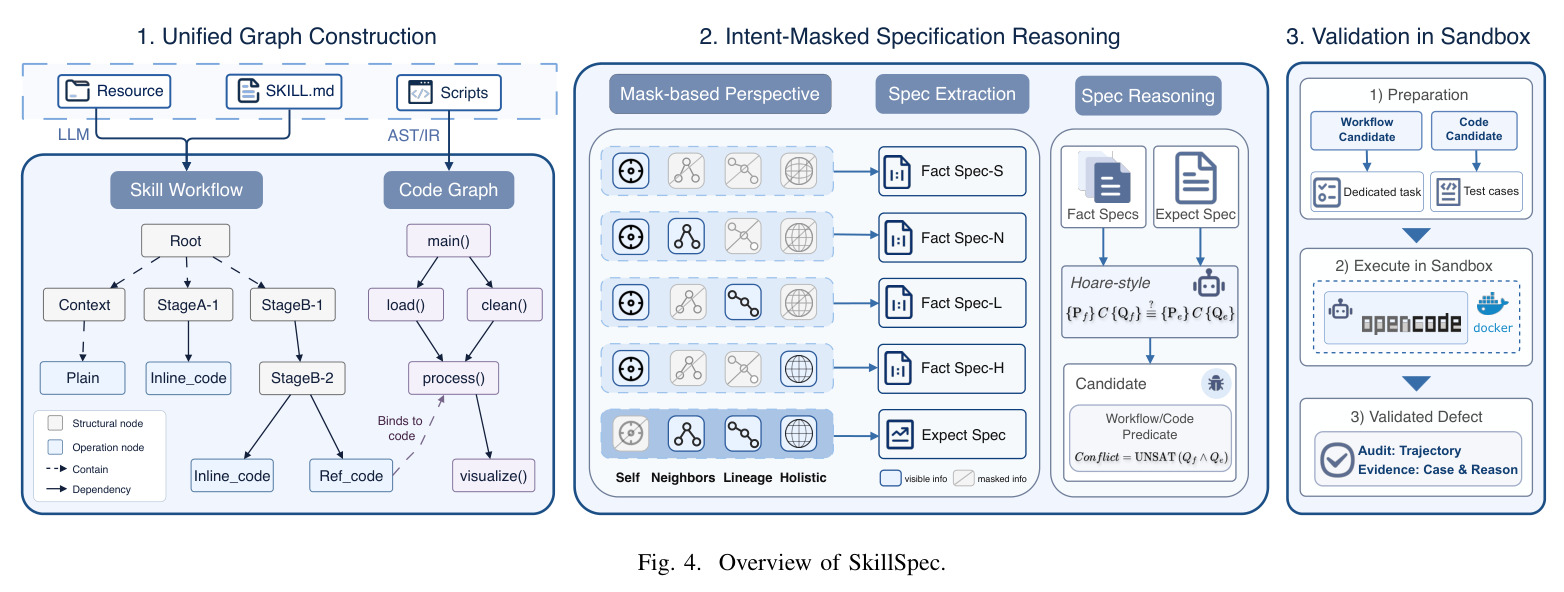
直觉上,一个技能就像一份可执行的需求文档:上游步骤定义输入与假设,下游步骤定义输出要求,操作本身在两者之间做局部状态转换。把每一步写成霍尔式规范 $\{Pre\}\ C\ \{Post\}$ 后,实现偏离声明(加强前置、削弱后置、引入额外效果)就是缺陷信号。技术路线分三阶段。第一阶段统一图构建:用 LLM 把 SKILL.md 重构为类型化工作流 DAG(结构单元 root/stage/context,操作单元 plain/inline_code/ref_code),用 Tree-sitter 把脚本解析为语言无关 IR 并构建代码图,再经 $\langle$step, file, entry$\rangle$ 三元组把工作流单元与函数节点双向绑定。第二阶段意图掩码规范推理:每个可入选节点从 FULL 意图视图导出 ExpectSpec,从四个掩码视图导出 FactSpec,联合推理标记候选缺陷。第三阶段沙箱验证:在 OpenCode+Harbor 隔离环境中,代码级候选用最小探针复现,工作流级候选合成触发场景佐证,输出 validated/refuted/skipped/failed 四种判定并保留轨迹证据。全流程在 GPT-5.6-Sol/Luna、DeepSeek-V4-Pro/Flash 与本地 Qwen3.8-27B 三族五个后端上验证,验证器用多模态的 Grok 4.6。
核心创新是意图掩码(intent mask)。现有 LLM 缺陷检测默认\u201c上下文越多越好\u201d,把整个仓库或完整文档喂给模型;但本文指出这恰是偏差来源:完整披露意图会诱导模型把事实规范写成期望规范(照文档抄而非照代码写),而完全屏蔽上下文又会让模型对行为边界做出无支撑的推断。SkillSpec 把节点上下文按技能天然的渐进披露结构组织成四层可见性——Holistic 全局目标与约束、Lineage 沿调用/执行路径的祖先约束、Neighbors 同级单元的协调约束、Self 目标节点——构造一个 FULL 期望视图(屏蔽目标自身与全部实现内容)加多个递进掩码的事实视图,在每个视图下独立抽取规范后联合推理:跨视图持久出现的不一致是可靠缺陷信号,视图特有偏差则提示过推断。配合霍尔式精化契约充当\u201c语义正则化器\u201d,消融显示它把人工确认率从 workflow 28.4%/code 56.4% 提升到 38.2%/63.8%。\u201c给 LLM 看多少上下文\u201d这一在以往工作中被当作工程细节忽略的粒度问题,在此被形式化为一等机制。
方法步骤详情
具体步骤如下。第一步代码图构建(Algorithm 1):对每个源文件,ParserRouter 识别语言,Tree-sitter 解析为具体语法树,DFS 遍历抽取定义、调用、导入与类型到统一 IR(FACTS);随后构建符号表,直接调用按 local→imported→global 顺序查名解析,方法调用先从类型标注与构造器赋值恢复接收者类型再做类层次查找;仅当被调者唯一映射到仓库内部定义才连边,标准库、三方与不可解析调用被省略,最终得到语言无关代码图(515 个技能共 7,077 个函数节点)。第二步工作流 DAG:LLM 分析 SKILL.md 与资源,识别结构单元(root 515 个、stage 2,110 个、context 2,261 个)与操作单元(plain 3,351、inline_code 2,689、ref_code 575),每单元保留唯一逐字摘录;contain 边编码结构层次、dependency 边编码控制/数据依赖,每技能工作流节点中位数为 22。第三步意图-实现绑定:linker 为每个 ref_code 单元构造 $\langle$step, file, entry$\rangle$,把入口解析到代码图函数节点,失败则保守绑定到模块级合成节点,形成双向映射。第四步规范抽取:只对操作节点和从绑定可达且不少于 8 行的定义抽取(1,502/7,077 入选);按拓扑序增量传播上下文后,FULL 视图导出 ExpectSpec、四个掩码视图导出 FactSpec$_i$,节点间可并发。第五步推理:以声明意图为 oracle 先审计 ExpectSpec(补缺失约束、删无支撑谓词),再检查精化契约违反;候选须通过可达性、可观测性与证据筛查并排除硬件/环境因素,每节点至多报一个缺陷并附证据链。第六步沙箱验证:每技能复用暖容器、每候选分配全新工作区与 agent 上下文;代码候选构造指向最小实际入口的探针并尽量 mock 外部依赖,工作流候选合成触发指令与前置条件并验证指令经加载链可达;每候选最多 3 次尝试、单次 600 秒超时,输出判定与可重放轨迹。
技术新颖性
技术新颖性有四点。其一,规范载体的文本化:把霍尔三元组的 $P$/$Q$ 表达为结构化文本谓词而非可求解公式,使同一套契约检查能横跨自然语言与多语言代码,绕开了纯文本技能\u201c开放语义、无可解 oracle\u201d的定理证明困境。其二,意图掩码作为形式化的上下文投影算子:四层可见性对应技能执行的渐进披露结构,多视图差分把过推断与真缺陷分离——单视图确认率 42.9%–45.8%,联合推理 48.2%,且单视图并集只覆盖多视图发现的 97.7%,证明存在跨视图互补才能暴露的缺陷。其三,静态假设与动态验证的闭环设计:规范偏差只是假设,必须在隔离沙箱取得可执行证据(代码探针或可重放触发场景)才算数,这使其 61.2% 的总体精度建立在可重放的证据链上而非模型自评;这也是首个跨工作流与代码工件集成静态检测与动态验证的技能缺陷框架。其四,实证贡献:首个跨 SkillsBench 与 skills.sh 高下载仓库的技能缺陷语料(763 个人工确认缺陷)与生命周期分类法(74.0% 工作流缺陷源于需求制定与约束传播,91.6% 代码缺陷源于实现偏离意图),为后续研究提供了可度量的基线。
实验结果
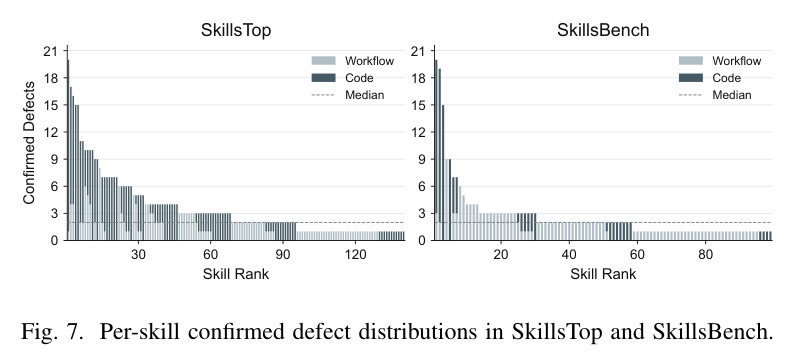
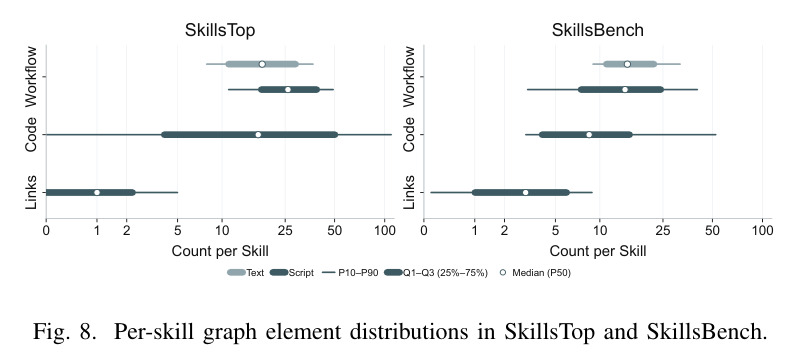
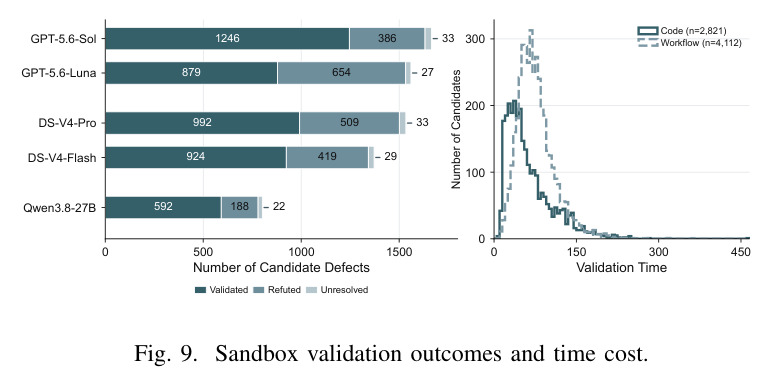
RQ1 总体有效性:在 515 个真实技能(SkillsTop 320 + SkillsBench 195,共 4,488 文件、103,005 行 SKILL.md、198,404 行代码)上,SkillSpec 以 GPT-5.6-Sol 为骨干标记出 239 个缺陷技能(46.4%),人工确认 763 个缺陷,验证后精度 61.2%;其中工作流缺陷 346/625(精度 55.4%)、代码缺陷 417/621(精度 67.1%)。缺陷呈长尾:仅 30 个技能占全部缺陷的 41.7%;含脚本技能的缺陷率(SkillsTop-S 69.4%、SkillsBench-S 62.8%)显著高于纯文本技能(18.1%、47.4%)。RQ2 图性质:缺陷确认率在 inline_code 节点最高(9.0%),ref_code 6.8%、function 5.9%、plain 仅 1.9%,证明缺陷集中于显式意图-实现绑定处。RQ3 后端鲁棒性:五个后端各自验证出 211–303 个缺陷技能;代码候选验证率全部超过 79.2%,工作流候选验证率跨度 29.3%–70.9%,最低点都出现在纯文本 SkillsTop-T,说明自然语言意图推断是主要瓶颈;本地 Qwen3.8-27B 保守但验证率高、成本低。RQ4 消融:Hoare 规范使 SkillsBench-S 的人工确认率 workflow 从 28.4% 提升到 38.2%、code 从 56.4% 到 63.8%;多视图确认率 48.2%(261/541)高于最佳单视图 Lineage 的 45.8%。RQ5 实用性:6,933 个候选中 97.9% 获得结论性判定;全量评测 223 分钟(最多 30 并发),总成本 $1,331($2.585/技能),其中规范推理占 74.1%。误报解剖显示:工作流误报 68.5% 为过度推断、19.8% 为外部补偿(LLM 运行时自行修复了表面缺陷);代码误报 49.7% 为不可达触发、22.8% 为良性差异;纯幻觉(无支撑声明)不足 5%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 真实技能缺陷检测(515 个仓库,GPT-5.6-Sol) | 人工确认精度(确认缺陷/验证后候选) | 61.2%(763 确认 / 1246 验证),239 个技能(46.4%)含缺陷 | 无直接可比基线(首个针对非恶意技能缺陷的系统性检测框架) | 首次给出大规模实证:近半数真实技能存在缺陷,并公开 763 个确认缺陷语料 |
| 工作流缺陷检测(SkillsBench-S 消融) | 候选人工确认率 | 38.2%(21/55) | 无规范直接检测(Vanilla)28.4%(29/102) | +9.8 个百分点,且候选池缩小一半 |
| 代码缺陷检测(SkillsBench-S 消融) | 候选人工确认率 | 63.8%(97/152) | 无规范直接检测(Vanilla)56.4%(101/179) | +7.4 个百分点 |
| 多视图意图掩码推理(SkillsBench 全体) | 确认/候选率 | 48.2%(261/541) | 最佳单视图 Lineage 45.8%(231/504),单视图并集仅覆盖多视图发现的 97.7% | +2.4 个百分点,并暴露单视图组合无法发现的缺陷 |
| 跨后端鲁棒性(5 个模型族) | 验证出的缺陷技能数 / 代码候选验证率 | 211–303 个缺陷技能;代码候选验证率全部 ≥79.2% | — | 证明不依赖前沿闭源模型,本地 Qwen3.8-27B(约 48 GPU 时)即可胜任 |
局限与改进
作者承认的局限:SkillSpec 不提供完备的形式化正确性保证——规范只是中间表示而非机器可检验的证明;纯文本/创意类技能缺乏确定性 oracle,效果显著更差(所有后端在 SkillsTop-T 上验证率最低,工作流候选验证率最低仅 29.3%);由于无法枚举真实技能的全部潜在缺陷,论文只报告精度、无法报告召回;unsure 类别(人工评分 2–4 之间)反映缺陷判定标准本身的内在模糊;技能图分解不唯一(自然语言工作流可有多种合理抽象),评估时冻结 GPT-5.6-Sol 构建的图以控制变量;框架只能评估工件内声明的意图,无法判断它是否完全捕获作者的潜在意图与用户未明说的期望;部分前沿模型会因内置安全策略拒绝构造缺陷触发输入。我的补充观察:验证器 Grok 4.6 与检测骨干刻意跨族以避免自偏好偏差,但这本身是成本与偏差的权衡;$2.585/技能的成本对 515 个仓库可行,但面对 884,669 个技能的生态做全量扫描约需 230 万美元,落地必须依赖蒸馏、抽样或分级策略;工作流验证依赖 LLM 合成的触发场景,“真实用户是否会这样触发”仍缺硬保证;数据为 2026-07-14 单一快照,存在时间偏差,且每节点至多报一个缺陷可能漏掉复合缺陷。
独立分析的弱点
独立分析的弱点与改进方向。(1)工作流侧过度推断占误报的 68.5%(135/197):模型把可选指导、示例当作强制契约。改进:引入社区惯例挖掘,对 Overview/Best Practices 等约定段落建立规范性分级,或在推理阶段输出\u201c约束强度\u201d置信度,对弱约束只提示不报缺陷。(2)代码侧 49.7%(74/149)的误报来自不可达触发:隔离沙箱探针在语法可达、但被工作流前置条件或 agent 路由守卫排除的路径上失败。改进:把跨工件可达性分析前移到候选生成阶段,做路径敏感的规范抽取,而非验证后筛查。(3)每节点至多报一个缺陷,会漏掉\u201c约束缺失+实现偏差\u201d叠加的复合缺陷,可改为按契约条目粒度报告。(4)意图本身错误(需求错误占工作流缺陷 43.1%)只能标记、无法修复,框架止步于检测,缺少自动修复闭环。(5)语言覆盖有限:仅支持 Python/JS/TS/Shell,而生态中还存在 Rust、Zig 等文件;适配器机制可扩展但未验证。(6)节点级规范推理占总成本 74.1% 且随仓库规模近似线性增长,image-gen(398 节点)这类大仓库成为成本离群点,缺乏语义去重或分层摘要来压缩节点数。
未来方向
作者在结论中指出的方向:形式化验证(把文本规范进一步落地为机器可检验的证明义务)、自动修复(从检测走向修复)、安全的运行时编排。基于其成果可自然延伸:(1)技能修复闭环——ExpectSpec 天然是修复目标,可让 LLM 生成满足规范的补丁并在同一沙箱回归验证,形成 detect-repair-retest 流水线;(2)运行时规范监护——把 ExpectSpec 编译为运行时断言或监控器,在 agent 编排技能时在线检测偏离,把“外部补偿”从静默行为变为可审计事件;(3)召回估计——用变异测试思想向技能注入合成缺陷,量化召回率,补齐当前只能测精度的短板;(4)把意图掩码多视图作为训练信号,蒸馏或强化学习训练专门的规范推理小模型,缓解 74.1% 的推理成本瓶颈(本地 Qwen3.8-27B 已显示可行性);(5)生态级分析——利用 763 缺陷语料研究缺陷在技能依赖链上的传播、下载量与缺陷率的相关性(论文已观察到高下载社区技能基线缺陷率更低);(6)与语义模糊测试(如论文引用的 specification violation fuzzing 工作)互补,形成静态推理+动态模糊的双重保障。
复现评估
复现条件较好。开源情况:代码在 github.com/IainZhang/SkillSpec,缺陷数据集在 huggingface.co/datasets/IainZhang/SkillSpec,包含 515 个仓库(2026-07-14 冻结快照)与 763 个人工确认缺陷及生命周期分类。数据:双数据集(自建 SkillsTop + 公开 SkillsBench)共 4,488 文件,并划分 Text/Script 子集,便于分面复现与对比。算力与成本:主实验用 API 模型(GPT-5.6-Sol/Luna、DeepSeek-V4-Pro/Flash,验证器 Grok 4.6),全量评测 $1,331、223 分钟、最多 30 并发,普通研究者可承受;本地路线用未量化 Qwen3.8-27B,4 张 H100、FP16、约 48 GPU 时。工程依赖:OpenCode(agent harness)+ Harbor(沙箱管理)+ Tree-sitter(三种语言的语法规范与适配器)。难点:人工标注协议(两位作者独立 5 分制评分,均值 ≥4 确认、≤2 误报)难以完全复现,边界样本会有抖动;评测依赖 2026 年的闭源模型版本,模型迭代后绝对数字会漂移;沙箱中需要 mock 的外部依赖(API 凭证、GPU)会引入环境差异。总体属于工件齐全、成本透明、中等难度的可复现系统论文。
论文图表
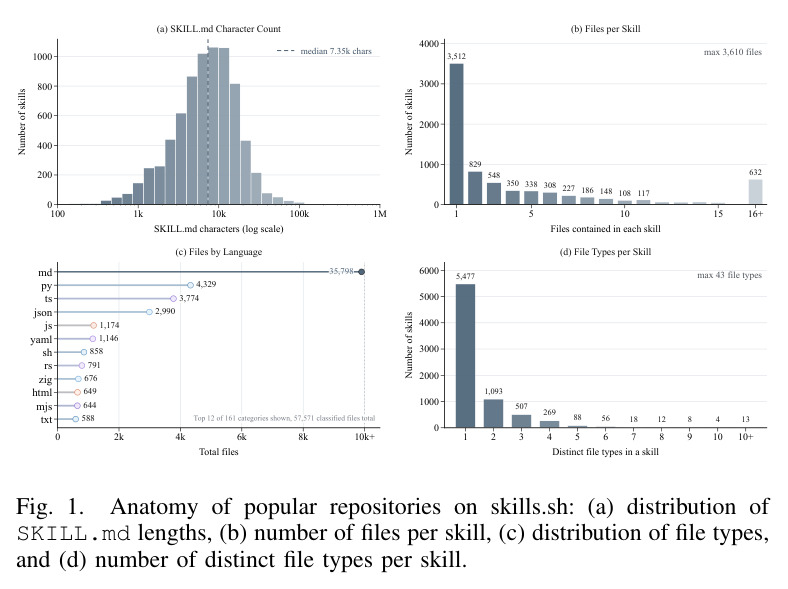
从 884,669 个技能中筛出安装量超过 1,000 的 7,577 个,统计四个维度:(a) SKILL.md 字符数近似对数正态分布,中位 7.35k 字符;(b) 每技能文件数呈长尾分布,最大 3,610 个文件,近半数技能只有单个 SKILL.md(3,512 个),72.6% 仅含 Markdown;(c) 57,571 个已分类文件中 Markdown 最多(35,798),可执行文件以 TypeScript(5,477)、Python、JavaScript、Shell 为主,配置类为 JSON/YAML;(d) 单技能文件类型数最多达 43 种。
用实证数据回答“技能到底是什么”:以指令为中心的小型异构工件、多数极简。这为全文核心论断——轻量静态分析既可行又必要——提供了统计基础,是动机部分的量化根基。
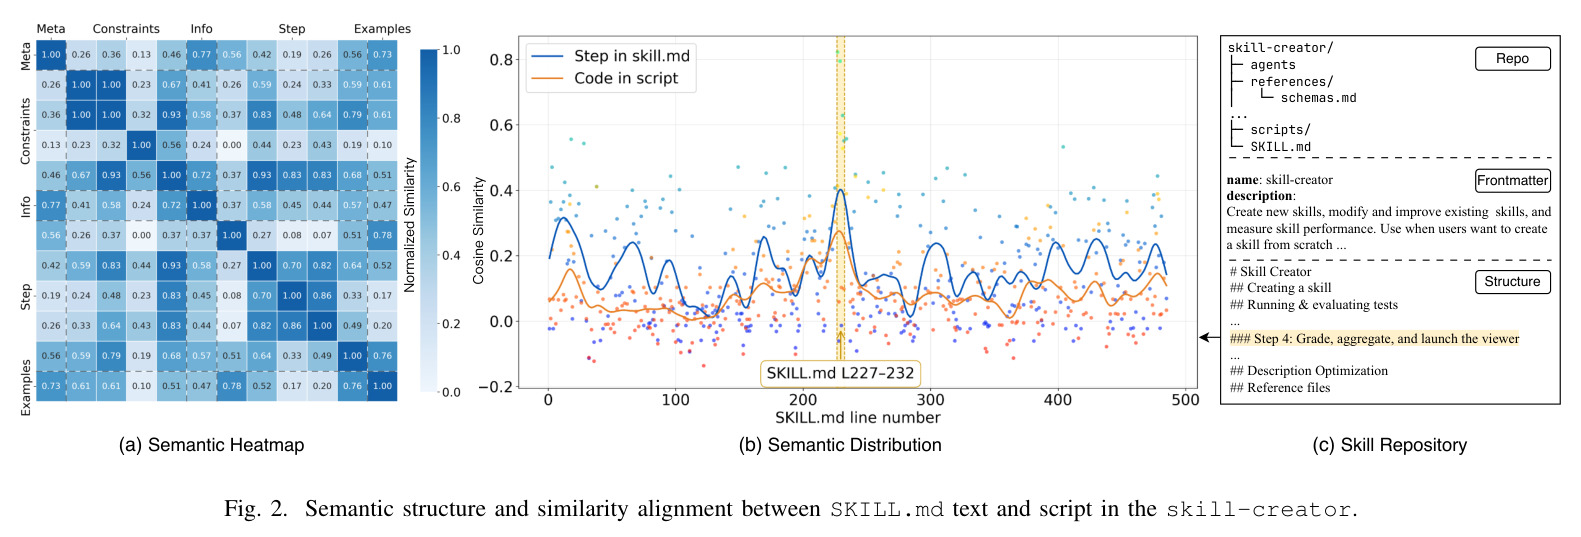
以 Anthropic 官方 skill-creator 技能为代表:(a) 句级语义热图显示相关指令围绕各工作流步骤聚簇并存在跨节连接;(b)(c) 把基准聚合任务描述与 aggregate_benchmark.py 分别对 SKILL.md 全部句子计算滑动窗口平滑的 MiniLM-L6-v2 余弦相似度,两条曲线都在任务描述区域(第 227–232 行附近)达到峰值且局部趋势一致。
实证支撑“技能以分布式文本约束编码隐式规范、且声明意图与实现语义对齐”这一关键假设,是意图-实现绑定与单元级规范推理整个方法设计的动机实验。
定义四层可见性在工作流图节点与代码图节点上的语义:Holistic 为技能级目标与全局约束(两图共享);Lineage 为执行路径上游单元/调用路径上的祖先定义;Neighbors 为父阶段及兄弟操作/直接调用者与兄弟被调者;Self 为目标节点(事实视图中额外暴露绑定实现分支,期望视图中被屏蔽)。
意图掩码的精确语义规范表,是实现复现与理解多视图之间差异的必要参考,消除“每层到底给 LLM 看什么”的歧义。
评测集统计:SkillsTop 含文本 160 + 脚本 160 个技能,SkillsBench 含文本 152 + 脚本 43 个,共 515 技能、4,488 文件、103,005 行 SKILL.md、198,404 行代码、635,856 行其他资源;均于 2026-07-14 收集并冻结版本。
划定评测范围与 Text/Script 子集划分,后续所有按数据集与技能类型分解的实验结果都以这张表为基准进行解读。
总体效果:515 技能中 239 个(46.4%)含至少一个缺陷,人工确认 763 个;工作流缺陷验证 625、确认 346(精度 55.4%),代码缺陷验证 621、确认 417(精度 67.1%);含脚本技能缺陷率远高于纯文本(SkillsTop-S 69.4% 对 SkillsTop-T 18.1%,SkillsBench-S 62.8% 对 47.4%),每技能平均缺陷 1.4–4.4 个。
论文最重要的结果表:给出主结论“46.4% 的真实技能存在缺陷、总体精度 61.2%(工作流 55.4%/代码 67.1%)”,并直观呈现两类缺陷可验证性的不对称。
763 个确认缺陷按四类分布(LLM-as-a-judge 自动归类):工作流侧需求错误 149(43.1%)、语义冲突 61(17.6%)、实现偏差 90(26.0%)、约束缺失 46(13.3%);代码侧实现偏差占绝对主导 382(91.6%),约束缺失 28(6.7%)、需求错误仅 7(1.7%)、语义冲突 0。
揭示生命周期义务的不对称转移:74.0% 工作流缺陷源于需求制定与约束传播阶段,91.6% 代码缺陷源于实现偏离既定意图,支撑“技能正确性是全生命周期精化义务”的核心论断。
各类节点的数量、占比、入选数与缺陷确认情况:工作流 root 515、stage 2,110、context 2,261(结构节点不参与检测);plain 3,351(确认 64,确认率 1.9%)、inline_code 2,689(确认 243,9.0%)、ref_code 575(确认 39,6.8%);代码图函数节点 7,077(入选 1,502,确认 417,确认率 5.9%)。
用节点粒度证明缺陷集中于语义丰富的实现边界(尤其意图-代码绑定的 inline_code/ref_code/function 节点),为双向绑定与结构化表示的设计决策提供直接证据。
五个后端(GPT-5.6-Sol、GPT-5.6-Luna、DeepSeek-V4-Pro、DeepSeek-V4-Flash、本地 Qwen3.8-27B)在 4 个子集上的候选/验证数与验证率:各后端验证出 211–303 个缺陷技能;GPT-5.6-Sol 总体验证率最高(技能 84.6%、代码候选 90.8%、工作流 63.7%),工作流验证率跨度 29.3%(Luna, SkillsTop-T)至 70.9%;代码候选验证率所有后端均超过 79.2%,各后端最低点均出现在纯文本 SkillsTop-T。
核心鲁棒性证据:规范推理跨模型族、跨参数规模一致有效,不依赖前沿闭源模型;同时把“自然语言意图推断是主要瓶颈”这一结论量化到具体数字。
SkillsBench-S 上与无规范直接检测(Vanilla)的对照:Vanilla 产出 102 个工作流候选(人工确认 29,28.4%)与 179 个代码候选(确认 101,56.4%);SkillSpec 产出 55 个工作流候选(确认 21,38.2%)与 152 个代码候选(确认 97,63.8%),验证率也从 65.7%/83.2% 升至 70.9%/91.4%。
隔离霍尔式规范本身的贡献:显式状态断言像语义正则化器,显著抑制过度推断、收紧候选池并提高确认率,是方法组件有效性的关键消融证据。
SkillsBench 上单视图与多视图对照:Self 234/546(42.9%)、Lineage 231/504(45.8%)、Neighbors 236/546(43.2%)、Holistic 228/517(44.1%),多视图联合 261/541(48.2%);单视图并集只覆盖多视图确认缺陷的 97.7%,交集 76.2%。
证明多视图联合推理超越简单聚合——存在跨视图互补才能暴露的缺陷,且无任何单一视图稳定占优,是意图掩码设计价值的直接实验支撑。
端到端成本分解(GPT-5.6-Sol 做图构建与推理、Grok 4.6 做沙箱验证,515 技能 223 分钟、总成本 $1,331):图构建 $0.404/技能(15.6%)、规范推理 $1.915/技能即 $0.137/节点(74.1%)、沙箱验证 $0.266/技能即 $0.082/候选(10.3%),合计 $2.585/技能;含脚本技能因仓库更大而更贵,398 节点的 image-gen 是高成本离群点。
精确的成本画像对落地部署至关重要:规范推理是绝对瓶颈,直接提示优化方向(节点缓存、语义去重、本地小模型),也让部署门槛可量化评估。
通过沙箱验证但被人工判为误报的 346 个案例分类:工作流误报 197 个中过度推断 135(68.5%)、外部补偿 39(19.8%)、良性差异 12(6.1%)、不可达触发 8(4.1%)、无支撑声明 3(1.5%);代码误报 149 个中不可达触发 74(49.7%)、良性差异 34(22.8%)、过度推断 31(20.8%)、无支撑声明 7(4.7%)、外部补偿 3(2.0%)。
系统解剖误差来源:纯幻觉不足 5%,主要错误模式(过推断、不可达触发、运行时外部补偿、良性差异)各自对应一个明确的可改进技术方向,是理解方法边界的必读表。