到货即坏:公共模型仓库中的失效量化大语言模型产物及其检测方法 Broken on Arrival: Non-Functional Quantized LLM Artifacts in Public Model Registries and How to Catch Them
普查305个Ollama量化标签发现7个失效,逐张量重建证明文件未损坏、败在缺校准
前置知识
GGUF 与 k-quants 量化
GGUF 是 llama.cpp 的单文件模型格式,也是 Ollama 的底层格式。k-quants 把权重切成固定大小的块(每块如 256 个权重),各带独立缩放因子,并按固定混合规则给张量分配量化类型;q3_K_M 这类“级别”名描述整套混合方案而非单一比特宽度,仓库标签通常 2–8 位每权重。
论文的普查对象就是仓库里的 GGUF 标签,“低位宽标签”、逐张量类型与字节比较、张量混合(tensor mix)差异等核心概念都建立在对该格式与命名约定的理解上,不熟悉 GGUF 就无法读懂归因方法。
重要性矩阵(imatrix)与量化校准
imatrix 是 llama.cpp 的校准机制:先用校准文本(如 WikiText-2)前向一遍模型记录激活统计,量化时用它为舍入误差加权、替每个块挑选更优缩放因子,相当于把均匀误差最小化换成激活加权最小化。GPTQ、AWQ 是同类思想的 checkpoint 级实现,位宽越低收益越大。
本文最核心的结论——给 Qwen2.5-Coder-3B 加一步 imatrix 校准,把三个失效级别从 0 分救回 46–69%——就是对校准作用的受控验证,不懂 imatrix 就无法理解“collapse, rescued”这一定性。
HumanEval+ 与 EvalPlus
HumanEval 是 164 道 Python 编程题基准,运行生成代码并通过全部单元测试才算解出;EvalPlus 在其上加入强化测试(更多边界用例)构成 HumanEval+,可显著降低假阳性通过率。本文全部功能判定用它打分,且须逐题串行评分以避免并行超时误判。
全文所有功能判定都用这 164 个任务打分,15 任务筛选套件就是从“23 个健康配置全部解出的 39 个任务”中取字典序前 15 个,“非功能性”定义为解出不足 10%(即 16/164)——理解判分规则才能理解筛选与确认两级阈值。
困惑度(perplexity)
困惑度衡量模型在留出文本上的预测不确定度:$\mathrm{PPL}=\exp\left(-\frac{1}{N}\sum_i \log p(x_i\mid x_{<i})\right)$,对 WikiText-2 计算即可。量化损伤会直接推高它,且无需执行生成代码,是廉价的预检查信号。
论文用困惑度作为 RQ3“免执行检测”的主力手段:5 个失效构建的困惑度是 fp16 的 27–5,700 倍(如 Qwen q2_K 达 66,391,fp16 仅 11.5),而 4 位标签停留在 fp16 的 ±5% 内,10–25 倍阈值即可零执行地标记全部失效构建。
张量级出处比对与配方匹配重建
把 GGUF 文件按张量逐一取出,比较类型、形状与字节内容(忽略元数据与张量顺序);并用文件元数据指示的配方从原始 checkpoint 重新量化出“裁判”构建。文件哈希只能证明字节级副本,张量对比才能识别不同文件名下的同一转换。
这是本文归因程序(recipe-matched rebuild)的技术基础,“精确可复现却不工作”这一反直觉核心结论正来自该比对,而且它还揭露了 phi3.5 失败文件通过 4 个店面分发的同一转换事实。
研究动机
开发者今天在本地运行大语言模型,通常是从公共模型仓库拉取一个量化文件。互联网范围的测量发现超过 32 万个公开可达的自托管 LLM 服务,其中 155,423 个是 Ollama 实例;另一项为期一年的测量记录到 152,137 个暴露 Ollama 的独立 IP。下载的文件是模型作者所评估权重的转换版本,通常以 GGUF 格式存储在每权重 2–8 位,由仓库运营者或社区志愿者生产——而作者核查过的所有仓库,无论仓库页面还是文件元数据,都没有记录发布前做过任何功能性测试。缺口并非假设:2024 年 llama.cpp 维护者发现,修复前转换的 BPE GGUF 文件会在“几乎所有情况下”回退到错误的默认预分词,某精选仓库随即报告受影响模型;两年后作者普查时,该仓库 305 个合格标签中仍有 26 个缺少 pre-tokenizer 类型。量化研究也表明聚合指标会掩盖对单个答案的损伤,但此前没有任何工作在仓库尺度上测量“量化文件失效的频率与原因”。
本文的目标是本文的目标是替模型分发管道补上缺失的功能检验环节:在仓库规模上实际执行发布的文件,为下游用户提供质量验证。研究拆解为四个问题:RQ1(流行度)——多少分发的产物不可用、分布在哪里;RQ2(原因)——失败归因于文件本身、量化配方、模型、聊天模板还是推理后端;RQ3(免执行检测)——不执行生成代码时,廉价输出统计量或困惑度能否标记失败;RQ4(验收门)——调优过的 15 任务筛选能否充当仓库的验收测试。作者同时发布全部审计数据(逐产物转录、输出统计、判定与分数)、重建与裁判文件哈希、逐张量比较、运行日志与注日期的运行计划,以及集成了筛选、评分、重建、校准与张量比较脚本的 quantcheck 工具,并给出可落地建议:发布前筛查低位宽标签,对失败者先校准再发布或直接扣留该级别。
与已有工作不同的是,本文的独特切入是把“执行”与“重建”两类此前互不相通的问题拼在一起。最接近的先行工作 Singh et al. 探测了 13 个 Ollama 仓库模型与 14 个 Unsloth 构建的量化阶梯,发现仓库的 Phi-3、Phi-3.5-mini 与 Qwen2.5-3B 的 q2_K 构建不可用,却把“误量化还是模型压不动该级别”留成悬案,也没有比较同一权重的普通构建与校准构建。Liu & Tsai 检验 HF GGUF 文件能否从发布者自己的 fp16 GGUF 逐位重推导——他们问“文件能否被复现”,本文问“文件能否工作、若不能为什么”;执行与重建回答不同的问题,因为一个文件可以精确匹配其配方却仍然不工作。Table I 显示本文是唯一同时覆盖执行普查、配方对照与受控归因三列的研究。方法论上另一独特之处是自我纠错:本研究的 v1 版按分发者而非配方选择参照转换,把这几个标签误诊为“有缺陷的转换”;配方匹配重建纠正了诊断,也示范了归因必须以配方而非分销商为轴。
核心方法
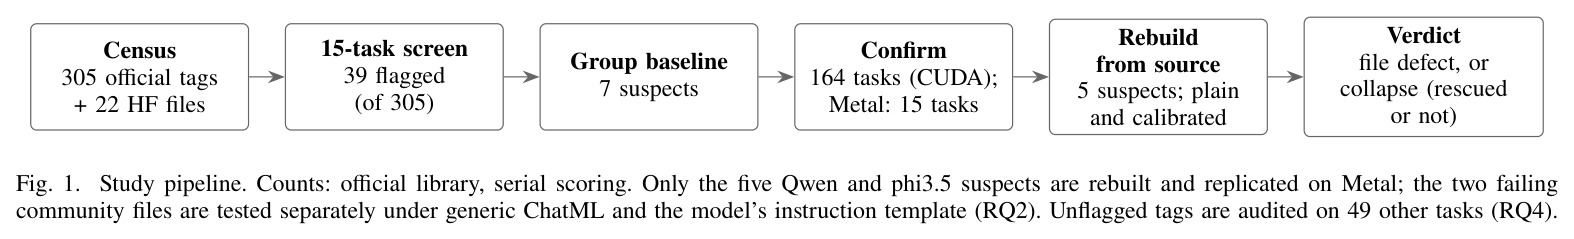
直觉上,模型分发是一条数据管道:checkpoint → 转换 → 量化 → 发布,任何环节都可能引入损伤,但管道上没有任何功能检查关卡,对下游用户而言,仓库标签是一个未经验证的输入。本文的做法是替管道补上这道测试:先在仓库规模上执行发布的文件做普查,再对确认的失败做受控归因。技术路线是 Fig. 1 的四级流水线:第一步普查,枚举官方 Ollama 库 15 条模型线的全部 305 个合格标签(291 个量化)加 22 个 HF 社区文件;第二步用在 24 个已知配置上调优过的 15 任务套件廉价筛选,标记 39 个;第三步把 7 个“疑似者”放到全部 164 个 HumanEval+ 任务上用 CUDA 复测(Metal 上复跑 15 任务);第四步对其中 5 个 Qwen 与 phi3.5 疑似者做配方匹配重建——从原始 checkpoint 量化无校准对照构建(referee)逐张量比较,再用 imatrix 校准构建测试救援。解码全程固定(贪心、seed 42、context 2048),第二台 RTX 4090 逐字节复现了 225 个答案。
核心创新是“配方匹配重建归因”。低分本身不说明原因,作者为每个疑似者下载原始 checkpoint,用文件元数据指示的配方(无 quantize.imatrix 键,即无校准)自己转 GGUF、同级量化,然后把仓库文件与这份 plain 重建逐张量比较——检查类型、形状与字节,忽略元数据与张量顺序。若一致,仓库文件就是一个精确但未校准的量化,失败源于配方(collapse);再用一份同权重、同 llama.cpp 提交、同张量混合的 imatrix 校准构建测试,若分数大幅回升则判“校准可救援”。这与所有先前工作的本质区别在于把比较轴从“分发者”换成“配方”:v1 版拿疑似者与第三方 bartowski 的 imatrix 文件对比,得出“转换缺陷”的错误结论;配方匹配重建发现官方文件与无校准重建逐张量一致,诊断翻转为“未校准量化、可被校准救援”。由此得出本文最重要的概念贡献:精确可复现不等于功能正常——出处与可复现性检查只回答文件从哪来、怎么造的,只有功能测试回答它能不能用。
方法步骤详情
抽样:合格标签为 instruct、代码能力、显式量化后缀、≤8 GB 的构建,得 305 个产物;社区另取 22 个流行 HF 文件。套件调优:在 24 个 Qwen2.5-Coder 配置上跑全部 HumanEval+ 与 MBPP+,23 个健康、1 个已知失败;取 39 个全健康任务中字典序前 15 个。筛选两阶段:阶段一标记 <9/15 的产物;阶段二按组基线分为 healthy(≥60%)、suspect(≤2/15 且基线 ≥8)、low baseline、degraded;疑似者 164 任务解出 <10% 即判非功能。归因:疑似者 CUDA 复测 164 任务、Metal 复跑 15 任务;从 checkpoint 无校准量化得 plain 重建并逐张量比较;校准构建用 WikiText-2 或 Python 代码建 imatrix。规则事前登记于注日期计划:file defect(疑似 ≤2/15 而 plain ≥5 且高 ≥4);collapse(plain 同样失败),同级别校准 ≥5 且高 ≥4 为 calibration-rescued。
技术新颖性
技术新颖性有五层。其一,首次在官方仓库的合格总体上做执行普查:305 个标签全部执行并发布完整转录,Table I 显示此前没有任何执行研究同时覆盖普查、配方与归因三列。其二,张量级归因程序:不比较文件哈希(哈希只能暴露字节级副本),而是比较类型、形状与字节并忽略元数据与张量顺序,从而识别“同一转换换了名字”——phi3.5 失败文件正是经 4 个店面分发的同一转换,其中两个字节级相同、第三个仅张量级可辨。其三,用受控实验证明“可复现 ≠ 可用”,把出处、可复现性与功能三个常被混为一谈的属性干净地分离。其四,对归因方法本身的方法论自觉:file-defect 条款、设置检查与首次审计样本在重建前登记于注日期计划,rescue 条款在首轮结果后修订并明确标注;v1 的误诊与 v3 的纠正都公开,构成一份罕见且可审计的实证轨迹。其五,把验收测试思想从软件供应链(npm 扫描、CI 测试、tinyBenchmarks 少样本估计)迁移到模型仓库,并量化了验收门的全部限制——套件选择敏感度、生成设置稳健性、12–105 秒/产物的成本——使其成为可操作的工程流程而非口号。
实验结果
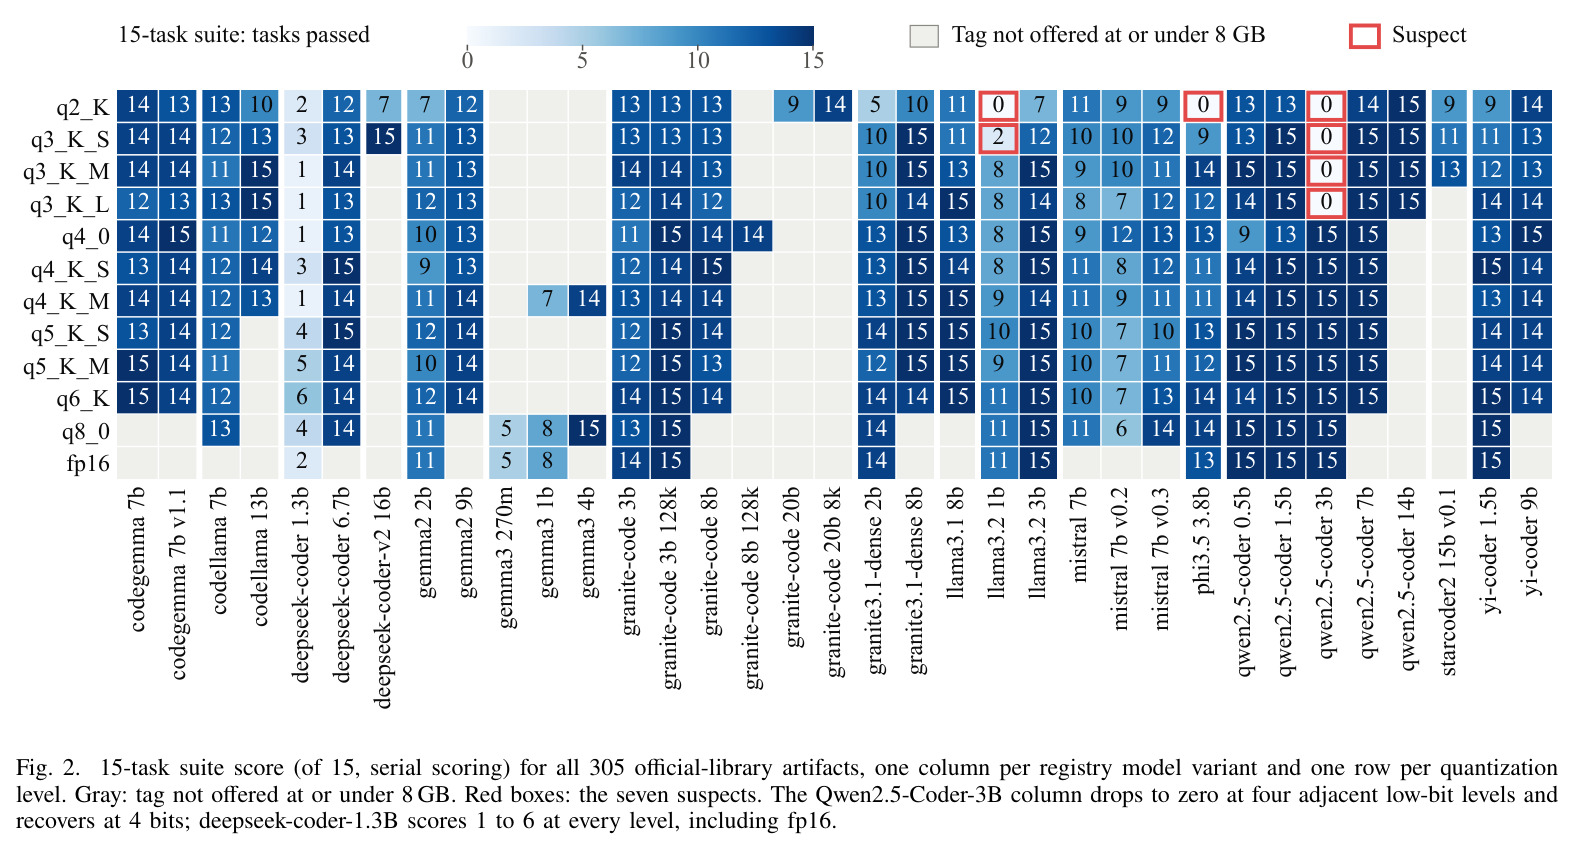
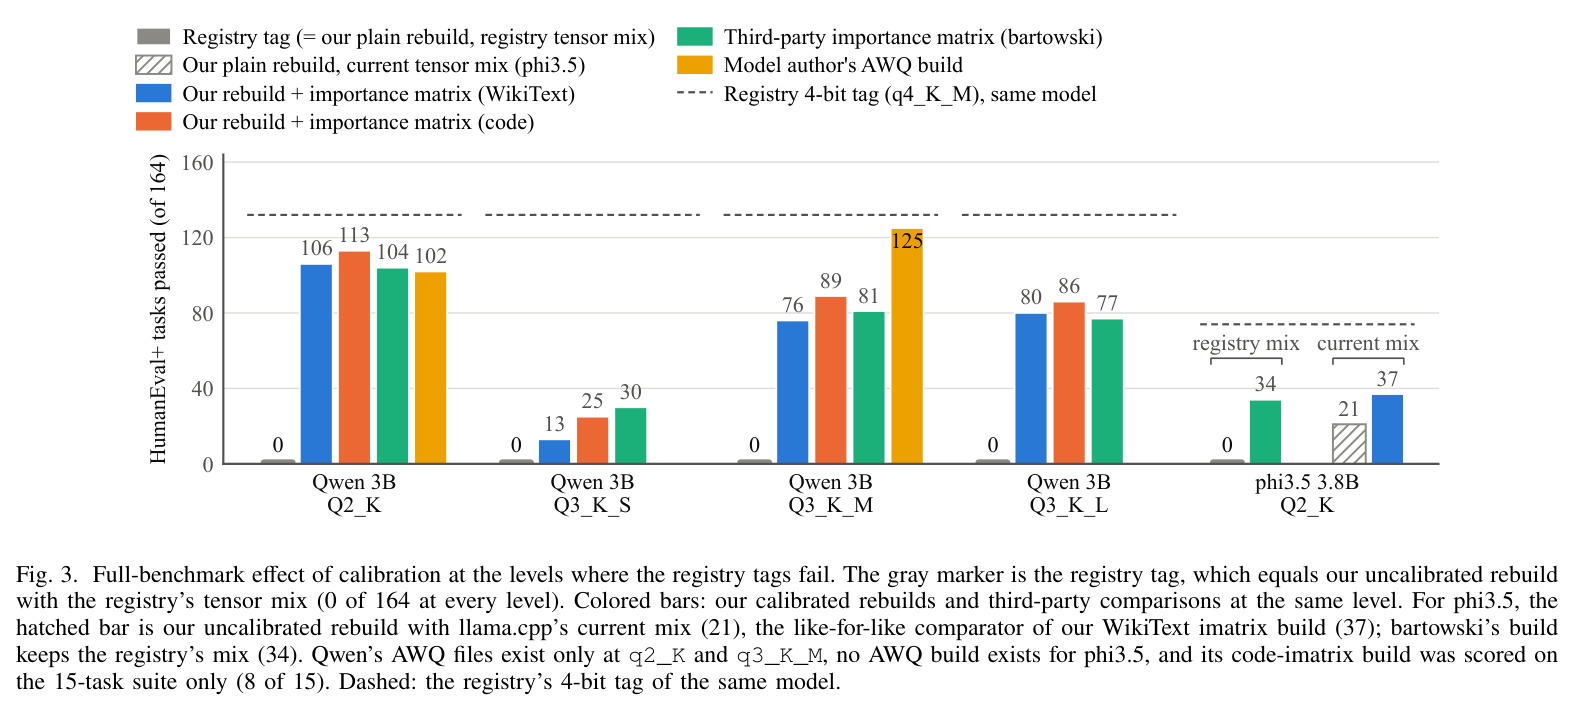
RQ1:305 个官方产物中 7 个(2.3%)不可用,涉 3/35 个变体;六解 0/164、一解 6,事件为 Qwen2.5-Coder-3B×4 相邻低级别、phi3.5-mini q2_K、llama3.2-1B×2,均属 ≤4B 模型的 q2_K–q3_K_L 标签。deepseek-coder-1.3B 全组 12 标签(含 fp16)仅 1–6/15,fp16 仅 16/164,整组低基线逃过筛选,故 7 是下界;社区 20/22 健康。RQ2:失效不崩溃、正常速度输出胡言乱语;五份重建与仓库文件逐张量一致,无一损坏;加 imatrix 后 Qwen q2_K 升至 106–113、q3_K_M 至 76–89、q3_K_L 至 80–86,phi3.5 至 37,q3_K_S 仍弱;同配方在 1.5B 正常(13–15/15),配方不能预测失败。RQ3:截断与 6-gram 重复各标记 3–4 个疑似者;困惑度为 fp16 的 27–5,700 倍,零执行可标记全部失效构建。RQ4:66 个抽查标签无一不可用;≥3 任务子集即可保持疑似者;筛选中位 30 秒/产物。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Ollama 官方库合格标签执行普查 | 非功能性标签占比 | 7/305(2.3%),35 个变体中 3 个(8.6%)失效 | 此前无仓库级执行测量;仓库未记录任何功能测试 | 首次给出仓库级失效率与 Wilson 95% 区间 1.1–4.7% |
| Qwen2.5-Coder-3B q2_K 代码生成 | HumanEval+ 通过任务数(共 164) | 未校准 0 → imatrix 校准 106–113;bartowski 104;AWQ 102–125 | 同模型 4 位标签 q4_K_M 132/164 | 0% 提升至约 65–69% |
| Qwen2.5-Coder-3B q3_K_M 代码生成 | HumanEval+ 通过任务数 | 0 → 76–89(自有 imatrix),AWQ 达 125 | q4_K_M 132/164 | 0% 提升至 46–54%(AWQ 达 76%) |
| phi-3.5-mini q2_K 代码生成 | HumanEval+ 通过任务数 | 0(仓库混合)→ 21(当前混合,attn_qkv 存为 Q3_K,3.16 对 2.96 位每权重)→ 37(再加 imatrix) | 同模型 q4_K_M 74/164 | 0% 提升至约 23% |
| 免执行失效检测 | WikiText-2 困惑度相对 fp16 的倍数 | 5 个失效构建为 27–5,700 倍(Qwen q2_K 66,391 对 fp16 11.5;q3_K_S/M/L 为 920/333/373) | 4 位标签停留在 fp16 的 ±5% 内(4.2% 与 5.1%) | 10–25 倍阈值可零执行标记全部测过的失效构建 |
| 15 任务筛选成本 | 每产物生成时间(单消费级 GPU) | 12–105 秒,中位 30 秒 | 全 164 任务基准评测 | 筛查阶段约两个数量级提速,且 66 个通过抽查者无失效 |
局限与改进
作者承认的:构念上筛选只测 Python 代码生成,产物可能在其他任务失败而通过;筛选任务取自 Qwen2.5-Coder 家族健康配置全解的题池,“容易得离谱”,阈值粗糙(phi3.5 校准只把 15 任务分从 4 提到 9,但 164 任务支持同样判定)。内部有效性上,HumanEval/15 评分故障(并行超时误判)说明工装会出错,串行复评后未改变任何判定;llama3.2-1B 因许可证未能重建与 Metal 复制;注日期运行计划未公开预注册。外部有效性上,普查只覆盖一个仓库 ≤8 GB 代码 instruct 标签,社区样本小且按流行度选择;7 是下界(低基线组未计入,全跑又在非疑似者中发现 8 个 ≤16/164);救援证据主要来自 Qwen2.5-Coder-3B;生成用单一固定运行时,重建用更新的 llama.cpp。我自己的观察:困惑度阈值 10–25 倍事后选定、误报率未测;预检查需要 fp16 参照构建;只覆盖 CUDA 与 Metal;校准后 Q3_K 仍约 6 倍困惑度差距的机制未查明;imatrix 文本与有无校准两因素未完全解耦。
独立分析的弱点
弱点一:功能覆盖单一。只测 Python 代码生成,聊天模板损坏、多语言退化都会漏网,而 TheBloke 两个文件补上模板后从 5–6/15 恢复到 13–15/15、164 任务分从 16/18 涨到 98/101,说明模板失败真实;改进方向是多领域冒烟套件。弱点二:相对筛选对整组失败无能为力。deepseek-coder-1.3B 全组 1–6/15 逃过 suspect 判定,因为组内没有可用的高精度基线;改进是设绝对下限或与论文自报分数核对。弱点三:统计基础薄弱。10–25 倍困惑度阈值事后选定、误报率未知;q3_K_S 为 2/15,在 3–14 任务子集中有 31–87% 概率掉出疑似集合;改进是系统调阈值并测 FPR/FNR。弱点四:机制未明。同一配方为何 1.5B 可用而 3B 失败?tied embeddings 的证据方向不一,校准后 Q3_K 仍差的原因未查明;改进是逐层消融量化误差。弱点五:单运行时单后端。Ollama 0.32.6 加 CUDA/Metal 的结论未必迁移到新版 llama.cpp、vLLM 或 CPU 后端;改进是建立版本×后端矩阵复测。
未来方向
作者提出的:仓库应在发布前筛查每个低位宽标签,失败者先校准再发布或扣留该级别;元数据应记录配方、校准输入与有效位每权重,使标签可验证;从业者应在部署所用的后端与聊天模板上测试产物;研究者用仓库标签做替身时应把配方问题与精度极限分开——SynConfRoute 测得 q2_K 为 0% 并建议 3B 以上用 Q4_K_M,而本文校准后的 q2_K 能解约三分之二 HumanEval+,说明这类结论可能误读。可延伸的:把 quantcheck 集成为仓库 CI 验收门,对新上传自动跑 30 秒筛选并公示;把归因管线自动化(失败→重建→张量对比→报告);普查扩展到 AWQ/GPTQ/EXL2 格式与 vLLM/MLX 运行时,回答失效是否为 GGUF/Ollama 特有;对校准救援做机制研究——为何 imatrix 救得了 Q2_K/Q3_K_M/Q3_K_L 却救不了 q3_K_S、救援为何在高位宽减弱;审计 imatrix 校准文本本身(校准数据可被投毒,与 GGUF 量化攻击面相接);做纵向监测——作者已观察到 8–10 月失效文件字节不变,可推广为持续失效追踪。
复现评估
复现条件在实证研究里属最好一档。工具与数据全部开源:quantcheck v3.4(github.com/aditi-p31/quantcheck)含审计数据集(转录、输出统计、判定与分数)、重建与裁判文件哈希、逐张量比较、运行日志、注日期运行计划及调优配置的逐任务结果。算力门槛很低:普查筛选在单张消费级 GPU(RTX 4090)上每产物中位 30 秒;转换、量化与 imatrix 全在 CPU(llama.cpp v0.7.0,620d222);复制用 Apple M2。关键变量钉死(Ollama 0.32.6、贪心、seed 42、context 2048),第二台 RTX 4090 逐字节复现 225 个答案,外部读者在 CPU Debian 加 Ollama 0.33.3 独立复现 q3_K_M 失败。难度:跑筛选与普查复现属低难度;完整重建归因需熟悉 llama.cpp 的 convert/quantize/imatrix 管线,属中等;唯一硬缺口是许可证限制的 Llama-3.2-1B-Instruct checkpoint 使两个标签无法归因。
论文图表
把本文与九项执行类研究按“执行对象”和三列能力对比:Gao et al.(API 端点)、Cai et al.(模拟替换)、Kimi Vendor Verifier(厂商部署)、Kadasi et al.(hub 任务模型)、Husom et al.(树莓派上的 Ollama 标签)、Kurt(自有转换)、SynConfRoute(Ollama 标签)、Singh et al.(Ollama 与 HF 构建)、Liu & Tsai(HF GGUF 重建)。只有本文同时勾选普查(census)、配方(recipe)与归因(cause)三列。
这张表划定了论文的贡献坐标:先前工作要么只测执行不查原因,要么只验证可复现性不问功能,本文是第一个把三者串起来的研究,读者据此可快速定位与相关工作的差异。
实验设置清单:生成用 Ollama 0.32.6(捆绑 llama.cpp 96278e3)并全程钉住;重建用 CPU 上的 llama.cpp v0.7.0(620d222)做转换、量化、imatrix 与困惑度;checkpoint 为 Qwen2.5-Coder-3B/1.5B/0.5B-Instruct 与 Phi-3.5-mini-instruct 的固定 revision;后端为 RTX 4090 CUDA(普查与复测)与 Apple M2 Metal(复制);解码为贪心、seed 42、context 2048、至多 768 个新 token;评分用 EvalPlus 0.3.1 的 HumanEval+ 强化测试、逐题串行;校准 imatrix 取 100 段 512 token 的 WikiText-2 训练集或 1.5 MB llama.cpp 仓库 Python 源码。
所有结论的可信度都取决于环境是否被钉死。这张表给出复现所需的全部版本号与常量,也是“第二台 4090 逐字节复现 225 个答案”这一稳定性声明的前提。
串行评分下 305 个官方产物对组基线的分类计数:healthy(≥60% 基线)271 个、degraded(<60% 但基线 ≥8)2 个、low baseline(基线 <8)6 个、suspect(≤2/15 且基线 ≥8)7 个、无框内基线 19 个。注释指出全部 6 个低基线标签和 6 个健康标签都是 deepseek-coder-1.3B(得分 1–6/15),即整组失败的家族同时占据了两个类别的异常份额。
RQ1 普查的完整计数表:2.3% 的分子分母、以及为什么 7 只是下界(低基线组不计入失效),都能在这张表里对账。
七个疑似者的归因主表,列为:库标签 15 任务分、库标签 164 任务分、plain 重建分(phi3.5 含两种张量混合)、自有 imatrix 分(WikiText 与代码两列)、第三方分(bartowski;llama3.2-1B 用 unsloth)、Qwen 官方 AWQ 分、最佳校准 164 任务分与最终判定。四个 Qwen 标签与 phi3.5 均判为“collapse,被校准救援”,其中 q2_K 最佳校准 113、q3_K_M 125(AWQ)、q3_K_L 86、phi3.5 37;q3_K_S 仅 30,未达救援规则;两个 llama3.2-1B 因许可证未重建,判“未归因”,且 unsloth 的校准文件也得 1 与 4/15。
RQ2 的全部结论浓缩在一行行分数里:plain 重建与库文件同为 0 分证明非文件缺陷,校准列的大幅回升证明配方可救,未归因行的诚实记录展示了归因规则的边界。
四个失效构建对全套件最简单任务(一行字符串长度函数)的回答开头,逐字保留(合并连续空白):Qwen q2_K 输出“program9 demon1 bil mess(bil is sports Audi program program...”直到 token 上限;q3_K_S 输出互相打断的代码块;q3_K_M 输出流畅的解说后给出空函数;phi3.5 q2_K 输出混乱的 import 与引号嵌套。共同点是语言流畅、速度正常、绝不崩溃。
让读者亲眼看到“非功能性”的真实样貌:这不是报错或拒绝服务,而是貌似正常的胡言乱语——这正是用户最难察觉、也最值得仓库端验收测试拦截的失败模式。
同一未校准配方在 Qwen2.5-Coder 两个尺寸上的三列对比(库标签 / plain 重建 / WikiText imatrix 重建):1.5B 的 q2_K 到 q3_K_L 全部为 13–15/15(校准后 12–15),库与重建张量在两个尺寸都完全一致;3B 同样低四位库与重建全为 0,校准后分别升到 15/2/9/7。同一配方、同一工具链,唯一变量是模型尺寸。
“配方本身不能预测失败”这一关键结论的直接证据:如果 q2_K 配方天生损坏,1.5B 不可能全过;失败只在 3B 的权重上与未校准误差相互作用时出现。
各构建在 WikiText-2 上的困惑度:fp16 为 11.5(Qwen)/6.9(phi3.5),库 q4_K_M 为 12.1/7.2(约 +4–5%);库 q2_K 高达 66,391/184.1(fp16 的约 5,700/27 倍),库 q3_K_S/M/L 为 920/333/373;库低位文件与 plain 重建困惑度相等,印证张量一致;校准后大幅回落(Q2_K 14.4/14.9 与 10.4/10.5;Q3_K_M 72.7/70.8 与 7.7/7.7),W/C 两种 imatrix 差距 4% 内。
RQ3 免执行检测的量化基础:失效与困惑度爆炸强相关而 4 位标签几乎无损,说明一个便宜的困惑度预检查就能在发布前拦下这些文件;同时校准后 Q3_K 仍约 6 倍于 fp16 却能解题,提醒困惑度不是功能判定。
替代生成设置下的 15 任务分数:基线为贪心、context 2048、上限 768;另测 context 4k、context 8k、上限 2k、温度 0.2 配三个种子。五个重建疑似者(库疑似者与 plain Qwen-3B)在所有设置下均为 0,phi3.5 plain(当前混合)保持 0–4,而健康的 Qwen-3B q4_K_M 全部 15,phi3.5 q4_K_M 为 9–11。结论:所有判定对解码设置稳健(校准构建未在替代设置下复测)。
验收门必须排除“换个采样参数就好了”的质疑。这张表证明失效是确定性的、与温度/上下文/长度上限无关,是 RQ4 验收门可靠性的必要稳健性检验。