以训练为编译:将自然语言规范编译为可本地复用的神经函数 Compile by Training: Turning Natural-Language Specifications into Local Neural Functions
教师模型合成数据微调LoRA,把自然语言规范编译成本地可复用的神经函数
前置知识
LoRA 低秩适配
LoRA 在冻结的基座模型旁注入低秩矩阵对 $A \in \mathbb{R}^{d \times r}$、$B \in \mathbb{R}^{r \times d}$,只训练增量 $\Delta W = BA$(秩 $r$ 远小于 $d$),用极少量参数即可为特定任务定制模型。本文用 rank-64、alpha-16 的 LoRA 适配器表示每个编译出的函数,所有函数共享同一个冻结的 Qwen3-0.6B 解释器。
编译出的神经函数本质上就是一个 LoRA 适配器加运行时脚手架,不理解 LoRA 就无法理解程序如何被打包成 .paw 工件、如何存储版本化与组合复用。
Program-as-Weights 与摊销编译器
PAW 是本文的前作范式:把'程序'表示为共享解释器上的适配器,并由一个摊销编译器(超网络)在单次前向传播中直接预测出任务适配器,耗时约 3.5 秒,但每个函数投入的计算量完全相同、无法按需追加。FuzzyBench-Hard 正是专门挑选快编译器精确匹配为零的困难规范子集。
PAW 快速编译器是本文的对照基线和初始化来源,理解它'快但固定算力'的特性,才能明白本文'编译期按规范追加训练算力'的定位与 +0.612 LEM 提升的来源。
合成监督与知识蒸馏
用大模型生成输入-输出对来训练小模型,是 Self-Instruct、蒸馏(Hinton 等)等路线的共同思想。本文让 GPT-5.4-mini 与 GPT-5.5 按 2:1 混合,为每条规范合成约 2400 个唯一样本对,经编译器逐条校验、剔除畸形批次后作为 LoRA 微调的监督信号。
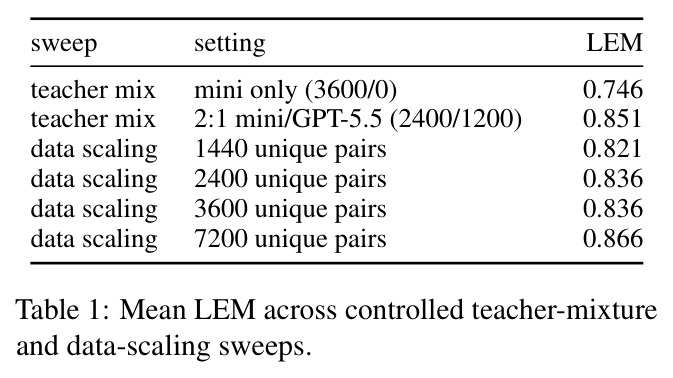
编译的核心一步就是从规范自动构造训练集,教师配比与数据规模直接决定最终函数质量(Table 1 的两组消融全部围绕它展开)。
LLM-as-Judge 与 LEM 指标
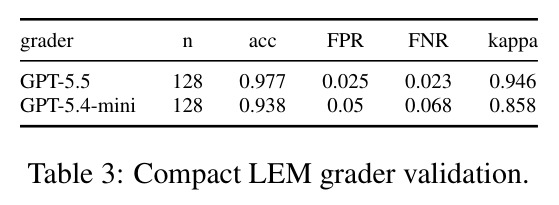
模糊任务的多个输出都可能是对的:两个 JSON 数值相同仅键序不同,精确匹配会误判为错。LEM(LLM Exact Match)用 GPT-5.5 按规范判断语义等价,明确忽略空格、JSON 缩进与键序、列表符号等格式差异,但拒绝数值、顺序、结构和逻辑错误;作者用 128 条人工标注验证裁判,准确率 0.977、Cohen's $\kappa = 0.946$。
论文所有主结果都以 LEM 度量,只有了解其判定规则与经过验证的可信度,才能正确解读 0.836 这个核心数字的含义与局限。
编译/运行分离
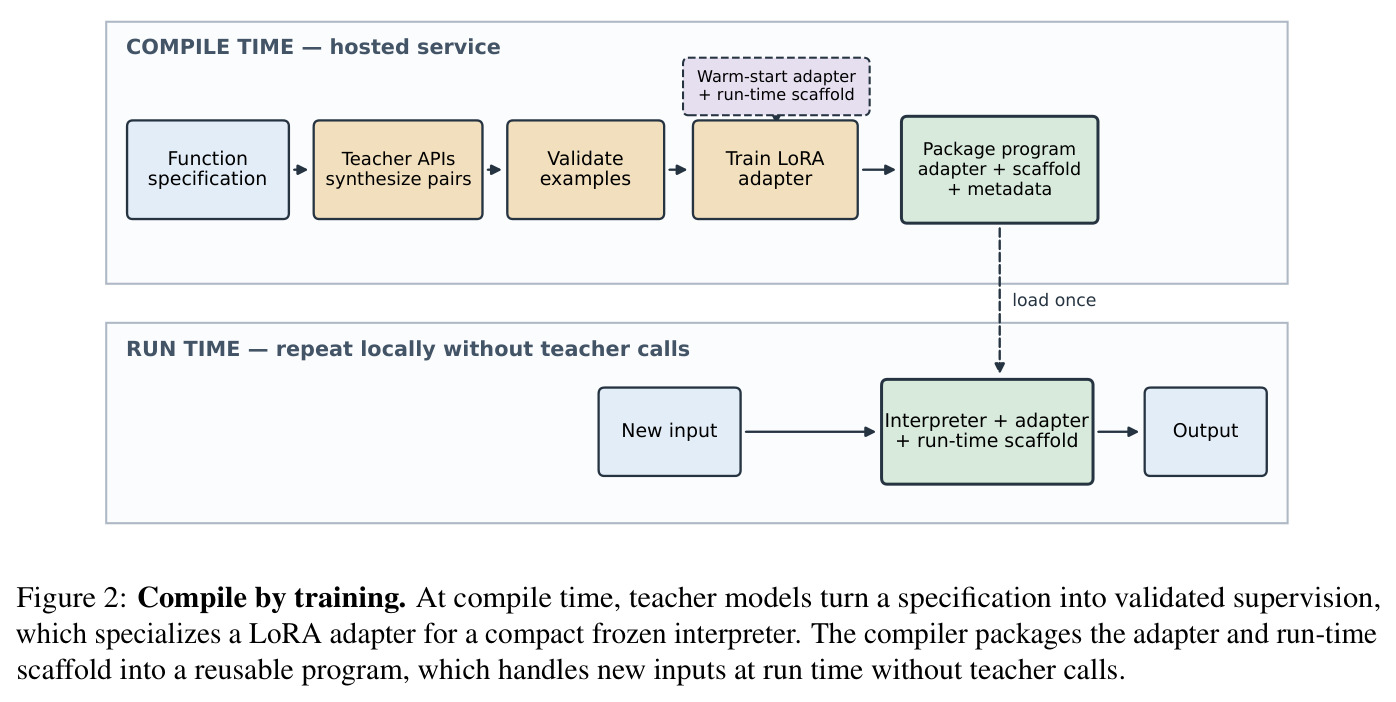
借鉴软件构建的分工:编译期允许昂贵的一次性计算(调用教师 API、GPU 训练),运行期产物在本地被反复调用且不回传数据。本文用 .paw 工件打包适配器、运行时脚手架、原始规范和解释器元数据,使其像普通软件一样被缓存、版本化和组合。
这是全文成本模型与隐私论证的基础:教师与 GPU 只是编译期依赖,新输入永远不会发给 PAW 服务或教师,这一卖点贯穿摘要、部署与结论。
研究动机
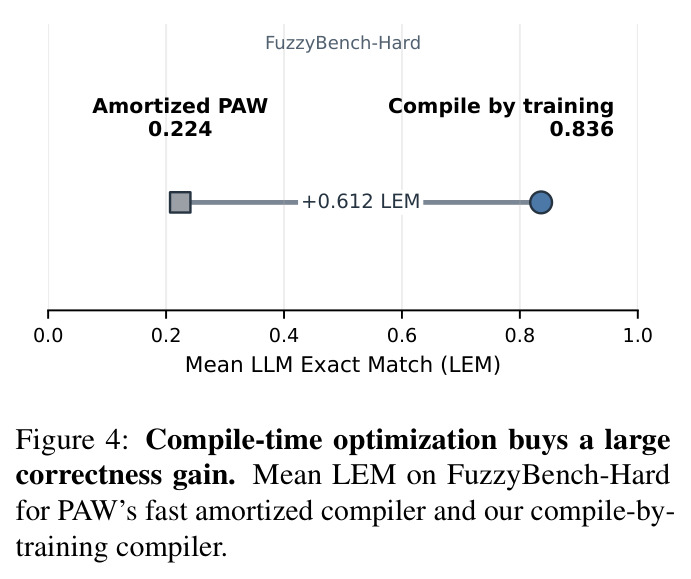
许多反复出现的文本函数处于两难境地。以邮件分诊为例:把 'Signature needed by EOD' 判为立即处理、把新闻邮件判为等待,这个行为描述起来很容易、在成千上万条消息上都很有用,但写成硬编码规则非常繁琐;直接为每条消息调用大型远程模型虽然准确,却每次都要付出网络延迟、按次计费的成本,还依赖外部服务商。也就是说,这类函数对传统代码来说太模糊,对逐次大模型调用来说又太高频、太专用。已有的 Program-as-Weights(PAW)摊销编译器虽能在单次前向传播中以约 3.5 秒预测出神经程序,但它对每个函数投入的计算量固定,在困难规范组成的 FuzzyBench-Hard 上平均 LEM 只有 0.224,没有一条精确匹配——快,但不够准。
本文的目标是本文要构造一个'编译器':输入一条自然语言函数规范 $s$,输出可存储、可版本化、可组合的神经程序 $p_s$,使得 $\hat{y} = \mathrm{Run}(p_s, x)$ 能在本地对新输入反复推理,运行期完全不需要教师模型。论文把这个问题拆成三个明确的待验证问题:其一,编译期追加算力能否比一次性权重预测得到显著更准的函数;其二,约一分钟量级的构建能否仍然融入交互式服务的使用节奏;其三,各自独立编译出的神经函数能否作为组件,与普通代码一起嵌进更大的应用。
与已有工作不同的是,本文的独特切入是把'编译'从生成源代码或一次性预测权重,重新定义为'以训练为编译':保留 PAW 的程序格式与运行时接口,把摊销编译器的预测当作初始化,再用教师合成的规范专属数据做梯度优化。在这一视角下,模型适配变成类似软件构建的步骤,大语言模型充当'工具建造者'而非运行时依赖。同时,论文不是只提概念,而是用合成-训练重叠、共享作业队列、教师输出缓存、跨刷新持久的后台作业交互等一整套系统工程,把分钟级构建真正压进了交互式服务的可用范围,这是与 Prompt2Model 等同类工作最大的不同。
核心方法
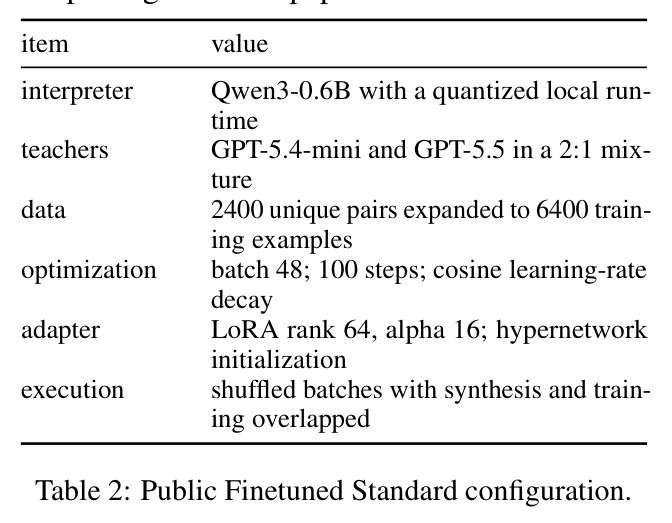
系统把'构建'与'使用'严格分离,接口为 $p_s = \mathrm{Compile}(s)$ 与 $\hat{y} = \mathrm{Run}(p_s, x)$。编译分两阶段:先用教师模型从规范合成任务数据集 $\mathcal{D}_s = \{(x_i, y_i)\}_{i=1}^{n} \sim T(s)$;再用这些样本为共享冻结的 Qwen3-0.6B 解释器训练轻量 LoRA 适配器,最小化 $\mathcal{L}(\theta_s) = \sum_{(x,y)} -\log p_{\theta_s}(y \mid r_s(x))$,$r_s$ 是把规范编码为结构化指令、并为运行时输入留占位符的脚手架。公开配置:量化 Qwen3-0.6B、2:1 混合教师(GPT-5.4-mini/GPT-5.5)、rank-64/alpha-16 LoRA、摊销编译器热启动、batch 48、100 步余弦学习率调度($2 \times 10^{-4}$),2400 个唯一样本对扩展为 6400 条训练样本。最终适配器、脚手架、规范与解释器元数据被打包进可版本化的 .paw 工件。
核心创新是'编译即训练'这一重构:编译不再是让模型生成代码,也不是 PAW 那样单次前向预测全部适配器权重,而是把编译期算力按规范投入'教师合成数据 + 专属梯度优化'。与 PAW 的本质区别在计算分配策略:摊销编译器对每个函数花同样的固定计算(3.5 秒),而本文以它的预测为热启动再精炼,用约 50.9 秒把 FuzzyBench-Hard 的 LEM 从 0.224 提到 0.836。与 Prompt2Model、LoRA Land 等微调管线的区别在于产物形态:为共享冻结解释器生成可版本化的程序工件,并首次把摊销预测用作规范级训练的初始化——相当于把'训练'当作一种编译期的测试时算力来消费。
方法步骤详情
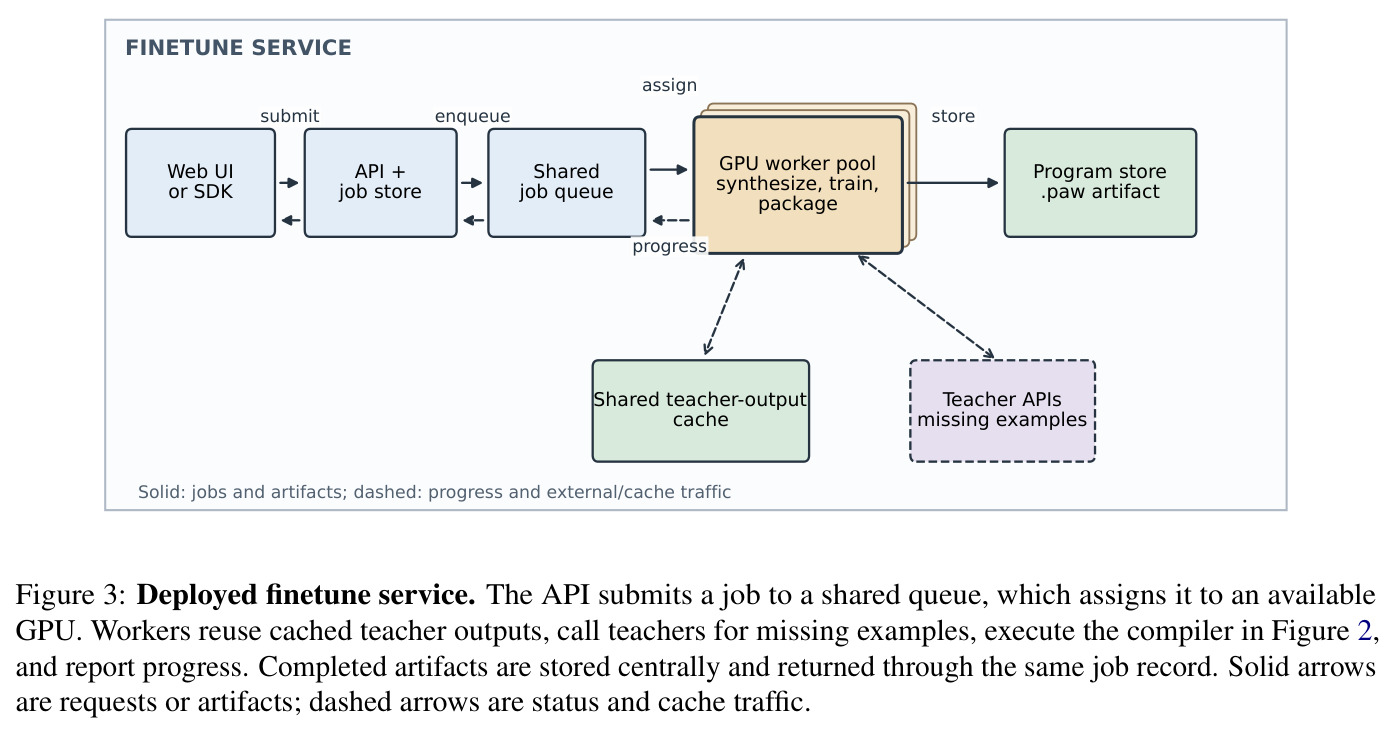
完整流程分六步。第一步规范:开发者写自然语言规范 $s$,例如'从 /pdf/ 链接提取 arXiv 编号并忽略 /abs/ 链接'。第二步合成:混合教师按结构化 JSON 模板生成 (输入, 输出) 对,低成本教师供大多数样本、大教师补充互补监督,编译器逐条校验并拒绝畸形或不完整批次;训练在首批样本就绪后即启动,只在训练追上合成时才阻塞。第三步重叠:流式流水线让教师请求、模型加载与训练并发执行,调度器把晚到样本优先填入较早批次所需的空槽,不改变已接受样本及其训练顺序,从而缩短关键路径。第四步训练:以摊销编译器超网络的输出初始化 rank-64 LoRA(alpha 16),batch 48、100 步、学习率余弦衰减($2 \times 10^{-4}$)。第五步打包:适配器与脚手架写入 .paw 工件,存入共享工件库并回链持久作业记录。第六步运行:SDK 把新输入与运行时提示拼接后交给共享解释器本地执行,全程不访问 PAW 服务与教师 API。
技术新颖性
技术新颖性分三层。概念层:把自然语言规范到神经函数的转换建模为分钟级后台构建作业,在'速度-精度'谱系上给出第三个点——快编译器 3.5 秒 / 0.224 LEM、逐次大模型调用随时可用但贵、本文 50.9 秒 / 0.836 LEM,让用户像选编译优化等级一样做权衡。方法层:摊销预测作初始化 + 规范专属测试时训练的混合范式,是对单次前向权重预测的自然升级,且不改变程序格式与运行时接口,保证向后兼容。系统层:合成-训练重叠调度、GPU 工人池与作业队列分离、教师输出缓存复用、跨页面刷新持久的作业进度交互,使 4 个并发编译作业的平均排队等待仅 1.01 秒,并有效隐藏了占主导地位的教师合成延迟。
实验结果
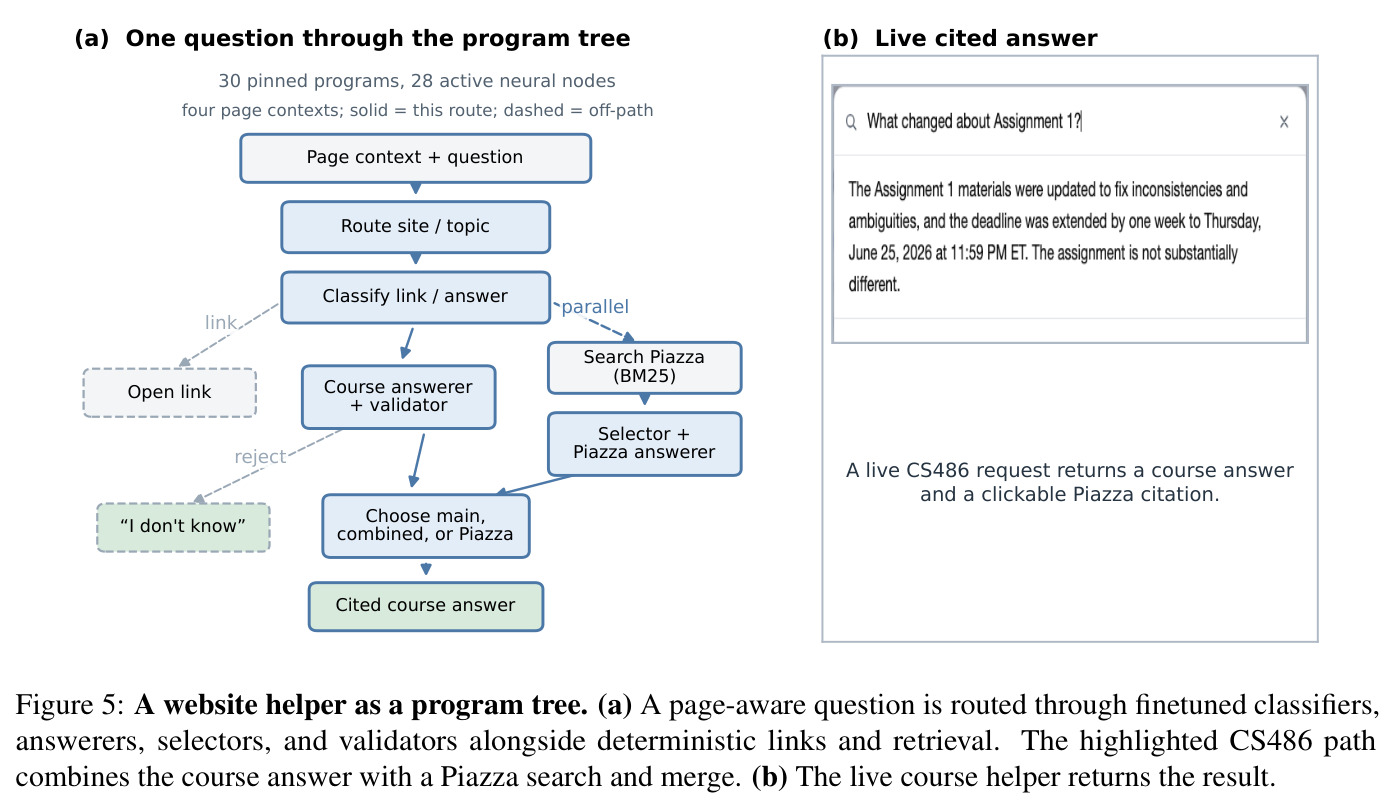
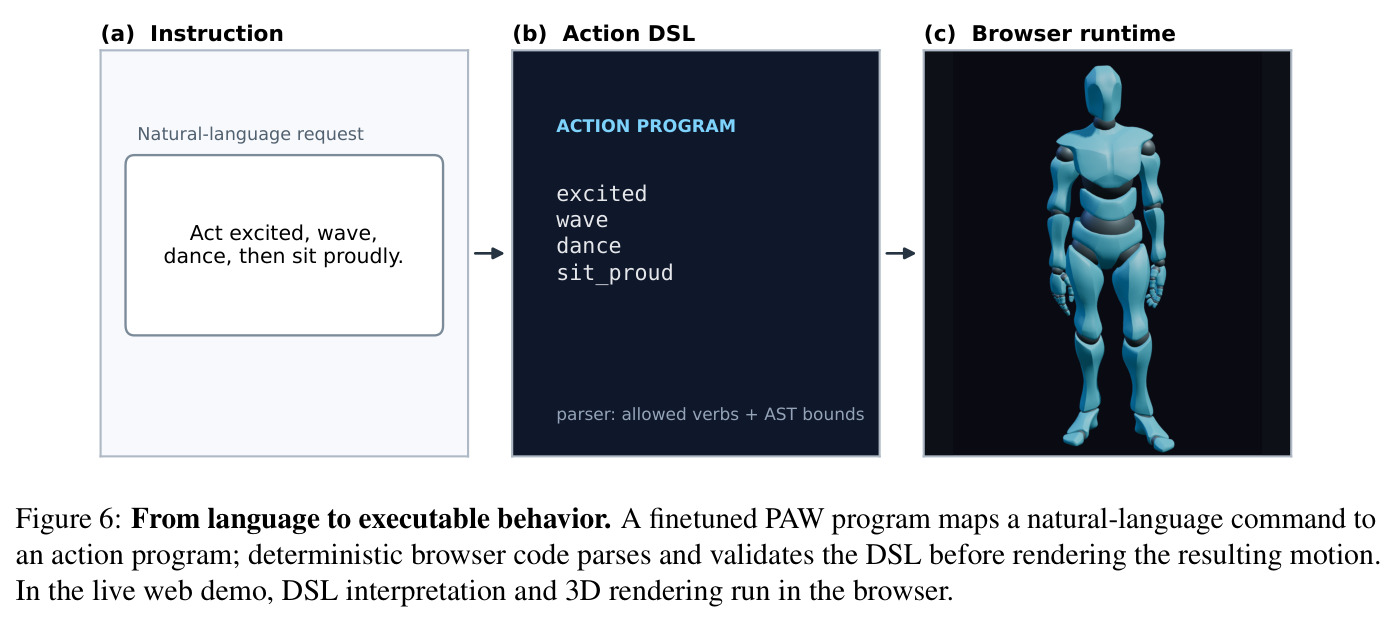
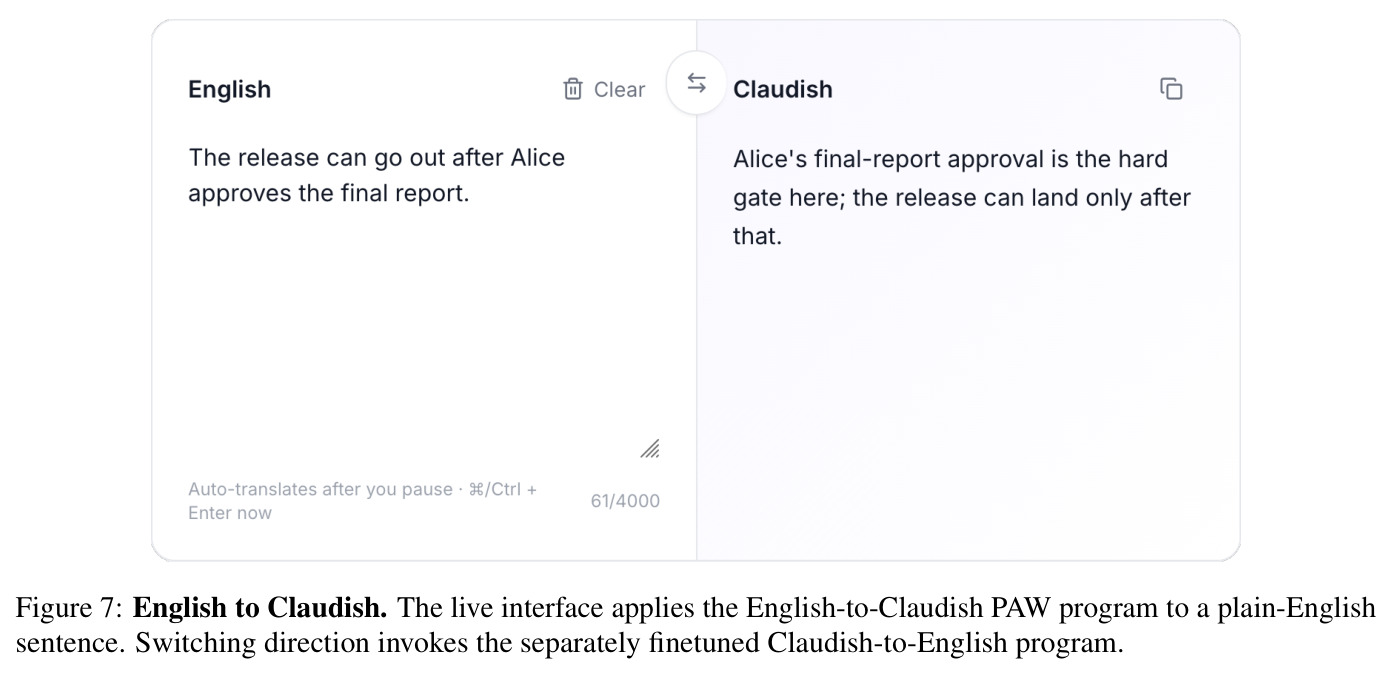
核心结果有四组。第一,正确性:在快编译器无精确匹配的 FuzzyBench-Hard 上,编译即训练把平均 LEM 从 0.224 提到 0.836,绝对提升 +0.612,代价是编译时间从 3.5 秒增至 50.9 秒。第二,消融(Table 1):教师换成 2:1 的 mini/GPT-5.5 混合后 LEM 从 0.746 升至 0.851;数据规模上 1440→2400 对使 LEM 从 0.821 升到 0.836,7200 对达 0.866,收益尚未饱和。第三,延迟与指标可靠性:冷编译在 B300 上 50.9 秒、H200 上 68.2 秒、RTX 上 99.2 秒;4 个并发作业平均排队仅 1.01 秒;GPT-5.5 裁判对 128 条人工标注达 0.977 准确率、$\kappa=0.946$。第四,真实部署:paw-helper 以 30 个程序(28 个在线路由)服务 4 个网站;Avatar Director 在 44 条手写指令中 43 次生成预期动作结构;英-克劳迪什翻译上线 12 天完成 100,747 次请求。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| FuzzyBench-Hard 语义正确性 | LEM(LLM Exact Match,GPT-5.5 裁判) | 0.836(编译约 50.9 秒) | 0.224(PAW 摊销快速编译器,3.5 秒) | +0.612 绝对提升 |
| 教师混合消融(开发规范) | 平均 LEM | 0.851(2:1 mini/GPT-5.5,2400+1200 条) | 0.746(仅 mini,3600 条) | +0.105 |
| 数据规模消融(开发规范) | 平均 LEM | 0.866(7200 唯一样本对) | 0.821(1440 唯一样本对) | +0.045(2400 对时已到 0.836,3600 对持平) |
| Avatar Director 动作生成 | 预期动作结构命中率 | 43 / 44 条手写指令 | 无(系统演示,无对照) | 定性验证可执行行为生成 |
| LEM 裁判元评估 | 人工标注一致准确率 / Cohen's κ | 0.977 / 0.946(GPT-5.5) | 0.938 / 0.858(GPT-5.4-mini 备选裁判) | 确立主裁判可信度 |
局限与改进
作者承认的局限:合成监督可能继承教师错误,需要保证正确性的应用应当校验输出或保留确定性控制路径;应用证据集中在组合与结构化执行,尚无系统性用户研究。我自己的观察:其一,所有主指标由 LLM 裁判(GPT-5.5)给出,尽管 $\kappa=0.946$,仍存在与裁判模型自身偏置相关的循环性风险;其二,FuzzyBench-Hard 特意选取快编译器精确匹配为零的子集,对比虽诚实但天然放大增益,且缺少与 Prompt2Model、LoRA Land 等外部基线的对照;其三,解释器固定为 0.6B,复杂推理任务的精度上限不明,7200 样本对时 LEM 仍在上升暗示明显的数据饥渴;其四,编译需要 B300/H200 级 GPU,个人开发者的本地编译成本在叙述中被弱化。
独立分析的弱点
独立分析的弱点:第一,教师是闭源 API(GPT-5.4-mini/GPT-5.5),合成数据无法完全复现且引入供应商锁定,改进方向是用开源教师或把合成器本身蒸馏到本地小模型。第二,LEM 依赖 LLM 裁判,其格式宽容规则(容器灵活性、大小写、引号包裹)存在被输出'钻空子'的边界情形,改进方向是对可程序化验证的任务默认使用确定性检查器、裁判只作兜底。第三,每个函数一个 rank-64 LoRA 挂在同一 0.6B 解释器上,函数数量增大后存储与加载开销线性增长,改进方向是适配器合并、共享低秩子空间或按需换入。第四,缺乏失败模式分类与置信度估计,编译出的函数面对分布外输入可能自信地出错,改进方向是弃权阈值、多次采样一致性校验或共形预测式输出验证。第五,论文未报告编译失败率、重试与教师拒绝率等运行统计,服务侧稳健性只能靠旁证推断。
未来方向
作者明确提出的方向:开展系统性用户研究;为高保证场景设计确定性控制路径与输出校验。基于成果可延伸的:其一,规范驱动的自动回归测试——编译时同步生成测试套件并纳入 CI,把神经函数真正纳入软件工程流程;其二,跨规范的知识共享,相似规范复用教师输出甚至适配器片段,进一步压低编译成本(数据缩放曲线未饱和说明数据效率仍有空间);其三,为神经函数设计类型系统与组合代数,支持程序树(分类-回答-选择-校验)的静态检查与失败传播分析;其四,系统刻画教师质量、样本数与 LEM 之间的缩放律;其五,安全研究:教师合成数据可能被注入后门,运行时输入可能携带提示注入,需要端到端审计工具;其六,把'编译即训练'推广到多模态与工具调用型规范。
复现评估
复现条件较好但非完全开源。可复用资源:公开交互服务(programasweights.com 的 playground、avatar、claudish 演示)、paw-helper 与 claudish 的 GitHub 仓库(含规范与代码)、附录 Table 2 的完整配方(量化 Qwen3-0.6B、2:1 教师配比、6400 条训练样本、batch 48、100 步、rank-64/alpha-16、余弦调度)、附录 D 的教师合成提示词与附录 E 的 LEM 裁判提示词全文。门槛所在:教师是闭源 API,2400+1200 条样本的调用费用需自行承担;训练在 B300 上 50.9 秒、H200 上 68.2 秒,RTX 也可行但要 99.2 秒以上;论文未显式放出训练框架代码与编译好的检查点;FuzzyBench-Hard 子集的定义依赖 PAW 原论文。总体难度中等:合成数据加 LoRA 微调是标准流程,真正的工程量在重叠调度、作业队列与缓存等服务编排上。
论文图表
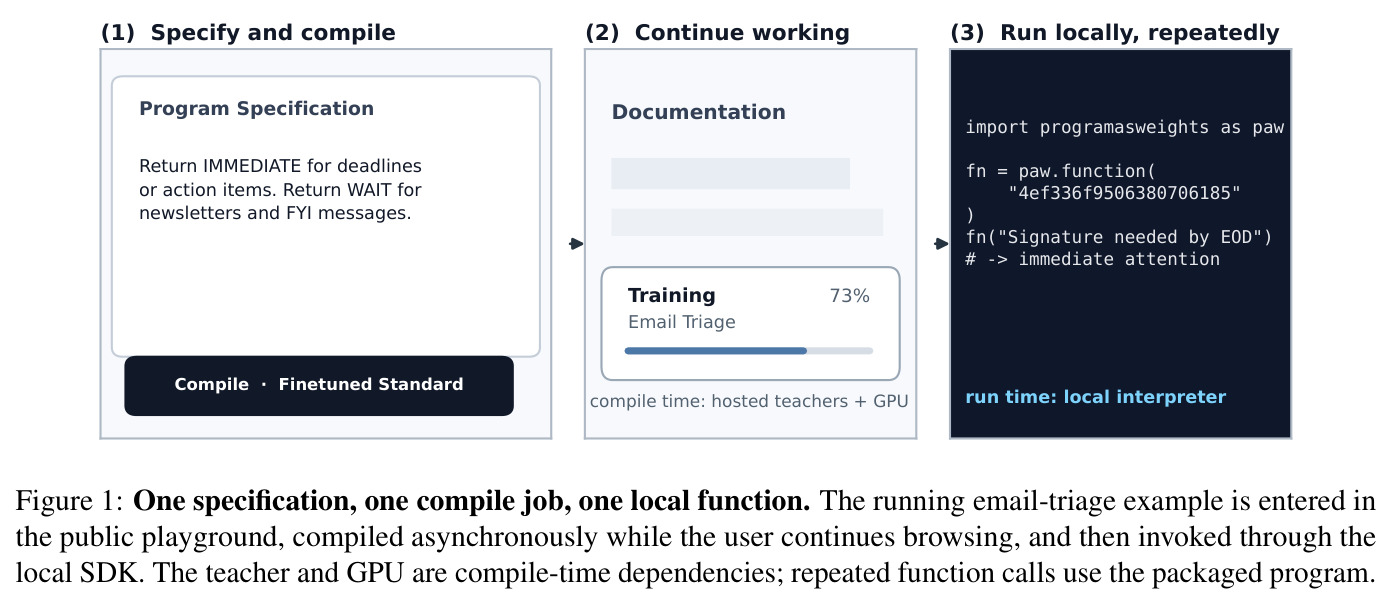
以邮件分诊为例展示三步工作流:用户在公共 playground 输入规范('Return IMMEDIATE for deadlines or action items. Return WAIT for newsletters and FYI messages.'),编译异步进行时用户可继续浏览(界面显示 73% 训练进度与 Finetuned Standard 配置),完成后通过本地 SDK(import programasweights as paw)加载程序并对 'Signature needed by EOD' 输出 immediate attention;标注了编译期依赖托管教师与 GPU,运行期只在本地解释器上执行。
这张图定义了整个系统的用户体验与成本模型:教师和 GPU 是编译期依赖、重复调用零外部交互,是理解论文动机、产品形态与'构建-运行'分离思想的最佳入口。