LLaDA-Image:用全开源训练配方构建强图像生成器 LLaDA-Image: Building Strong Image Generators with Fully Open Training Recipes
98%真实数据从头训练6B扩散Transformer,登顶开源SOTA并蒸馏至2-4步推理
前置知识
扩散语言模型(dLLM)与 LLaDA 2.0
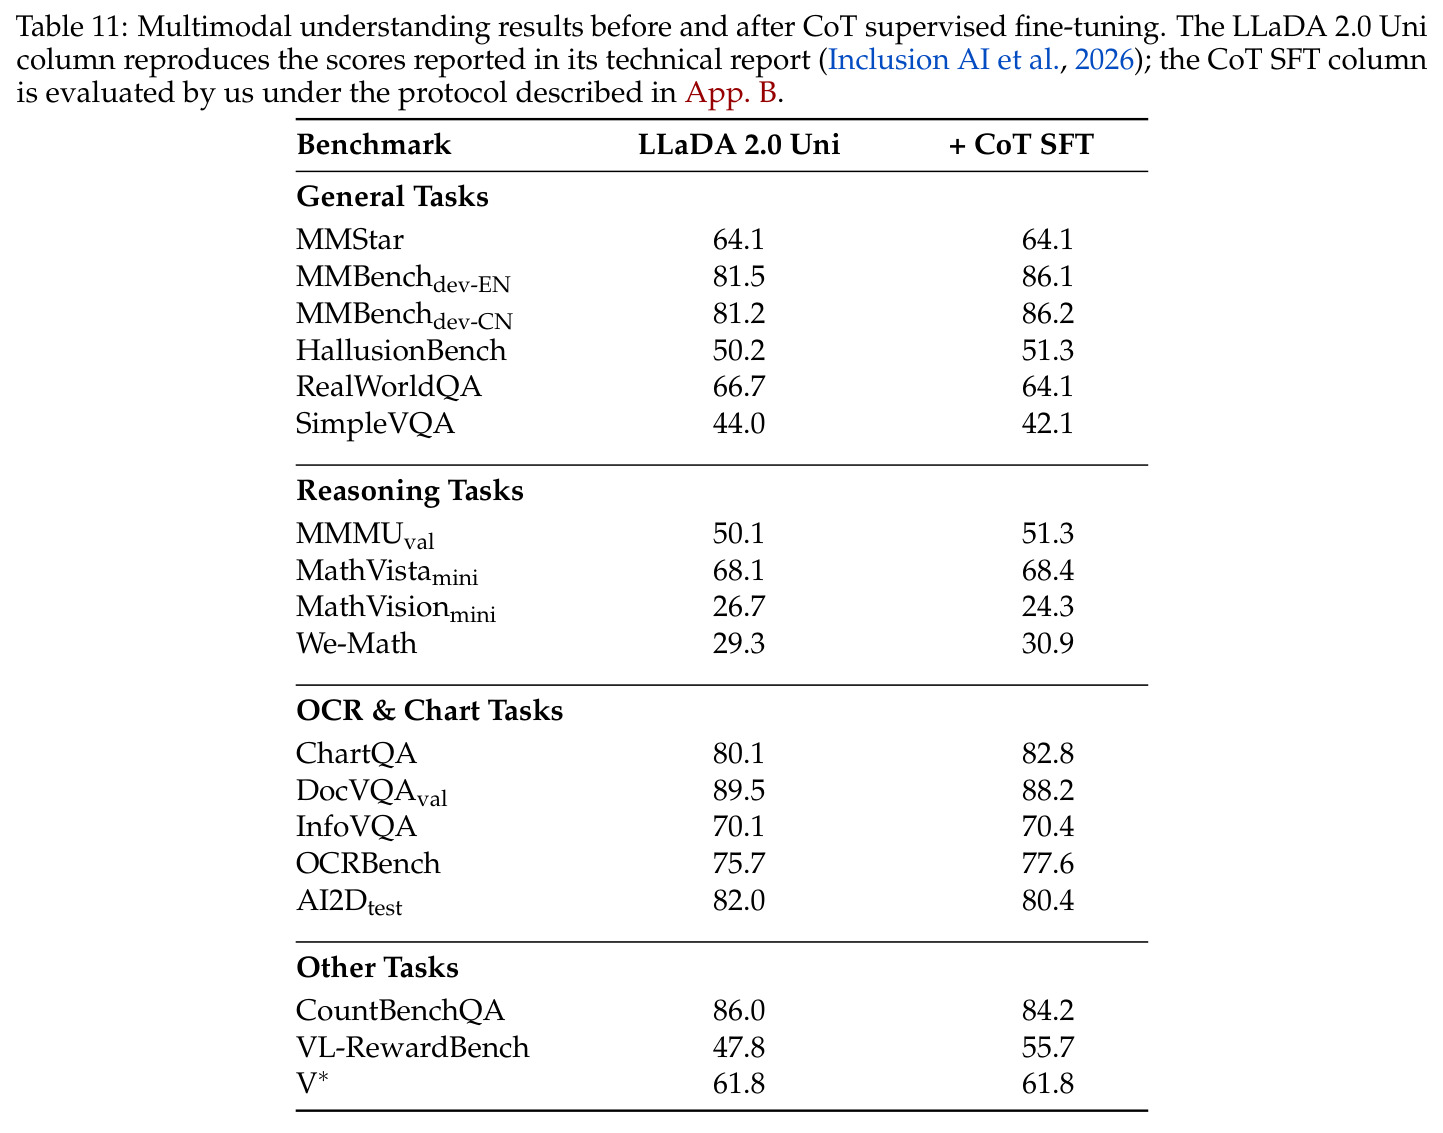
dLLM 是用离散扩散(掩码预测)方式做文本生成的语言模型,不同于自回归模型的逐 token 生成,它以块扩散(block diffusion)形式并行预测被掩码的 token。LLaDA 2.0 Mini 是 Inclusion AI 发布的 dLLM 骨干,配 SigLIP-VQ 视觉编码器可构成视觉语言模型(VLM),具备多模态理解与思维链推理能力。
本文的文本条件编码器不是普通 T5/CLIP 文本编码器,而是这个冻结的 dLLM-VLM。理解它的输入接口(prefill 隐状态)和为何要靠 RQA 从中『引出』生成相关信息,是读懂架构设计的前提。
流匹配(Flow Matching)
一种连续扩散生成范式:在噪声 $z \sim \mathcal{N}(0,I)$ 和数据 $x$ 之间构造线性插值 $x_t = (1-t)x + tz$,训练网络 $F_\theta$ 预测恒定速度场 $v = z - x$,推理时沿预测速度从纯噪声积分到数据。相比 DDPM 的随机微分方程,路径更直、采样更少步。
LLaDA-Image 的 DiT 就是流匹配模型,训练目标是 $\mathcal{L} = \mathbb{E}\|F_\theta(x_t, t, h_{cond}) - (z-x)\|_2^2$;后期的时间步采样策略(logit-normal)和 TwinFlow 蒸馏公式都建立在这套约定上。
分布匹配蒸馏(DMD2)
少步蒸馏方法:让学生生成器一步从噪声映射到样本,用最小化学生分布与目标分布之间的反向 KL 来训练。需要一个冻结的『真实分数』模型和一个在线追踪学生分布的『伪造分数』模型,两者交替更新,伪造分数用更快的时间尺度追踪非平稳分布。
本文的 LLaDA-Image Turbo 用 TwinFlow 蒸馏,TwinFlow 是 DMD2 的改进版——用正负时间符号让一个共享 DiT 主干同时扮演生成器和伪造分数两个角色。理解 DMD2 的双模型结构才能体会 TwinFlow 省掉了什么。
VAE 潜空间与 SigLIP-VQ 特征
VAE 把图像压缩到低维潜空间,扩散模型在潜空间训练可大幅省算力(本文用 FLUX.2 VAE)。SigLIP-VQ 则是视觉-语言对齐的语义编码器,输出离散化的 patch token,捕捉高级语义而非像素细节。两者一个管像素保真、一个管语义理解。
本文编辑能力的双通路设计正建立在这两者的分工上:SigLIP-VQ 提供参考图语义、VAE 干净潜变量提供像素级证据,这是理解『如何在不改架构的情况下保住未编辑区域』的关键。
Muon 优化器与无参数 RMSNorm
Muon 是近年兴起的面向隐层矩阵参数的优化器,对更新量做正交化,在大规模训练中比 AdamW 收敛更稳更快。RMSNorm 通常含可学习的缩放参数,无参数版本仅做均方根归一化($\text{RMSNorm}(x)=x/\text{mean}(x^2) \cdot g$,去掉可学习 $g$ 的版本),减少参数间的耦合扰动。
论文把『全 DiT 用无参数 RMSNorm + Muon 优化器』列为两条 Recipe,声称是长周期从零训练稳定性的关键。想复现这类大规模训练时,这类工程细节往往比算法创新更致命。
研究动机
主流文生图系统的训练范式(从 Stable Diffusion 到 SD3 一脉)从第一天起就把『视觉先验学习』和『语言对齐』耦合在一起,最烧算力的预训练阶段必须依赖海量图文对。这带来三个具体麻烦:其一,caption 昂贵且有损——在 256² 这类低训练分辨率下,caption 描述的细节经下采样后可能根本不在图里,条件与目标天然错配;其二,为加速收敛大量掺入合成图文对,会传播合成数据的伪影并压低模型长期真实感的天花板;其三,闭源系统(GPT-Image 2、Nano-Banana 2.0、Seedream 5.0 等)能力虽强,但数据构成、模型结构和训练配方完全不透明,开源社区只能猜。同时,统一模型还面临两个结构性难题:如何把多模态理解接入生成而不破坏预训练好的理解能力,以及如何在指令编辑时保留参考图中不应改动的内容——多数开源系统(Qwen-Image、Z-Image、LongCat-Image)为此干脆发布两个独立模型分支。最后部署端还要求把几十步的长扩散轨迹压缩到几步而不掉质量。
本文的目标是本文的目标是回答一个非常实际的系统问题:用一份完全公开的配方,能否从零训练出一个能力扎实的图像生成器?具体拆成五个可交付目标:(1) 在最耗算力的早期阶段摆脱大规模图文对依赖,仅用真实图像就学出强视觉生成先验;(2) 单一 checkpoint 同时支持文生图与指令引导编辑,不需要任务专用分支,且编辑时不损失文生图能力;(3) 全流程训练稳定可复现,不靠运气;(4) 通过少步蒸馏得到 2-4 步即可推理的 Turbo 版本;(5) 把权重、训练代码、数据构建配方全部开源,让每个阶段的设计权衡可被检查、配方可被复用。最终量化目标是在 Qwen-Image-Bench 英中双赛道上成为开源最强。
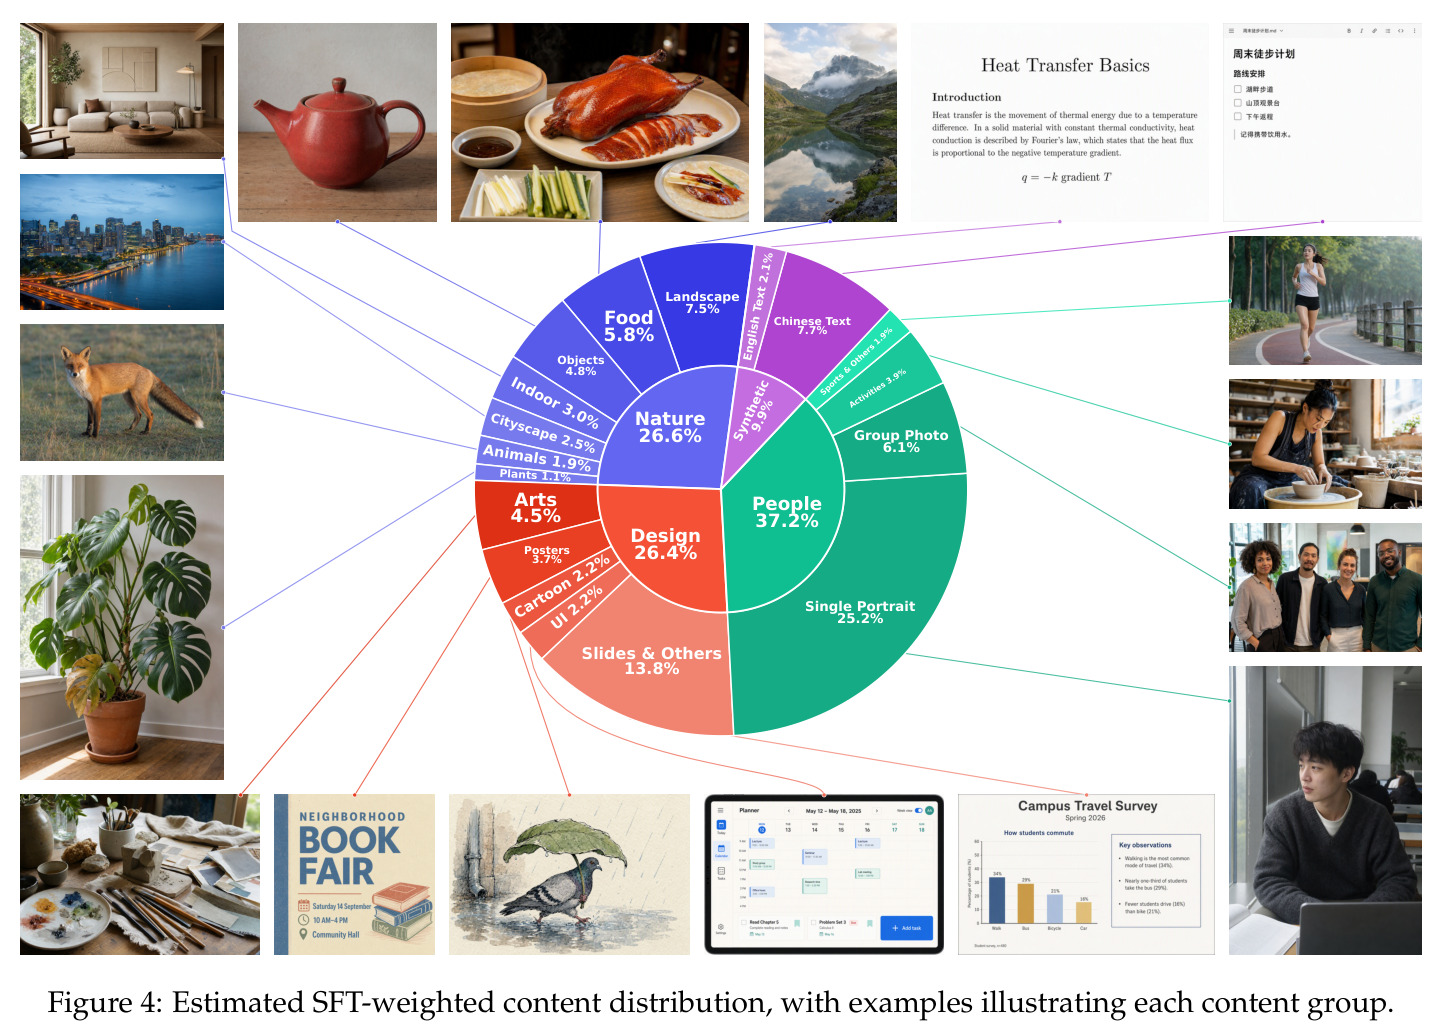
与已有工作不同的是,本文的独特切入是一套环环相扣的『解耦 + 主干复用』组合拳。数据侧:沿 IOMM 思路把视觉先验学习与语言对齐彻底解耦——冻结的 dLLM-VLM 直接从『待生成的这张图本身』提取语义作为条件(masked self-conditioning),使 220M 样本中 90% 以上无需任何 caption,且 98% 为真实图像,敢于押注『真实数据早期收敛慢但天花板更高』。架构侧:编辑用的参考图完全绕过 VLM,经 SigLIP-VQ 与 FLUX.2 VAE 干净潜变量两条支路直通 DiT,理解模块保持纯净。优化侧:全 DiT 无参数 RMSNorm 配 Muon 优化器保稳定。蒸馏侧:TwinFlow 用时间符号(正负 $t$)在单个 DiT 主干上同时扮演生成器与伪造分数两个角色,取消 DMD2 的独立伪造分数网络。这些选择单独看都有先例,但拼成一条从图像自条件到双头蒸馏的完整开源路径是本文独有的。
核心方法
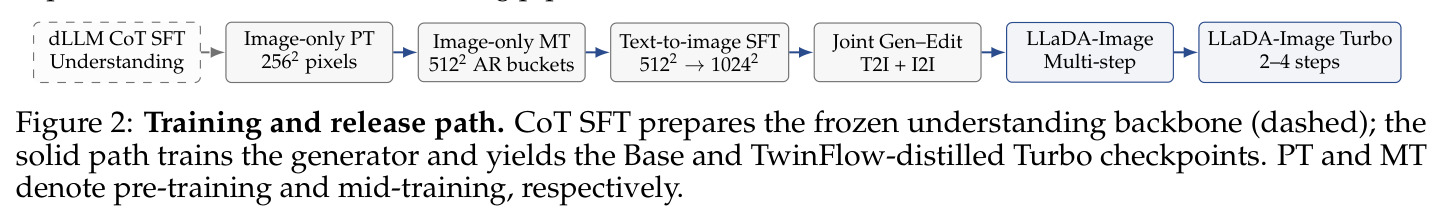
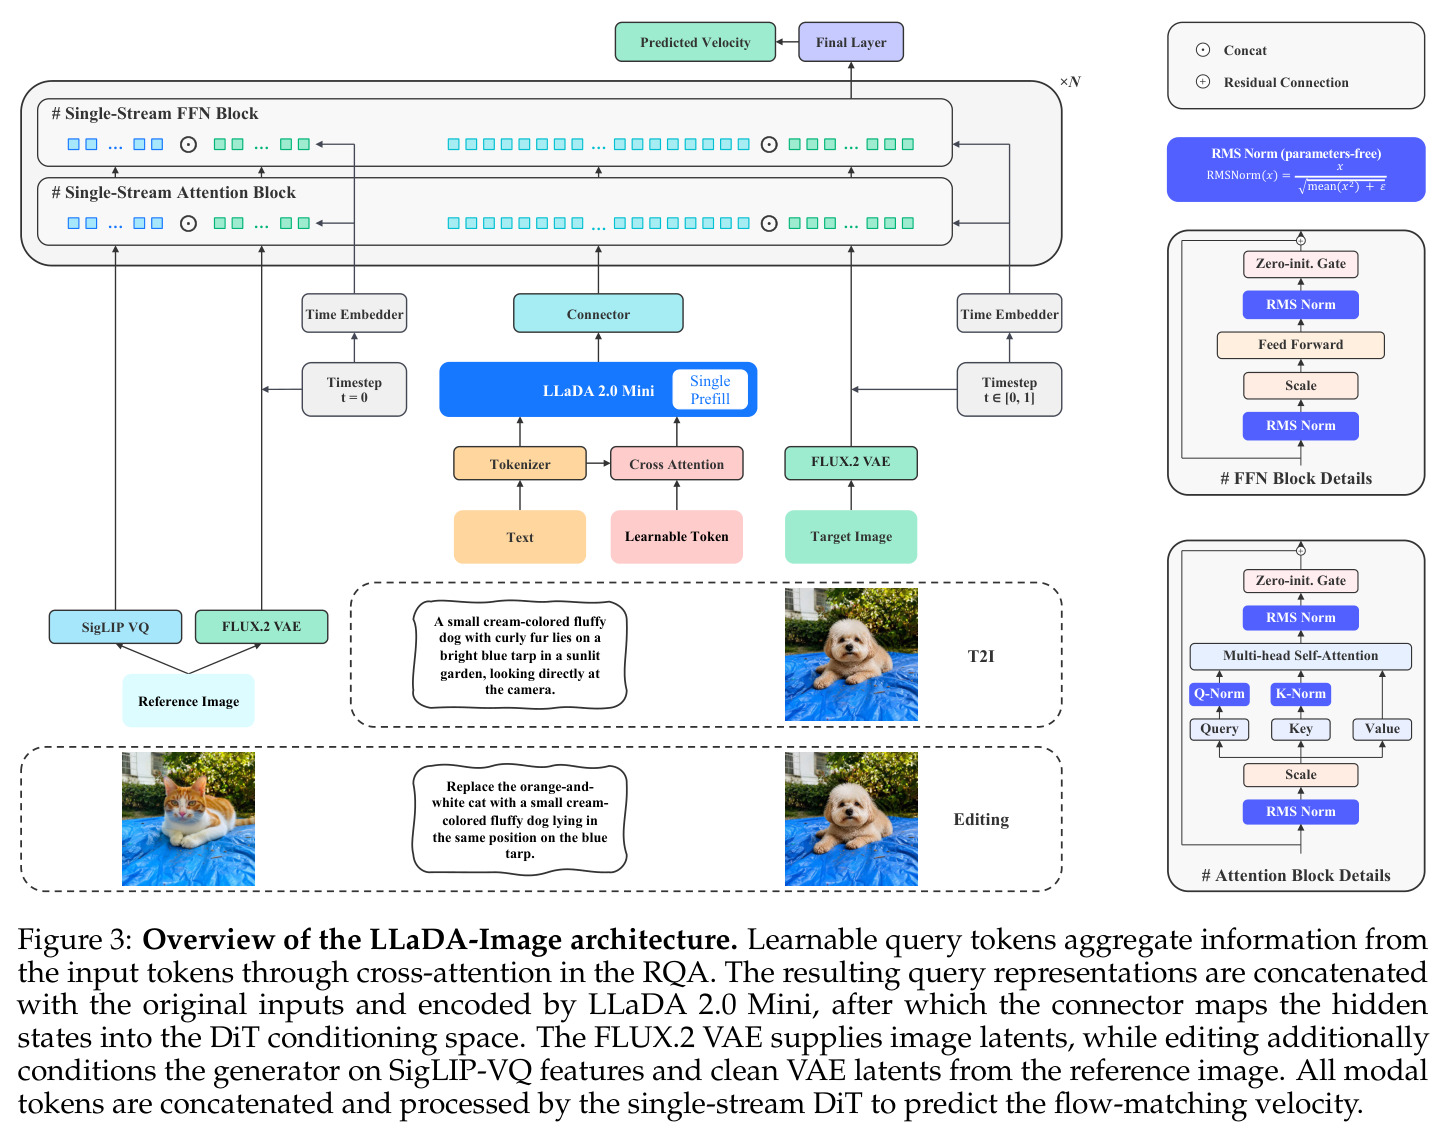
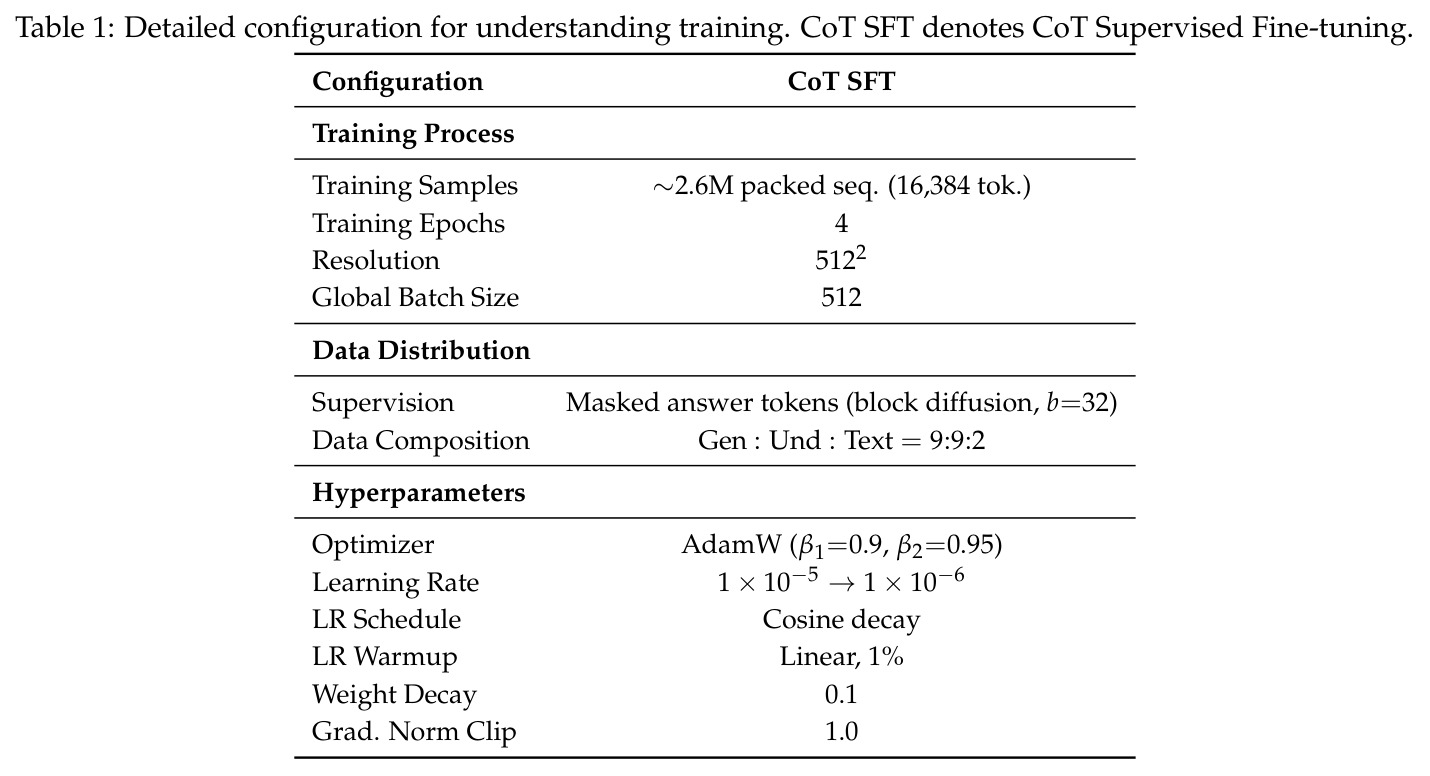
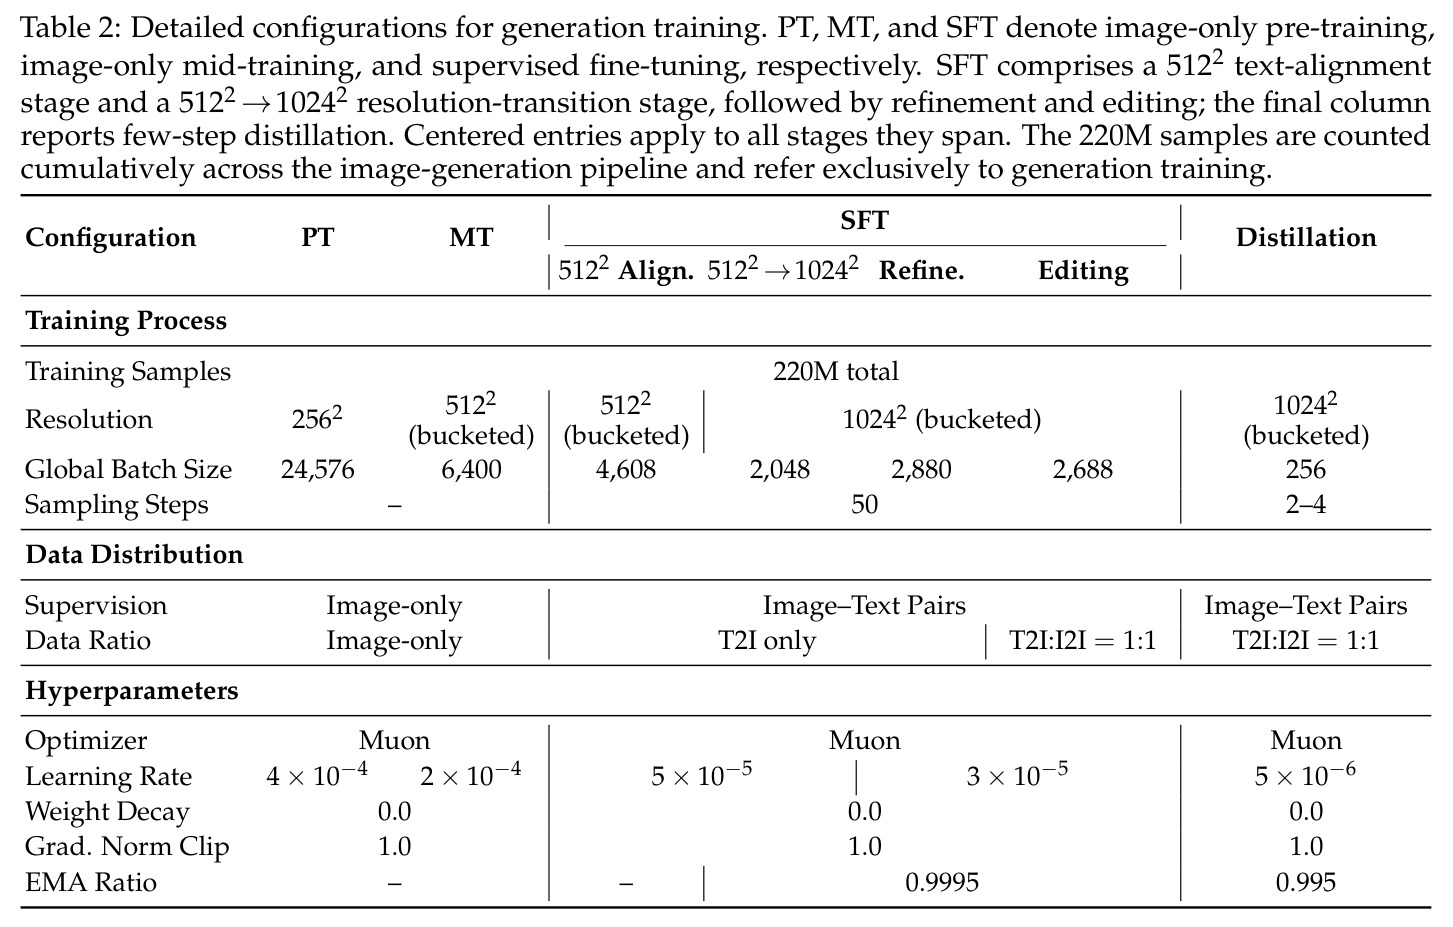
直觉上,这套系统想回答『图像里本来就有的语义,为什么还要花大价钱让人重新写成 caption?』。整体架构分三段:一个冻结的 dLLM 视觉语言模型(LLaDA 2.0 Mini 骨干 + SigLIP-VQ 编码器)负责多模态理解;一个轻量接口(残差查询适配器 RQA + 浅层 Transformer 连接器)把 VLM 的 prefill 隐状态 $h_{vlm}$ 投影到 DiT 条件空间得到 $h_{cond}$;一个 6B 参数的单流扩散 Transformer 在共享序列上对图像 token 和条件 token 做联合自注意力,用流匹配目标 $\mathcal{L}_{FM}(\theta,\phi,\psi) = \mathbb{E}_{y,x,z,t,m}\|F_\theta(x_t, t, h_{cond}) - (z-x)\|_2^2$ 预测速度场。训练是一条渐进式流水线:先对理解骨干做 CoT 监督微调(约 260 万条 16,384 token 的打包序列、4 个 epoch),然后 256² 图像-only 预训练、512² 图像-only 中期训练(引入宽高比分桶)、512² 图文对齐 SFT、512²→1024² 升分辨率、文本密集与人像数据精修、文生图与编辑 1:1 混合联合训练,最后对收敛的多个检查点做权重合并,并用 TwinFlow 蒸馏出 2-4 步的 Turbo。全程 220M 样本、98% 真实图、图像-only 占 90% 以上。
核心创新是图像自条件(image-only self-conditioning):预训练时不再需要外部 caption,而是让冻结 VLM 看『这张训练图自己』。具体做法是把图像经 SigLIP-VQ 编成 patch 特征 $c_{img} = v(y) \in \mathbb{R}^{N \times D}$,配一条固定辅助提示(如『生成与参考图相同的图像』),再以保留概率 $1-\rho_{img}$ 随机掩掉部分 token:$\tilde{c}_{img} = c_{img} \odot m$,$c = \text{concat}(c_{aux}, \tilde{c}_{img})$。这把稠密重建改造成稀疏到稠密的预测任务——DiT 必须从可见 patch 恢复缺失内容,从而学到上下文与组合性视觉结构,而非恒等映射。与已有方法的本质区别有三点:第一,SD/SD3 范式在最贵阶段绑死图文对,本文证明 90% 以上无文本数据即可;第二,低分辨率训练时 caption 描述整图而细节已丢失,自条件天然保证『条件看到的就是 DiT 要画的』,高分辨率图可只轻微下采样后取信息量大的局部 crop;第三,编辑参考图绕过 VLM,理解模块无需为像素级保真妥协。TwinFlow 则以符号化时间($+t$ 训生成器、$-t$ 训伪造分数)让一个主干兼任 DMD2 中两个网络,配双输出头(DuMo 风格)使辅助分支在推理时零开销。
方法步骤详情
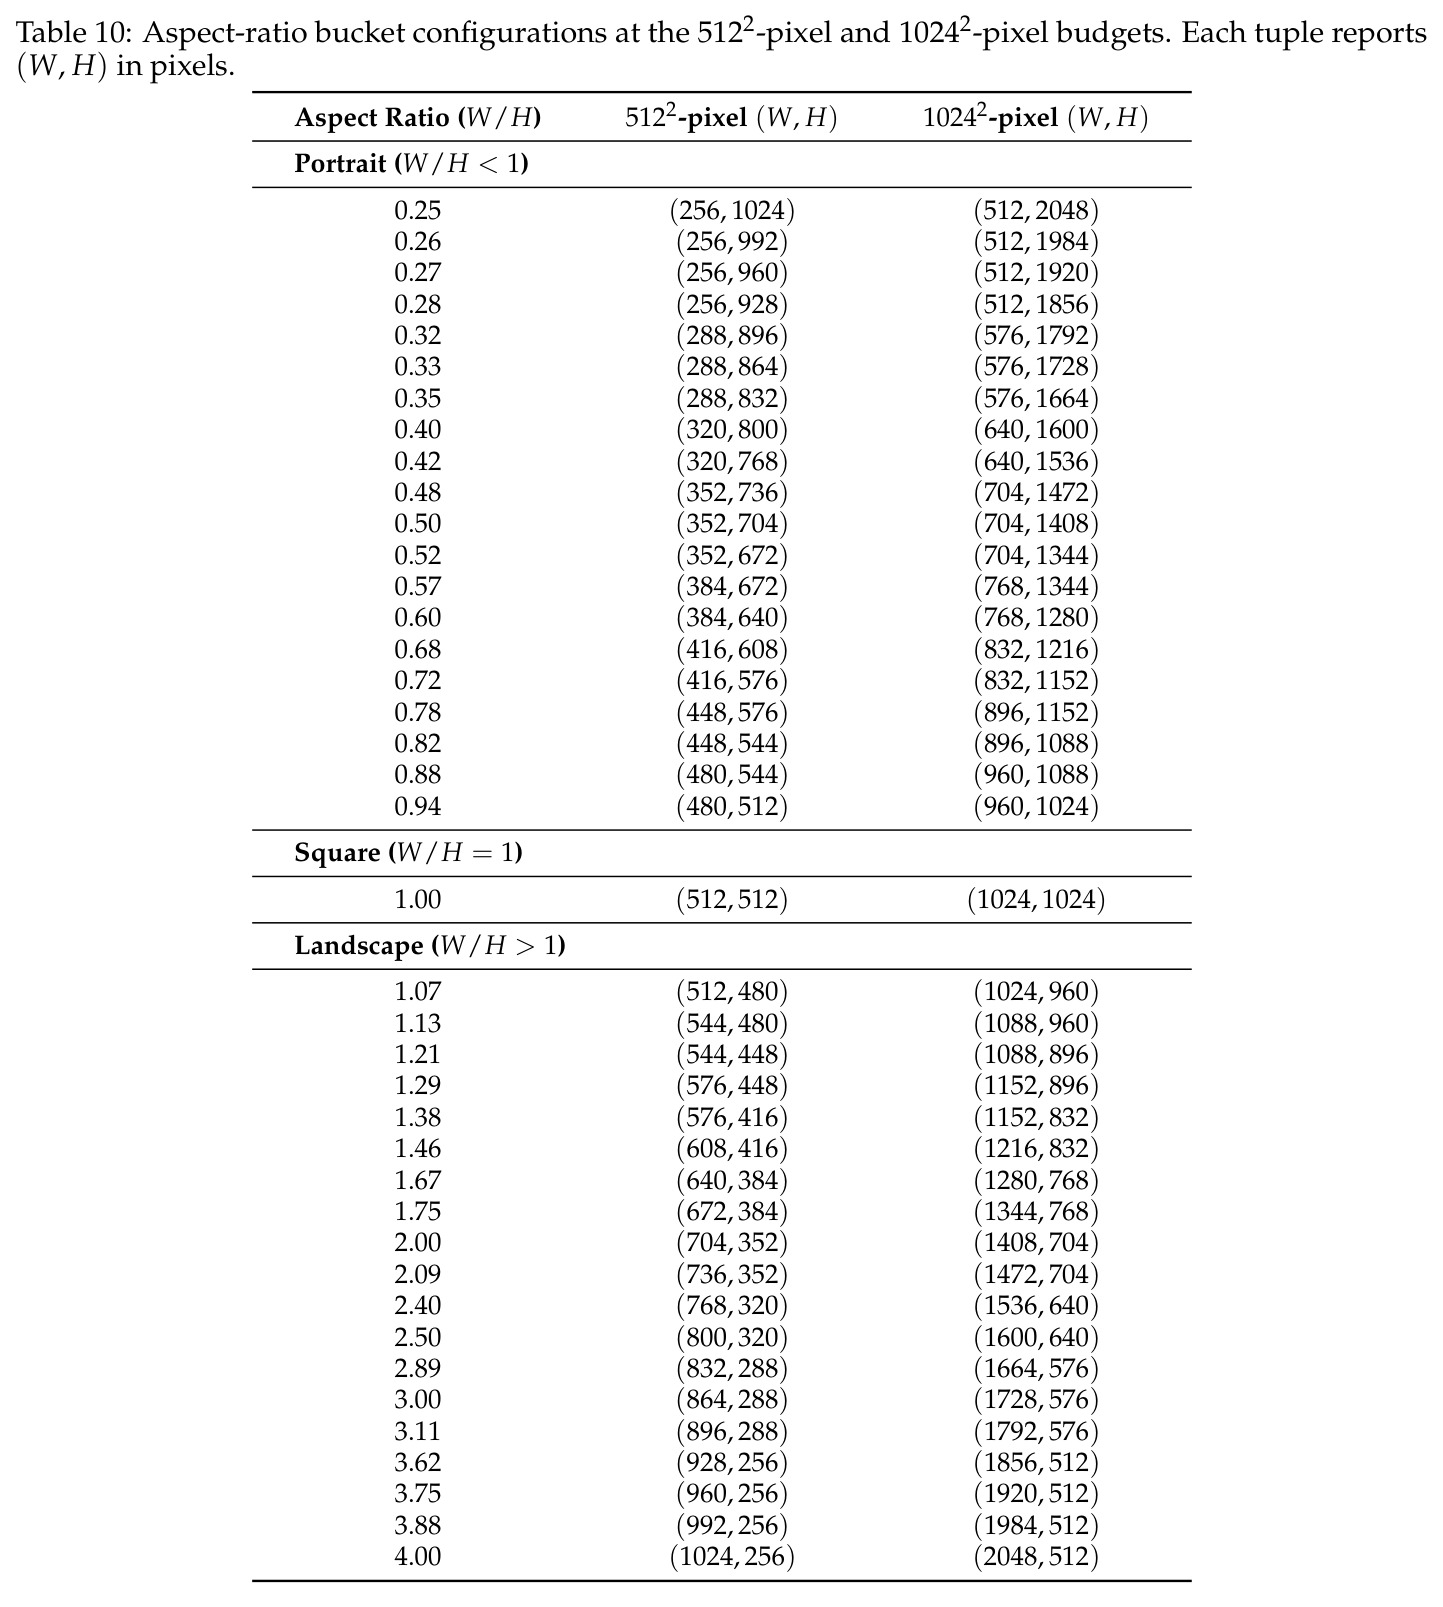
第一步 CoT SFT(理解侧,生成侧不动):语料离线 tokenize 后贪心装箱到 16,384 token 序列,图像以 512² 变宽高比 crop 做 VQ 编码,块对角注意力掩码防止跨样本泄漏;生成、理解、纯文本数据按 9:9:2 混合;块扩散块大小 $b=32$,掩码率 $\rho = \cos(r\pi/2)$,$r \sim U(0,1)$,每批次在掩码与其补集下各走一步,损失按块内监督 token 数归一化;AdamW 学习率 $1\times10^{-5}$ 余弦衰减到 $1\times10^{-6}$。第二步图像-only 预训练:256²,随机方形 crop 仅轻微下采样,VLM 从 crop 自身提条件,全局批大小 24,576,Muon 学习率 $4\times10^{-4}$,只更新 DiT、RQA 和连接器。第三步图像-only 中期训练:同一套公式升到 512² 像素预算,引入宽高比分桶(把图分到宽高比最近的桶、保比缩放、裁掉少量溢出),批 6,400,学习率 $2\times10^{-4}$。第四步 SFT 对齐:512² 桶上换图文对监督,批 4,608,学习率 $5\times10^{-5}$,时间步改用 logit-normal 采样 $t = \text{sigmoid}(P_{mean} + P_{std}\,\epsilon)$,$P_{mean}=P_{std}=0.8$,把监督质量压向高噪声区间。第五步升 1024² 桶再训。第六步精修:上调文本密集与人像样本比例,全程真实图占 SFT 70% 以上。第七步联合编辑训练:T2I:I2I = 1:1 能力回放,编辑参考图走 SigLIP-VQ 特征支路(嵌入层+两层 Transformer 得 $h_{ref}$)与干净 VAE 潜变量支路($x^{edit}_t = \text{concat}(x_t, x_{ref})$),学习率降至 $5\times10^{-6}$,EMA 0.9995。第八步对附近收敛检查点做权重合并。第九步 TwinFlow 蒸馏:一步映射 $\hat{x} = z - F_\theta(z, +1, h_{cond})$,伪造分支对加噪样本 $\hat{x}_{-t} = (1-t)\,\text{sg}(\hat{x}) + tz'$ 拟合 $\mathcal{L}_{fake} = \mathbb{E}\|F_\theta(\hat{x}_{-t}, -t, h_{cond}) - (z' - \text{sg}(\hat{x}))\|_2^2$,DMD 损失 $\mathcal{L}_{DMD} = \mathbb{E}[w(t)\langle \text{sg}(s_{fake}-s_{real}), \hat{x}_t\rangle]$,生成器与伪造分支按 1:2 交替(DMD2 为 1:5),四步反向模拟对齐推理轨迹,最后再做 TBSM 强化学习微调。
技术新颖性
技术新颖性体现在四个层面。数据层面:『真实图像 + 图像自条件』的组合把 IOMM 思路推到 6B 规模并全程贯穿(PT、MT 共 90% 以上样本),并用实验性 Recipe 明确主张真实数据『早期慢、终局强』,这是对当前合成数据军备竞赛的正面反命题。架构层面:RQA 在冻结 VLM prefill 前注入可学习查询 token 做 cross-attention、以残差方式追加而非替换输入($h_{vlm} = g(\text{concat}(c, q_\psi(q_0, c)))$),既不动 VLM 权重又能引出对生成最有用的信息;编辑参考图双通路(语义走 DiT 专属分支、像素走 VAE 潜变量拼接)让单一主干无需独立编辑网络即可保真。工程层面:全 DiT 无参数 RMSNorm + Muon 的稳定性配方、宽高比分桶的近似恒定像素预算(避免各数据并行 rank 内存不均)、以及针对『邻近检查点分数震荡』的权重合并,都是可迁移的实操知识。蒸馏层面:TwinFlow 的 signed-time 构造是最实质的算法贡献——用一个共享 DiT 加两个输出头替代 DMD2 的独立伪造分数网络,头选择仅由时间符号决定,推理时丢弃伪造头零开销;1:2 的更新调度相对 DMD2 的 1:5 也减少了对非平稳分布的追踪成本。
实验结果
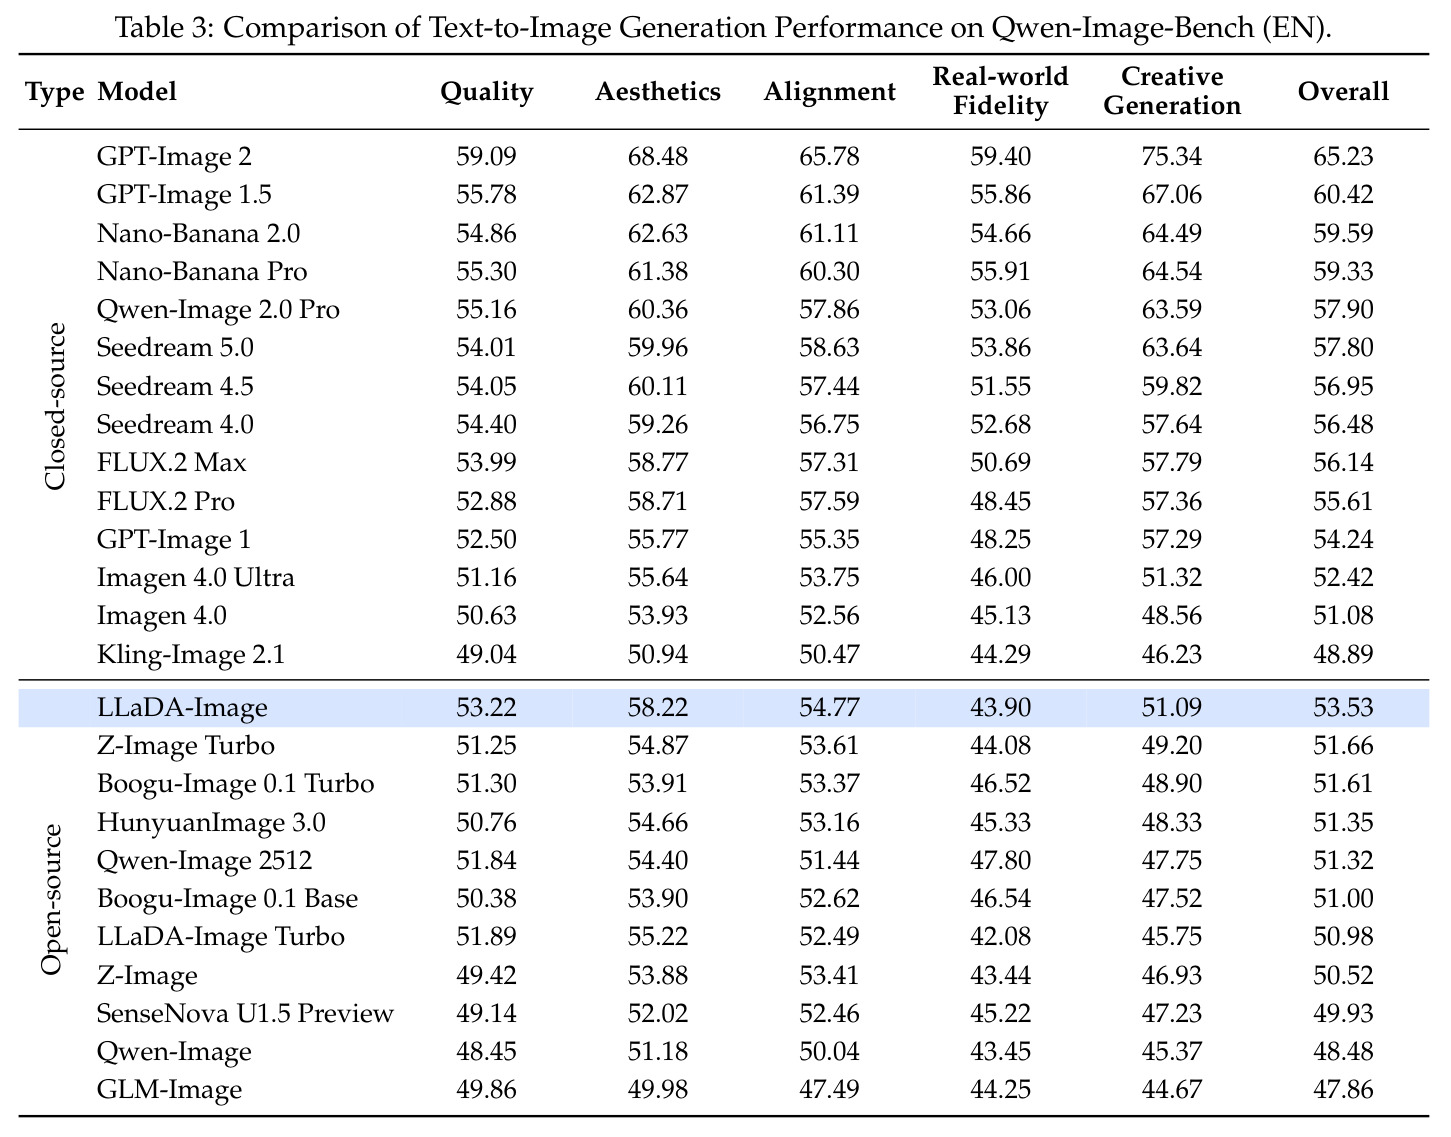
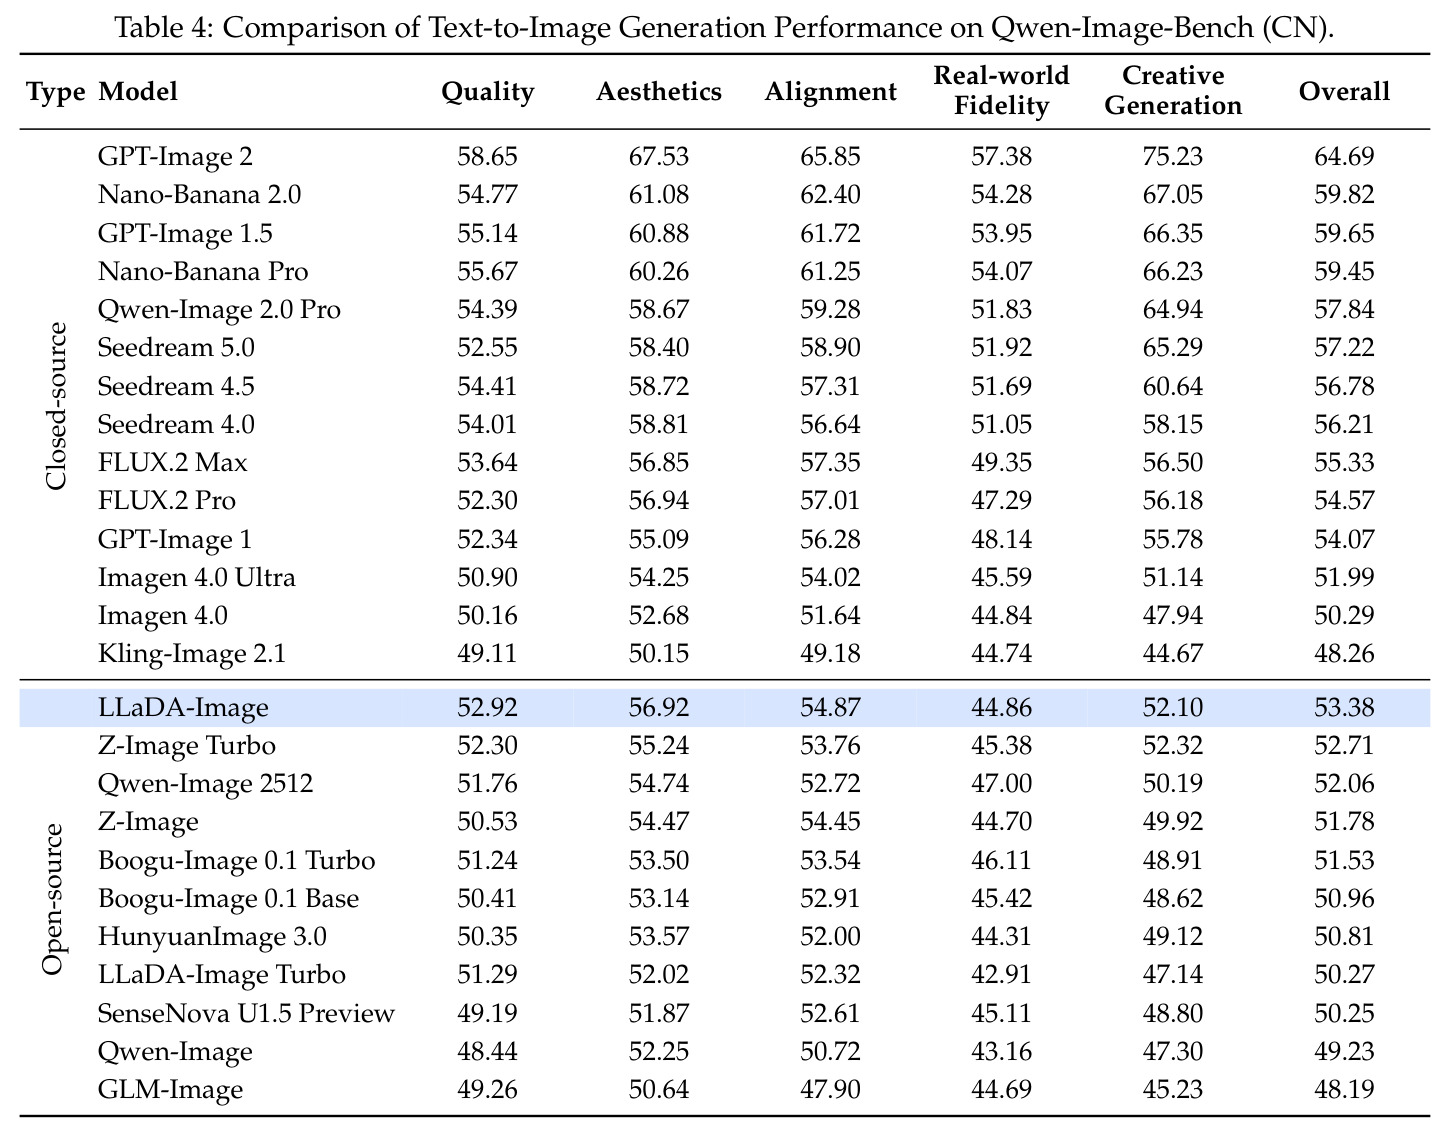
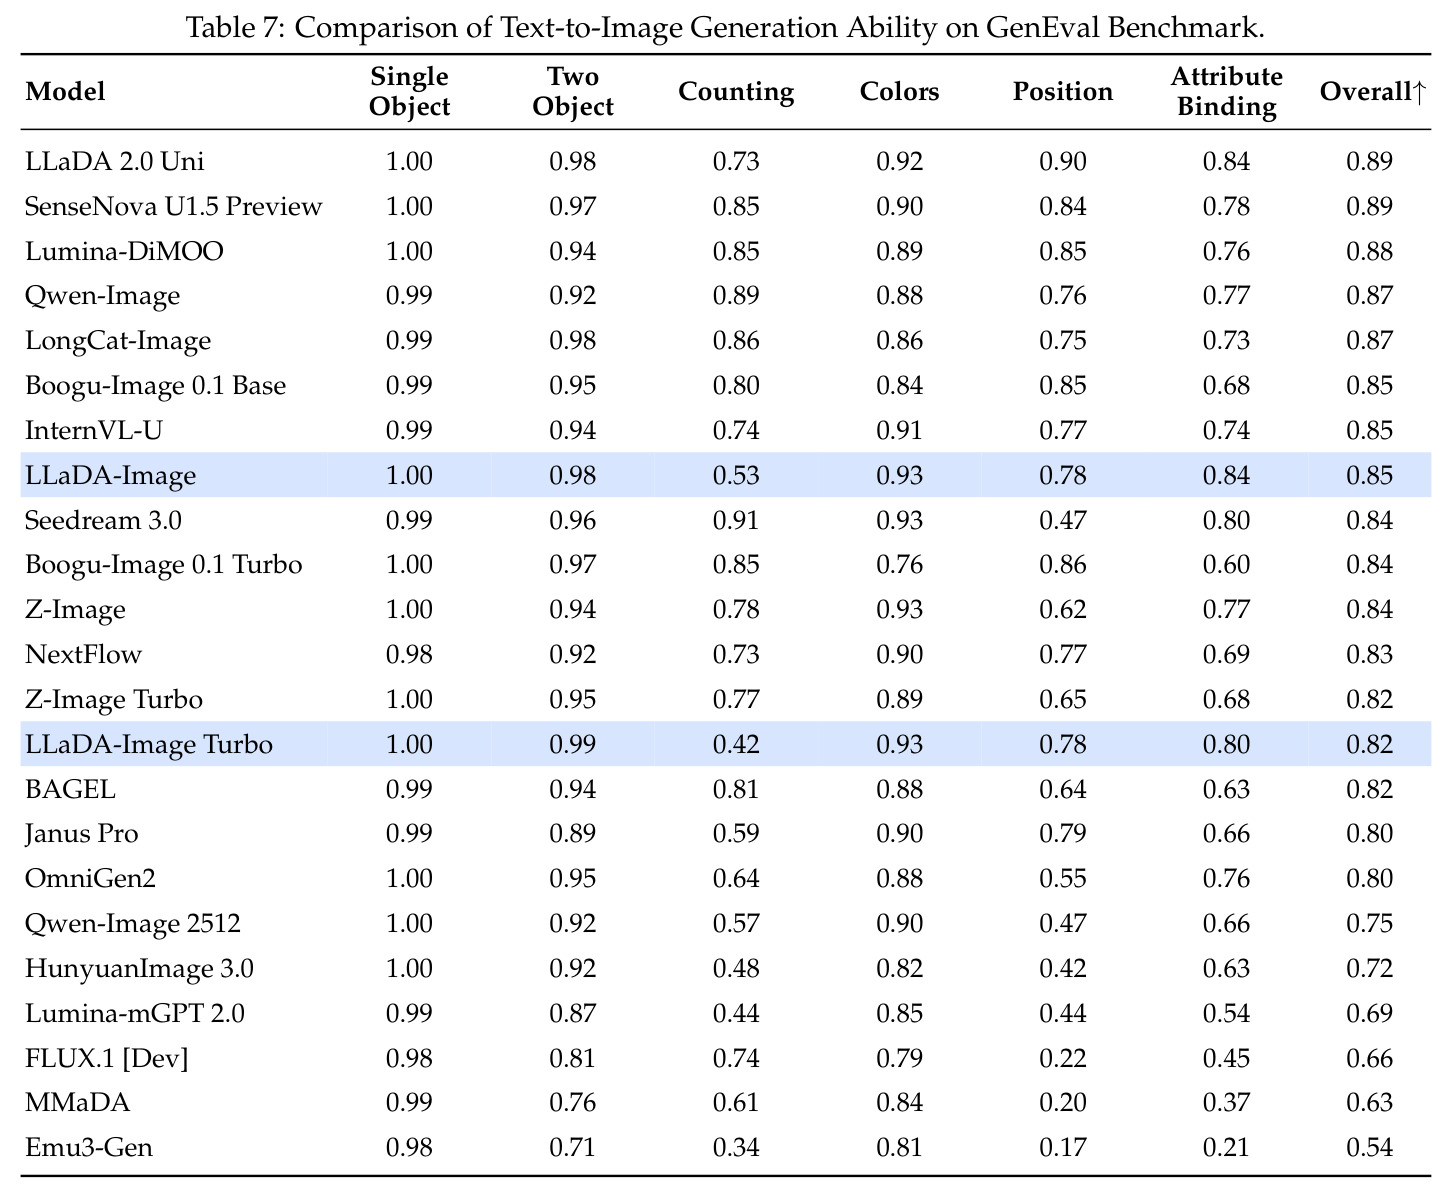
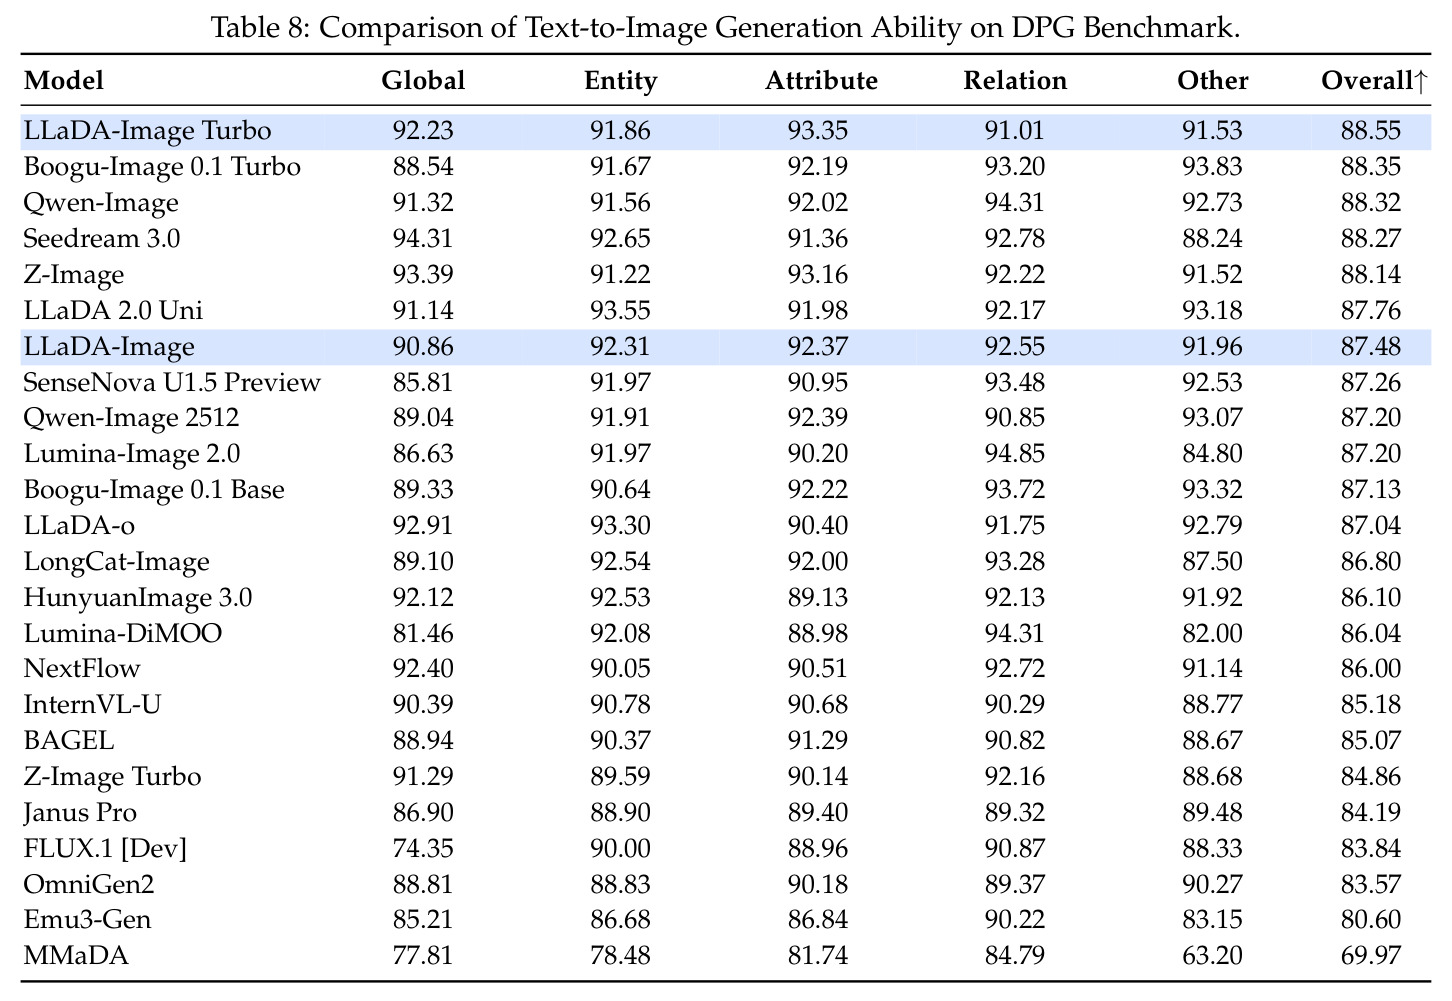
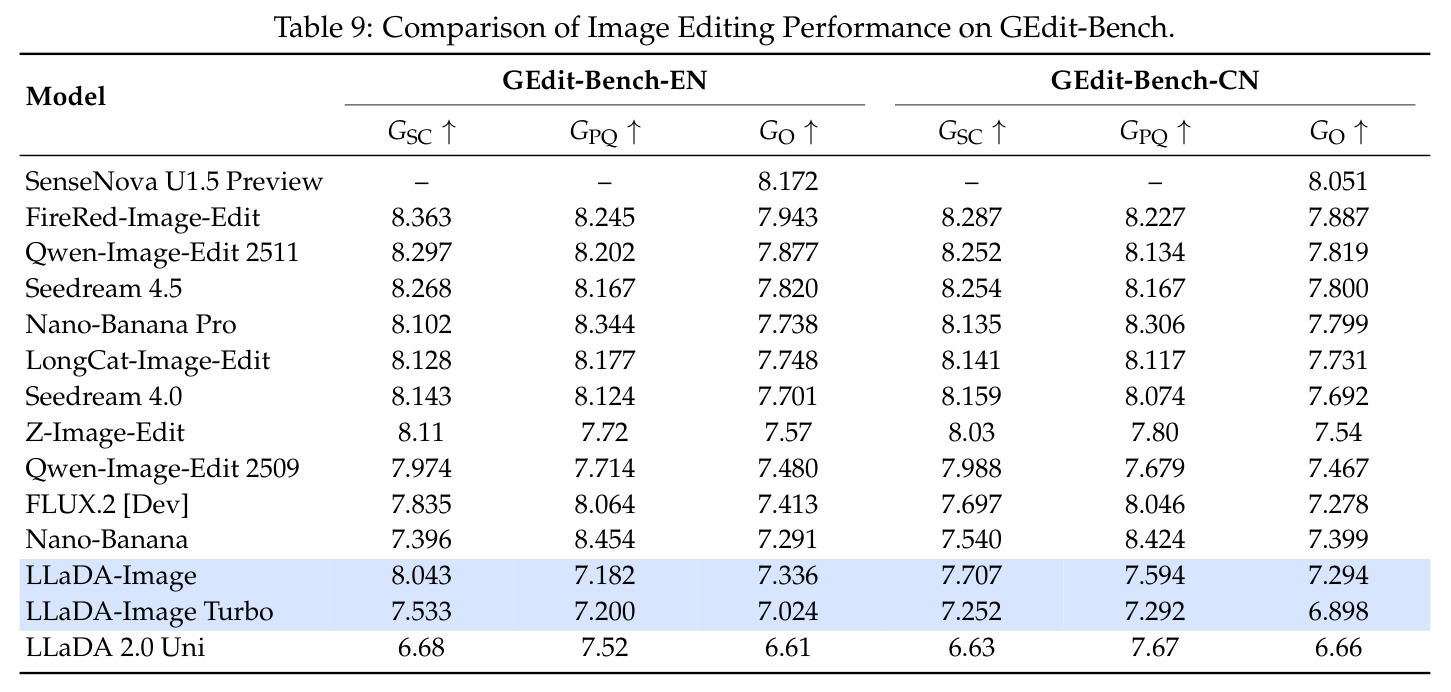
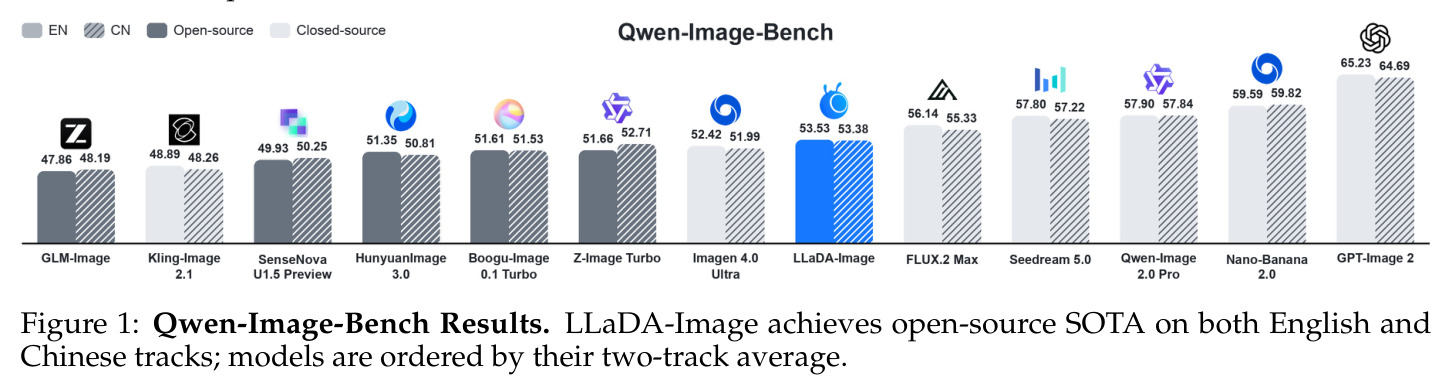
文生图主战场 Qwen-Image-Bench(1000 条分层 prompt、五维度、英中双轨):LLaDA-Image 英文轨总分 53.53、中文轨 53.38,均为开源第一,分别超过次优开源 Z-Image Turbo 1.87 和 0.67 分;且在没有 prompt 增强、没有测试时思维链的标准推理设置下取得。分维度看,它在英中双语的 Quality、Aesthetics、Alignment 三个维度均为开源第一(英文 53.22/58.22/54.77),Creative Generation 英文第一(51.09),但 Real-world Fidelity 是明显短板(英文仅 43.90,在开源组中靠后)。须清醒看到与闭源差距:GPT-Image 2 英文 65.23、中文 64.69,领先约 11 分。长文本渲染 LongText-Bench:英文 0.923、中文 0.913,跨语言差距小体现双语均衡,但落后于专攻文字渲染的 Qwen-Image 2512(0.956/0.965)和 Boogu(0.952/0.969)。复杂视觉文字 CVTG-2K:平均词准确率 0.875 为全场第二(SenseNova 0.887 第一),NED 0.945 与 CLIPScore 0.818 均为最高档,且随文本区域从 2 个增至 5 个准确率仅从 0.892 降到 0.857,抗区域数增加的鲁棒性好。传统基准 GenEval 总分 0.85(单物体 1.00、双物体 0.98、属性绑定 0.84 并列最高),但 Counting 仅 0.53 暴露计数弱点;DPG-Bench 87.48,各维度均衡(Entity 92.31、Attribute 92.37、Relation 92.55)。编辑能力 GEdit-Bench:英文 GO 7.336、中文 7.294,证明单 checkpoint 可双语编辑,但分量解构显示语义一致性(英文 GSC 8.043)明显强于感知质量(GPQ 7.182),与专职编辑模型(SenseNova 8.172、FireRed 7.943)仍有差距。蒸馏有效性:Turbo 用 4 步采样在 Qwen-Image-Bench 英文拿到 50.98、中文 50.27,仅比多步版低约 2.5 和 3.1 分,DPG 上甚至以 88.55 排全场第一,验证了 TwinFlow 蒸馏的高保真。作者同时明确表示 GenEval 与 DPG 已饱和、不再作为主要证据。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文生图综合(英文) | Qwen-Image-Bench EN 总分 | 53.53 | Z-Image Turbo(次优开源)51.66 | +1.87,开源新 SOTA;但距闭源 GPT-Image 2 的 65.23 仍差 11.7 |
| 文生图综合(中文) | Qwen-Image-Bench CN 总分 | 53.38 | Z-Image Turbo(次优开源)52.71 | +0.67,开源新 SOTA;距 GPT-Image 2 的 64.69 差 11.31 |
| 长文本渲染(英文) | LongText-Bench-EN 准确率 | 0.923 | Qwen-Image 2512: 0.956 | 落后 0.033,位居开源第三 |
| 复杂视觉文字(海报/广告等) | CVTG-2K 平均词准确率 | 0.875 | SenseNova U1.5 Preview: 0.887 | 全场第二;NED 0.945 与 CLIPScore 0.818 为最高档 |
| 物体计数 | GenEval Counting | 0.53 | Qwen-Image: 0.89 | 显著落后,是最弱的分项(总分 0.85 亦非第一) |
| 密集长 prompt 跟随 | DPG-Bench 总分 | 87.48(Base)/ 88.55(Turbo,全场第一) | Qwen-Image: 88.32 | Turbo 版反超所有对比模型 |
| 指令图像编辑(英文) | GEdit-Bench-EN GO 总分 | 7.336 | SenseNova U1.5 Preview: 8.172 | 落后 0.836;语义一致性 8.043 尚可,感知质量 7.182 是短板 |
| 少步蒸馏保真 | Qwen-Image-Bench EN(4 步) | Turbo 50.98 | 自身多步版 53.53 | 仅损 2.55 分即换得 2-4 步推理 |
局限与改进
作者承认的局限有三:一是世界知识广度不足,对专业题材、文化特定概念和依赖事实语境的 prompt 描绘不可靠;二是长文本与多区域文字渲染在区域数、文本长度和版式复杂度上升时稳定性下降;三是训练名义像素预算止步 1024²,原生 2K 生成只是未来计划而非已验证能力。结合数据我还能补充几点:其一,Real-world Fidelity 维度英文仅 43.90,在开源组内也排不进前列,说明照片级真实场景(而非美观合成图)仍是弱项,这可能与 220M 的数据规模和去重过滤策略有关;其二,GenEval Counting 0.53 且蒸馏后掉到 0.42,计数能力在压缩时被进一步牺牲,说明少步蒸馏主要保住了分布整体形状而丢了细粒度组合性;其三,编辑的感知质量 GPQ(英文 7.182)显著低于语义一致性,双通路设计保住『不动的部分』却略微牺牲了『生成部分的质感』;其四,作为技术报告,全文没有消融实验——无参 RMSNorm、Muon、logit-normal 采样、检查点合并、真实数据占比等关键 Recipe 均只有结论没有对照数据,读者只能整体接受;其五,评测以 VLM-as-judge 类基准为主,人评与真实用户偏好证据未报告。
独立分析的弱点
第一,计数与组合性弱(GenEval Counting 0.53、蒸馏后 0.42):图像自条件学的是『从可见 patch 补全缺失区域』,这类任务对数量语义的监督信号天然稀薄,SFT 阶段也没有针对性数据。改进方向:在精修阶段掺入可程序化验证数量的合成计数样本,或引入基于 VLM 反馈的强化学习直接奖励计数正确。第二,Real-world Fidelity 偏低(英文 43.90):真实图占 98% 却在这项上吃亏,暗示瓶颈不在数据真假而在数据覆盖——真实网图的审美偏好分布可能偏离该维度评测的真实场景。改进方向:对失败 case 做聚类分析,针对性补充纪实摄影、抓拍类数据。第三,编辑感知质量短板:干净 VAE 潜变量拼接是逐像素的硬约束,可能限制生成区域的自由度。可探索把像素通路做成软约束(如特征层面的正则)或引入质量感知的 RL 后训练。第四,无 2K 原生分辨率:1024² 桶上限使高清需求用户必须外插。可在中期训练即引入 2K 桶并配合渐进分辨率课程,论文自己也把这列为方向。第五,零消融:所有 Recipe 缺乏对照,社区难以判断各成分边际贡献。即便算力受限,也可以在 1/10 规模上做正交消融并开源结论。第六,蒸馏对 Counting 的额外损伤提示 TwinFlow 可与能力保持正则(如在蒸馏目标中加入原模型中间表征对齐)结合。
未来方向
作者明确提出的方向有四:(1) 把课程扩展到原生 2K 分辨率生成;(2) 加强 grounding 与排版能力,提升知识密集概念与多区域文字的可靠性;(3) 拓宽世界知识覆盖,让模型能忠实描绘专业题材和文化特定概念;(4) 探索 agentic generation——通过闭环的规划、评估、编辑流程让模型自主迭代产出,这与他们已有 dLLM 推理能力天然契合。基于本文成果还可自然延伸:其一,图像自条件课程迁移到视频生成,视频帧间冗余比图像更大,image-only(帧-only)预训练的省 caption 红利会更显著;其二,TwinFlow 的 signed-time 单主干思想可推广到任意流匹配模型的蒸馏,尤其适合与本文的 dLLM 骨干结合做离散扩散的少步化;其三,RQA+冻结 VLM 的参数高效接口值得在其他冻结大模型(如 Qwen-VL)上复用验证,形成『冻结理解 + 可插拔生成』的生态;其四,真实数据主导 vs 合成数据主导的 scaling law 值得系统量化——本文只给出了定性主张(早期慢、天花板高),若能画出两类数据配比下质量-算力曲线,将对整个社区的配方设计产生指导意义;其五,把 CoT 推理能力显式接入生成(推理时先规划再画)目前只停留在理解侧 SFT,闭环利用是明显的低垂果实。
复现评估
开源程度在同类工作中属于最高档:GitHub(inclusionAI/LLaDA-Image)与 HuggingFace 集合发布四个 checkpoint(Base、Turbo 及各自 FP8 变体),附训练与推理代码,以及覆盖数据构建、渐进训练、统一生成-编辑、TwinFlow 蒸馏的详细配方;附录还给出宽高比桶配置、CoT SFT 细节、caption 与过滤用的完整 prompt。但从零复现的门槛依然很高:6B DiT 从零训练,预训练全局批大小 24,576、蒸馏阶段也需 1024² 分辨率与 EMA,意味着数百卡级的算力和数周时间;数据处理依赖 Qwen3.6-35B-A3B 与 Qwen3-VL-235B-A22B-Instruct 两个大模型做 caption 与一致性校验,仅这一步就是一笔可观的推理开销;220M 样本的原始采集、去重和过滤流程虽写了规则但语料本身不直接开源。现实的复现策略是分层的:普通研究者可直接用发布的 checkpoint 做推理、微调或二次蒸馏(可行性高);中等规模团队可复刻 SFT 之后的阶段(数据量已大幅缩小);只有资金充足的大团队才应尝试从零跑完整流水线。代码与配方的可检查性是本文相对多数只放权重的厂商报告的最大加分项。
论文图表