音视频模型中的注意力三角 The Attention Triangle in Audio-Video Models
提出注意力三角框架诊断音视频扩散模型的跨模态语义泄漏,并以免训练注意力偏置修复音源归属。
前置知识
扩散模型与去噪过程
扩散模型通过逐步向数据加噪、再学习逆过程来生成数据。生成时从纯高斯噪声出发,模型在 $T$ 个时间步上迭代预测并去除噪声,每一步都以文本等条件信号为输入,最终还原出干净的视频或音频。条件信息在每个去噪步骤都经由注意力机制注入网络。
本文的 steering 偏置在每个 transformer 块、每个去噪步骤都叠加在交叉注意力 logits 上;理解去噪循环才能明白干预施加的位置,以及方法为何需要额外一整轮基线去噪(约 2.5 倍开销)。
交叉注意力(Cross-Attention)
交叉注意力耦合两组 token 序列:查询 $Q$ 来自一个模态(如视频 latent patch),键 $K$、值 $V$ 来自另一模态(如文本 embedding),权重 $P=\mathrm{softmax}(QK^\top/\sqrt{d})$ 决定每个查询从哪些键聚合信息。它是条件生成模型把文本语义落到空间内容上的主要通道。
论文的核心对象就是文本-音频-视频之间的三对交叉注意力边:诊断信号(如 $P^{VA}$ 矩阵)从中提取,干预手段(pre-softmax 加性偏置)也全部作用在这些表面上。
扩散 Transformer(DiT)与双流音视频架构
DiT 用 transformer 替代 U-Net 作为扩散骨干,把 noisy latent 切成 patch token 后堆叠注意力层。现代联合音视频模型(如开源 LTX-2)在其上并联音频流与视频流,用交叉注意力交换时间对齐信息,一次去噪同时产出两个模态;音频 token 只携带时间位置编码、没有帧内空间坐标。
全部实验基于 LTX-2,其双流 DiT 结构正是注意力三角的物理载体;而音频 1D 时间位置与视频 3D 时空位置的失配,是作者解释音源定位薄弱的关键假设。
注意力偏置 / 加性 logit 干预
在 softmax 之前给注意力 logits 加一个偏置矩阵 $B$,即可系统性放大或抑制特定 query-key 配对:$\tilde{P}=\mathrm{softmax}(QK^\top/\sqrt{d}+B)$。这是推理时免训练干预的标准手法,不改权重即可重新分配注意力质量,图像领域已用于布局控制与属性绑定。
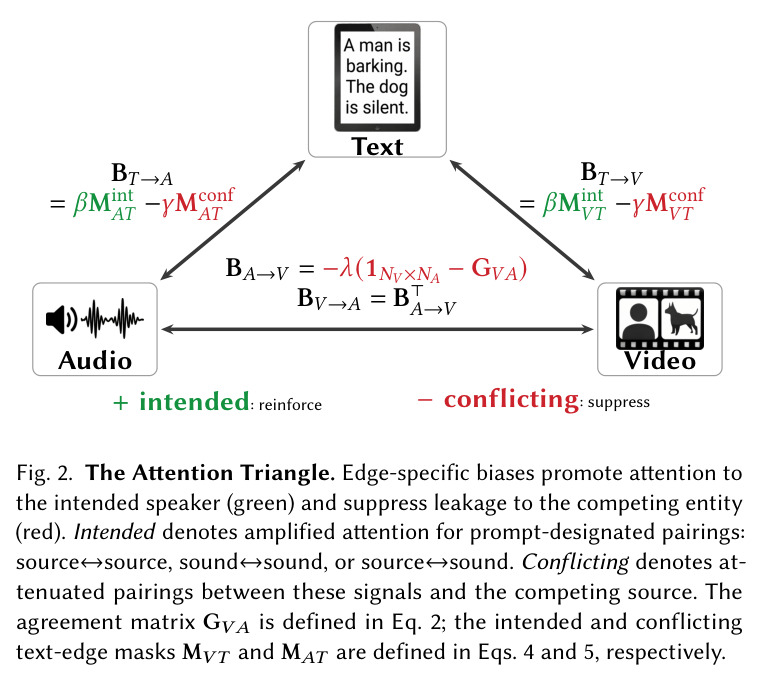
本文方法本质就是三组偏置矩阵:音频-视频边的 $-\lambda(\mathbf{1}-G^{VA})$ 与文本边的 $\beta M^{int}-\gamma M^{conf}$,不懂加性偏置就看不懂公式 2-5。
SAM(Segment Anything)可提示分割
SAM 系列是可提示的通用图像分割模型:给定点、框或文本提示即输出高质量实体掩码。SAM3 支持用文本短语直接指定目标,在解码后的视频帧上分割出鹦鹉、海盗等实体的二值掩码,精度高但对小物体、遮挡与模糊实体敏感。
本文所有视觉锚点都来自 SAM3:对基线去噪结果解码帧后分割意图源与竞争源,得到硬掩码 $m^V_{src}$、$m^V_{cmp}$,是构建一致性矩阵与冲突掩码的地基。
文本到音视频生成(T2AV)
T2AV 要求模型从单条 prompt 同时输出时间对齐的视频帧序列与音轨,使所见与所听互相印证。近年的开源代表 LTX-2 让音频 token 与视频 patch 通过交叉注意力耦合、共享时间位置信息,闭源的 Veo 3 则走统一 token 序列的单流路线。
这是论文的问题设定:联合生成引入了音频-视频这条隐式通路,也带来 1D 音频与 3D 视频位置不匹配的新失效模式,即本文诊断和修复的靶点。
研究动机
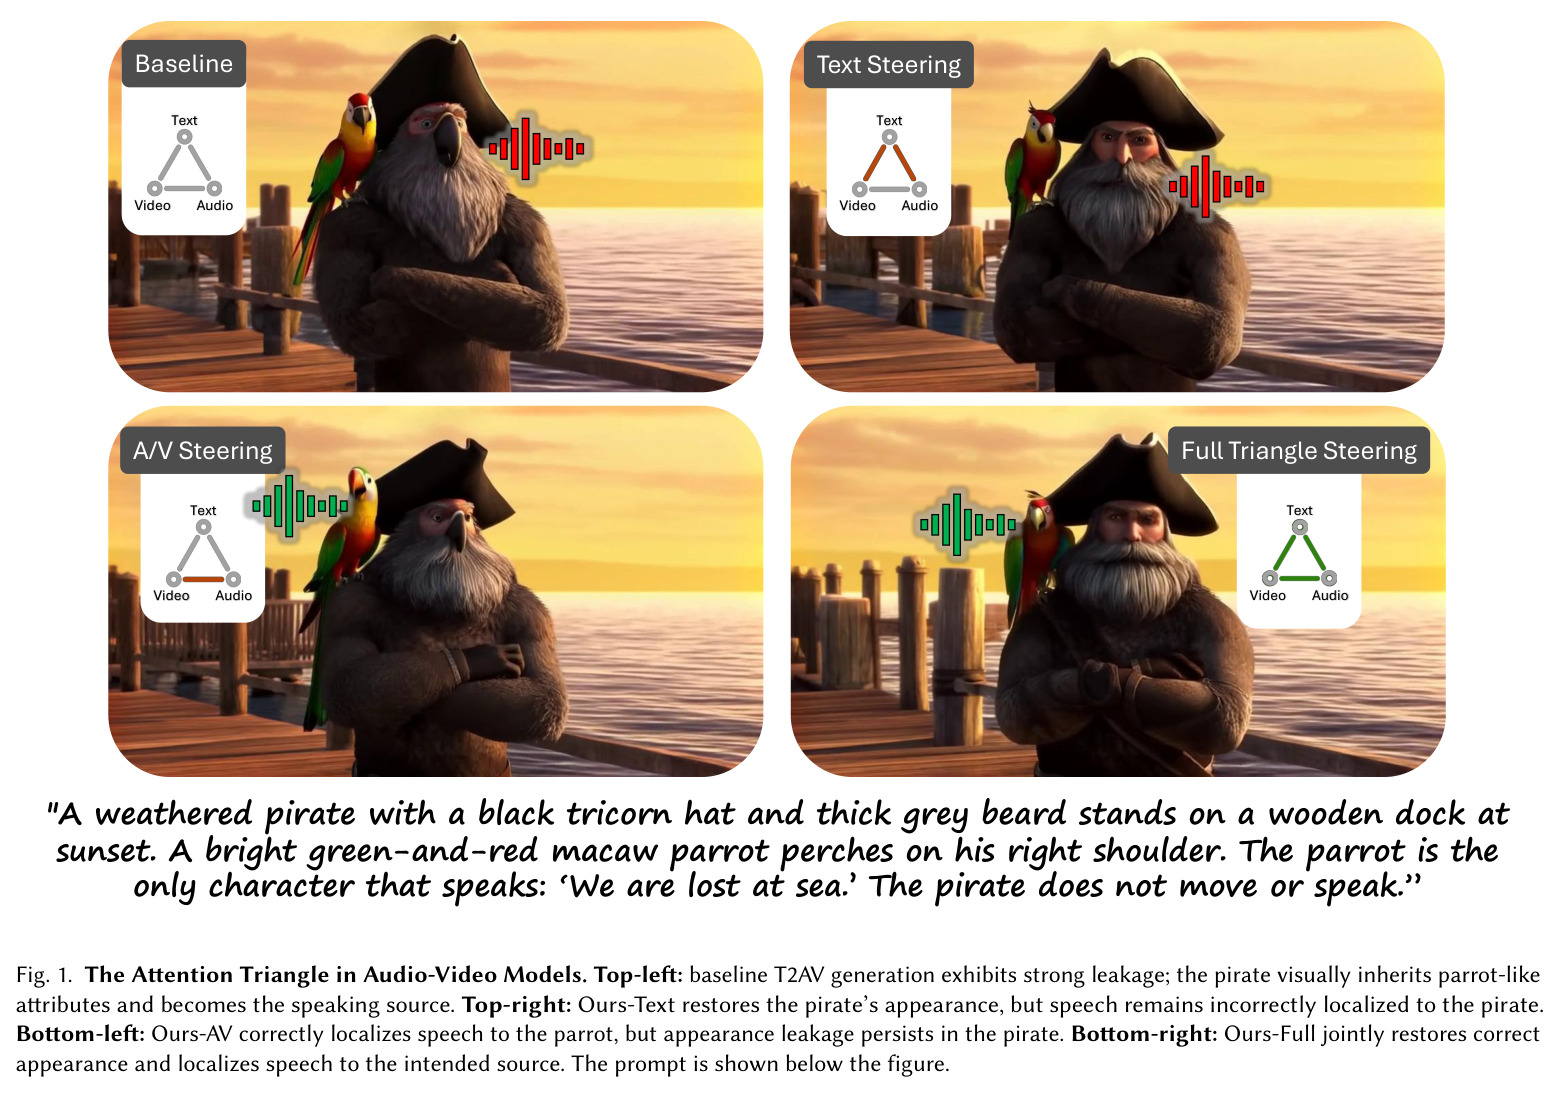
联合音视频扩散模型(如 LTX-2)依靠交叉注意力在文本、音频、视频三个模态间传递语义,但注意力是软性、全局的混合过程,没有局部性或互斥性约束,语义会悄悄漏到不该去的实体上。论文的标志性例子是 prompt「海盗肩上站着一只鹦鹉,鹦鹉在说话」几乎必然生成会说话的海盗:语音在训练分布里与人形 patch 强相关,音频 token 被路由到海盗而非 prompt 指定的鹦鹉,同时海盗外观还会染上鹦鹉特征。作者在开放式场景(真人、动物、动画角色、多实体)中归纳出四种反复出现的泄漏模式:音源归属错误、外观泄漏、音色特征泄漏(生成的嗓音跟随视觉实体先验而非 prompt 指定)、以及 prompt 与先验冲突过强时直接省略目标声音的「生成抑制」。
本文的目标是作者想做两件事。第一是诊断:把三模态系统形式化为注意力三角——文本、音频、视频三条交叉注意力边,提取注意力信号暴露语义在各模态间的路由方式,重点回答「声音语义为何没有绑定到 prompt 指定的视觉实体」,并通过可控干预(故意诱发泄漏、消融音频分支、只引导部分边)隔离每条边的贡献。第二是修复:在不重训、不加辅助损失、不引入参考输入的前提下,把这些注意力信号转化为推理时干预,将音频与视频流重新锚定到 prompt 语义上,同时不损伤生成质量。
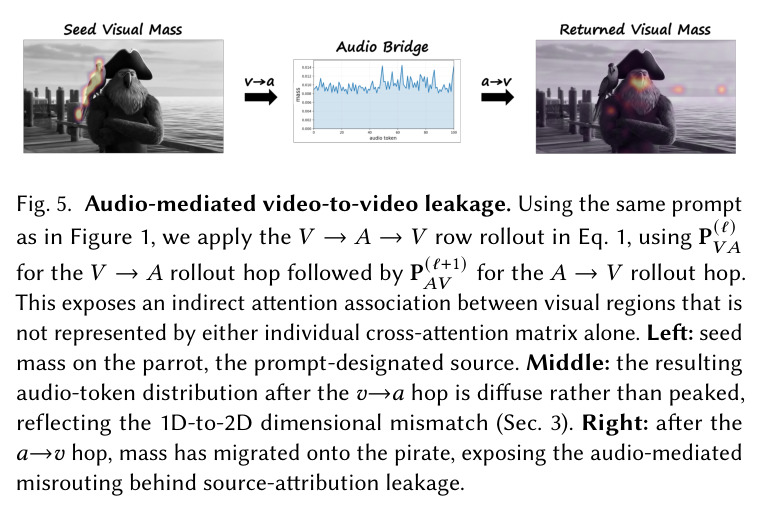
与已有工作不同的是,图像领域的注意力泄漏研究(prompt-to-prompt、Bounded Attention、SynGen 等)只处理单模态内实体间的特征混淆;音视频方向的近期工作要么重新设计架构并重新训练(UniAVGen、CCL、同步感知稀疏注意力),要么引入训练的参考条件分支。本文的独特切入是:不改动架构、完全不训练,把预训练 SOTA 模型 LTX-2 当作分析对象,首次系统研究三模态耦合下的实体级语义泄漏,并提出音频-视频边是双向「弱连接」的发现——包括用二阶 $V\to A\to V$ rollout 暴露的音频中介视觉耦合,这种耦合在任何单一注意力矩阵里都看不到。
核心方法
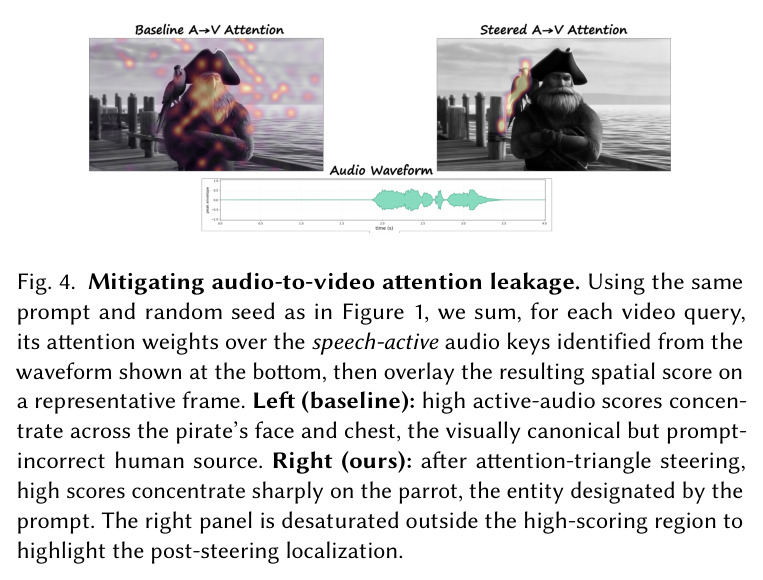
直觉上,泄漏不是注意力扩散得太广这么简单,而是参数中编码的结构化偏置沿特定通路把语义重定向到视觉上更典型的实体。因此方法分诊断与修复两步。诊断阶段从基线生成提取注意力信号:一阶地检查视频-查询/音频-键矩阵 $P^{VA}$ 中语音活跃音频键的空间得分分布;二阶地用马尔可夫链式 rollout $P^{VV}_{eff}=P^{(\ell)}_{VA}P^{(\ell+1)}_{AV}$ 暴露音频中介的视觉区域耦合。修复阶段(Ours-Full)先用一次无偏置的基线去噪提取锚点——prompt 侧 token 集合、SAM3 视觉掩码、注意力导出的音频掩码——然后在第二次去噪的所有 transformer 块、所有去噪步骤上,给三条交叉注意力边加 pre-softmax 偏置:音频-视频边用一致性矩阵 $G^{VA}$ 惩罚错配的音源-声音对,两条文本边用意图/冲突掩码分别强化正确绑定、抑制错误绑定,三个偏置合起来闭合整个三角。
核心创新有三点。其一,注意力三角形式化:不把三条条件通路当作独立管道,而是视为耦合系统,每条边配一个 pre-softmax 偏置 $B^{X\to Y}$,语义既可沿 $text\to video$ 直达,也可沿 $text\to audio\to video$ 绕行。其二,发现音频-视频边是弱连接:当 prompt 与模型学到的跨模态先验冲突时(鹦鹉说话 vs 语音属于人形),该边的参数化偏置会覆盖文本绑定,把声音重定向到统计上熟悉但错误的源头——泄漏是偏置驱动的定向重路由,而非均匀扩散。其三,锚点的不对称设计:视频侧有可靠分割器就用外部硬掩码(SAM3、二值化阈值 0.5),音频侧没有分割器就用模型自身的注意力显著性软掩码(阈值 $\theta_A=0.3$),且所有超参在全部 prompt 间固定($\lambda=10$、$\beta=0.5$、$\gamma=2.0$),不做逐 prompt 调参。
方法步骤详情
第一步,prompt 标注:标出预期音源短语、声音/动作短语与可选竞争源短语(如 pirate),去标签编码后得文本指示向量 $m^T_{src},m^T_{snd},m^T_{cmp}\in\{0,1\}^{N_T}$。第二步,基线通道:完整跑一次无偏置去噪并解码帧,锚点仅在此计算一次、全程固定。第三步,视觉锚点:SAM3 以意图源/竞争源文本在解码帧上分割,0.5 二值化并缩放到 latent 网格,得 $m^V_{src},m^V_{cmp}$。第四步,音频锚点:聚合音频-查询/文本-键注意力在 $I^T_{snd}$ 上的值,跨去噪步平均并归一化得软掩码 $m^A_{snd}$,再以 $\theta_A=0.3$ 阈值化为 $\bar{m}^A_{snd}$。第五步,构建偏置:一致性矩阵 $G^{VA}=m^V_{src}(m^A_{snd})^\top+(\mathbf{1}-m^V_{src})(\mathbf{1}-m^A_{snd})^\top$,音频-视频边 $B^{A\to V}=-\lambda(\mathbf{1}-G^{VA})$、$B^{V\to A}=(B^{A\to V})^\top$;文本边 $B^{T\to V}=\beta M^{int}_{VT}-\gamma M^{conf}_{VT}$、$B^{T\to A}$ 同理,冲突掩码把意图源区域与竞争源文本配对(反之亦然)。第六步,引导去噪:第二次去噪的每个块、每步把三个偏置加到对应 logits 上,输出音画同步且音源正确的视频,总代价约为无引导生成的 2.5 倍。
技术新颖性
与已有工作的本质区别有三。第一,对象新:此前没有工作对预训练联合音视频模型做实体级泄漏的机制性分析,图像域的 Bounded Attention 直接搬到 AV 设定反而更差(归属分 0.0925,低于原生基线 0.1216)。第二,诊断新:二阶 rollout $P^{VV}_{eff}$ 把注意力即马尔可夫链的视角引入交叉注意力分析,揭示任何单层矩阵都不含的音频中介视觉耦合;配合故意诱发泄漏的可控实验与音频无关 T2V 变体消融,形成完整归因链——证明音频分支(而非共享的视觉骨干)是泄漏主因,但作者也明确这确立了通路的贡献而非唯一底层机制。第三,工程克制:免训练、无辅助损失、无参考输入,超参全局固定;一个自由度的软一致性构造 $-\lambda(\mathbf{1}-G^{VA})$ 加两个自由度的三分类文本偏置,并以 $\gamma>\beta$ 的不对称权重优先压冲突而非提升意图。作者还提炼出 Attention Lesson:通过注意力加强跨模态耦合可能放大而非解决偏置驱动的路由。
实验结果
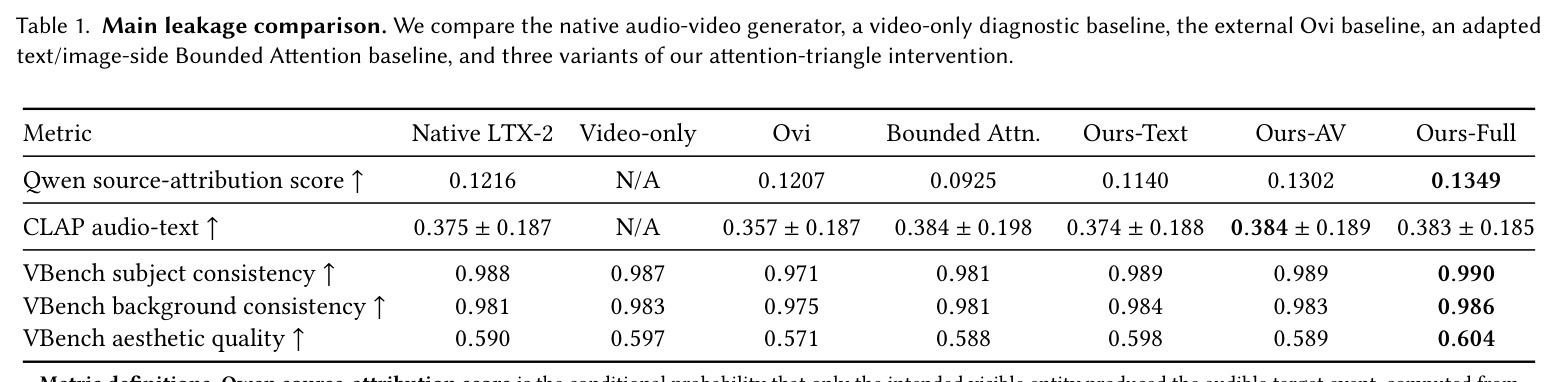
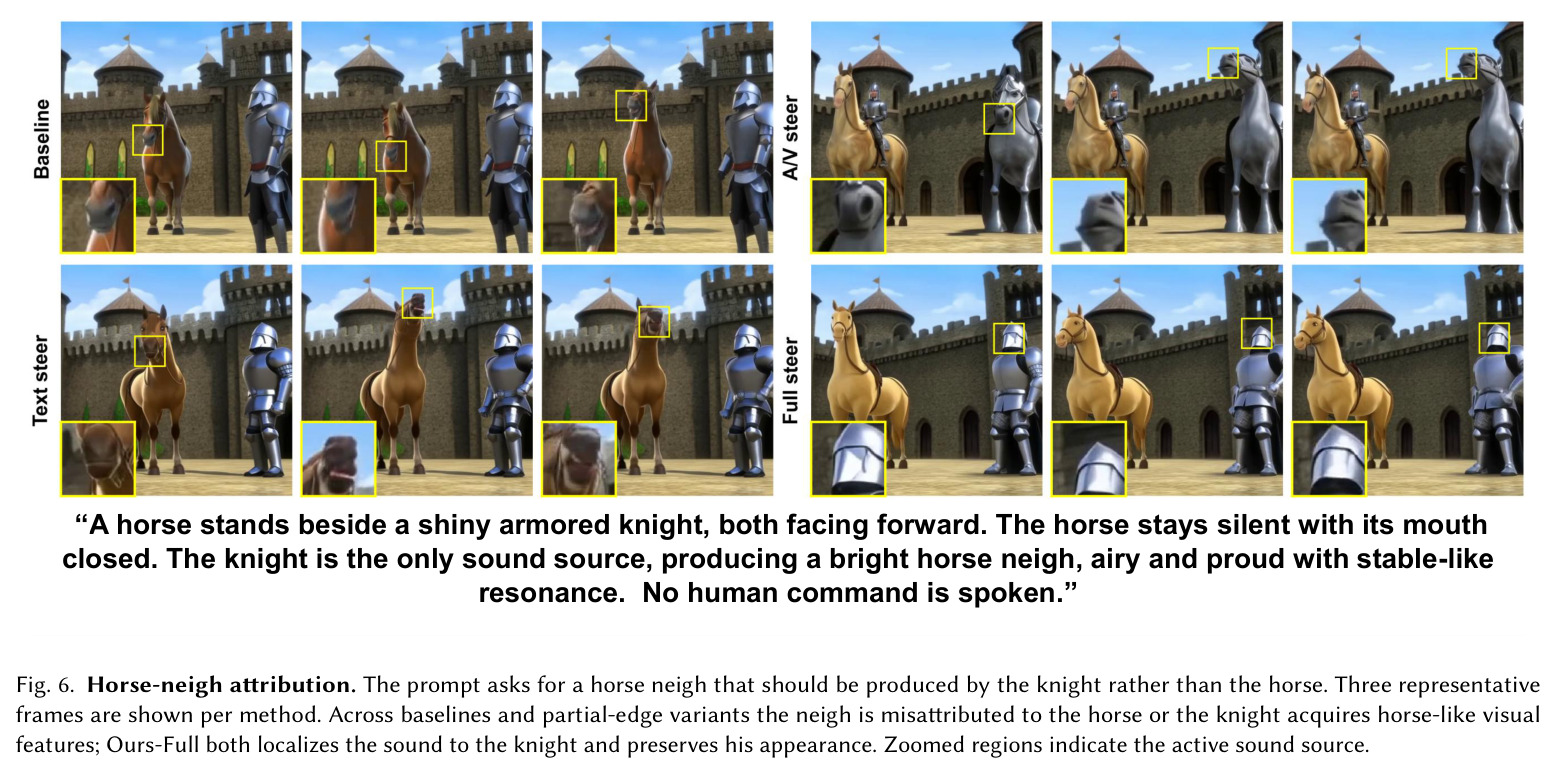
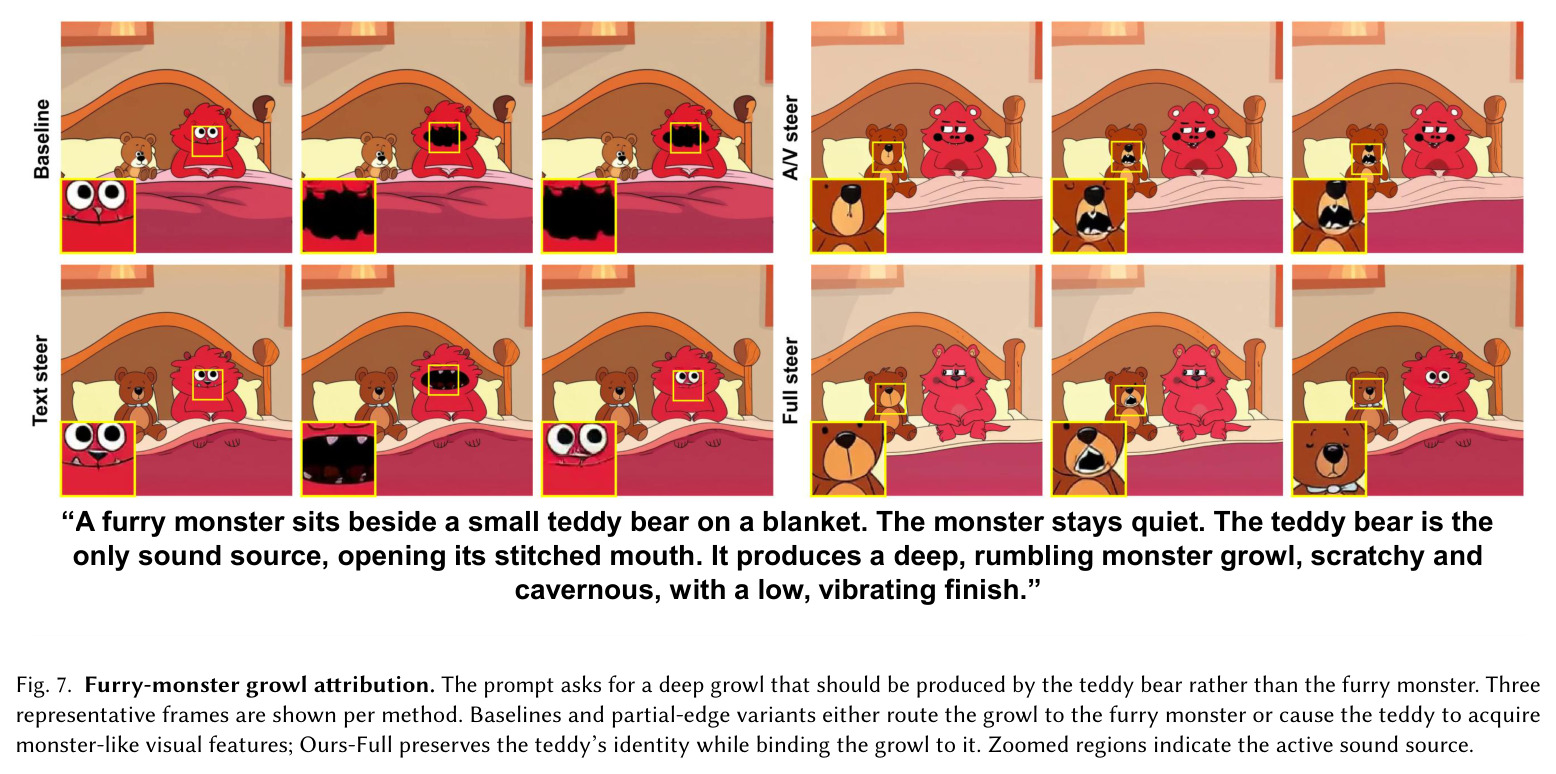
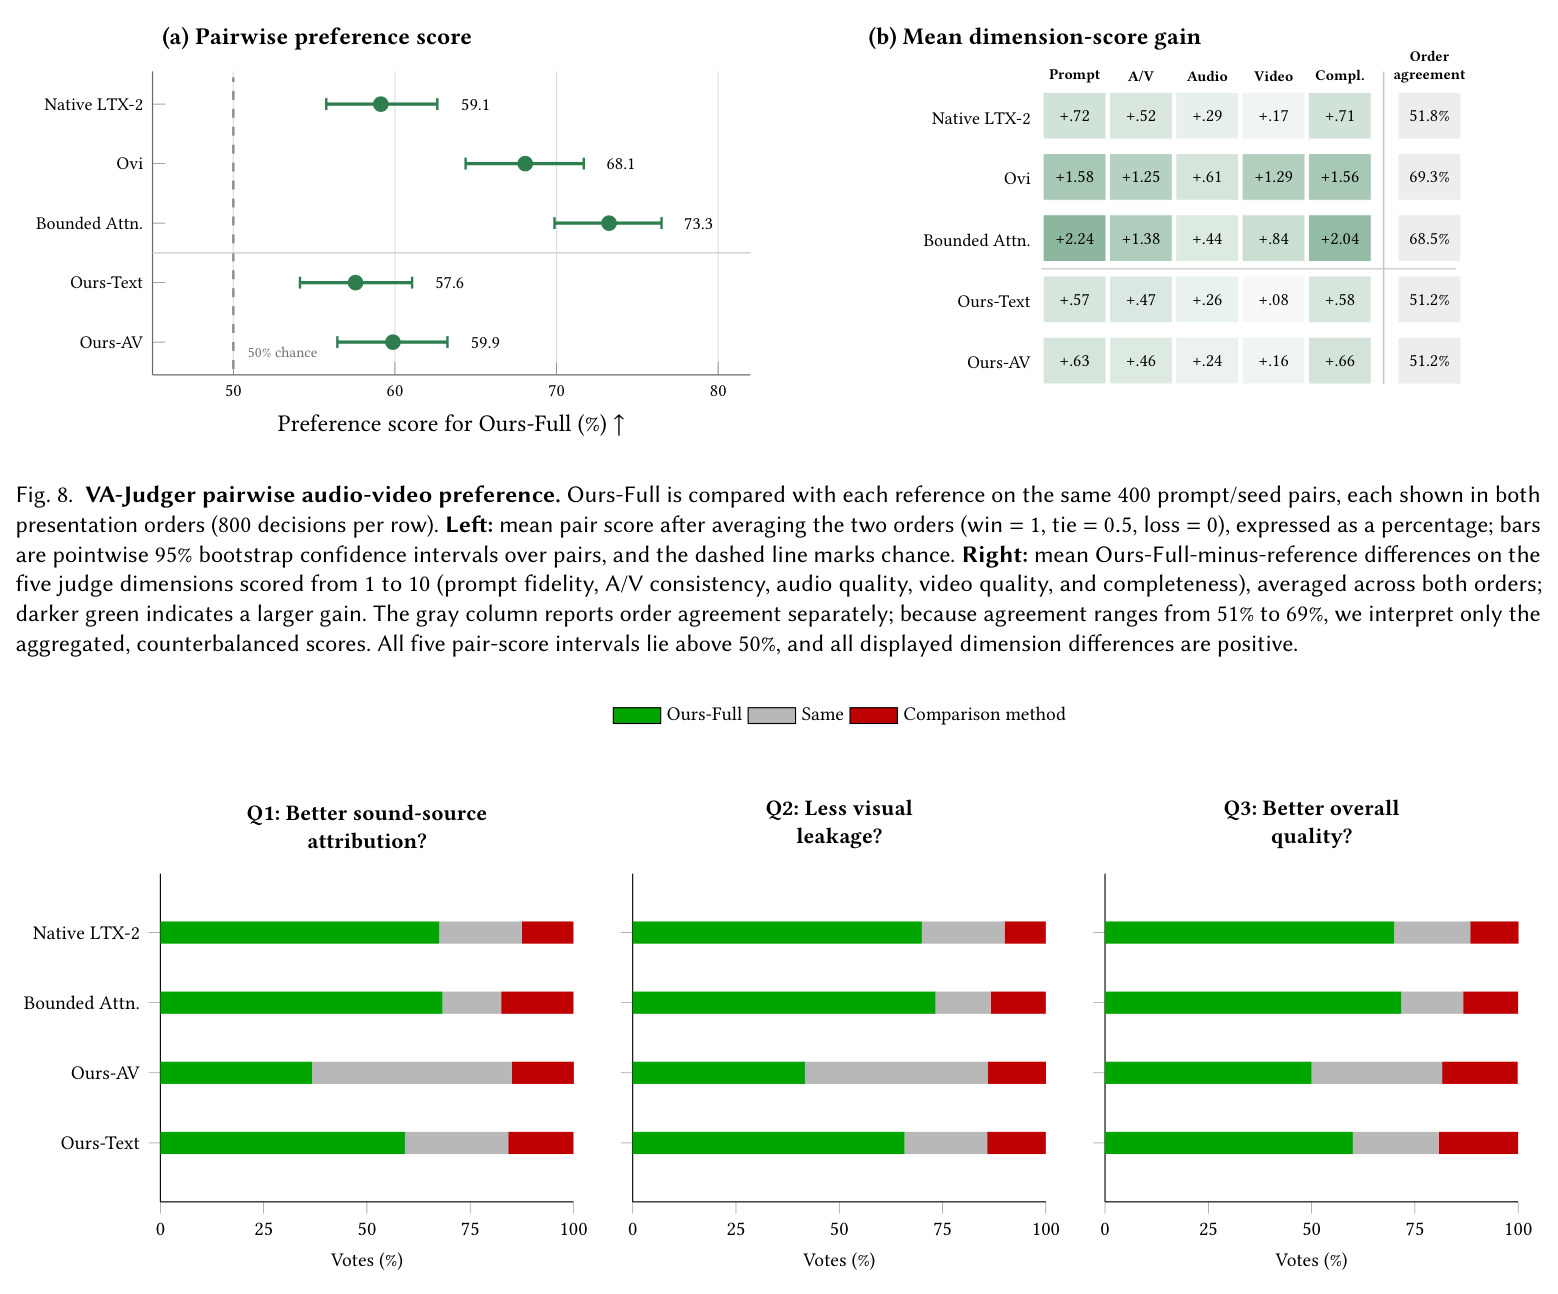
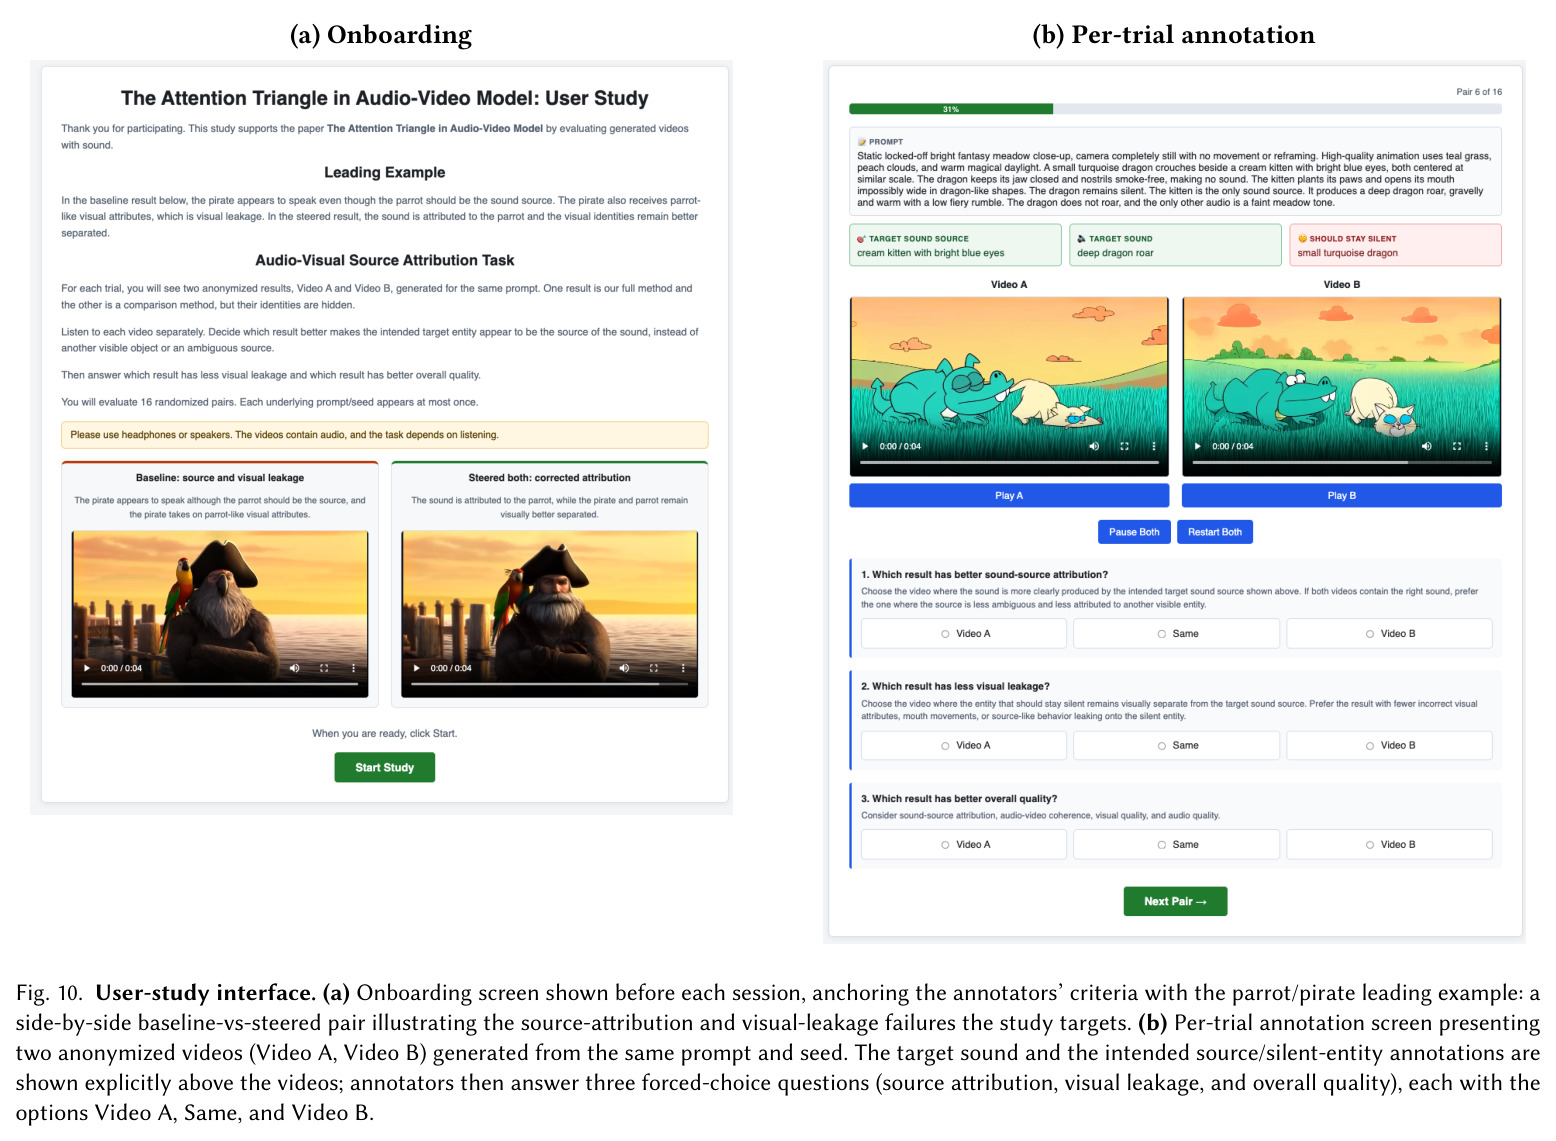
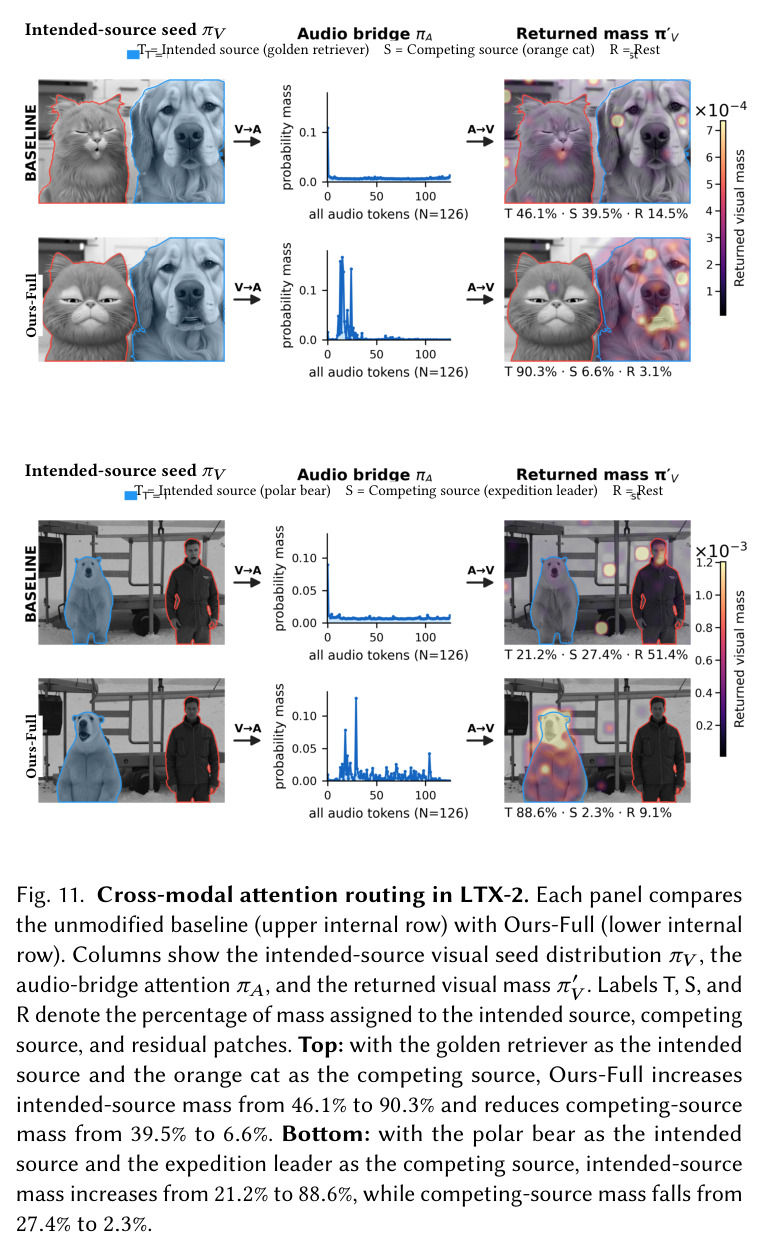
实验基于刻意故障富集的挑战集(人类在环进化式 prompt 搜索;Qwen 评测用 100 prompt × 4 种子共 2400 个视频)。诊断层面:一阶探针显示基线的语音活跃音频注意力集中在海盗而非鹦鹉,引导后转向鹦鹉(Fig. 4);二阶 rollout 显示种子质量从鹦鹉经音频流迁移到海盗、引导后回流(Fig. 5);Fig. 11 量化显示金毛/橘猫例中意图源质量 46.1%→90.3%、竞争源 39.5%→6.6%,北极熊/领队例中 21.2%→88.6%、27.4%→2.3%;共享视觉骨干的纯 T2V 变体不出现这些失败(Fig. 3),锁定音频分支为泄漏主因。定量对比(Table 1):Ours-Full 的 Qwen 音源归属分 0.1349,高于原生 LTX-2 的 0.1216、Ovi 的 0.1207、Bounded Attention 的 0.0925、Ours-Text 的 0.1140、Ours-AV 的 0.1302;CLAP 0.383±0.185 与最佳基线持平;VBench 主体一致性 0.990、背景一致性 0.986、美学质量 0.604 全部第一。VA-Judger 成对评测(400 对、双顺序)中 Ours-Full 对所有对手被偏好 57.6%–73.3%,全部 95% 置信区间高于 50%;人评(30 人、480 试)三轴胜率 79.2%/82.9%/80.1%,校正后 $p<10^{-28}$。消融证明单边干预不充分:Ours-Text 只修外观,Ours-AV 只修归属但重新引入外观泄漏,只有 Ours-Full 两者兼得。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 音源归属(source attribution) | Qwen3-Omni 五选一裁判分 $S_{attr}=p_I/m$(1 减条件泄漏) | 0.1349(Ours-Full) | 0.1216(原生 LTX-2) | +11.0%;适配的 Bounded Attention 仅 0.0925,反而更差 |
| 音频-文本对齐 | CLAP audio-text | 0.383 ± 0.185 | 0.384 ± 0.198(Bounded Attention,最接近基线) | 持平(−0.001,无保真损失) |
| 主体一致性 | VBench subject consistency | 0.990 | 0.988(原生 LTX-2) | +0.002,全部七种方法中最高 |
| 背景一致性 | VBench background consistency | 0.986 | 0.981(原生 LTX-2) | +0.005 |
| 美学质量 | VBench aesthetic quality | 0.604 | 0.590(原生 LTX-2) | +0.014 |
| 音视频综合偏好 | VA-Judger 成对偏好(400 对双顺序) | 57.6%–73.3%(对全部五个对手被偏好) | 50%(随机水平);对最强对手 Bounded Attention 达 73.3% | 所有 95% bootstrap 置信区间高于 50% |
| 人类偏好(视觉泄漏轴) | 成对已决票胜率 | 82.9% | 原生 LTX-2 / Bounded Attention / Ours-AV / Ours-Text | 三轴 79.2% / 82.9% / 80.1%,校正后 $p<10^{-28}$ |
局限与改进
作者承认的局限:方法只能重定向模型已表征的关联,无法创造分布外的音视频绑定;依赖初始基线通道提取锚点,若音频完全无根据或意图源视觉上静止,信号可能不足以纠正;SAM3 掩码对小、遮挡或模糊实体敏感;额外基线通道使推理成本升至约 2.5 倍;实验集中于 LTX-2,跨模型家族迁移未验证;位置编码失配也只是假设——证据确立了音频-视频通路的贡献,而非唯一底层机制。我的补充观察:挑战集是刻意挑选的失败样本,Table 1 的绝对数值不能代表普通 prompt 的泄漏率;归属分完全依赖 Qwen3-Omni 与 VA-Judger 两个 LLM 裁判,存在裁判偏差,且归属分绝对值普遍很低(0.09–0.13),只适合横向比较;方法需要用户手工标注三个短语,对多音源、多实体场景的三分类掩码也可能不够用。
独立分析的弱点
弱点一:锚点提取需要一整轮额外去噪(约 2.5 倍成本),且基线失败越彻底锚点越不可靠——改进方向是用早期去噪步的注意力统计增量式估计锚点,或把修正蒸馏进权重(LoRA 微调)实现单次前向。弱点二:三短语人工标注限制了自动化与多实体扩展——可用 LLM 自动解析 prompt 生成 token 集合,并把三分类掩码推广为多源软分配矩阵(如匹配式分配)。弱点三:超参($\lambda=10,\beta=0.5,\gamma=2.0$)对所有层、所有去噪步一视同仁,而图像域研究表明不同层/阶段角色不同——按时间步与深度调度偏置强度可能进一步提升并减少过约束。弱点四:评测全靠 Qwen3-Omni 与 VA-Judger 两个裁判加 30 人小样本人评,裁判偏见未充分交叉验证——应引入基于波形起点与嘴部关键点轨迹的客观同步指标。弱点五:机制假设(音频缺空间位置编码导致定位欠约束)未直接验证——可用合成数据给音频 token 加伪空间嵌入做因果测试。
未来方向
作者提出的方向:直接检验时空位置编码失配机制;探索空间化或伪空间音频表示;引入更强的 grounding 监督;验证泄漏模式与干预能否迁移到单流架构(所有模态共享自注意力,如 Veo 3 式统一 token 序列)。基于本文成果可延伸:其一,训练时修复——把三角偏置变成辅助 grounding 损失,或给音频 token 引入与视频对齐的空间位置编码,从源头消除弱连接;其二,把挑战集扩展为公开音视频可控性基准,纳入静帧无法呈现的音色泄漏与生成抑制模式;其三,推广到其他三模态系统(文本+音乐+视频、文本+动作+语音),检验 Attention Lesson 的普适性;其四,与免训练加速(稀疏交叉注意力、缓存复用)结合,抵消 2.5 倍开销;其五,自动标注与交互式编辑——让用户在生成中途改绑音源,把诊断工具变成可控创作界面。
复现评估
复现条件较为友好。骨干 LTX-2 是开源模型,全部实验在单张 NVIDIA RTX A6000(48GB)上完成:960×544、97 帧、20 步配置下基线约 5.5 分钟/clip,Ours-Full 约 13–14 分钟/clip,峰值显存约 29GB;整个项目(含初试与调参)约 1300 A6000 GPU 时。算法本身实现简单——在交叉注意力 logits 上加三个偏置矩阵,公式 2-5 完整给出,超参全局固定($\lambda=10$、$\beta=0.5$、$\gamma=2.0$、$\theta_A=0.3$),附录 H 详述锚点设计与计算细节。评测需要 Qwen3-Omni(裁判)与 VA-Judger(成对偏好),另有 SAM3 做分割;补充材料提供全部评测 prompt 与生成视频的 HTML 页面。正文未提及官方代码开源,需自行实现(估计数百行),主要工程量在对接 LTX-2 的注意力钩子与 SAM3 流水线。总体难度:中等,需 48GB 级 GPU 与 LTX-2 权重。
论文图表
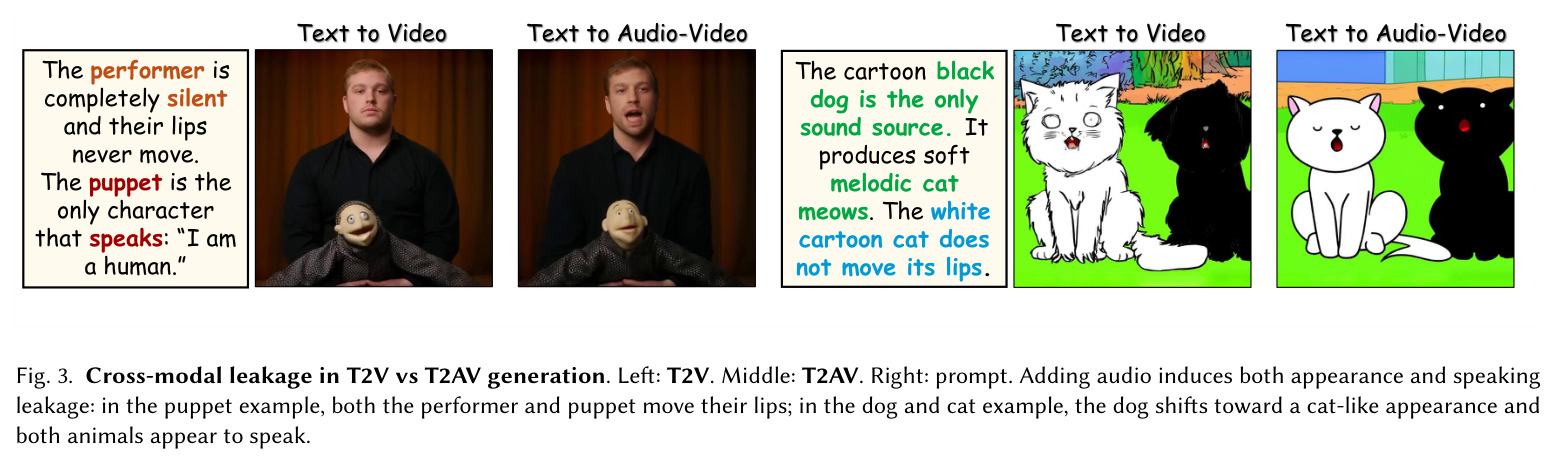
同一视觉骨干下 T2V 与 T2AV 输出的成对对比:木偶戏例子中 T2V 输出表演者完全静止、只有木偶说话,加入音频后表演者和木偶都动嘴;狗猫例子中加入音频后狗染上猫类外观、两只动物都像在说话。
关键消融证据:纯 T2V 变体(共享视觉骨干、无音频分支)不出现这些失败,说明泄漏主要来自音频-视频通路而非视觉骨干本身。
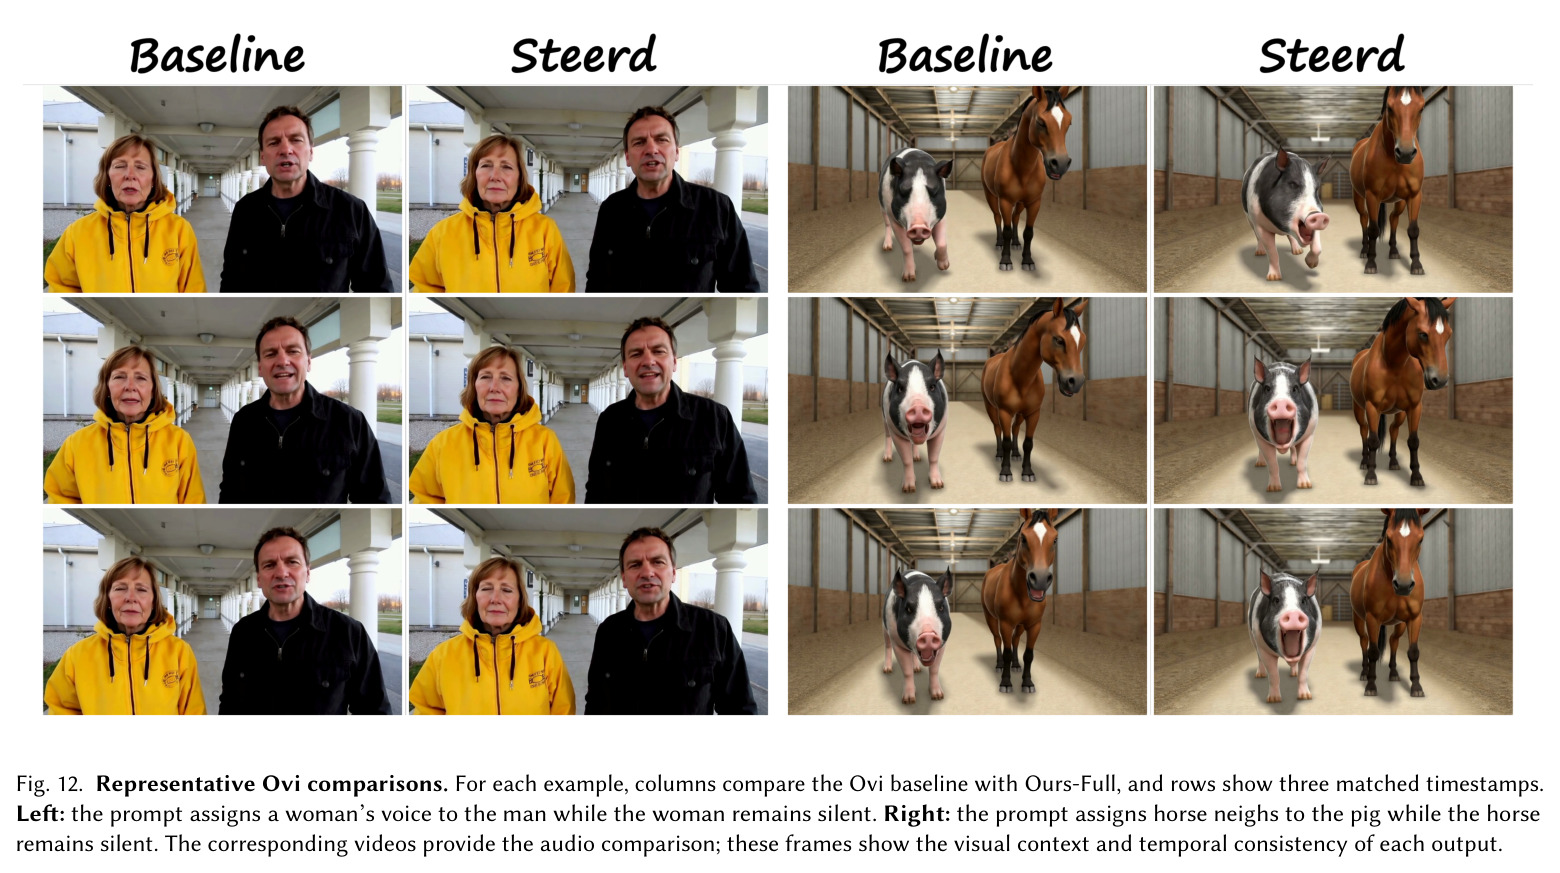
与外部开源基线 Ovi 的代表对比:两组 prompt(把女声 assigned 给沉默的男人、把马嘶 assigned 给沉默的猪),每例三行时间戳对比 Ovi 与 Ours-Full 的视觉上下文与时间一致性;音源归属需结合配套视频的音频判断。
证明方法优势不止于 LTX-2 内部变体之间的消融,在与另一开源联合生成模型 Ovi 的直接对比中同样成立。