PACE:面向用户请求隐性冲突挖掘的基准与多智能体检索框架 PACE: Towards Surfacing Hidden Conflicts in User Requests
提出PACE基准与PACEMAKER框架,从个人知识库中挖掘让合理请求变得不宜执行的隐性冲突。
前置知识
RAG(检索增强生成)
LLM 回答前先从外部文档库检索相关片段拼入上下文,以弥补参数知识不足、支持个性化与私有数据问答。典型流程:离线建索引 → 按查询检索 top-k 文档 → 拼进 prompt → 生成回答。质量取决于检索能否命中真正需要的信息。
PACEMAKER 本质是一个面向『冲突评估』任务的 RAG 变体,理解它与标准 RAG 的差异——检索目标是诊断性证据而非答案线索——是读懂全文的前提。
稠密检索与 BM25 稀疏检索
稠密检索把查询和文档编码为向量,用余弦相似度做近似最近邻搜索,擅长语义匹配;BM25 是基于词频的稀疏词项匹配,擅长字面与专名匹配。两者互补,实践中常并行使用后再融合排序。
论文采用双路检索加 WRRF 融合,是方法在线阶段的入口;单靠任何一路都难以召回与查询语义弱相关的冲突证据,这正是问题难度的来源。
自我中心知识库(egocentric KB)
以某个用户(ego)为中心的个人知识库,存储关于本人及密切相关者(alter,如家人、朋友、同事)的原子事实句,涵盖日程、健康、偏好、环境等。信息离散分散且体量大,本文平均每个实例约 2,035 条事实。
这是任务的舞台:决定请求可行性的证据散落其中,且与查询字面几乎无重叠,是『隐性冲突』难以被现有检索发现的根源。
kNN 文档图与多跳遍历
把每篇文档与其 $k$ 个最近邻连边构成无向图;检索时从种子文档出发沿边做广度优先扩展,可以找到与查询不直接相似、但与已命中证据相邻的文档,即『多跳』证据。HippoRAG、GraphRAG 等图 RAG 都依赖类似结构。
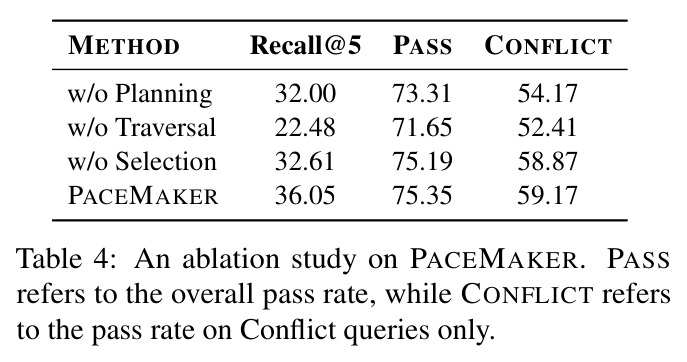
这是 PACEMAKER 的核心机制之一:消融实验显示去掉多跳遍历后 Recall@5 从 36.05 跌至 22.48,是召回语义弱相关冲突事实的关键。
加权倒数排名融合(WRRF)
多路检索结果的融合算法,按 $\sum_{m} \frac{w_m}{k+\mathrm{rank}_m(d)}$ 对文档在每一路的倒数排名加权求和后重排;加权版允许给某些查询视图更高权重。本文取 $k=60$,权重 $w=[1.0, 1.2]$。
论文给反事实查询的结果更高权重(1.2 vs 原始查询 1.0),主动把冲突证据往前排,是『冲突感知』在排序层面的具体实现。
LLM-as-a-judge(LLM 裁判评估)
用强 LLM 按既定评分标准自动评估模型自由文本输出的方法,需抽样与人类标注比对一致率来验证可靠性。本文采用 PASS/WRONG/FAIL 三级评分:PASS 指结论正确且理由与金标一致,WRONG 指结论对但理由不完整或偏题,FAIL 指结论错误。
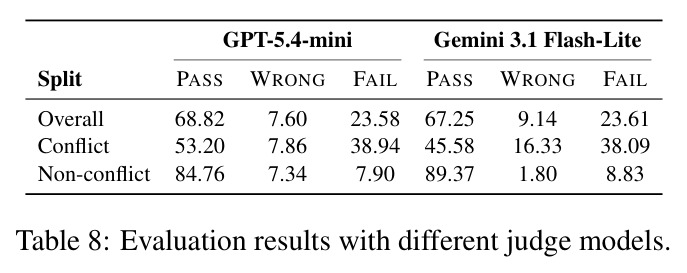
PACE 的回答质量评估完全依赖 GPT-5.4-mini 裁判(与人类一致率 93.5%),理解三级评分的定义才能正确解读论文中的 PASS 率指标。
研究动机
现有的个性化 LLM 助手研究几乎都默认一个前提:准确理解并执行用户请求就是好的;而安全类基准(SORRY-Bench、HarmBench、R-Judge 等)检测的也只是输入中显式存在的风险内容。但真实场景中,一个请求表面完全合理,是否该执行却取决于用户的当前处境。论文的例子很典型:『这周五晚 7 到 8 点在 Hearth & Bone 订两人位』看似普通,但知识库里分散藏着四个事实——用户 Ethan 当晚已与 Maya 有晚餐约定、Maya 是纯素食者、这家店本周是固定菜单(牛排、骨汤、芝士类)且不接受换菜——组合起来才暴露冲突。盲目执行会伤害同伴,而无脑拒绝又会造成过度拒绝、降低可用性。更麻烦的是检索层面:决定性事实与查询语义几乎不相关(查询只说订餐厅,证据讲的是伴侣的饮食禁忌),标准检索天然失灵。实验还证实,即便把整库直接塞给模型(Full KB),开源设置 PASS 率仅 57.49%,两个闭源设置也只有约 73%,远低于给金标证据的 Oracle(86.89%–91.26%),说明海量『看似相关实则无关』的干扰事实会严重干扰冲突推理。
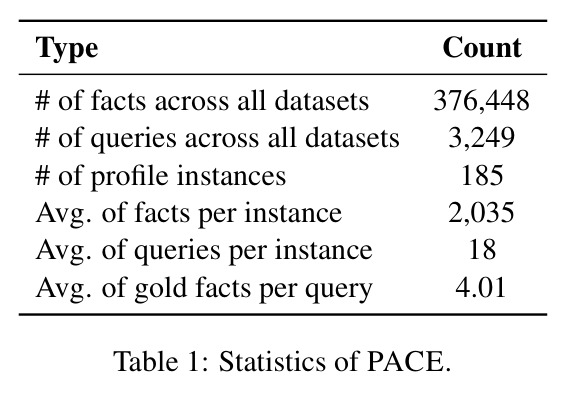
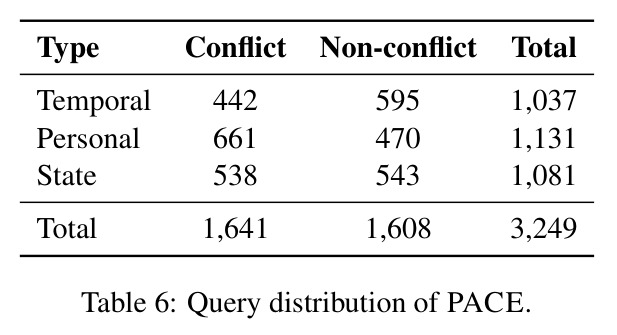
本文的目标是本文的目标分两层。第一,构建 PACE(Personalized Assistants for Conflict Evaluation)数据集,系统评测模型能否发现这类隐性冲突:共 3,249 条查询、376,448 条原子事实、185 个人设实例,每条查询配套一个自我中心知识库,标注冲突/非冲突标签与情境类型(时间 Temporal、个人 Personal、状态 State 三类),要求模型在数千条干扰事实中检索证据、判断请求是否该执行并给出理由。第二,提出 PACEMAKER,一个训练无关、模型无关的多智能体检索框架,通过冲突感知的查询规划、混合检索融合、多跳图遍历和两阶段证据过滤,把决定请求可行性的分散证据(平均每查询 4.01 条金标事实)从约 2,035 条事实中捞出来,同时提升检索指标(Recall@K、MRR)和最终判断质量(PASS 率),并保持非冲突查询的通过率不下降,避免过度拒绝。
与已有工作不同的是,本文的独特切入在于把检索的目标从『与查询相关的支持性信息』重新定义为『决定请求该不该执行的诊断性证据』。已有的个性化 RAG、记忆系统(Mem0、A-Mem、LongMemEval 方向)和图 RAG(GraphRAG、HippoRAG 2)优化的都是『如何找到与问题相关的内容来回答问题』;情境安全研究则假设风险信号已存在于输入之中。而冲突评估恰好卡在两者之间的盲区:不合适性既不写在请求里,也不绑定在单个显著事实上,而是由多条分散、语义弱相关的知识库事实组合出来的。论文还刻意让请求在孤立看时完全正常可执行,并排除『本身就不合理』的案例,迫使系统必须主动推测冲突可能藏在哪个维度(时间?同伴约束?环境状态?),这把问题从『识别』升级成了『定向挖掘』,是此前没有工作系统研究的设定。
核心方法
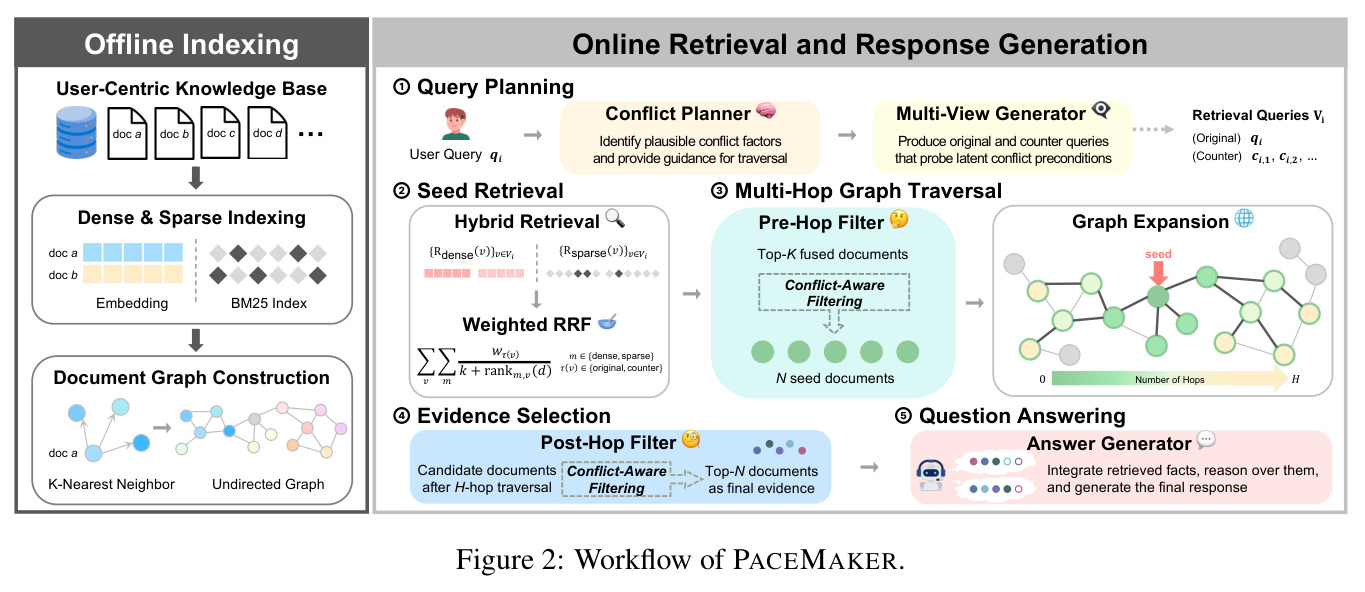
直觉上,PACEMAKER 模仿一个谨慎的人类助理:先想『这事可能卡在哪』,再带着假设主动查证,遍历相关线索,最后综合拍板。技术路线分离线索引和在线推理两段。离线阶段:把每条原子事实用 embedding 模型编码,用 FAISS 建稠密索引、BM25 建稀疏索引,并按余弦相似度构建 $k=10$ 近邻的无向文档图,全程零 LLM 调用。在线阶段五步:① 冲突规划器读入用户查询和参考日期,列出最多 3 个潜在冲突维度(日程约束、既有承诺、资源可用性等);② 多视图生成器据此产出原始查询加最多 3 条『反事实查询』,显式探测这些冲突前提;③ 每条视图同时走稠密与稀疏检索,用加权倒数排名融合(WRRF)合并,预跳过滤代理挑出 10 条最可能有决策价值的种子文档;④ 在 kNN 图上从种子出发做广度优先遍历,最大深度 $H=5$、每跳扩展 $M=3$ 个邻居,收集关联文档池;⑤ 后跳过滤代理从全部候选中选 top-10 证据,答案生成器据此输出『能否执行 + 理由』。整个在线流程每查询共 4 次 LLM 调用。
核心创新是『冲突感知的查询重写 + 定向证据过滤』。与已有方法的本质区别有两点。第一,反事实查询(counter queries):系统不检索与原查询相似的文档,而是先推测『如果存在冲突,会是什么类型』,再生成显式探测这些前提的查询(例如原查询只说订餐厅,反事实查询会去查同伴的饮食限制、既有日程),并在 WRRF 融合中给反事实视图更高权重 1.2、原始查询 1.0,主动把冲突证据拉进候选池。第二,两阶段 LLM 过滤:预跳过滤在图遍历前筛种子、后跳过滤在遍历后定终选,两道『决策相关性』闸门防止语义相关但无诊断价值的干扰文档污染种子集和最终证据,也阻断误导性种子在图扩展中级联传播。相比之下,GraphRAG 和 HippoRAG 2 的图检索是通用相关性导向,不知道自己要找的是『决定可行性的约束』,因此在 Conflict 查询上大幅落后。
方法步骤详情
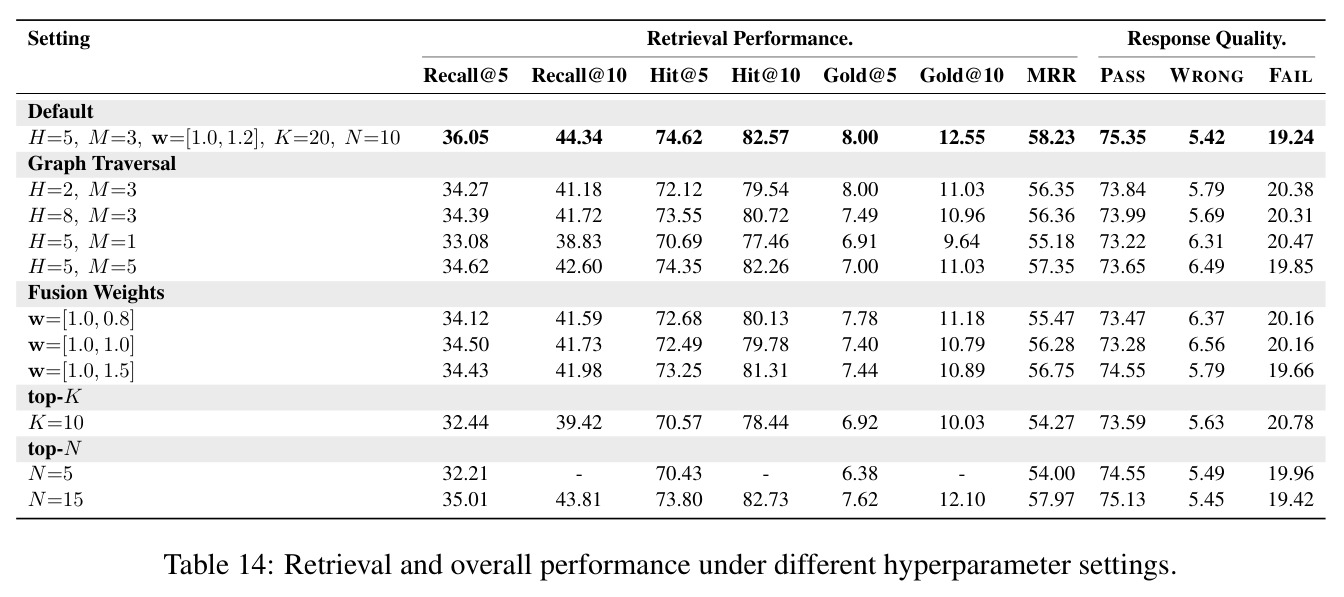
步骤一(离线索引):输入约 2,035 条/实例的原子事实,输出稠密索引、BM25 索引和 $k=10$ 的 kNN 图,0 次 LLM 调用,约 80.78 秒。步骤二(查询规划):冲突规划器以用户查询加参考日期为输入,输出最多 3 条探测线索,覆盖日程、既有承诺、资源可用性等维度。步骤三(多视图生成):生成原始查询和最多 3 条反事实查询,全部以参考日期为条件解析相对时间表达(如 this Friday)。步骤四(混合检索与融合):每条视图分别从稠密、稀疏两路各取 top-10,按权重 $w=[1.0, 1.2]$、参数 $k=60$ 做 WRRF,取融合 top-20;预跳过滤代理从中选出 10 条种子文档。步骤五(多跳遍历):种子作广度优先搜索(BFS)入口,每跳扩展前沿文档的 $M=3$ 个近邻,最深 $H=5$ 跳,汇成候选文档池。步骤六(后跳过滤):对池内全部文档做最终筛选,保留 top-10 最直接决定请求可行性的证据。步骤七(答案生成):整合证据推理,输出能否执行及理由,供三级评分评估。超参敏感性实验(Table 14/15)表明默认配置最优且邻近配置性能稳定。
技术新颖性
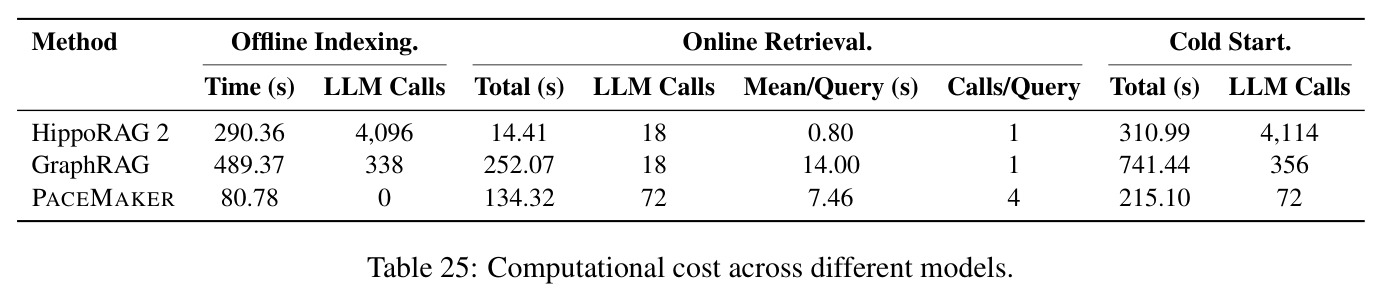
新颖性体现在四个层面。任务层面,首次系统定义『隐性冲突评估』:请求本身正常,冲突只在与知识库联合推理时浮现,既不同于显式安全检测,也不同于偏好遵循。检索层面,把『诊断性证据选择』作为第一目标,并提出反事实查询机制,这是『个性化先于检索』思想在冲突场景的具体化——查询扩展不再是同义改写,而是假设驱动的威胁探测。系统层面,训练无关且模型无关,同一框架在 Qwen3-4B-Instruct、GPT-5.4-mini、Gemini 3.1 Flash-Lite 三种后端上都有效;索引阶段零 LLM 调用(80.78 秒 vs HippoRAG 2 的 290.36 秒/4,096 次调用),冷启动总成本 215.10 秒最低,特别适合个人知识库需要频繁初始化或刷新的场景。数据层面,原子化分解加干扰生成保证金标事实分散且与查询语义弱相关(平均每查询 4.01 条金标、每实例约 18 条查询、约 2,035 条事实),切中了真实个人知识库离散、嘈杂的形态,而质量验证(93.3% 人机一致率)保证了标签可信。
实验结果
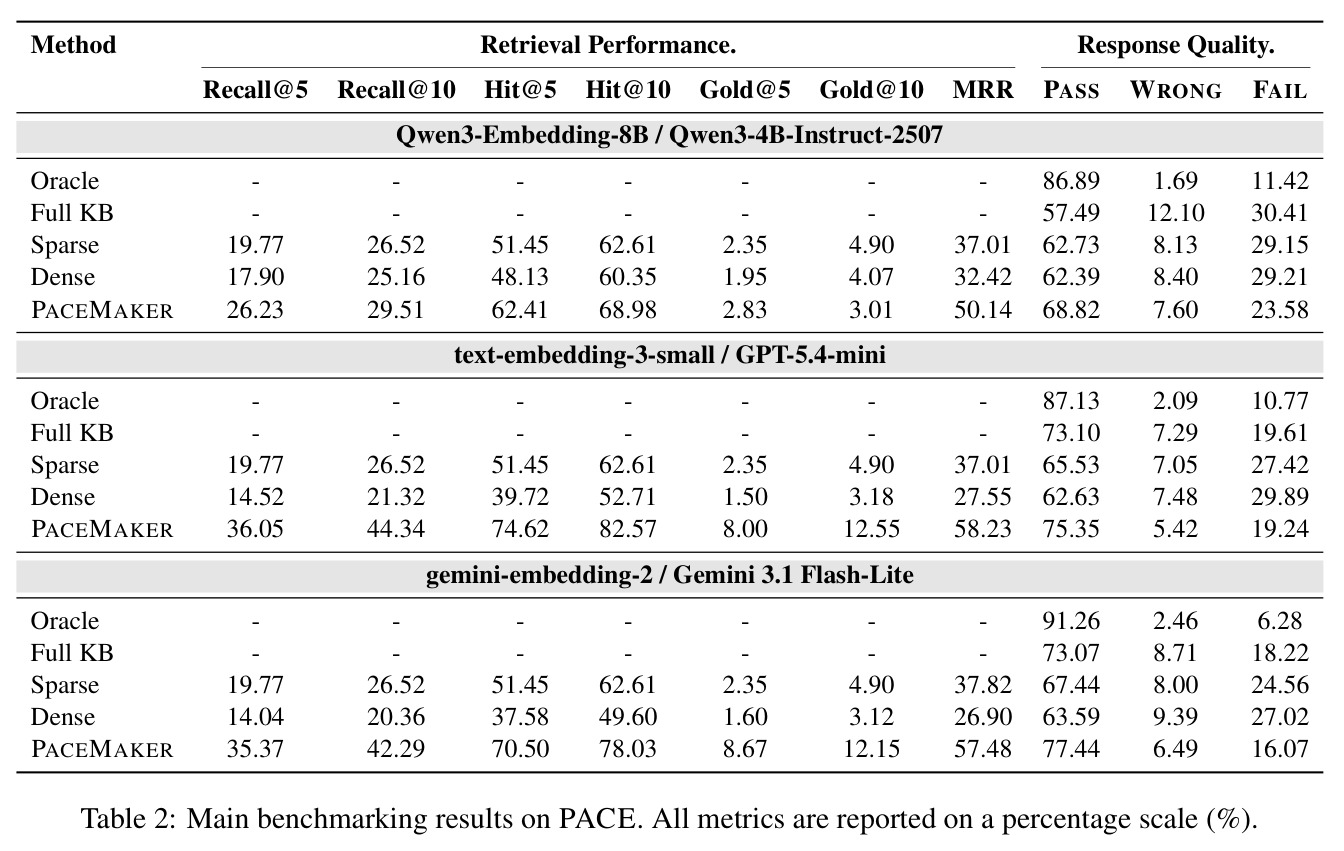
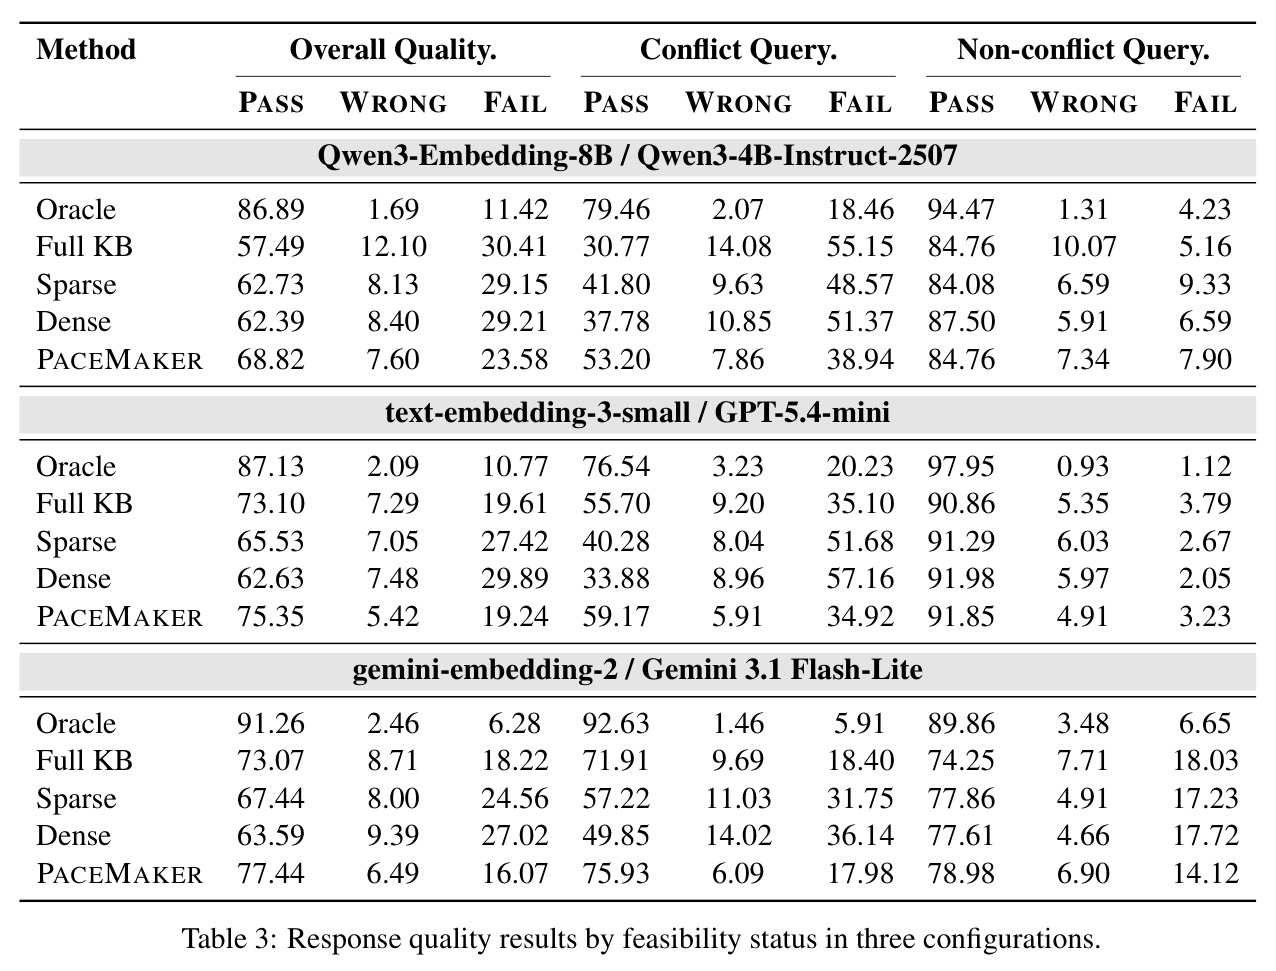
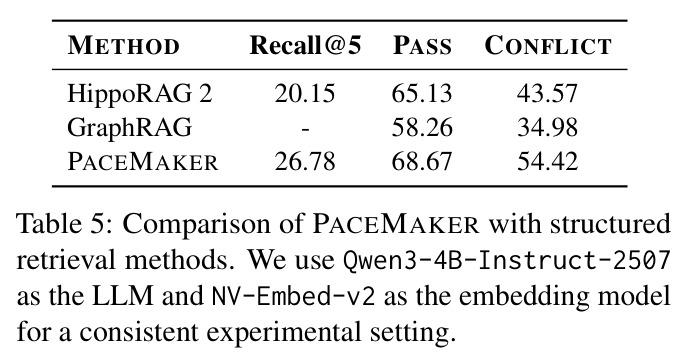
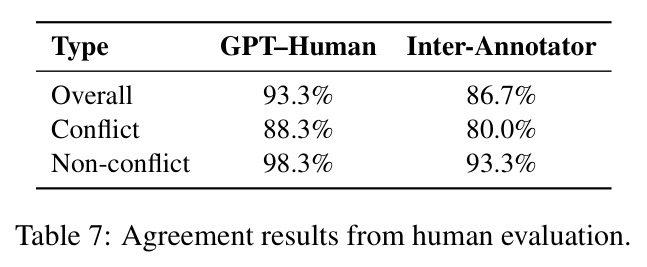
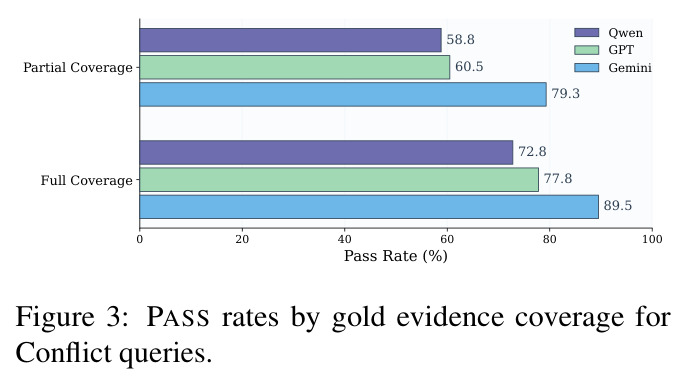
主实验(Table 2)显示 PACEMAKER 在三种配置下全面领先。GPT 配置(text-embedding-3-small + GPT-5.4-mini):Recall@5 从稀疏基线的 19.77%、稠密的 14.52% 提升到 36.05%,Recall@10 达 44.34%,Hit@10 达 82.57%,MRR 58.23;PASS 率 75.35%,高于稀疏 65.53%、稠密 62.63%、全库 73.10%,仍低于 Oracle 的 87.13%。Gemini 配置:PASS 77.44%(Oracle 91.26%),Recall@5 35.37%。Qwen 开源配置:PASS 68.82%,超过稀疏 62.73%、稠密 62.39%、全库仅 57.49%(Oracle 86.89%)。分可行性看(Table 3),冲突查询远难于非冲突查询;PACEMAKER 的 Conflict PASS 比各配置最强非 Oracle 基线分别高 11.40、3.47、4.02 个百分点(Qwen 下 53.20% vs 稀疏 41.80%),同时非冲突表现基本不掉。证据覆盖分析(Figure 3)显示部分覆盖(Hit@10=1 但 Gold@10=0)时 PASS 为 58.8/60.5/79.3,全覆盖(Gold@10=1)时升至 72.8/77.8/89.5,证明凑齐全部金标事实带来决定性增益。消融(Table 4)中去掉多跳遍历伤害最大:Recall@5 从 36.05 跌到 22.48,PASS 从 75.35 跌到 71.65,Conflict PASS 从 59.17 跌到 52.41;去查询规划次之(PASS 73.31),去证据选择影响最小(75.19)。与结构化检索对比(Table 5,统一用 Qwen3-4B + NV-Embed-v2),PACEMAKER PASS 68.67%/Conflict 54.42%,均高于 HippoRAG 2(65.13%/43.57%)和 GraphRAG(58.26%/34.98%),说明挑战不在多跳本身而在朝决定性证据导向的检索。按情境类型(Figures 5-7),时间型查询在所有配置下 PASS 最低,因其需要串联多条时序事实。计算成本(Table 25):PACEMAKER 索引 80.78 秒、0 次 LLM 调用,在线 7.46 秒/查询、4 次调用,冷启动 215.10 秒,优于 HippoRAG 2(310.99 秒)与 GraphRAG(741.44 秒)。数据集质量:可行性标签与人类判断一致率 93.3%,自动裁判与人类一致率 93.5%,跨裁判一致率 86.40%。
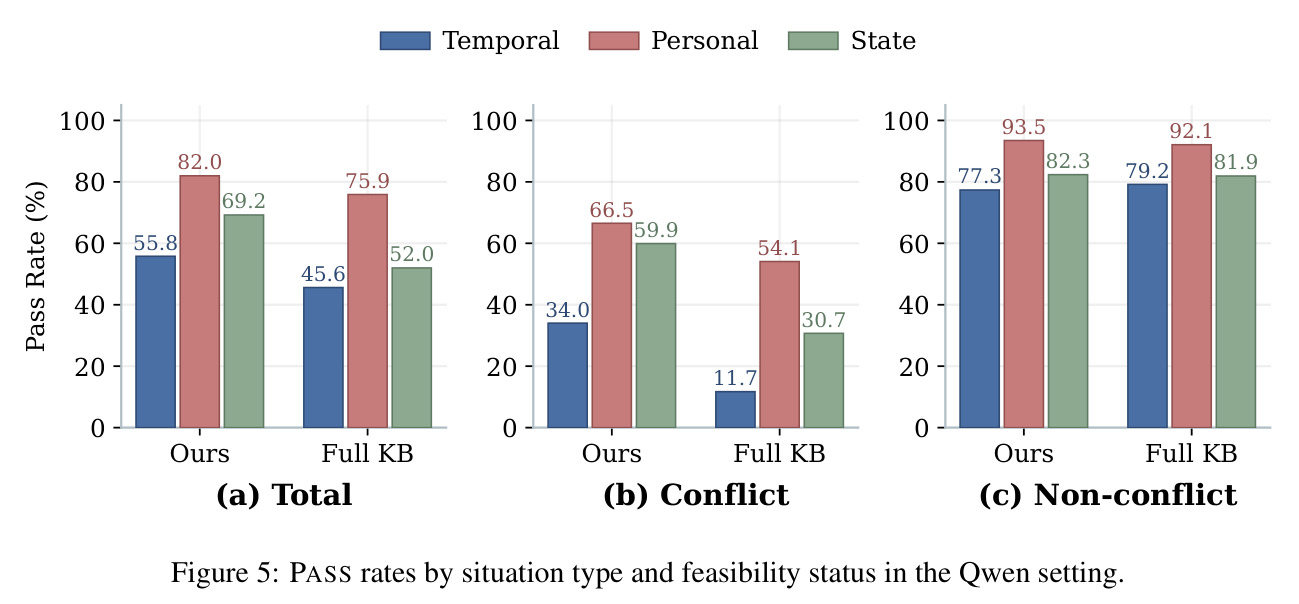
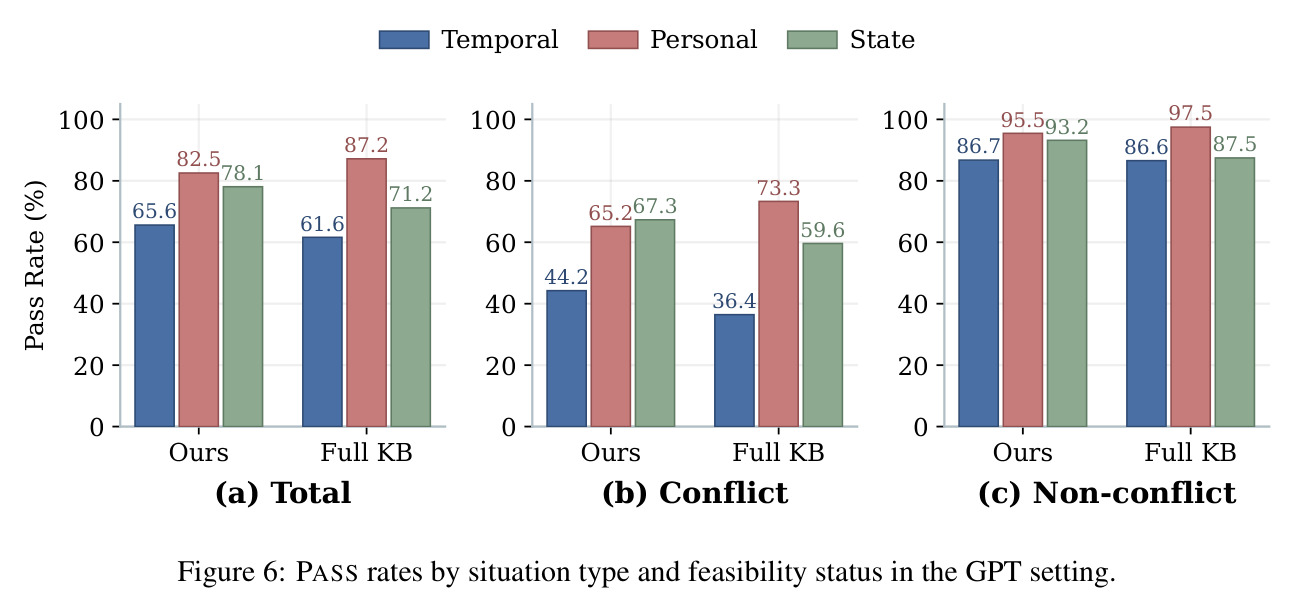
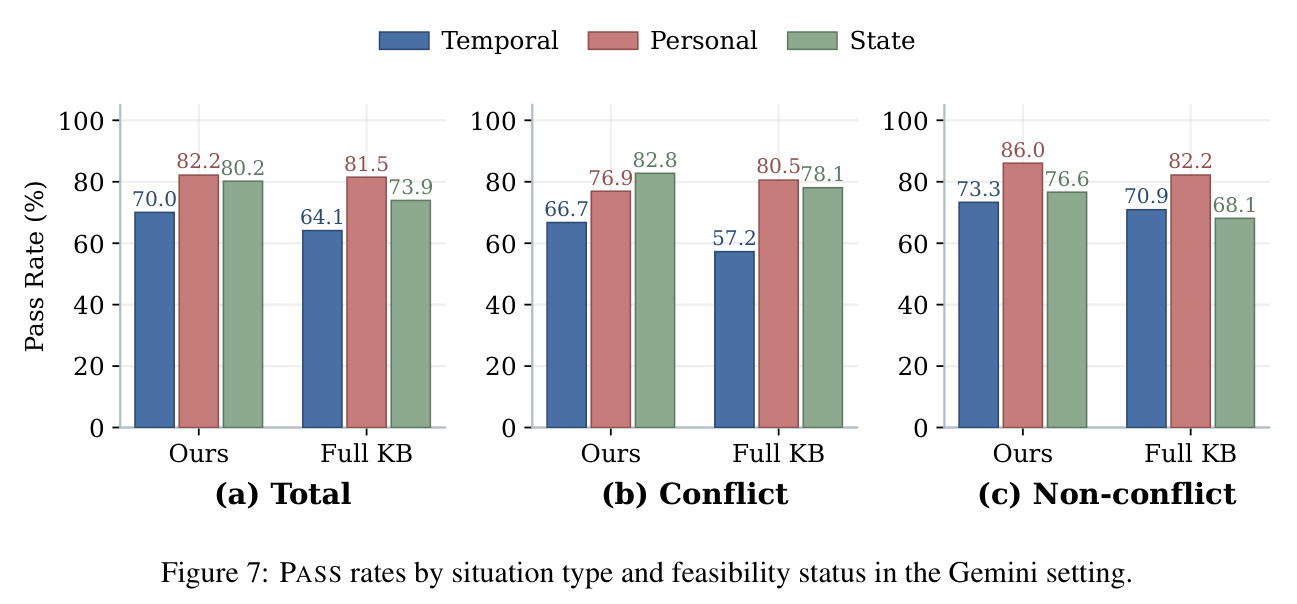
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| PACE 端到端回答质量(GPT 配置:text-embedding-3-small + GPT-5.4-mini) | PASS(%) | 75.35 | 稀疏检索 65.53;稠密检索 62.63;全库 73.10;Oracle 上限 87.13 | 较最强非 Oracle 基线(全库)+2.25 点,较稀疏检索 +9.82 点 |
| PACE 冲突查询回答质量(GPT 配置) | Conflict PASS(%) | 59.17 | 全库 55.70;稀疏检索 40.28;稠密检索 33.88 | 较最强非 Oracle 基线 +3.47 点,较稀疏 +18.89 点 |
| 冲突证据检索(GPT 配置) | Recall@5(%) | 36.05 | 稀疏检索 19.77;稠密检索 14.52 | +16.28 点(vs 稀疏) |
| 冲突证据检索(GPT 配置) | MRR | 58.23 | 稀疏检索 37.01;稠密检索 27.55 | +21.22(vs 稀疏) |
| 与结构化检索对比(Qwen3-4B-Instruct-2507 + NV-Embed-v2) | Conflict PASS(%) | 54.42 | HippoRAG 2 为 43.57;GraphRAG 为 34.98 | 较 HippoRAG 2 +10.85 点 |
| 冷启动成本(含 2,056 条事实、18 条查询的样例实例) | 总时间(秒)与索引期 LLM 调用 | 215.10 秒;索引 0 次 LLM 调用 | HippoRAG 2 为 310.99 秒(4,096 次调用);GraphRAG 为 741.44 秒(338 次调用) | 冷启动最快,索引期零 LLM 依赖 |
| 数据集标签质量(PACE 可行性标签) | 人机一致率(%) | 93.3(GPT 标签 vs 人类);自动裁判与人类一致率 93.5 | 标注员间一致率 86.7 | 标签可靠性达到与人类间一致性相当的水平 |
局限与改进
作者承认两点:基准只评『可行性判断』而非完整任务执行(推荐、日程、规划等下游能力均未覆盖);方法为训练无关设置,未对查询重构、证据选择、图遍历做任务特定优化。我的补充观察:第一,绝对性能仍低——最好的 Conflict PASS 只有 75.93%(Gemini),距 Oracle 91.26% 有约 15 点差距,冲突查询上的 FAIL 率仍达 17.98%–38.94%,离可部署还很远。第二,金标完整召回几乎不随方法改善:GPT 配置下 PACEMAKER 的 Gold@10 仅 12.55%,Qwen 配置下更是只有 3.01%、甚至低于稀疏检索的 4.90%,说明其优势主要靠『命中部分关键证据』而非『找齐全部证据』,与 Figure 3 中全覆盖带来的大幅增益对照后,这意味着还有很大的未兑现空间。第三,流水线多处依赖较强的模型做规划和过滤(闭源设置收益明显高于 Qwen 开源设置),弱模型部署时反事实查询的收益会缩水。第四,数据完全由 GPT-5.4-mini 合成再自审,人工验证只抽样了 120 条查询和 600 条裁判校验实例,可能存在推理模式与文风上的系统性偏置;人工检查还发现人类对可行性倾向于更宽松的解释。第五,在线延迟 7.46 秒/查询约为 HippoRAG 2(0.80 秒)的 9 倍,对交互式助手偏慢。第六,情境类型只有时间/个人/状态三类,缺少金钱、法律、社交礼仪等维度。
独立分析的弱点
弱点一,冲突查询上 FAIL 率仍高(GPT 配置 34.92%、Qwen 配置 38.94%),即近四成案例要么结论就错、要么理由实质偏离金标。改进方向:在答案生成后增加『证据-结论一致性校验』代理,或训练判断校准模块,区分『碰巧正确』与『证据支撑的正确』。弱点二,规划器最多只产出 3 个冲突维度假设,而平均每查询有 4.01 条金标事实,假设空间不足直接限制了反事实查询的覆盖面——这可能是 Gold@K 上不去的根因。改进方向:让规划器输出开放式冲突假设清单并迭代补查,或引入缺失证据检测(识别证据链缺口后定向检索)。弱点三,预跳/后跳过滤是单点串行瓶颈,过滤错误会级联传播到遍历和生成。改进方向:保留多组候选证据集并行生成答案再投票,或用轻量 reranker 替代部分 LLM 过滤。弱点四,评估依赖 LLM-as-judge,虽整体与人类一致率 93.5%,但 WRONG 类分歧最大(90.5%),换 Gemini 裁判时还出现把冲突回答降级为 WRONG 的倾向,理由质量的评判标准并不稳定。改进方向:让模型输出结构化结论(冲突维度、引用的关键事实、结论)再逐项比对,降低自由文本裁决噪声。弱点五,整套方法是为『单请求-单库快照』设计的,没有利用跨请求的历史与 KB 更新信号,长程个性化场景下需要重新设计。
未来方向
作者明确提出的方向:扩展知识库加入更丰富的 persona 世界、可操作实体和动态任务环境,使基准能同时评估冲突感知与端到端个性化任务求解(推荐、日程、规划);对查询重构、证据选择、图遍历、决策校准做任务特定训练以提升性能上限。基于本文成果可延伸的方向:其一,把冲突评估从请求时快照推进到持续监控——KB 更新时主动预测哪些即将到来的承诺会与用户新计划相撞,做成主动式助手(与 Propersim、ContextAgent 等前瞻性助手工作衔接);其二,把反事实查询生成与个性化查询扩展文献结合,学习用户级的冲突模式先验,减少每次从头推理的开销;其三,将 PACE 式推理嵌入 Agent 安全栈,与显式内容安全审查互补,形成『输入安全 + 情境可行性』双层防护;其四,研究冲突解释的措辞与用户接受度——如何礼貌拒绝并给出替代方案(如 Figure 1 中『另找一家 7-8 点两人都能吃的餐厅』),这涉及人机交互与对齐;其五,多用户场景:冲突证据可能来自多个 alter 且涉及隐私边界,可研究跨用户知识约束下的冲突检测与信息隔离。
复现评估
复现友好度较高。代码与数据已在 GitHub 开源,数据集 3,249 条查询、376,448 条事实规模适中;附录 E 完整公开了 persona 扩展、档案合成、查询/上下文生成与验证的全部 prompt,数据生成路径清晰可复刻,但生成依赖 GPT-5.4-mini,换用其他模型可能产生分布差异且需一定 API 费用。方法本身训练无关,部署只需一个 embedding 模型加四个 LLM 代理;开源设置用 vLLM 在 4 块 NVIDIA RTX A6000 上即可运行,闭源设置需 OpenAI/Gemini API(约 3,249 查询 × 每查询 4 次流水线调用,外加评估调用,量级可控)。索引每实例约 81 秒、单查询在线约 7.5 秒,全套实验在普通实验室算力内可完成。人工评估部分(MTurk 600 条 × 3 标注员,要求 1 万+ HIT、98%+ 通过率)如需复现要额外预算,但自动指标足以验证主要结论。整体难度中等:工程链路较长(五阶段流水线,超参 $k=60$、$w=[1.0,1.2]$、$H=5$、$M=3$、$K=20$、$N=10$ 需对齐),无训练环节,主要风险是闭源模型版本差异带来的数值波动;论文已提供超参敏感性(Table 14/15)与换裁判(Table 8)、换 embedding(Table 16/17)的稳健性分析,降低了复现的不确定性。
论文图表
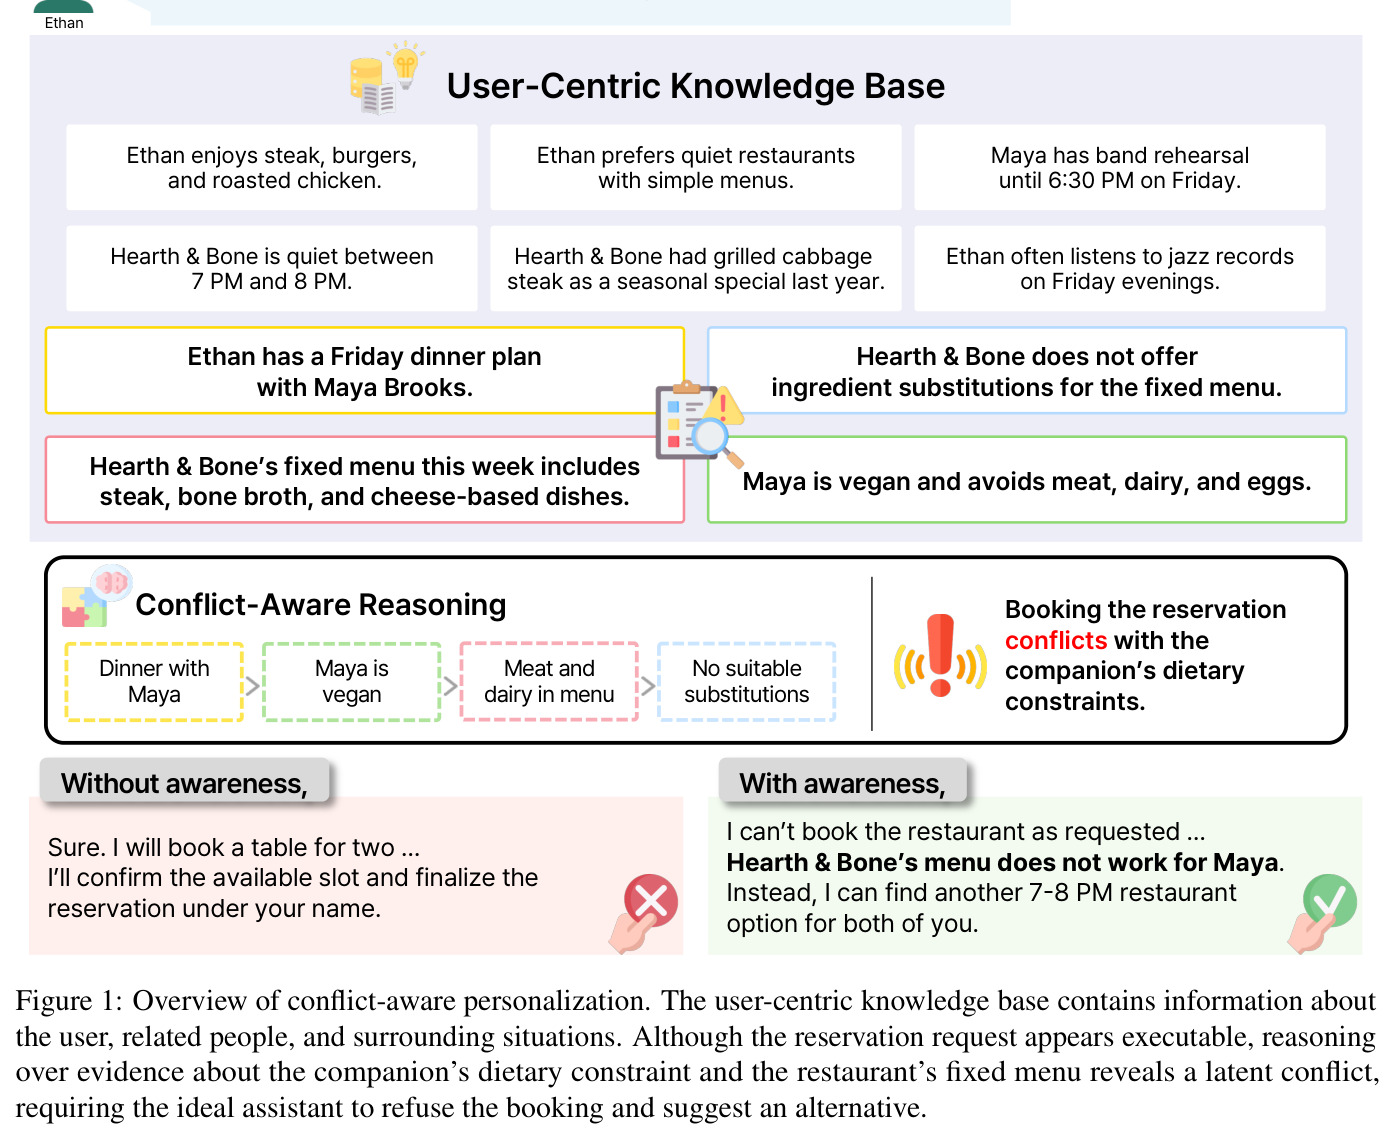
以 Ethan 请助手在周五 7-8 PM 于 Hearth & Bone 订两位为例,展示用户中心知识库中的多条事实(Ethan 喜欢牛排、偏好安静餐厅、周五晚与 Maya 有约、Maya 是纯素食者、该店本周为固定菜单且不接受换菜等),并对比无感知助手直接预订与有感知助手识别『同伴饮食约束 + 固定菜单』冲突后拒绝并提出替代方案两种行为。
一图讲清整篇论文要解决的问题:请求本身完全正常,冲突只在知识库多条事实组合推理后才浮现,这是理解任务定义和后续所有设计的起点。