2026 PNPL 竞赛:LibriBrain100 中的词分类与高效跨被试泛化 The 2026 PNPL Competition: Word Classification and Efficient Cross-Subject Generalisation in LibriBrain100
以 MEG 词分类为核心的非侵入式语音解码竞赛,设单被试深度与跨被试泛化双赛道
前置知识
脑磁图(MEG)
一种非侵入式脑成像技术,通过测量神经元同步电活动产生的微弱磁场来记录大脑活动。时间分辨率达毫秒级,空间精度典型为 5–10 mm、最佳可达 2–4 mm,接近侵入式 ECoG 却无需开颅手术,并能覆盖全脑,而植入电极只能采样有限的皮层区域。
本文任务的输入就是 306 通道的 MEG 时间序列,竞赛的数据规模与双赛道设计都建立在 MEG 的时空精度优势之上。
脑机接口(BCI)
将神经活动直接转译为输出信号(文字、语音或控制指令)的系统。语音 BCI 分为侵入式(植入电极,性能强但需开颅、数据难规模化)与非侵入式(MEG/EEG 等,安全但信噪比低);第一个侵入式语音 BCI 流水线由词分类、语音检测与语言模型三部分构成。
竞赛的终极目标是让重度瘫痪者用非侵入手段恢复交流,理解这一临床动机才能读懂 Broad 赛道把校准数据压到 10 分钟的设计。
Top-10 平衡准确率(BAcc@10)
检索式词分类的主指标:对 $K=50$ 的固定词表,模型输出 top-10 候选,按类计算 Recall@10 再取平均:$\mathrm{BAcc}@10 = \frac{1}{K}\sum_{k=1}^{K} \mathrm{Recall}@10_k$。平衡化使每个词贡献相等、不受出现频率影响。随机猜测期望为 $10/50=20\%$,100% 表示正确词总在前 10。
排行榜与最终排名都以它为准,论文中所有基线分数(73.23%、42.96%)都必须对照 20% 的随机线来解读。
跨被试泛化与零样本泛化
跨被试泛化指模型能否迁移到训练时未见的新被试;零样本泛化更严格,要求完全不使用该被试的任何校准数据直接预测。由于个体脑解剖与信号模式差异巨大,这是非侵入解码最难、也最具临床价值的设定。
Broad 赛道的 40/20/10 分钟分层数据梯度与 8 名零样本保留被试正是围绕这一概念设计的。
OVMI(开放词表互信息)
开放词表互信息是信息论指标:$\mathrm{OVMI}(S)=C(S)\,I(X;Y \mid X \in S)$,其中 $C(S)$ 是检索词表对参考词频分布(竞赛用 SUBTLEX-UK)的覆盖率,$I$ 是意图词 $X$ 与解码输出 $Y$ 在词表内的互信息,单位为比特/词,随机水平为 0。它同时惩罚解码错误与词表覆盖不足。
BAcc@10 强烈依赖词表选择,OVMI 是论文推荐的跨研究可比辅助指标,读懂 Broad 赛道基线的低分必须借助它。
研究动机
非侵入语音解码领域正陷入“有进展、难比较”的困境。侵入式脑机接口性能惊人:从 Moses 等 2021 年首次解码连通语音,到 Willett 等 2023 年词汇量突破 125,000 词,再到 Card 等 2024 年词错率(WER)降至 2.5%,已优于人类转录约 5–10% 的水平,但开颅手术风险与逐患者采集难以规模化使其无法普及。非侵入的脑磁图(MEG)以毫秒级时间分辨率和 5–10 mm(最佳 2–4 mm)空间精度被视为最有希望的替代,近年解码研究不断涌现,却因缺乏共享基础设施(公共数据集、固定评测划分、标准指标、基线代码)而难以积累。以词分类为例:不同研究各自选用语料库中最频繁的 K 个词作目标词表,即便指标相同也不可比,且高频词多为交际价值有限的功能词。更关键的是,整个领域(包括最先进的侵入系统)几乎都只在单一被试上训练与评测,而实用 BCI 必须用几分钟而非几十小时的数据适应新用户——跨被试泛化恰恰是临床部署的真正瓶颈。
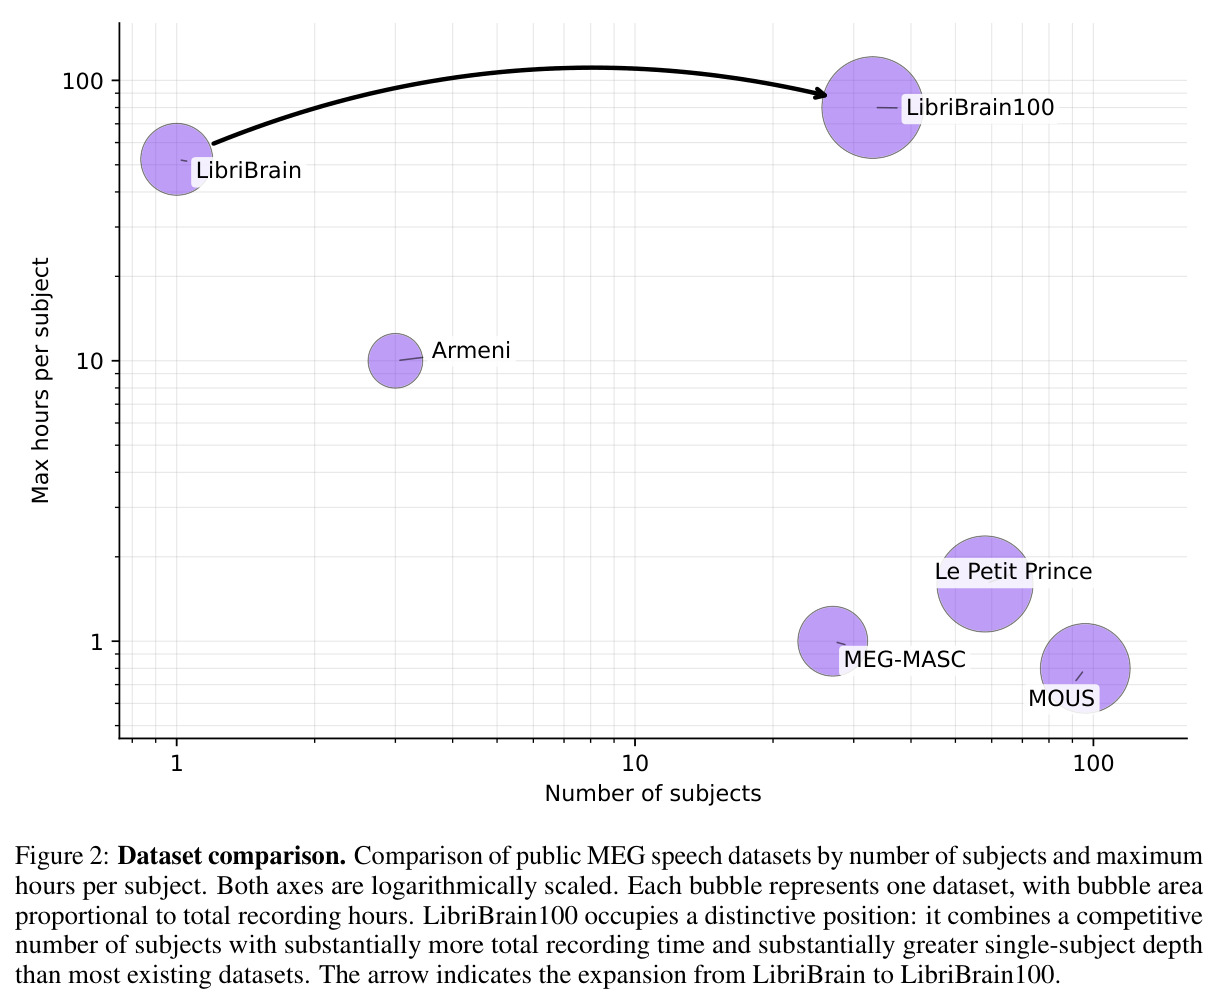
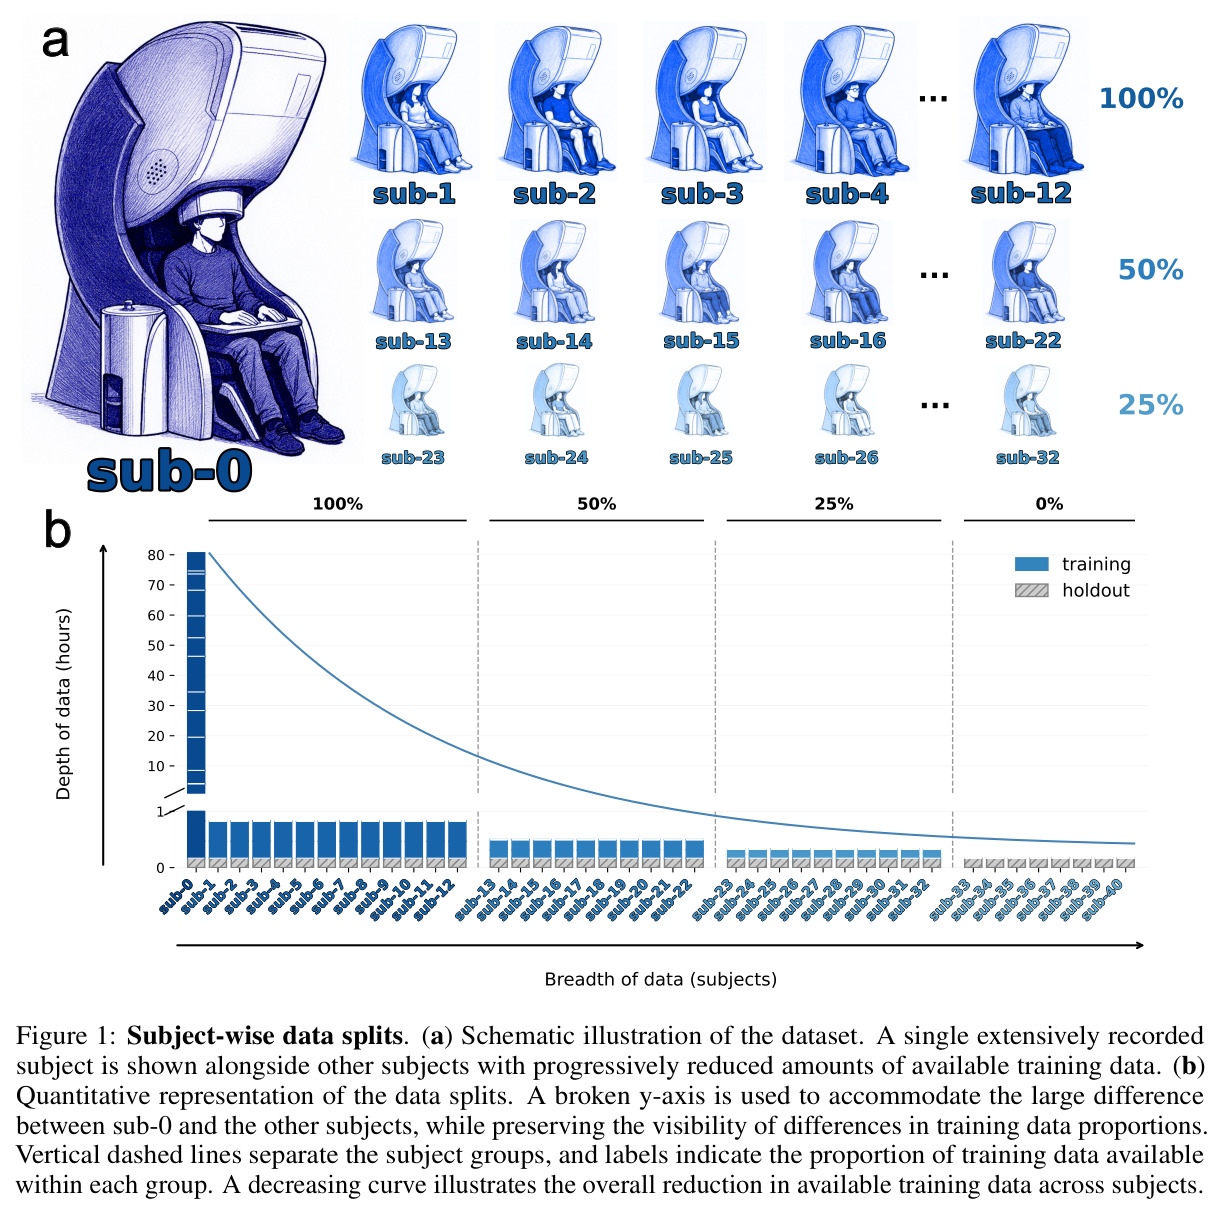
本文的目标是本文的目标是通过 2026 年 PNPL 竞赛建立非侵入语音解码的社区基础设施,把分散的研究拧成一股绳。具体包括:(1) 发布扩展数据集 LibriBrain100,将原 LibriBrain 单被试(被试 0)数据扩展到约 80 小时(迄今最深的单被试 MEG 数据集),并新增 32 名被试各约 40 分钟录音,共 33 人;(2) 把任务课程推进到词分类,设立两条赛道——Deep 赛道追求单被试(被试 0)上的极致解码性能,Broad 赛道评测跨被试泛化,被试特定数据从约 40 分钟递减到 20、10 分钟(10 分钟处于临床可行范围),另有 8 名被试完全不提供训练数据以评测零样本泛化;(3) 建立统一评测:自定义 50 词竞赛词表上的 Top-10 平衡准确率为主指标,辅以 Moses 50 词表与开放词表互信息 OVMI;(4) 配套 pnpl 库、参考模型 checkpoint、Colab 教程、Kaggle 提交平台与公开排行榜,让没有神经科学背景的机器学习研究者也能低门槛参与。
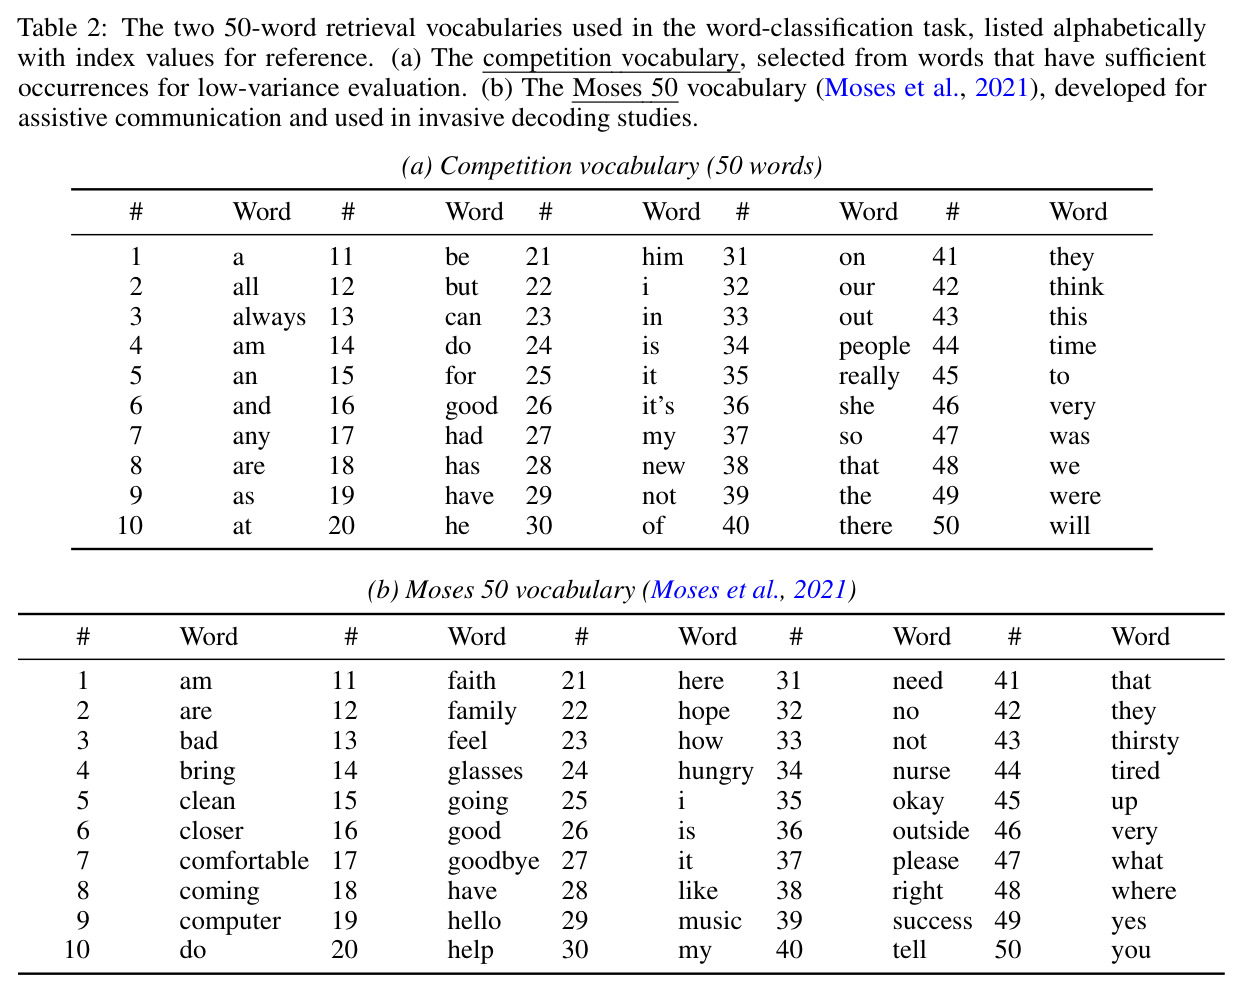
与已有工作不同的是,本文的独特切入角度有三。其一,课程式任务设计:2025 年首届 PNPL 竞赛从最简单的语音检测(二元分类)与音素分类起步,获胜方案分别达到 F1-macro 95.6% 与 73.6%;2026 年顺势推进到词分类,它比开放词表 brain-to-text 结构化得多(后者 2025 年才首次超过随机水平),又首次触及词汇与语义信息,是与首个侵入式语音 BCI 流水线(词分类+语音检测+语言模型)对应的可靠中间靶点。其二,首次把跨被试泛化作为显式竞赛目标:连 Willett、Card 等 SOTA 侵入系统都是单被试训练评测,Broad 赛道以 40/20/10 分钟梯度与零样本保留被试直接模拟临床约束,为数据高效泛化提供全新评测范式。其三,评测协议创新:固定竞赛词表解决可比性、Moses 50 词表衔接侵入文献、OVMI 信息论指标跨越不同词表横向比较——三管齐下,直击词分类“词表决定成绩”的顽疾。
核心方法
这篇论文本质是一份竞赛说明书,其“方法”是评测基础设施的系统性设计。直觉是:一个领域要积累式发展,光有更好的模型不够,还需要公共数据、固定划分、标准指标和可复现基线。技术路线如下:数据层面,LibriBrain100 以 HDF5 存放 MEG 信号、TSV 存放标签,在 Hugging Face 上以 libribrain 与 libribrain2 两个仓库发布(含序列化 HDF5 与未预处理 FIF 原始格式,后者含头动伪迹且体积大);任务层面,形式化为给定 MEG 窗口 $x \in \mathbb{R}^{306 \times T}$(306 个传感器 × T 个时间样本),预测被试正在听到的词 $y \in V$,$V$ 为固定的 50 词检索词表;评测层面,holdout 标签不公开、只发布录音供参赛者上传预测,且划分为持续更新排行榜的分区与最终排名独立分区以防过拟合;工程层面,pip install pnpl 即可自动按需下载数据并得到标准 PyTorch DataLoader,三个 Colab 教程可在免费 GPU 上完成从数据加载到提交的全流程。
核心创新是“双赛道 + 分层数据协议”的竞赛结构。Deep 赛道榨干被试 0 约 80 小时的史上最深单被试 MEG 数据,允许使用任何数据训练,目标是推动非侵入词分类的性能极限;Broad 赛道则把临床约束编码进数据划分:12 名被试释放约 40 分钟、10 名约 20 分钟、10 名约 10 分钟的被试特定数据(10 分钟正是临床上可接受的采集时长),另有 8 名被试(33–40)不释放任何训练数据,专用于零样本跨被试泛化评测——这是最具临床价值也最严苛的区域。与已有工作的本质区别在评测协议:以往词分类研究各用各的高频 K 词词表,成绩不可比;本文固定竞赛词表并显式公开,同时并行追踪侵入文献通用的 Moses 50 词表,再以 OVMI 度量“解码质量 × 词表覆盖率”的联合信息量,使不同词表的结果可以放在同一把信息论的尺子下比较。
方法步骤详情
流程分五步。(1) 数据构建与分层释放:33 名被试听自然语音,被试 0 扩展至约 80 小时;被试 1–32 各录约 40 分钟,按 40/20/10 分钟分层释放;被试 33–40 仅提供无标签 holdout 录音。(2) 任务形式化:输入为 $306 \times T$ 的 MEG 窗口,输出为 50 词表上的 top-10 词预测。(3) 指标计算:主指标 $\mathrm{BAcc}@10 = \frac{1}{K}\sum_{k=1}^{K}\mathrm{Recall}@10_k$($K=50$,随机水平 20%),辅以 BAcc@1(随机 2%)破平局;OVMI 单位为比特/词。(4) 基线设定:Deep 赛道用被试 0 全量数据复现 d'Ascoli 等 2025 监督模型;Broad 赛道用 MEG-XL——约 800 名被试、约 300 小时 MEG 上自监督预训练的基础模型——以半个 session 微调、另一半验证。(5) 参与:pnpl → Colab 教程 → 生成 holdout 预测 CSV → 上传 Kaggle → 排行榜更新。
技术新颖性
技术新颖性体现在四个“首次”。其一,词分类首次被标准化为竞赛任务:词是事实上的开放集合,词表的选择(而不仅是大小)直接改变成绩——自定义高频 K 词词表最大化训练样本与表面分数却不可比,Moses 50 支持跨研究对比却可能在语料中词例稀少;本文同时报告三种互补评测并建议领域采纳,本身就是对评测学的贡献。其二,跨被试泛化首次成为竞赛目标,且这是首个基于大规模多被试 MEG 数据集的竞赛,零样本保留被试的设计在同类基准中独一无二。其三,参考模型的挑选本身反映了领域最新认识:被试内数据充足时监督模型(d'Ascoli)更强,每被试数据稀缺时自监督基础模型 MEG-XL 的预训练先验优势显著,两条赛道各配最合适的基线。其四,与侵入式 Brain-to-Text '24 竞赛对照,本文坚守非侵入 MEG 路线,明确将 Brain2Qwerty 等打字解码排除在外(手指瘫痪者无法受益),坚持面向真实患者的课程式路线图。
实验结果
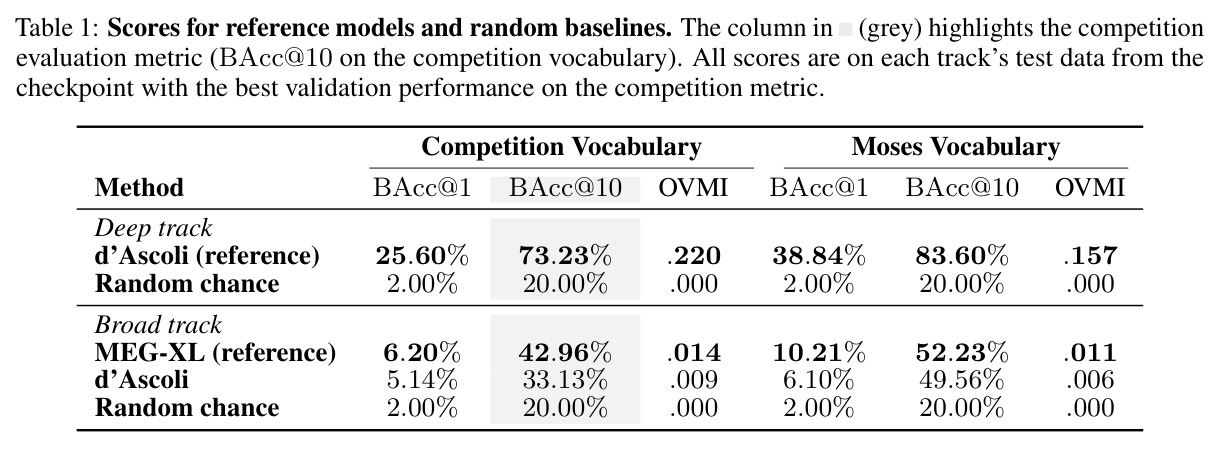
定量结果集中在参考模型基线(Table 1),为验证集最佳 checkpoint 在测试数据上的分数。Deep 赛道:d'Ascoli 监督模型用被试 0 全量数据训练,竞赛词表 BAcc@10 达 73.23%(随机 20%)、BAcc@1 25.60%、OVMI 0.220 比特/词;Moses 50 词表上更高,BAcc@10 83.60%、BAcc@1 38.84%、OVMI 0.157。Broad 赛道:MEG-XL 微调后竞赛词表 BAcc@10 42.96%、BAcc@1 6.20%、OVMI 仅 0.014;Moses 词表 BAcc@10 52.23%;同赛道的监督 d'Ascoli 模型只有 BAcc@10 33.13%、BAcc@1 5.14%、OVMI 0.009——每被试数据稀缺时自监督预训练带来约 9.8 个百分点的优势,印证基础模型先验价值。两赛道 73.23% 对 42.96% 的落差定量刻画了跨被试泛化难度。2025 年竞赛已吸引 15 国 155 支队伍、6,041 次提交,LibriBrain 至 2026 年 4 月下载超 16,000 次。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Deep 赛道:单被试(被试 0)词分类 | BAcc@10(竞赛 50 词词表) | 73.23%(d'Ascoli 参考模型) | 随机猜测 20.00% | +53.23 个百分点 |
| Broad 赛道:跨被试词分类 | BAcc@10(竞赛 50 词词表) | 42.96%(MEG-XL 参考模型) | 同赛道 d'Ascoli 监督模型 33.13% | +9.83 个百分点 |
| Deep 赛道:Moses 50 词表词分类 | BAcc@10 | 83.60% | 随机猜测 20.00% | +63.60 个百分点 |
| Broad 赛道:跨被试词分类 | BAcc@1(竞赛 50 词词表) | 6.20%(MEG-XL) | d'Ascoli 5.14%;随机猜测 2.00% | +1.06 个百分点(相对监督基线) |
局限与改进
作者承认的局限:BAcc@10 无法区分正确词排第一还是第十,故需 BAcc@1 破平局;持续提交可能过拟合排行榜分区,因此设置独立的最终排名分区。我自己的观察:其一,Broad 赛道基线离可用尚远——BAcc@10 42.96% 看似两倍于随机,但 BAcc@1 仅 6.20%、OVMI 只有 0.014 比特/词,说明每词可传递的信息量仍极小;其二,零样本组(被试 33–40)没有任何基线报告,最 clinically 相关的区域反而是基线数据最缺的区域;其三,基线微调协议保守(仅用 Sherlock 1 Session 1 的一半数据),被试 0 与被试 1–32 联合训练等更优策略被明确留给参赛者,参考分数可能低估可达到的上限;其四,20 名被试各只有 10–20 分钟数据,跨被试结论的统计功效有限;其五,holdout 语料来源不公开,外部有效性(换语料库后是否成立)无法检验;最后,所有结论都基于听自然语音的健康被试,距离瘫痪患者的真实部署仍有距离。
独立分析的弱点
独立分析的弱点与改进方向:(1) 单被试与跨被试的性能鸿沟(BAcc@10 73.23% vs 42.96%)表明当前模型严重依赖被试特异性特征,改进方向是被试不变表征学习、域对抗训练或测试时自适应(如熵最小化类方法),让 10 分钟校准数据专注于个体对齐而非从头学习;(2) MEG-XL 预训练语料约 300 小时/800 被试,相对视觉与语言基础模型仍很小,Broad 赛道 OVMI 接近 0 说明跨被试可迁移信息存在严重瓶颈,可扩大多被试多中心预训练并引入 EEG–MEG 跨模态联合训练;(3) 词表仅 50 词且随机底线高达 20%,容易高估表面进展,建议以更大词表或以 OVMI 为主报告;(4) 评测假设“被试在听”,而真实 BCI 还需把语音检测(2025 任务)与语言模型衔接起来,本届未将三者串成端到端流水线;(5) 竞赛周期仅三个月(2026-07-15 至 10-15),涉及大型基础模型的系统性改进可能来不及充分展开,赛后数据全量释放才能支撑更深入的研究。
未来方向
作者提出的后续工作:竞赛结束后释放被试 1–32 的全量约 40 分钟数据;组委会将独立开展赛后结果分析;获胜方案经核验后将被公开,并鼓励向 pnpl 仓库贡献数据加载器、可复用基线与文档。基于本文成果可延伸的方向:其一,把 2025 年的语音检测与本届词分类拼接成连续语音解码流水线,逼近非侵入 brain-to-text(Jayalath 等 2025a 已首次报告显著优于随机的词错率);其二,面向 10 分钟校准的临床目标,系统研究少样本/元学习式被试适配以及零样本解码的性能极限;其三,把 MEG-XL 类自监督基础模型扩展到更多被试与更多任务层级(语音检测、音素、词、句子),检验缩放定律在神经数据上是否成立;其四,开展跨数据集泛化验证,例如与 Brain2Qwerty 等打字范式数据比较,界定“听”与“说/打字”解码的表征共享程度;其五,与侵入式系统在 Moses 50 上正面对标,量化非侵入与侵入路线的真实差距,为临床转化路线图提供依据。
复现评估
复现性非常好,是这篇基准论文最突出的优点之一。数据完全公开:Hugging Face 上 libribrain 与 libribrain2 两个仓库提供序列化 HDF5 与原始 FIF 两种格式;pnpl 库一条命令安装(pip install pnpl),自动按需下载并给出标准 PyTorch DataLoader,无需了解底层仓库结构。代码与模型公开:参考模型代码与 checkpoint 在 GitHub(如 neural-processing-lab/MEG-XL),Deep 赛道基线对应 d'Ascoli 等 2025 的监督词解码模型。教程友好:三个 Colab notebook(数据加载与被试 0 微调、跨被试微调、holdout 预测与提交)均可在免费 GPU 上运行;提交走 Kaggle 平台自动评测 CSV 预测文件。算力门槛低,Colab 免费 GPU 即可起步并明显超过随机基线,但要用满 80 小时数据冲击 Deep 赛道 73.23% 的基线,可能需要可观算力。整体复现难度:入门到中等,非常适合作为 MEG 解码方向的练手基准。
论文图表