ExecRetrieval:度量代码嵌入检索中的功能正确性鸿沟 ExecRetrieval: Measuring the Functional-Correctness Gap in Code-Embedding Retrieval
把执行验证的单编辑缺陷变体植入检索池,暴露嵌入检索rank-1的功能辨别短板
前置知识
稠密嵌入检索
把查询与候选分别编码为固定维向量,用余弦相似度(对 L2 归一化向量等价于内积)排序候选的检索范式。第一阶段用 ANN 索引快速召回 top-k,再交给 reranker 或下游执行验证精筛,是 RAG 与代码搜索的主流架构。
论文测的正是这一架构:23 个稠密嵌入配置在同一含近克隆的池上的 rank-1 排序能力,即候选召回阶段传递给下游多少辨别负担。
exec@k 与 execution_precision@k
以执行结果裁决的检索指标。$\mathrm{exec@k}(q)=\mathbb{1}[\exists\, i \le k:\ \mathrm{PASS}(\hat{r}_i, T_q)=1]$,即 top-$k$ 中存在通过查询测试套件 $T_q$ 的片段;$\mathrm{execp@k}$ 是 top-$k$ 中通过者的比例,另配 canonical-ID nDCG 作对照。
这是论文的核心指标族;exec@10=1.00 与 exec@1=0.331 的悬殊对比就是全文主结论的直接来源。
变异测试
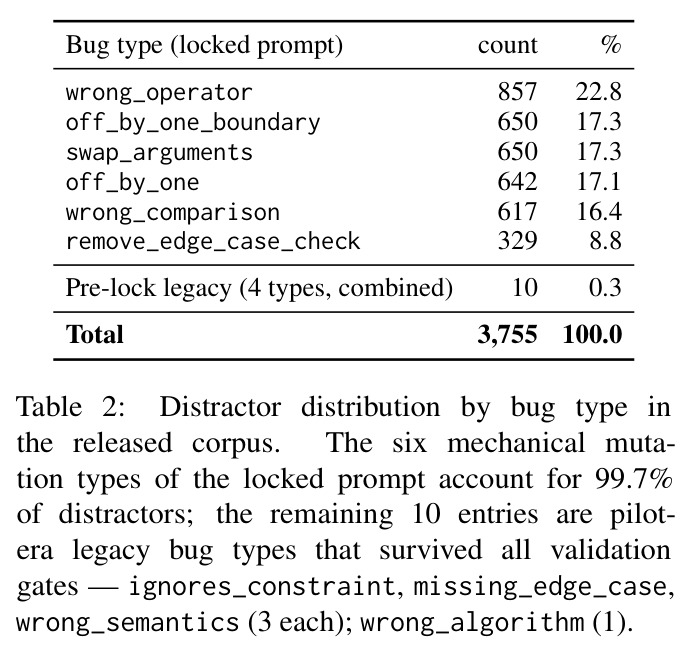
对程序施加小机械变换(换算子、删边界 guard、换比较符等)生成 mutant,用“好测试应杀死 mutant”来评估测试质量。本文对应六类:off_by_one、wrong_operator、swap_arguments、remove_edge_case_check、wrong_comparison、off_by_one_boundary。
论文借其纪律构造 distractor:每个错误实现都是对 canonical 的单一可归因编辑,使检索失败能精确归因到那一次编辑。
McNemar 检验与配对 bootstrap
比较同一批查询上两个系统二元结果(exec@1 成败)的精确检验:只统计两者结论不一致的查询数来判断差异是否显著;查询级 bootstrap(重采样 939 条查询 5,000 次)给出指标置信区间。
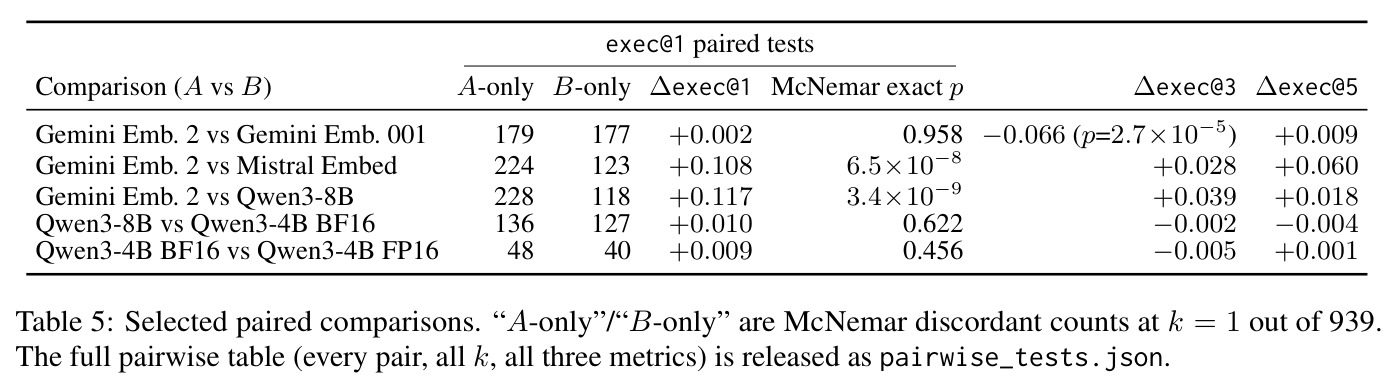
论文所有模型对比都基于它,例如 Gemini Embedding 2 与 001 在 exec@1 上 p=0.958 不可区分,但在 exec@3 上 $p \approx 2.7\times10^{-5}$ 显著分化。
近克隆与 hard negative
近克隆指与目标实现几乎相同(此处仅差一个编辑)但语义不同的代码;hard negative 指检索训练或评测中与查询高度相似、却应排在正确答案之后的负例,是对模型分辨力的最强考验。
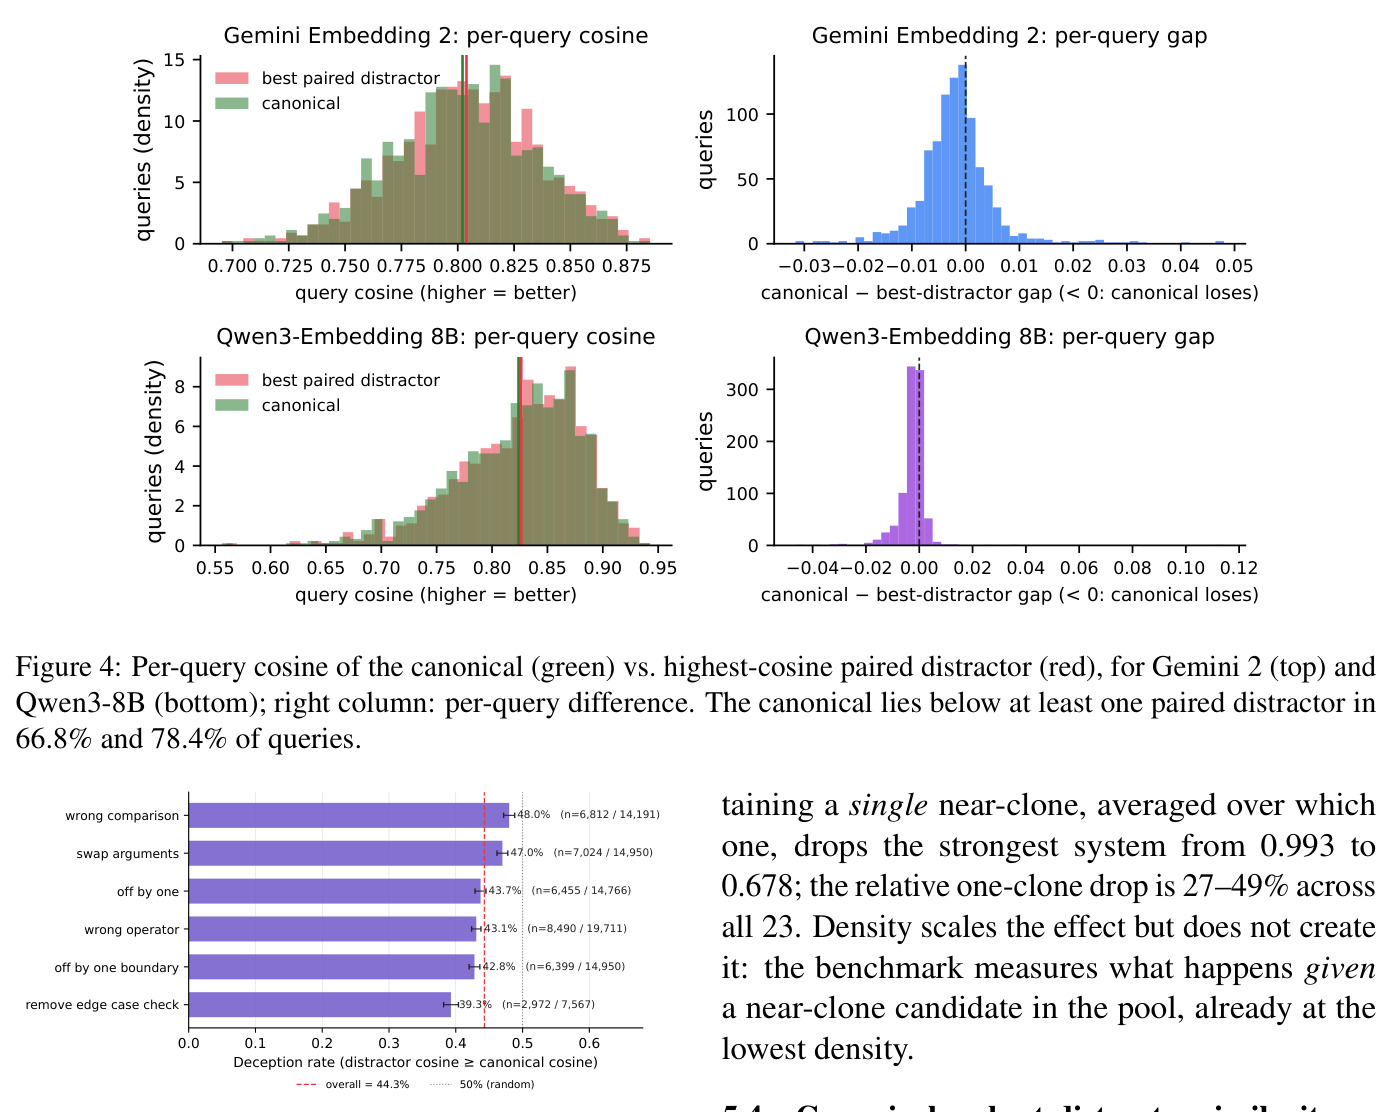
论文证明现有嵌入对这种最强负例失去分辨力——canonical 在 67–78% 的查询上余弦低于至少一个近克隆缺陷变体。
研究动机
嵌入检索已是编码助手与 RAG 代码生成的核心组件:IDE 用它定位历史函数,agent 从本地仓库和开源语料召回候选,rerank、执行与测试在下游兜底。但现有代码检索基准全都测不到“功能正确性辨别”这一轴:CodeSearchNet(99 条查询约 4,000 条人工相关标注)、CoSQA(20,604 对人工标注)、CodeXGLUE、CoIR 聚合套件与 CodeRAG-Bench 都按身份匹配或主题相似度打分,搜索池里没有和正确实现近乎相同却语义相反的错误候选。于是一个只做主题匹配的检索器与一个真正能分辨功能正确性的检索器在这些基准上得分完全一致。而真实场景恰恰会出现这种候选:agent 循环缓存的失败尝试、复制粘贴后分叉的工具函数(研究显示 GitHub 约 70% 文件是文件级克隆、约 52% 克隆组含不一致修改)。当池里有一个与 canonical 仅差一次编辑的 buggy 变体时,嵌入能否仍把通过测试的实现排到第一,此前从未被受控测量过。
本文的目标是本文要构建并操作化一个“功能接地”的代码检索基准 EXECRETRIEVAL,使其满足四个性质:(i) 每个查询的搜索池同时包含已知正确的实现与少量近克隆错误变体;(ii) 正确性由确定性执行测试裁决而非人工标注;(iii) 覆盖十个算法域与六种机械变异类型,使失败无法归因于单一域或单一 bug 模式;(iv) 支持逐查询配对统计(配对 McNemar 精确检验与查询级 bootstrap 区间),让系统在同一输入上可比。在此之上,用 23 个稠密嵌入配置加 BM25、按各家 provider 文档的原生最佳调用方式评测,报告 $k \in \{1,3,5,10\}$ 的 exec@k、execution_precision@k 与 canonical-ID nDCG,回答一个具体问题:当每个查询都配有近克隆反事实时,现代嵌入模型能否仍把通过测试的实现放到排序顶部。
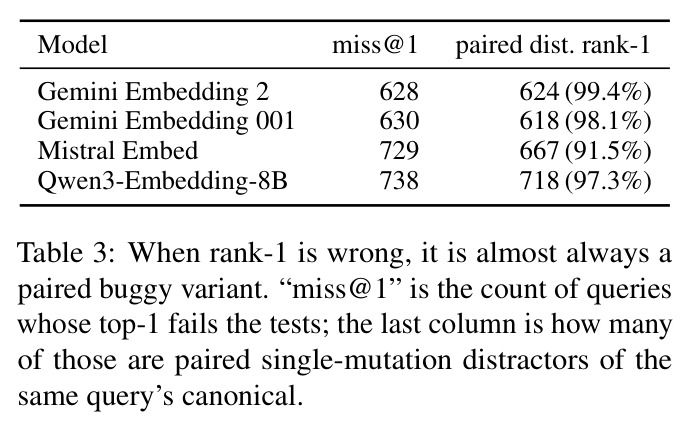
与已有工作不同的是,独特切入点是把“反事实”直接种进检索池本身。最接近的先前工作都没做到这一点:CoQuIR 用在线评测判定与 Defects4J 缺陷对给自然代码打正确性标注,变体并非为每个查询定制的受控编辑;xCodeEval 以错误提交为负例做 NL-to-code 执行评测;Li et al. (2025b) 用 LLM 合成语法相似、功能不同的 Type-IV 变体,验证后作为微调数据并以代码到代码方式评测。EXECRETRIEVAL 则为每个查询自己的 canonical 机械生成单编辑 mutant 并植入自然语言检索池,使每一次 rank-1 错误都可归因到一个具体、可执行检验的编辑(实测 rank-1 miss 中 91.5–99.4% 正是配对 mutant)。这把“嵌入是否理解代码语义”的模糊之争,转换成“嵌入对一个 token 之差是否符号敏感”的可精确测量问题。
核心方法
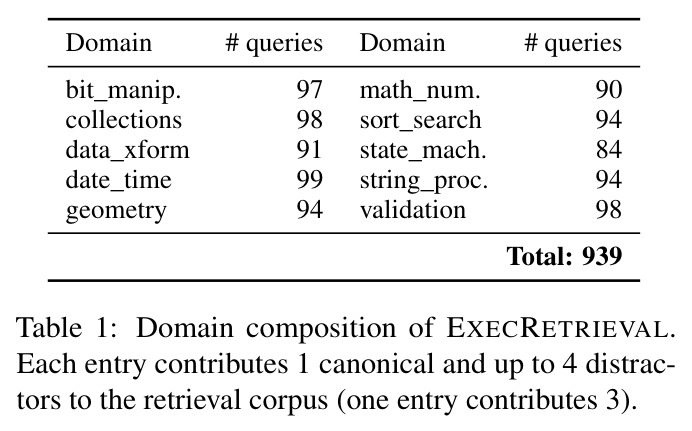
直觉上,要测嵌入能否区分正确实现与“仅差一个编辑”的错误实现,就必须让两者同时出现在池中,并由执行结果裁决谁对。形式化地,每个实例是五元组 $(q, f, c, T, D_1,\ldots,D_n)$:自然语言查询 $q$、目标函数名 $f$、canonical 实现 $c$、7–10 条 assert 测试 $T$、3–4 个单编辑缺陷 distractor $D_j$;要求 $c$ 通过全部 $t_i \in T$,每个 $D_j$ 至少挂一条。检索语料是 939 条 canonical 加 3,755 条 distractor 共 4,694 条片段。技术路线分三步:先用两阶段 LLM 流水线生成数据并过五道验证门(GPT-5.4 高推理档首验通过率 91%);再按 provider 文档的“最佳公平调用”(task type、前缀、dtype、归一化、batch、相似度度量)嵌入全部语料与查询并冻结为 .npz 矩阵;最后在冻结矩阵上确定性计算三族指标,并做配对 McNemar 检验与 5,000 次 query-level bootstrap。
核心创新是把变异测试的纪律引入检索基准构造:每个 distractor 必须是对 canonical 的单一目标编辑,限定在六类古典变异算子内,并强制执行验证“canonical 全过、distractor 至少挂一条”。锁 prompt 禁止 wrong_semantics(重写替代算法)源于一个反直觉发现:让 Claude Sonnet 4/4.6 写“错误代码”时,127/400(31.8%)产出意外正确的实现,其中 40 例还在 bug_description 里自认“actually correct”;换 GPT-5.4 高推理档后意外通过骤降到 3/4,112(0.07%),这一选型成为决定性。再配以两项完整性保障——distractor 全量执行 sanity sweep(0 个通过自己的全部测试)与跨 canonical 名称碰撞扫描(AST 搜索同名函数并互跑对方测试,0 碰撞)——保证任何错误检索必然源于那一个可归因的编辑,而非数据泄漏或测试歧义。
方法步骤详情
① 注册表:Claude Sonnet 4.6 生成 1,000 条(函数名, 查询, 域)候选,两轮去重到 954,最终 939 条通过验证;registry 不含实现以防自我串扰。② 生成:对每条调用 GPT-5.4(高推理档),返回 canonical、7–10 条 assert-only 测试与 4 个六类变异 distractor;两项 prompt 改进把首验通过率提到 91%(崩溃型拒绝 24%→3%)。③ 五道验证门:schema、AST 语义、canonical 执行全过、每个 distractor 至少挂一条测试、语料完整性(跨条目同名函数互跑测试,0 碰撞)。④ 执行:每对(代码, 测试套件)在全新 Python 子进程(-I、5 秒超时)运行;最终 939/939 canonical 全过、3,755/3,755 distractor 至少挂一条,缓存 46,458 行。⑤ 评测:23 个稠密配置加 BM25(k1=1.5, b=0.75)在冻结矩阵上算 exec@k、execp@k、nDCG 并做配对统计。
技术新颖性
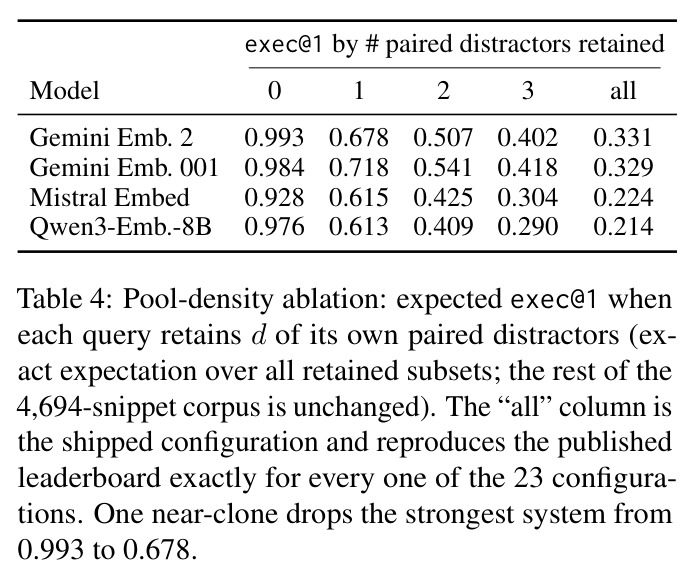
新颖性体现在三个层面。构造层面:首次把执行验证、与 canonical 单编辑之差的反事实植入自然语言检索池,使 rank-1 失败可逐例归因——四强系统 91.5–99.4% 的 rank-1 miss 恰是配对 mutant,把“检索失败”具体化为“符号级语义不敏感”。统计层面:per-query 配对设计能检出聚合分数掩盖的差异,例如 Gemini Embedding 2 与 001 在 exec@1 上不可区分(McNemar $p=0.958$)但在 exec@3 上显著分化($p \approx 2.7\times10^{-5}$)。消融层面:池密度消融精确计算保留 $d \in \{0,\ldots,4\}$ 个近克隆时的期望 exec@1,证明鸿沟不是密集池假象——零近克隆时四强达 0.93–0.99,仅一个近克隆就把最强系统从 0.993 砍到 0.678;编辑大小分桶(欺骗率 39.5–47.5%,Spearman $|\rho| \le 0.07$)与堆叠 2–4 个行不相交变异(差 <1.7 点)排除了“微编辑伪影”与“变异数量伪影”两种替代解释。
实验结果
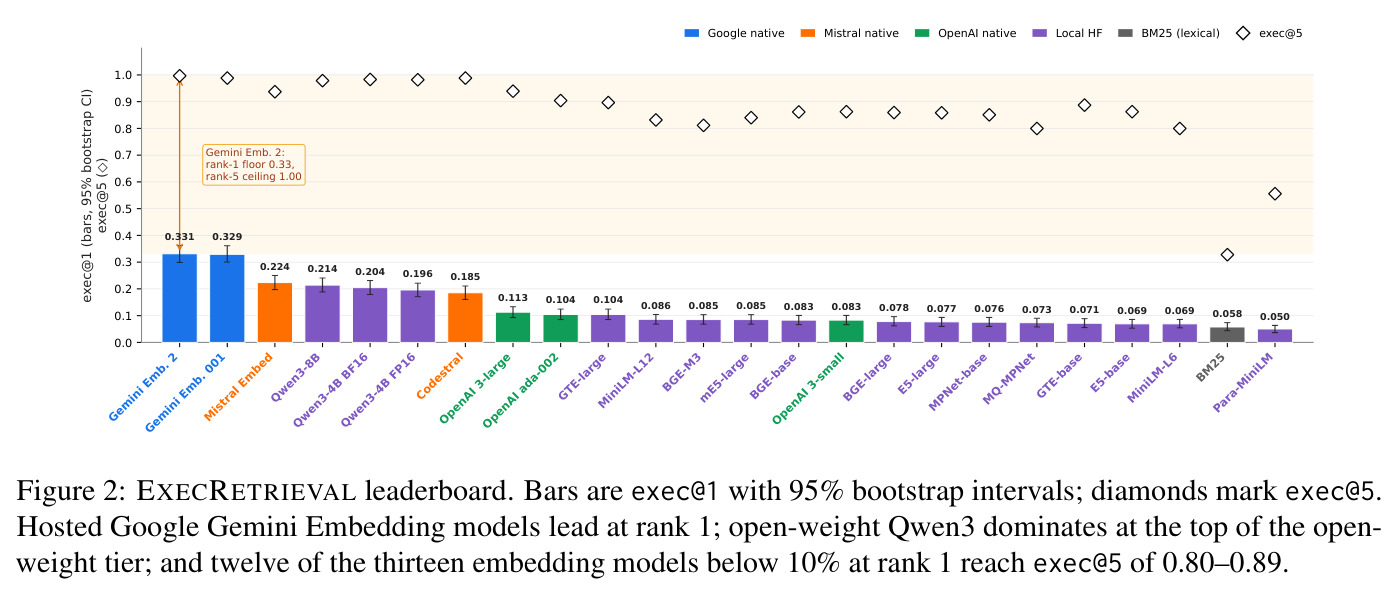
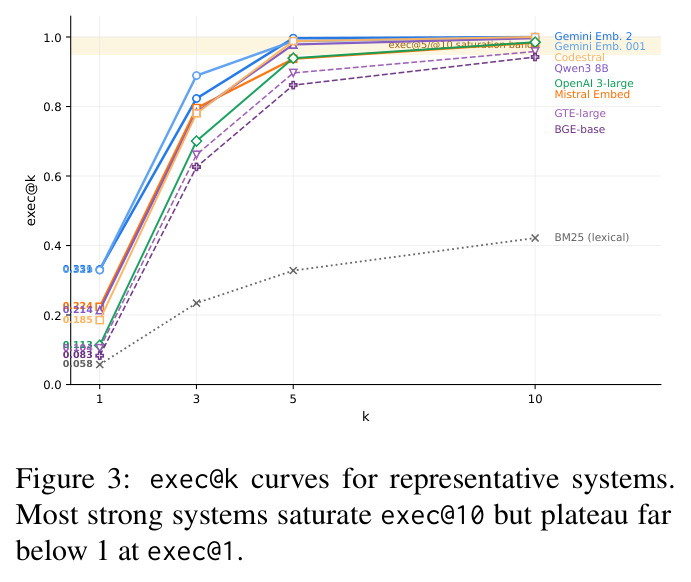
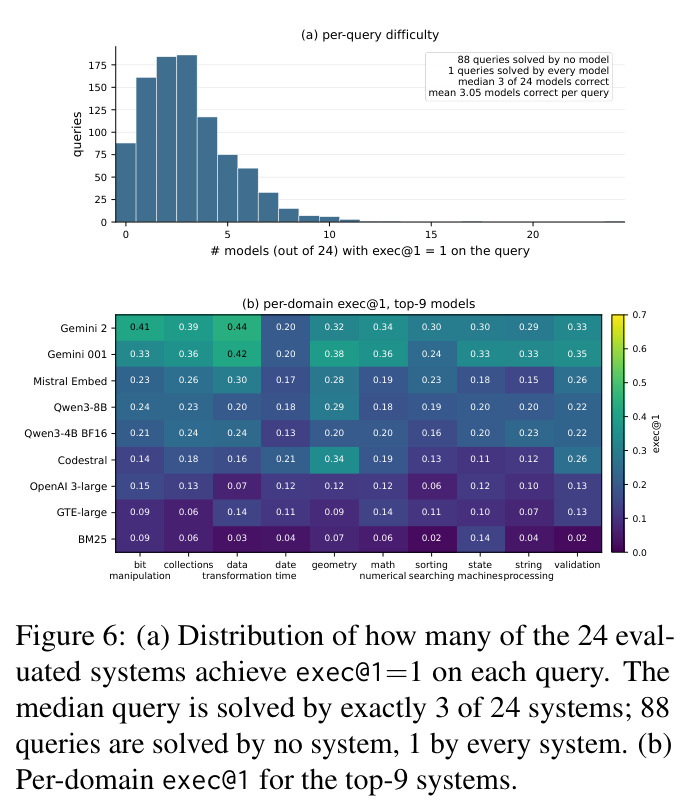
① Top-k 易、rank-1 难:最强系统 Gemini Embedding 2 的 exec@10=1.000 但 exec@1 仅 0.331;Gemini 001 为 0.329;Mistral 0.224、Qwen3-8B 0.214;BM25 仅 0.058。② 失败结构化:四强的 rank-1 miss 中配对 mutant 占 91.5–99.4%。③ 机制:66.8%(Gemini 2)与 78.4%(Qwen3-8B)的查询中 canonical 余弦低于最强配对 distractor,中位差 −0.002。④ 密度消融:仅 1 个近克隆就把 Gemini 2 从 0.993 打到 0.678(相对降幅 27–49%)。⑤ 欺骗率普适:86,135 个三元组中 44.3% 被欺骗,六类变异落在 39.3–48.0% 窄带,无一接近 50% 随机线;date_time 域最难(平均 exec@1=0.091);Qwen3 家族内无 scaling($p=0.622$)。中位查询仅被 3/24 个系统在 rank-1 解决。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 代码检索·功能辨别(939 查询,池中含近克隆反事实) | exec@1 | 基准本身;最强被测系统 Gemini Embedding 2 = 0.331(95% CI [0.299, 0.362]) | BM25 词法基线 = 0.058;次强 Gemini Embedding 001 = 0.329 | 稠密嵌入较 BM25 高约 5.7 倍,但暴露 rank-1 短板;前两名统计不可区分($p=0.958$) |
| Top-10 召回 | exec@10 | Gemini Embedding 2 / 001 / Codestral Embed 2505 = 1.000 | BM25 = 0.422;BGE-base、E5-large-v2 约 0.94–0.95 | 主题级召回已饱和,全部差距集中在 rank-1 |
| rank-1 失败归因 | rank-1 miss 中配对 mutant 占比 | Gemini Embedding 2 = 99.4%(624/628) | Gemini 001 = 98.1%、Qwen3-8B = 97.3%、Mistral = 91.5% | 四强系统的失败几乎全是“选中近克隆缺陷变体”,而非随机错检 |
| 池密度消融(保留 1 个配对 distractor) | 期望 exec@1 | Gemini Embedding 2 从 0.993 降至 0.678 | 零近克隆时 0.993(rank-1 近乎解决) | 一个近克隆即造成 0.315 绝对跌幅;23 个系统相对降幅 27–49% |
| 变异类型欺骗分析 | deception rate(distractor 余弦 ≥ canonical) | 总体 44.3%;wrong_comparison 最高 48.0% | remove_edge_case_check 最低 39.3%;随机水平 50% | 六类变异欺骗率窄带分布(39.3–48.0%),失败不绑定单一 bug 模式 |
局限与改进
作者承认的局限:仅覆盖 Python,跨语言泛化未知(管线语言无关但每种语言需自己的 runner);distractor 是机械变异而非自然人写 bug——8.5% 的机械变异对跨多行(最多 15 行,多为删除边界 guard),且正确性相对 LLM 生成的测试套件,可能超出查询字面所述域;闭环语料(恰 4,694 条片段)使 exec@k 与开放域代码搜索数字不可比,所有结论都条件于“池中存在近克隆”这一前提,真实部署语料中该情形的出现频率未测量;执行 runner 只做进程隔离加 5 秒超时,不限制文件与网络访问,不能跑不受信代码;hosted API 嵌入随 provider 更新漂移(以发布 .npz 矩阵缓解)。我的补充观察:canonical 与 distractor 除单编辑外风格完全一致,这是对嵌入最有利的情形,真实缺陷代码还叠加风格噪声,结论作为下界反而更有说服力;free-form LLM bug 未纳入(试点 400 例中 127 例意外正确,过滤本身非平凡),更自然的 bug 分布留待后续。
独立分析的弱点
① 缺少生态效度:基准证明了“有近克隆时 rank-1 崩”,但没测真实语料中近克隆共现的频率,无法把 0.331 换算成端到端影响——改进方向:在 commit history 的 pre-fix/post-fix 对或 agent 轨迹缓存上统计近克隆密度,估计真实失败率。② 只有诊断没有药方:论文未测试任何缓解手段(cross-encoder rerank、执行信号重排、hard-negative 微调),而冻结矩阵加执行 oracle 使这类实验零额外标注成本——改进方向:补一组 rerank 基线并量化 rank-1 lift。③ 变异谱系较窄:六类算子未覆盖类型混淆、异常路径、作用域等 bug 族,且“wrong output, not crash”约束偏向输出型缺陷——改进方向:扩充算子集并混入执行过滤后的自由格式 LLM bug。④ 单语言、自包含函数:仓库级跨文件上下文中的近克隆行为完全未知——改进方向:按作者计划移植 JS/Rust/Go 并构造 repo 级池。⑤ 模型覆盖偏 hosted 服务,本地小模型仅 Qwen3 家族有 dtype 对照,归因粒度有限。
未来方向
作者明确提出三个后续方向:其一,用 cross-encoder 或 LLM reranker 对嵌入检索的 top-k 重排,测量能否在不重训第一阶段模型的情况下补齐 rank-1 差距,发布的执行 oracle 与冻结 .npz 矩阵使该实验完全确定、可复算;其二,把生成与验证管线移植到 JavaScript、Rust 或 Go,检验近克隆欺骗是否是 Python 特有现象;其三,引入自由格式 LLM 生成的错误实现(仅保留未通过测试者)以探查更自然的 bug 分布——但执行过滤不可省略,试点中 127/400 的“错误代码”请求意外产出正确实现。基于本文成果还可延伸:把单编辑 mutant 直接作为对比学习的 hard negative 改进嵌入训练目标;把执行 oracle 变成检索训练与评估的在线信号(execution-in-the-loop retrieval);测量真实 agent 缓存失败尝试场景下的近克隆出现率,把 44.3% 的欺骗率转化为端到端风险估计;以及研究嵌入空间中是否存在可干预的“符号级语义方向”。
复现评估
复现条件极佳。作者发布:SHA-256 定 ID 的 4,694 条语料与 939 条查询文件、23 个通过形状/有限值/零范数检查的 .npz 嵌入矩阵、46,458 行 per-pair 执行缓存、pip freeze、全 bundle 的 SHA-256 manifest、invocation_table.json(模型 ID、维度、dtype、相似度度量、batch、前缀与 provider 文档 URL)以及全配对 pairwise_tests.json。validator 与 runner 只依赖 Python 标准库外加一个最小 pytest.raises shim,即使 hosted endpoint 变化也能从保存的矩阵确定性重算全部分数。算力需求低:本地模型仅需单张 A40(Qwen3-8B 因 FP16 出非有限相似度改用 BF16),hosted 模型走 API;数据生成的 GPT-5.4 phase-2 token 成本在附录 B 公开。复现门槛只剩 provider API key 与按文档对齐调用配方;BM25 与全部本地模型部分零门槛。
论文图表
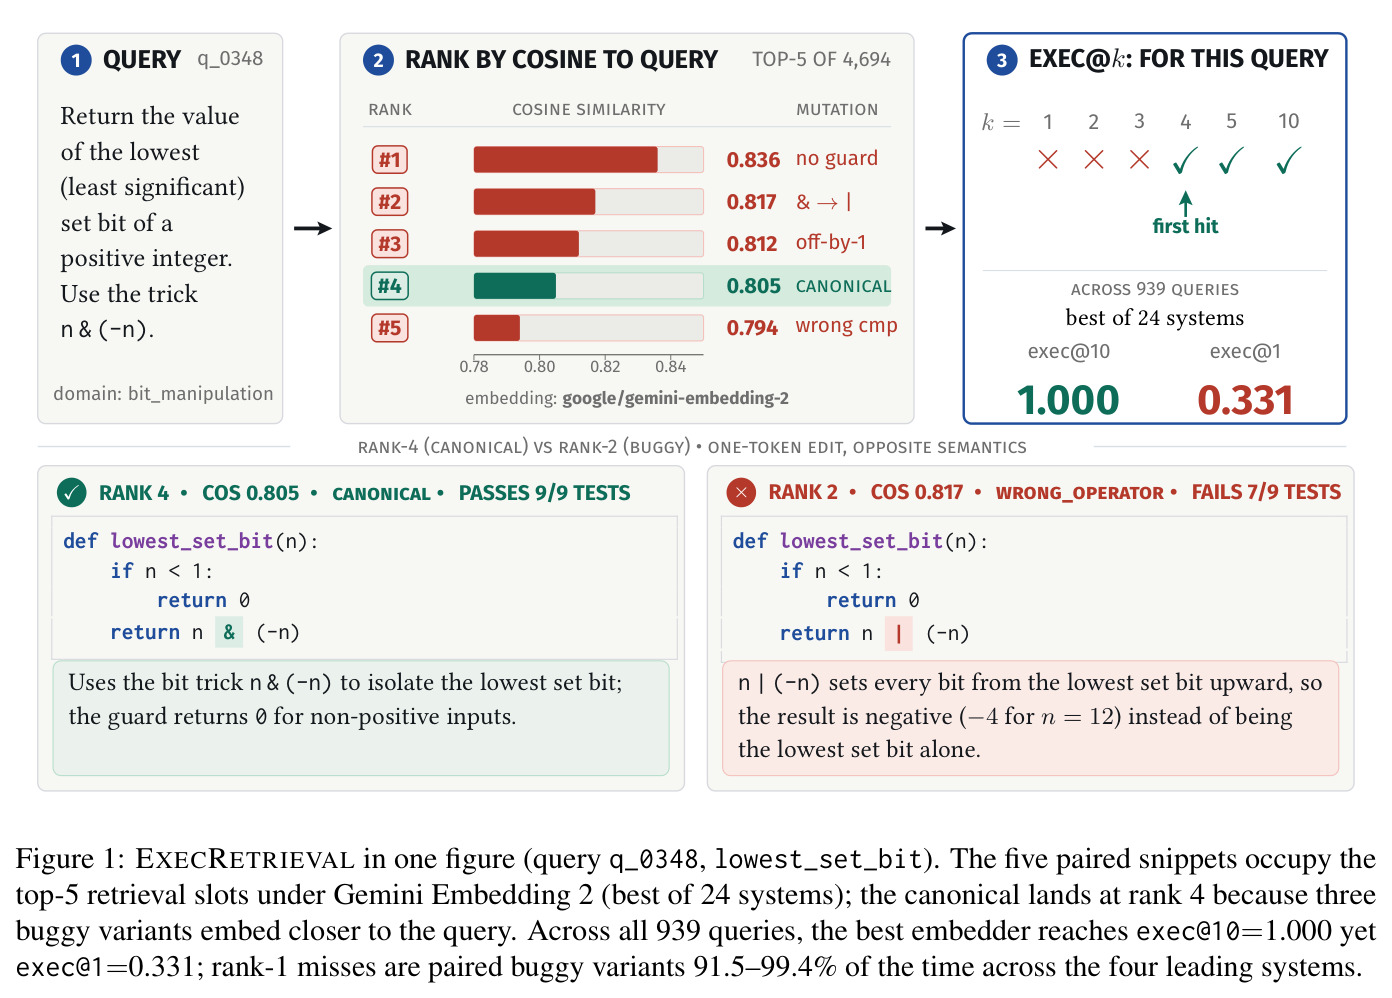
以 lowest_set_bit 查询为例:Gemini Embedding 2 的 top-5 全部是该查询自己的配对片段——三个变异 distractor(如把 n & (-n) 改成 n | (-n),余弦 0.817、0.812、0.794)占据第 1、2、3、5 位,通过 9/9 测试的 canonical 只排第 4(余弦 0.805)。汇总到 939 个查询,最佳系统 exec@10=1.000 而 exec@1 仅 0.331。
一页看懂任务设定、数据形态与全文主结论:单 token 之差即可让嵌入把错误实现排在正确实现之前,是理解论文动机的最佳入口。