ZipTok3D:基于紧凑词元前缀的高保真三维分词器 ZipTok3D: High-Fidelity 3D Tokenization with Compact Token Prefixes
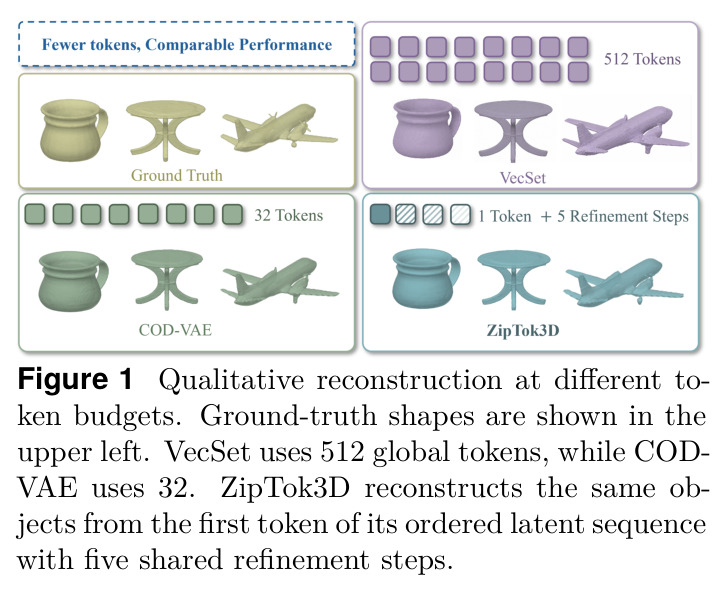
嵌套前缀分词+参数共享迭代解码,1个词元即可高保真重建3D物体,较COD-VAE缩短32倍
前置知识
3D 分词器(Tokenizer)
将三维物体表面几何编码为一串隐向量(token)的模型,是 3D 生成流水线的第一阶段:生成模型在低维 token 空间做扩散或自回归采样,再由解码器恢复为网格或隐式场。token 数量直接决定下游生成的采样步数与计算成本。
本文全部贡献发生在 tokenizer 层面,理解「token 序列长度与重建保真度的矛盾」是读懂动机与实验设定的前提。
三平面表示(Triplane)
用三个正交的 2D 特征平面(XY/XZ/YZ)隐式表示 3D 场:任意空间点的特征由其在三个平面上的投影特征组合得到,再经 MLP 输出占用率等属性;配合 marching cubes 可提取网格,是 COD-VAE 等方法的解码目标。
ZipTok3D 解码器的任务就是把少量全局 token 展开成 $128\times128$ 的三平面特征,方法部分所有状态操作都发生在三平面 token 上。
嵌套 Dropout(Nested Dropout)
训练时随机截断隐序列只保留前缀 $Z_{:K}$,并要求每个被保留的前缀都能独立重建完整输入,从而在 token 位置间诱导出信息排序:越靠前的 token 携带越全局、越本质的信息,序列可通过截断直接变长变短。
这是本文让前缀 token「按重要性排队」的核心训练手段,没有它前几个 token 不会自动承载物体级几何。
占用场(Occupancy Field)
把物体表面隐式定义为指示函数 $O(x)\in\{0,1\}$,网络对任意查询点预测其位于表面内部的概率;重建时在稠密网格点上查询,再用 marching cubes 提取等值面得到网格。本文用 50 万个体查询点加近表面查询点监督。
本文解码目标就是占用场,主指标 query IoU 即 50 万个体查询点上的占用预测正确率。
参数共享循环 Transformer
不堆叠多个不同参数的层,而是反复施加同一个 Transformer 块 $L$ 次(源自 Universal Transformer),以权重共享换取可变的有效解码深度;常配合中间监督或环内自蒸馏,保证每一步中间状态都是有效输出。
ZipTok3D 靠它把极少的 token 展开为细致的 3D 场,是理解其解码器设计与消融结论的关键。
生成分配指标(MMD/COV/1-NNA)
基于倒角距离(CD)比较生成形状集合与真实集合的三个指标:MMD 衡量生成集合与真实集的接近程度(越小越好),COV 衡量对真实分布的覆盖多样性(越高越好),1-NNA 用 1 近邻分类器判断两个分布是否可分,50% 为理想值。
用于检验极短前缀 token 是否仍能支撑下游类条件生成,读懂 Table 2 必备。
研究动机
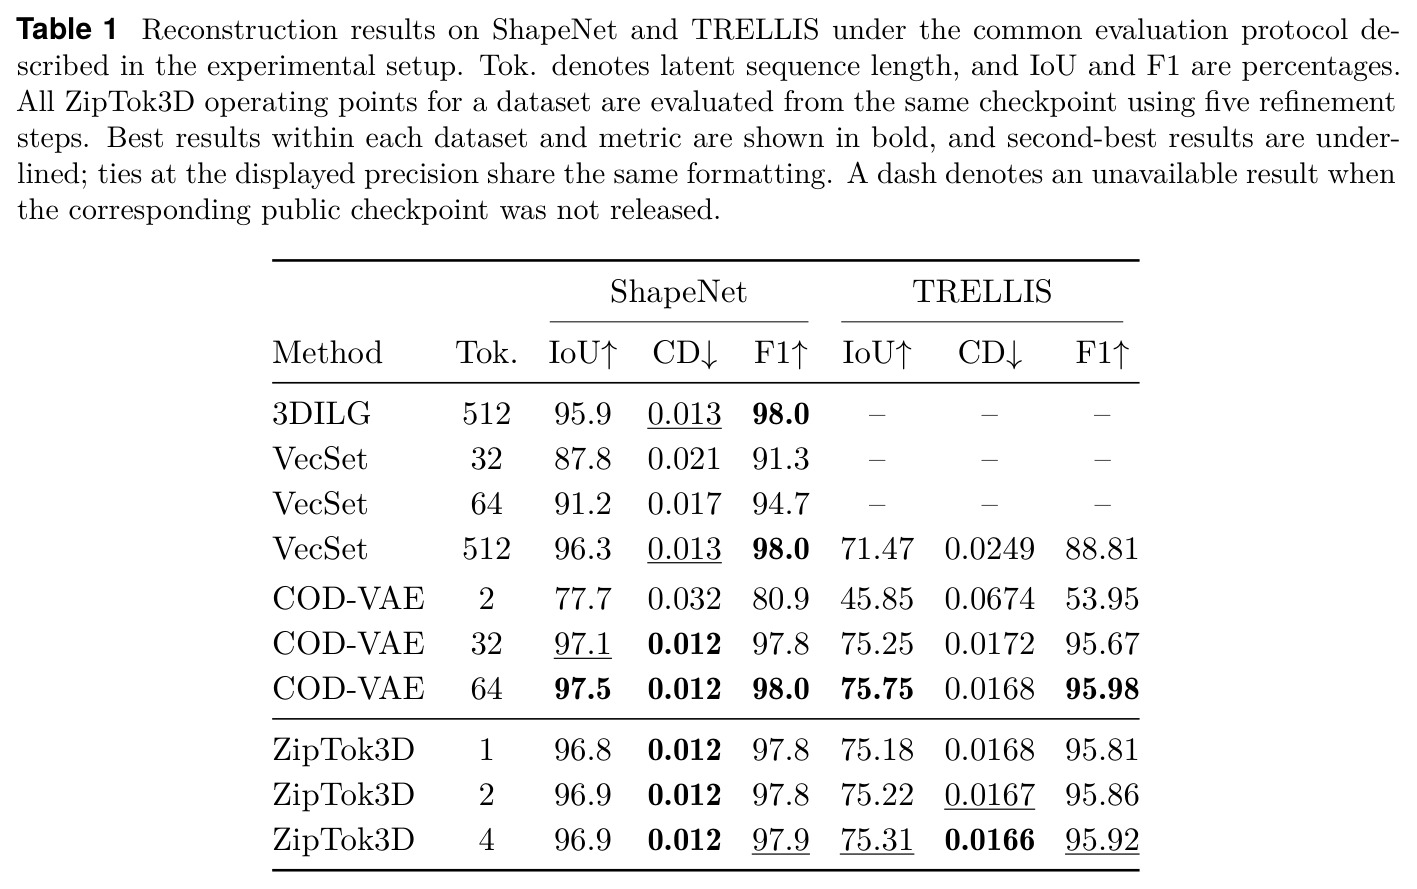
现有 3D 分词器分两类:空间组织方法(3DILG 的不规则网格、OctFusion 的八叉树、TRELLIS 的稀疏体素格)用局部锚定的 token 保留空间结构,想压缩就得加粗或稀疏化结构本身;全局方法把物体级几何压成固定大小的 token 集合,序列更短却在极低预算下急剧退化——VecSet 需要 512 个 token 才在 ShapeNet 上达到 96.3% IoU,COD-VAE 用 32 token 时 IoU 为 97.1%,减到 2 token 暴跌到 77.7%,VecSet-512 在 TRELLIS 上也只有 71.47%。根源在于固定预算目标只约束整个 latent 集合的联合信息,从不规定哪些信息必须放进前几个 token;当预算缩到几个 token 时,全局结构与细粒度细节只能争夺极有限的隐容量,而单次前馈解码也难以把极简表示一步还原成空间细节。
本文的目标是本文目标是造一个能从极短 token 序列高保真重建三维物体的分词器:在 ShapeNet 上仅用 1 个 token、在更复杂的 TRELLIS-500K 上仅用 4 个 token,就达到 COD-VAE 使用 32 个 token 的重建水平,把 token 序列分别缩短 32× 和 8×;同时紧凑前缀可直接接入下游类条件生成(配等长的二阶段 VAE 与 EDM 扩散模型),在 2 token 的 stage-2 序列上保持接近 COD-VAE-32 的分布指标并获得更高的采样吞吐。方法还需提供两个独立可调的推理旋钮——保留前缀长度 $K$ 与解码迭代深度 $L$——让用户能在表示长度与解码计算量之间自由权衡。
与已有工作不同的是,与 VecSet、COD-VAE 等固定预算优化隐式分配信息不同,本文显式优化一个嵌套前缀族:训练时用 nested dropout 按指数间隔 $\{1,2,4,8,16,32,64,128\}$ 采样保留长度,要求每个前缀独立完成完整重建,迫使靠前的 token 优先承载物体级几何;与任意 token dropout 的本质区别在于嵌套结构保证每个支持长度都是一致、可直接截断的表示。解码侧也与 LoST 等依赖扩散补全的可变长方法不同:ZipTok3D 用参数共享的 Transformer 块循环精化三平面状态,从每个前缀直接确定性重建输入几何,无需额外生成采样过程;计算量由迭代次数 $L$ 控制,模型参数量保持不变。
核心方法
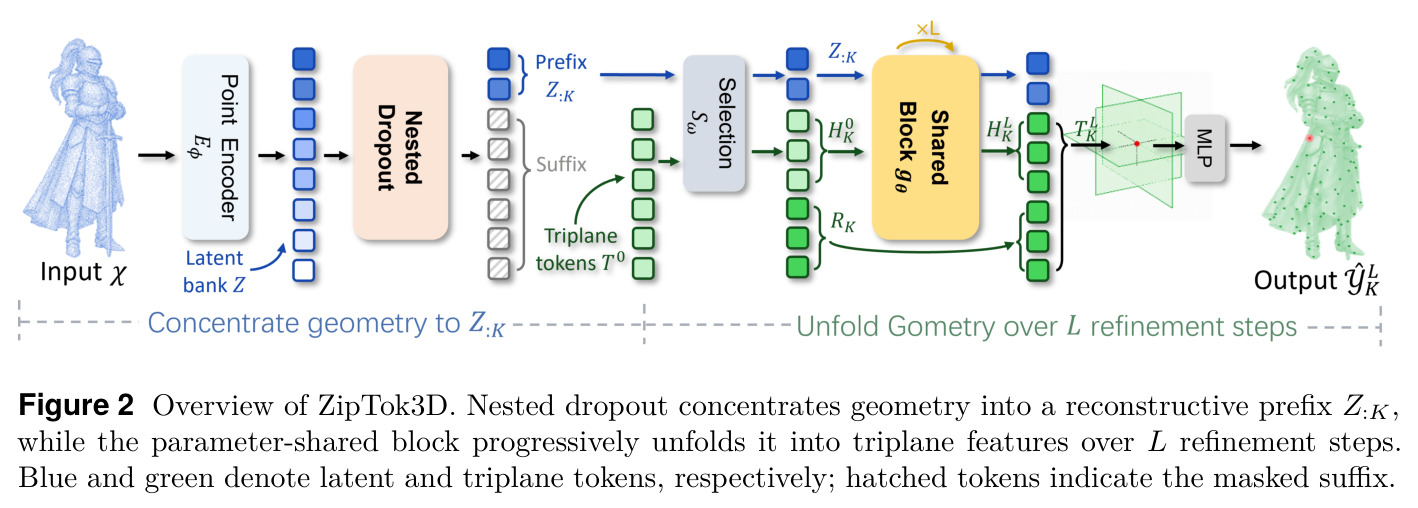
方法的直觉是:极低 token 重建要同时回答两个问题——序列截短后还剩哪些信息、需要多少计算把它展开成空间场。ZipTok3D 把二者拆成两个推理旋钮:前缀长度 $K$ 决定 latent 序列长度,解码迭代次数 $L$ 决定解释该表示所用的计算。技术上,渐进点编码器 $E_\phi$ 把 $N=2048$ 个表面点映射为最多 $M=128$ 个宽度 $d=512$ 的隐向量 $Z=E_\phi(X)$;训练时按指数间隔集合均匀采样 $K$,掩掉后缀并要求 $Z_{:K}$ 重建完整物体。解码时,可学习的三平面 token $T^0$ 先经选择块 $S_\omega$ 与前缀交互,分成被选状态 $H^0_K$ 与冗余 token $R_K$;随后同一个 6 层 Transformer 块 $g_\theta$ 以固定前缀为条件迭代精化 $L=5$ 次,恢复成 $128\times128$ 三平面后,由共享占用 MLP 在查询点上输出占用概率。
核心创新是把「信息的嵌套组织」与「计算的迭代展开」解耦后联合训练。表示侧:nested dropout 让一次训练同时覆盖 8 个 token 预算,几何信息按重要性从前往后排布,推理时按需截断即可切换预算,同一 checkpoint 服务所有长度,这与 COD-VAE 固定优化完整 latent 集合有本质区别。解码侧:与其加深网络(参数与延迟线性上涨)或引入扩散补全(需额外采样),不如反复施加同一个块——参数共享使有效解码深度增长而参数不变(解码器仅 23.5M,COD-VAE 为 39.3M),并对随机抽样的中间精化步施加重建损失加环内自蒸馏,保证每一步状态都是有效重建。由此,「前几个 token 存什么」与「如何用有限计算展开」两个难题各得其所、相互配合。
方法步骤详情
第一步编码:2048 个表面点经渐进点编码器输出 $Z\in\mathbb{R}^{128\times512}$。第二步前缀采样:训练时 $K\sim\mathrm{Unif}\{1,...,128\}$(指数间隔),后缀被掩蔽。第三步选择:$(H^0_K,R_K)=S_\omega(T^0,Z_{:K})$ 把三平面 token 分为被选状态与冗余部分。第四步迭代精化:$H^\ell_K=g_\theta(H^{\ell-1}_K,Z_{:K})$,共享 6 层块执行 $L=5$ 次。第五步恢复与查询:$T^{K,\ell}=\mathcal{R}(H^\ell_K,R_K)$ 还原三平面,占用 MLP 出 logit,经 sigmoid 得占用概率。第六步训练:$\mathcal{L}_{rec}$ 为 BCE(近表面权重 $\lambda_{near}=0.1$)加辅助损失;随机抽中间步施加 $\beta=0.5$ 加权的重建+自蒸馏损失。推理时输入精确 $K\times512$ 前缀,不补零。
技术新颖性
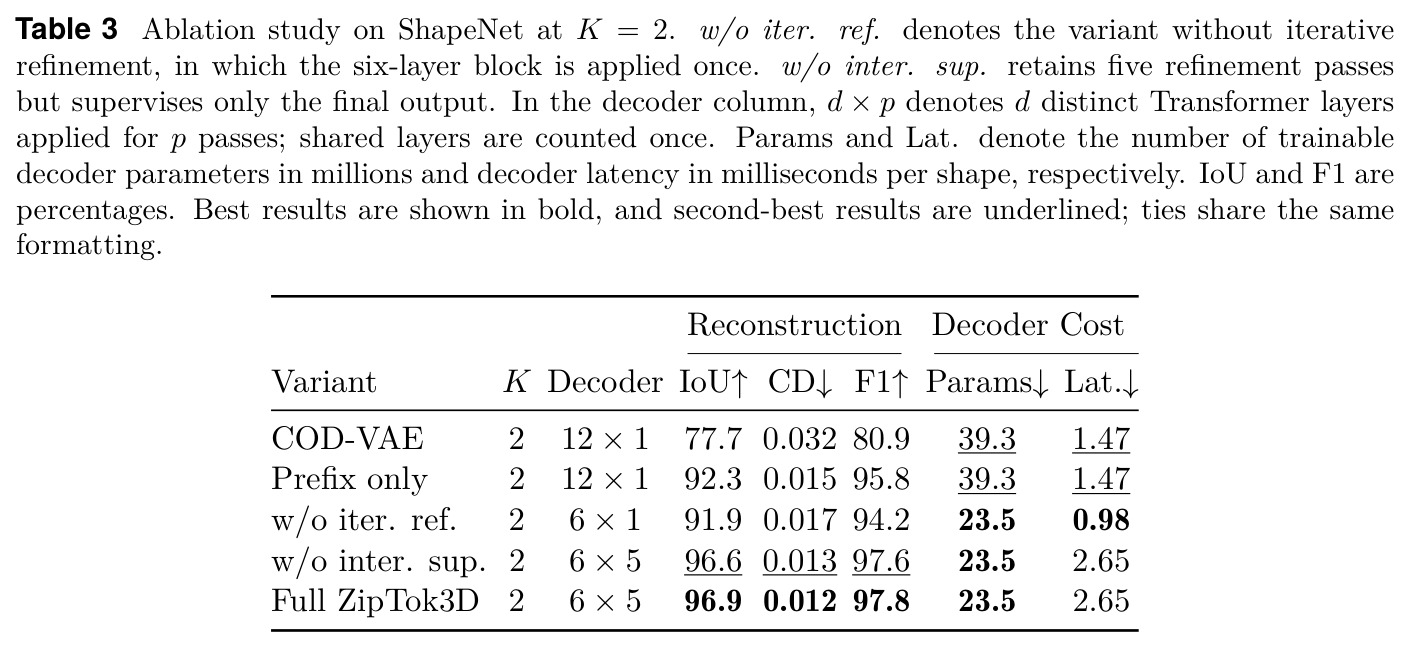
技术新颖性体现在三点组合:(1) 首次把 nested dropout 的嵌套前缀组织应用于 3D 全局 latents 并与 COD-VAE 式三平面选择解码结合——此前 3D 可变长方案要么按八叉树/超体素自适应分配(OAT、SuperVoxelGPT),要么按语义显著性排序后依赖扩散补全(LoST),都没有学习「每个前缀都可精确重建」的嵌套表示;(2) 把 Universal Transformer/ELT 的参数共享循环精化引入 3D token 解码,用同一 6 层块迭代 5 次展开极简前缀,配合随机中间步监督与环内自蒸馏稳定联合优化;(3) 消融证实两组件贡献可分离:相同 12 层×1 次解码器下仅加 nested dropout 就把 K=2 的 IoU 从 77.7 提到 92.3,换成 6 层×5 次共享精化再提到 96.9。
实验结果
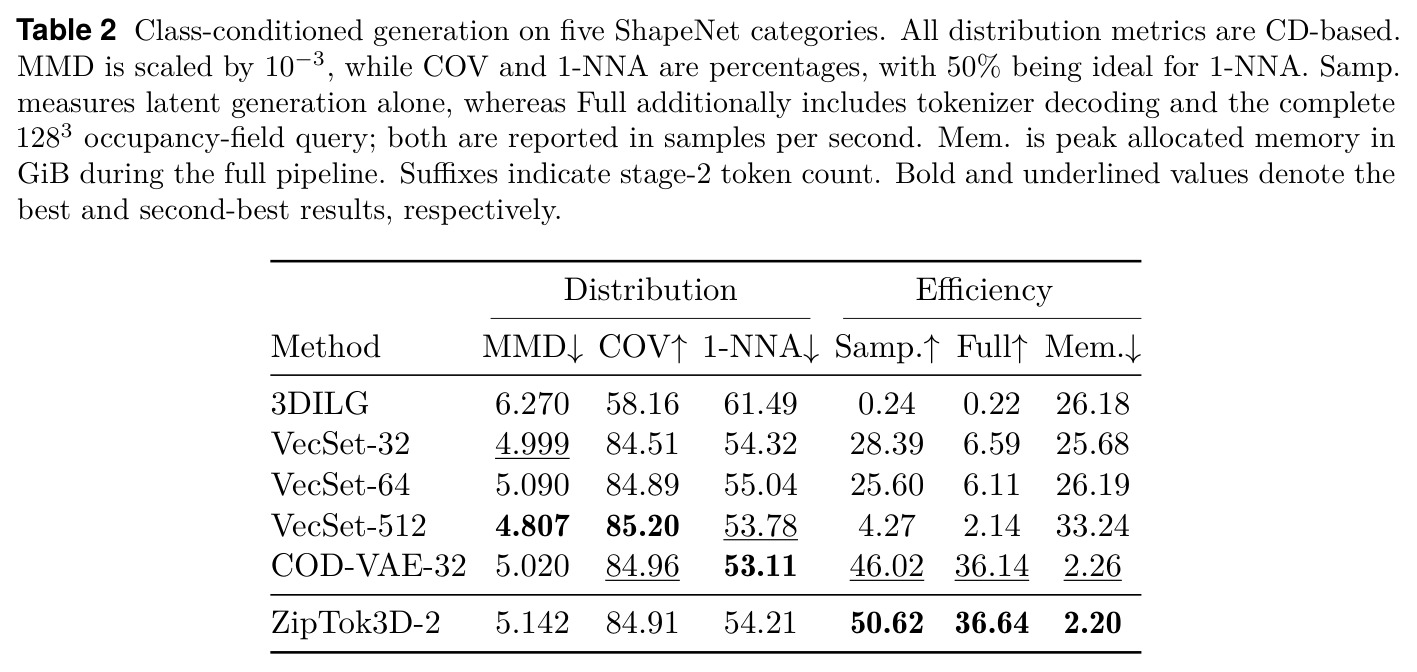
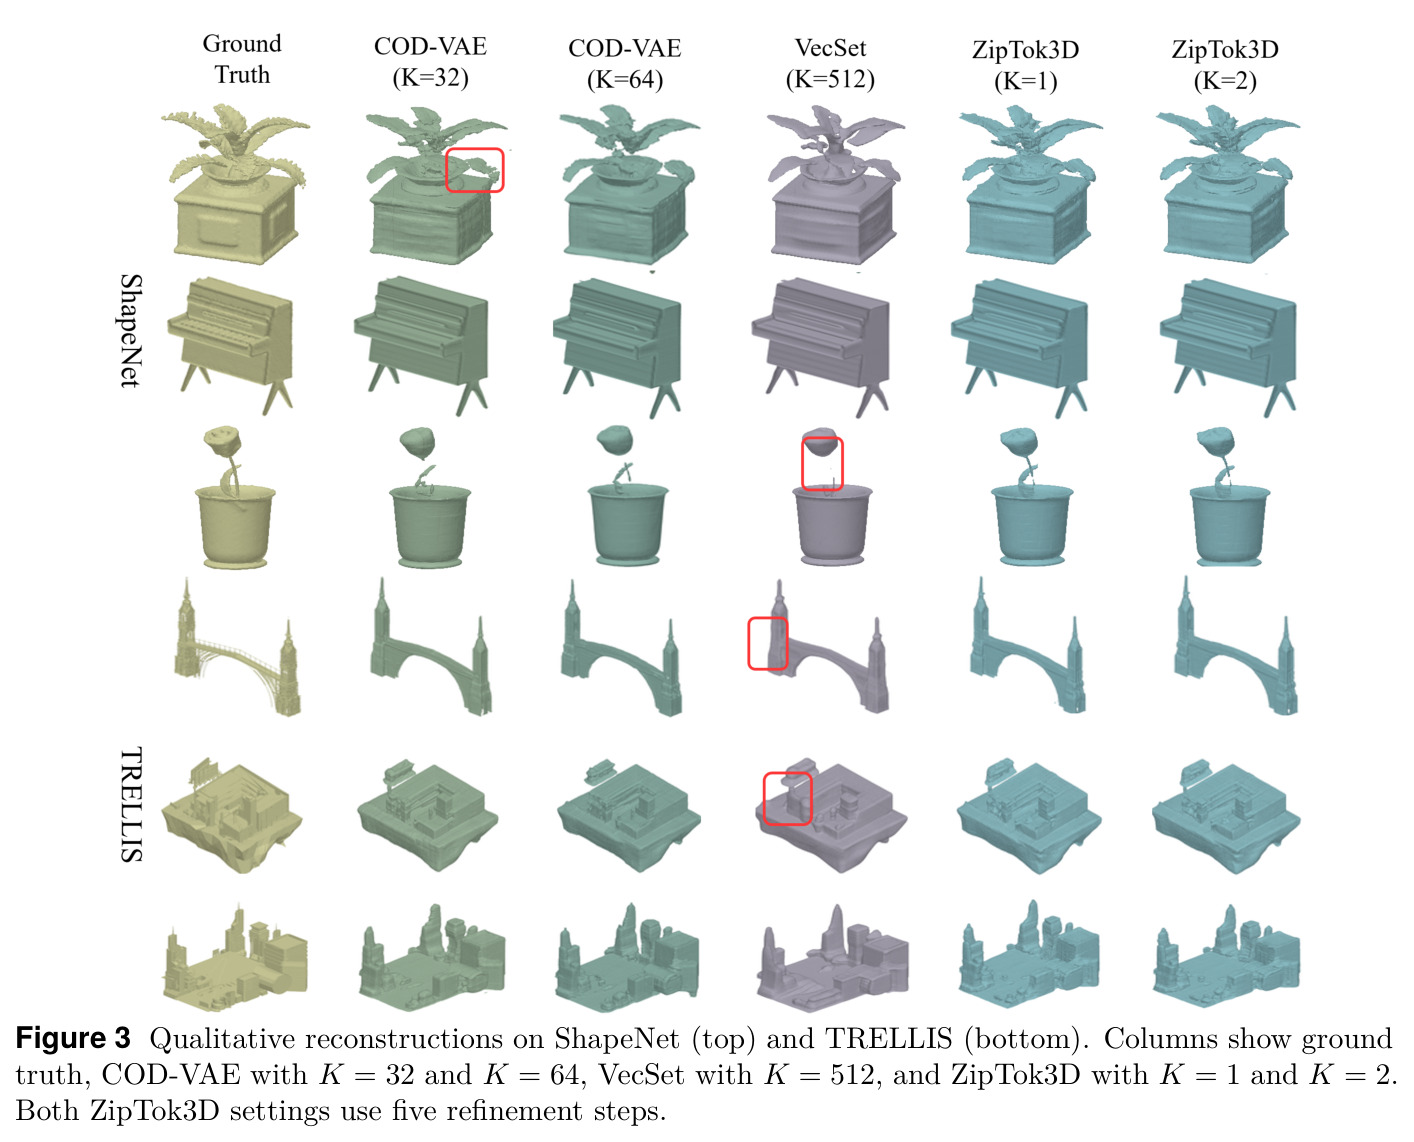
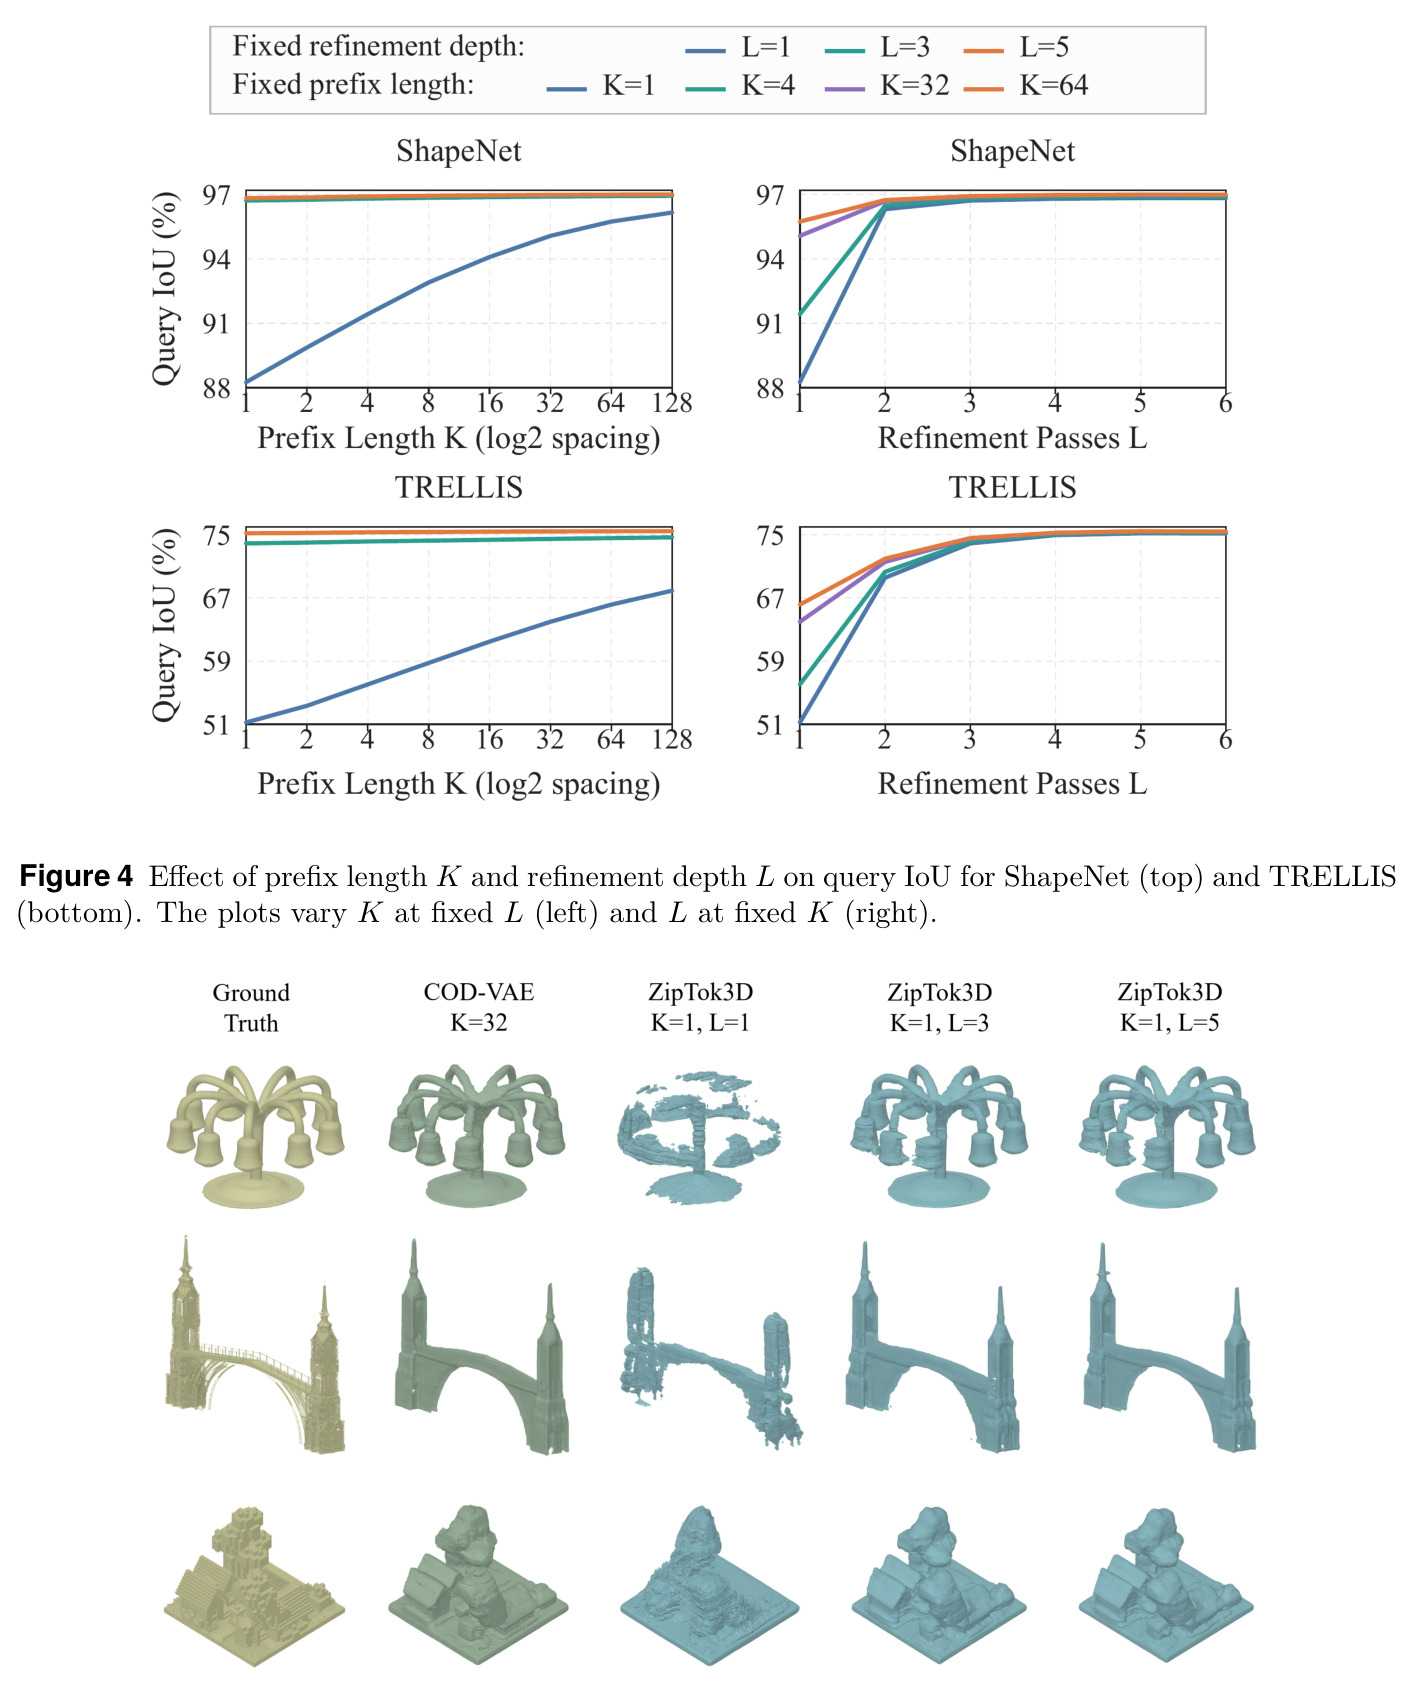
重建主实验(Table 1):ShapeNet 上 1 token 达 IoU 96.8/CD 0.012/F1 97.8,与 32 token 的 COD-VAE(97.1/0.012/97.8)几乎持平,序列缩短 32×;而 COD-VAE 减到 2 token 时 IoU 仅 77.7,说明收益来自训练方式而非简单缩短 latent。TRELLIS 上 4 token 达 75.31/0.0166/95.92,优于 COD-VAE-32 的 75.25/0.0172/95.67;配对 bootstrap(2 万次重采样)显示 IoU 差 +0.06(95% CI 含零),CD 与 F1 置信区间显著偏向本文。生成实验(Table 2):ZipTok3D-2 的 $2\times32$ 序列比 COD-VAE-32 短 16×,MMD/COV/1-NNA 为 5.142/84.91/54.21% 对 5.020/84.96/53.11%,基本持平,潜采样吞吐更高(50.62 vs 46.02 样本/秒),显存 2.20 对 2.26 GiB。消融(Table 3):K=2 时 77.7→92.3(仅前缀训练)→96.9(加共享精化与中间监督)。Figure 4 揭示 K 与 L 互补:长前缀在浅解码下收益最大,深迭代在极低 token 区收益最大。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ShapeNet 3D 重建(1 token) | query IoU / mesh CD / F1 | 96.8% / 0.012 / 97.8% | COD-VAE(32 token):97.1% / 0.012 / 97.8% | token 数减少 32×,指标几乎持平(IoU 差 0.3 点),而 COD-VAE 自身在 2 token 时 IoU 只有 77.7% |
| TRELLIS 3D 重建(4 token) | query IoU / mesh CD / F1 | 75.31% / 0.0166 / 95.92% | COD-VAE-32:75.25% / 0.0172 / 95.67% | token 数减少 8×,CD 与 F1 经 bootstrap 检验显著更优(置信区间不含零) |
| ShapeNet 类条件生成(5 类,2 token stage-2) | MMD-CD / COV-CD / 1-NNA | 5.142 / 84.91 / 54.21% | COD-VAE-32:5.020 / 84.96 / 53.11% | stage-2 序列缩短 16×,分布指标接近,潜采样吞吐更高(50.62 vs 46.02 样本/秒),显存更低(2.20 vs 2.26 GiB) |
| ShapeNet 消融 K=2(解码器效率) | IoU / 解码器参数量 / 延迟 | 96.9% / 23.5M / 2.65ms | COD-VAE:77.7% / 39.3M / 1.47ms | IoU +19.2 点,参数减少约 40%,代价是延迟增加约 1.8× |
局限与改进
作者承认的点:共享块的 5 次迭代把解码延迟从 1.47ms 推到 2.65ms(约 +80%),虽换来大幅质量提升,延迟敏感场景仍需权衡;TRELLIS 的 query IoU 提升(+0.06)置信区间含零,不能断言显著优于 COD-VAE-32;结论部分也坦承前缀长度与迭代深度目前固定,未按输入复杂度自适应。我的补充观察:(1) 每个 K-L 组合与每个数据集只训一次(seed 123456),bootstrap 只覆盖评估对象变异,训练随机性带来的方差未量化;(2) 表示仅含几何占用,无纹理/外观通道,离完整 3D 资产生成还有距离;(3) 生成实验限于 5 个 ShapeNet 类别与 18 步 EDM 采样,未测 text-to-3D 或开放类别;(4) 极低 token 下模型可能隐式依赖类别先验,对分布外形状的泛化能力未检验。
独立分析的弱点
弱点一:固定 5 次迭代对简单物体浪费计算、对复杂物体可能不足——Figure 4 已显示不同 K 下最优 L 不同,可引入提前退出(early-exit)或按预测不确定性自适应停止迭代。弱点二:训练同时优化 8 个前缀长度与中间步监督,$\alpha_t$ 退火、$\beta=0.5$ 等超参较多,联合优化不稳定风险高,可研究课程化前缀调度或只约束最短关键长度。弱点三:占用解码依赖 $128^3$ marching cubes 与 50 万查询点,全流程吞吐(36.64 样本/秒)并未随 token 减少而线性提升,瓶颈转移到解码与查询侧,可用稀疏查询或点云直接解码绕开。弱点四:类条件生成用的二阶段 VAE 与 EDM 是较传统的组件,短序列的理论优势(自回归生成只需 $O(K)$ 步)未被充分利用,可在 1-2 token 上尝试纯自回归或流匹配先验。
未来方向
作者提出的方向:设计更善于利用短 latent 序列的生成模型(例如让扩散/自回归先验显式建模有序前缀的语义结构),以及按每个输入自适应分配前缀长度和精化深度。基于本文成果可延伸:(1) 把嵌套前缀与自适应计算结合,用 early-exit 实现「质量-算力」连续调节,一个模型覆盖多档预算;(2) 扩展到带纹理/材质的多通道 token、场景级生成与 text-to-3D,检验紧凑前缀在开放域是否保持优势;(3) 在有序表示上训练变长自回归先验,实现「难例多花 token、易例 1 token」的弹性生成;(4) 与语义排序(LoST 类)结合,让前缀同时具备几何与语义单调性,支持可解释的部分编辑;(5) 探索「嵌套前缀+共享迭代解码」范式在视频、分子结构等其他模态的通用性。
复现评估
复现难度中等偏上。利好因素:数据全部公开(ShapeNet-v2 沿用 COD-VAE 预处理与划分,评估集 1,283 物体 55 类;TRELLIS-500K 用 VecSet 水密预处理,seed 42 划分出 2,613 个评估资产);评估协议完全沿用 COD-VAE(50 万体查询 IoU、$128^3$ marching cubes 的 CD/F1),补充材料给出资产清单、优化器参数、梯度累积、损失权重与模型选择协议;训练固定 seed 123456,并有项目主页 forthloth.github.io/ziptok3d。门槛:训练需 4×A800(FP16、有效 batch 672,ShapeNet 1000 epoch / TRELLIS 300 epoch),单卡复现训练不现实;正文未明确承诺开源代码,需关注项目页是否发布 checkpoint。若只做推理验证,拿到 checkpoint 后单卡即可复现全部重建与效率表格,难度较低。
论文图表
K=1 时的迭代精化可视化,五列依次为真值、COD-VAE K=32、ZipTok3D K=1 在 L=1、L=3、L=5 下的重建:L=1 只有部分全局结构且表面碎片化,L=3 恢复主体且表面连贯,L=5 主要用于锐化薄结构、边界与局部细节。
把「迭代展开紧凑信息」这一抽象机制可视化,直接支撑由粗到细的精化叙事,也解释了 L=5 后收益递减的原因。