NeoMME:单塔多模态原生多语言基础编码器,面向高效微调与推理 NeoMME: A Single-Tower Multimodal-Native Multilingual Foundation Encoder for Efficient Fine-Tuning and Inference
从零预训练的单塔双向多模态编码器,检索比肩 3.75B 模型且吞吐翻倍
前置知识
双向编码器与掩码预训练
BERT 式模型使用双向注意力,每个位置能同时看到前后文;预训练时随机遮住一部分 token(如固定 15%),让模型根据剩余上下文预测被遮内容,这种「完形填空」目标学到的表示天然适合分类与检索等判别任务。Ettin 的匹配对照实验进一步表明:原生掩码预训练的编码器在分类与检索上强于由因果解码器改造而来的编码器。
NeoMME 的骨架就是一个从随机初始化预训练的双向 Transformer,理解其掩码目标与注意力形式是读懂架构设计与消融结论的前提。
掩码离散扩散(Masked Discrete Diffusion)
把 BERT 的固定遮盖率推广为采样的噪声轨迹(MDLM、MD4、LLaDA):训练时每段文本采样遮盖率 $\rho\sim U(0,1)$,按此概率把 token 替换为 [MASK],模型学习在任意噪声水平下去噪;推理时可从全遮画布出发迭代「预测-揭示」生成文本。损失按逆遮盖率 $1/\max(r_s, r_0)$ 加权,兼顾不同噪声水平的样本。
NeoMME 的全部预训练都基于图像条件化的掩码离散扩散,这是它区别于传统 MLM 和 VLM 的核心,也是论文「图像增益」探针实验的理论基础。
迟交互检索与 MaxSim 打分
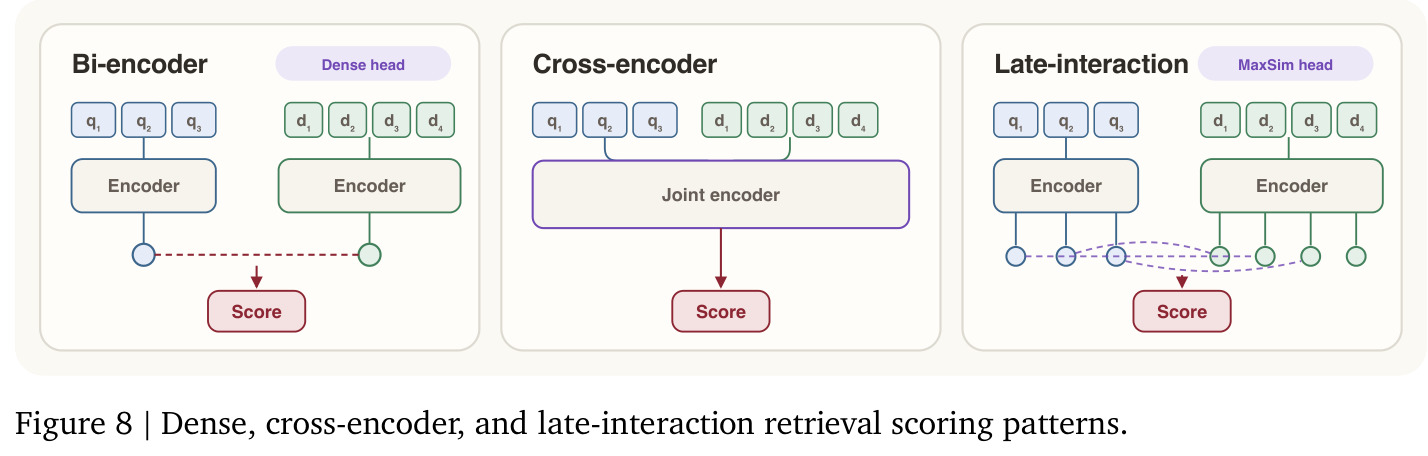
检索架构谱系分三类:稠密双塔把查询和文档各压成一个向量后做点积;交叉编码器把二者拼接联合编码、表达力强但无法离线索引;迟交互(ColBERT/ColPali)保留每个 token 一个 128 维向量,打分时每个查询向量找文档中最相似的文档向量再平均:$s_{\text{late}}(q,d)=\frac{1}{L_q}\sum_{s=1}^{L_q}\max_{1\le t\le L_d}\langle \boldsymbol{q}_s,\boldsymbol{d}_t\rangle$。表达容量更大,但存储随 token 数线性增长、打分也比余弦相似度更贵。
本文的检索双头设计、LIK 融合内核、层级 token 池化与量化压缩,全部围绕迟交互表示「强但贵」这一核心矛盾展开。
视觉文档检索(Visual Document Retrieval)
把 PDF 页面整页渲染成图片直接嵌入检索,跳过 OCR 与版面解析管线,从而保留表格、图形、布局等文本抽取会丢失的证据。ColPali 用 VLM 的 patch 级多向量表示加 MaxSim 打分开创了这条路线;检索到的页面可喂给 VLM 做视觉增强生成(Visual RAG)。ViDoRe v1/v2/v3 是该领域的标准基准,主指标为 nDCG@10。
NeoMME-Retriever 的所有核心对比实验(0.523/0.556 nDCG@10)都在 ViDoRe 基准上进行,不理解这一任务设定就无法评估其结果的意义。
动态分辨率与 2D RoPE
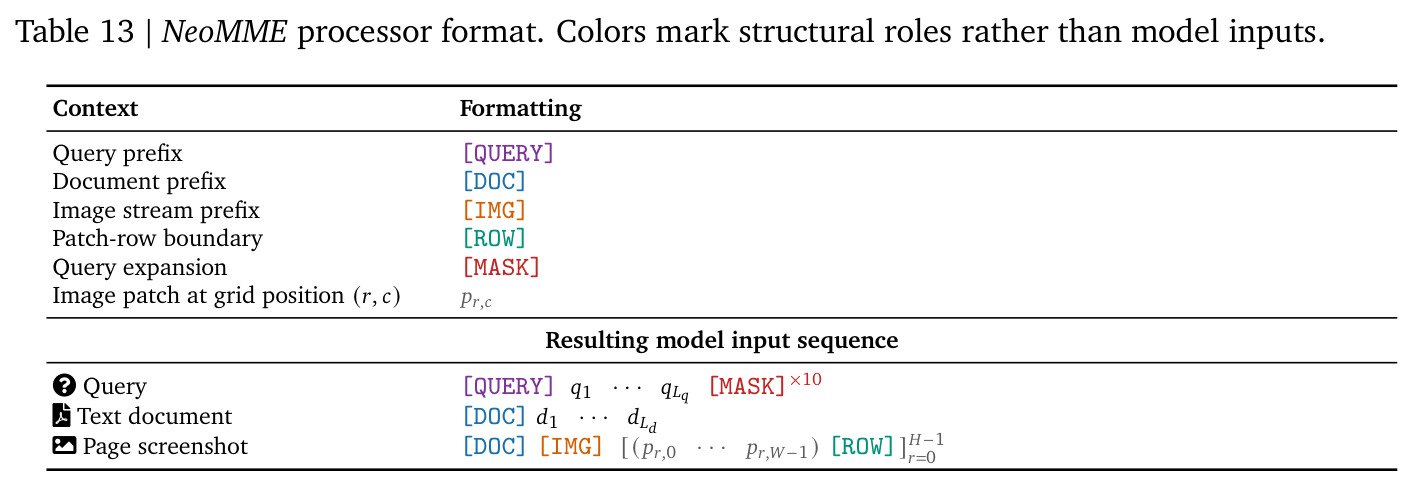
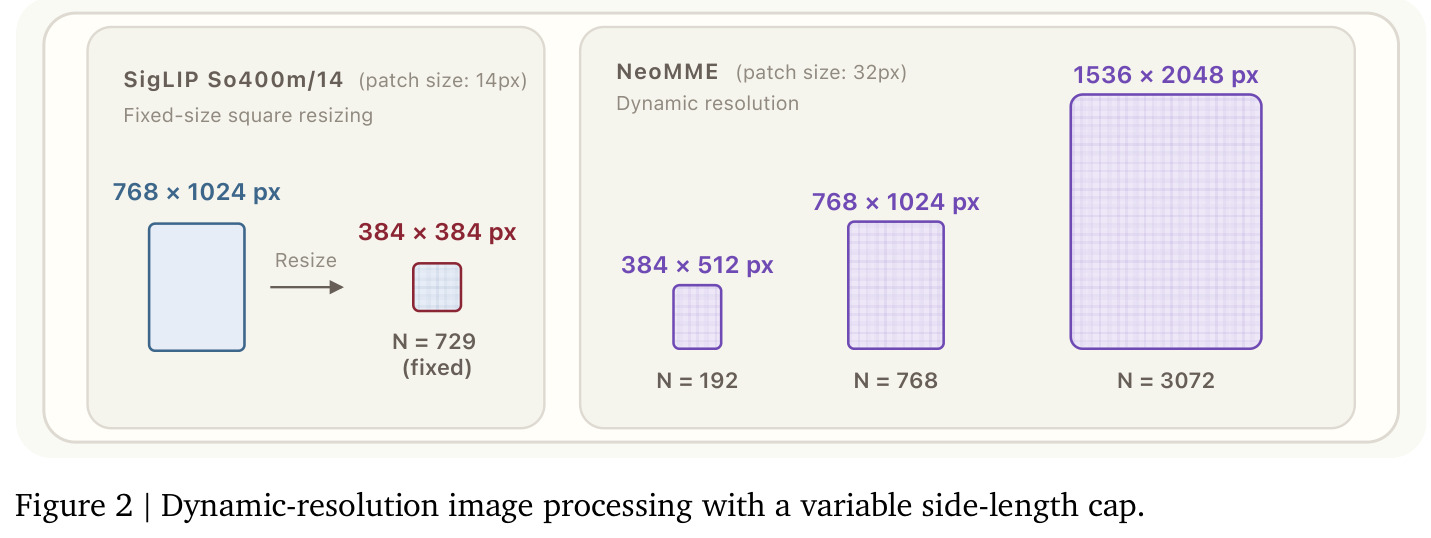
动态分辨率指不把图片强行缩放成正方形,而是保留长宽比、仅当超过上限时把长边下采样(Qwen2-VL 式),patch 数量随图片尺寸自然变化。2D RoPE 把旋转位置编码扩展到(行, 列)两个坐标轴:文本 token 沿对角线取坐标 $(i,i)$ 保持一维顺序,图像 patch 用 $(r,c)$ 表达二维空间位置,一套注意力机制同时服务两种模态。
这解释了 NeoMME 如何用 32×32 的大 patch 在 16,384 token 上下文里装下两张 4K UHD 图像,并保持文档版面的空间结构。
层级 token 池化与非对称量化
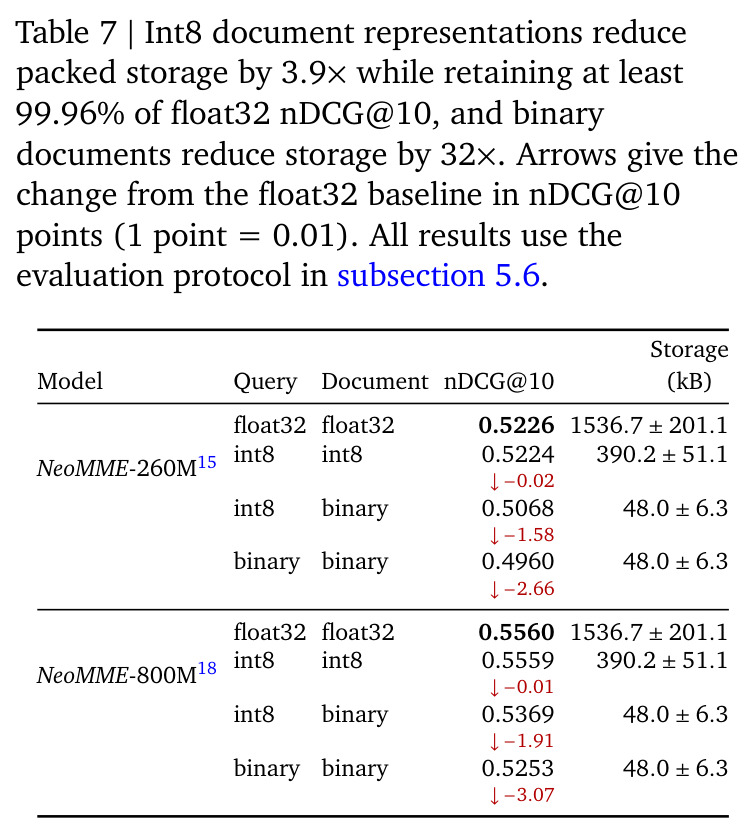
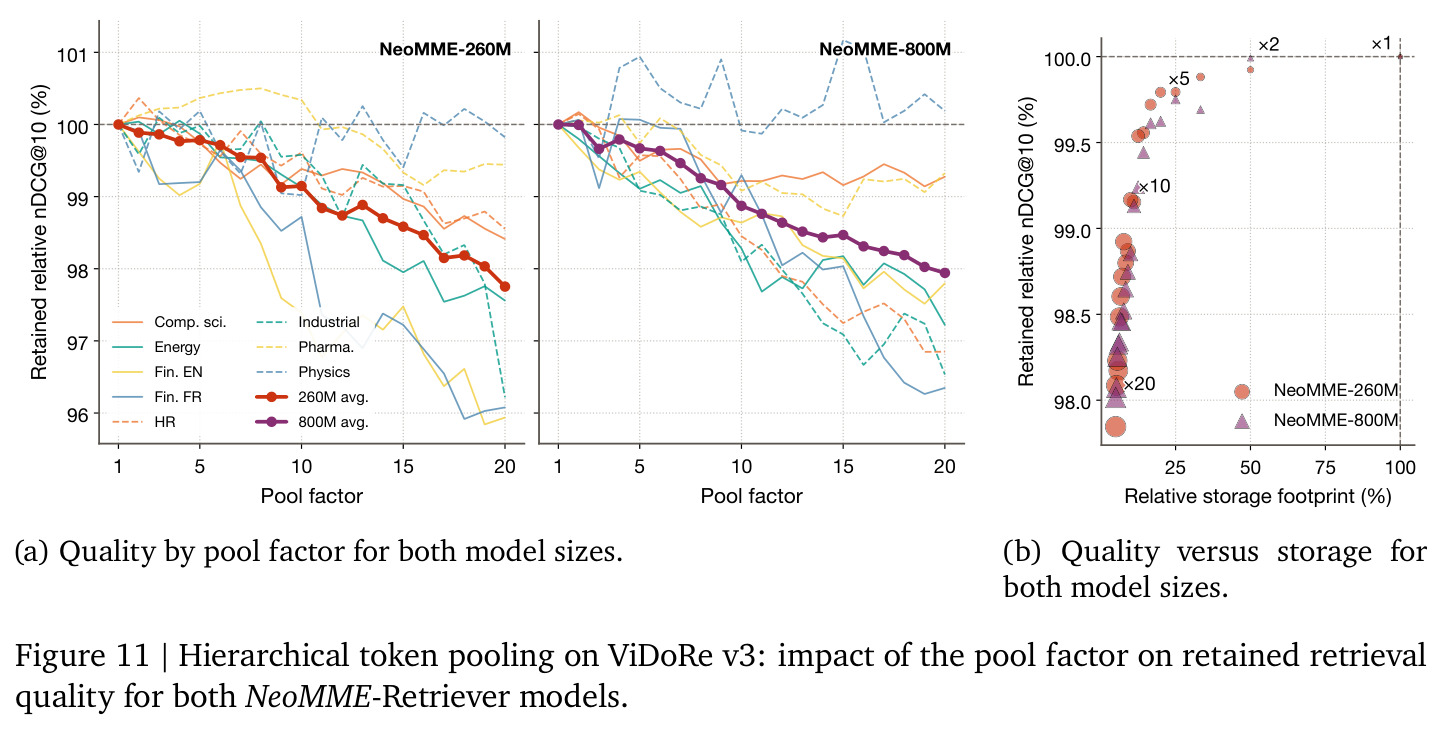
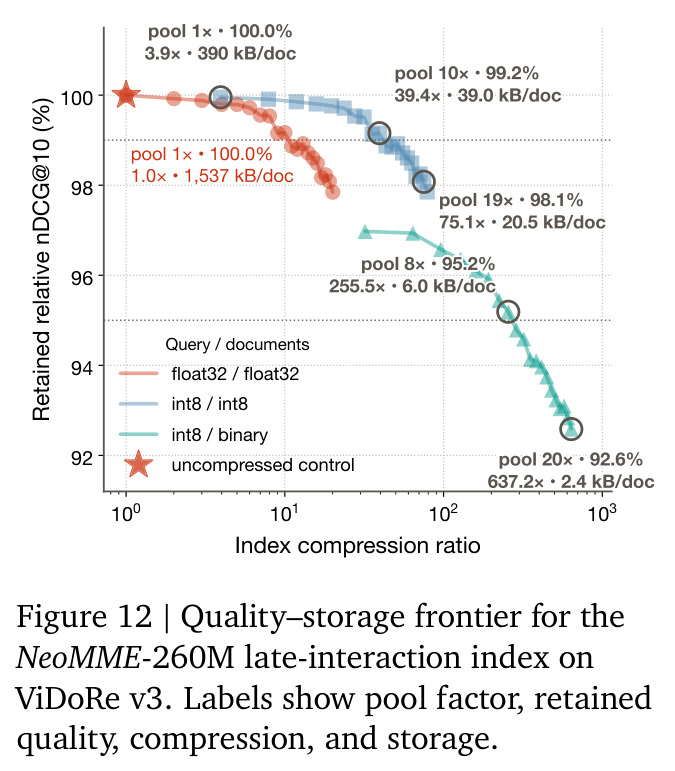
层级 token 池化把语义相近的文档向量聚类后用均值替代,池化因子 $k$ 表示每 $k$ 个向量合并成 1 个,存储近似缩小 $k$ 倍。非对称量化利用「文档占索引体积大头、查询只编码一次」的不对称性:查询用 int8、文档用 1-bit 二进制码,打分时反位移恢复。两者结合可对迟交互索引做数量级压缩。
论文最亮眼的工程成果——255 倍压缩仅损失不到 5% 检索质量——完全建立在这两项技术之上,是其能否大规模落地部署的关键。
研究动机
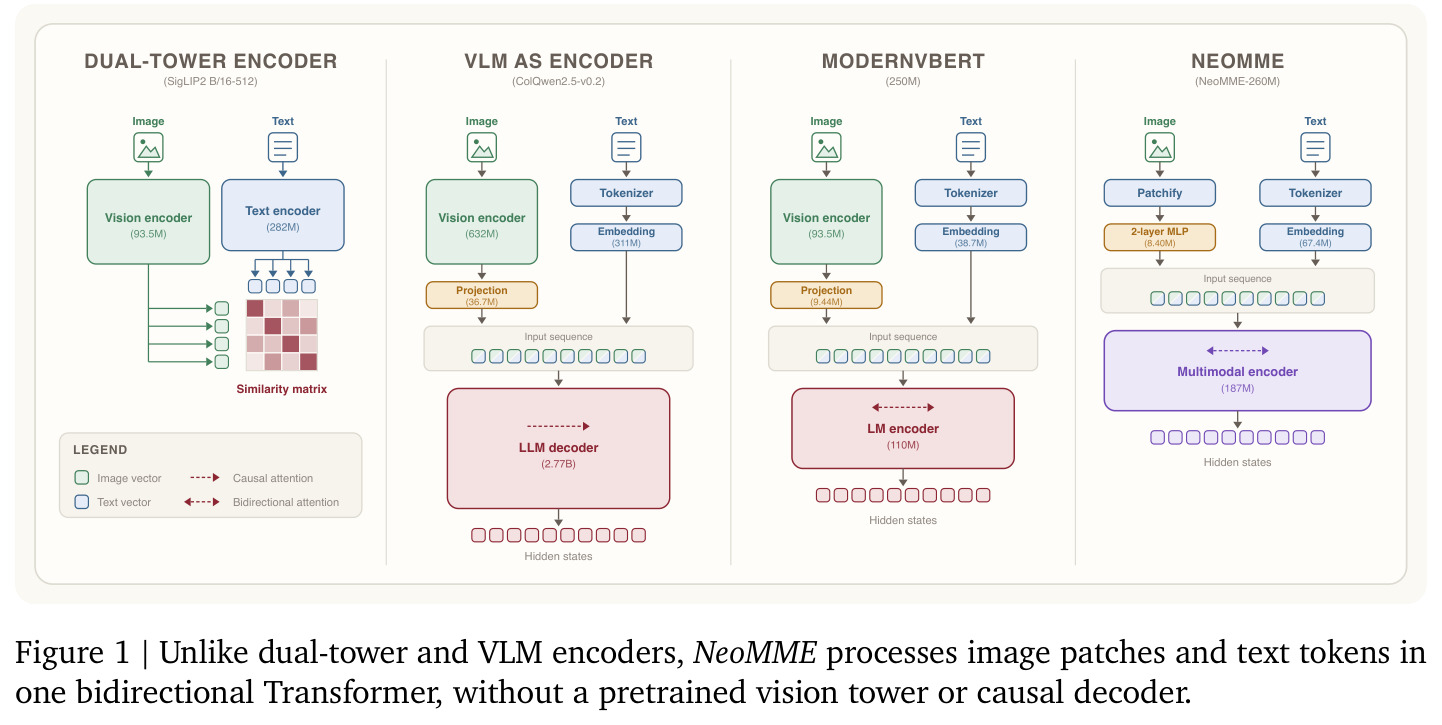
视觉文档检索系统普遍「寄生」在生成式 VLM 上:ColPali 直接复用 Qwen2 级别的视觉塔加因果解码器(2.9B–3.75B 参数),DSE、Jina Embeddings v4、Nemotron ColEmbed V2 也都从预训练 VLM 改造而来。这些模型本来是为图像-文本生成设计的,拿来做非生成式的嵌入任务时继承了巨大的参数量与算力开销。另一条路是用 250M 量级的 ModernVBERT:它把因果解码器换成了双向编码器,但仍然要背一个单独预训练的 SigLIP2 视觉塔。更早的双塔结构(CLIP/SigLIP)模态交互很浅,而 VLM 结构的生命周期是割裂的——视觉塔和语言模型要分别预训练、对齐、微调、部署,没有一条统一的计算路径。
本文的目标是构建一个完全从零预训练、由单一双向 Transformer 同时处理多语言文本和原始图像 patch 的多模态原生编码器家族(260M 与 800M 两个规模),在 16,384 token 上下文下高效编码高分辨率文档图像;再以此骨架微调出同时输出稠密与迟交互两种表示的视觉文档检索器 NeoMME-Retriever,在 ViDoRe 基准上做到同参数规模的 Pareto 最优,并系统性解决迟交互嵌入的存储、压缩与索引吞吐问题。
与已有工作不同的是,此前从零训练的单塔多模态模型(ViLT、OneR、M3AE)要么从预训练 ViT 初始化、要么只有小规模英文实验;tower-free 生成式 VLM(Fuyu、EVE、SOLO、NEO)虽把 patch 直接喂进主干,但都是因果解码器、面向生成;UniDisc、MMaDA 把扩散搬进共享 Transformer 却依赖外部视觉 tokenizer 且主打生成任务。NeoMME 的独特组合在于四个要素的交集:连续原始像素 patch(而非离散视觉 token)+ 从随机初始化训练的无视觉塔共享双向 Transformer + 图像条件化的掩码文本扩散目标 + 面向稠密/迟交互双头的文档检索微调——作者明确指出这个组合在已有系统中没有先例。
核心方法
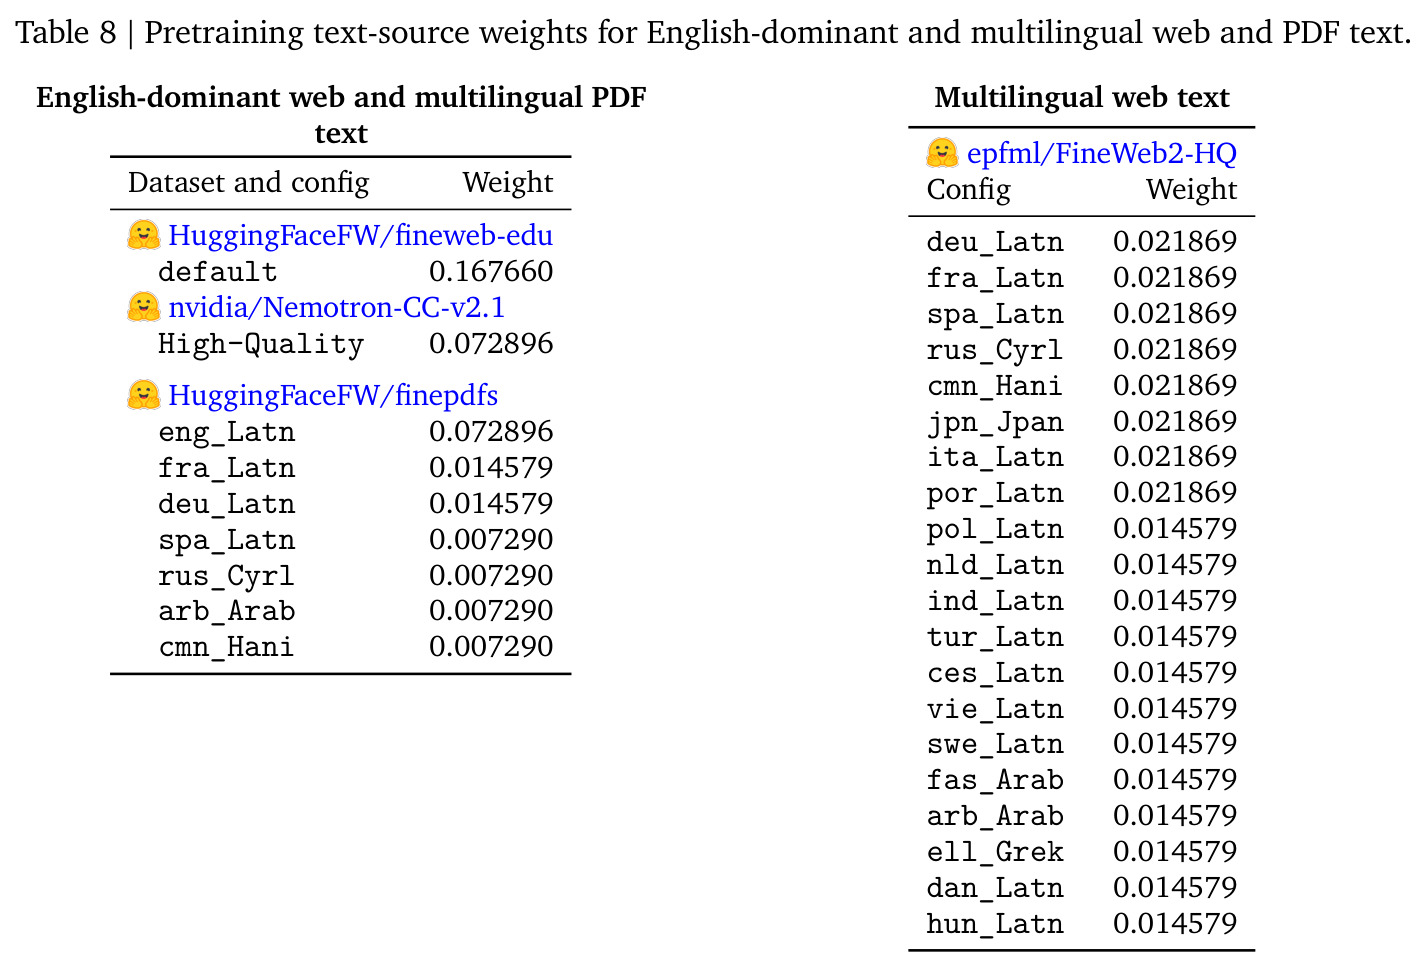
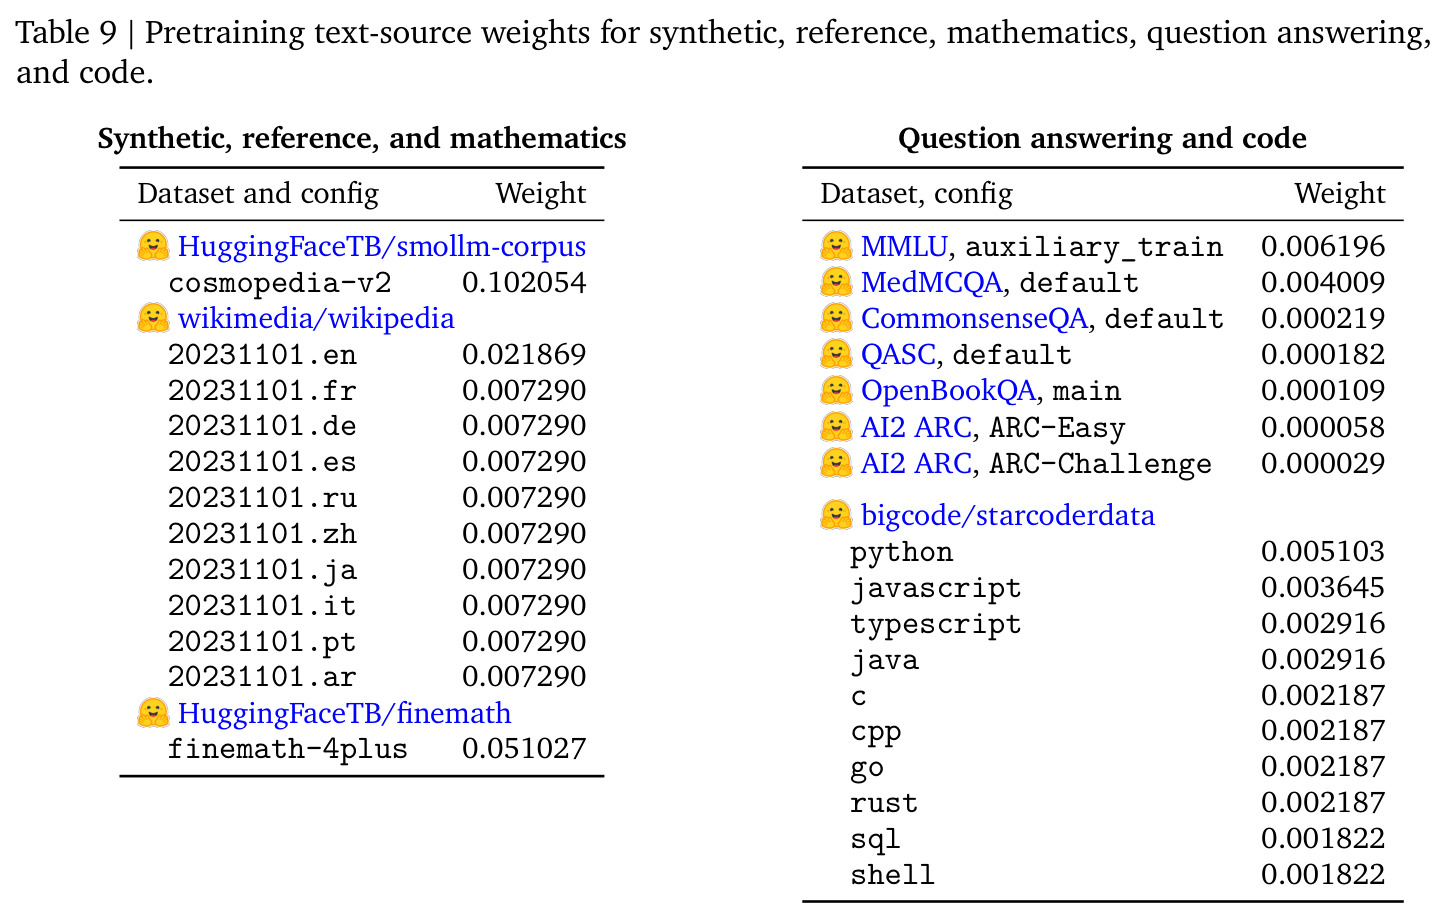
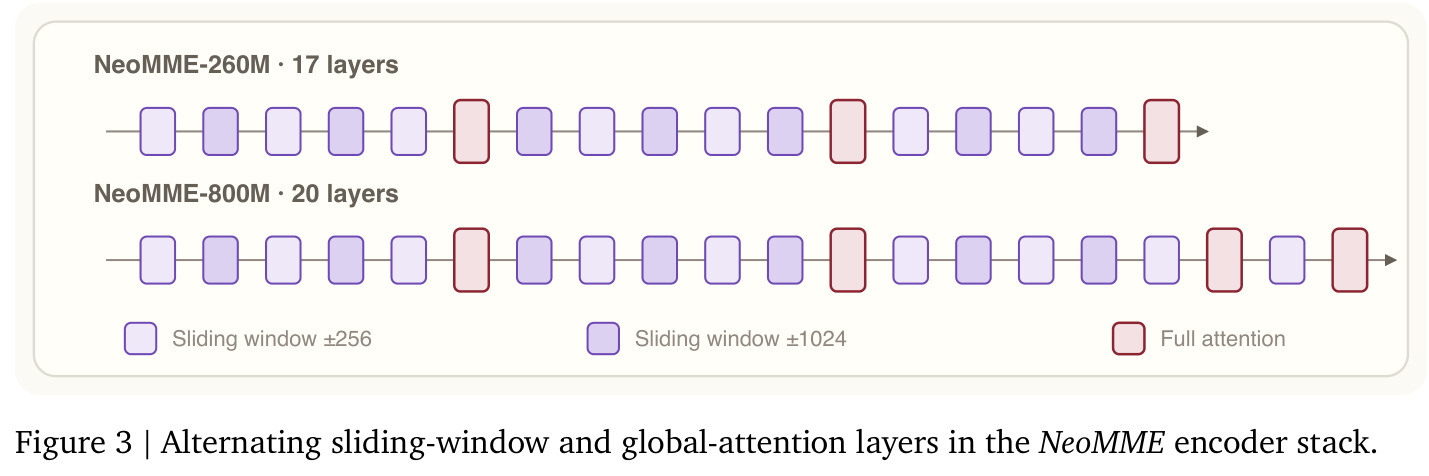
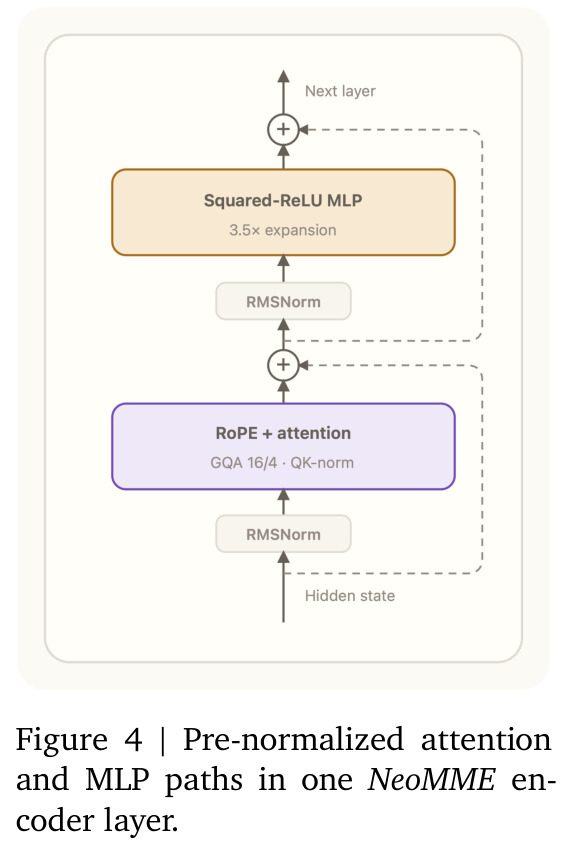
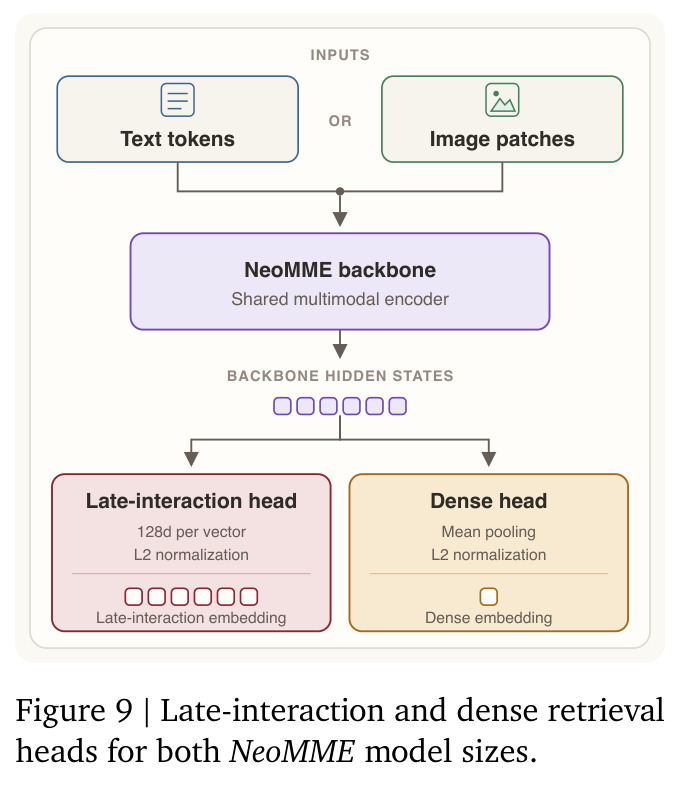
直觉上,作者想让「看图」和「读文」走完全同一条计算路径:文本 token 和 32×32 像素 patch 各自经过轻量投影进入同一隐藏空间,之后所有 Transformer 层共享,没有任何预训练视觉塔。技术路线分五步:(1)从零训练 131,072 词表的字节级 BPE 分词器,允许合并跨越空白边界以捕捉多词表达和代码缩进;(2)搭建长上下文双向骨干——滑动窗口与全局注意力交错、GQA、QK 归一化、2D RoPE、ALBERT 式分解嵌入;(3)在约 524B 打包 token 上做图像条件化掩码离散扩散预训练:纯文本段遮盖率 $\rho\sim U(0,1)$,多模态段 $\rho\sim U(0.3,1)$,图像 patch 永远可见、不做任何图像重建目标;(4)加迟交互头(每 token 线性投影到 128 维)与稠密头(均值池化 + Matryoshka 多宽度)联合对比训练;(5)用 GradCache 支撑大 batch、自研 LIK 融合内核降低 MaxSim 显存峰值,完成检索微调与系统评测。
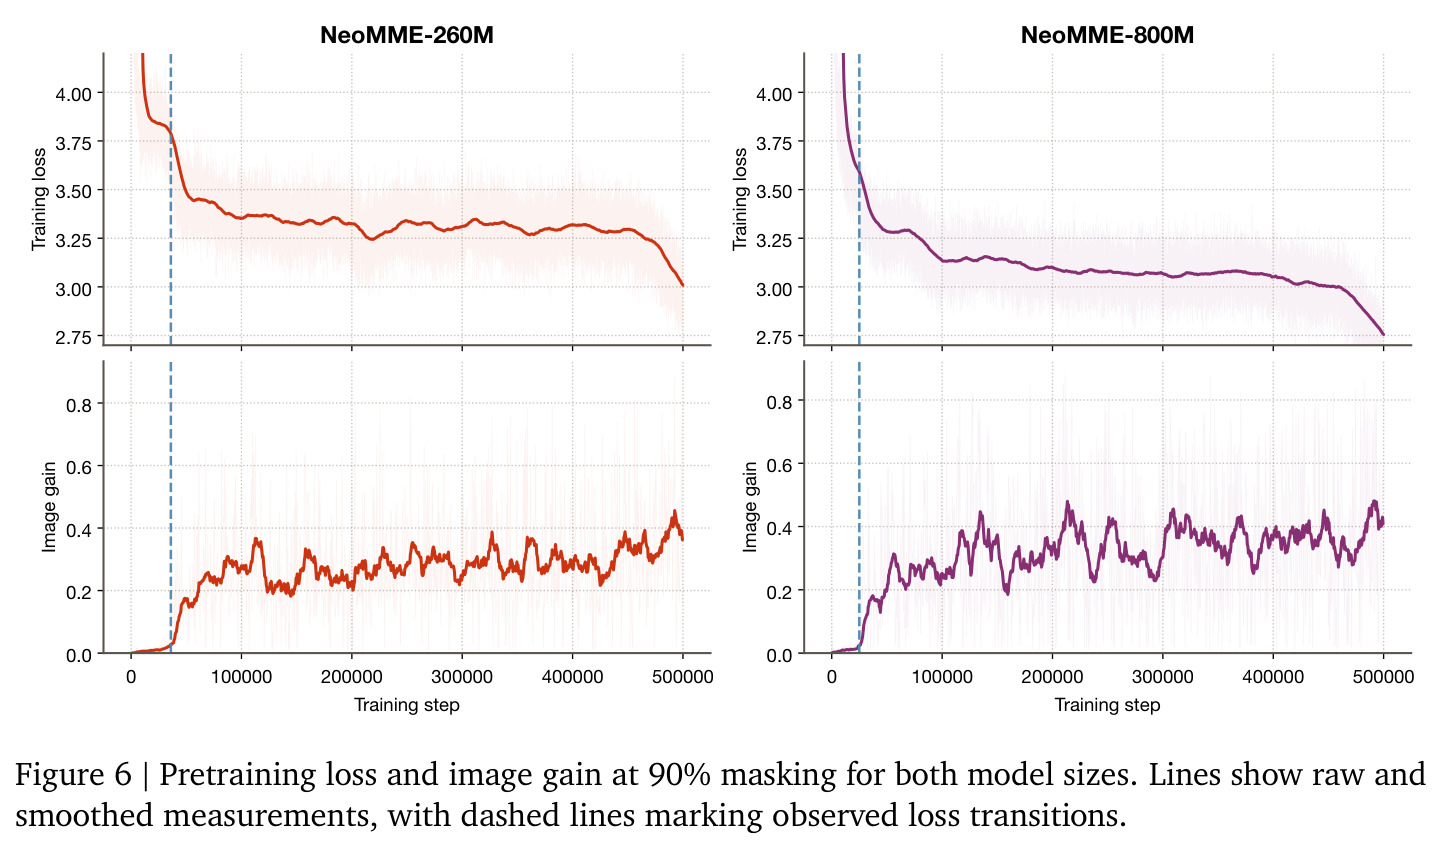
核心创新是把「多模态原生 + 掩码离散扩散 + 单塔双向」三者合一。与 ColPali 类方案的本质区别:完全不继承任何预训练 VLM,视觉通路只是一个 LayerNorm 加两层 MLP 的 patch 投影,参数与算力预算全部留给从零学习的骨干,同一骨干统一了预训练、微调、并行化和服务全生命周期。与 BERT 的区别:遮盖率不再是固定 15% 而是采样的噪声轨迹,且多模态样本最低遮 30%——用「拔掉文本捷径」倒逼模型读图,跨模态消融探针显示 90% 遮盖时可见图像带来 38.4(260M)/40.5(800M)个百分点的 token 恢复准确率增益。与 ModernVBERT 的区别:连 SigLIP2 视觉塔也去掉;与 ViLT 的区别:随机初始化 + 16K 长上下文 + 动态分辨率 + 现代组件(滑动窗口注意力、GQA、NorMuon 优化器、WSD 调度),是一次完整的现代化重做而非旧配方翻新。
方法步骤详情
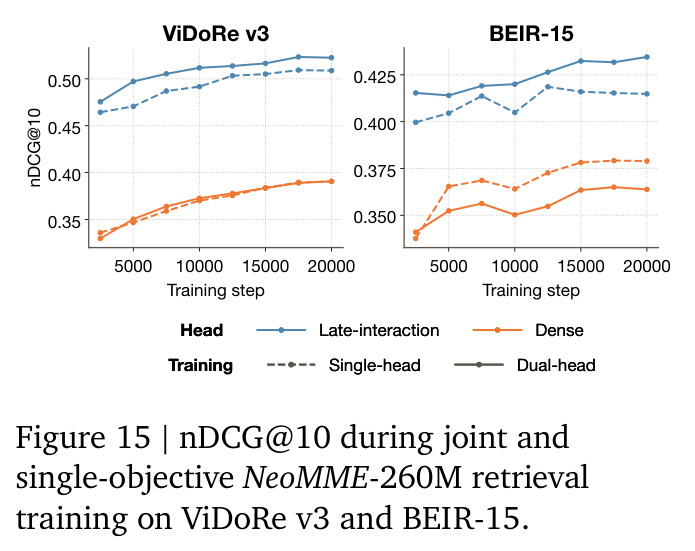
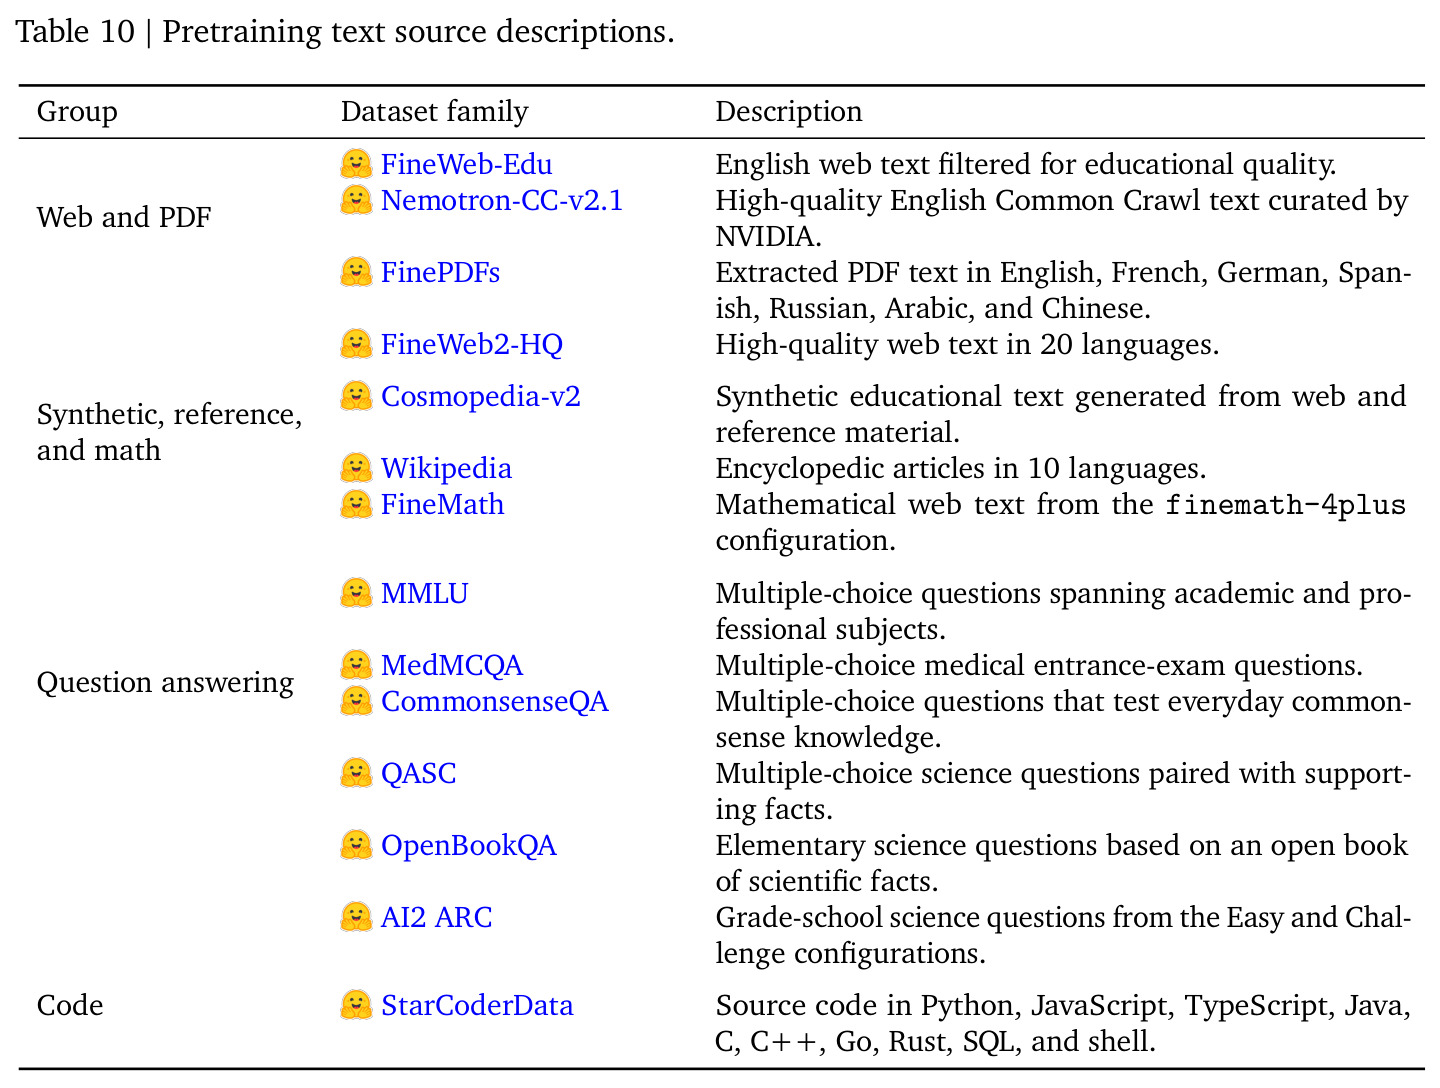
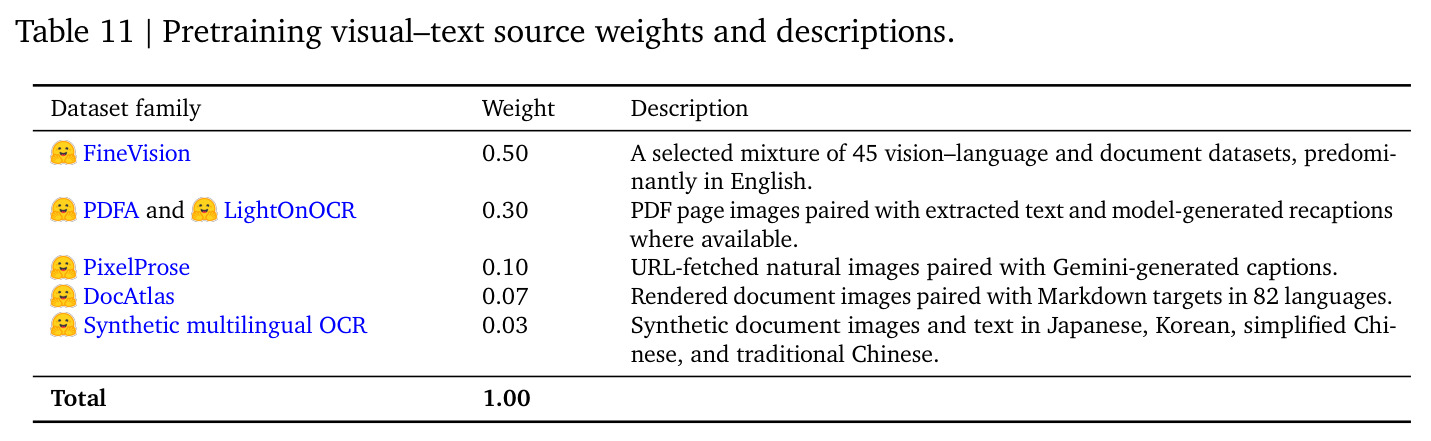
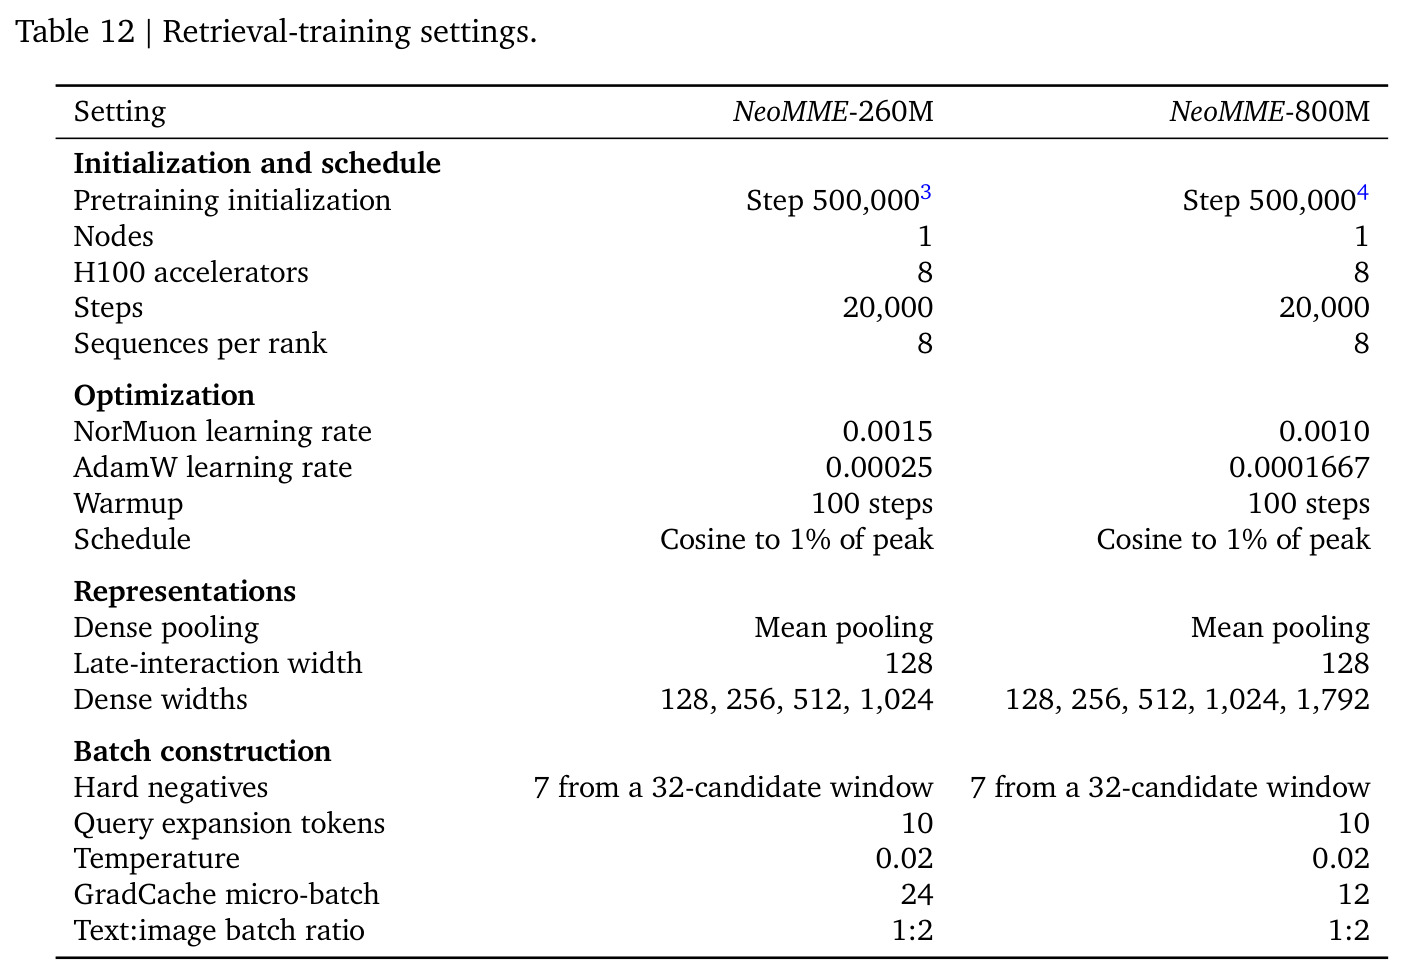
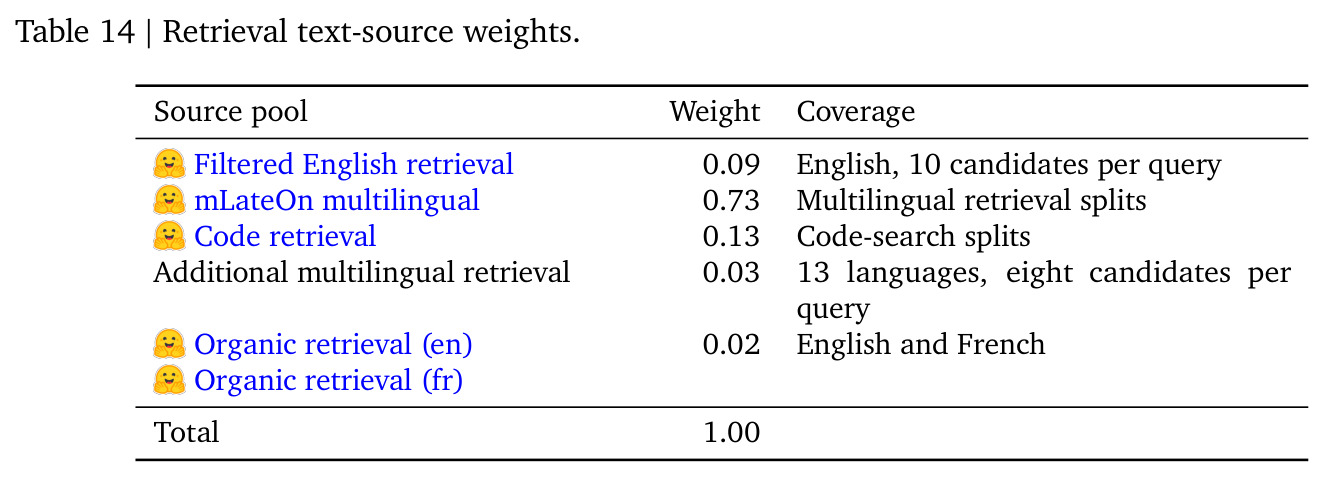
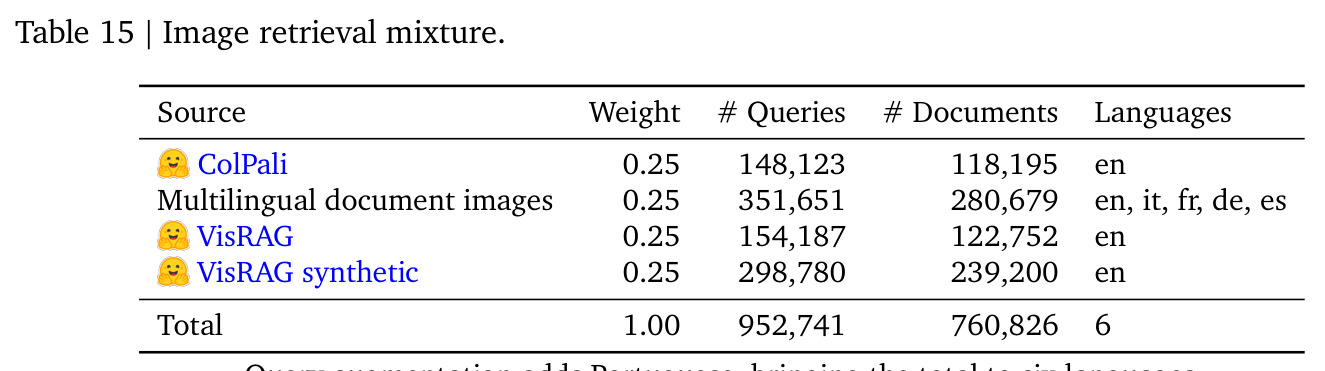
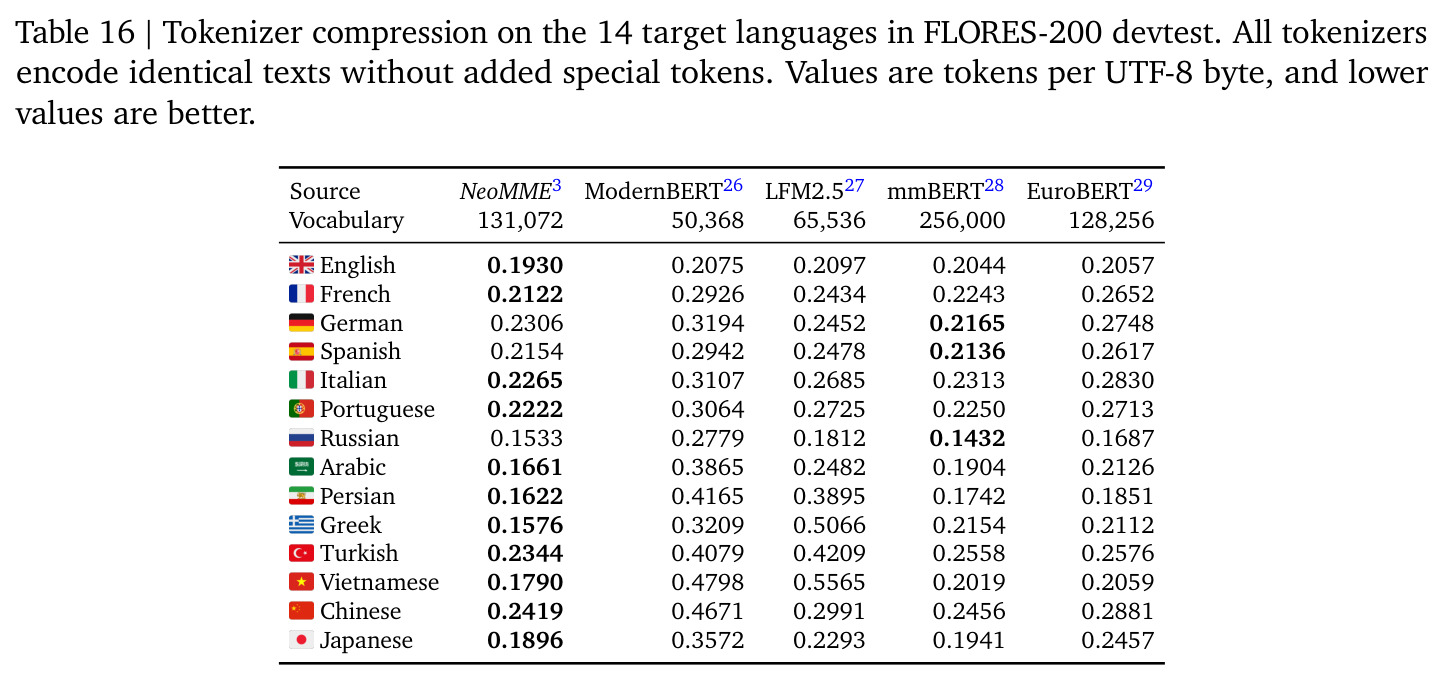
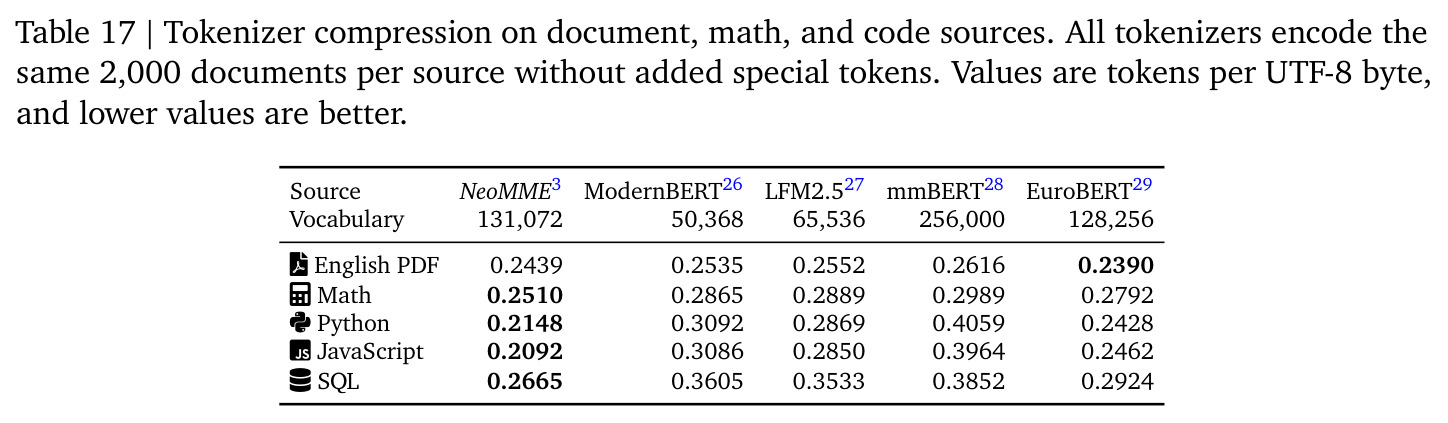
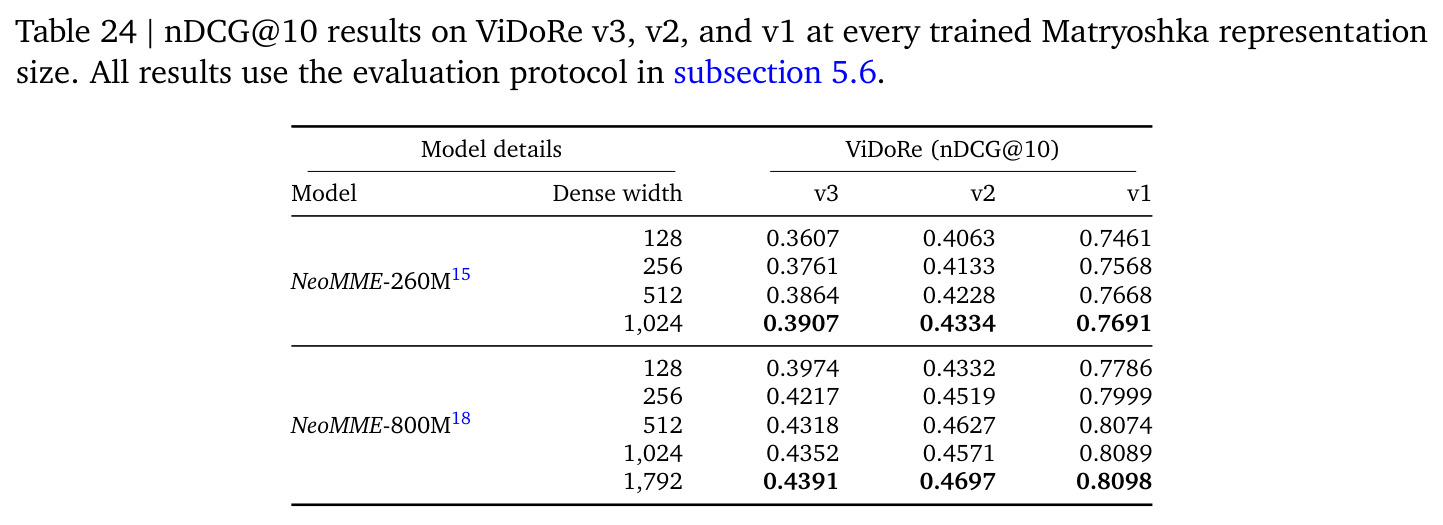
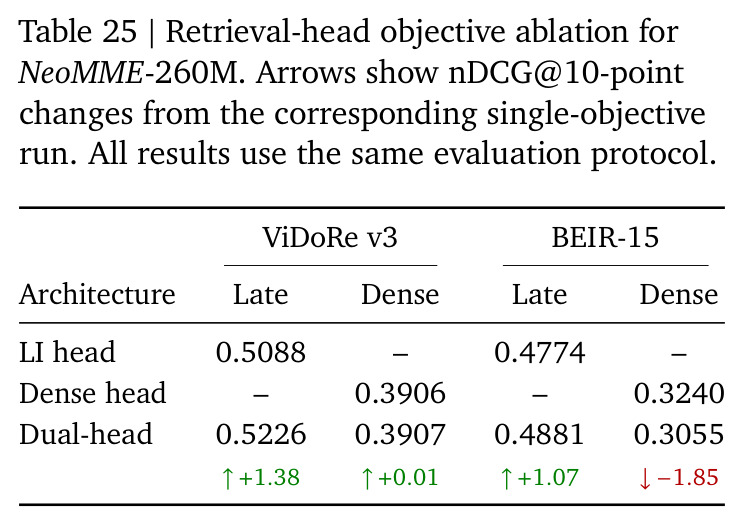
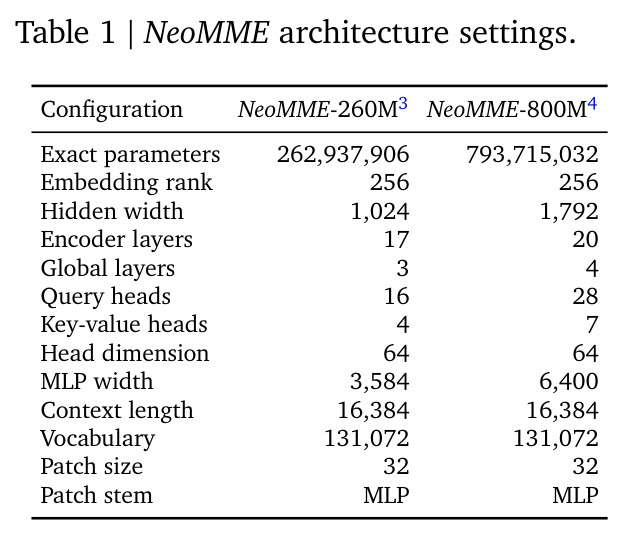
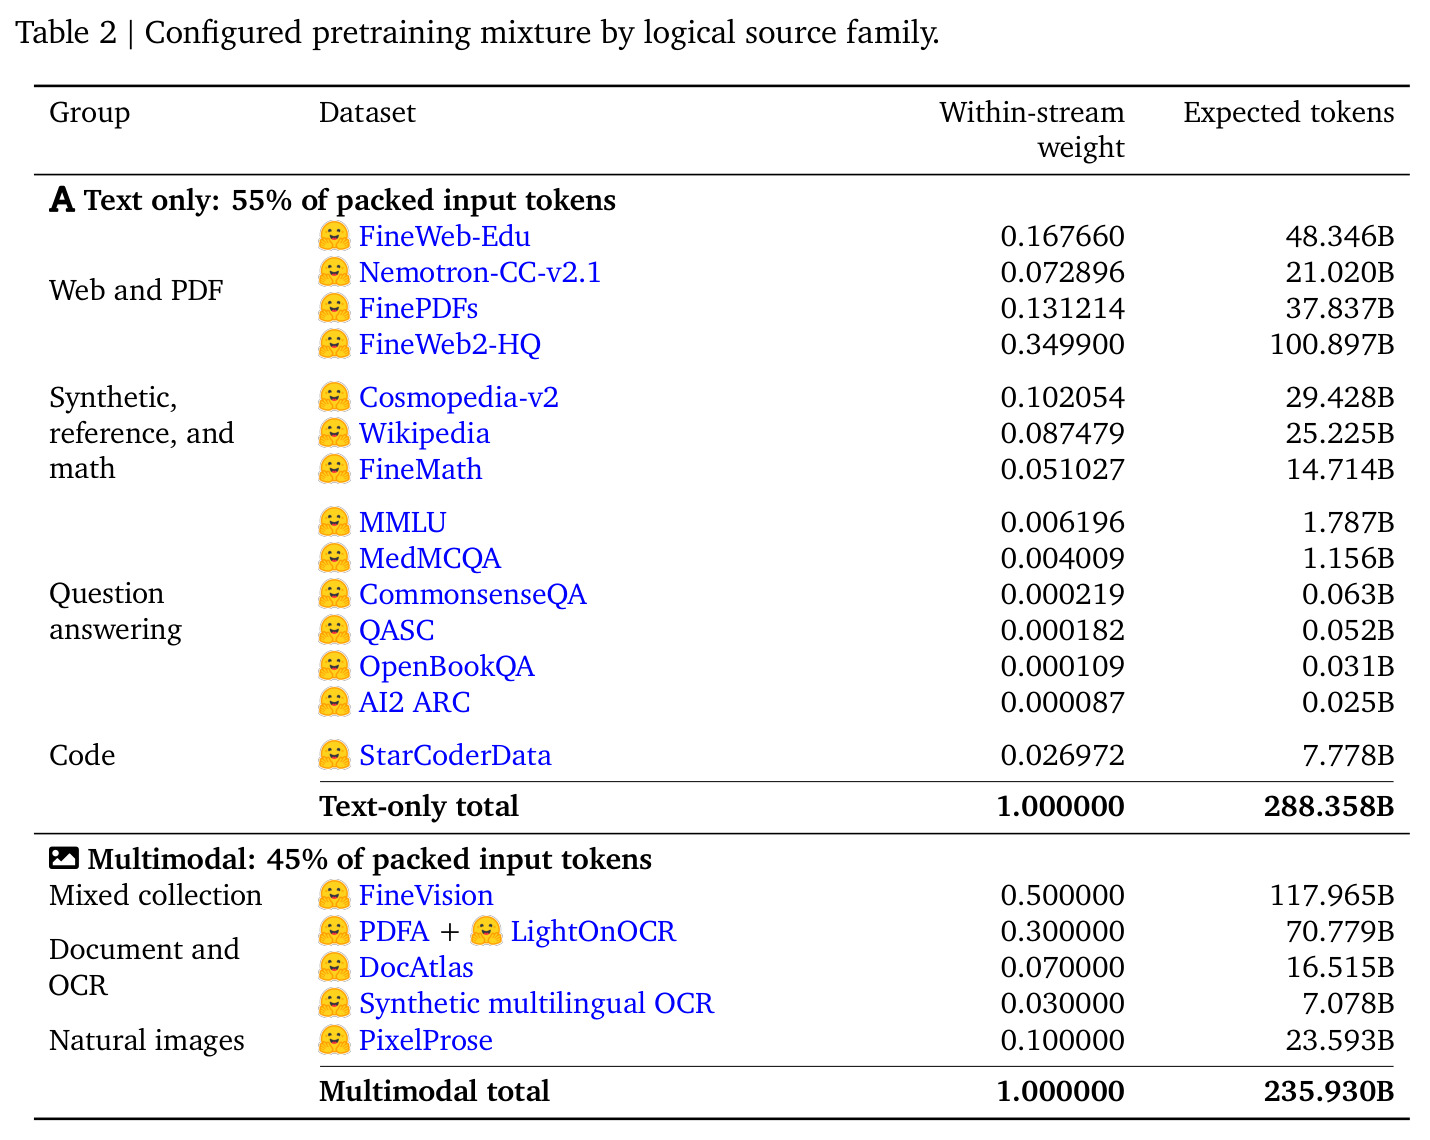
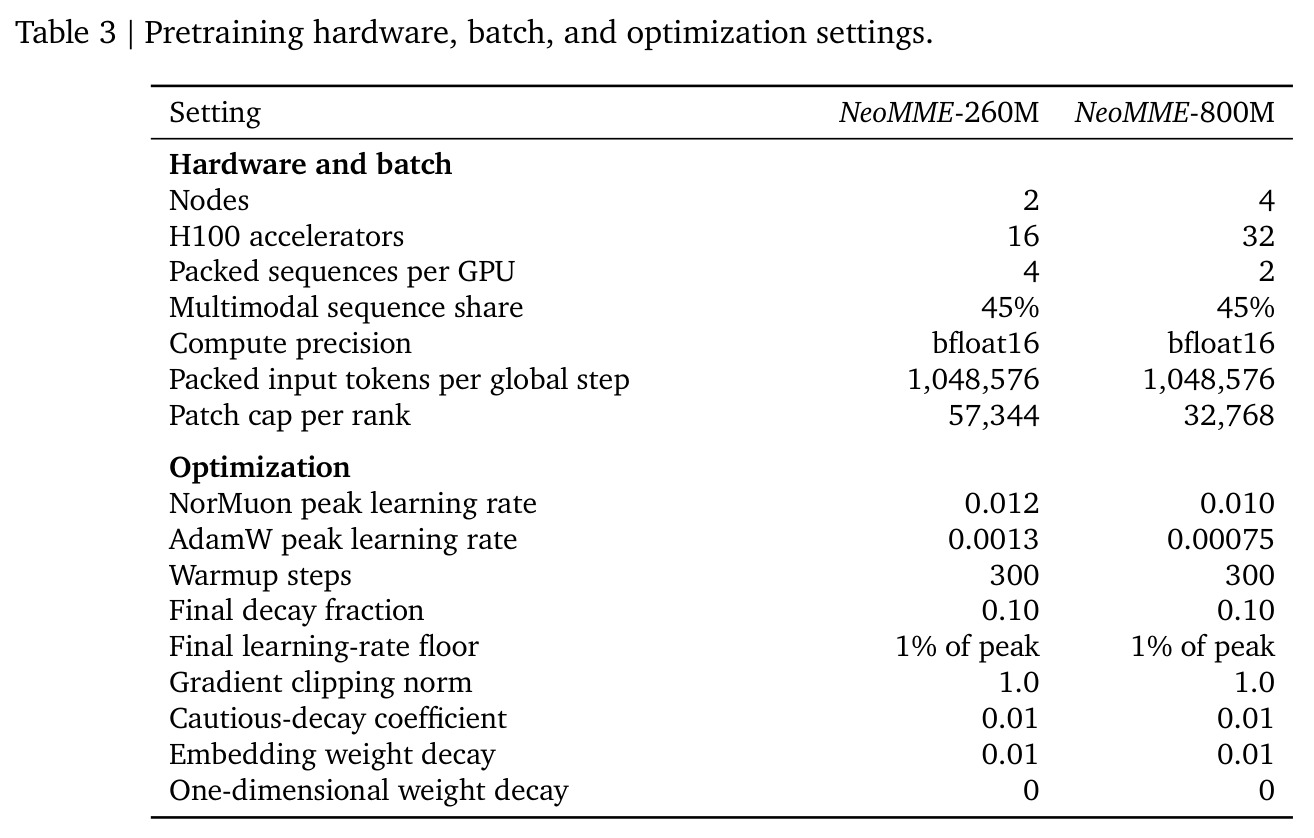
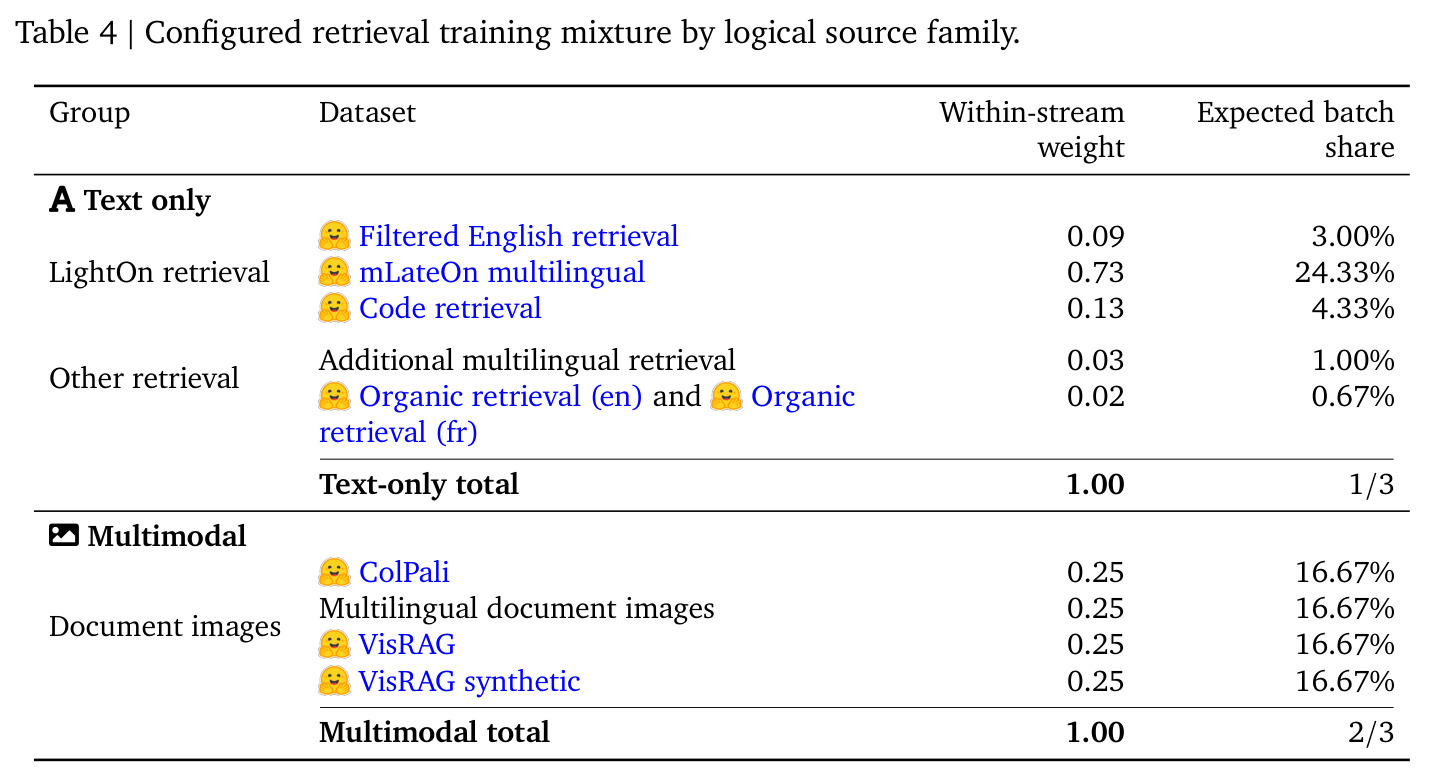
第一步分词器:在 FineWeb-Edu、FineWeb2-HQ、FineMath、StarCoderData 混合语料上训练 byte-level BPE,131,072 词表、单 token 上限 48 字节,在 14 种目标语言的 FLORES-200 上比 ModernBERT 少产 44.4% 的 token。第二步输入层:文本用 256 维查找表加线性投影($\boldsymbol{h}^{(0)}_i = P E^\top x_{i,:}$),图像 patch($3\times32\times32=3072$ 维)经 LayerNorm 加两层 MLP 投影,无 patch 合并模块;预训练时每样本随机采样 1024–2048 像素的长边上限做分辨率增广。第三步骨干:260M 为 17 层/隐藏宽 1024,800M 为 20 层/1792,均支持 16,384 上下文;除每第 6 层和最后一层是全局注意力外,其余为 ±256/±1024 半窗交替的滑动窗口注意力;注意力输出经 sigmoid 门调制,残差分支乘 $(2L)^{-1/2}$,首末全局层注入 token 索引值嵌入;注意力输出与 MLP 降维投影零初始化,使每个块在初始时是恒等映射。第四步预训练:260M 用 2 节点 16 张 H100、800M 用 4 节点 32 张,每全局步 1,048,576 token、50 万步;损失为加权交叉熵 $\mathcal{L}_j=\frac{\sum_{i\in\mathcal{M}_j} w_i\,\text{CE}_i}{\sum_{i\in\mathcal{M}_j} w_i}$,其中 $w_i=1/\max(r_{s(i)}, r_0)$、$r_0=0.05$ 且权重封顶 20;优化用 NorMuon(矩阵参数)加 MasterAdamW(嵌入与一维参数),WSD 学习率调度最后 10% 衰减到峰值 1%。第五步检索微调:$\mathcal{L}_{\text{retrieval}}=\mathcal{L}_{\text{late}}+\mathcal{L}_{\text{dense}}$,温度 $\tau=0.02$,稠密损失在 {128, 256, 512, 1024(, 1792)} 各 Matryoshka 宽度上取平均;多模态流用 Qwen3.5-9B 为 10 万页生成查询、过滤后新增 191,915 条合成查询,并用 Qwen3-VL-Reranker-8B 在两阶段自挖难负例时过滤;另外附加 10 个可学习的查询扩展 token。
技术新颖性
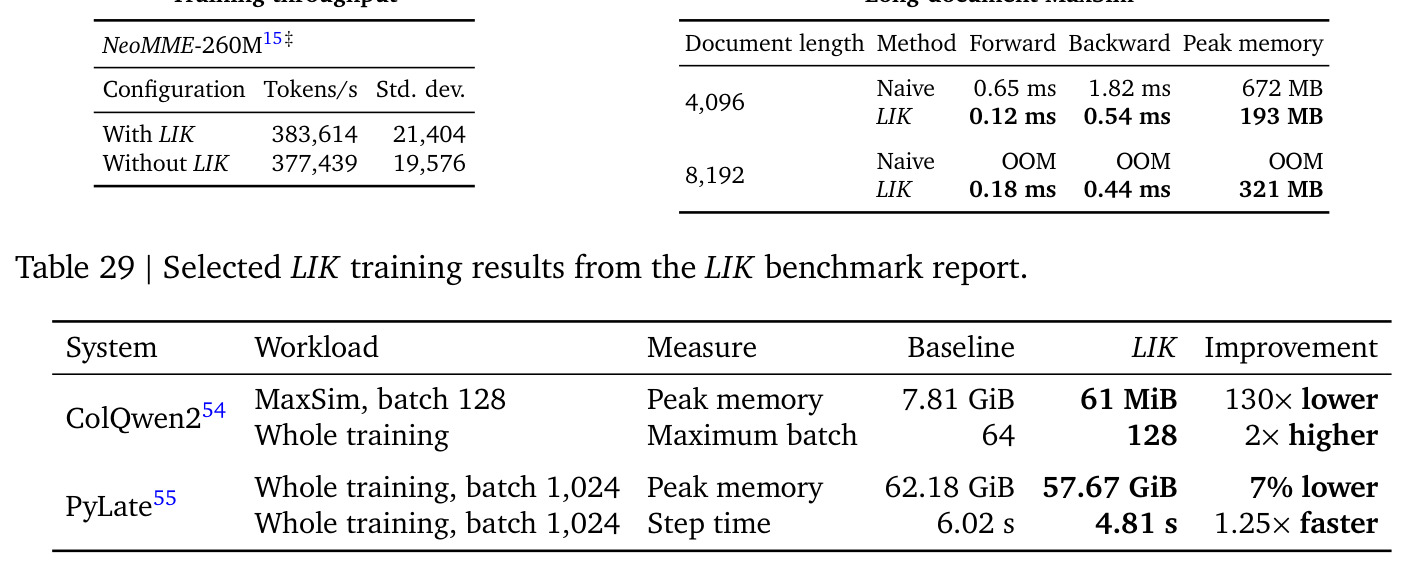
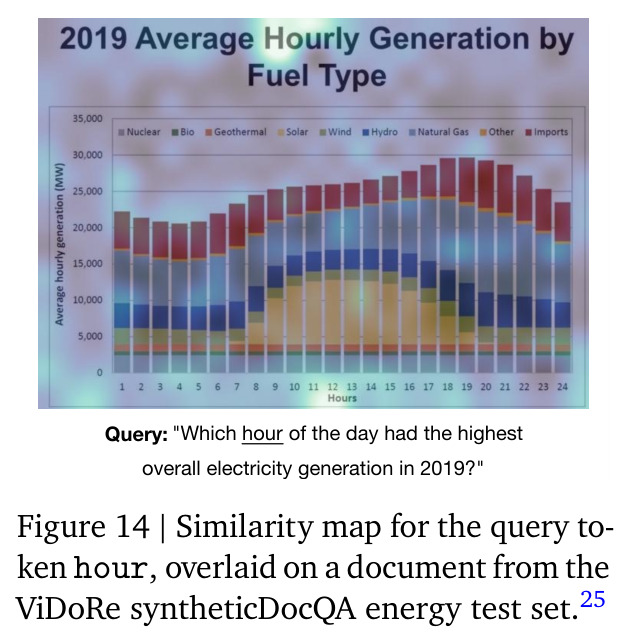
技术新颖性有四层。架构层:首个「原始连续 patch + 从零预训练 + 双向注意力」的无视觉塔多模态编码器——EVE/NEO 系列是因果的,UniDisc/MMaDA 用离散视觉 token,ModernVBERT 保留预训练视觉塔。目标层:图像条件化离散扩散用于表示学习此前只有近似物——DiffEmbed 只做纯文本,LaViDa/MMaDA 依赖外部视觉塔或面向生成;NeoMME 明确不用任何像素重建或图像级对比目标,却证明「只靠文本去噪 + 可见 patch」足以逼出 OCR 级的视觉理解(Figure 14 的相似度图显示模型能对准图表标题和坐标轴数字)。工程层:LIK 融合 MaxSim 内核把 4096 文档 token 的显存峰值从 672 MB 降到 193 MB、反向传播从 1.82 ms 降到 0.54 ms,而朴素实现在 8192 token 时直接显存溢出。评测层:首次给出池化×量化的完整组合网格(255.5× 压缩保 95.19% 质量),为迟交互检索的工业落地提供了可复用的成本-质量曲线。
实验结果
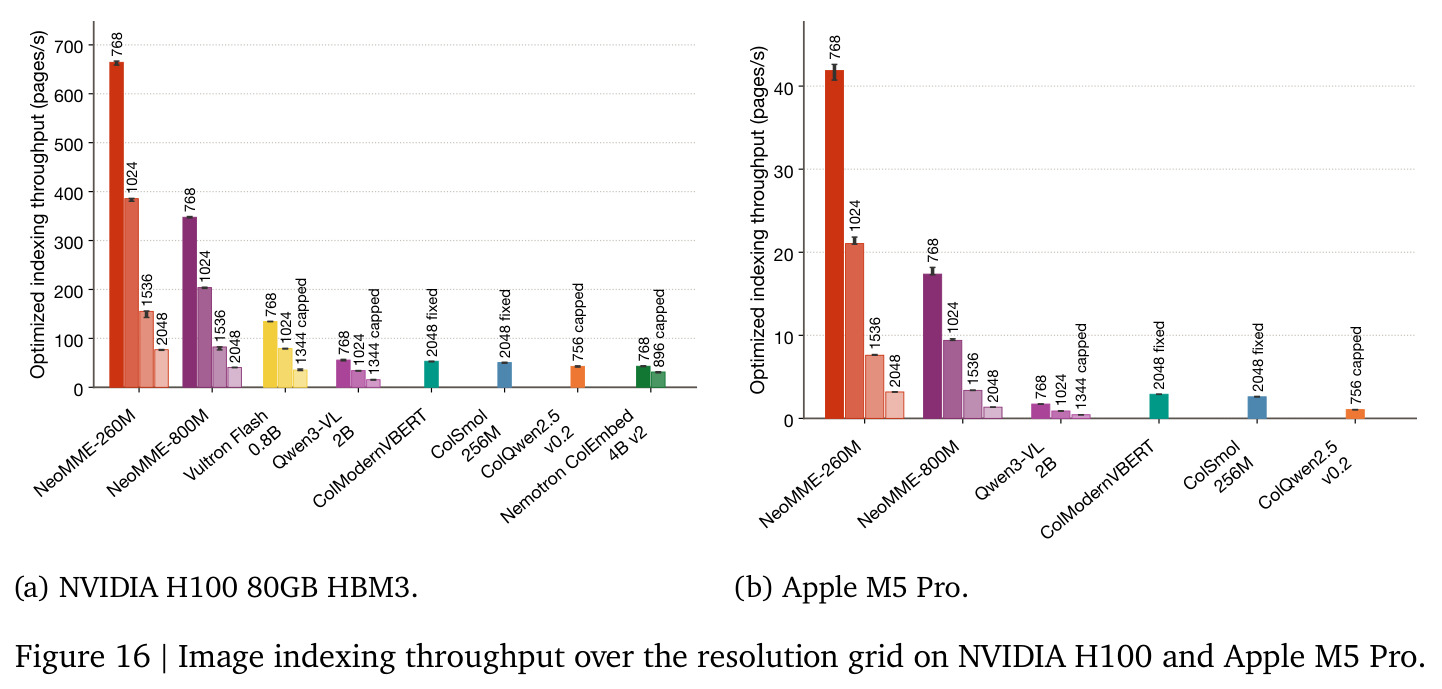
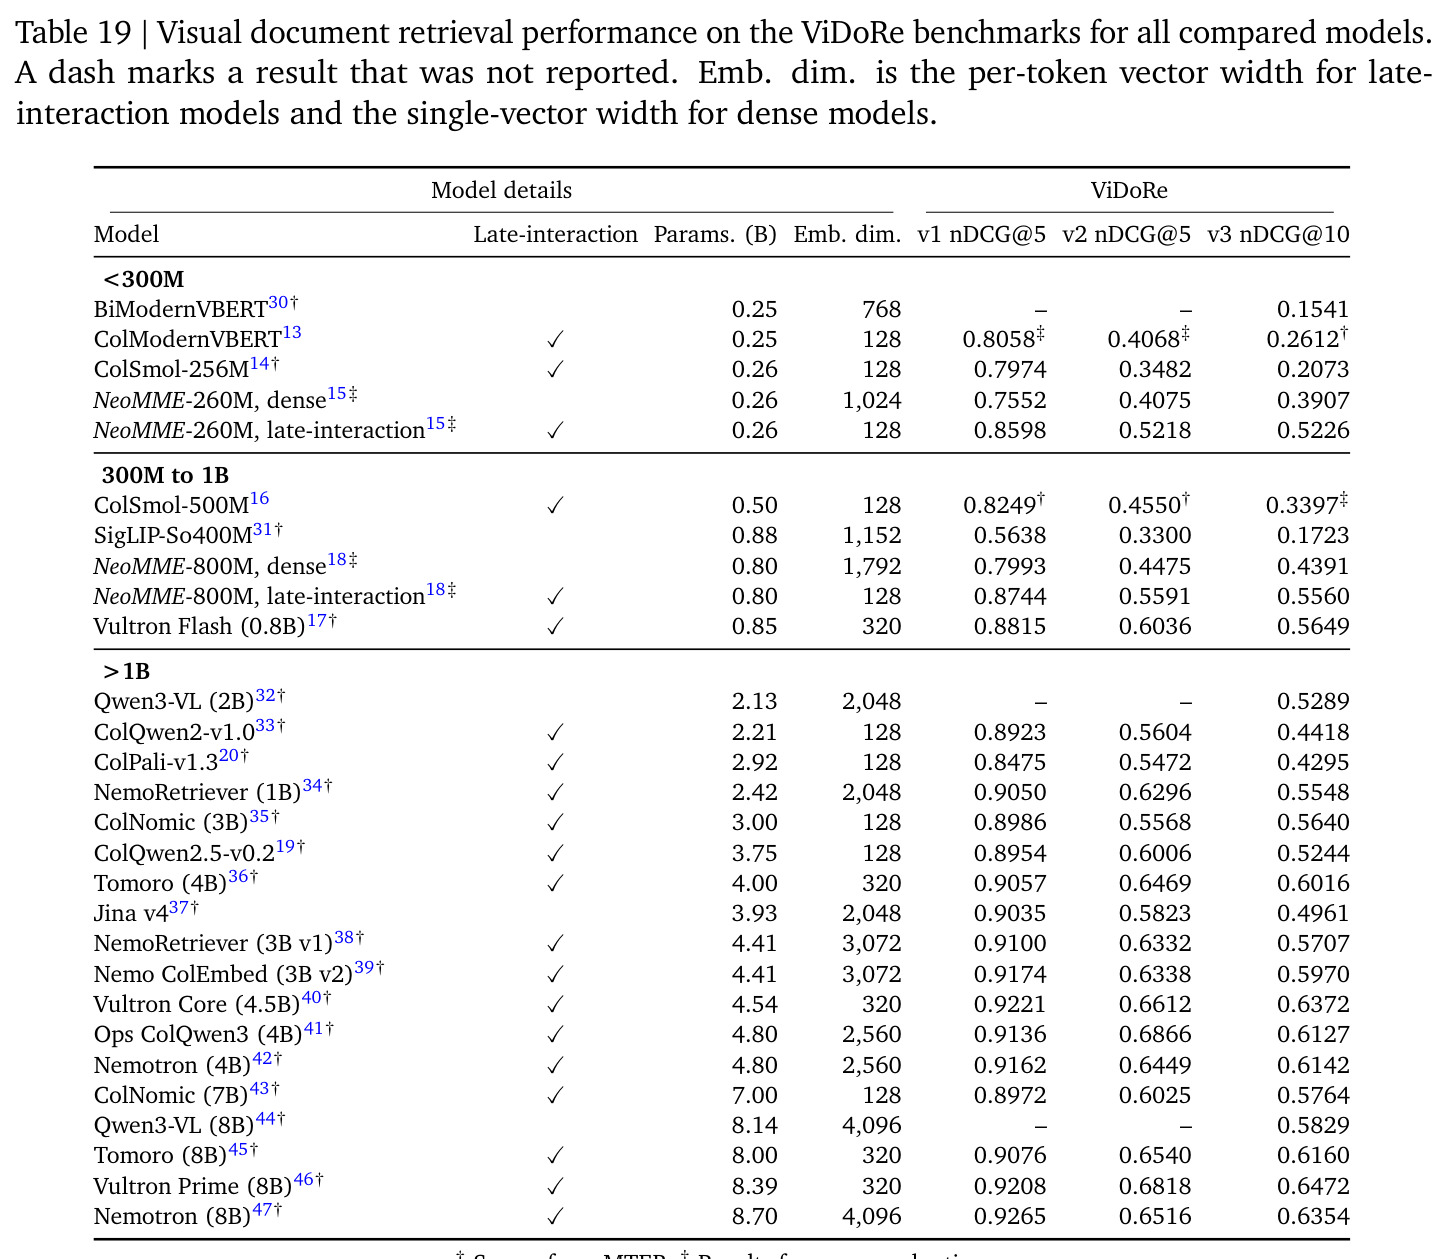
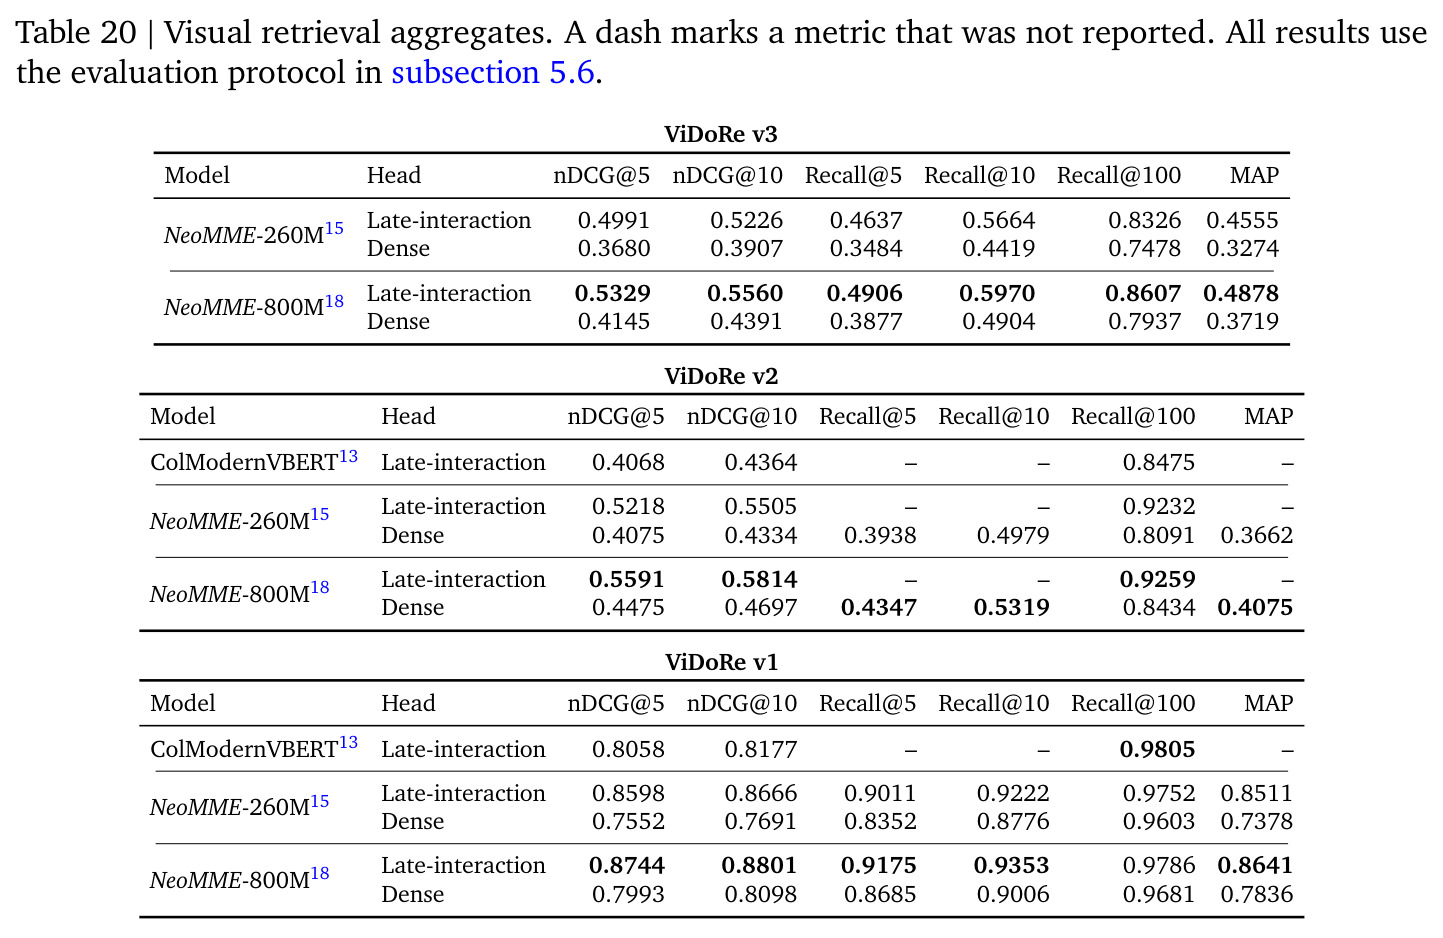
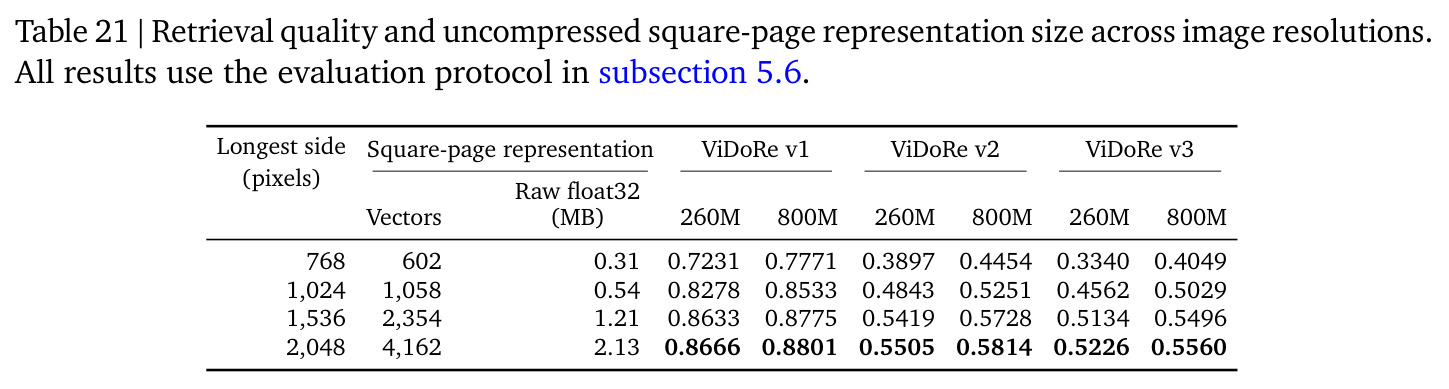
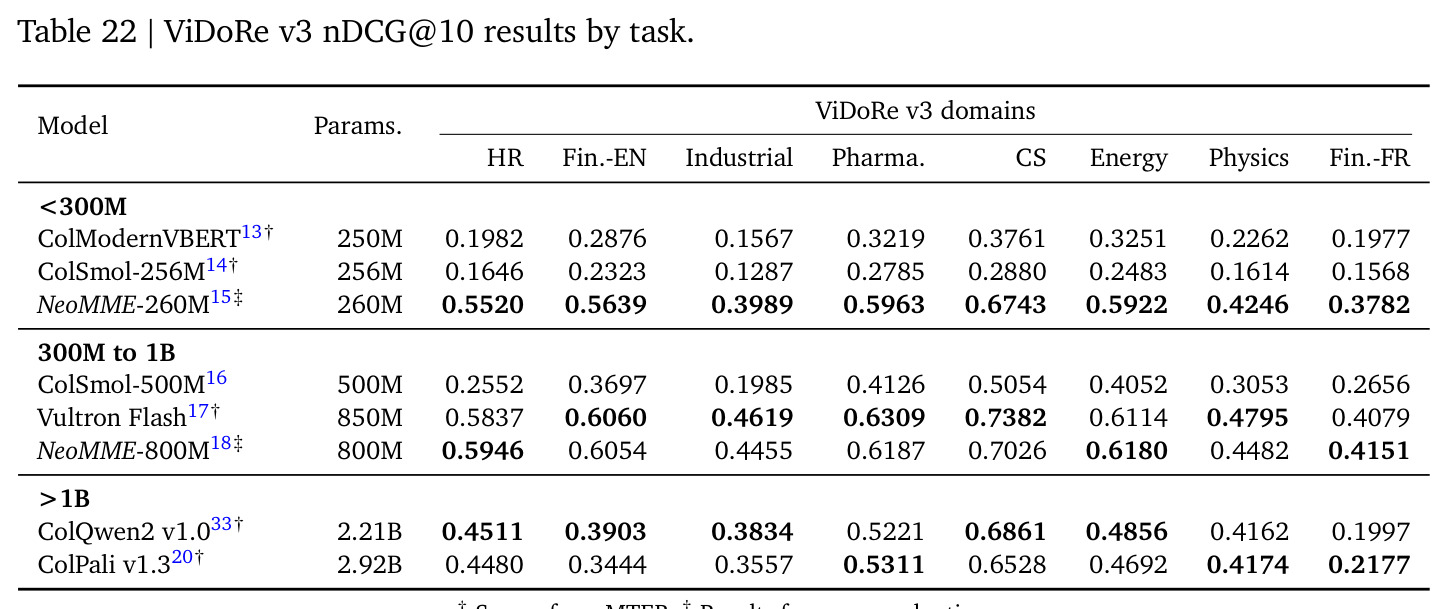
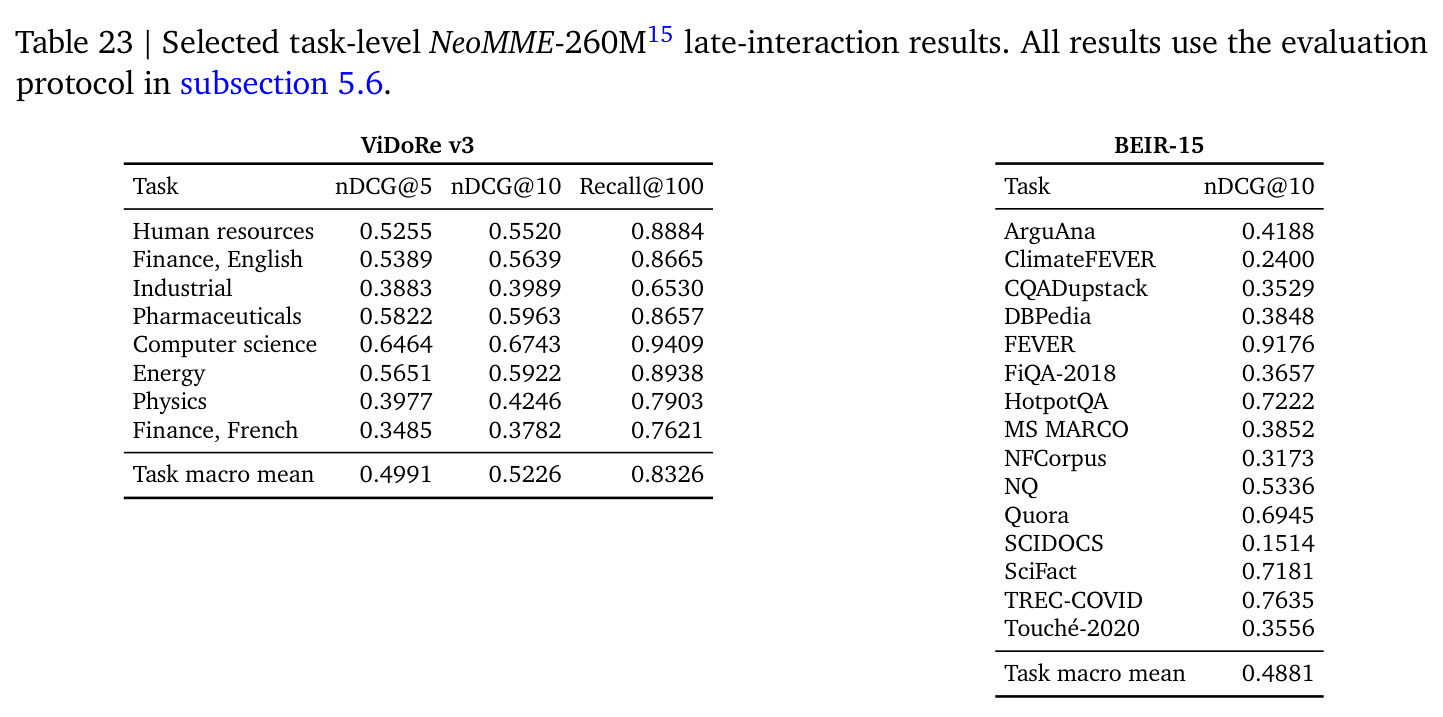
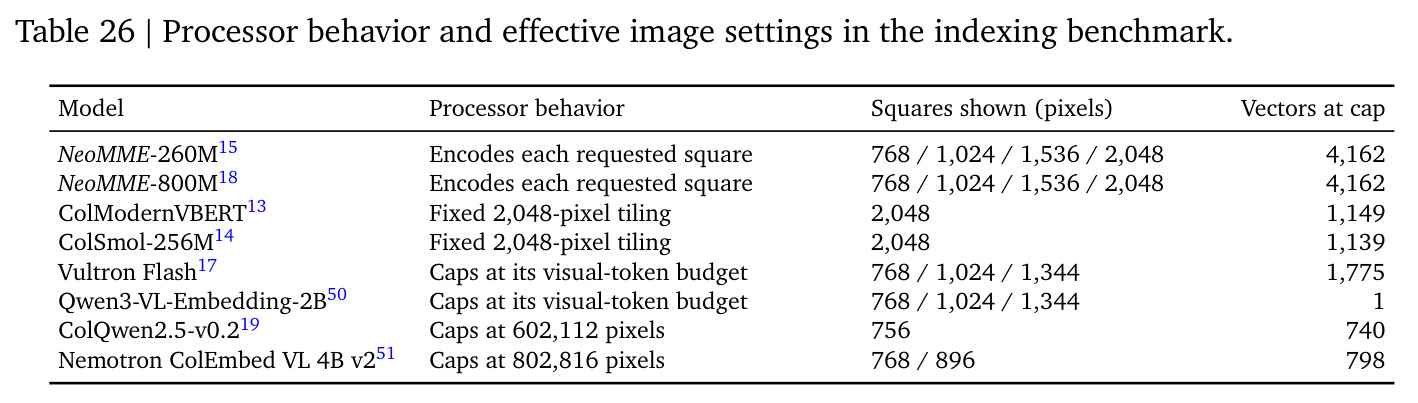
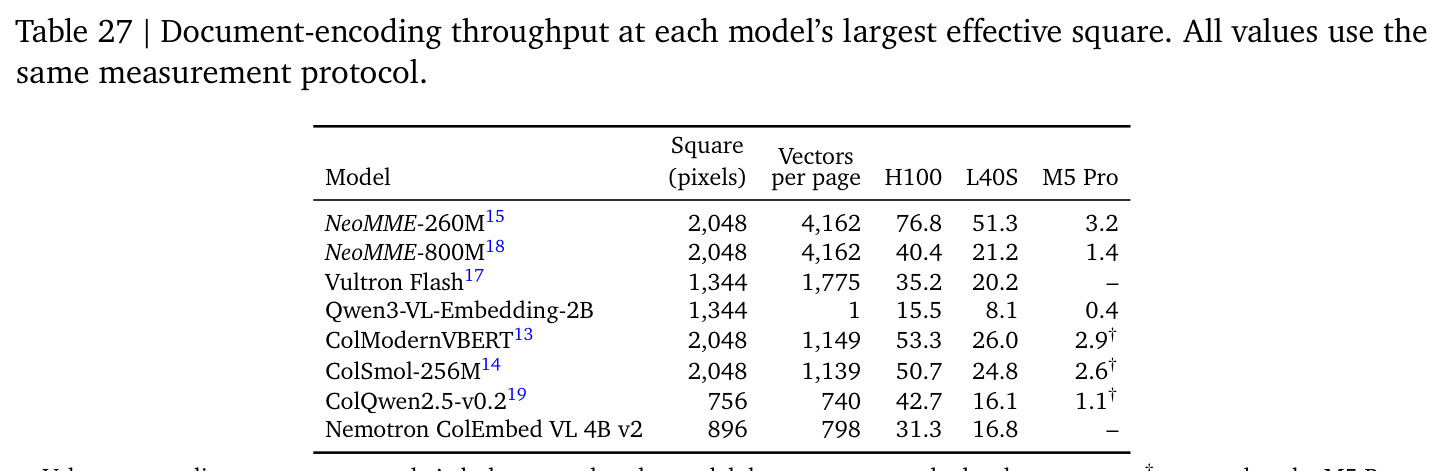
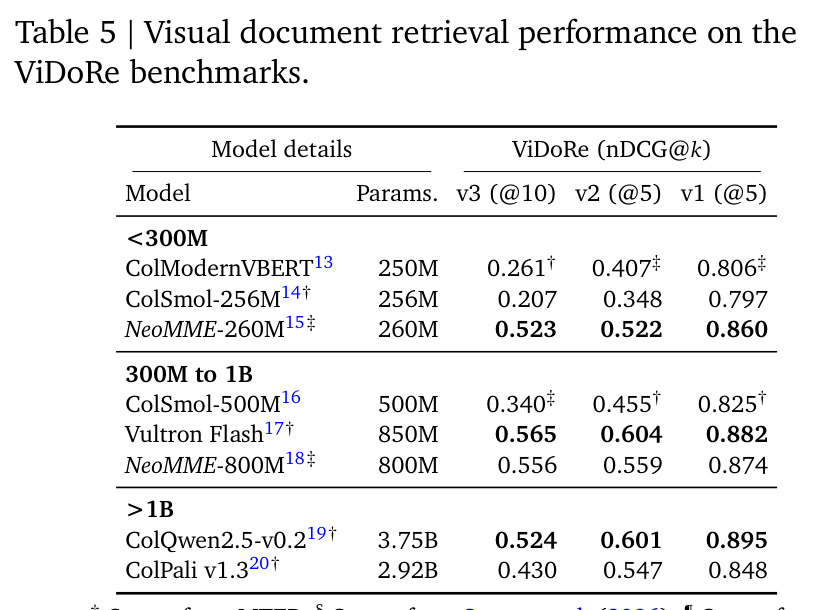
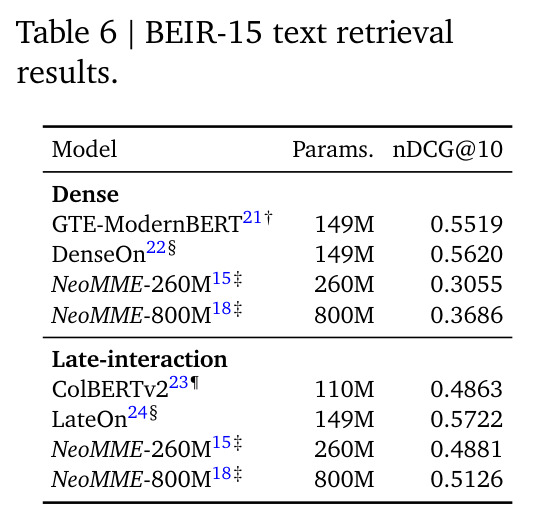
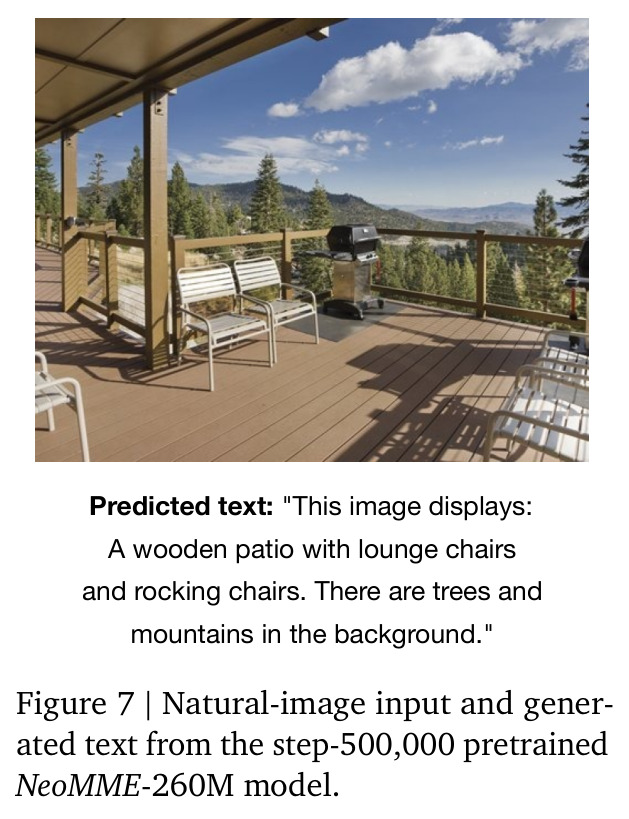
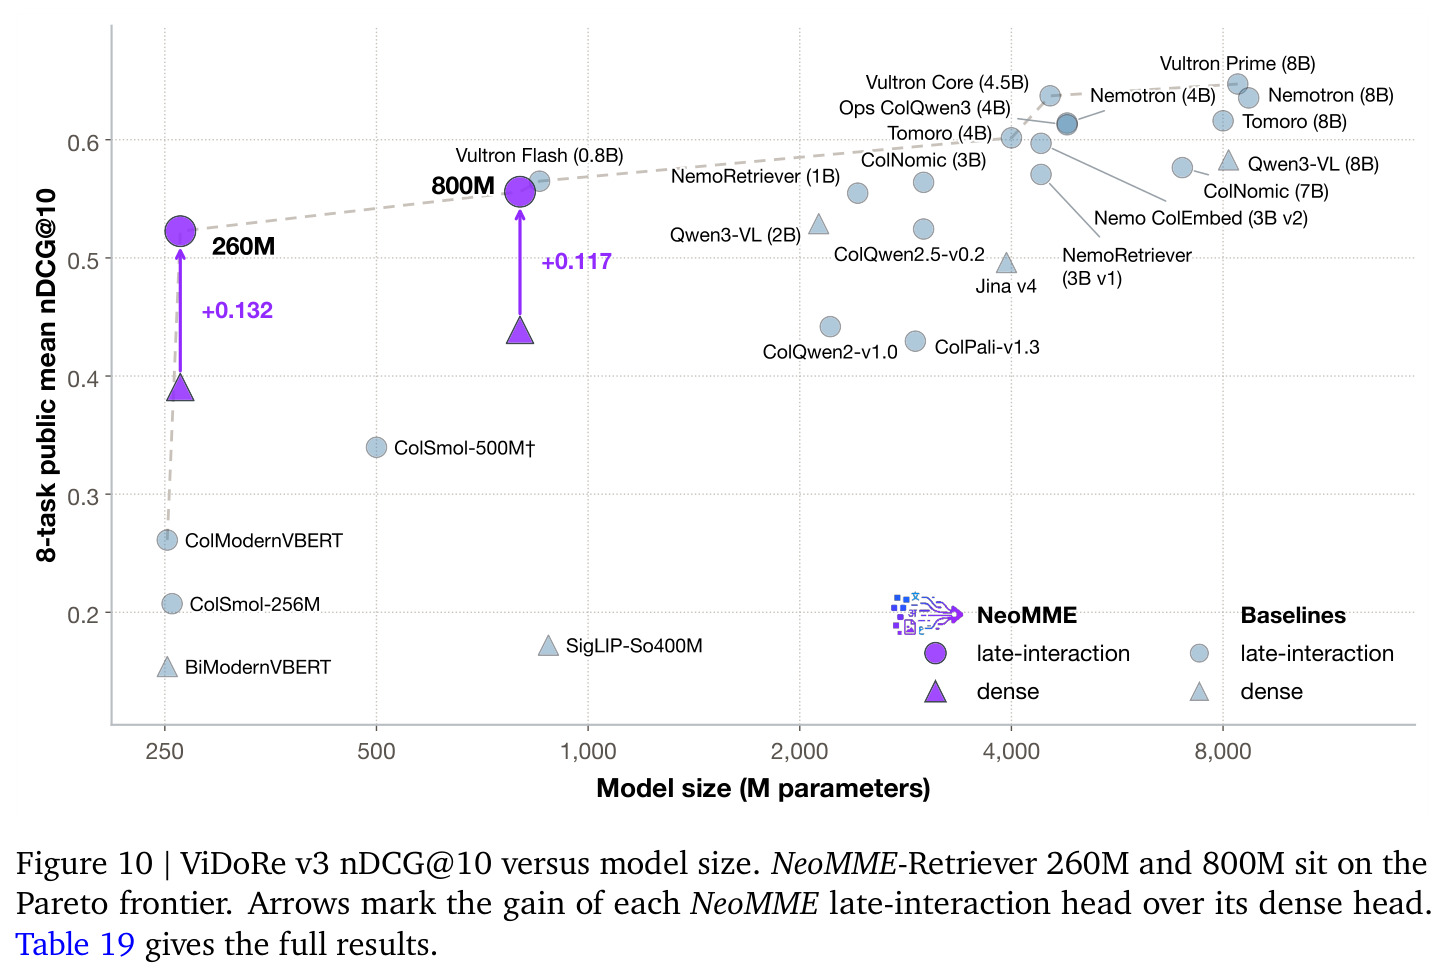
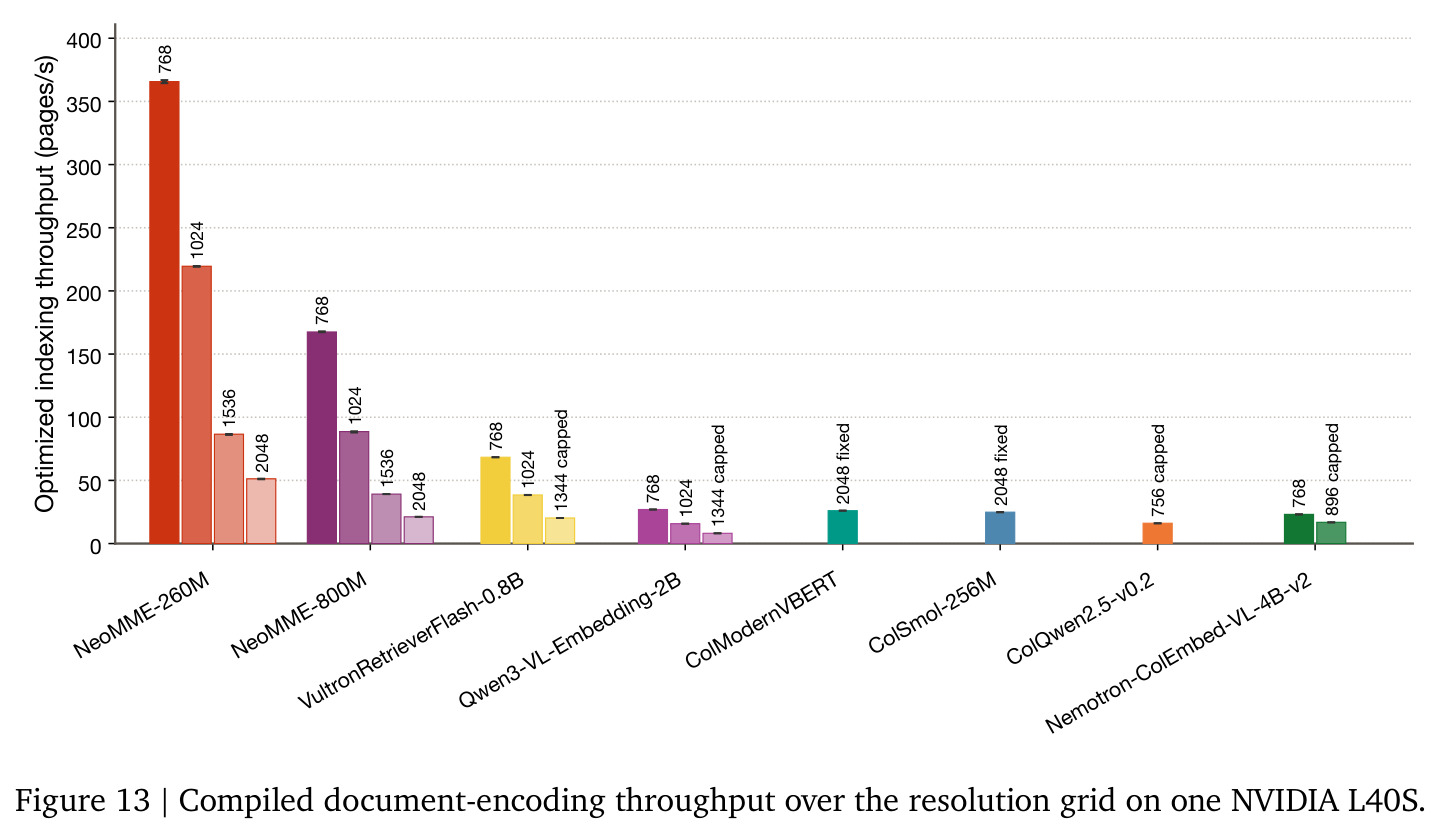
检索质量:ViDoRe v3 上 NeoMME-Retriever 260M 拿到 0.523 nDCG@10,超过所有严格小于 800M 参数的对比模型——比 300M 以下最佳模型高 26.1 分,且与 3.75B 的 ColQwen2.5(0.524)只差 0.2 分而参数量小 14.4 倍;800M 达到 0.556,距 850M 的 Vultron Flash(0.565)仅 0.9 分,反超 ColQwen2.5 达 3.2 分。ViDoRe v2 上 800M 得 0.559、260M 得 0.522;v1 上两者分别为 0.874 和 0.860。文本检索(BEIR-15):迟交互头 260M 0.4881、800M 0.5126(对比 LateOn 0.5722、ColBERTv2 0.4863),迟交互比稠密头高 18.3/14.4 分;稠密头明显偏弱(0.3055/0.3686 vs DenseOn 0.5620)。吞吐:2048×2048 输入下 260M 在单张 L40S 上编码 51.3 页/秒,是 ColModernVBERT(26.0 页/秒)的 1.97 倍;800M 在 1536×1536 达 39.2 页/秒,比 Vultron Flash(1344² 下 20.2 页/秒)快 94%。压缩:池化因子 7 即保留 99% 以上质量并省 7 倍存储;因子 10 加 int8/int8 把每文档从 1536.7 kB 压到 39.0 kB(39.4×)保留 99.16%;因子 8 加 int8 查询/二进制文档压到 6.0 kB(255.5×)仍保留 95.19%。分辨率:长边上限从 2048 降到 1536,相对质量损失至多 1.8% 而方形页只需约 57% 的向量数。迁移能力:17 任务分类均值 75.3(对比专用文本模型 LFM2.5-Encoder 的 79.3),LEDGAR 8K 长文档分类 85.5%,CoNLL-2003 实体 F1 89.3;自然图像冻结探针仅 13.2%,但 RVL-CDIP 文档分类仅用 6000 样本(不到训练集 2%)微调即从 51.6% 升至 81.5%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 视觉文档检索 ViDoRe v3(8 个公开任务) | nDCG@10 | NeoMME-260M 0.523;NeoMME-800M 0.556 | ColModernVBERT(250M) 0.261;ColSmol-256M 0.207;ColSmol-500M 0.340;Vultron Flash(850M) 0.565;ColQwen2.5-v0.2(3.75B) 0.524;ColPali v1.3(2.92B) 0.430 | 为 <800M 参数中最强;较 <300M 最佳 +26.1 分;800M 距 Vultron Flash 仅 0.9 分、反超 ColQwen2.5 3.2 分 |
| 视觉文档检索 ViDoRe v2 | nDCG@5 | NeoMME-260M 0.522;NeoMME-800M 0.559 | ColModernVBERT 0.407;ColSmol-256M 0.348;ColSmol-500M 0.455;ColQwen2.5 0.601 | 较 <300M 参数最佳模型 +11.5 分 |
| 视觉文档检索 ViDoRe v1 | nDCG@5 | NeoMME-260M 0.860;NeoMME-800M 0.874 | ColModernVBERT 0.806;ColSmol-256M 0.797;ColQwen2.5 0.895;ColPali v1.3 0.848 | 较 <300M 参数最佳模型 +5.4 分 |
| 文本检索 BEIR-15(迟交互头) | nDCG@10 | NeoMME-260M 0.4881;NeoMME-800M 0.5126 | ColBERTv2(110M) 0.4863;LateOn(149M) 0.5722 | 800M 超过 ColBERTv2 约 2.6 分;仍落后于检索数据规模大三个数量级的 LateOn |
| 文本检索 BEIR-15(稠密头) | nDCG@10 | NeoMME-260M 0.3055;NeoMME-800M 0.3686 | GTE-ModernBERT(149M) 0.5519;DenseOn(149M) 0.5620 | 落后约 18–25 分;作者归因于检索训练数据仅约 43 万文本查询 vs mLateOn 的 6.6 亿 |
| 文档编码吞吐(NVIDIA L40S,2048×2048 输入) | 页/秒 | NeoMME-260M 51.3 页/秒;NeoMME-800M 21.2 页/秒 | ColModernVBERT 26.0 页/秒 | 260M 达 1.97×;800M 在 1536×1536 下 39.2 页/秒,比 Vultron Flash(1344² 下 20.2)快 94% |
| 迟交互索引压缩(ViDoRe v3,NeoMME-260M) | 每文档存储 / 保留 nDCG@10 | 池化 8 + int8 查询/二进制文档:6.0 kB,保留 95.19%;池化 10 + int8/int8:39.0 kB,保留 99.16% | float32 未压缩:1536.7 kB / 100% | 最高 255.5× 压缩仍保 95% 以上质量;39.4× 压缩保 99% 以上 |
| MaxSim 训练内核(LIK,4096 文档 token) | 峰值显存 / 反向耗时 | 193 MB / 0.54 ms | 朴素实现 672 MB / 1.82 ms(8192 token 时直接 OOM) | 显存 3.5× 降低、反向 3.4× 加速,且数值精确一致 |
局限与改进
作者承认的局限:(1)预训练规模小——总计划 524B token 中纯文本约 290B,而 ModernBERT 用了约 2T 文本 token,约为其 7 倍;(2)没有任何视觉目标(不做掩码图像建模、像素重建或图像级对比),这可能是自然图像冻结探针只有 13.2% 的原因;(3)检索监督少——约 43 万文本查询 + 85 万图像查询,对比 mLateOn 的 6.6 亿对比样本 + 1600 万难负例差三个数量级;(4)训练了混合模态嵌入空间但未在 UniDoc-Bench、MixBench 上评测混合语料检索;(5)视觉检索语言覆盖窄(页图仅 en/fr/de/it/es);(6)缺少隔离架构、数据、规模各因素贡献的系统消融;(7)未做蒸馏。我的补充观察:分词器在 FLORES-200 全部 204 语言上覆盖明显弱于 14 个目标语言;吞吐对比未计入各模型图像处理器的耗时且各用自标定 batch;255× 压缩只报质量不报优化后检索延迟;自然图像微调结果方差大(Stanford Cars 46.8±6.3),说明该骨干在文档域之外的适应性仍很初步。
独立分析的弱点
第一,自然图像表示几乎为零:冻结 16-shot 探针平均只有 13.2%,Stanford Cars 微调后也只有 46.8±6.3%,意味着该骨干目前只能服务文档场景;若要扩展到通用图文检索,需要在扩散目标中加入低速率的图像 token 预测或图像级 InfoNCE。第二,稠密头严重偏科:BEIR-15 上稠密 0.3686 对迟交互 0.5126,而「稠密 ANN 召回 + 迟交互重排」恰是论文宣传的两段式部署路径,稠密召回弱会直接拖垮端到端召回率,改进方向是用作者自己提到但未实施的蒸馏把迟交互的排序知识迁进稠密头。第三,从头复现门槛高:800M 预训练用了 32 张 H100 跑 50 万步,检索微调的数据管线依赖 Qwen3.5-9B 生成查询和 Qwen3-VL-Reranker-8B 过滤,社区难以完整复刻配方。第四,二进制文档打分的实际服务收益未验证:packed binary 点积需要专门的 XOR+popcount 内核才能兑现延迟优势,论文只报质量与存储,未给出优化后的查询延迟。第五,滑动窗口为主的注意力对需要超长程推理的纯文本任务是否够用,论文未单独评估。
未来方向
作者提出的方向:扩大预训练规模(更多文本、图像与步数);引入并与当前目标做匹配对照的视觉目标(图像 token 预测、像素重建、图像级对比);用更大规模检索数据做匹配实验以剥离数据量与架构的贡献;在 UniDoc-Bench(7 万 PDF 页统一语料)与 MixBench 上评测混合模态检索;用「代码生成文档→翻译源内容→多语言渲染」构造大规模多语言文档检索数据集并开源;在预训练与检索两阶段都做 800M→260M 的蒸馏;系统评估数据偏差与迭代掩码采样的安全性。基于成果可延伸的:把 LIK 内核与二进制打包打分结合,做出真正的 XOR-popcount 服务内核并测端到端延迟;验证池化+量化方案在 ColQwen 系等其他迟交互模型上是否同样有效(即方案通用性);探索同一扩散骨干的生成能力与嵌入能力的互相促进(如同骨干既做 OCR 生成又做检索);利用官方发布的 predecay 检查点在医疗、法律等垂直领域做退火续训。
复现评估
开源情况非常好:两个预训练骨架(Hcompany/NeoMME-260M、NeoMME-800M)、两个检索器(NeoMME-260M/800M-Retriever)以及两个 predecay 检查点(45 万步处)均以 Apache 2.0 发布,并且以 day-zero 方式贡献进了 Hugging Face Transformers 库,兼容 Sentence Transformers 的稠密与多向量检索,还提供了在线 demo space。论文完整披露了架构超参(Table 1)、预训练配比与采样权重(Table 2)、优化器与调度细节(Table 3)、检索训练配比(Table 4)及全部基准数字,去污染协议也有说明。复现难点:预训练需要 16–32 张 H100 量级算力(2–4 个 AWS p5.48xlarge 节点、50 万步),个人与中小团队难以承担;查询合成依赖 Qwen3.5-9B 与 Qwen3-VL-Reranker-8B;部分对比基线分数取自 MTEB 榜单而非统一复评,横向可比性有一定折扣。若只是拿发布权重做推理、索引或检索微调,260M 单卡即可运行,门槛很低。综合评级:权重复用容易,从头复现研究级配方困难。
论文图表