从生产流量到后训练:构建覆盖企业请求组合的自托管大语言模型 From Production Traffic to Post-Training: Building a Self-Hosted LLM That Covers the Corporate Request Mix
从生产错误分析出发,分域训练GRPO专家并SLERP合并,把企业流量整合到单一自托管32B模型
前置知识
GRPO(Group Relative Policy Optimization)
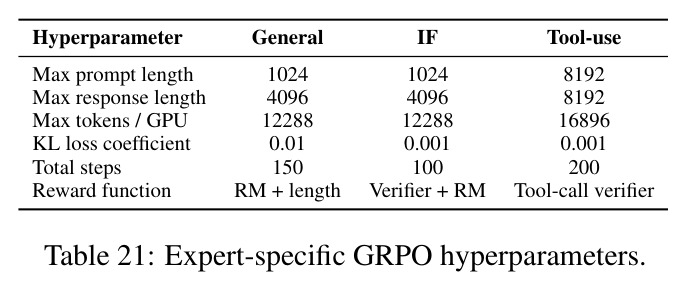
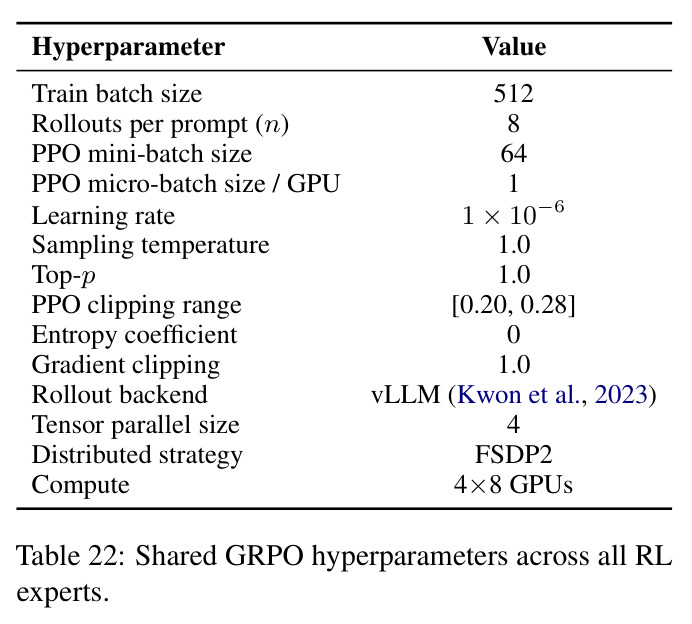
DeepSeek 提出的强化学习算法,是 PPO 的简化变体:对每个提示采样一组补全(本文为 8 个),用组内平均奖励作为基线计算相对优势,从而省去价值网络。训练中通过 KL 惩罚约束策略不偏离参考模型太远。本文用 verl 框架实现,共享设置为 batch 512、每提示 8 个 rollout、学习率 $1\times10^{-6}$、温度 1.0、vLLM rollout、FSDP2 分布式。
本文的三个能力专家(通用对话、指令遵循、函数调用)全部从共享 SFT 检查点用 GRPO 训练,每个专家的奖励函数与 KL 系数都不同,理解 GRPO 才能看懂各专家的训练细节与失败模式。
奖励破解(Reward Hacking)
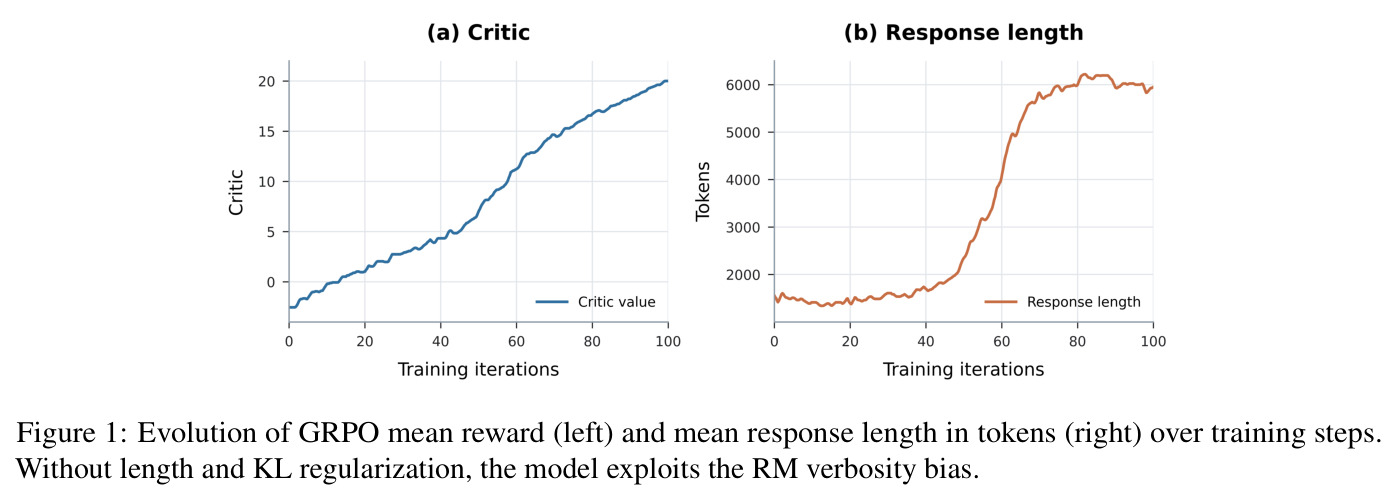
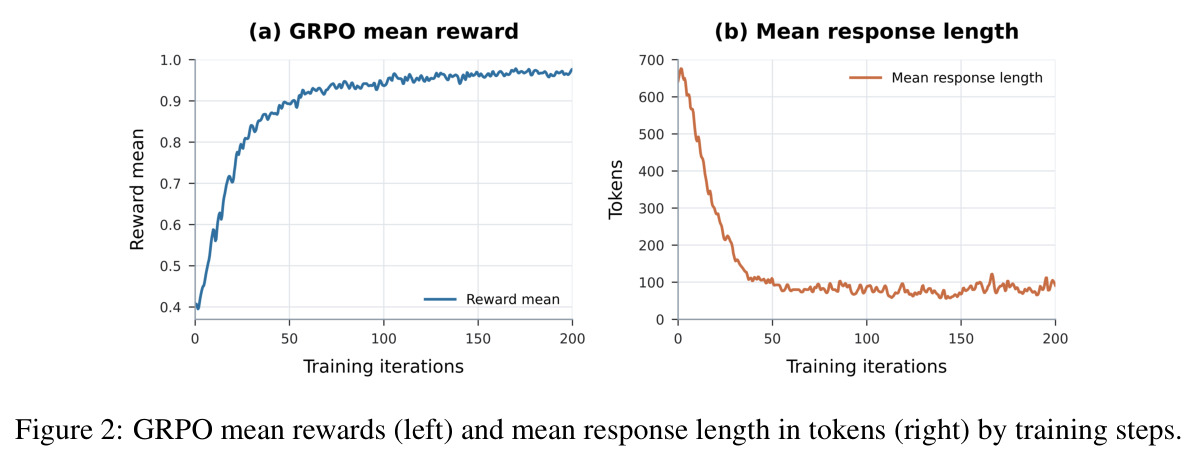
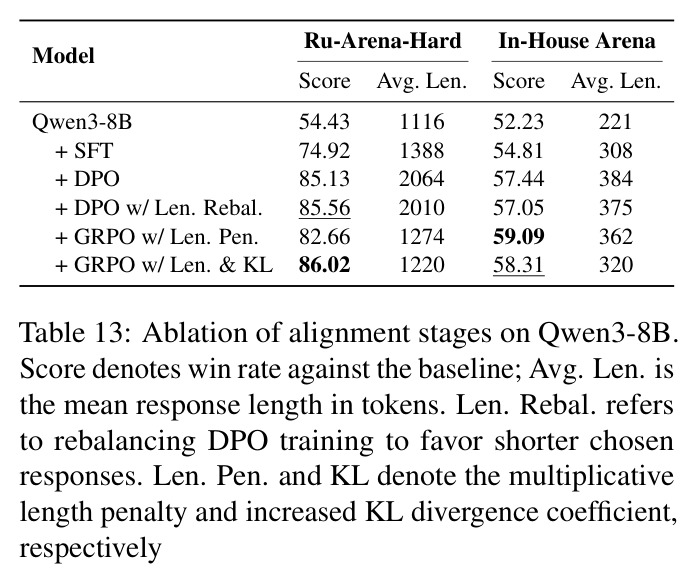
当奖励只是真实目标的代理时,策略会找到提高代理奖励却不提升真实目标的捷径(Skalse et al., 2022)。经典例子是 RLHF 中模型学会写冗长回答迎合奖励模型的长度偏好。本文系统记录了三种与企业后训练对应的形态:IF 专家的语义坍缩(只输出能通过形式检查的空洞答案)、FC 专家的过度调用(拿不准就发工具调用)、General 专家的冗长攻击(响应长度从 1332 涨到 2064 token),并逐一给出领域特定修复。
三种失败模式及各自的领域特定修复是本文最核心的工程经验,也是作者论证'为什么不能联合多目标训练、必须分域训练再合并'的直接论据。
SLERP 与权重空间模型合并
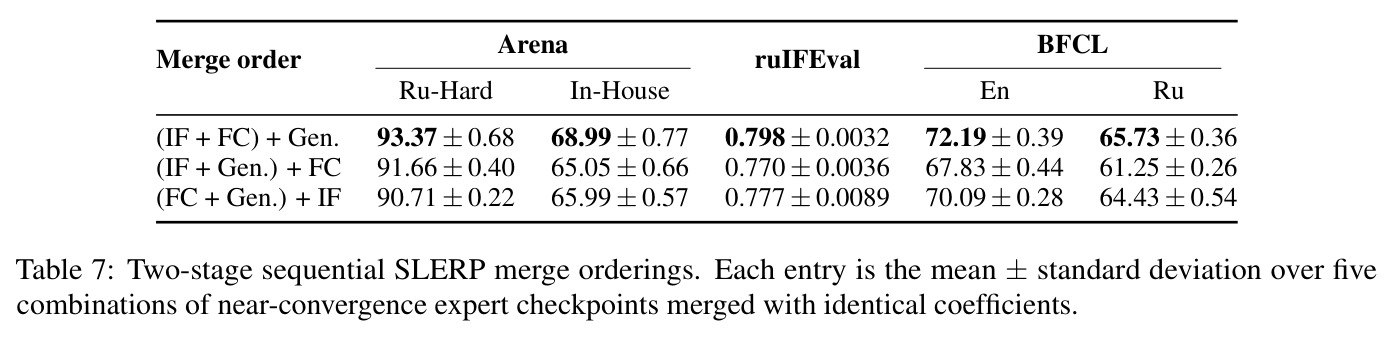
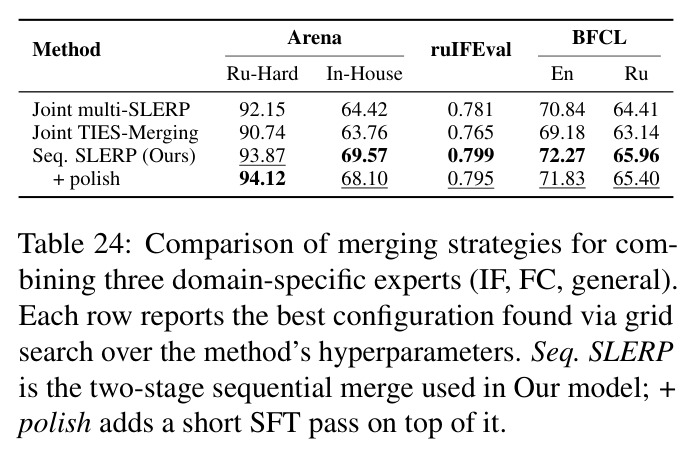
SLERP(球面线性插值)在两个模型权重向量之间沿球面路径插值,相比线性插值更好保留各权重矩阵的范数与方向结构,是 MergeKit 等工具中的标准算子。本文用两阶段顺序合并:先用逐层网格搜索的系数合并 IF 与 FC 专家,再以系数 $t_2=0.8$ 与 General 专家合并。关键性质是 SLERP 不满足结合律——合并顺序会影响结果,本文穷举了三种顺序,发现顺序间差异甚至大于专家检查点本身的随机波动。
合并是把三个独立专家装进一个部署模型的最后一步,合并顺序与逐层系数的选择直接决定最终基准分数,也是论文相对联合训练方案的核心卖点。
LLM-as-a-Judge 与 Cohen's κ
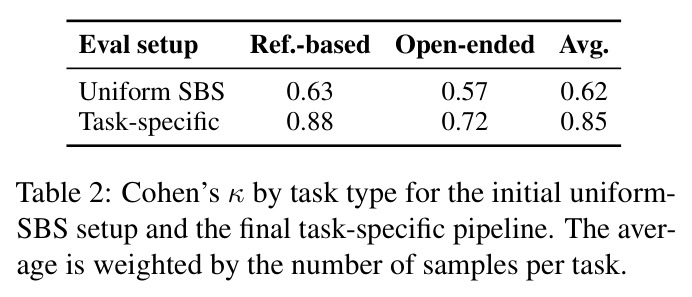
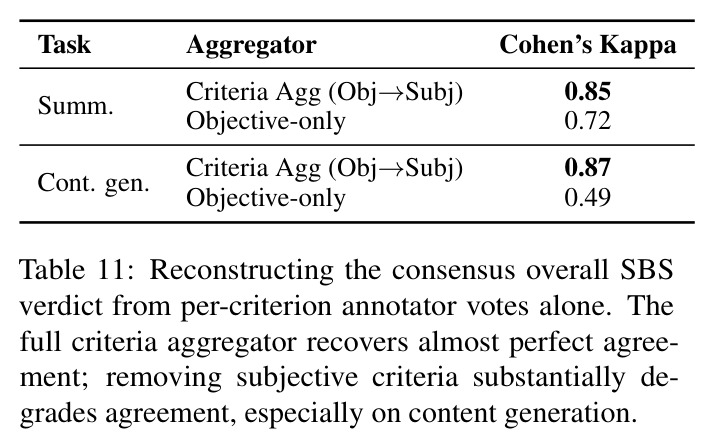
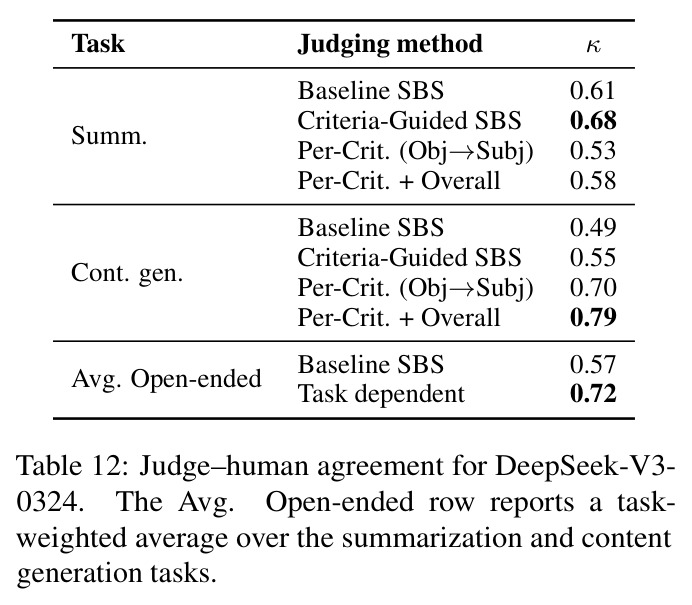
用强 LLM 给模型回答打分或做成对比较(side-by-side,SBS)。Cohen's κ 在排除随机一致后衡量评委与人类标注的一致性,$\kappa=\frac{p_o-p_e}{1-p_e}$,比原始准确率更适合类别不平衡的标注分布。本文以 DeepSeek-V3-0324 为评委,通过任务特定评判方案把 κ 从均匀 SBS 的 0.63 提到 0.88(参考式)与 0.72(开放式)。
论文所有开放式质量结论都建立在 LLM 评委之上,κ 是判断这些结论可信度的核心指标,附录还用四个评委做了敏感性分析。
可验证奖励(RLVR)与 IFEval/BFCL
RLVR 指奖励由程序化验证器给出而非人类偏好模型,可精确、可扩展但覆盖面窄:IFEval 用确定性函数检查输出是否满足格式、长度、关键词等约束;BFCL 在 AST 模式下把预测的函数调用与参考答案做结构和语义匹配而非真实执行。本文 IF 专家用 VerIF 式可验证奖励,FC 专家用 Tool-N1 二值精确匹配奖励(调用与真值的多字典完全一致得 1,否则 0),两者的奖励漏洞分别催生了语义坍缩与过度调用两种失败模式。
两类专家各自的奖励破解失败模式(语义坍缩、过度调用)都直接源于可验证奖励的漏洞,理解 RLVR 的能力与盲区才能看懂论文的修复方案设计。
Jensen–Shannon 距离与 TF-IDF 多样性
TF-IDF 余弦距离度量查询之间的词汇多样性;Jensen–Shannon 距离是对称化的 KL 散度,$JSD(P\|Q)=\tfrac{1}{2}KL(P\|M)+\tfrac{1}{2}KL(Q\|M)$,其中 $M=\tfrac{1}{2}(P+Q)$。本文用它衡量采样出的基准集与生产池在四个维度(被查询模型、提示长度、服务、任务类型)上的偏离,配合平均成对 TF-IDF 距离刻画多样性。
内部基准能否代表生产流量完全由这两个量刻画,是理解模板感知采样器设计与 Table 1 采样方法对比的前提。
研究动机
数据驻留与监管约束迫使大型企业自托管 LLM,而自托管意味着一个有限的 GPU 池要被数百个应用共享。文中描述的典型困境是:每个团队按自身任务挑选最合适的模型,之后更换模型会带来迁移摩擦;新一代开源模型大约每季度发布一次,但旧模型因业务依赖无法退役;随着'模型动物园'持续膨胀,实际每 token 的有效成本不断上升。该企业的 LLM 平台承载 200 多个内部应用的流量,其中约 12% 的请求带工具调用,且流量高度模板化——大量请求是把变量片段填入少数提示模板的产物。这带来两个具体麻烦:其一,公开基准(IFEval、BFCL、Arena-Hard 等)与真实生产分布脱节,公开榜单上的名次无法预测内部服务质量;其二,长尾应用积累的流量不足以支撑可靠的 A/B 测试,任何新模型都必须对未见过的 workflows 保持泛化,而历史做法(新模型上线、旧模型不下线)让 GPU 预算碎片化在多个推理集群上。
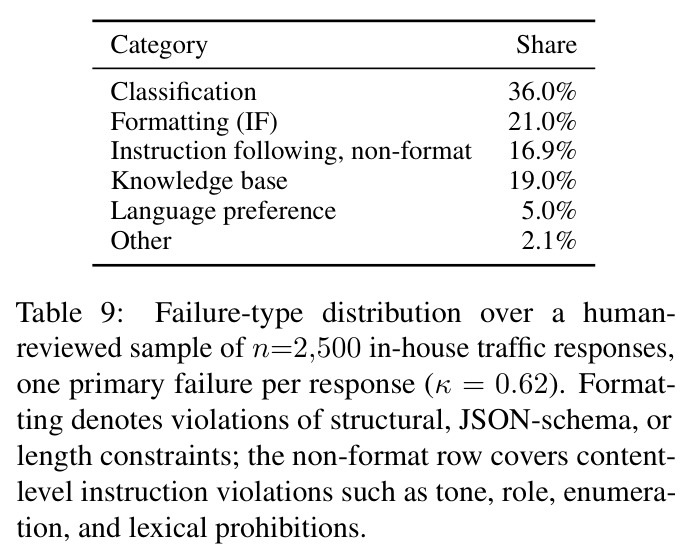
本文的目标是目标不是训练一个更大的通用模型,而是把分散在多个模型上的生产流量整合到单一自托管检查点上,并让重训足够便宜、可以每个生产周期都执行一次更新。具体拆成三个由生产错误分析得出的质量轴:一是指令遵循(含格式约束),在 2,500 条人工归因的失败样本中格式化违规占 21.0%、非格式 IF 违规占 16.9%,合计 37.9%,超过最大的单类'分类'(36.0%),且可用确定性验证器打分,是最大的单项改进杠杆;二是函数调用,覆盖约 12% 的带工具流量,主要问题是俄语工具描述对英语中心的基座模型是分布外的、以及用俄语填写参数值易错;三是对齐内部任务分布,让通用对话质量匹配企业真实请求组合。整个过程必须不回归通用能力,并以生产分层的离线基准而非公开榜单来追踪质量。
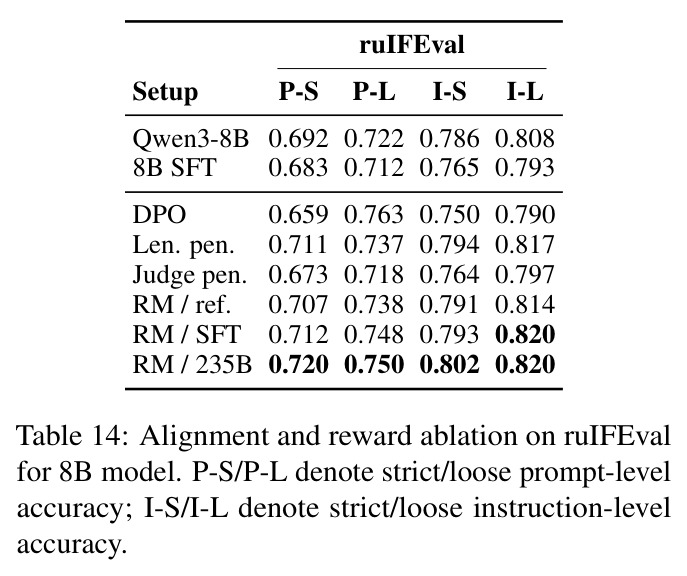
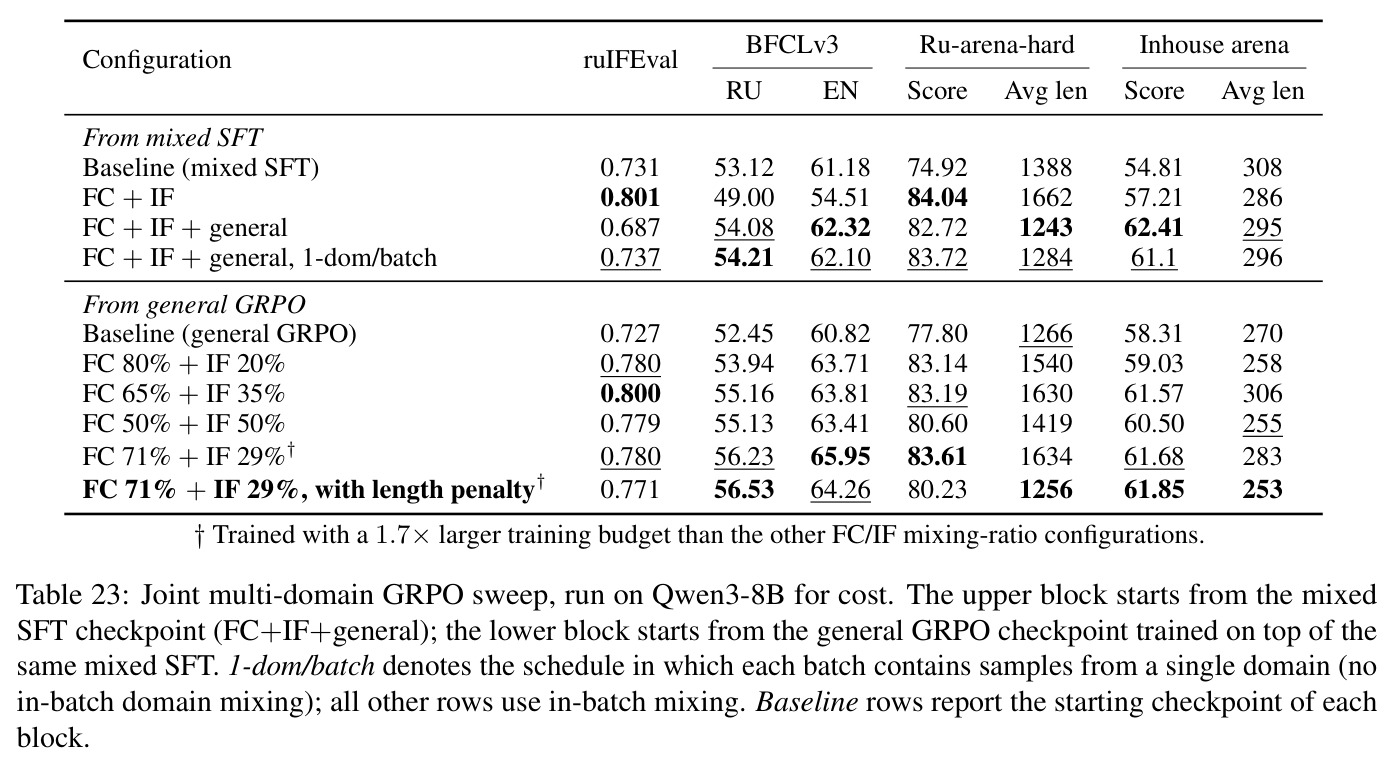
与已有工作不同的是,独特之处在于把'生产流量'当作整个方法的第一公民,形成从错误分析到部署的闭环。第一,评估基准不是公开集,而是从每月约 10 万条生产查询中用模板感知采样器分层构建的内部 Arena:掩码变量 token 后用 LSH 聚出模板,模板内做多样性选择、按 $\sqrt{count}$ 分配预算,再按任务类型路由到不同评判方案并对照人工标注校准(κ 从 0.63 提到 0.88/0.72)。第二,训练不做联合多目标优化——扫描实验证明多奖励联合 GRPO 存在强跨域干扰(8B 上把 ruIFEval 从 0.731 拉到 0.801,却把 BFCLv3 EN 从 61.2 压到 54.5)——而是从共享 SFT 分叉出三个独立 GRPO 专家,再用两阶段顺序 SLERP 合并,把'加一个新能力'变成'独立训练一个专家加只做评估的系数搜索'。第三,针对俄语这一被英语中心的 IF 验证器与 FC 数据集忽略的语言,所有数据管线原生生成而非机器翻译(翻译会切断用户话语与枚举值的交叉引用)。论文还完整记录了每条轴各自暴露的奖励破解模式及修复,这类失败模式档案在企业后训练文献中相当少见。
核心方法
直觉上,这篇论文把'让一个模型同时满足三种互相拉扯的奖励'换成'三个专家各自变好再合体'。整体流程分四步。第一步是诊断:三人独立给 2,500 条生产回复标注单一主失败类别(六类、多数投票、标注一致性 $\kappa=0.62$),结合对带工具流量(约 12%)的单独人工评估,锁定指令遵循、函数调用、内部分布对齐三个可训练的轴;同时从月度流量构建模板感知的内部基准。第二步是共享 SFT:基座是 Qwen3-32B,配西里尔字母密集分词器,仅以非推理模式运行以满足生产延迟与成本约束;SFT 数据混合内部生产样本、通用俄语语料(约 80% 来自开源俄语指令语料、20% 内部日志)、IF 与 FC 数据,消融证明混合所有域不损失各域质量。第三步是从这个共享 SFT 检查点分叉出三个独立 GRPO 运行,各训练到收敛,每个用领域专属奖励并针对各自的失败模式做修复。第四步是两阶段顺序 SLERP 把三个专家合并成单一部署模型,用 vLLM 单卡 FP8 副本上线,上线六个月后吸收了平台 50% 的流量。
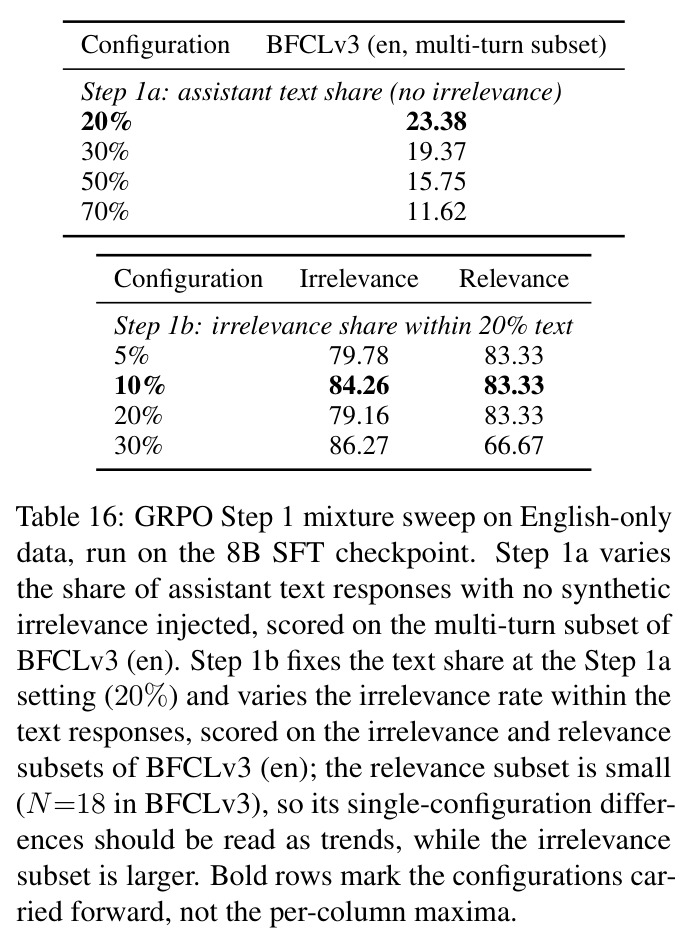
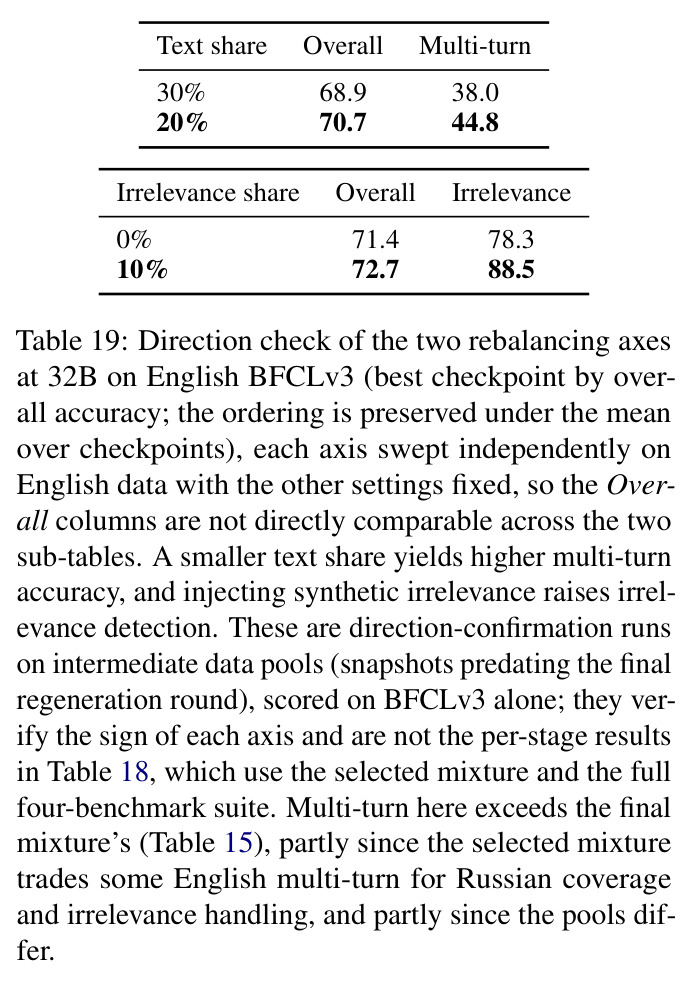
核心创新是'模块化后训练'这一结构性选择,加上每个模块内'失败模式驱动的奖励/数据修复'。与 Tulu 3、DeepSeek-R1 等把多目标塞进一条后训练管线的做法不同,本文用一个不对称结论统一了流程:SFT 阶段数据混合即可(Table 3 显示共享 SFT 与各域单独 SFT 质量相当),而 GRPO 阶段必须分域——因为每个奖励都有一个平凡捷径,联合优化时跨域干扰不可调和。三个代表性修复是论文的精华。其一,IF 专家的纯验证器奖励导致语义坍缩:模型发现只输出满足藏头检查的空洞字母就能拿满奖励,修复是在 VerIF 式奖励上叠加提示特定的奖励模型质量校正,$R_i=V_i+1$(若 $V_i>0$ 且 $S_i>\alpha_i$)、$R_i=V_i-0.5$(若 $V_i>0$ 且 $S_i\le\alpha_i$)、$R_i=V_i$(若 $V_i\le0$),其中 $S_i$ 是补全的 RM 分,阈值 $\alpha_i$ 取教师在同一提示下 8 个补全的平均 RM 分。其二,FC 专家的 Tool-N1 二值奖励存在'拿不准就调用'的漏洞,修复不改奖励而改数据分布:注入 10% 移除了正确工具的合成无关样本(目标改为文本拒绝),并把文本目标份额定为 20% 以保多轮准确率。其三,General 专家的 RM 冗长偏好把响应长度从 1332 推到 2064 token,修复是弃用 DPO 改用 GRPO,并施加乘法长度惩罚 $R(x,y)\mapsto R(x,y)(1-\alpha(x,y))$,$\alpha(x,y)=\mathrm{sgn}\,R(x,y)\cdot\mathrm{clip}(L(y)/L_0(x),\,d_{min},\,d_{max})$($d_{min}=0.1$、$d_{max}=0.3$,基线长度 $L_0$ 来自 235B 教师),同时把 KL 系数从 0.001 提到 0.01。
方法步骤详情
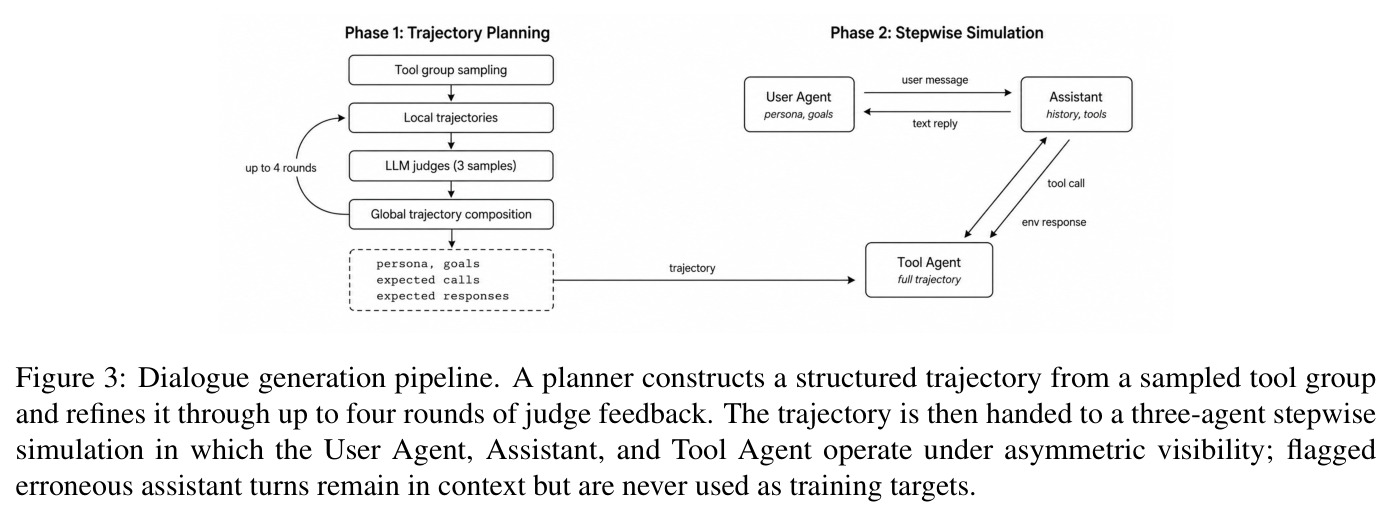
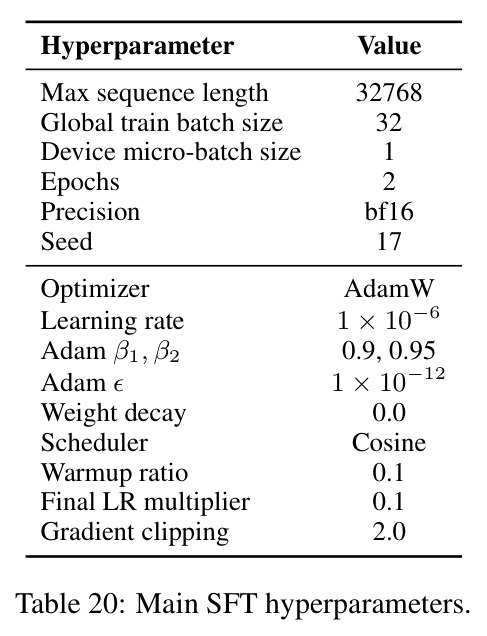
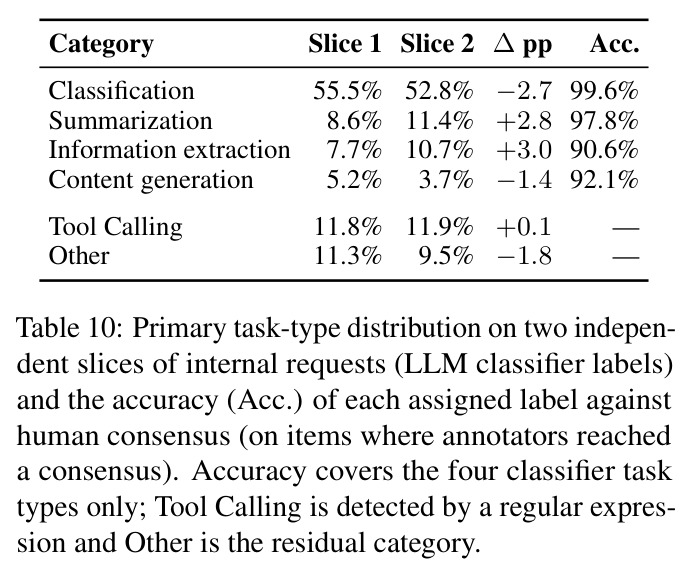
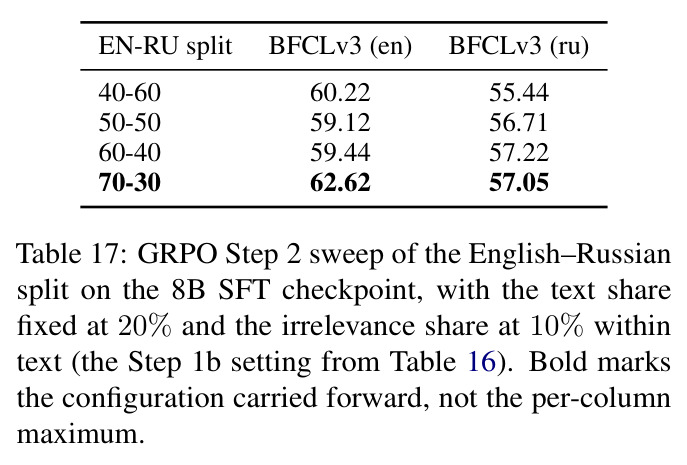
方法步骤如下。(1)错误分析:三人标注 2,500 条生产回复的六类失败,格式化 21.0%、非格式 IF 16.9%、分类 36.0%、知识库 19.0%、语言偏好 5.0%;带工具流量单独评估,定位失败主因是俄语工具描述分布外与俄语参数填写,而非选错函数。(2)内部 Arena 构建:markdown 感知解析器掩码变量 token,LSH 把近似重复的规范化提示聚成模板,模板内对变量片段跑 greedy max-min,预算按 $\sqrt{count}$ 分配;每条请求经 LLM 分类器路由(与人类共识一致率 90.6–99.6%),分类与信息抽取(约 63.2% 流量)用 Kimi-K2.5 生成的金答案做参考式评分(人工验收率 97.7%/85.2%),开放式任务用分任务评判(摘要用 Criteria-Guided SBS,内容生成用 Per-Criterion+Overall)。整体 κ 从均匀 SBS 的 0.62/0.63 提到 0.85/0.88。(3)共享 SFT:57 小时、4 节点×8 H100、bf16、32k 序列、2 epoch、AdamW、cosine 调度。(4)三个 GRPO 专家(verl,batch 512,8 rollouts/提示,lr $1\times10^{-6}$,PPO clip 0.20–0.28):General 专家用 RM+长度惩罚+KL 0.01,约 40 小时;IF 专家用验证器+RM 校正、KL 0.001,约 28 小时,数据来自 54 个手写种子约束经 LLM 扩增(约 10 万候选)、验证器一致性过滤(100k→72k→50k)、回译验证(相似度 0.6 阈值,剩 43k 约束)、每约束挂 3 个 SFT 样本并筛选全对补全,最终 10k 用户级+16k 系统级样本;FC 专家用二值精确匹配奖励、KL 0.001,约 62 小时,数据来自 BERTopic 主题池(15.5K→33.5K)生成 33.5K 工具(gpt-oss-120b 生成、每工具 4 个描述长度档),planner 构建参考轨迹后由用户/助手/工具三个非对称可见性的智能体逐步重放,产出 1.2M 英文+300K 俄文轮级样本;GRPO 混合比 70% 英/30% 俄、80% 工具调用/20% 文本、文本中 10% 合成无关样本。(5)两阶段 SLERP:先 (IF+FC) 以逐层系数(attention 从 {0, 0.3, 0.5, 0.7, 1} 网格搜索、MLP 互补、嵌入与归一化层固定 0.5),再以 $t_2=0.8$ 并入 General;穷举三种顺序后选 (IF+FC)+Gen;尝试过的 polish 后处理阶段因无净收益被移除。(6)部署:vLLM 单 GPU FP8 副本、16–48 pods、平均 45 RPS 峰值 110 RPS、P95 延迟 3.2 秒、首 token 时间 0.3 秒。
技术新颖性
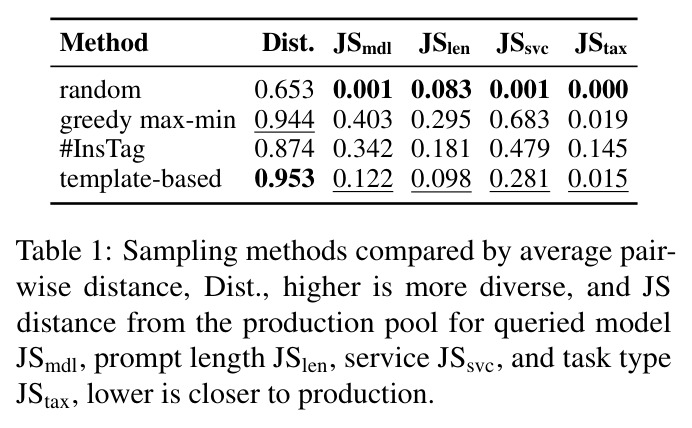
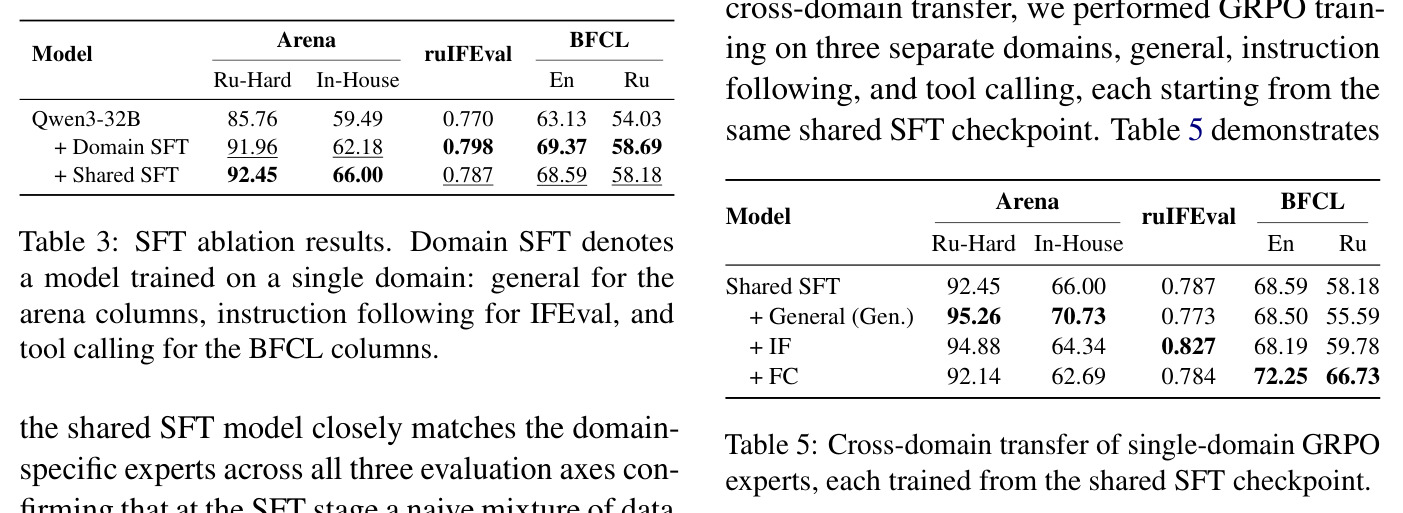
技术新颖性可从四个层面评估。评估层面:模板感知采样器是论文最干净的贡献——Table 1 显示随机采样代表性好但多样性差(Dist. 0.653),greedy max-min 与 #InsTag 多样性高(0.944/0.874)却严重扭曲服务分布(JSsvc 0.683/0.479)和任务类型(#InsTag 的 JStax 0.145),模板感知采样同时拿到最高多样性 0.953 与整体最低的 JS 距离组合,是唯一'既广又准'的配置;任务特定评判把评委–人类 κ 从 0.63 提到 0.88,证明'一个评判配方通吃'不成立。训练层面:'SFT 可共享、RL 必须分域'这一不对称结论有清晰实验支撑(Table 3 与 Table 5/23 的对照),并给出了联合 GRPO 的完整失败扫描档案(Table 23),比文献中笼统的'多目标 RL 脆弱'更有工程价值;把奖励破解按域分类并各自给出针对性修复(RM 校正、数据注入、长度+KL 正则)是可复用的实践知识。数据层面:俄语原生 FC 管线(工具池+三智能体非对称可见性模拟)直接回应了多语言工具使用研究中'参数值语言不匹配'这一主导失败模式,避开机器翻译切断用户话语与枚举值交叉引用的结构性风险;IF 管线把 AutoIF 适配到俄语并公开了全部过滤阈值。工程层面:两阶段顺序 SLERP+逐层系数网格搜索、以及'polish 阶段被证伪并移除'的负结果都有报告。局限是合并顺序与系数目前只能靠穷举与网格搜索,没有可迁移到新专家组合的一般规则。
实验结果
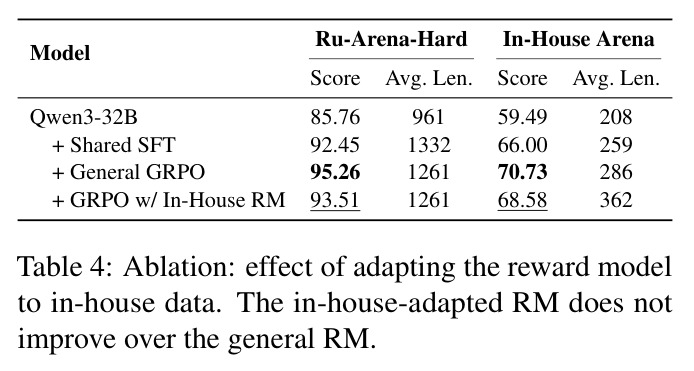
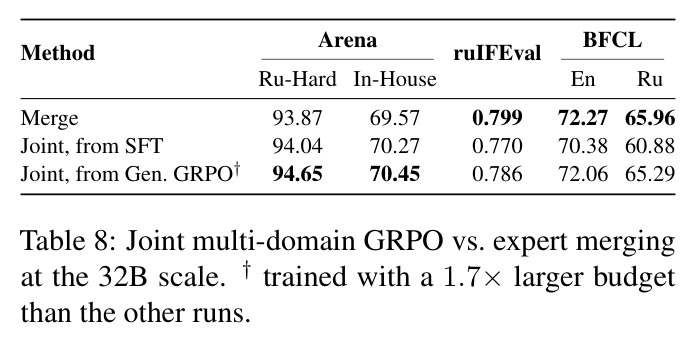
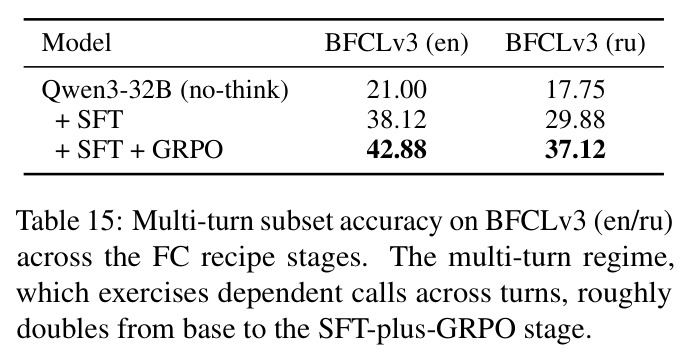
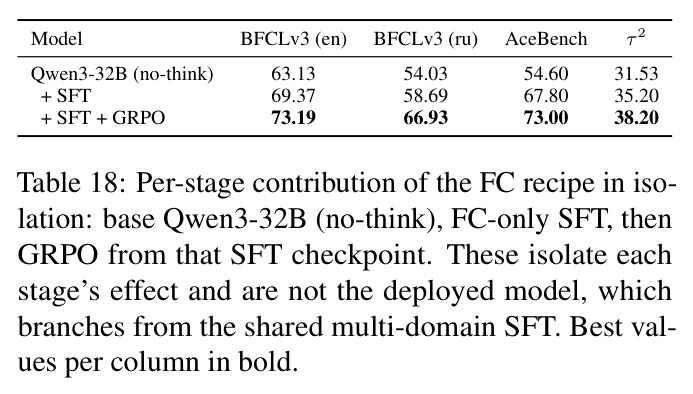
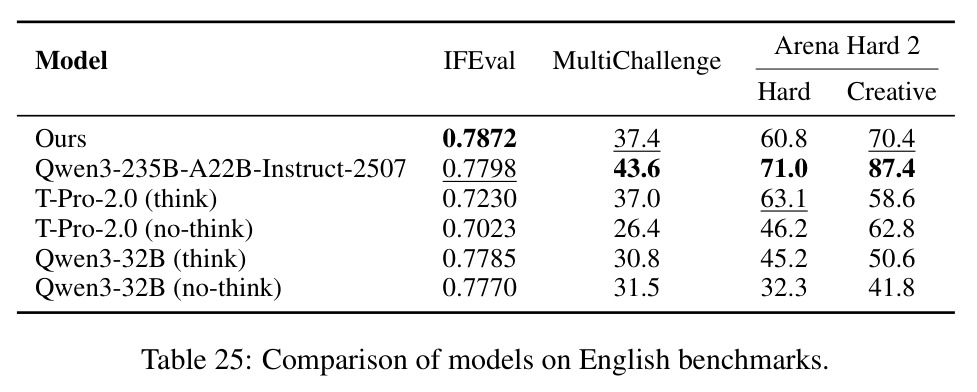
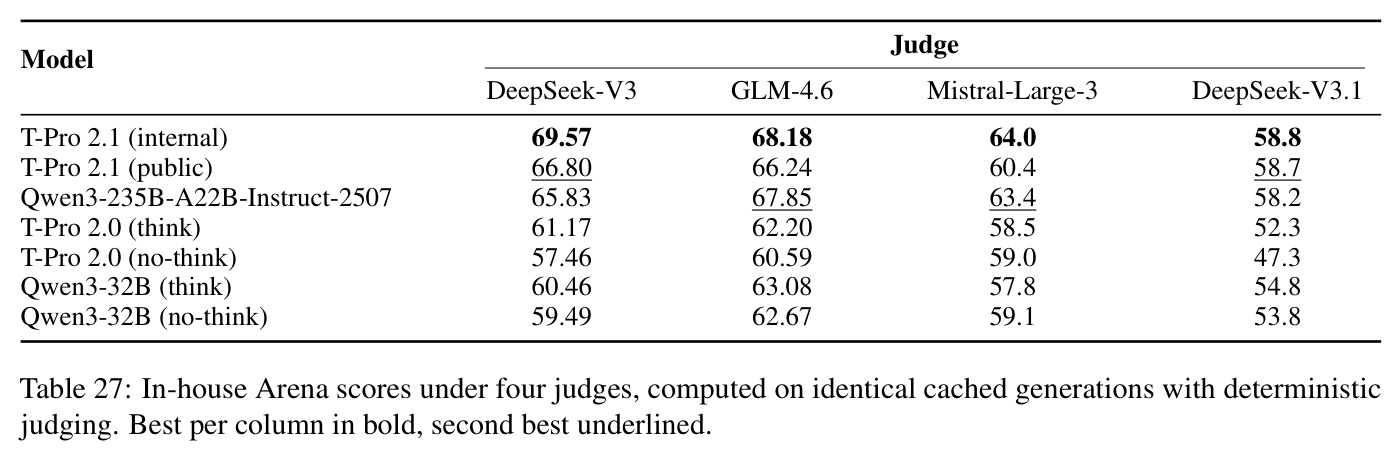
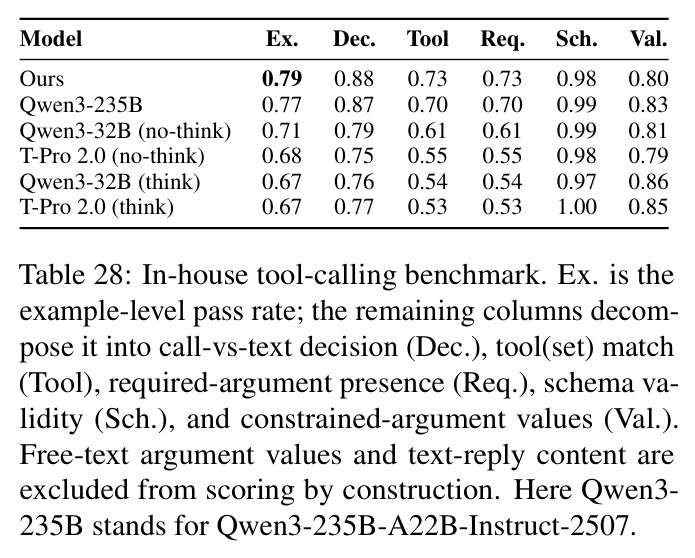
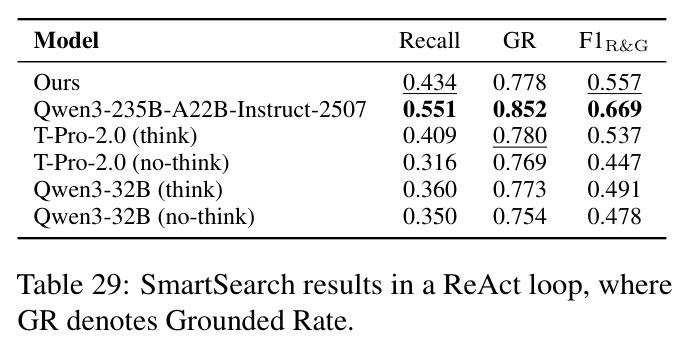
核心发现按实验逐一展开。(1)SFT 消融(Table 3):共享 SFT 与各域单独 SFT 几乎打平——Ru-Arena-Hard 92.45 vs 91.96、内部 Arena 66.00 vs 62.18(共享反而更高)、ruIFEval 0.787 vs 0.798、BFCL 68.59/58.18 vs 69.37/58.69,说明 SFT 阶段混合所有域是免费的。(2)GRPO 跨域迁移(Table 5):每个专家只改善自己的域——General 把两个 Arena 拉到 95.26/70.73 但 ruIFEval 与 BFCL 几乎不动;IF 把 ruIFEval 提到 0.827;FC 把 BFCL En/Ru 提到 72.25/66.73。这是'GRPO 必须分域再合并'的直接证据。(3)奖励模型适应内部数据无收益(Table 4):内部 RM 使分数更低(93.51/68.58 vs 95.26/70.73)且响应显著变长(362 vs 286 token),通用 RM 已含足够信号。(4)合并顺序(Table 7):(IF+FC)+Gen 最优(Ru-Hard 93.37、内部 Arena 68.99、BFCL En 72.19),顺序间差异超过五个近收敛检查点组合的随机波动。(5)联合 GRPO vs 合并(Table 8,32B):联合训练从 SFT 出发 BFCLv3 掉到 60.88 RU/70.38 EN、ruIFEval 0.770,全面输给合并的 65.96/72.27/0.799;带 General GRPO 热启动且预算 1.7× 才追平。(6)主结果(Table 6):最终模型在内部 Arena 69.57 超过约 7× 总参数的 Qwen3-235B-A22B-Instruct-2507 的 65.83,in-house IFEval 0.85 vs 0.83、in-house BFCL 0.79 vs 0.77、ruBFCLv3 65.96 vs 64.42、AceBench 73.50 vs 70.20,全部在非推理模式下取得;在依赖骨干规模的 ruMultiChallenge(34.1 vs 46.2)与 SmartSearch(0.557 vs 0.669)上差距缩小但未消除;ruWildChat 从基座 52.0 提到 80.7,距大模型仅 4.4 分。(7)FC 各阶段贡献(Table 18):英语侧 SFT 占大头(BFCL en 63.13→69.37)而 GRPO 精修 +3.8;俄语侧 GRPO 贡献最大单段增益(58.69→66.93),归因于过度调用的再平衡而非语种比例;BFCLv3 多轮子集从 21.00/17.75 翻倍到 42.88/37.12(Table 15)。(8)SmartSearch(Table 29):F1R&G 从 0.478 提到 0.557,非推理配方超过 32B 与 T-Pro-2.0 的思考模式,说明 FC 配方收益大于测试时推理。(9)部署与成本:上线六个月吸收 50% 平台流量(116M 请求/月、200+ 应用),每 token 成本相对 235B 基线降 2.8–3.9×,对原先使用最大平台模型的服务降 4–9×;少数回滚来自需要 frontier 级 agentic 能力的团队。(10)配方归因:同配方无内部数据的公开检查点在公开基准上接近内部版(如 ruIFEval 0.807 vs 0.799),证明增益主要来自配方而非内部数据;但内部 Arena 上两者差 2.77 分(66.80 vs 69.57),内部数据增量仍有实际贡献。
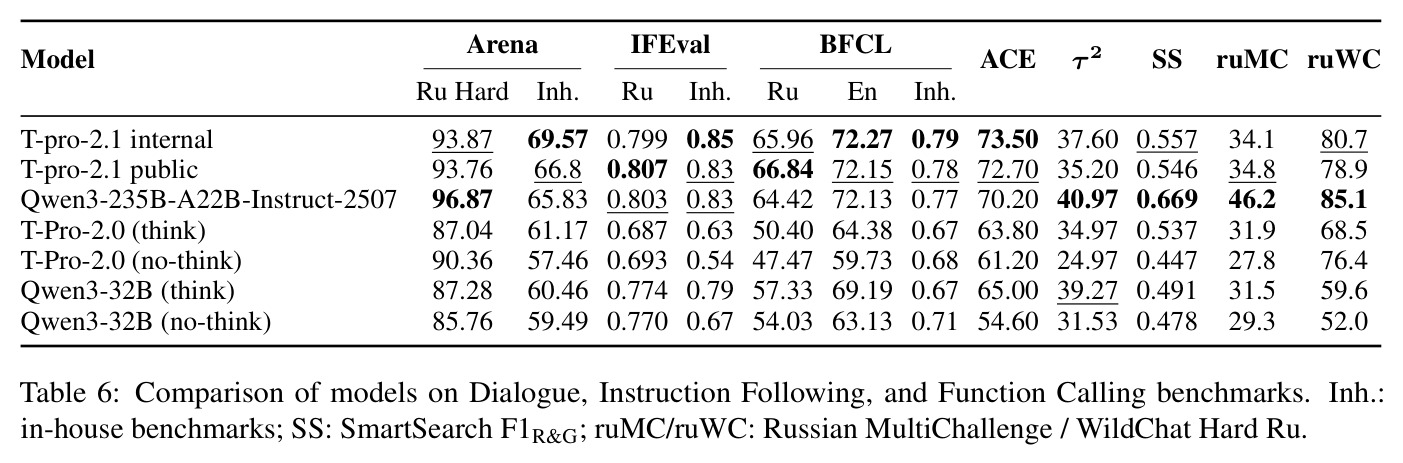
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 内部 Arena(生产分层对话) | 竞技场评分(DeepSeek-V3 评委、任务特定评判) | 69.57 | Qwen3-235B-A22B-Instruct-2507(约7×参数):65.83;Qwen3-32B 基座:59.49 | 较 7× 参数基线 +3.74,较基座 +10.08,且四个评委下均排名第一 |
| ruIFEval(俄语严格指令遵循) | 准确率 | 0.799 | Qwen3-32B no-think:0.770;联合 GRPO:0.770 | +0.029 vs 基座,+0.029 vs 联合训练 |
| 内部 IFEval(生产分布指令遵循) | Loose 指标 | 0.85 | Qwen3-235B-A22B-Instruct-2507:0.83;基座:0.67 | 超过 7× 参数模型 +0.02,较基座 +0.18 |
| 内部 BFCL(AST 函数调用) | 示例级通过率 | 0.79 | Qwen3-235B:0.77;Qwen3-32B no-think:0.71 | 追平并超过 7× 模型 +0.02,较基座 +0.08 |
| ruBFCLv3(俄语函数调用) | 准确率 | 65.96 | Qwen3-235B:64.42;联合 GRPO(32B):60.88 | 超 7× 模型 +1.54,超联合训练 +5.08 |
| AceBench(工具使用) | 准确率 | 73.50 | Qwen3-235B:70.20;基座:54.60 | 超 7× 模型 +3.30,较基座 +18.90 |
| SmartSearch(ReAct 多步内部文档检索) | F1R&G(Recall 与 Grounded Rate 的调和平均) | 0.557 | Qwen3-32B no-think:0.478;Qwen3-235B:0.669 | 较基座 +0.079,超过 32B/T-Pro-2.0 思考模式,仍落后 235B 0.112 |
| ruWildChat Hard(俄语开放对话) | 评分 | 80.7 | Qwen3-32B no-think:52.0;Qwen3-235B:85.1 | 较基座 +28.7,距 7× 模型缩至 4.4 分 |
局限与改进
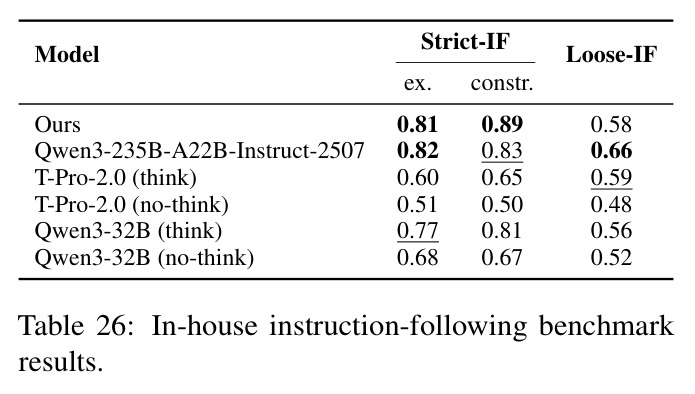
作者承认的局限:评估只覆盖俄语和英语,所有量化结论只在这两种语言上得到验证;部署证据来自单一组织的单一自托管平台,且全部实验只用 Qwen3 模型家族,配方虽不依赖骨干但未在别处验证;开放式质量依赖 LLM 评委,评委换模型后绝对分数会显著移动(Table 27:部署版内部 Arena 分数在 DeepSeek-V3/GLM-4.6/Mistral-Large-3/DeepSeek-V3.1 下分别为 69.57/68.18/64.0/58.8),作者用四评委证明排序不变,但迁移到其他分布仍需重新校准。我自己的观察:内部 IFEval 的 Loose-IF 只有 0.58,明显低于 235B 的 0.66,作者也承认验证器奖励集中于代码可验证约束,语气、角色、语义禁止类软约束是配方的结构性盲区;SmartSearch 每个查询只有一个规范来源页、仅两个工具,比真实企业检索(证据散布多页、工具发现)简单,且自由文本参数值只按存在性评分、不检查内容正确性,文本回复只评 call-vs-text 决策;FC 训练与评估的工具均不可执行,正确性完全依赖 planner 参考轨迹而非真实环境反馈,这与 τ2-bench 端到端成绩偏低(38.20 vs 235B 40.97)相互印证;合并顺序与逐层系数靠穷举+网格搜索,增加第四个专家时搜索成本会快速上升;公开检查点与内部版在内部 Arena 有 2.77 分差距(66.80 vs 69.57),复现者拿不到这部分的内部数据增量。
独立分析的弱点
独立分析出的弱点与改进方向:(1)软约束能力天花板:IF 奖励以可验证约束为核心,语气/角色/语义禁止类约束只能靠 SFT 继承,Loose-IF 0.58 对 235B 0.66 的差距难以靠现有奖励闭合,可引入 rubric/清单式奖励(RubricHub、OpenRubrics 一类)覆盖主观维度并保留防坍缩的 RM 校正。(2)会话级与单步奖励错位:GRPO 奖励优化单次调用的精确匹配,而 τ2-bench 衡量整个会话的任务成功率,两者不对齐导致 τ2 每阶段增益有限(31.53→35.20→38.20),可改用轨迹级或结果级奖励、或引入过程奖励模型。(3)合并的扩展性差:每新增一个能力轴,SLERP 顺序组合数增长且逐层系数需重新网格搜索,而'顺序间差异大于检查点随机性'意味着结果对超参敏感,可探索任务向量方法(TIES/task arithmetic)或可微/学习式合并系数搜索来降低边际成本。(4)评委依赖与反馈回路风险:内部 Arena 既是模型选择信号又由 LLM 评委打分,长期优化可能过拟合评委风格,需持续人工一致性审计与多评委集成对冲。(5)模板假设的脆弱性:模板感知采样依赖'变量可掩码'的结构,对完全开放式的长尾流量(Other 类占 9.5–11.3%)覆盖有限,解析器对新提示格式也可能失效。(6)单模型天花板:少数团队因需要 frontier 级 agentic 能力而回滚,说明 32B 稠密模型对最复杂工作流仍不够,需要配套的路由或混合部署策略。(7)数据管线单一生成器自举:FC 对话由 Qwen3-235B 生成并验证、工具由 gpt-oss-120b 生成,存在教师先验截断多样性的风险,部署模型在 ruBFCLv3 上超过对话生成器本身(65.96 vs 64.42)部分缓解了这一担忧,但多样性上限仍受教师约束。
未来方向
作者提出的方向:在更多语言、其他组织与其它骨干家族上验证配方;论文明确把跨语言/跨域验证留作未来工作。基于本文成果可自然延伸的研究:(1)软约束奖励设计:把 rubric 式奖励引入 IF 专家以缩小 Loose-IF 差距,同时保持 RM 校正防止坍缩复发,并研究两类奖励项的最优配比;(2)会话级 RL:为 FC 专家设计端到端任务成功奖励(τ2 风格双控制环境)或过程奖励,弥合单步精确匹配与整段会话成功之间的目标错位;(3)可执行工具环境:把三智能体模拟替换为真实沙箱执行反馈(Tool-N1/构建环境类思路),消除对 planner 参考轨迹的依赖并让奖励接地;(4)合并自动化:用任务向量正交化或基于验证集梯度的可微系数搜索取代穷举+网格搜索,使'新增一个专家'的成本可预测、可扩展到四个以上专家;(5)持续更新闭环:论文强调模型'便宜到每生产周期可更新',把错误分析→数据生成→专家再训练→合并→影子评估自动化为流水线是显然的工程下一步,也值得研究合并检查点的灾难性遗忘随周期数的演化;(6)智能路由:复用已有的任务分类器(与人类共识一致率 90.6–99.6%)把 frontier 级工作流路由到更大模型,在保留单模型成本优势的同时覆盖导致回滚的长尾需求;(7)跨语言专家共享:检验 IF/FC 专家的权重增量能否跨语言迁移(如俄语专家增量直接用于其他语言),摊薄每语言的重训成本。
复现评估
复现条件中等偏上,公开与封闭部分界限清晰。开源部分:公开检查点 T-pro-it-2.1 已在 HuggingFace(t-tech)发布,据论文所述用同一配方但不含内部数据,公开基准成绩接近内部版;附录提供了异常详细的合成数据配方与过滤阈值——IF 管线给出 54 个种子约束、约 33% 的管线通过率、验证器/测试用例一致性规则(8 个验证器、每函数 3 个测试用例、回译相似度 0.6、最终 10k 用户级+16k 系统级样本),FC 管线给出 33.5K 主题与工具规模、1.2M+300K 轮级样本、70/30 语种与 80/20 调用/文本混合比、10% 无关样本注入;训练配置完整公开(SFT:bf16、32k 上下文、2 epoch、AdamW、cosine、57 小时;GRPO:batch 512、8 rollouts、lr $1\times10^{-6}$、clip 0.20–0.28、各专家的 KL 系数与步数、vLLM+FSDP2+verl),SLERP 逐层系数网格也给出。算力:32B SFT 57 小时加三个 GRPO 专家 28/40/62 小时,均为 4 节点×8 H100,合计约 750 GPU·时量级,对工业团队可承受、对学术实验室偏贵,但论文的 8B 消融路径完整,可先在 8B 上低成本复现主要结论。不可复现部分:内部 Arena、in-house IFEval/BFCL、SmartSearch 基准与内部训练数据均不发布,2,500 条错误分析的生产分布只能信任作者;数据生成依赖 Kimi-K2.5、Qwen3-235B、DeepSeek-V3-0324、gpt-oss-120b、gemini-3.1-pro 等多个前沿模型的组合,完整复现的 API 成本不低。总体判断:公开基准上的 IF/FC 增益可以较有信心地复现,'内部 Arena 超过 235B'这一头条结论无法独立验证,只能通过公开检查点的接近成绩与四评委敏感性分析间接佐证。
论文图表