评估多模态大模型作为无人机控制的通用视觉-语言-动作智能体:指挥、接近、跟踪与搜索 Evaluating Multimodal LLMs as Generalist Vision-Language-Action Agents for Drone Control: Commanding, Approaching, Tracking and Searching
把九个多模态大模型放进无人机闭环控制,发现小模型败在到达声明纪律而非导航
前置知识
MLLM(多模态大语言模型)
在 LLM 基础上接入视觉编码器的模型,能同时处理图像/视频与文本,如 GPT-5、Gemini 3.7 Flash、Qwen3.5 系列。它们擅长感知(看懂图),但本文追问的是它们能否据此行动——在物理回路里一步步选择下一个动作并对自己的选择负责。
本文的自变量就是 MLLM:固定智能体架构、换不同 MLLM 进同一个无人机控制回路,比较 2B 到前沿模型的成败差异。
VLA(视觉-语言-动作)
把视觉和语言输入映射为动作输出的智能体范式。狭义 VLA 把动作映射训练进模型权重(动作头/动作 tokenizer),本文用其功能义:视觉语言进、动作出,映射可以由提示词+外部解析器装配在模型周围,而非位于权重内部。
论文标题所称 generalist VLA agent 正是在这个意义上:动作空间完全由提示词声明,任何能读提示词的 MLLM 即插即用。
闭环控制(closed loop)
智能体的动作改变环境状态,下一步观测又取决于上一步动作,误差会复合而非平均。无人机控制中相机位姿就是动作:指错一个点,下一帧就跟着错,模型必须在与世界持续交互中修正自己。
本文评测的是闭环而非静态问答,成功率低不等于感知差——必须区分『到不了』与『到了不知道到了』,这正是全文核心发现。
视觉定位(visual grounding / pointing)
在图像上指出目标所在位置,通常输出归一化像素坐标。SPF 等工作把导航简化为『指点+距离』:模型在图上标一个航点并给出前进距离,几何控制器把这对信息反投影成 3D 位移交给飞行栈执行。
DroneCATS-Agent 的 go 动作继承了这个指点接口(坐标归一化到 0–1000 加深度估计),是理解其动作空间的基础。
测试时计算(test-time compute)
推理时给模型更多解码预算(如扩展思考链)以换取更强能力,是静态问题求解的常用杠杆。但在约 2 Hz 的机载控制回路里,世界在你解码时仍在移动,每个 token 都有物理代价。
本文把深思设计成模型可主动调用的 think 动作而非默认常开,并用步级统计检验它到底有没有用——结论是几乎没用。
AirSim / Unreal 仿真
微软开源的无人机仿真器,基于 Unreal Engine 渲染,提供物理飞行模型与图像渲染,是无人机导航研究的标准平台。本文在住宅区、校园两张自制地图加 Blocks 几何地图上共布置 100 个 episode。
所有实验都在 AirSim 中进行,理解这一点才能评估结果向真机迁移的置信度,也是复现本文的必要环境。
研究动机
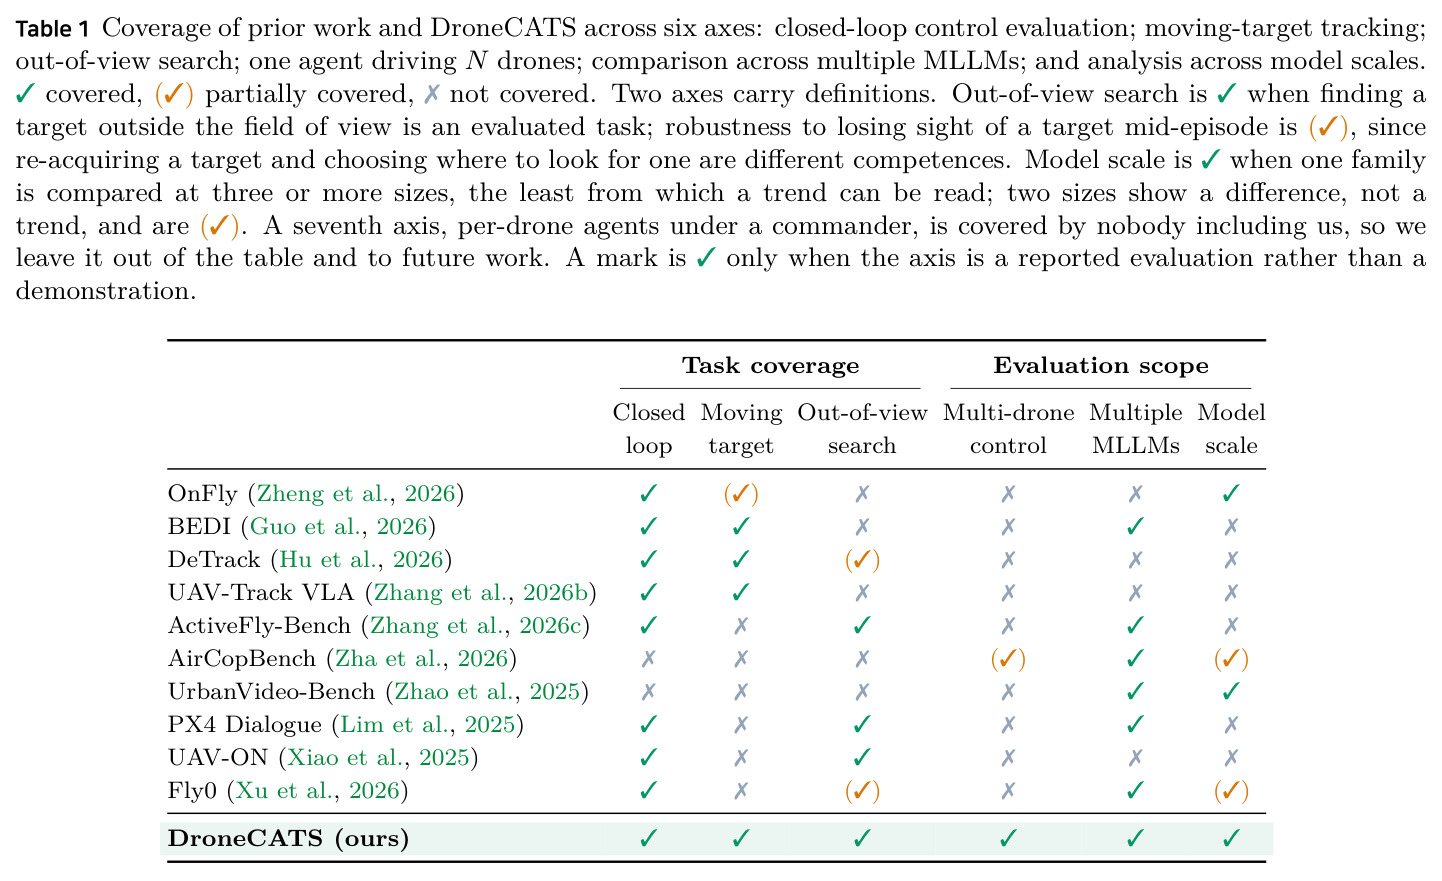
现有系统研究在回答『MLLM 能否闭环控制无人机』时,都在不断削减模型的决策权:TypeFly 把模型放在控制回路外做规划、依赖外部检测器;PIVOT 把控制化简为在图上画好的候选点里挑一个;SPF 把模型的工作化简为指一个像素;Fly0 让 MLLM 只输出语义定位元组(约 0.5 Hz),轨迹交给 50 Hz 的 Ego-Planner,在 AerialVLN 上拿到 70.4%;OnFly 再加验证器在输出进入执行器前纠错,把成功率从 26.4% 抬到 67.8%。这些工作每次比较都在变系统、固定模型,于是 Fly0 里 GPT-5、Gemini 3 Pro、Claude 3.7 Sonnet、Qwen2.5-VL-32B 四个差异巨大的骨干在定位上只差 1.1 个百分点(70.4–71.5%),连 3B 模型也只落后 6 分——看似『定位与骨干无关』,实则因为真正拉开差距的能力被工程手段移出了回路、从未被测量。基准侧同样碎片化:BEDI 多为选择题、跟踪靠 DeTrack 与 UAV-Track VLA、搜索靠 UAV-ON、指令跟随靠 AerialVLN 与 CognitiveDrone,没有工作在同一闭环协议下评测接近/跟踪/搜索,也没人让一个模型同时指挥多架无人机。
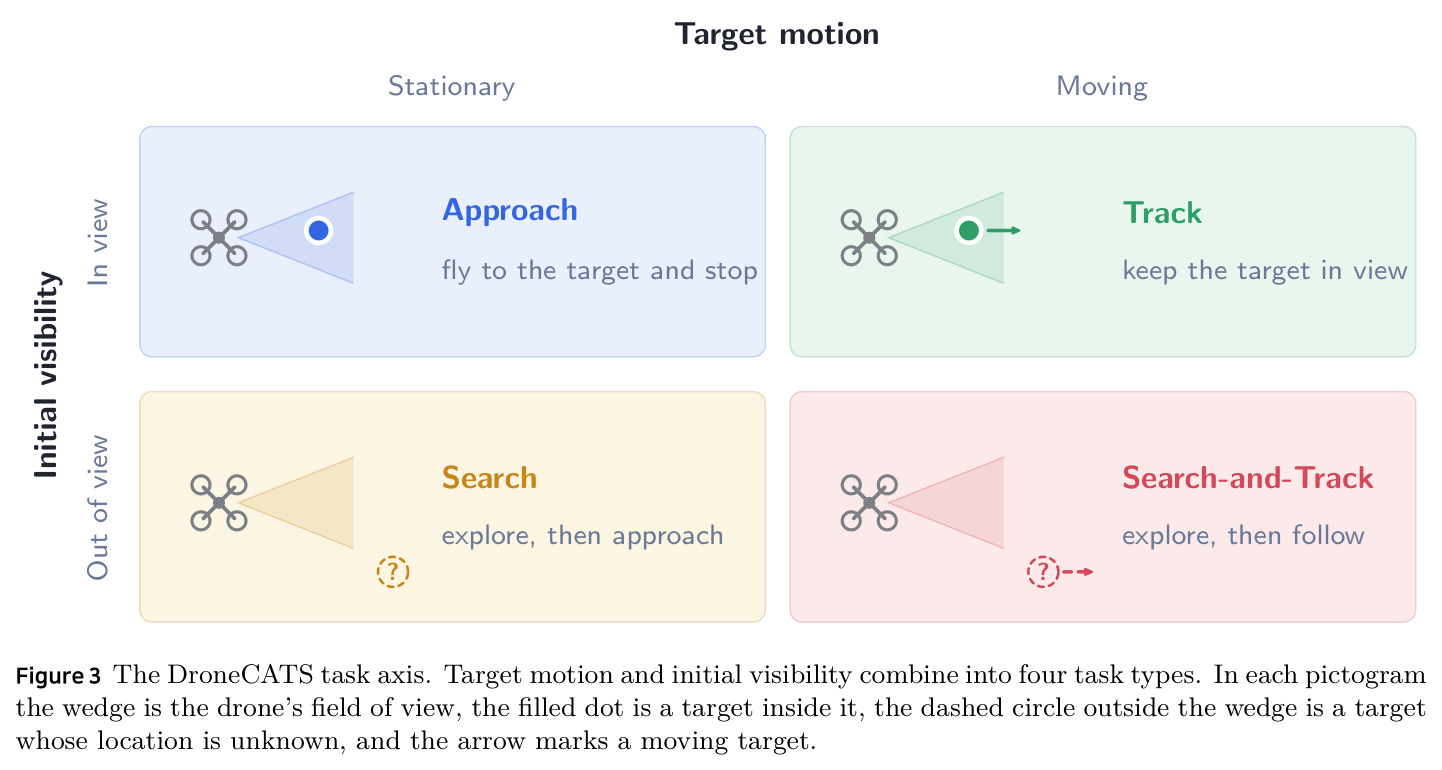
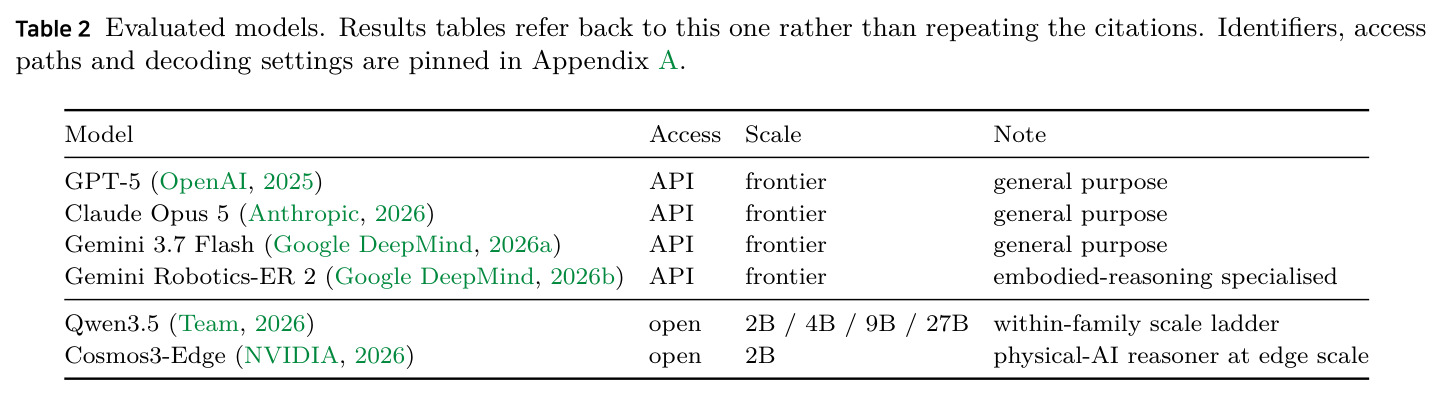
本文的目标是本文要回答反向问题:把系统固定、把模型当自变量,MLLM 作为通用视觉-语言-动作智能体在无人机闭环控制中究竟走得到多远。具体目标有三层。第一,构建 DroneCATS-Agent:一个模型无关的无人机智能体架构,动作空间(go/rotate/think/finished 四个动作)完全声明在提示词里,无微调、无 function-calling schema,任何能读懂提示词的 MLLM 即插即用,且搜索、深思、终止三个关键决定全部交还给模型。第二,构建 DroneCATS 基准:用『目标是否移动』与『首帧是否可见』两个二元轴划分出接近、跟踪、搜索、搜索-跟踪四种任务,用同一条以模型自身到达声明为锚点的判据统一评分,使四个格子的分数可比。第三,把评测规模下探到 2B 参数的边缘可部署模型(Qwen3.5 家族 2B/4B/9B/27B 与 Cosmos3-Edge-2B),找出在机载算力约束下最先崩溃的能力是什么。
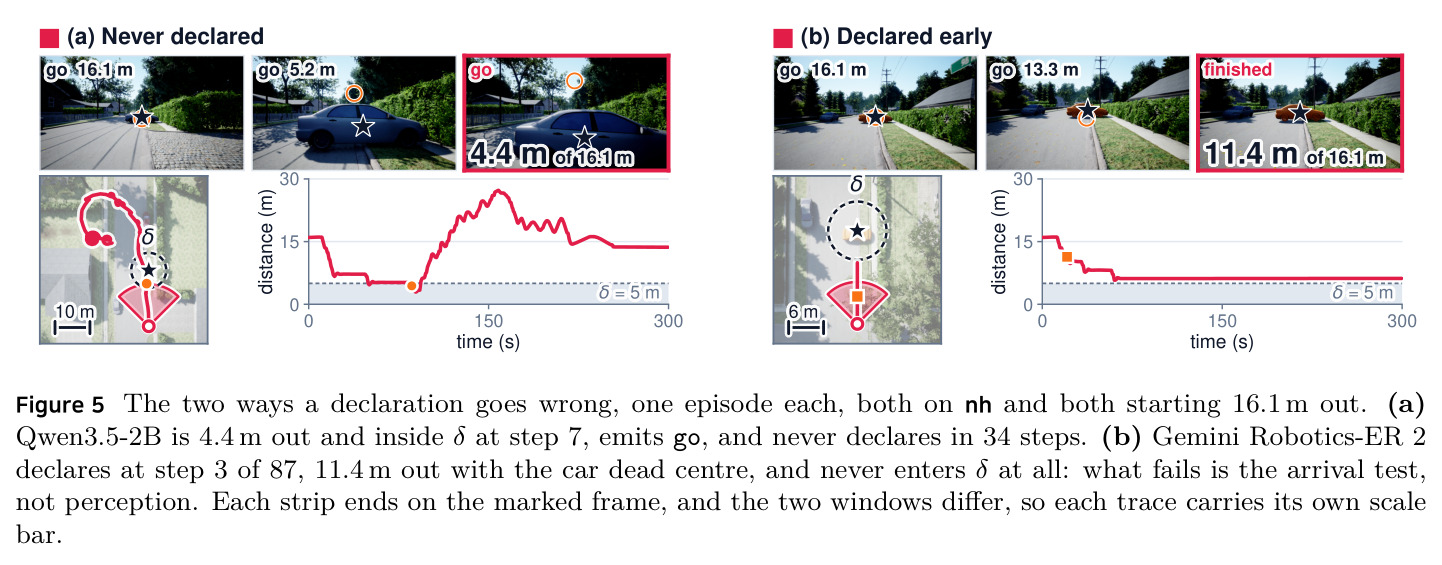
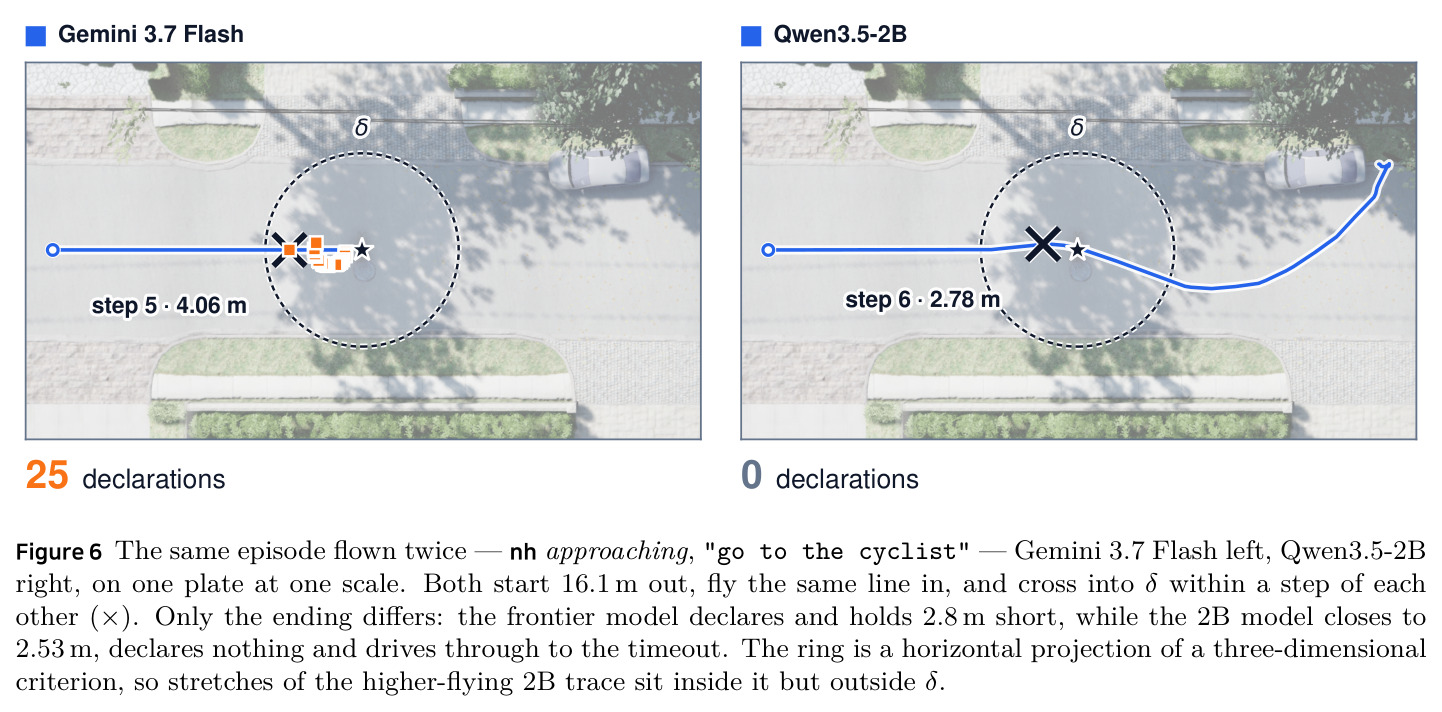
与已有工作不同的是,本文的独特切入是三个此前无人同时满足的条件的交集。其一,为模型而固定系统:与 OnFly 用一个 4B 模型评所有基线、Fly0 只在定位角色上扫骨干不同,本文固定智能体、变动骨干,使模型成为唯一变量。其二,把终止决策移进模型:此前系统用模型永远看不到的距离阈值在体外决定停止,DroneCATS-Agent 把 finished 变成模型提交的声明,脚手架记录后继续飞行,事后由验证器对照真值打分——这才可能问出『模型是否知道自己完成了』。其三,判据只认声明不认轨迹:成功定义为 $\exists\, i \in D: d_i \le \delta \land v_i$($\delta=5$ 米),从未声明但轨迹进过目标区的一律判负(337 次未声明失败中 61 次进过 $\delta$,按轨迹给分会把 182 个成功虚增三分之一)。再加上单上下文指挥 4 架无人机的全新组织维度,构成了完整的新评测空间。
核心方法
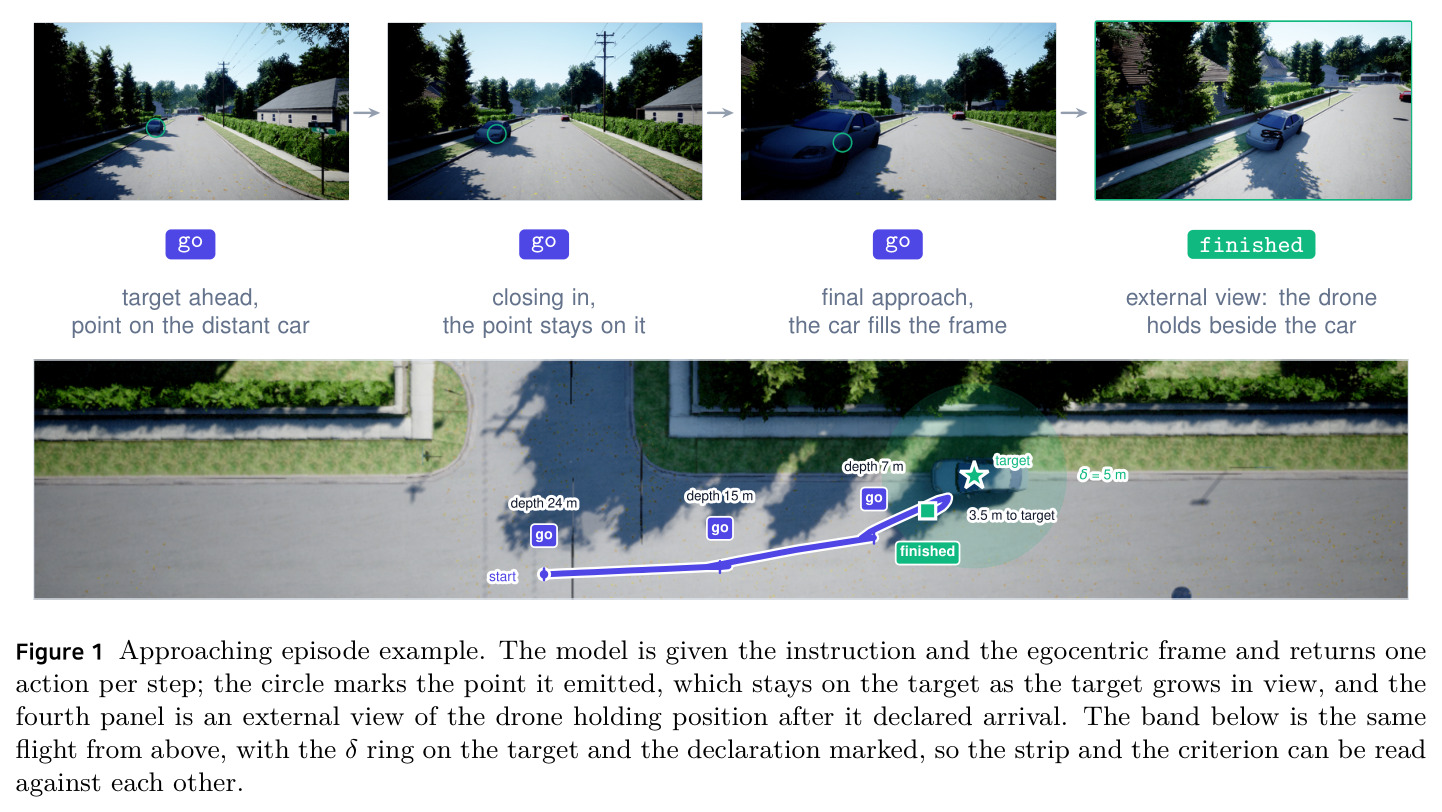
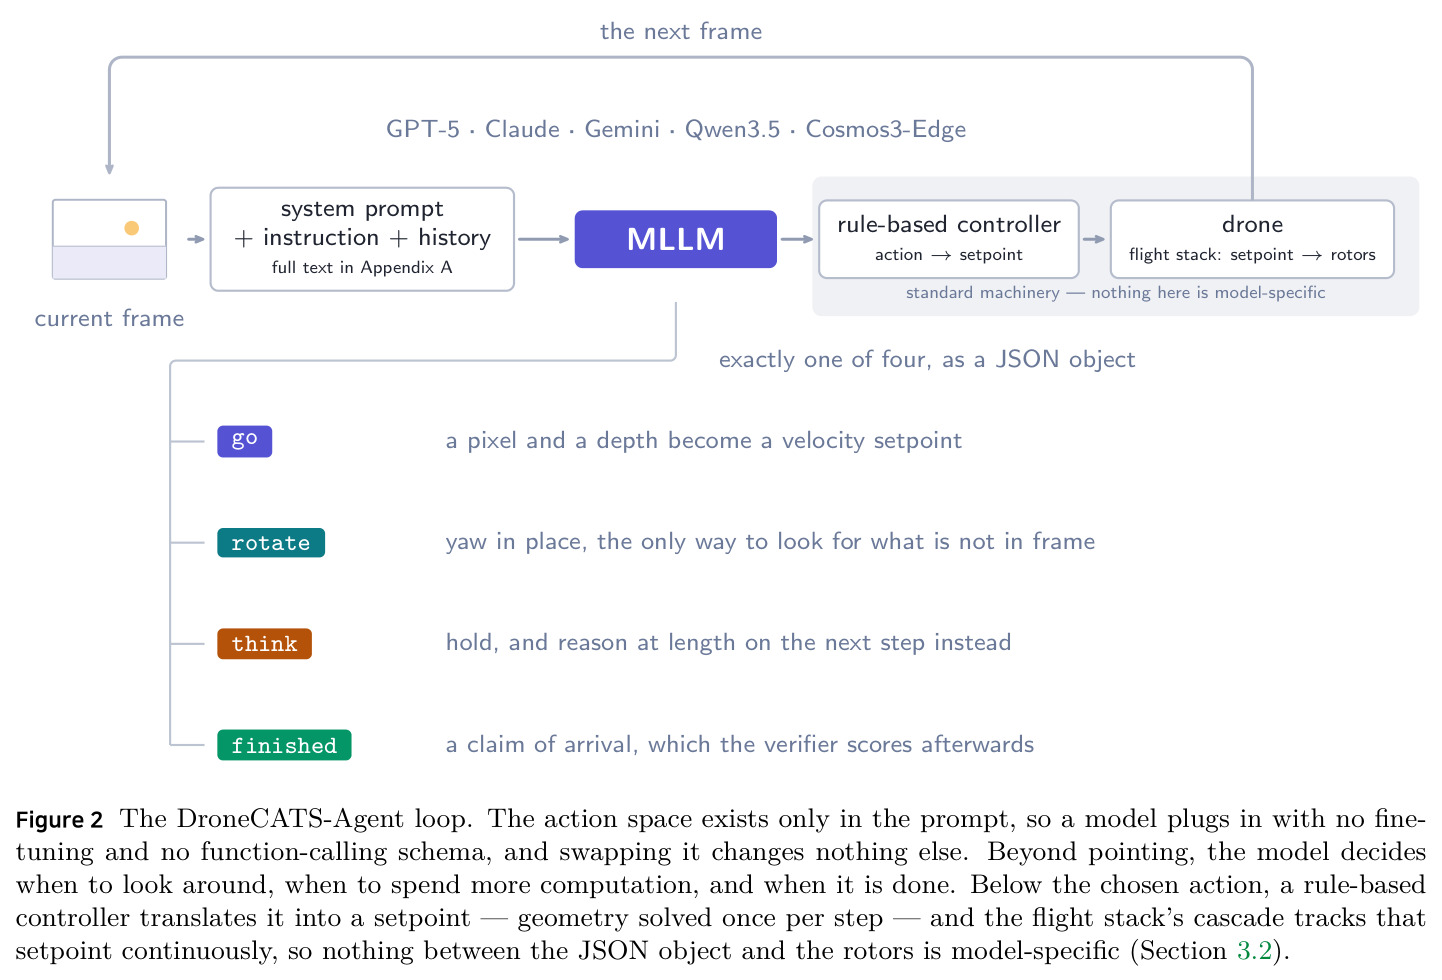
直觉上,MLLM 已经是很强的图像感知器,问题在于『行动』:能否把它直接丢进无人机控制回路、动作空间完全由提示词声明?DroneCATS-Agent 的回路是:每步给模型一张自我中心单目 RGB 帧、任务指令和最近 5 步动作历史,模型返回恰好一个 JSON 动作,四选一——go 携带图像点(两轴归一化到 0–1000)与深度(米,模型自己的单目估计,无相机内参);rotate 携带偏航角(提示词要求每步 ±90° 内);think 与 finished 不携带参数。动作之下是与模型完全无关的规则机器:几何控制器用已知相机 FOV 把像素和预测深度反投影成 3D 位移,作为体坐标系速度设定点交给飞行栈的级联控制器(速度→姿态→电机)按固定步长执行;rotate 转为保持位置的角速率设定点;think/finished 原地悬停。episode 上限 300 秒,脚手架记录全部声明事件与 2 Hz 位姿轨迹用于事后判分。模型唯一的传感器是这颗 RGB 相机——连它命令的深度都是自己的估计而非物理读数,提示词到电机之间没有任何部件与具体模型绑定。
核心创新是把『何时停』变成模型自己的主张,并让整条判据锚定在这个声明上。此前系统在模型外部用距离阈值决定终止,模型根本看不到那个量;本文让模型用 finished 提交到达声明,脚手架记下声明后继续飞,事后由验证器判定。成功判据 $$\mathrm{success} = \exists\, i \in D:\ d_i \le \delta = 5\,\mathrm{m} \ \land\ v_i$$ 对四类任务格完全一致(此前跟踪按 10 秒驻留、其他按距离,格子间不可比),且统计所有声明而非只看最后一次——这容纳了『声明瞬间目标恰好没被检测到』和『说完才漂进 $\delta$』两种无辜情形。与 SPF 的本质区别在加回的三个动作:rotate 使视野外搜索在构造上可达(看不到的目标无法用指点表达);think 把测试时计算变成模型可按步调用的动作(默认关闭,因为闭环里每个 token 都有延迟代价);finished 把终止权交还模型,使智能体可被指挥官委派——无法自察完成的智能体无法汇报完成,也就无法被委派。这使换模型不改变回路中任何其他东西。
方法步骤详情
第一步,构建提示词(附录 A 给出逐字全文):声明四个动作与 JSON 输出格式,无 function-calling schema;解析器按各模型训练习惯适配 $[x,y]$ 或 $[y,x]$ 轴序,不让任何模型因轴序吃亏。第二步,单步循环:输入当前自我中心帧+指令+最近 5 个动作 → 模型输出恰一个 JSON → 解析校验 → 若为 go,几何控制器用相机 FOV 把像素反投影成射线、乘上模型预测深度得到 3D 位移,转为体坐标系速度设定点按固定步长飞行(深度只作步长建议而非标定量测);rotate 转为保持位置的角速率;think/finished 悬停;仅当上一步是 think 时对该次调用开启扩展推理。第三步,脚手架全程记录声明事件 $(t,d,v)$ 与 2 Hz 位姿轨迹,跑满 300 秒,事后按算法 1 判分:取时限内第一条满足 $d_i \le 5\,\mathrm{m}$ 且可见的声明判成功,同时输出导航误差 NE 等诊断量;改 $\delta$ 无需重飞。第四步,指挥设定:$N=4$,四个视角按固定顺序填进同一上下文,一次回复给每架各发一条命令;场景放置多个同款候选物,铭牌需近距离才可读,全部声明合并按同一判据打分。第五步,9 个模型 ×(80 个单机 + 20 个指挥 episode),每格 20 个,另用 Flash 完整重飞 3 次做方差审计。
技术新颖性
相对既有工作的『减法+加法』结构是新的:PIVOT 让模型在图上候选点里选、SPF 让模型指点加距离,本文保留指点接口但把三个决定——搜索(rotate)、深思、终止(finished)——交还模型,而 Fly0/OnFly 是把这些责任进一步外包给 LiDAR 规划器或验证器。就评测空间而言(Table 1 的六轴覆盖表),此前没有工作在同一闭环协议下同时评测接近、跟踪、搜索三 competences,没有把骨干当主轴(AirCopBench 评 40 个模型但只出选择题不出动作,UrbanVideo-Bench 连动作题都是选择题),也没有让一个上下文指挥多架无人机(RALLY 每机各配一个 LLM 而非统一指挥)。声明锚定的统一判据、把『声明』当作可提交可被拒绝的动作、以及把标尺下探到 2B 以定位『最先崩溃的能力』,三者组合构成本文的技术签名。按模型训练习惯适配轴序这类工程细节也保证了比较的公平性。
实验结果
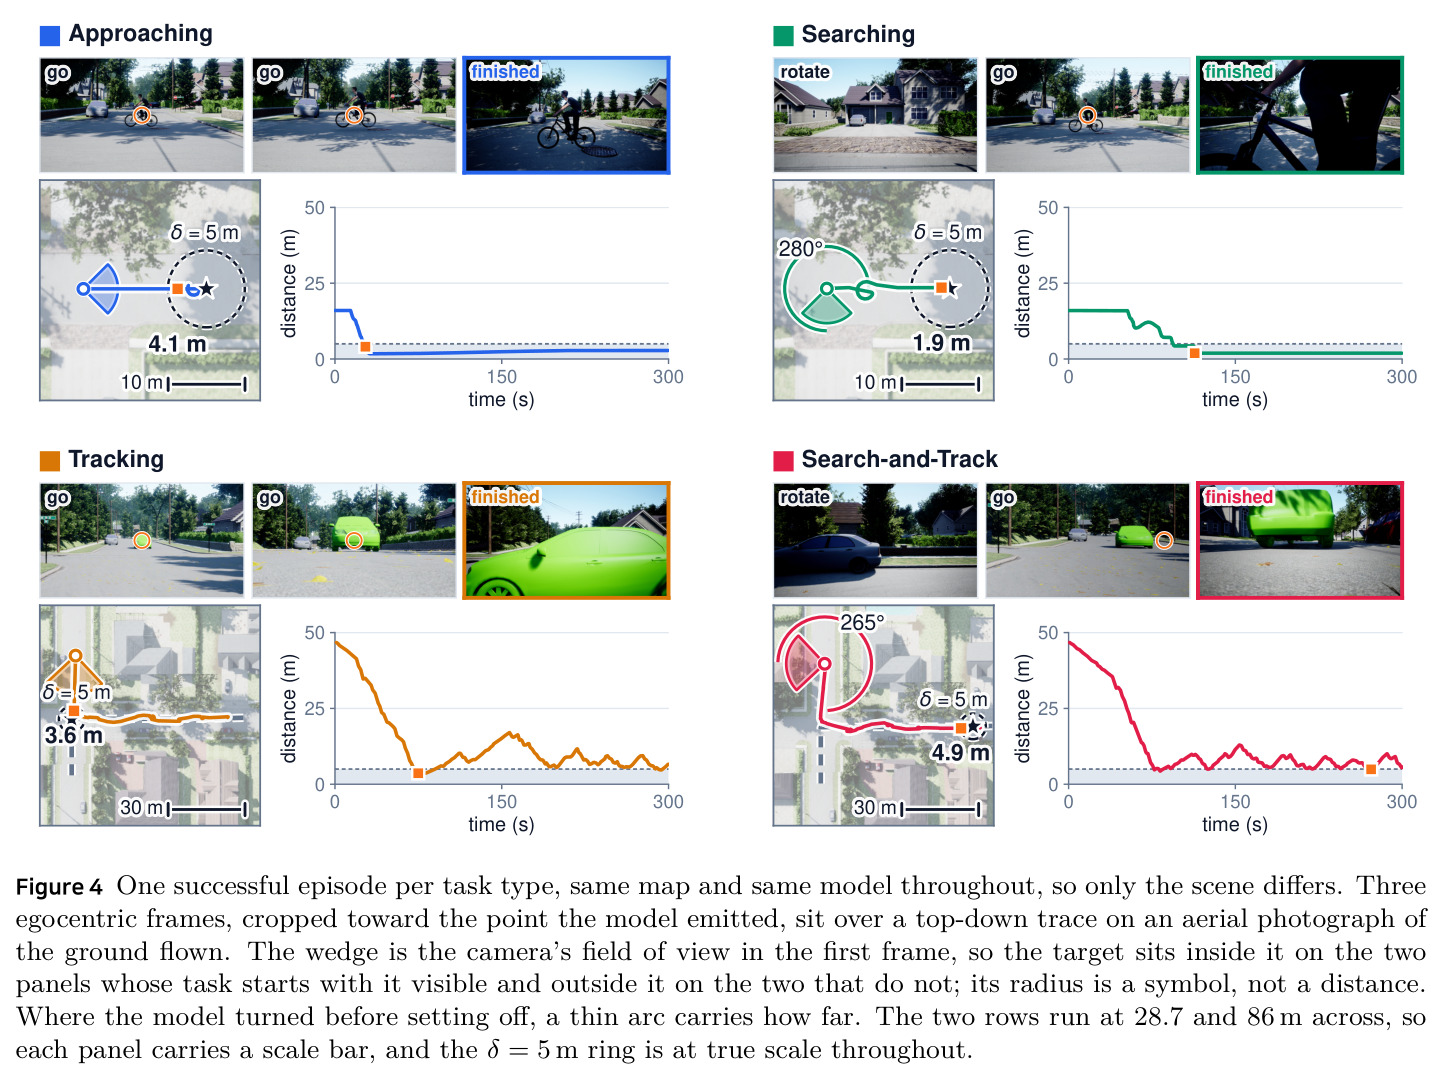
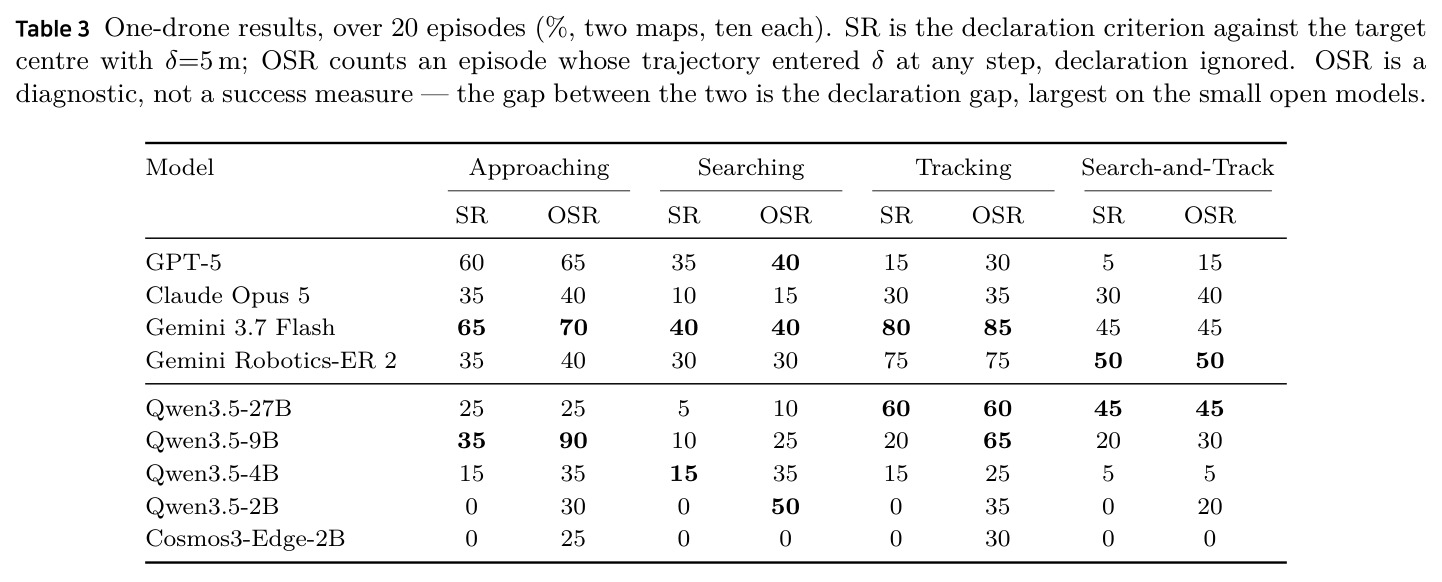
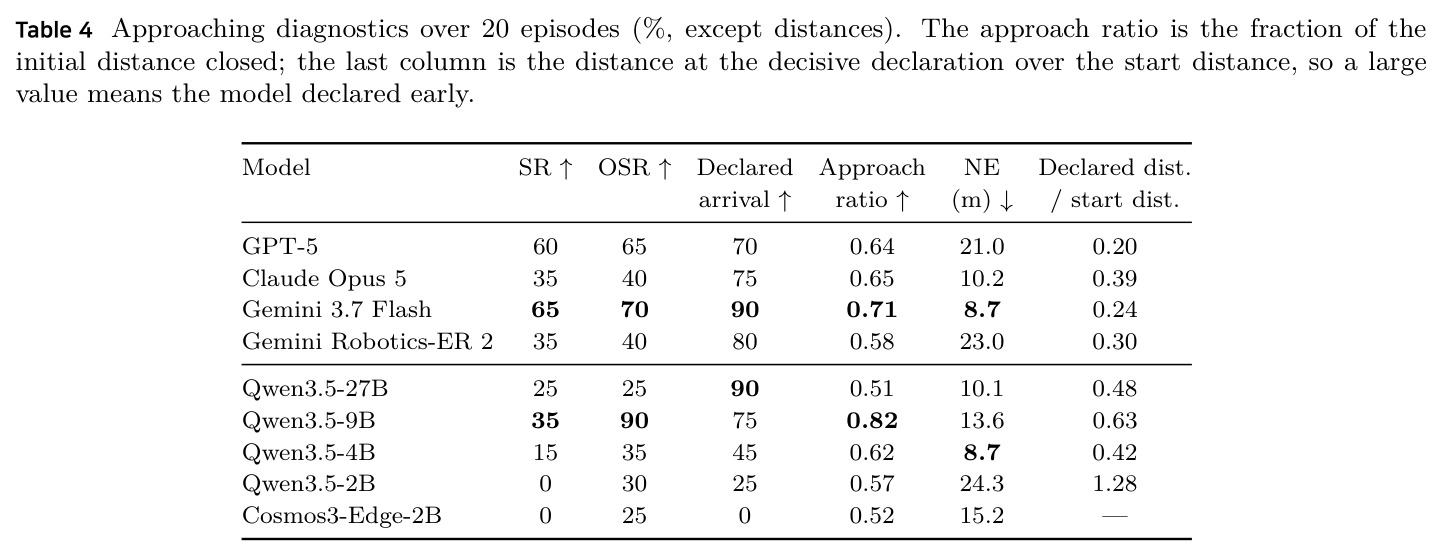
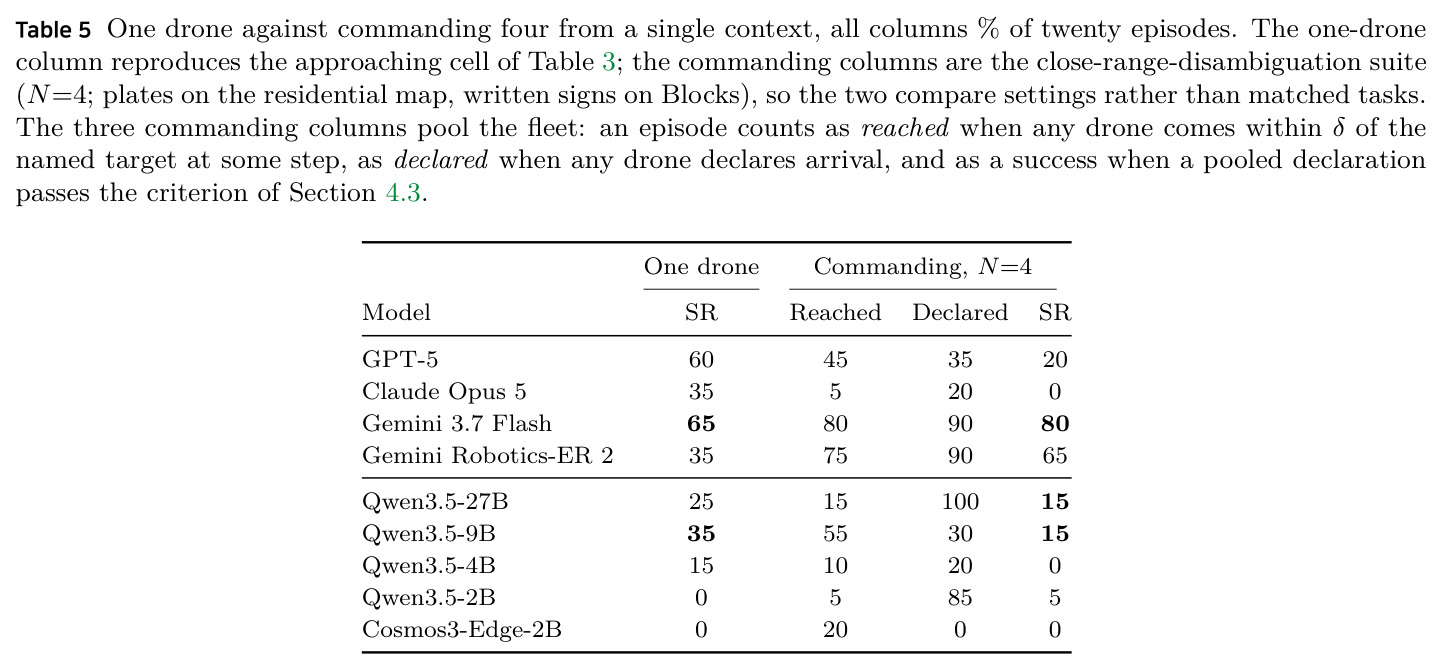
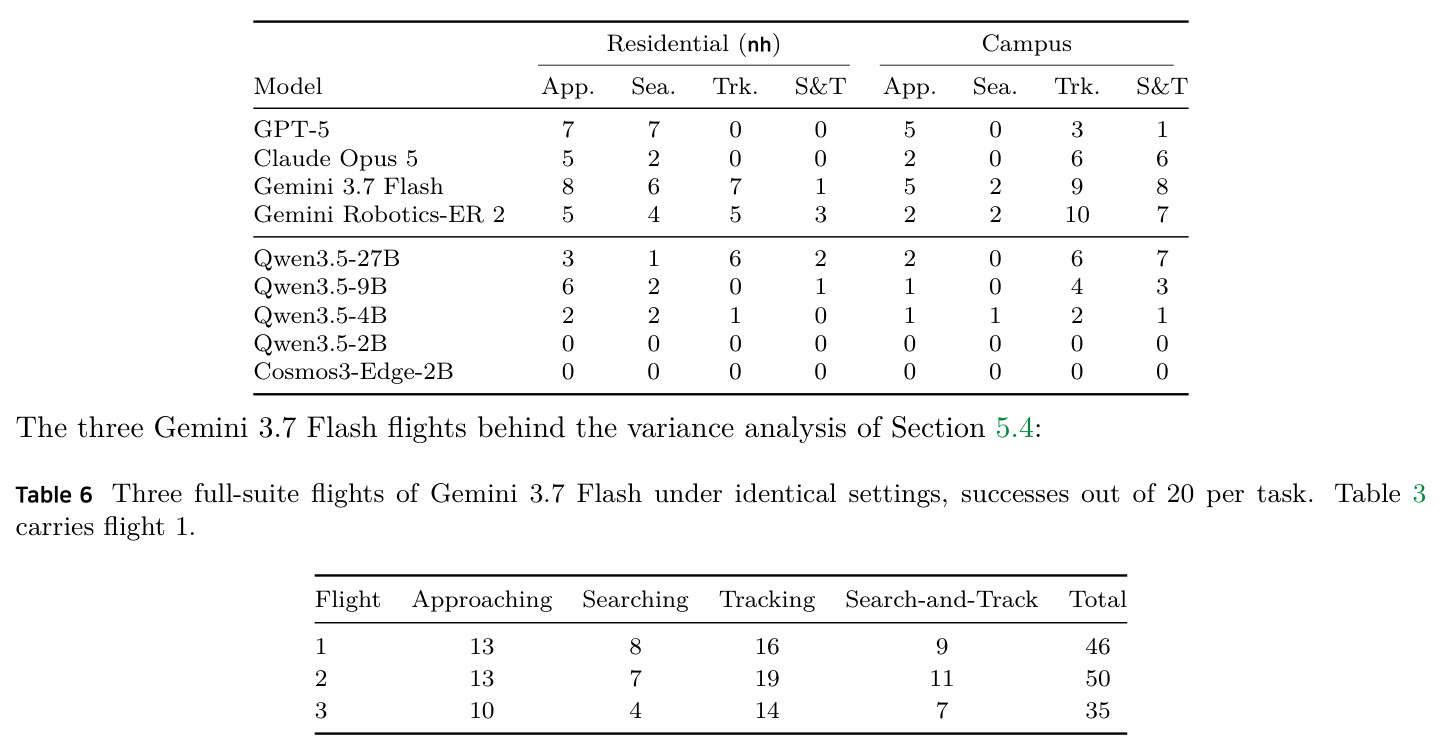
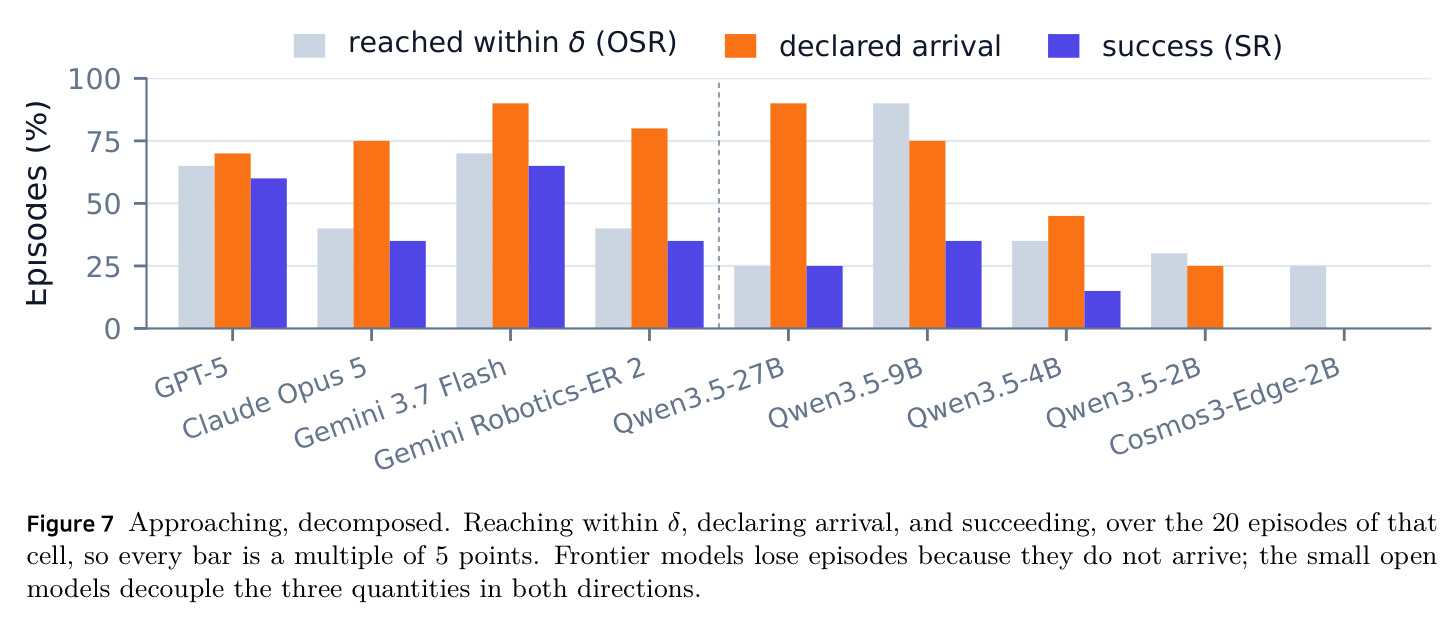
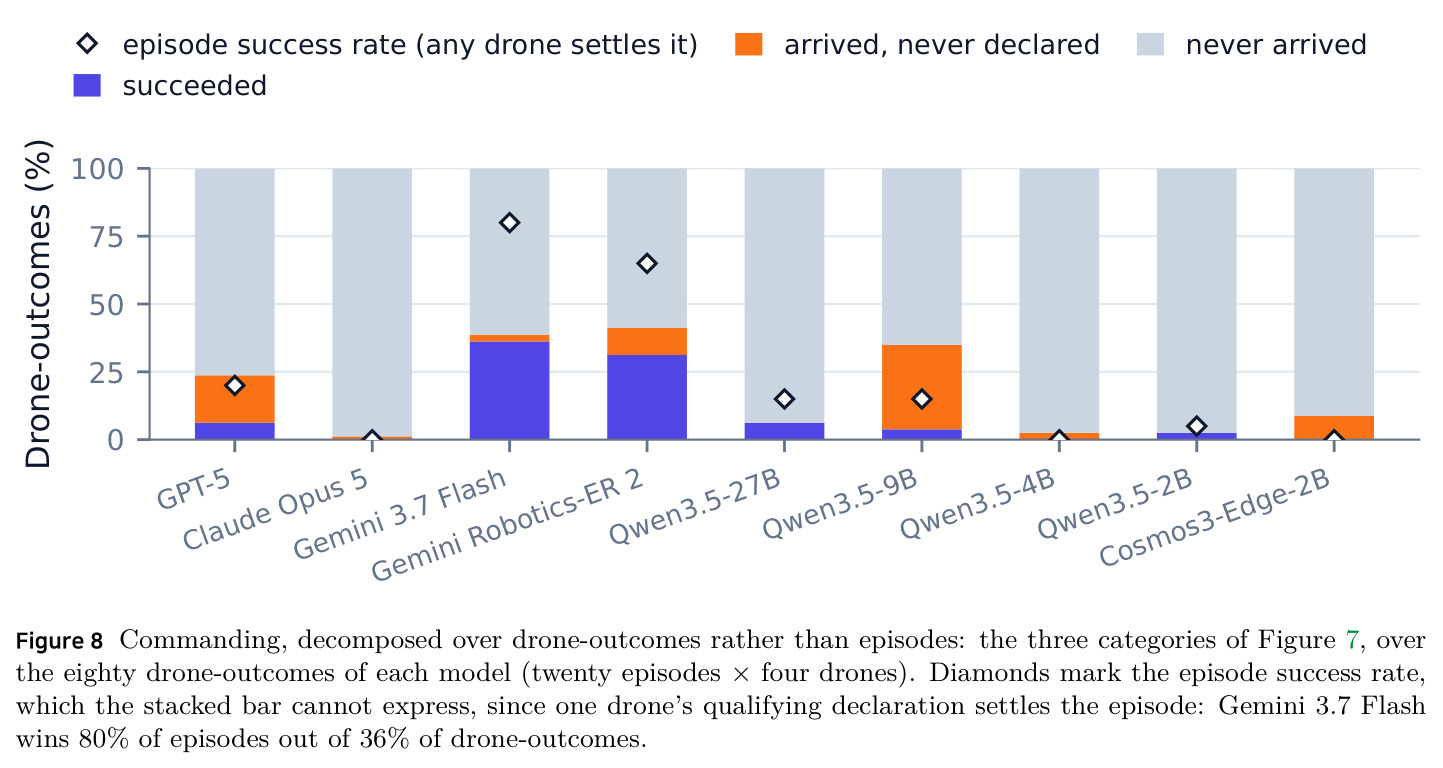
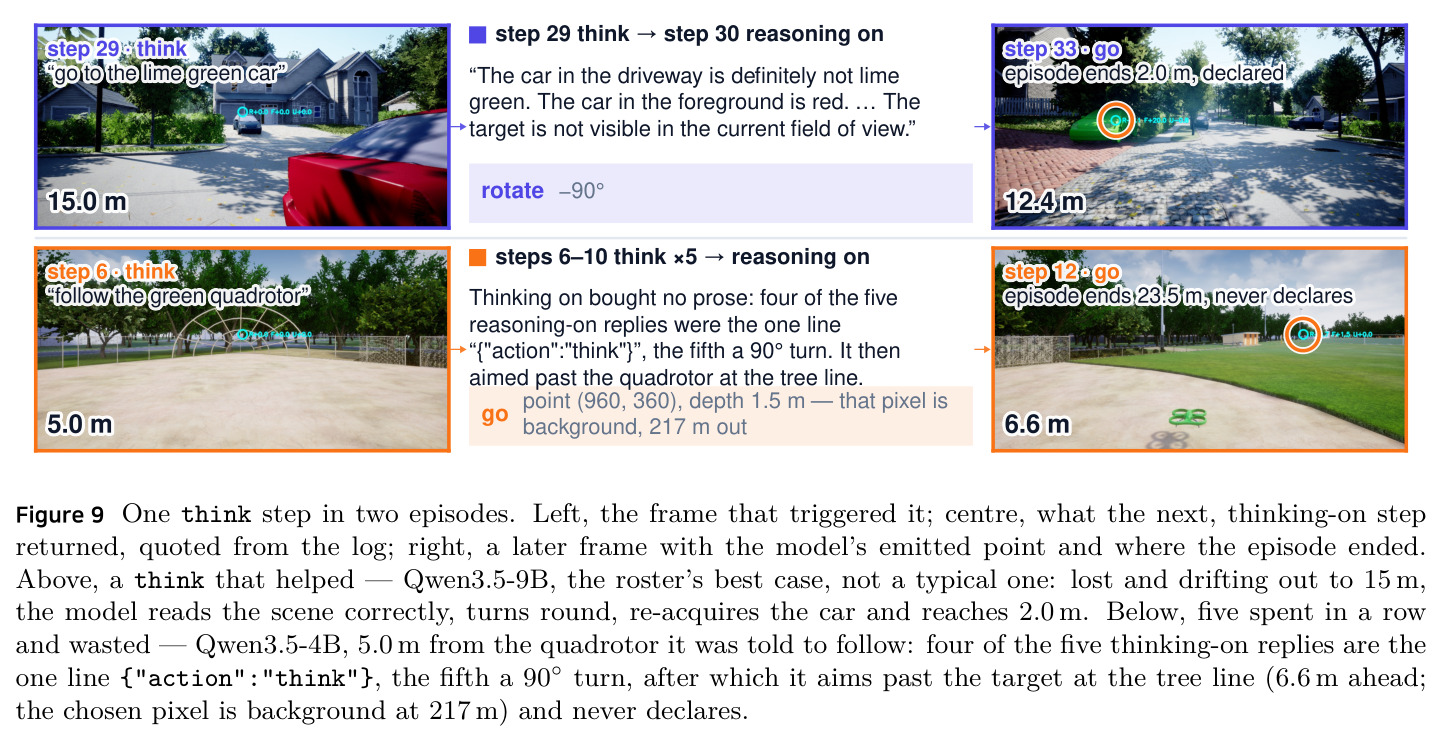
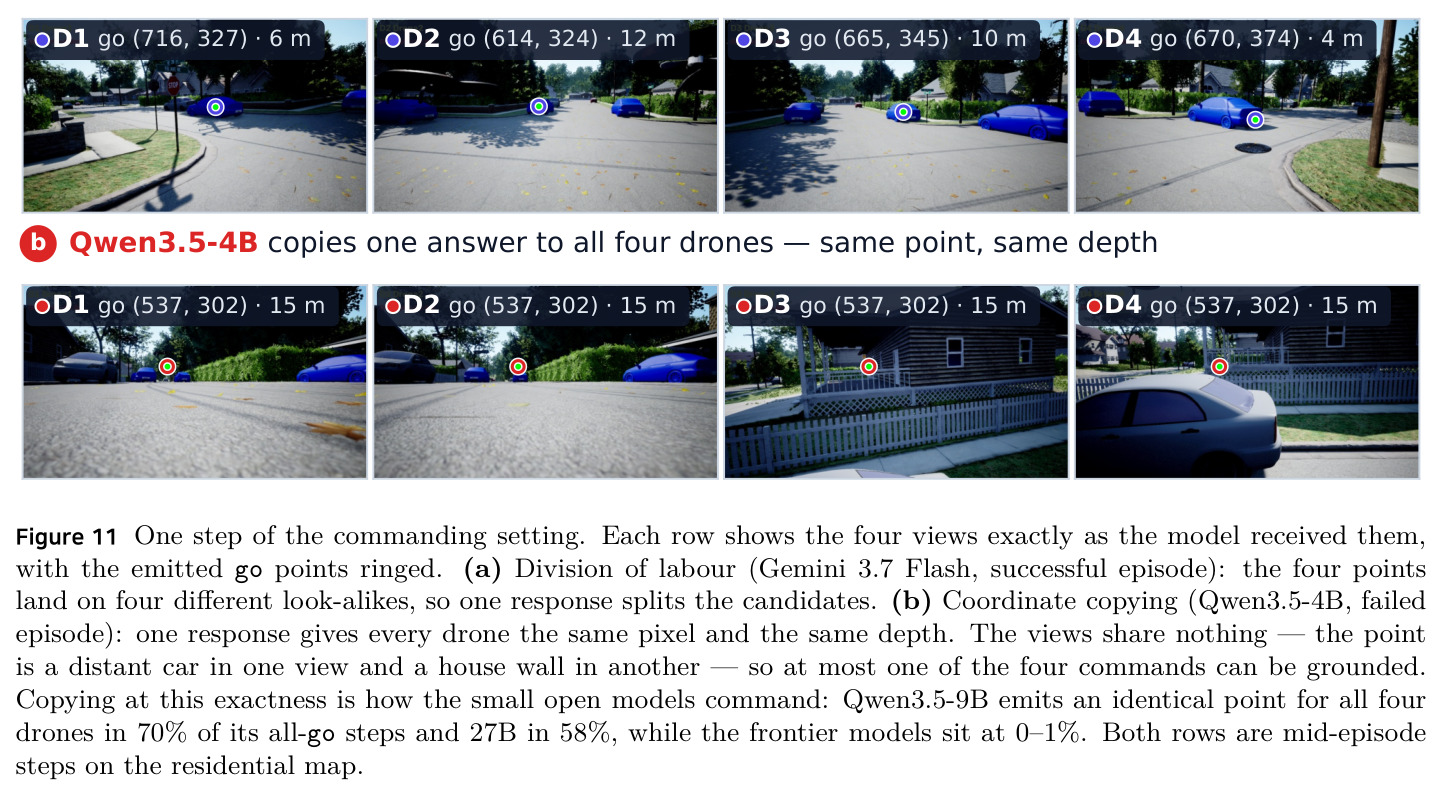
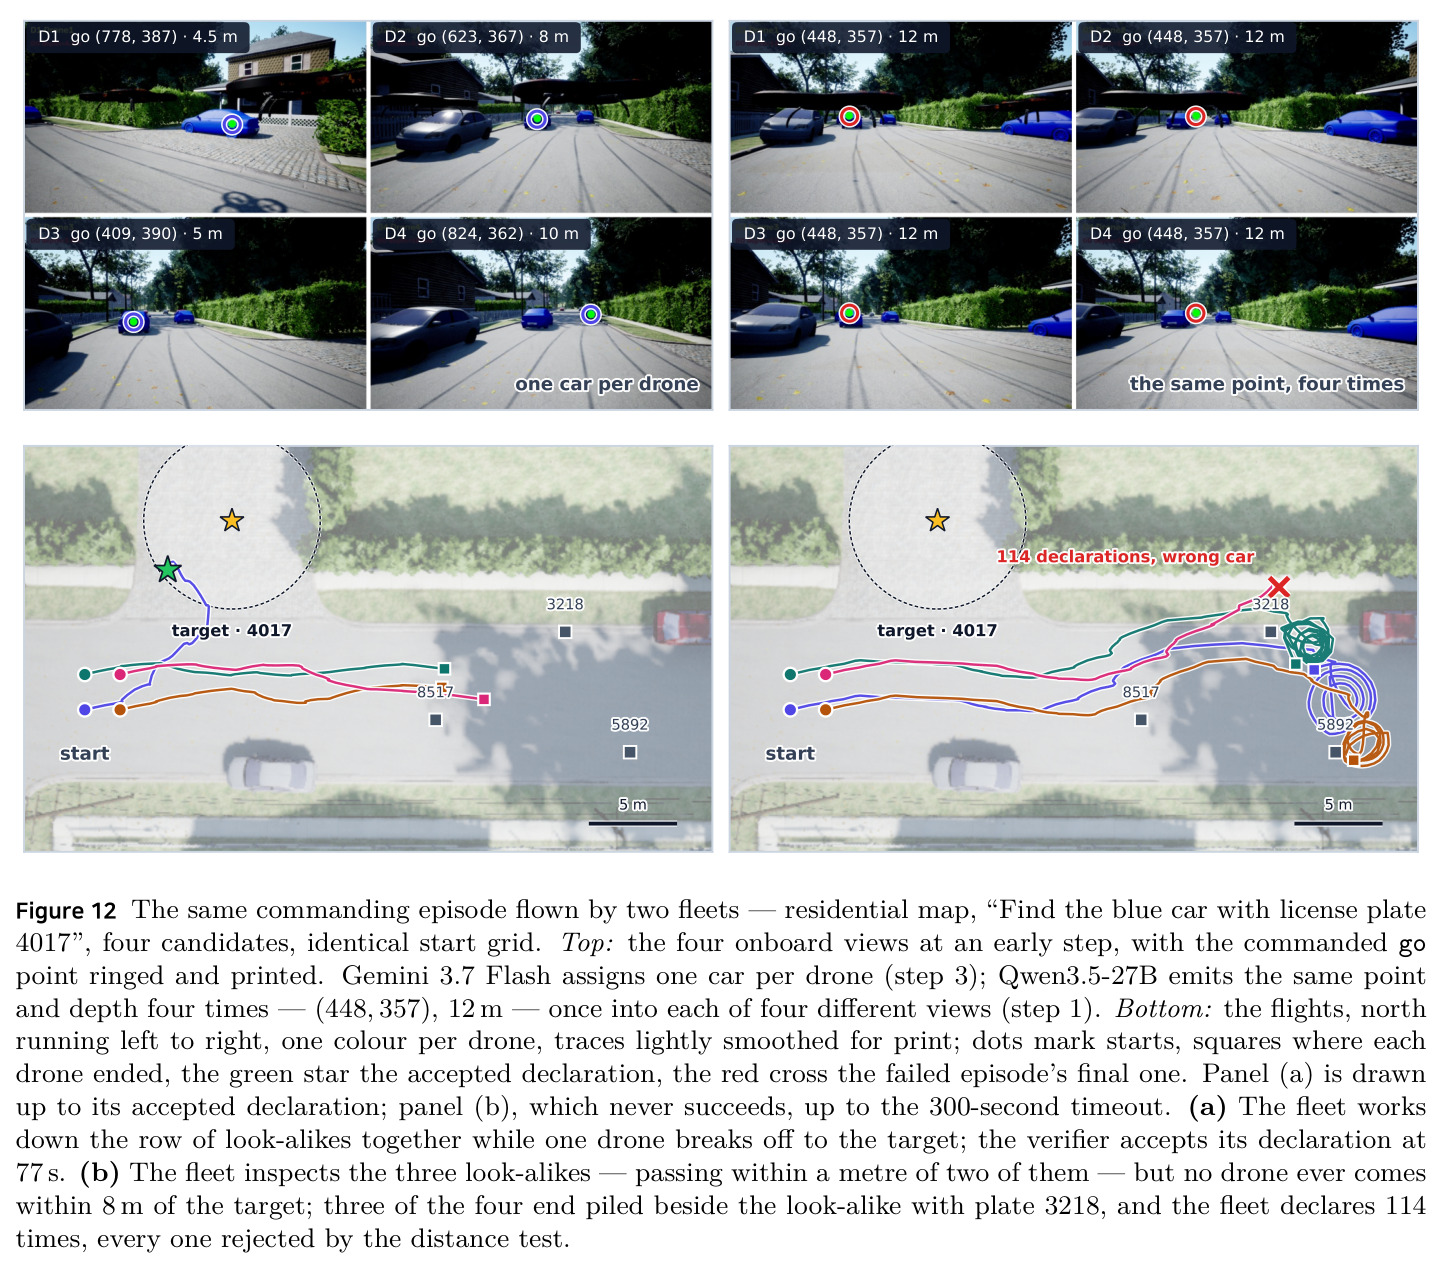
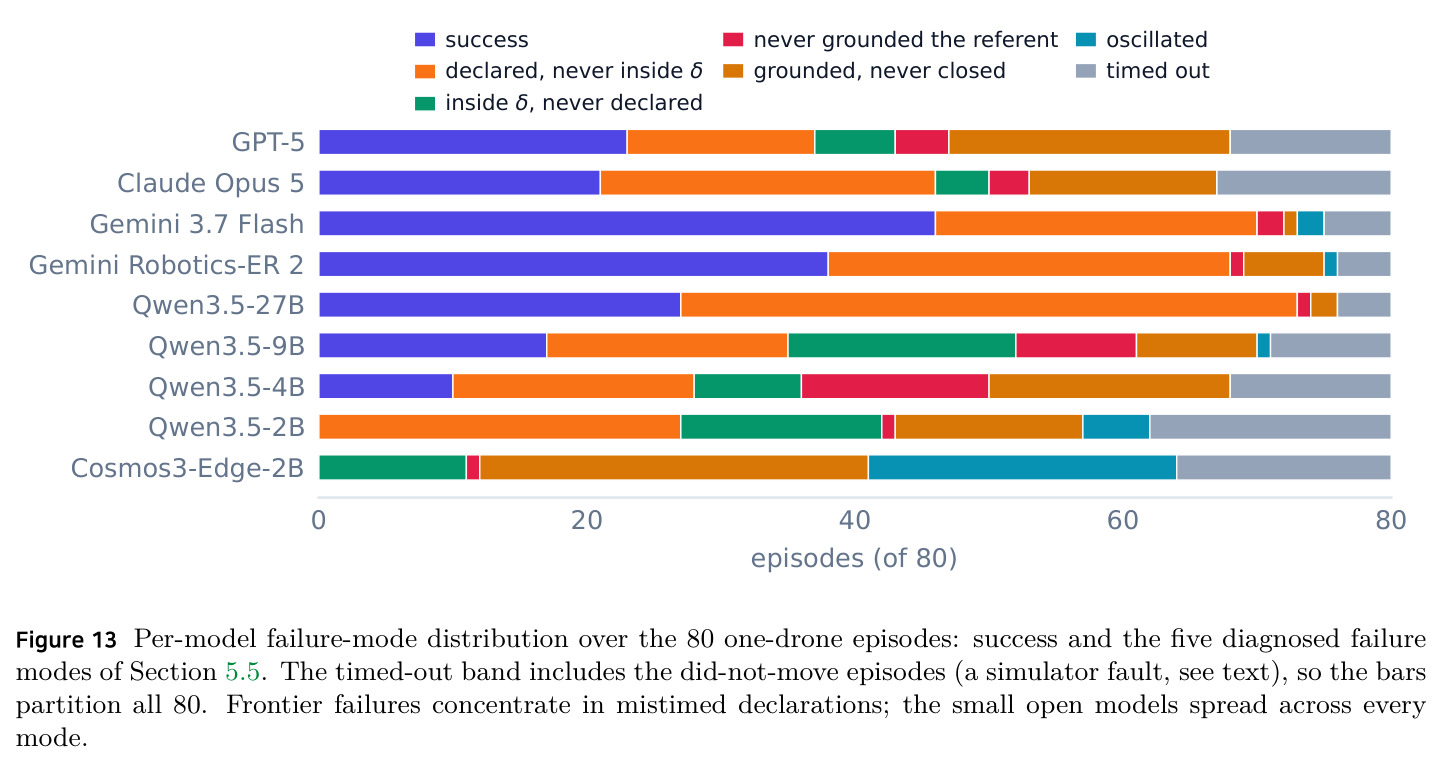
结果分四层。其一,最简单的格子也没被解决:接近任务最佳 Gemini 3.7 Flash 仅 65%(13/20),GPT-5 为 60%;目标藏到首帧外(搜索)Flash 掉到 40%,无模型超过 40%;排序跨格子不稳定——GPT-5 接近 60% 但跟踪移动目标仅 15%,Flash 跟踪达 80%。具身特化的 Robotics-ER 2 四格平均 47.5% 反低于 Flash 的 57.5%;Qwen3.5 阶梯单调:27B/9B/4B/2B 平均 33.8/21.3/12.5/0%。其二,核心发现『输在声明而非导航』:Qwen3.5-9B 在接近任务 90% 的 episode 进过 $\delta=5$ m(OSR),超过所有前沿模型,成功率却仅 35%,且平均在 0.63 倍起始距离处声明;Qwen3.5-2B 反向解耦——在 1.28 倍起始距离就宣布到达、成功率 0;Cosmos3-Edge-2B 进过 $\delta$ 25% 却零声明;2B/4B 仍关闭 57%/62% 的初始距离,瓶颈是协议遵从而非感知控制。其三,指挥放大分化:Flash 从单机 65% 升到 $N=4$ 的 80%,Robotics-ER 2 为 65%,GPT-5 从 60% 跌到 20%(失败全耗尽 300 秒预算)、Opus 5 归零;Qwen3.5-9B/27B 在 70%/58% 的 go 步把同一坐标复制给四个视角,Flash 仅 1%。其四,think 几乎无收益:1797 次调用中 think 后三步仅 +0.03 m/步,解卡率 1/230 低于普通步 103/8401,746 个开推理回复仅 3 个含散文。方差审计:单格二项噪声 9–13 个百分点,Flash 三次重飞总分 54.6±9.7%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 单机·接近(Approaching,20 episodes) | 成功率 SR(声明判据,$\delta=5$ m) | Gemini 3.7 Flash 65%,GPT-5 60% | Fly0(外部 Ego-Planner 接管轨迹)在 AerialVLN 达 70.4%,SPF 仅 46.7% | 不可直接比:把终止权与全部决策交还模型后,最简任务也未解决,说明此前的『接近饱和』是工程外包的假象 |
| 单机·搜索(Searching,20 episodes) | 成功率 SR | 最佳 40%(Gemini 3.7 Flash),GPT-5 35% | UAV-ON / ActiveFly-Bench 覆盖搜索但无统一闭环声明判据,无跨格可比分数 | 目标不在首帧使最强模型较接近任务下降 25 个百分点(65%→40%),超过三分之一的相对损失 |
| 单机·跟踪(Tracking,20 episodes) | 成功率 SR | Gemini 3.7 Flash 80%,Robotics-ER 2 75%,GPT-5 仅 15% | DeTrack / UAV-Track VLA 使用训练过的动作头,失败语义为策略失败 | 同协议下跟踪与接近的模型排序不一致,暴露跨任务能力不稳定这一此前不可见的维度 |
| 指挥(Commanding,N=4,20 episodes) | episode 成功率(机群声明合并判据) | Gemini 3.7 Flash 80%(36% 机架成功率)、Robotics-ER 2 65% | GPT-5 20%、Claude Opus 5 0%、Qwen3.5-2B 5% | 单机成绩无法预测指挥成绩(Flash 65%→80%,Opus 5 35%→0%);小模型 58–70% 的 go 步把同一坐标复制给四个视角 |
局限与改进
作者承认的局限有三:全部结果来自 AirSim 仿真,真机未验证(虽然速度设定点即真实自动驾驶仪 offboard 模式接受的格式);分层指挥(指挥官+每机子智能体)只论证了可表达性、未做评测;样本量小——每格 20 个 episode,单格二项标准差约 9–13 个百分点,同层内相邻模型的排序不可过度解读。此外控制回路吞吐对结果敏感:主机负载减慢步进会显著拉低成功率(移动物目标尤其敏感,会在停滞的步里拉开距离),因此必须钉住每步服务速率。我自己的观察补充:$\delta=5$ m 的三维球形判据对大目标(如建筑)的合理性与表面判分的差异只靠 OSR 界定,未做敏感性分析;think 实现近乎空转(746 个开推理回复仅 3 个含散文,增益 +0.03 m/步),据此断言『物理智能体不需要深思』可能为时过早,更可能是思考预算/提示词设计不足;指挥设定只测接近一种任务且 $N$ 固定为 4,未见 $N$ 的扫描;深度全凭单目先验且无标定,模型间深度先验差异会混淆导航能力的比较。
独立分析的弱点
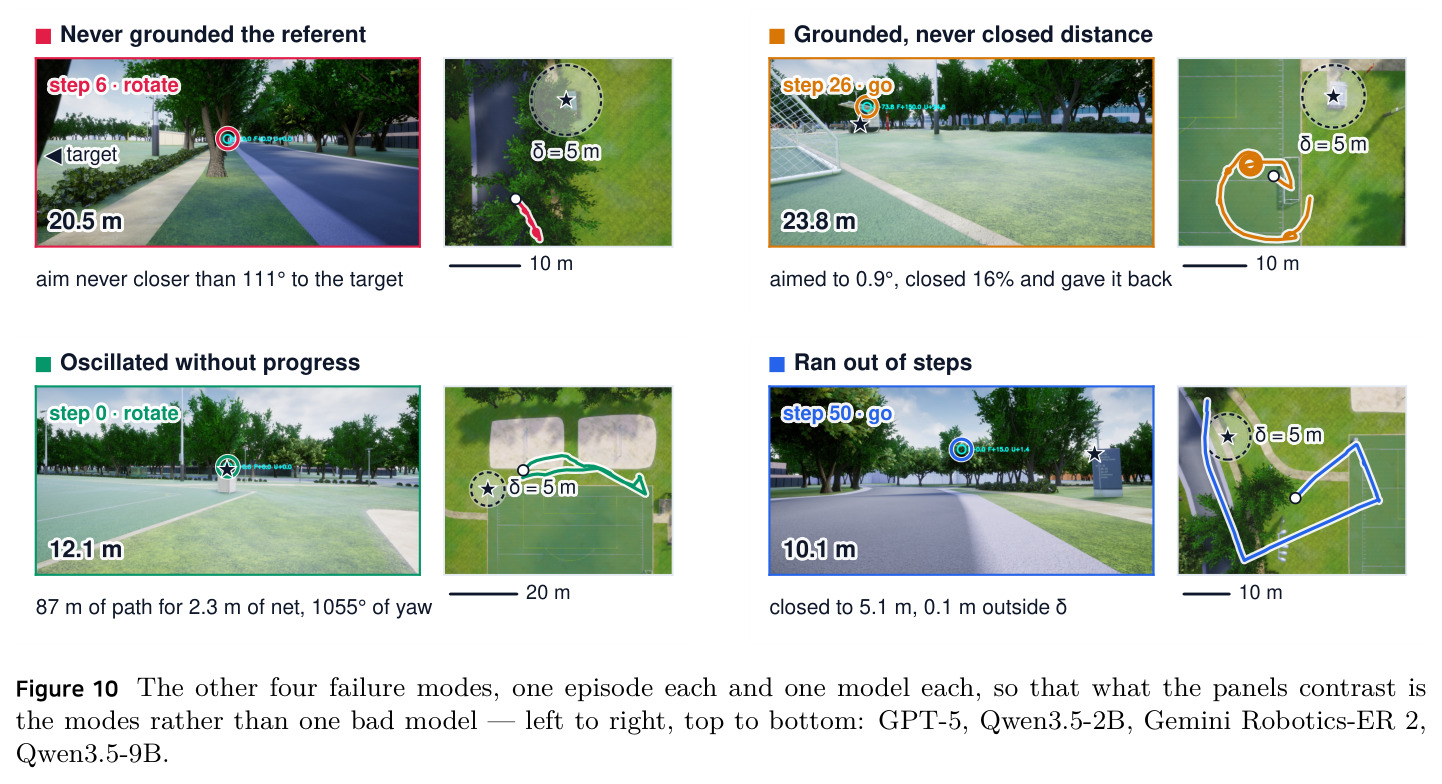
第一,统计功效不足:每格 20 个 episode、成功率步进 5 个百分点、二项噪声 9–13 点,使大量模型间对比失去显著性——改进方向是扩大 episode 池、报告置信区间或用分层贝叶斯估计共享跨格信息。第二,think 动作设计缺陷:扩展推理只在上一步是 think 时开启一轮,746 次中 3 次含推理散文、平均增益 +0.03 m/步、解卡率反低于普通步,说明『深思』没有给模型真正的推理空间——应给受控的思考预算并绘制延迟-收益曲线,而非暗示物理智能体不需要深思。第三,判据可能混淆格式错误与协议理解:无声明但轨迹进过 $\delta$ 的 61 例中,部分可能是 JSON/轴序解析失败而非模型不知道该声明——应报告每模型的格式错误率,把『声明差』分解为语法与语义两部分。第四,单目深度未标定:go 的步长全凭模型尺度先验,深度先验强弱的模型差异会与导航能力混叠——可加入传感器测深或报告每步位移误差分布。第五,指挥设定的 token/延迟成本未报告:四个视角塞进一个上下文对 2 Hz 预算的冲击是部署关键量;此外失败分类学靠人工标注,可自动化以支撑更大规模实验。
未来方向
作者明确提出三步:其一,把动作空间从提示词移进权重——在这些相同场景采集的 episode 上训练,检验四种能力中哪一种被恢复(直接针对『协议不遵从』这一主要失败模式);其二,上真机——智能体命令的速度设定点正是真实自动驾驶仪 offboard 模式接受的形式,同一回路可直接飞行,用测量而非争论回答仿真差距;其三,评测分层指挥——finished 使每架无人机能自报完成,指挥官+每机子智能体的层级从『下一件要设计的事』变成『下一件要评测的事』。基于成果还可延伸:把到达声明与不确定性校准结合,让模型学会拒绝提交没有把握的声明;针对速率抖动做鲁棒性设计(作者已观察到 2 Hz 与抖动速率下的表现差异);为物理智能体设计真正的测试时深思——何时值得为 token 付出世界移动的代价;把六类失败分类学做成自动诊断工具;扫描 $N=2,8$ 与异构机群,检验声明合并判据的可扩展性。
复现评估
复现条件中等偏友好。代码承诺开源在 github.com/naver-ai/DroneCATS;附录 A 给出逐字提示词、模型标识符/接入路径/解码设置、反投影规则、每步上限与速度、飞行控制器细节,算法 1 即完整判据,且判分是事后从声明日志与 2 Hz 位姿轨迹两份日志进行的——改 $\delta$ 无需重飞;Table 6 提供三次重复飞行的方差基准,可对照检查自己复现的噪声水平。门槛在环境与算力:需要 Unreal/AirSim 与两张自制地图(目标手工摆放并经验收检查:起始距离 12–48 m、相机路径无遮挡、指代无歧义);本地服务 2B/4B 需要 H100 级 GPU(Cosmos3-Edge-2B 32k 上下文占 10.5 GiB、每 30 token 0.44 s 约 2 Hz;Qwen3.5-4B 需 13.9 GiB),更大的 Qwen3.5 与四个前沿模型走 API、有费用且速率受服务商波动影响——而论文已证明吞吐敏感会污染结果,复现时必须钉住每步服务速率。一次完整跑分为 100 个 episode、每个最长 300 秒,方差审计需三倍于此。
论文图表