让置信度改变而非预测:面向后验校准的保预测修复(CORD) Let Confidence Change, Not the Prediction: Prediction-Preserving Repair for Post-hoc Calibration
CORD 在校准器拟合后修复概率向量,实现零预测改变的同时降低 ECE、NLL 和 Brier。
前置知识
置信度校准(Confidence Calibration)
模型报告的置信概率应与实际正确频率一致:报告置信度为 $p$ 的样本中约有 $p$ 比例预测正确。最常用的度量是期望校准误差 ECE:把样本按最大置信度分桶(本文用 15 个等宽桶),计算各桶内平均置信度与准确率之差的加权平均。现代神经网络普遍过度自信,因此需要在训练后校正。
本文的全部目标是在不改变 Top-1 预测的前提下改善这种置信度与频率的一致性,ECE 是核心评价指标之一。
后验校准(Post-hoc Calibration)与常见校准器
冻结已训练分类器的参数,只在其输出上拟合一个轻量映射。最简单的是 Temperature Scaling(TS):用单一正温度 $T$ 缩放 logits 后过 softmax;表达力更强的有 Vector/Matrix Scaling、Dirichlet 校准、一类一个保序回归(IROvA)等,它们统称本文的 Base 校准器。
CORD 的处理对象正是这些校准器输出的概率向量 $q$:它不改动任何拟合过程,只在输出之后做一次结构化修复。
Top-1 Prediction Change Rate(TPCR)
衡量校准前后 Top-1 预测被改变的总比例:$\mathrm{TPCR}=\frac{1}{N}\sum_i \mathbf{1}\{d_1(x_i)\neq d_0(x_i)\}$。准确率变化 $\Delta\mathrm{Acc}=(|C^+|-|C^-|)/N$ 只记录净效果,TPCR 统计全部改变,包括错误类之间的切换 $C^0$。
论文用 TPCR 揭示被准确率指标掩盖的预测漂移,并把「TPCR 归零」设为 CORD 必须构造性满足的核心指标。
KL 散度与伯努利 KL 散度
$D_{KL}(q\|u)=\sum_j q_j\log(q_j/u_j)$ 度量分布差异。本文的关键工具是链式分解 $D_{KL}(q\|u)=d_B(b\|s)+(1-b)D_{KL}(\alpha\|\alpha^u)$,其中 $d_B(r\|s)$ 是二元分布间的 KL 散度。
该分解是 CORD 推导的核心:固定剩余类条件分布后,整个修复问题简化为对一个标量 $s$ 的伯努利 KL 拟合。
严格评分规则(NLL 与 Brier)
严格评分规则在真实分布处取得最优期望值,因此能评估完整概率报告的质量。NLL 是观测类概率的负对数 $-\log\hat p_y$;多分类 Brier 分数是预测向量与 one-hot 标签的平方误差。与只看最大置信度的 ECE 相比,它们对整个分布的改动更敏感。
CORD 声称改善的是完整概率报告而不仅是置信度,NLL/Brier 的成对下降是支撑这一声明(超越 ECE)的关键证据。
带等式约束的凸优化与拉格朗日乘子
对可分严格凸目标 $\sum_i f_i(s_i)$ 同时施加区间约束 $s_i\in I_i$ 和均值等式约束时,KKT 条件表明每个变量的解由同一共享乘子 $\eta$ 经区间裁剪响应 $\psi(\eta;g_i,I_i)$ 给出,$\eta$ 可用二分法求得。
这解释了 CORD 如何用单个标量 $\eta^\star$(仅 8 字节)协调全部 $n$ 个修复,并实现在校准集上保留平均质量的目标。
研究动机
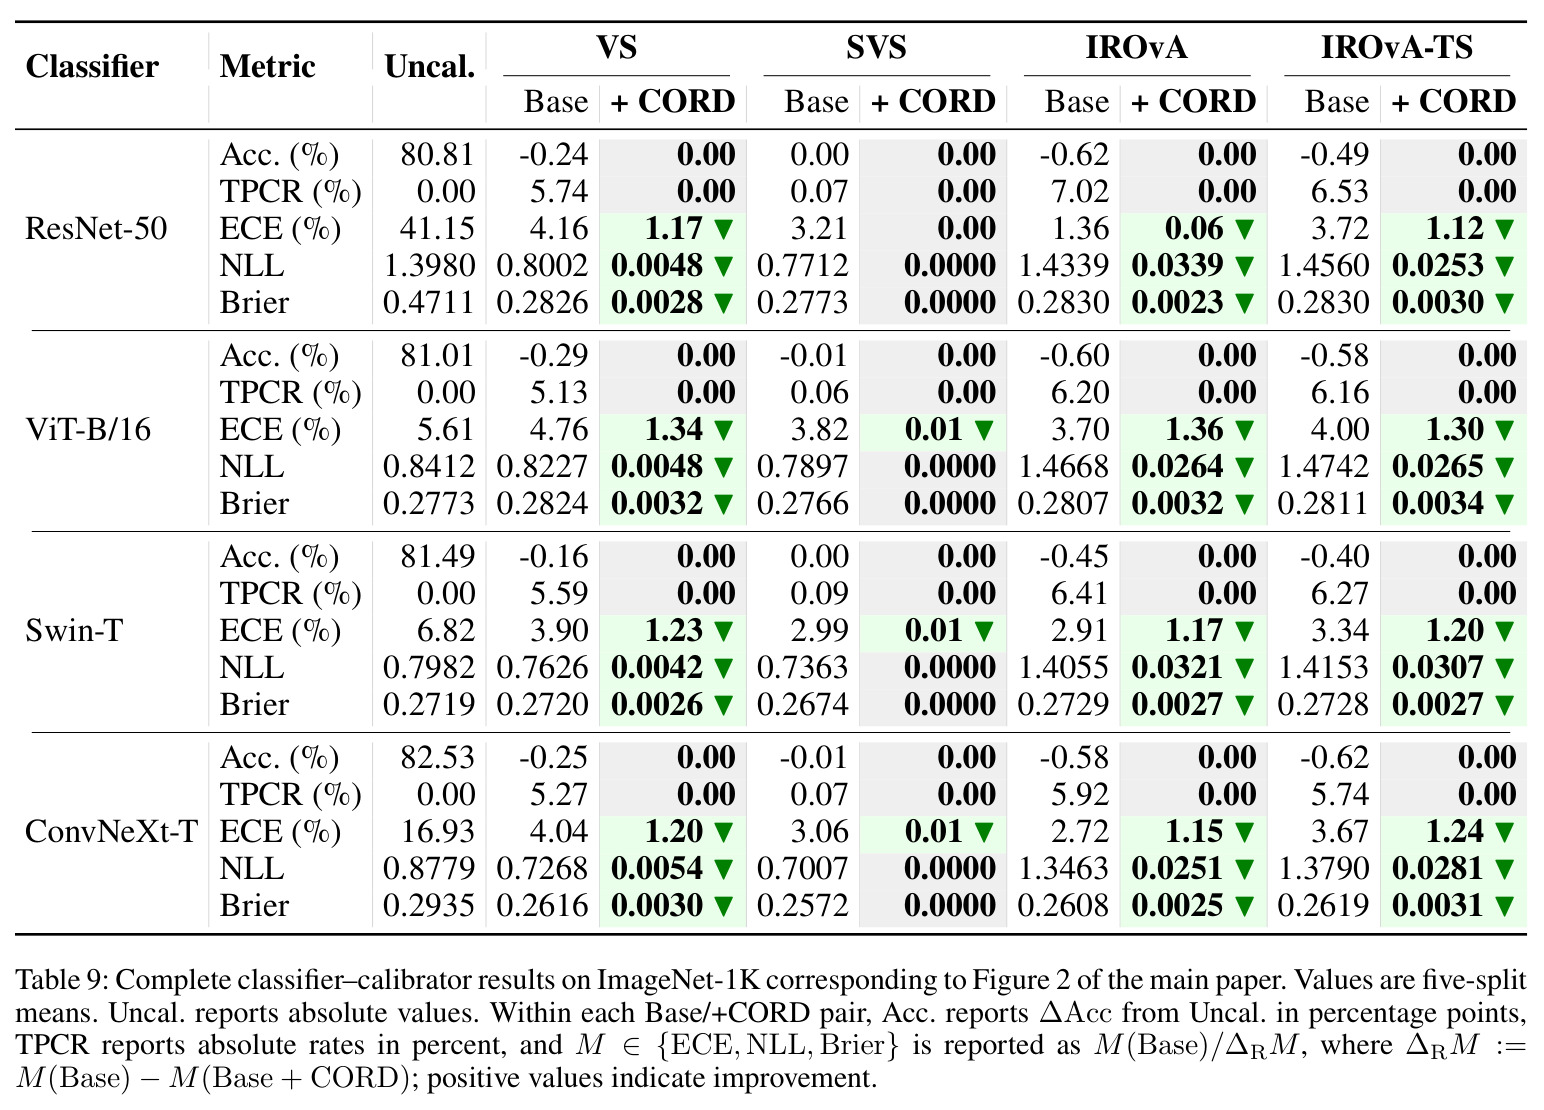
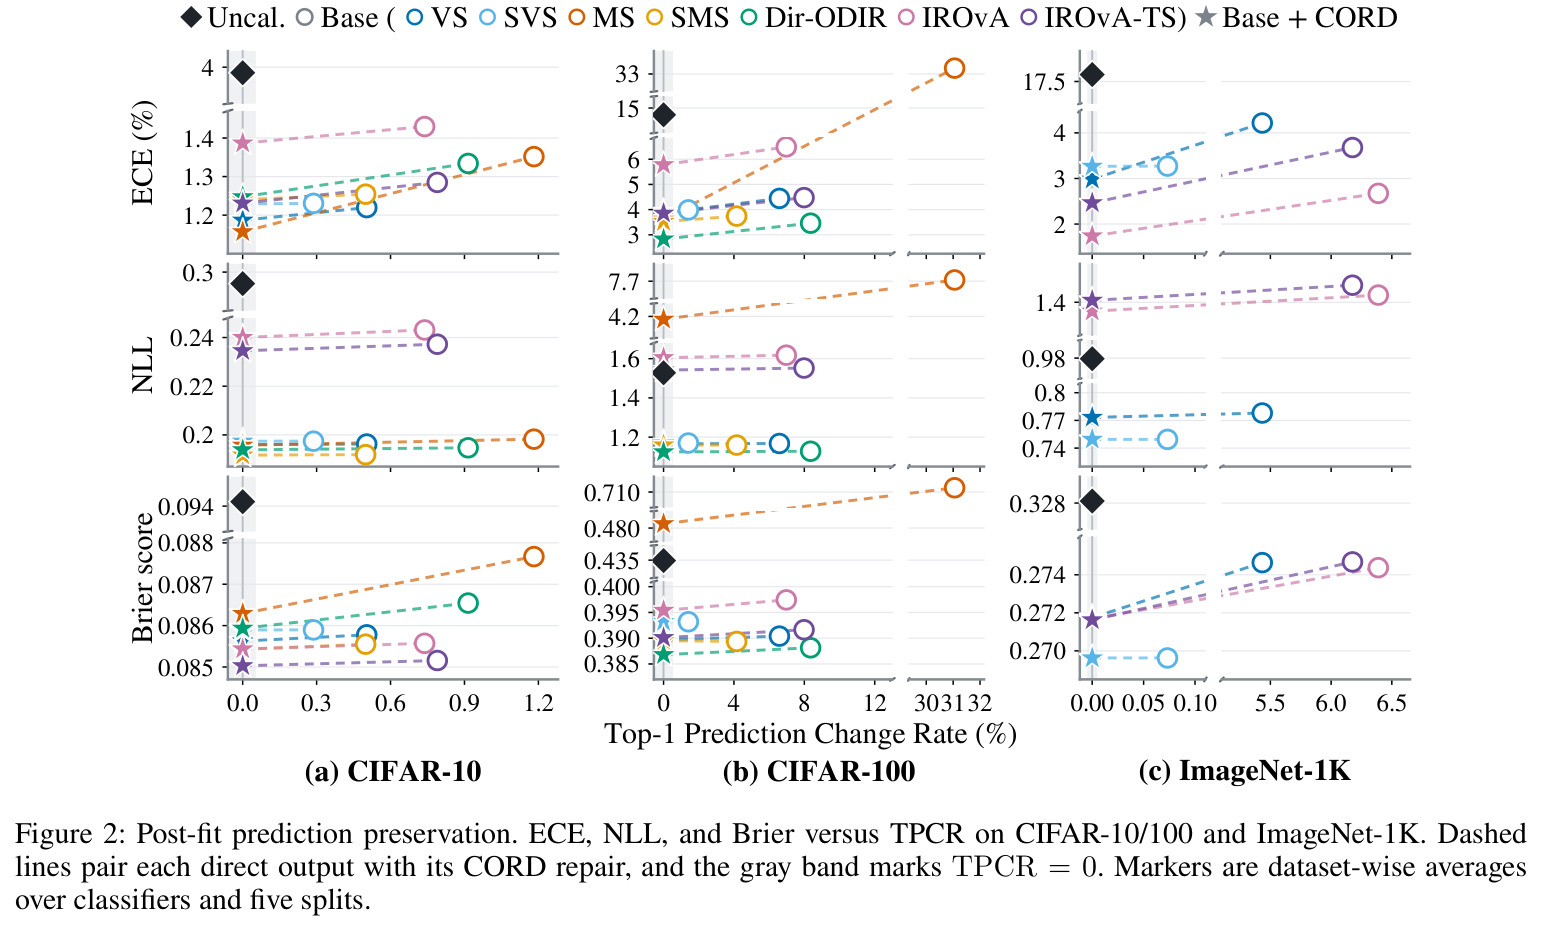
多分类后验校准在修正置信度的同时可能悄悄改变 Top-1 预测本身,而准确率只反映这种改变的净效果。论文的开篇实验很直观:对 ImageNet-1K 上预训练的 ResNet-50 施加 Vector Scaling(VS),Top-1 准确率仅变化 −0.24 个百分点,却有 5.74% 的样本预测被改变,其中变对 $C^+$ 占 1.78%、变错 $C^-$ 占 2.02%、从一个错误类换成另一个错误类 $C^0$ 占 1.94%——$C^0$ 部分对准确率完全不可见。在 114 个数据集–分类器–校准器条件中,直接输出的 TPCR 跨度达 0.07%–31.05%,准确率变化介于 −10.06 到 +0.22 个百分点之间;极端例子是 Matrix Scaling(MS)作用在 CIFAR-100 的 ShuffleNetV2 上,TPCR 高达 40.51%、准确率下降 13.16 个百分点。若想在拟合阶段就避免这种漂移,就得像 Mix-n-Match 指出的那样,以牺牲校准映射的表达力为代价换取预测保持。
本文的目标是本文的目标是把「保持原始 Top-1 预测」这一约束从校准器拟合阶段移到拟合之后:允许任意表达力强的校准器(Base)不加保留约束地正常拟合,然后由一个轻量的拟合后适配器 CORD 修复其输出的完整概率向量,使修复向量的 argmax 精确恢复原始分类器的预测。适配器需满足四条设计需求:只使用原始输出与校准输出(R1)、不拟合任何额外的有监督预测映射(R2)、不引入用户或验证集调节的超参数(R3)、预测保持成为修复向量本身的性质(R4)。同时希望修复输出在 ECE、NLL、Brier 上平均优于直接输出,并在分布偏移与 10%–100% 校准集规模下保持收益,最终形成「一个校准器、两份共存报告(直接输出 + 修复输出)」的部署模式,由用户按场景选择。
与已有工作不同的是,已有方法分两类:一类在拟合时内置预测/保序约束(TS、IRM、IOP、PTS、AdaTS、MCCT-I、分割中的保序仿射校准),代价是缩小可行校准映射族、损失表达力;另一类(top-label 校准、TvA、STS)在拟合阶段就把置信度绑定到预先选定的类别上。此前没有任何方法在拟合完成后、对完整概率向量实施精确的逐点预测保持——这正是 CORD 的切入角度。它把修复重述为一维问题:固定剩余类之间的条件分布后,唯一自由度是分给原始类的质量 $s$;再在校准集层面用单个共享标量 $\eta^\star$ 协调所有输入的 $s_i$,以保留校准输出赋予原始预测的平均质量。由此,「表达力」与「保预测」的历史性权衡被解耦:前者完全留在拟合阶段,后者变成一次确定性的输出后处理。
核心方法
直觉上,一旦决定保持原始 Top-1 预测类别 $a$,剩下的问题只是:把多少概率质量 $s$ 放回类别 $a$?其余类之间的相对分配照抄校准输出 $q$ 即可。技术路线分四步:(1) 对每个输入,从 $q$ 提取原始类质量 $b=q_a$ 与剩余类的归一化条件分布 $\alpha$($\alpha_a=0$,$\alpha_j=q_j/(1-b)$);(2) 证明重构 $\hat p(s)=s\,e_a+(1-s)\alpha$ 是单纯形切片 $\{u: u_a=s\}$ 上唯一最小化 $D_{KL}(q\|u)$ 的向量,而预测保持等价于区间约束 $s\ge\rho/(1+\rho)$($\rho=\max_{j\ne a}\alpha_j$);(3) 为每个输入定义局部参考 $g$(校准 argmax 未变时为 $b$,需修复时为 $b$ 与 $p^0_a$ 的均值),用伯努利 KL 散度 $d_B(g\|s)$ 度量偏离代价;(4) 在校准集上求解带平均质量约束的可分严格凸问题,得到唯一共享乘子 $\eta^\star$;对新输入只需计算 $s=\psi(\eta^\star;g,I)$ 并重构,单样本代价 $O(K)$。
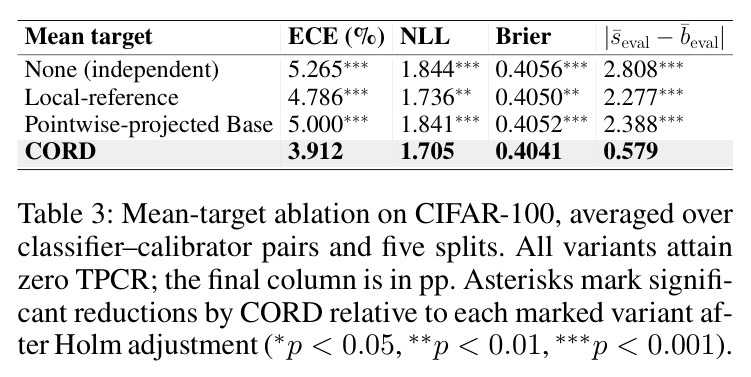
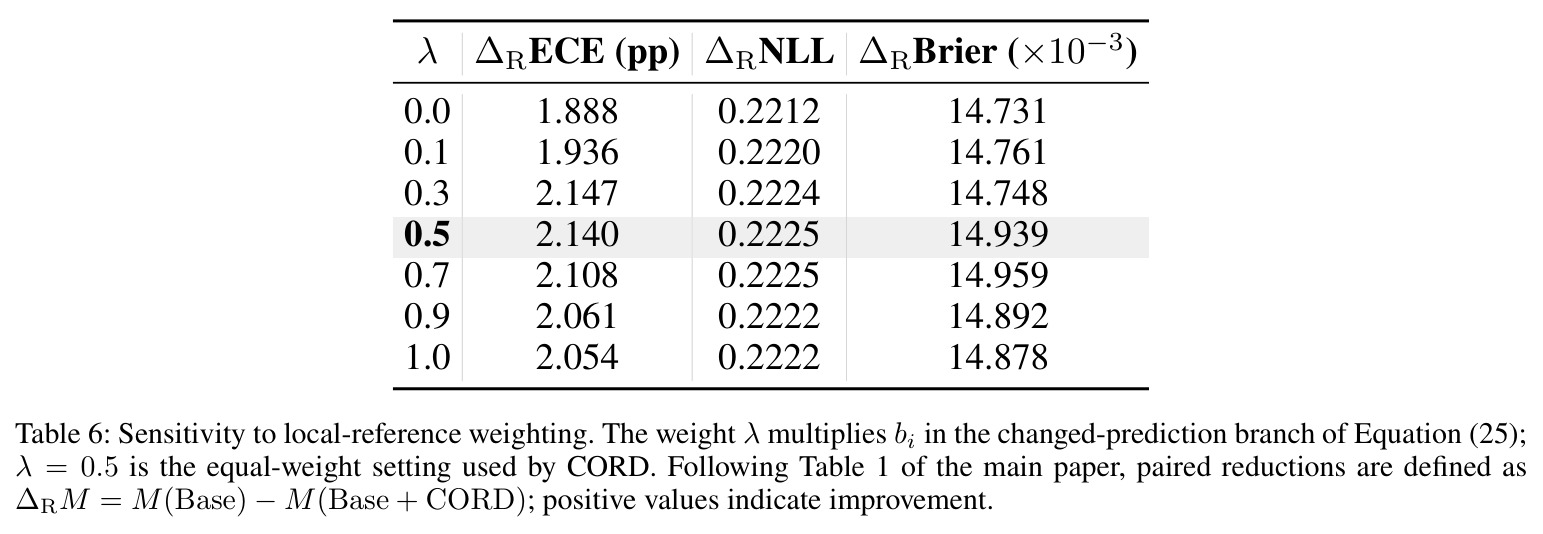
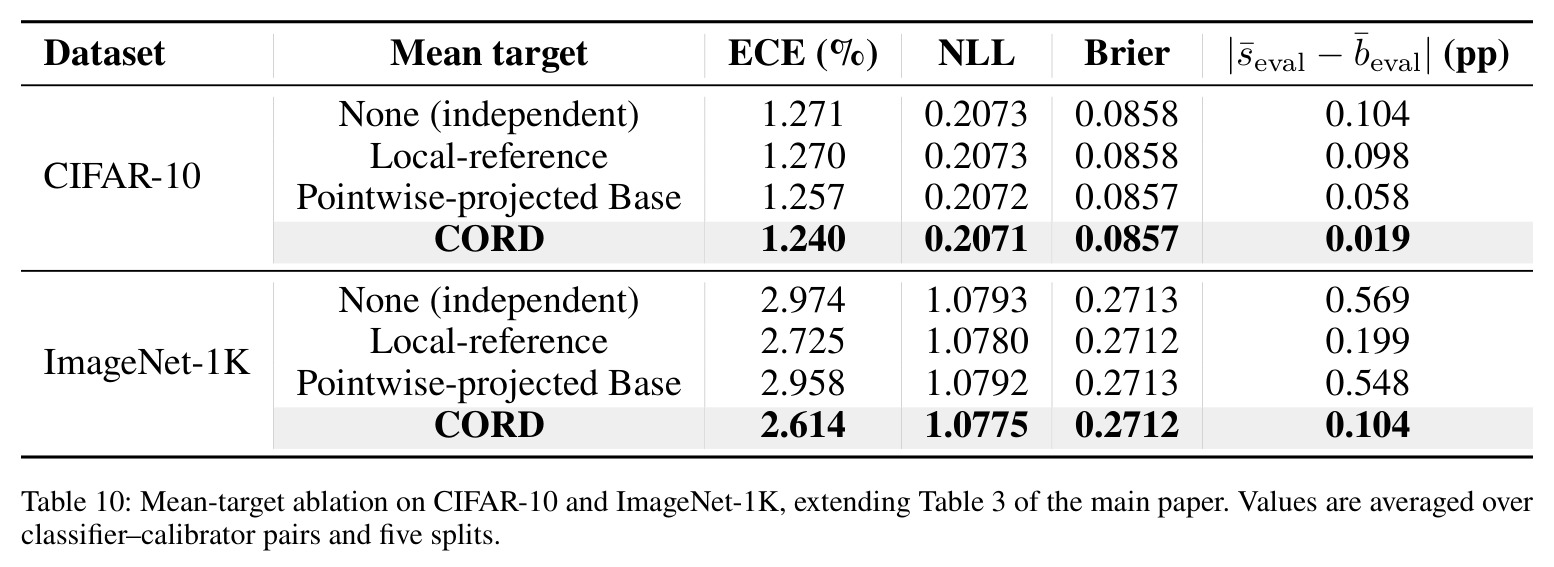
核心创新是 KL 链式分解带来的「一维化」与两级协调。对任何把质量 $s$ 分给 $a$ 的候选向量 $u$,有 $D_{KL}(q\|u)=d_B(b\|s)+(1-b)\,D_{KL}(\alpha\|\alpha^u)$;一旦继承 $\alpha$,第二项为零,修复被严格限制为只改变「原始类 vs 其余类」的质量切分,剩余类之间的相对分布与校准器完全一致:$\hat p_j/(1-\hat p_a)=q_j/(1-q_a)$。这是与已有方法的本质区别:拟合时保序方法约束的是校准映射本身,TvA 类方法在拟合时绑定类别,而 CORD 完全不动校准器,只对其输出做一次可证明的结构化改写。局部参考的取法也很巧妙:需修复时取 $g=(b+p^0_a)/2$,源于对 $b$ 与 $p^0_a$ 的 Bernoulli-KL 偏离等权处理后目标的对称性,附录证明对权重 $\lambda\in[0.3,0.9]$ 稳健。跨输入层面,CORD 把 Base 的平均质量 $\bar b$ 经区间投影得到继承可行均值 $\mu$,用单一 $\eta^\star$ 协调全部修复,消融显示该设计在 held-out 数据上也最贴近 Base 的平均质量。
方法步骤详情
完整流程见 Algorithm 1,输入为校准集输出对 $\{(p^0_i,q_i)\}$。第一步(构造单点量):对每个 $i$ 计算 $a_i=\arg\max_j p^0_{ij}$、$b_i=q_{i,a_i}$、条件分布 $\alpha_i$,由 $\rho_i=\max_{j\ne a_i}\alpha_{ij}$ 得可行区间 $I_i=[\rho_i/(1+\rho_i)+\epsilon_{num},\,1-\epsilon_{num}]$,并取局部参考 $g_i$(校准 argmax 未变时为 $b_i$,否则为 $(b_i+p^0_{i,a_i})/2$)。第二步(均值目标):把 $\bar b$ 投影到可行均值区间得到 $\mu$。第三步(共享标量):解方程 $n^{-1}\sum_i\psi_i(\eta)=\mu$,响应 $\psi$ 由闭式解经区间裁剪得到、关于 $\eta$ 连续非降,用防平台二分法求解,平台处按「离零最近」规则取唯一 $\eta^\star$。第四步(应用):对新输入重复单点量计算,取 $s=\psi(\eta^\star;g,I)$,输出 $\hat p=s\,e_a+(1-s)\alpha$;持久状态仅 $\eta^\star$(8 字节),每次修复 $O(K)$。命题 1 保证:输出在单纯形上、$a$ 唯一居首、条件分布逐点保持、校准集上 $n^{-1}\sum_i s_i^\star=\mu$。
技术新颖性
新颖性有四个层面。问题层面:首次提出并量化 TPCR,指出准确率变化只是 $C^+$ 与 $C^-$ 的净值、完全看不见错误类之间的切换 $C^0$,从而暴露「置信度校准好了、但它所描述的预测已被调包」这一被掩盖的盲区。定位层面:首创拟合后(post-fit)精确预测保持的适配器类别——与 TS/IRM/IROvA/MCCT-I 等拟合时保序方法不同,CORD 不缩小可行校准映射族、不牺牲表达力;与 aTDE 的聚合阶段投影不同,CORD 给出逐点精确保持;与 TvA/STS 等绑定类别的校准不同,CORD 修复的是完整概率向量。理论层面:KL 分解刻画修复族、区间约束保证唯一居首、严格凸性与 KKT 分析保证解存在且唯一、最近零乘子规则唯一化新输入上的修复规则,并刻画了退化为恒等映射的充要条件(所有 $b_i\in I_i$ 时 $\eta^\star=0$,此时对新输入返回 $q$ 当且仅当 $b\in I$)。工程层面:零超参数、8 字节常量状态、$O(K)$ 单样本修复、单线程 CPU 亚秒级构造,是可即插即用的轻量组件。
实验结果
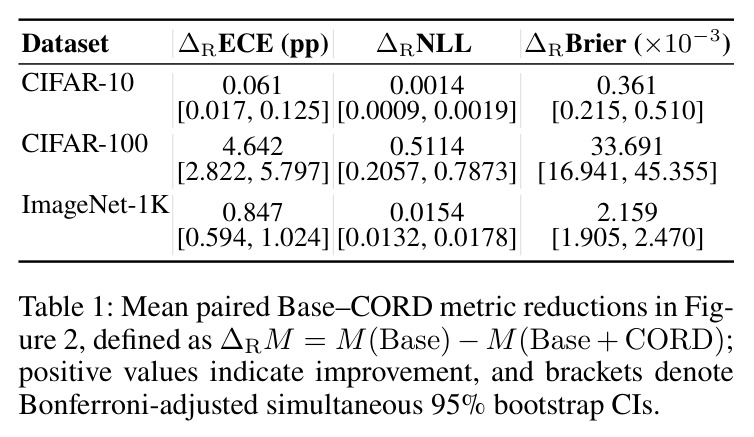
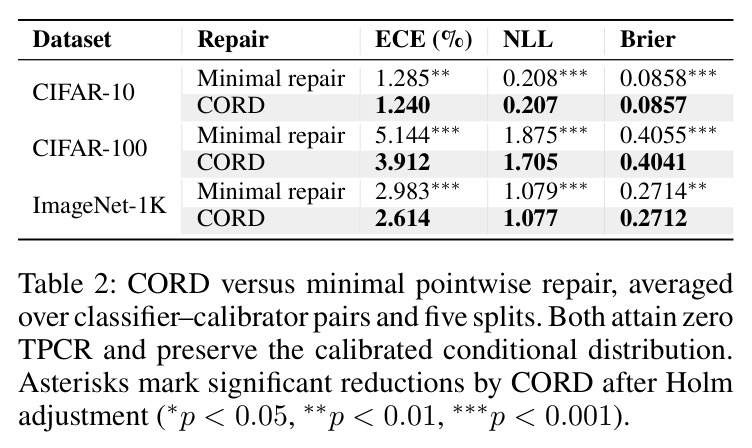
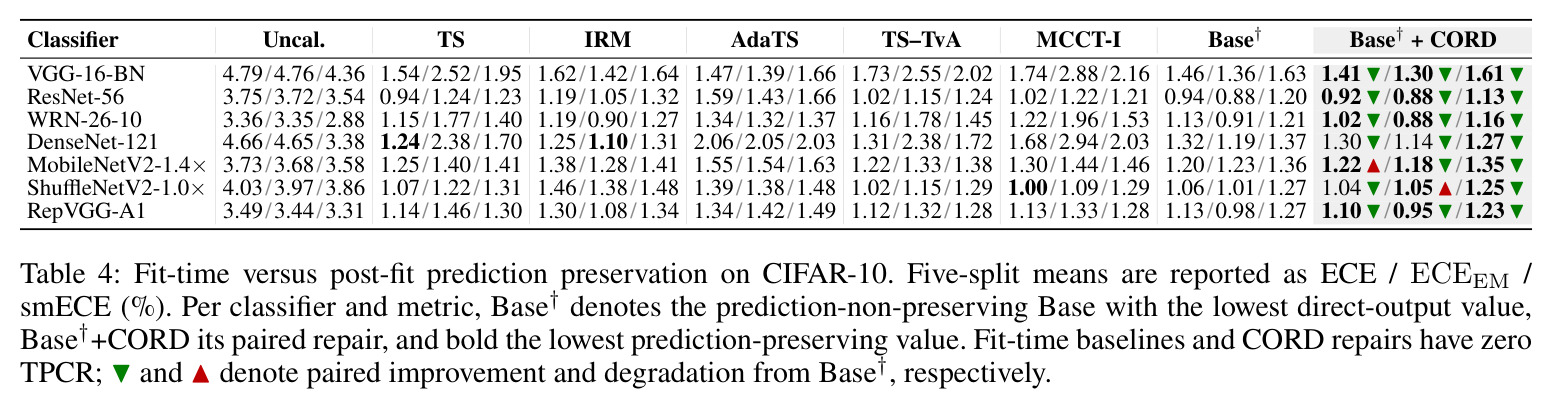
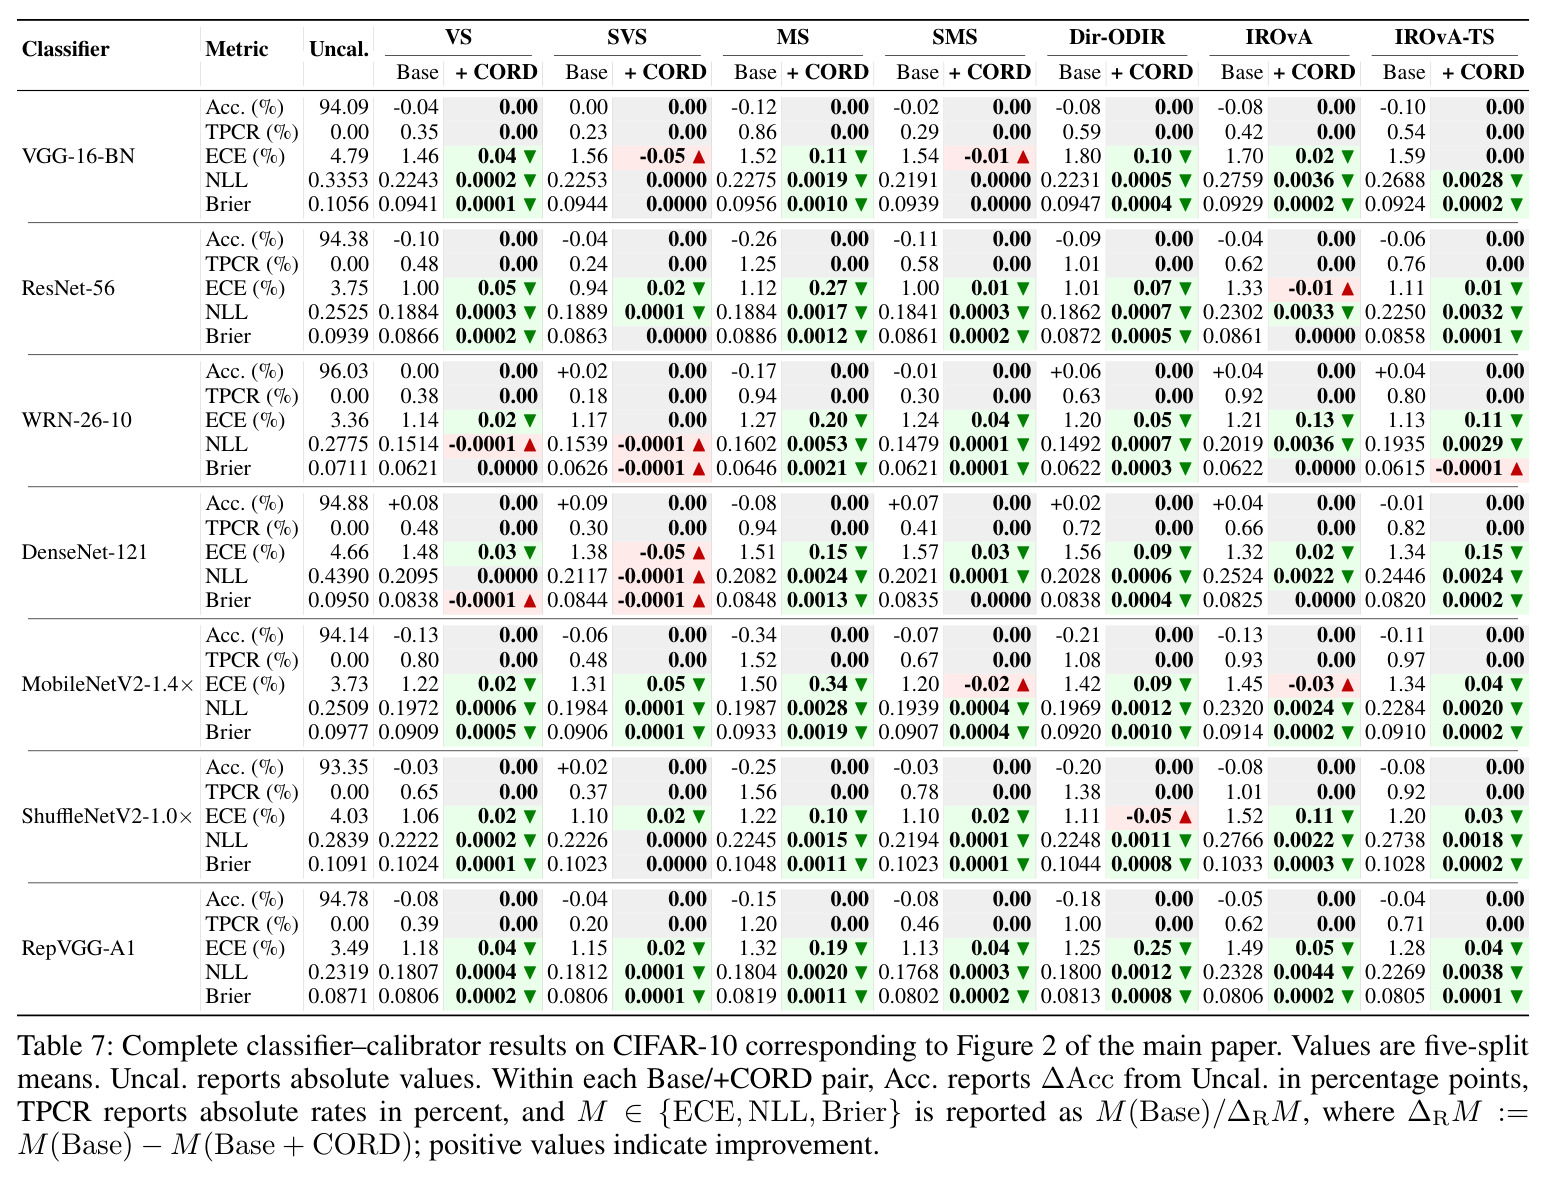
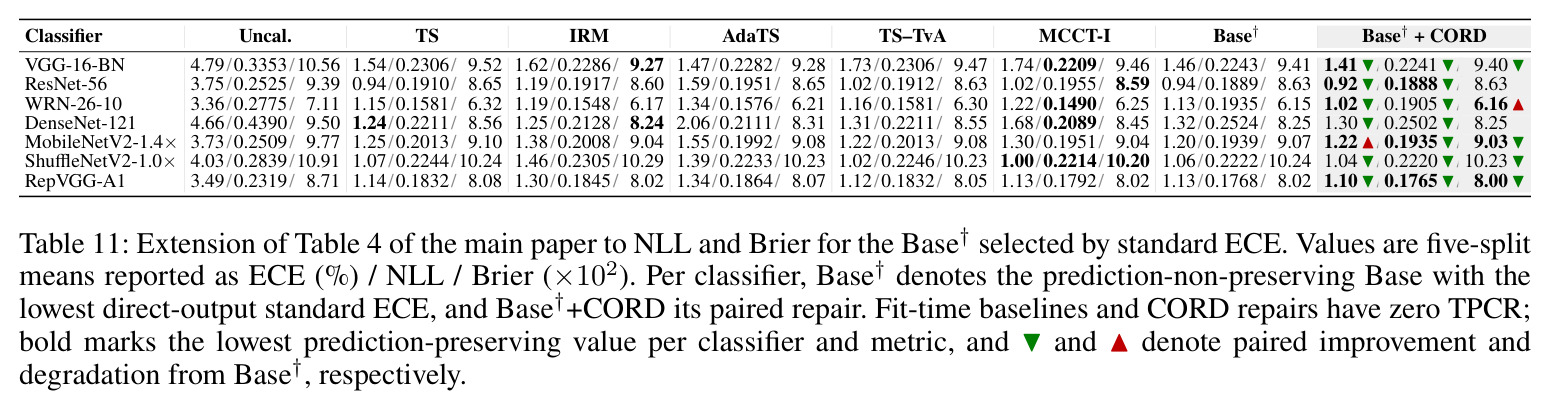
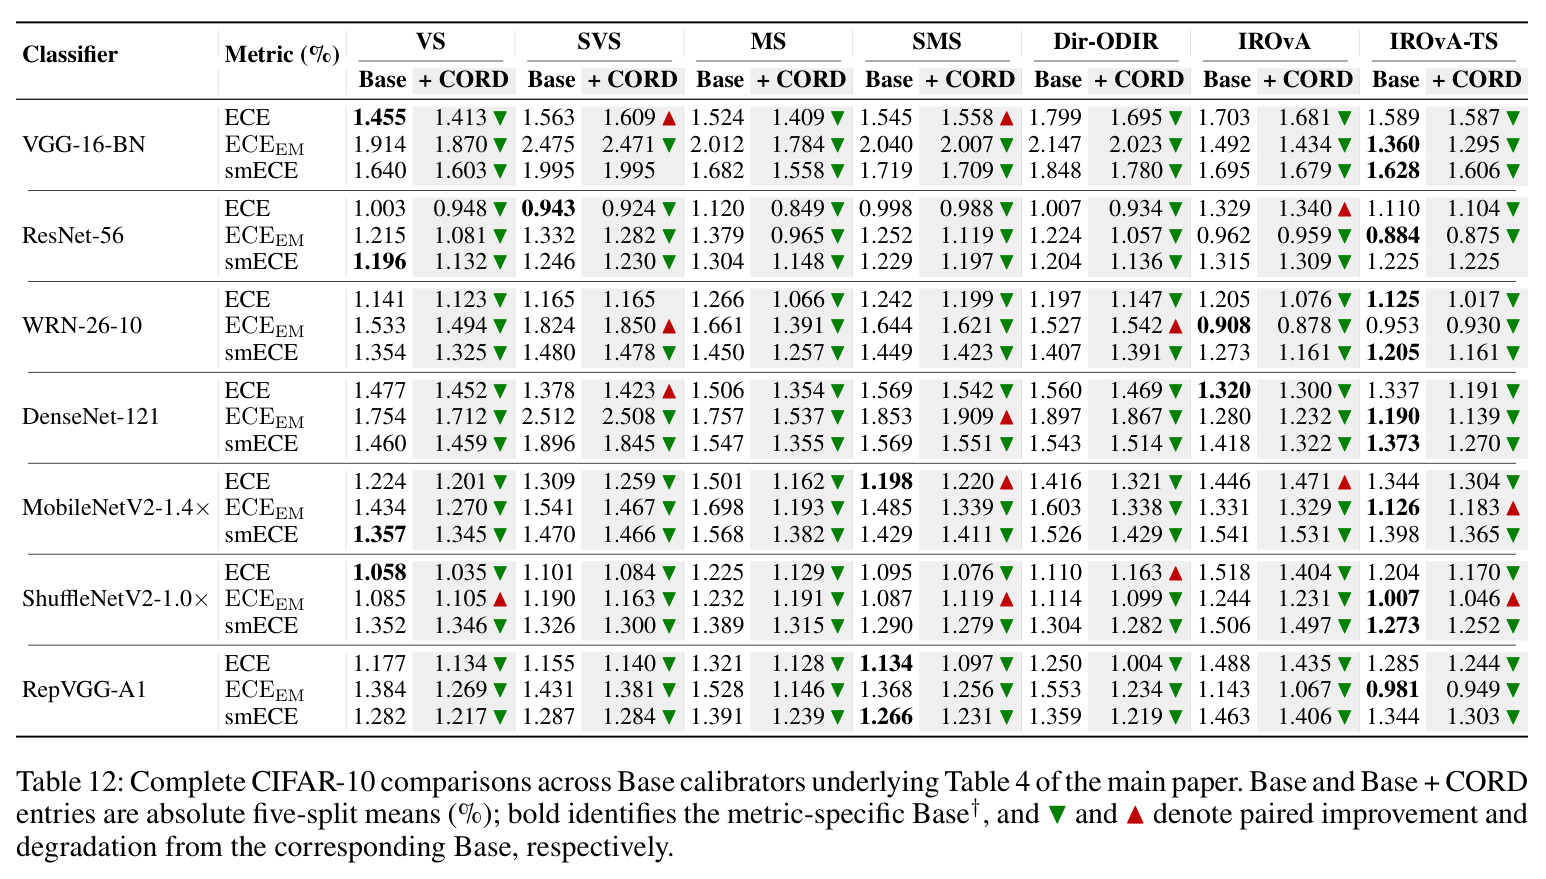
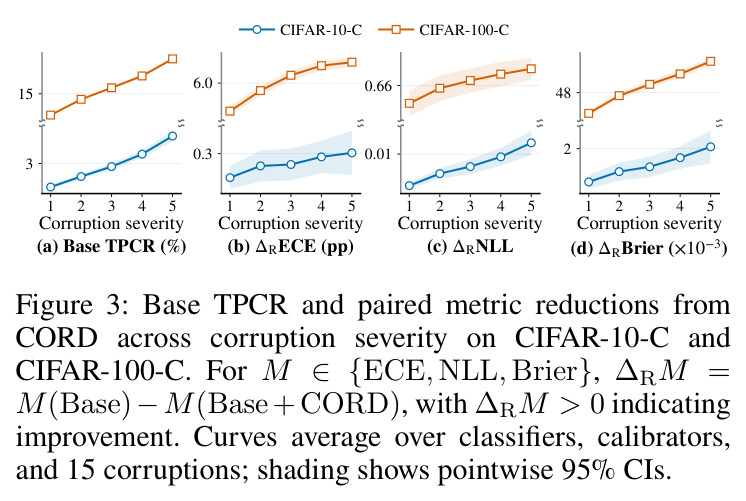
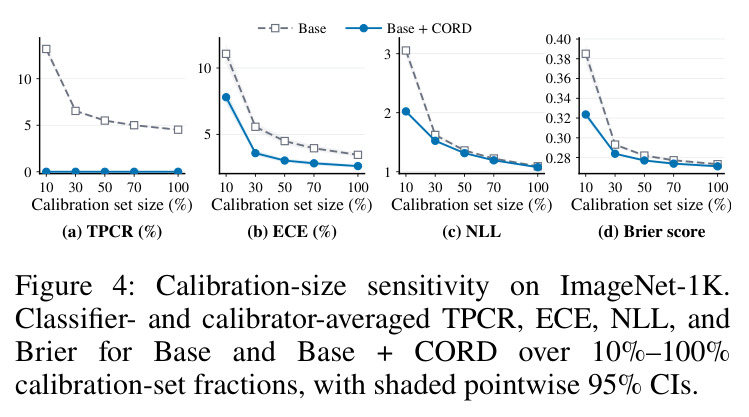
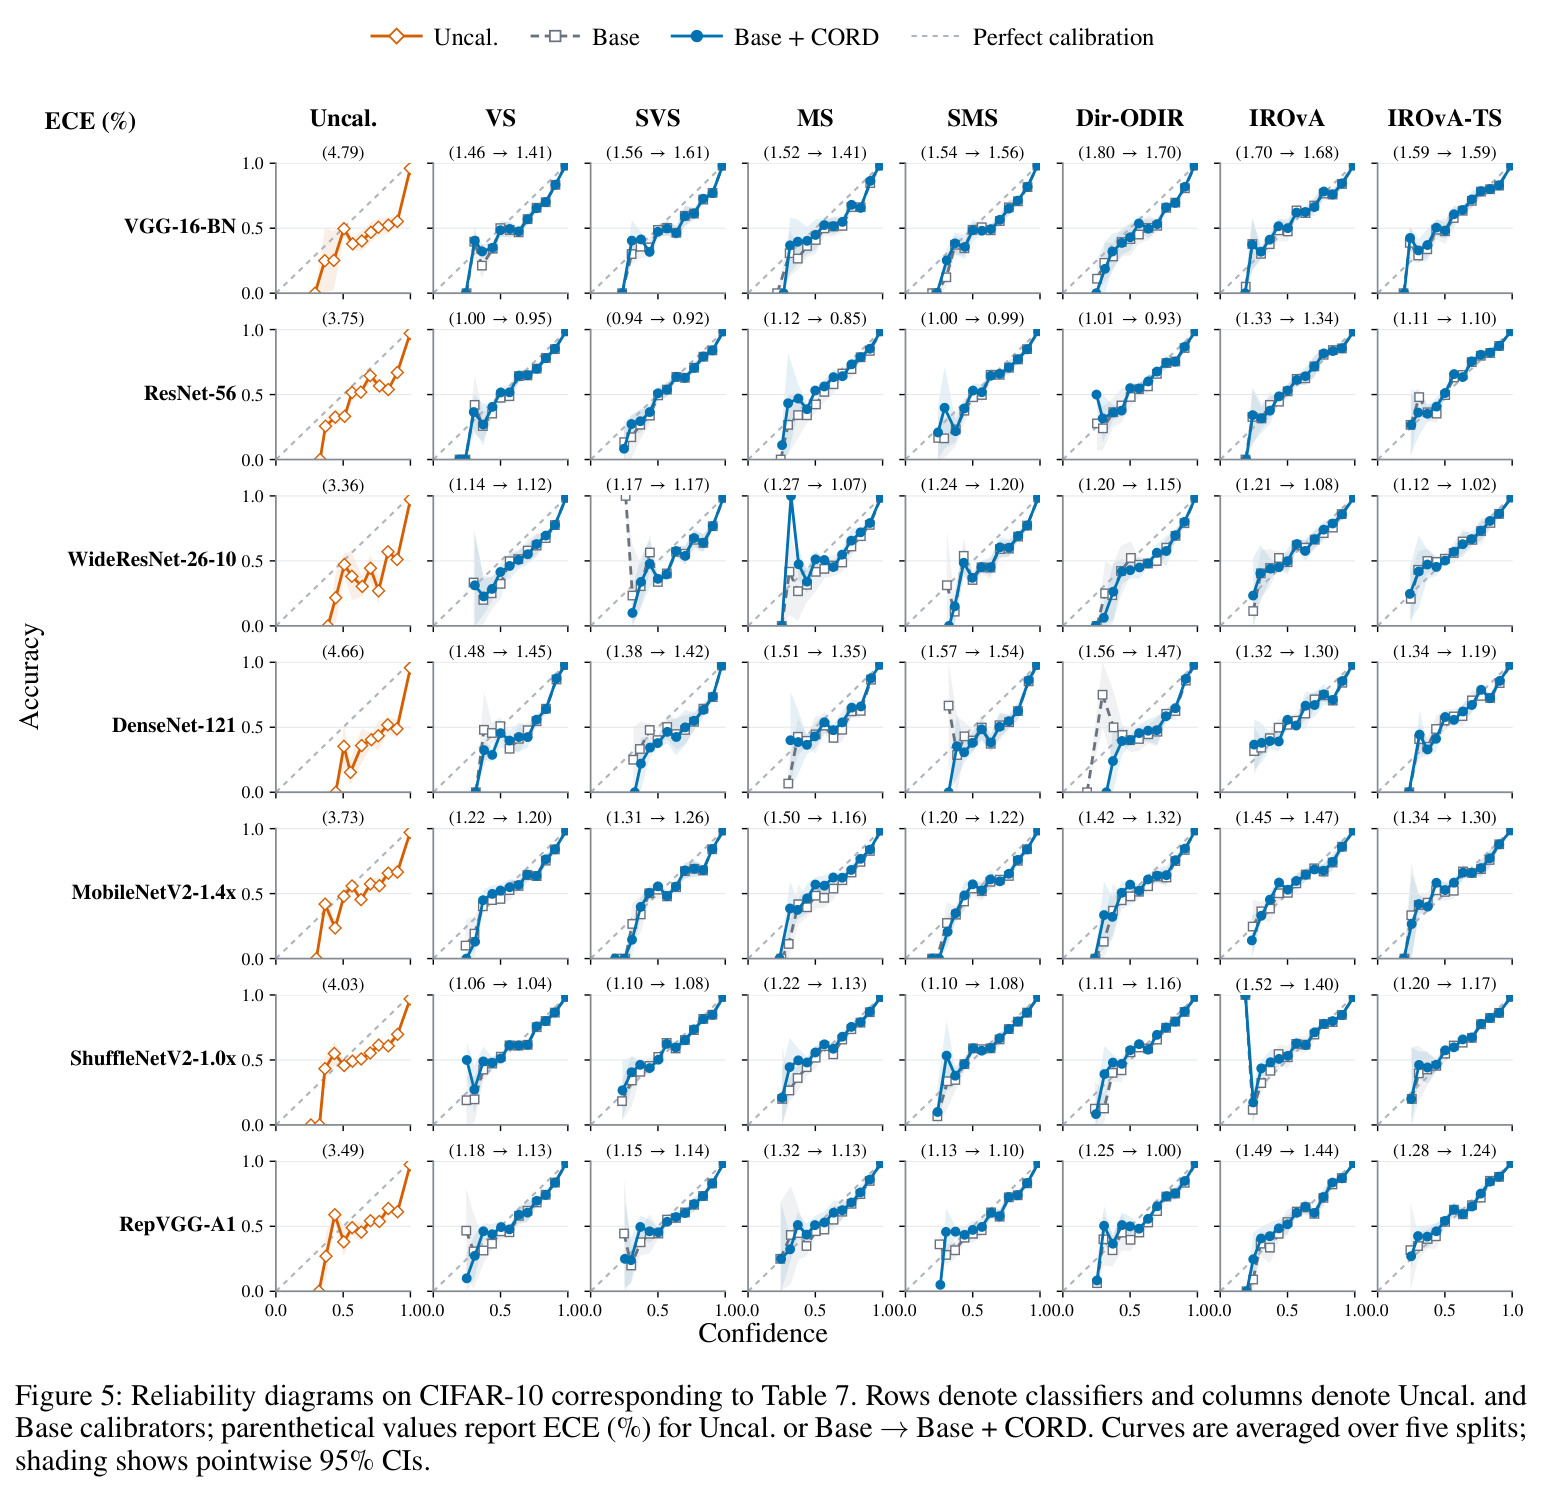
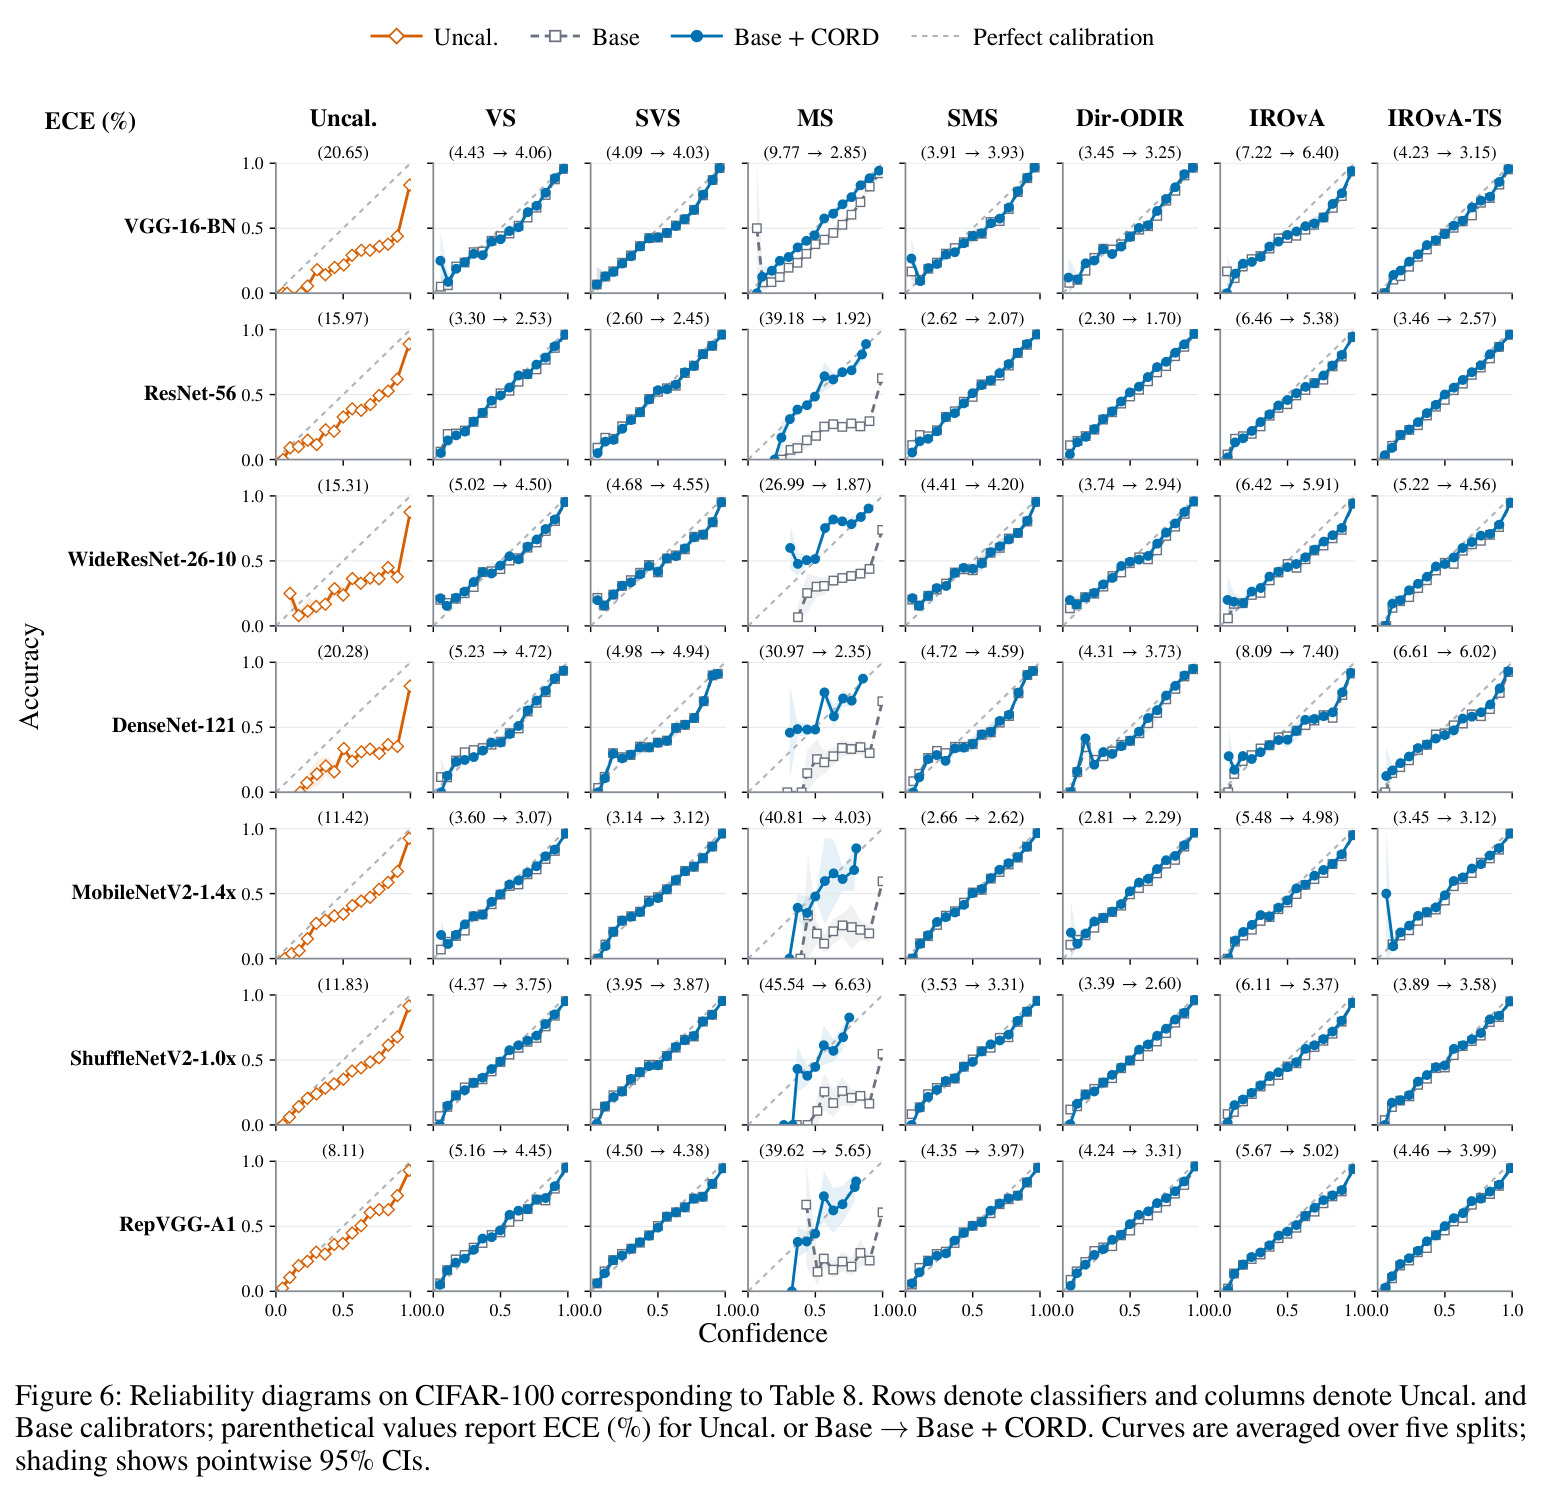
评估覆盖 CIFAR-10/100 与 ImageNet-1K 共 11 个分类器、7 个校准器、114 个条件、5 个划分。(1) 保持性:所有配对上 CORD 的 TPCR 均为 0,完全恢复原始准确率。(2) 质量:成对平均改善全部显著——CIFAR-10 上 ECE/NLL/Brier 分别降 0.061pp、0.0014、0.361×10⁻³;CIFAR-100 上降 4.642pp、0.5114、33.691×10⁻³;ImageNet 上降 0.847pp、0.0154、2.159×10⁻³,所有同时 95% bootstrap 置信区间为正,且收益随 Base 的 TPCR(0.07%–31.05%)增大而放大。(3) 消融:相对最小逐点修复,CORD 在 CIFAR-100 把 ECE 从 5.144 降到 3.912;均值目标消融中 CORD 在 held-out 上最贴近 Base 平均质量(0.579pp vs 2.808pp)。(4) 分布偏移:干净数据拟合、CIFAR-C 直接评估,Base 的 TPCR 随腐蚀强度 1→5 从 1.65% 升至 4.58%(C10-C)、12.75% 升至 18.70%(C100-C),CORD 恒为零且各强度下均改善。(5) 校准规模与对比:ImageNet 10%–100% 下小数据收益最大;与拟合时保序基线(TS/IRM/AdaTS 等)相比,Base† 直接输出 ECE 常更低(VGG-16-BN 1.46 vs 1.54/1.47),加 CORD 降至 1.41 且零 TPCR,ECE_EM 与 smECE 下结论一致。
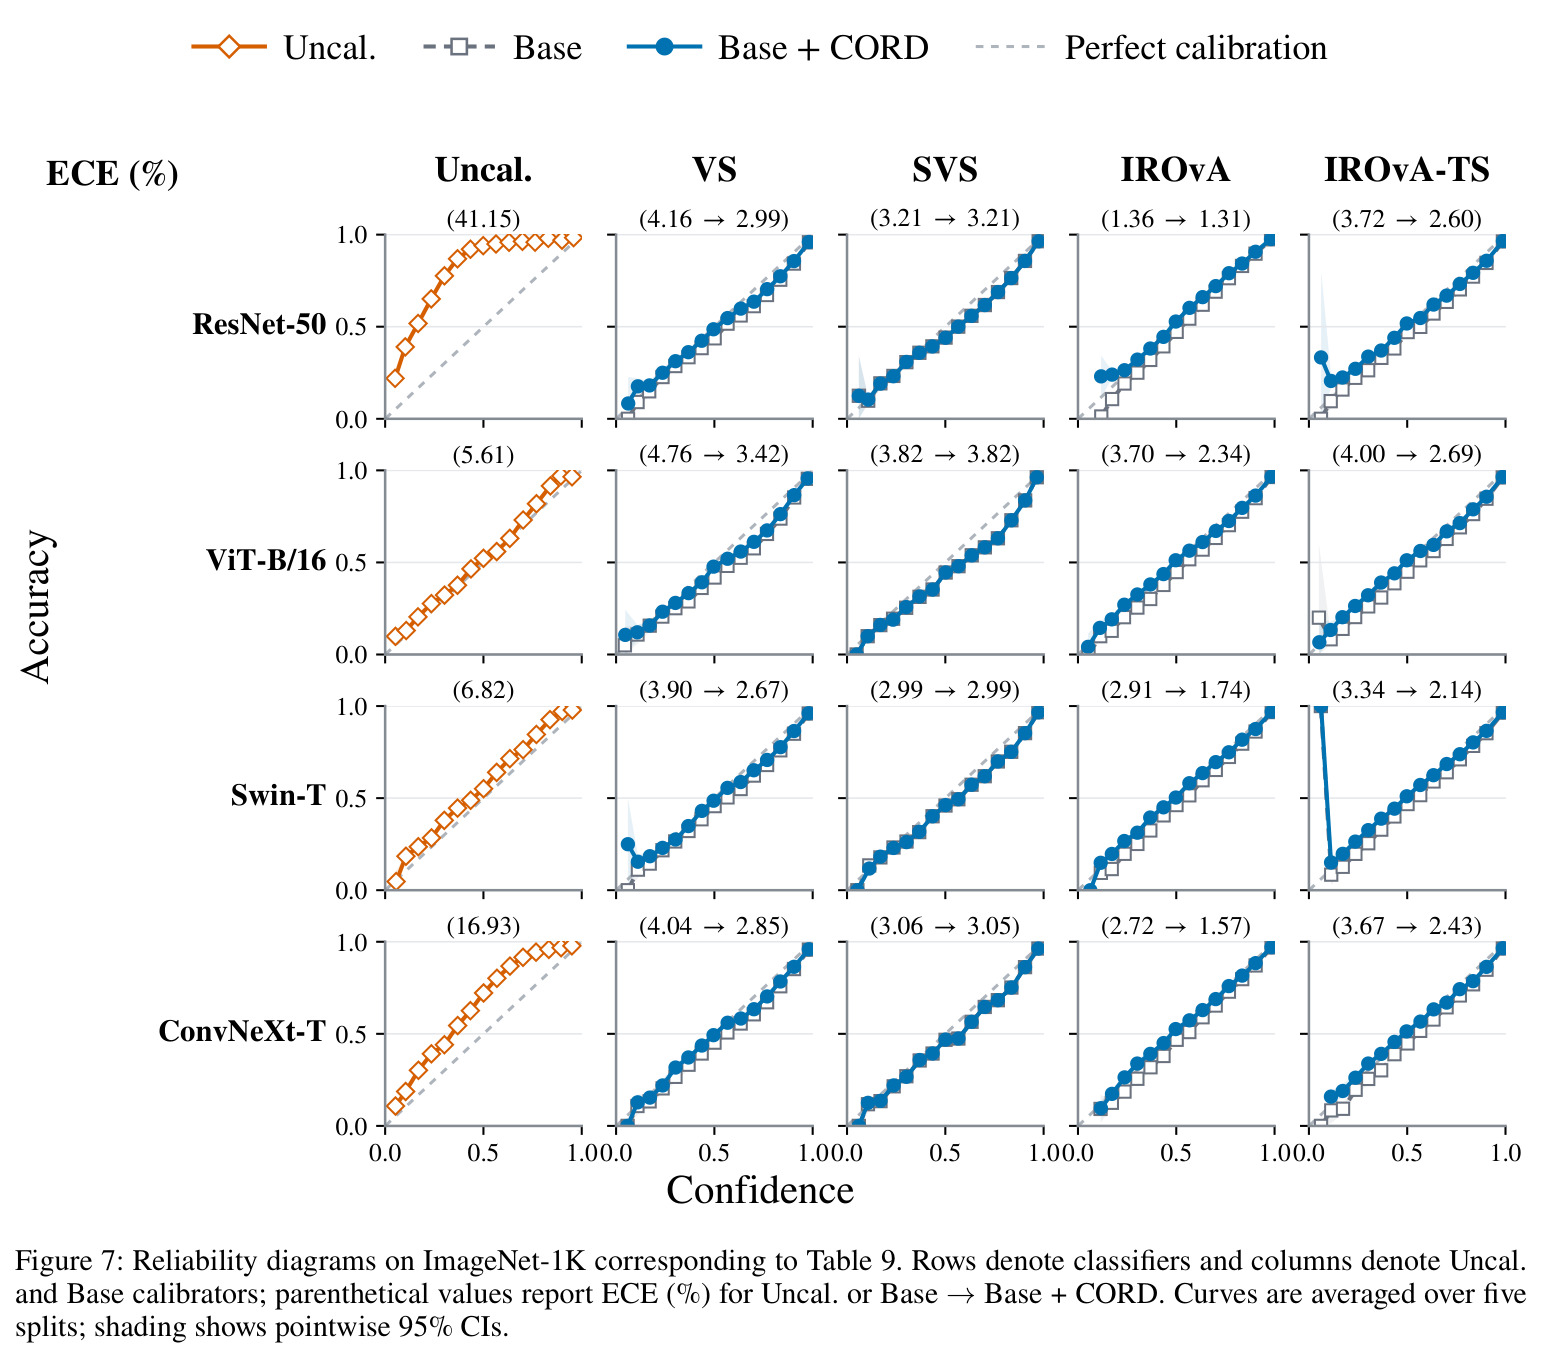
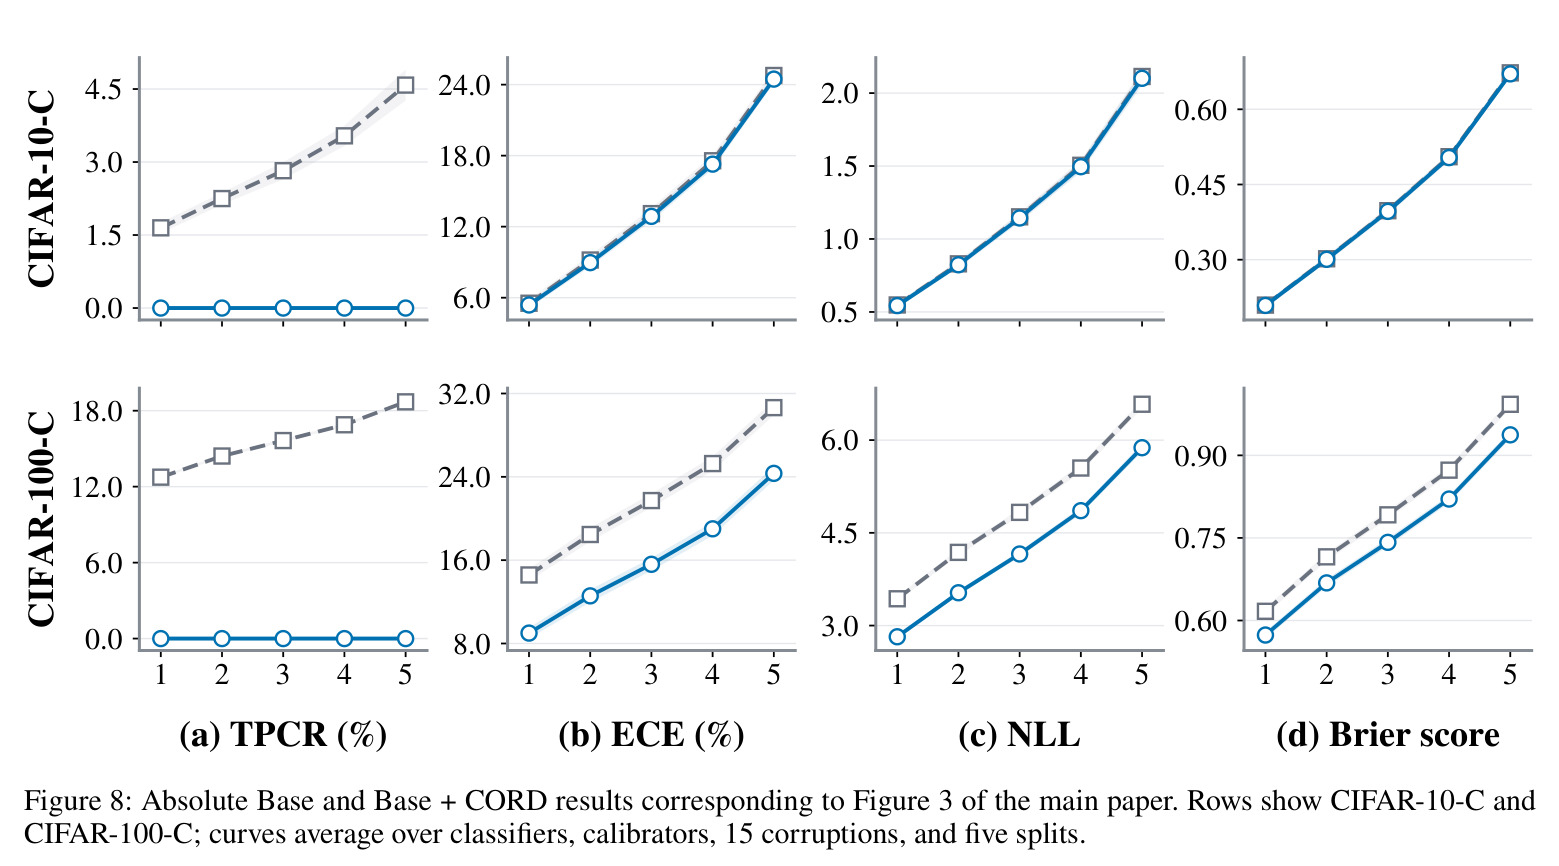
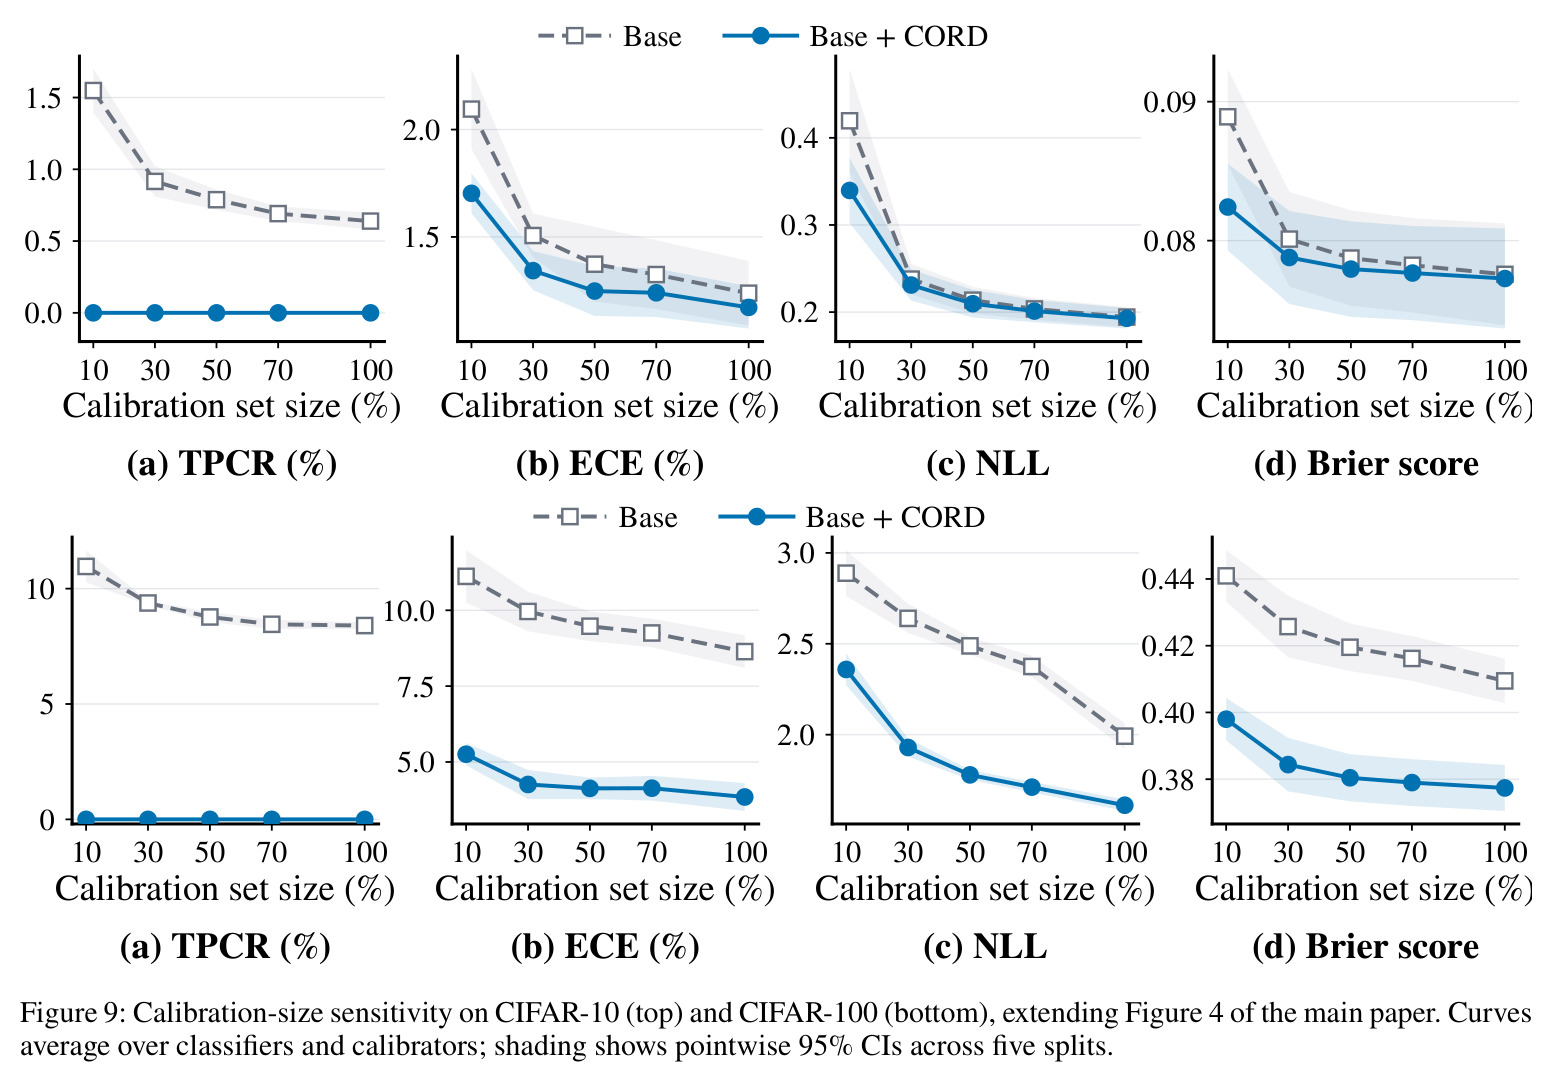
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 预测保持(ImageNet-1K,ResNet-50 + Vector Scaling) | TPCR(Top-1 预测改变率) | 0%(构造性保证,全部 114 个条件均成立) | VS 直接输出 5.74%(C+ 1.78% / C− 2.02% / C0 1.94%) | 预测改变完全消除,同时该配对 ECE 4.16%→2.99% |
| 置信度校准(CIFAR-100,7 分类器 × 7 校准器) | ECE | Base+CORD 相对 Base 平均降低 4.642pp | Base 直接输出(VS/SVS/MS/SMS/Dir-ODIR/IROvA/IROvA-TS) | +4.642pp,95% CI [2.822, 5.797] |
| 完整概率报告质量(ImageNet-1K) | NLL / Brier | 平均降低 0.0154 / 2.159×10⁻³ | Base 直接输出 | 置信区间 [0.0132, 0.0178] 与 [1.905, 2.470]×10⁻³,均为正 |
| 保预测修复内部对比(CIFAR-100) | ECE | 3.912(CORD 协调修复) | 5.144(最小逐点修复,同样零 TPCR、同样保持条件分布) | −1.232pp,验证共享标量协调与继承均值设计的价值 |
| 保预测校准横向对比(CIFAR-10,VGG-16-BN) | ECE (%) | 1.41(Base†+CORD,TPCR=0) | 拟合时保序基线:TS 1.54、IRM 1.62、AdaTS 1.47、TS–TvA 1.73、MCCT-I 1.74 | 较最佳基线 AdaTS 低 0.06pp,且无需在拟合时牺牲表达力 |
| 分布偏移下的保持(CIFAR-100-C,腐蚀强度 5) | TPCR | 0% | Base 直接输出 18.70%(强度 1→5 从 12.75% 持续上升) | 偏移下仍完全保持原始预测,且 ECE/NLL/Brier 均有成对改善 |
局限与改进
作者坦承的局限:预测保持本质上是部署选择——被校准器改对的预测($C^+$)会被 CORD 改回原始(可能错误的)预测,而改变是否提升正确性只能事后用标签知道,因此修复输出并非总是「更好」,只是与直接输出并存的另一份报告;此外 CORD 只处理 Top-1 保持,保序、排序等更丰富的结构约束留待后续。我自己的观察:(1) 可行区间下界 $s\ge\rho/(1+\rho)$ 是结构性的——当次最大类条件概率 $\rho$ 接近 1 时,原始类的修复置信度被迫逼近 0.5,即使模型实际几乎总正确,置信度校准存在不可消除的代价;(2) 均值目标 $\mu$ 继承自 Base,若校准器赋予原始预测的平均质量本身不佳,CORD 会忠实保留而非纠正它;(3) 个别配对的 ECE 可能轻微上升(如 CIFAR-10 上 VGG+SVS 从 1.56 升到 1.61),尽管 NLL/Brier 几乎总在改善;(4) 修复要求原始输出 $p^0$ 与校准输出 $q$ 同时可得,只保存校准后输出的管线需额外存储;(5) 实验全部为图像分类,未验证文本或结构化预测场景。
独立分析的弱点
独立分析出的弱点及改进方向:(1) 正确性盲区——CORD 对 $C^+/C^-$ 一视同仁,在 $C^->C^+$ 的条件(如 ImageNet ResNet-50+VS:$C^-$ 2.02% 高于 $C^+$ 1.78%)里它系统性恢复了更多错误预测;改进方向是用极小验证集估计净收益,在直接输出与修复输出间选择或自适应混合。(2) 置信度被结构钳制——$\rho\to 1$ 时 $s$ 被压到 0.5 附近,此时「预测接近打平」可作为拒绝预测信号显式上报。(3) 均值目标保守——$\mu$ 锚定 Base 的历史平均,无法用标签纠正系统性偏差;可探索带少量标签正则的变体,但会突破 R1/R2 设计需求。(4) 只保证 Top-1:其余类绝对概率整体缩放 $(1-s)$ 倍,依赖第二类绝对概率的下游机制(reject option、级联路由)仍受影响;可扩展到 top-k 或带序约束的修复。(5) 收益依赖 Base 的 TPCR——当校准器很少改变预测时(CIFAR-10 多数配对 TPCR<1.5%),ECE 改善平均仅 0.061pp,边际价值有限,宜配合「何时值得修复」的判据使用。
未来方向
作者明确列出的开放方向:更丰富的拟合后目标函数、替代性的修复选择原则、以及超越 Top-1 的保持扩展。在此基础上可以延伸:(1) 把 CORD 与拟合时保序校准器(IOP、MCCT-I)组合成「拟合时 + 拟合后」两级保持,研究两者的收益是否叠加或冗余;(2) 在语义分割等密集预测任务上复制该配方——该领域刚出现 argmax/保序约束的类条件仿射校准(Kirscher 等 2026),CORD 式修复或可简化其设计并解除拟合约束;(3) 理论化「何时应该保持预测」:以 $C^+/C^-$ 的先验或在线估计为基础,建立保持/改动的决策框架;(4) 研究修复输出对下游任务的影响,特别是选择性预测与 conformal 预测——逐点预测保持可能改善共形覆盖的有效性;(5) 把一维修复推广到多标签、检索校准或 LLM 的语言化置信度等场景;(6) 工程上,把 $\eta^\star$ 的估计做成流式在线更新,以适应数据分布缓慢漂移的生产环境。
复现评估
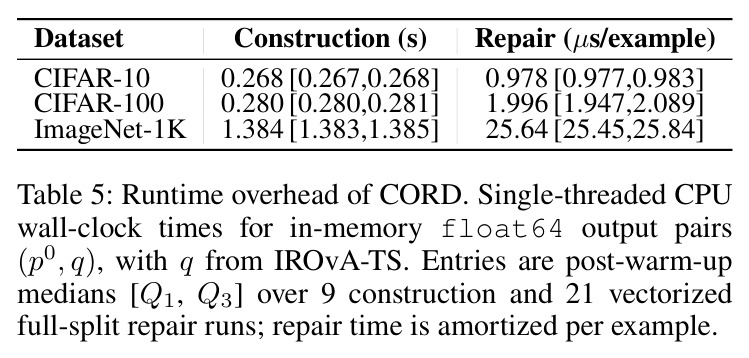
复现条件非常好。代码已在 GitHub 开源(github.com/labhai/CORD),附录直接给出约百行 NumPy 的完整参考实现,包含防数值抵消的闭式响应、有限区间二分、平台感知求解器与保序稳定化,所有数值约定($\epsilon_{num}=10^{-12}$、$\delta_{stab}=10^{-10}$、平局取最小类索引)均被固定。数据全部公开:CIFAR-10/100、ImageNet-1K、CIFAR-C,分类器均使用公开发布的预训练权重;各 Base 校准器用默认设置的现成实现;5 个随机种子且所有方法共享同一校准/评估划分(CIFAR 每划分 5,000 样本、ImageNet 25,000 样本),实验协议描述详尽。CORD 自身无需 GPU、无超参数:校准集构造在单线程 CPU 上仅 0.27–1.4 秒,修复摊销每样本约 0.98–25.64 微秒,持久状态只有 8 字节的 $\eta^\star$。总体复现难度低,主要间接依赖是先获得各 Base 校准器的拟合输出,ImageNet 推理是主要算力成本,但可复用公开 checkpoint 快速完成。
论文图表
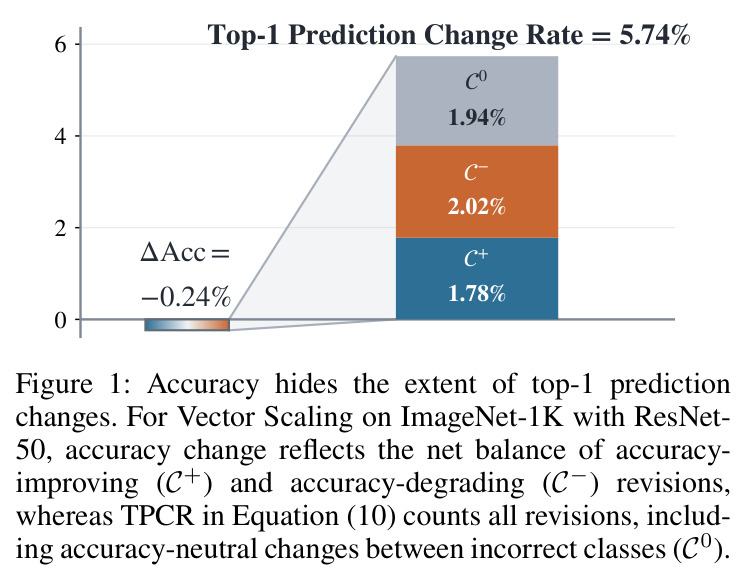
以 ImageNet-1K 上的 ResNet-50 + Vector Scaling 为例:准确率仅变化 ΔAcc = −0.24 个百分点,但 Top-1 Prediction Change Rate = 5.74%,并分解为变对 $C^+$ 1.78%、变错 $C^-$ 2.02%、错误类间切换 $C^0$ 1.94% 三部分,说明准确率只记录净效果、TPCR 才统计全部改变。
这是全文的动机图:一张图讲清「校准很好但预测被调包」这一被准确率掩盖的现象,是理解 TPCR 指标和 CORD 存在意义的起点。
五步伪码:在校准集上对每个输出对计算 $a$、$b$、$\alpha$、可行区间 $I$ 与局部参考 $g$;投影得到继承可行均值 $\mu$;解共享标量方程得 $\eta^\star$ 并只保留该标量;对新输入计算 $s=\psi(\eta^\star;g,I)$;返回 $\hat p=s\,e_a+(1-s)\alpha$。
把方法的全部计算流程浓缩在一页内,是复现 CORD 的最直接依据,也直观展示了「构造一次、每次修复 O(K)」的轻量特性。
CIFAR-100 完整结果:Base TPCR 从 0.40%(SVS+DenseNet)到 40.51%(MS+ShuffleNetV2),MS 的准确率变化最极端(−2.14 至 −13.16pp);CORD 修复后所有配对 TPCR 归零,ECE 改善最高达 37.26pp(ResNet-56+MS),NLL/Brier 几乎全为 ▼。
展示高 TPCR 场景的完整数据:既是问题严重性(MS 类校准器大幅改预测)的证据,也是 CORD 收益上限的量化出处。