ReFlowSET:面向SAR到光学图像转换的表示对齐潜在流匹配框架 ReFlowSET: Representation-Aligned Latent Flow Matching for SAR-to-EO Image Translation
通过VAE重建审计选定编解码器,从零训练双流DiT流匹配模型完成SAR到光学图像转换
前置知识
条件流匹配 (Flow Matching)
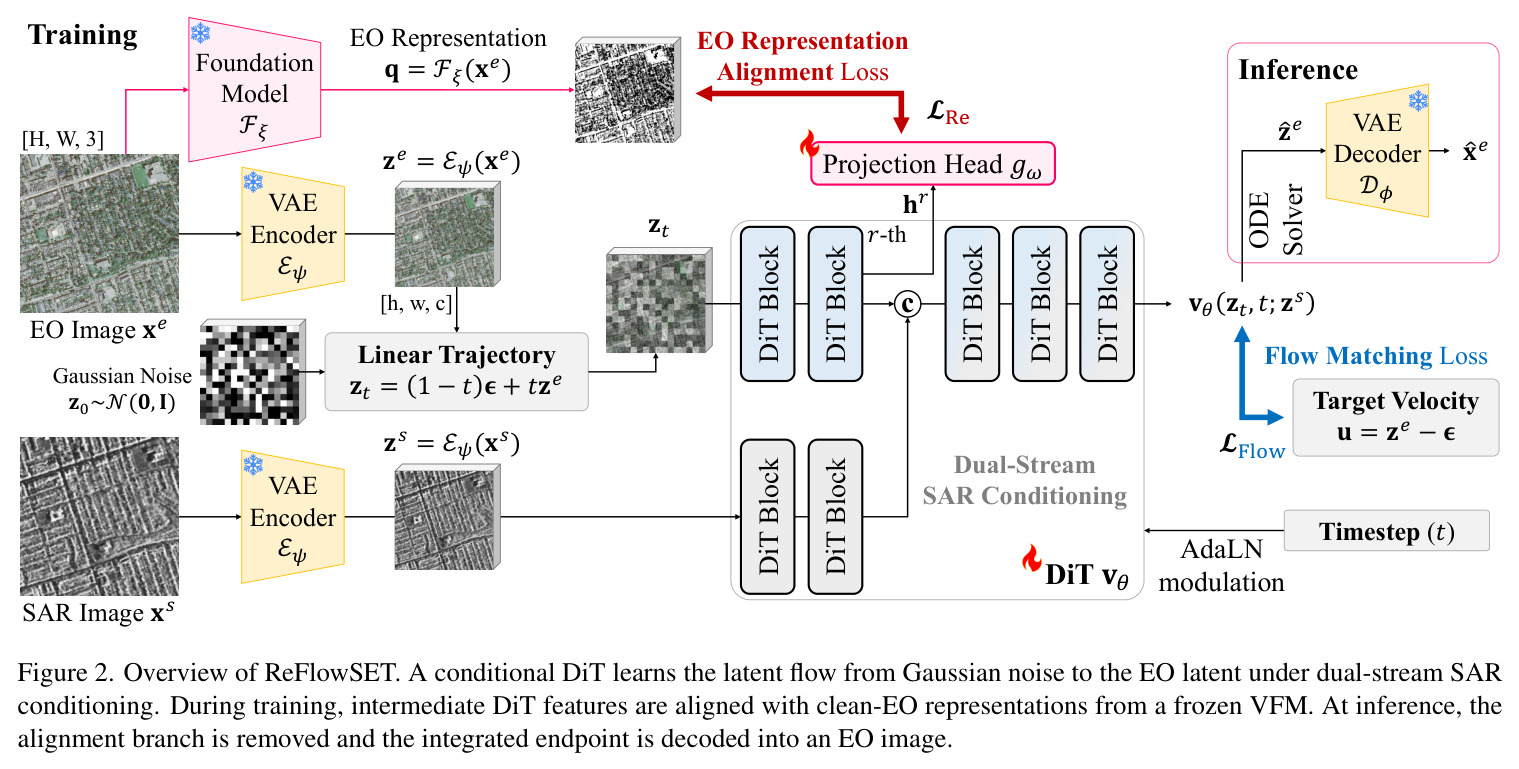
连续归一化流的一种训练范式:构造从高斯噪声到数据样本的线性插值路径 $z_t = (1-t)\epsilon + t z_e$,训练网络预测路径上的速度场 $u = z_e - \epsilon$,推理时从噪声出发对常微分方程(ODE)积分生成样本。相比扩散模型的多步加噪路径更平直,训练目标就是简单的回归速度场。
ReFlowSET 的生成主干就是条件流匹配,其核心损失、训练采样方式和推理流程全部建立在这套形式化之上,不理解它就无法读懂第 4.1 节。
VAE 编解码器与潜在空间
变分自编码器把图像压缩到低维潜在空间再解码重建,潜在扩散/流匹配模型实际在潜在空间中工作。往返重建质量 $D_\phi(E_\psi(x))$(如 PSNR)决定了该潜在空间可达到的保真上限,不同预训练编解码器之间的差距可达数个分贝。
本文的核心论点是'编解码器选型是被忽视的设计变量',Figure 1 的重建审计实验以及选 FLUX.2 而非 SD2.1 的所有决策都依赖这一概念。
DiT(Diffusion Transformer)
用 Transformer 块替代 U-Net 作为扩散或流模型的骨干网络,通过 AdaLN 等调制机制注入时间步与条件信息,扩展性好,FLUX、SD3 等新一代模型均采用。本文字符模型从零随机初始化训练,不继承任何预训练生成器权重。
本文从零训练的生成器就是 24 块、509.3M 参数的条件 DiT,双流条件化的前 8 块划分和表示对齐的插入位置都作用在其块结构上。
表示对齐 (Representation Alignment, REPA)
训练生成模型时,用可训练投影头把中间层特征映射到冻结视觉基础模型(如 DINOv3)的表示空间,以余弦相似度损失对齐,从而为从零训练的模型注入语义先验、加速收敛并提升生成质量。对齐分支训练结束后直接丢弃,推理零开销。
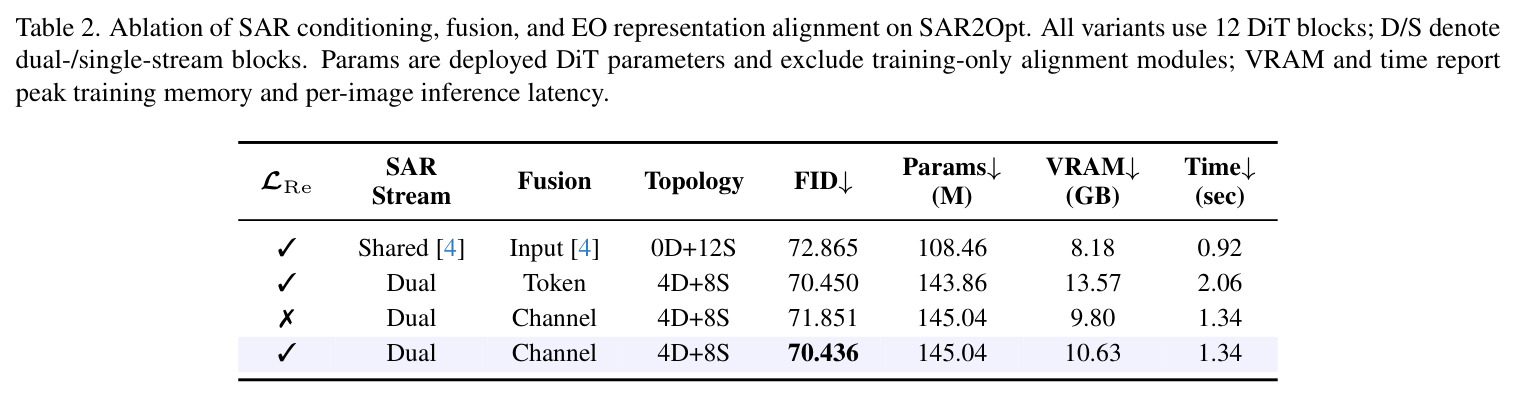
这是本文'训练期 EO 表示对齐'的直接来源;Table 2 的消融证明加入 $\mathcal{L}_{Re}$ 使 FID 从 71.851 降到 70.436 且不增加任何推理成本。
图像转换评价指标(FID/DISTS/LPIPS/SSIM/PSNR)
FID 用预训练网络特征衡量生成分布与真实分布的距离,越低越好;LPIPS 与 DISTS 是深度特征感知相似度,关注纹理与结构感知质量;SSIM 和 PSNR 是逐像素保真度指标,对配对遥感影像固有的局部空间错位非常敏感。
本文结论建立在 FID/DISTS/LPIPS 领先而 PSNR/SSIM 不占优的指标格局上,理解这些指标的取舍差异才能正确评价论文的贡献与局限。
研究动机
合成孔径雷达(SAR)能全天候成像,但相干成像机制带来斑点噪声和几何畸变,判读远不如光学遥感直观,因此 SAR 到光学(EO)图像转换(SET)成为关键任务。难点在于 SAR 后向散射与 EO 反射率刻画的是完全不同的物理量,跨模态映射天然存在歧义。而现有潜在扩散方法(如 cBBDM、C-DiffSET)都直接沿用为自然图像预训练的 Stable Diffusion 2.1 VAE 作为固定编解码器,从不检验它对 SAR 和 EO 影像是否合适。作者实测发现编解码器差异巨大:在 QXS-SAROPT 等四个数据集上,SD2.1 的 EO 重建上限仅约 20.5 dB,FLUX.2 却达到 28.7 dB,平均 EO 上限高出 7.49 dB——这意味着旧方法从起步就把可达的解码终点压低了好几个分贝。此外主流做法把 SAR 潜变量通过逐通道拼接立即与噪声潜变量混合,当配对影像存在局部空间错位时,统计特性迥异的两个模态被过早纠缠,进一步损害生成质量。
本文的目标是本文的目标是把潜在 SET 的'编解码器选型'从一个被默认的实现细节提升为显式的设计变量,并据此重构整个生成框架。具体包含三个子目标:其一,系统评估 SD2.1、SDXL、SD3.0、SD3.5、FLUX.1、FLUX.2 六个预训练 VAE 在 QXS-SAROPT、SAR2Opt、SpaceNet6、SAR-1M 四个数据集上对 SAR 与 EO 两种模态的往返重建保真度,选出联合上限最高的编解码器;其二,不继承选中编解码器配套的数十亿参数预训练生成器,而是只保留其冻结 VAE,从零训练一个 509.3M 参数的小型条件 DiT,用条件流匹配学习从高斯噪声到 EO 潜变量的流;其三,为弥补从零训练缺失的语义先验,引入仅作用于训练期的 EO 表示对齐损失,且不给推理带来任何额外开销。最终目标是在 QXS-SAROPT 和 SAR2Opt 两个基准上于感知相似度与分布真实性指标达到最先进水平。
与已有工作不同的是,论文的独特切入角度是'先审计、再训练':与其默认继承 SD2.1 VAE,不如先量化各编解码器对两种模态的重建上限 $D_\phi(E_\psi(x))$——EO 上限代表潜在目标训练下直接可达的解码终点保真度,SAR 上限代表条件生成能保留多少源结构——再据此选择潜在空间。作者声称这是首个针对 SET 的系统性模态级自动编码器上限分析。第二个差异化设计是不继承重型预训练生成器:FLUX.2 生成器有数十亿参数,本文只取其 VAE,用小得多的 DiT 从零训练,既享受高保真潜在空间又控制算力。第三个差异是语义引导方式:从零训练缺先验的问题不用标注数据解决,而是借用表示对齐(REPA)思想,把中间噪声特征对齐到冻结视觉基础模型 DINOv3 的干净 EO 表示,损失只在训练期存在,推理时整条分支被丢弃、零开销。三个选择组合起来,与直接微调 SD 或在其上构建条件扩散的现有路线形成清晰区隔。
核心方法
ReFlowSET 的整体思路可概括为'好底座 + 从零小模型 + 免费老师'。直觉上,潜在生成模型的上限受编解码器往返重建质量制约,因此第一步先用 $D_\phi(E_\psi(x))$ 的 PSNR 对六个预训练 VAE 做审计,选定 FLUX.2 作为 SAR 和 EO 共用的冻结编解码器。第二步把配对影像编码为 $z_m = E_\psi(x_m)$,训练一个 24 块、509.3M 参数的条件 DiT $v_\theta$,用条件流匹配学习从高斯噪声到 EO 潜变量的线性轨迹:$z_t = (1-t)\epsilon + t z_e$,目标速度 $u = z_e - \epsilon$,SAR 潜变量 $z_s$ 作为持久条件全程输入。第三步针对从零训练缺少语义先验的问题,在前 $r=8$ 个双流块之后接投影头 $g_\omega$,把噪声 EO 流特征与冻结 DINOv3 ViT-L/16 提取的干净 EO 表示做余弦对齐,总损失为 $\mathcal{L} = \mathcal{L}_{Flow} + \lambda\mathcal{L}_{Re}$。推理时对齐分支整体移除,从 $t=0$ 到 $1$ 用 Euler 求解器积分 50 步(CFG 1.5)后由解码器还原成 EO 图像。
核心创新点有三个层面,本质区别都针对现有方法的固定假设。第一,重建引导的编解码器选择:C-DiffSET、cBBDM 等把 SD2.1 VAE 当作不可动的前提,本文通过联合 SAR–EO 重建审计发现 FLUX.2 在 8 个数据集–模态组合中的 6 个最优、平均 EO 上限比 SD2.1 高 7.49 dB,并把审计结果直接转化为底座选择——同一框架内换用 FLUX.2 后 FID 从 25.5 降到 19.1(QXS-SAROPT)、从 84.5 降到 66.3(SAR2Opt),证实了该假设的价值。第二,双流延迟融合:前 8 个 DiT 块用独立参数化的两条流分别处理 SAR 条件和噪声 EO 潜变量,之后才逐通道拼接融合,避免逐位置拼接把统计特性迥异的模态过早纠缠。第三,训练期表示对齐:借鉴 REPA,用冻结 DINOv3 提取干净 EO 表示 $q_i$,以余弦损失对齐噪声流特征 $g_\omega(h_r^i)$,为从零训练的 DiT 提供语义教师,推理时零成本。三者共同把'从零训练的小模型战胜预训练大模型'变成了实验事实。
方法步骤详情
第一步,编解码器审计:在 QXS-SAROPT、SAR2Opt、SpaceNet6、SAR-1M 训练集上计算 SD2.1、SDXL、SD3.0、SD3.5、FLUX.1、FLUX.2 六个 VAE 对 SAR 与 EO 的编码–解码 PSNR,FLUX.2 在 8 项中的 6 项最高(QXS-SAROPT EO 28.7 dB 对 SD2.1 的 20.5 dB),选定其冻结 VAE 为共用编解码器。第二步,编码:将配对 SAR 图 $x_s$ 与 EO 图 $x_e$ 编码为 $z_s, z_e$。第三步,条件流匹配训练:采样 $\epsilon \sim \mathcal{N}(0, I)$、$t \sim U(0,1)$,构造 $z_t = (1-t)\epsilon + t z_e$,训练 24 块、509.3M 参数的 DiT $v_\theta$ 最小化 $\mathcal{L}_{Flow} = \mathbb{E}\|v_\theta(z_t, t; z_s) - (z_e - \epsilon)\|_2^2$。第四步,双流条件化:前 $r=8$ 块独立参数化地分别处理 SAR 流与噪声 EO 流,之后逐通道拼接、投影回模型宽度,交由其余 16 块联合处理。第五步,表示对齐:投影头 $g_\omega$ 将噪声 EO 流特征 $h_r^i$ 映入 DINOv3 表示空间,以余弦距离 $\mathcal{L}_{Re} = \frac{1}{N}\sum_i (1 - \cos(g_\omega(h_r^i), q_i))$ 计算损失,总目标 $\mathcal{L} = \mathcal{L}_{Flow} + \lambda\mathcal{L}_{Re}$($\lambda = 0.5$)。第六步,推理:以 CFG 1.5、Euler 求解器 50 NFE 从 $t=0$ 积分到 $t=1$,端点经冻结解码器 $D_\phi$ 得到 $\hat{x}_e$,对齐分支与投影头整体丢弃、零推理开销。
技术新颖性
技术新颖性体现在四个方面。首先,把自动编码器上限分析作为贡献本身:逐模态、逐数据集地系统测量六个 VAE 的重建天花板,这在此前的 SET 文献中没有人做过,论文也据此把'审计'上升为方法的第一步。其次,底座与生成器解耦:现有潜在 SET 方法全部绑定 SD2.1 的 VAE+U-Net 组合并微调,本文证明可以只继承 VAE 而从零训练生成器,在双卡 RTX 4090 上训完且指标反超预训练初始化的对手,这对资源受限的领域适配研究有方法论意义。再次,条件化架构的系统消融:作者不满足于照搬 C-DiffSET 的输入拼接,而是量化比较共享流、双流+token 融合、双流+通道融合三种拓扑,发现逐 token 融合把序列长度翻倍、显存从 10.63 GB 涨到 13.57 GB 却几乎无 FID 收益(70.450 对 70.436),这种带成本核算的设计决策在同类论文中少见。最后,把 REPA 式表示对齐从无条件类生成迁移到配对跨模态转换,对齐目标是干净 EO 目标图而非类别语义,且严格保持推理图不变。
实验结果
编解码器审计显示 FLUX.2 在 8 个数据集–模态组合中的 6 个取得最高 PSNR,平均 EO 重建上限比 SD2.1 高 7.49 dB(QXS-SAROPT EO 28.7 对 20.5 dB,SAR2Opt EO 25.3 对 18.9 dB),确立了底座选择。主实验上,在 QXS-SAROPT(16,001/3,999 划分)ReFlowSET 取得 FID 19.1(并列最佳)、DISTS 0.231(最佳)、LPIPS 0.534、SSIM 0.355、PSNR 16.09;在 SAR2Opt(1,450/627 划分)FID 从此前最佳 71.8 降至 66.3(相对降低 7.7%),DISTS 从 0.211 降至 0.185(相对降低 12.3%),LPIPS 0.522 亦为最佳。消融进一步支持各项设计:同一框架内把 SD2.1 换成 FLUX.2,两个基准的全部五项指标同时改善(FID 25.5→19.1 与 84.5→66.3);在 12 块紧凑模型上,双流加逐通道融合把 FID 从共享流基线的 72.865 降到 70.436,而逐 token 融合几乎无收益(70.450)却把训练显存从 10.63 GB 抬到 13.57 GB、单图推理从 1.34 s 增到 2.06 s;加入 $\mathcal{L}_{Re}$ 再把 FID 从 71.851 降到 70.436,仅多 0.83 GB 训练显存且无推理开销。需注意 PSNR/SSIM 未夺冠(HI-Diff 达 17.10),作者归因于像素指标对配对数据局部错位敏感。
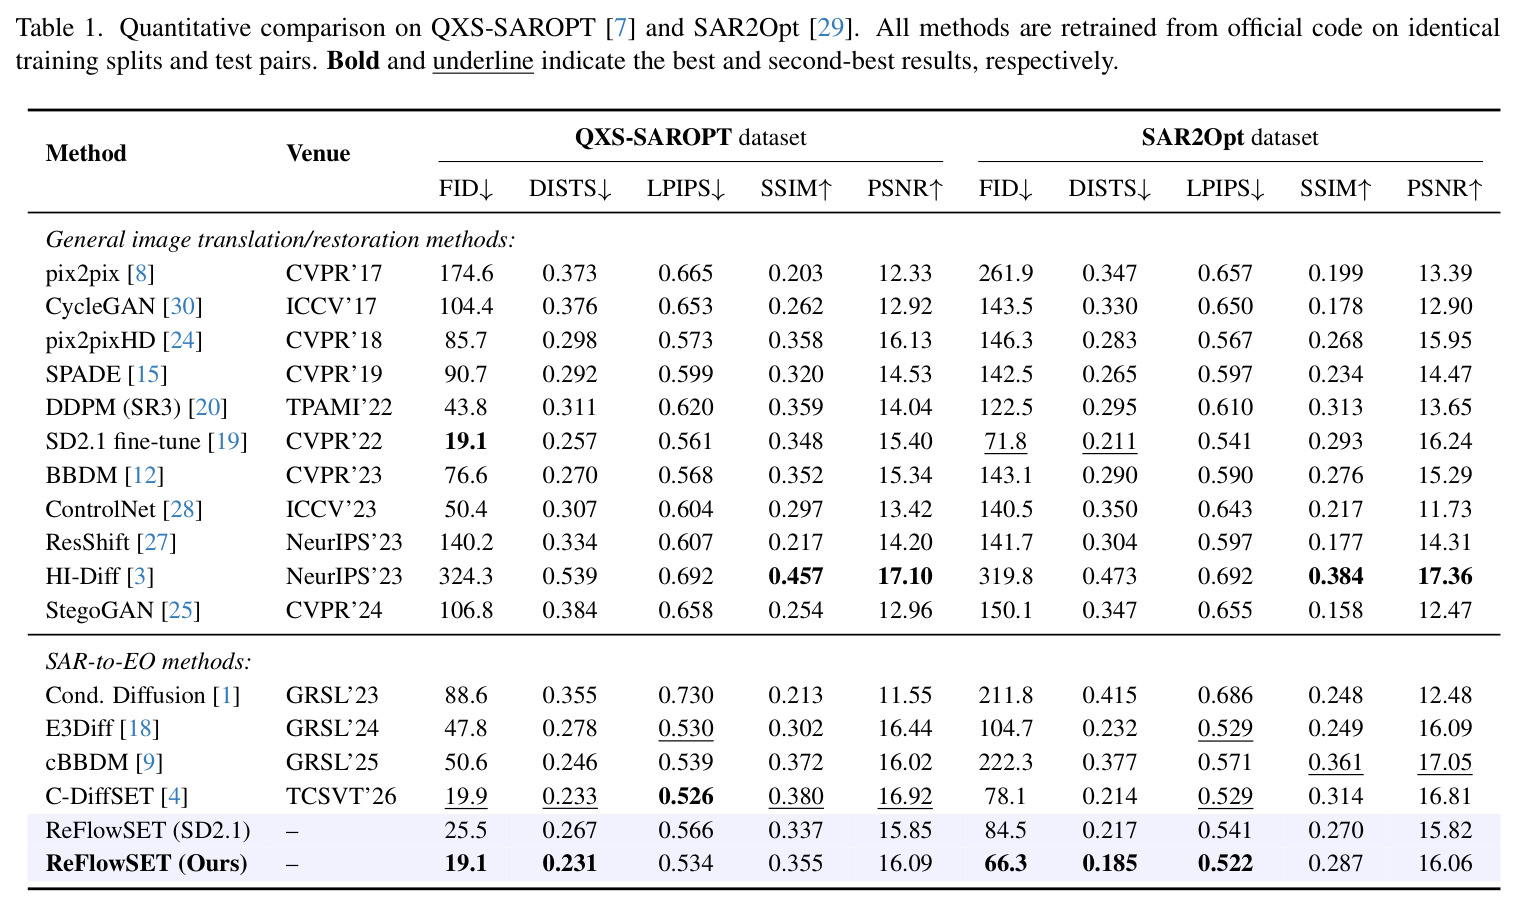
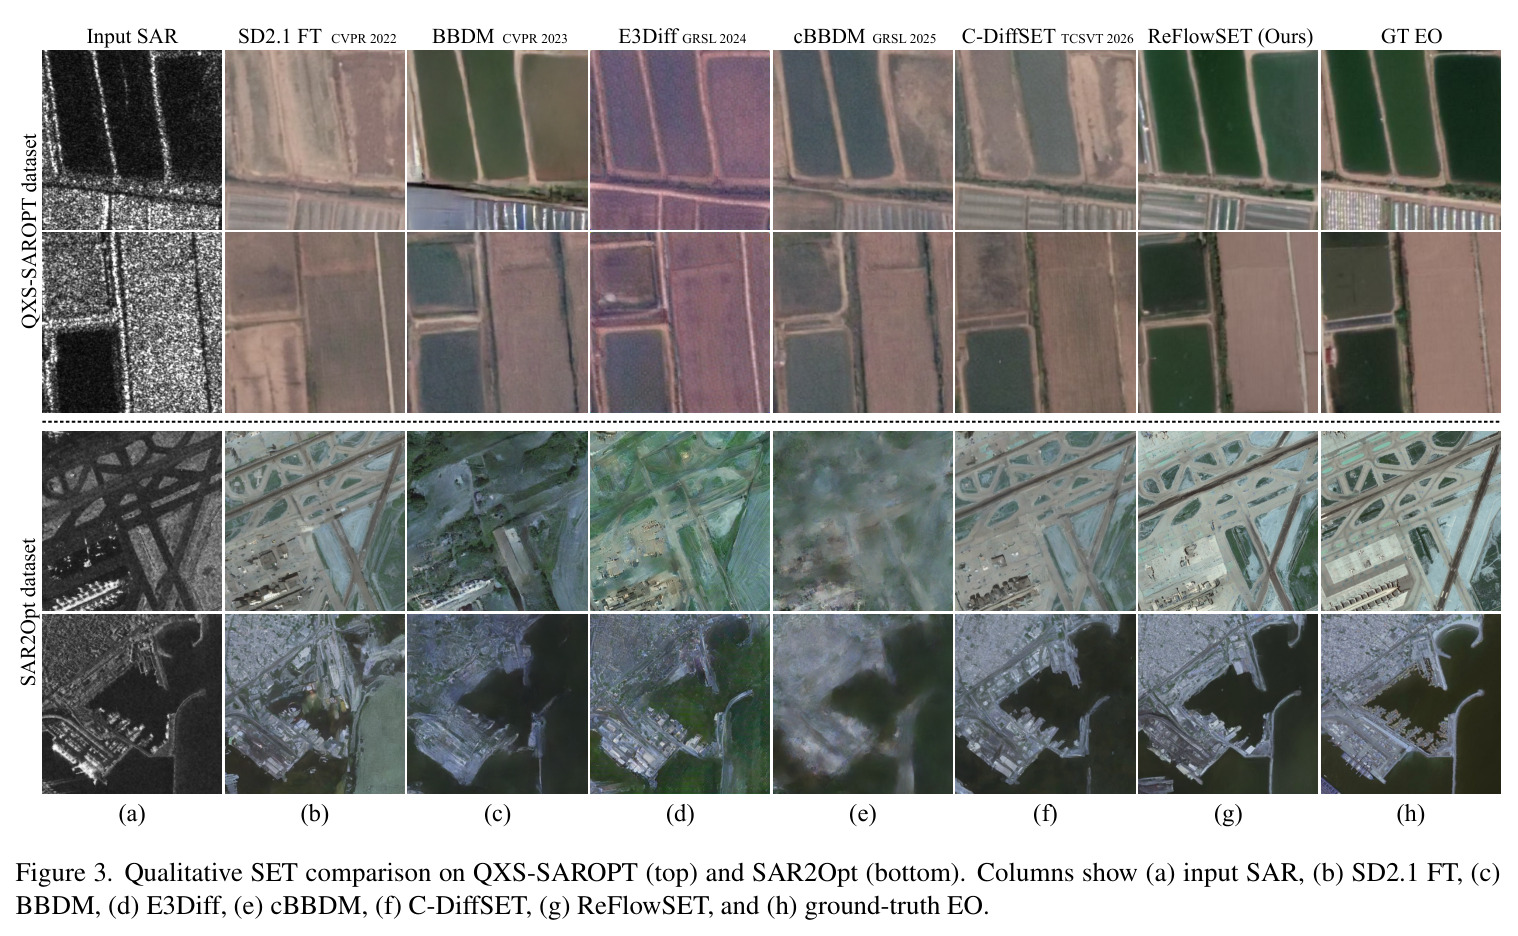
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SAR到EO图像转换(QXS-SAROPT) | FID↓ | 19.1 | C-DiffSET 19.9 / SD2.1 fine-tune 19.1 | 并列最佳 |
| SAR到EO图像转换(QXS-SAROPT) | DISTS↓ | 0.231 | C-DiffSET 0.233 | 最佳,超越次优 0.002 |
| SAR到EO图像转换(SAR2Opt) | FID↓ | 66.3 | C-DiffSET 78.1 | 相对降低 7.7% |
| SAR到EO图像转换(SAR2Opt) | DISTS↓ | 0.185 | C-DiffSET 0.214 | 相对降低 12.3% |
| SAR到EO图像转换(SAR2Opt) | LPIPS↓ | 0.522 | C-DiffSET 0.529 / E3Diff 0.529 | 最佳 |
局限与改进
作者明确承认的局限有二:一是 ReFlowSET 并未最大化 PSNR 和 SSIM——QXS-SAROPT 上 PSNR 16.09、SSIM 0.355 低于 HI-Diff 的 17.10/0.457,作者把像素保真指标定位为参考项,强调感知与分布指标;二是结论部分提出未来需检验跨传感器泛化能力,以及抑制'不受支持的 EO 类结构'的生成(即模型虚构地物)。我的补充观察:首先,双流设计使部署参数从 108.46M 增至 145.04M、训练显存升至 10.63 GB,代价并非免费;其次,编解码器审计只看往返重建 PSNR,未考察语义保持或潜在空间对条件生成的友好程度,'重建上限高'与'潜在空间适合 SET'之间的联系更多是实证假设而非理论保证;再次,实验仅覆盖两个评测基准,没有跨数据集测试,配对数据的局部错位问题本身没有被解决,只是通过指标叙事绕开了它;最后,推理需 50 NFE、约 1.34 秒/图,相比 E3Diff 的单步蒸馏仍有明显速度差距。
独立分析的弱点
第一个弱点是像素保真度偏低:SAR2Opt 上 PSNR 16.06 落后于 HI-Diff 的 17.36 和 cBBDM 的 17.05,SSIM 0.287 也明显低于 cBBDM 的 0.361,在需要精确量测的下游场景(变化检测、建筑轮廓比对)中可能吃亏,改进方向是引入错位感知的像素损失或多尺度频率损失,在不牺牲 FID 的同时拉高保真度。第二个弱点是审计维度单一:重建上限只以 PSNR 衡量,忽略感知质量和潜在空间的可生成性,可能出现'重建好但难生成'的编解码器,改进方向是加入感知指标和小型探测模型联合评分。第三个弱点是双流结构的性价比:参数量从 108.46M 涨到 145.04M(约 +33.7%),紧凑设定下 FID 仅改善约 2.4,可探索轻量化的模态特定适配器替代完整 DiT 块。第四个弱点是依赖 FLUX.2 VAE 与 DINOv3 两个大型冻结模型,显存与权重获取成本高,可用蒸馏或开源替代缓解。第五,缺乏对生成内容真实性的显式约束,作者自己也承认会虚构 EO 结构,需要不确定性估计或检索增强机制兜底。
未来方向
作者在结论中明确提出两个方向:跨传感器泛化——把在 GF-3、TerraSAR-X 上训练的模型推广到 Sentinel-1 等其他 SAR 传感器;以及抑制不受支持的 EO 类结构生成,即控制模型'脑补'出不存在的地物。基于本文成果还可以延伸:其一,把重建审计扩展为编解码器–数据集联合搜索,用感知指标与生成后验联合选型,甚至微调 VAE 使其专用于 SAR/EO 模态;其二,表示对齐的教师可换成遥感专用基础模型,并探索多尺度、多教师对齐以注入更丰富的地物语义;其三,50 NFE 的采样成本可通过一致性蒸馏或流匹配的少步求解器压缩到个位数步数,对齐 E3Diff 的单步效率;其四,SET 的产出天然服务于无云光学影像合成、灾害应急制图等业务,可在真实分布外数据上检验鲁棒性;其五,为像素级'不可信生成'提供置信度图,这与作者提到的抑制虚构结构一脉相承,也是走向业务落地的必要条件。
复现评估
复现条件相当友好。代码与预训练权重公开于 github.com/KAIST-VICLab/ReFlowSET;四个数据集全部公开:QXS-SAROPT 含 20,000 对 256 像素 GF-3 SAR 与 Google Earth 光学切片(16,001/3,999 划分),SAR2Opt 含 2,077 对 600 像素 TerraSAR-X 与 Google Earth 影像(1,450/627,随机/中心 512 裁剪),另有 SpaceNet6 与 SAR-1M 用于审计。论文给出了完整超参:AdamW 峰值学习率 $5\times10^{-4}$、1k 步预热加余弦衰减、bf16 精度、条件 dropout 0.1、CFG 1.5、Euler 50 NFE,QXS-SAROPT 训 40k 步批 64、SAR2Opt 训 20k 步批 32,仅在两张 RTX 4090 上完成,消费级双卡即可复现。难点主要在依赖项:需获取 FLUX.2 VAE 与 DINOv3 ViT-L/16 的冻结权重;作者比较的全部基线均用官方代码在同一划分上重训,对照实验可复制性高。综合评估为中低难度。
论文图表
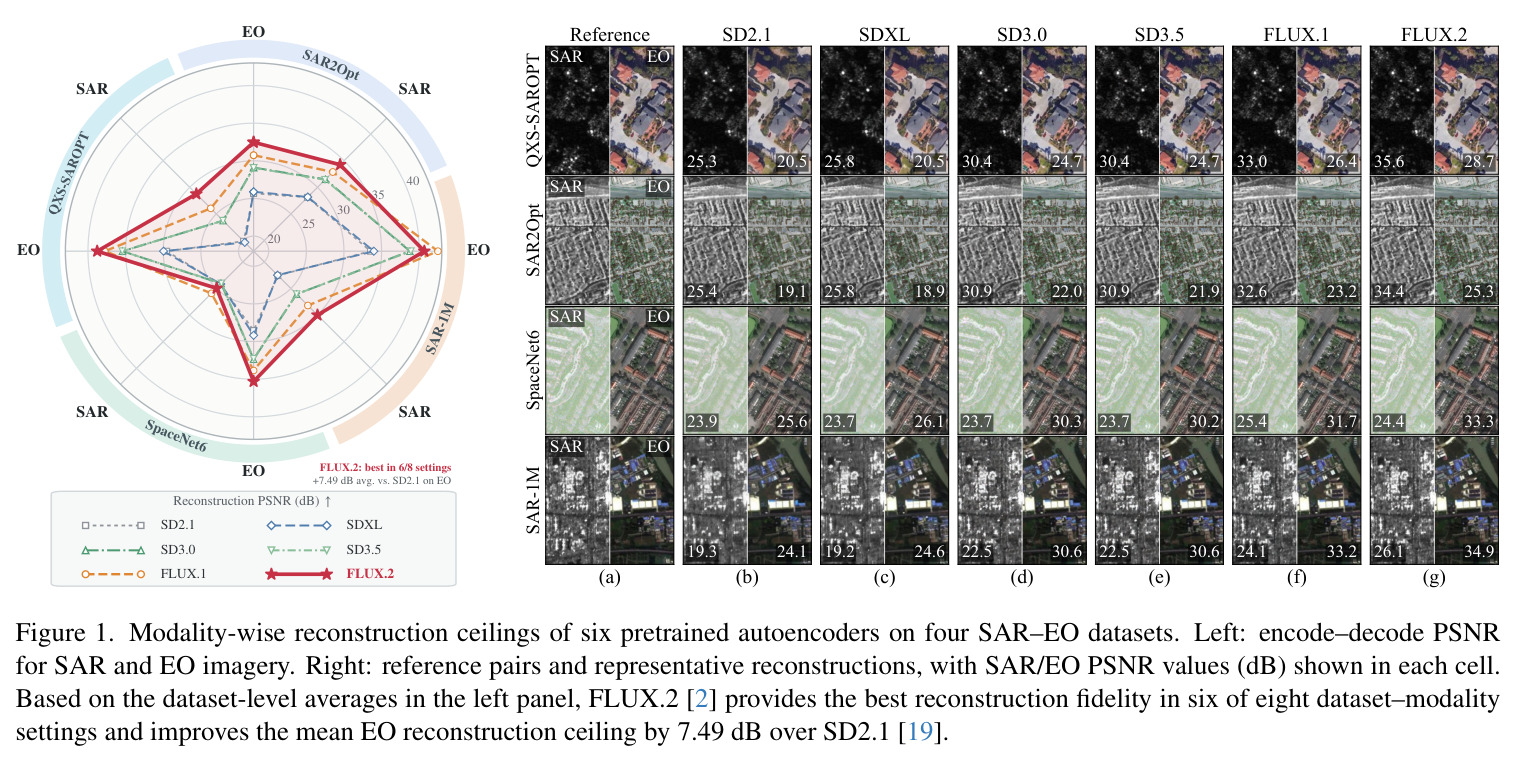
左侧展示 SD2.1、SDXL、SD3.0、SD3.5、FLUX.1、FLUX.2 六个编解码器在 QXS-SAROPT、SAR2Opt、SpaceNet6、SAR-1M 四个数据集上对 SAR 与 EO 影像的编码–解码 PSNR(仅用训练集统计);右侧给出参考影像对及各编解码器的代表性重建结果并标注逐图 PSNR。FLUX.2 在 8 个数据集–模态组合中的 6 个最优,平均 EO 重建上限比 SD2.1 高 7.49 dB(如 QXS-SAROPT EO 28.7 对 20.5 dB)。
这是全文动机的实证基础:它直观展示了编解码器之间可达数个分贝的重建差距、SD2.1 远非最优的事实,直接支撑'重建引导的编解码器选择'这一核心主张,也解释了为什么后续所有实验都换用 FLUX.2 底座。