控制-数据流分离:多智能体大语言模型中的稳定提示词优化 Control-Data Flow Separation: Stable Prompt Optimization in Multi-Agent LLMs
把智能体输出拆成类型化控制流与可优化数据流,使提示词优化不再破坏多智能体执行协议。
前置知识
提示词优化(Prompt Optimization)
把提示词文本当作可调参数来改进系统的一类方法:不改动模型权重,先让系统在一批训练样例上运行,再依据任务级反馈(标量损失或 LLM 生成的文字批评)反复改写提示词。代表工作包括 APE、OPRO、TextGrad、DSPy 的 BootstrapFewShot/MIPROv2 以及 GEPA,它们都能端到端优化整个流水线。
本文研究的正是这类方法被应用到多智能体系统时出现的协议崩塌问题;理解“把提示词当参数优化”这一范式是理解问题根源和论文动机的前提。
文本梯度(Textual Gradient)
TextGrad 提出的优化机制:把 LLM 程序的调用图看作神经网络,用自然语言书写的“梯度”(对输出的批评与改进建议)沿调用图反向传播,最终由优化器 LLM 据此改写各节点的提示词。它不需要真实梯度,只需要文本反馈,因此适用于闭源 API 模型。
论文的 naive 基线就是对整条提示词直接做 TextGrad,崩塌现象、消融实验(标量损失 vs 逐样本反馈)和附录中的失败日志全部围绕它展开。
多智能体系统与控制器路由
由多个各司其职的 LLM 智能体协作完成任务的系统,通常由一个 Python 程序控制器协调:控制器决定当前调用哪个智能体、把输出交给谁(路由)、何时终止(如 leader-worker 结构中领导者分配子任务并汇总工人结果)。智能体的提示词同时定义其角色和通信行为。
论文区分“控制通道”与“数据通道”的依据正是两类读者的存在:控制器读取输出做执行决策,其他智能体读取输出做任务推理,理解该系统模型才能明白协议为何会被提示词编辑改坏。
结构化输出与模式校验
让 LLM 输出符合预定义模式(JSON Schema、Pydantic/dataclass、Literal 枚举)的机器可读对象,并在运行时校验字段名、类型与取值集合,失败时可重试或回退。代表工具包括 instructor、LangChain 输出解析器、Outlines、XGrammar 等约束解码库。
本文的控制通道本质上就是一个类型化、运行时校验的程序对象;Literal 类型保证路由目标等字段取值集合封闭,这是协议稳定性保证的技术基石。
控制-数据流分离
源自编译器与网络协议设计的经典原则:把“指挥程序如何执行”的信息(控制流,如网络包头、元语言指令)与“被处理的内容”(数据流,如报文载荷、被编译的源语言)分开表示、分别传递,使二者可以独立演化而互不破坏。
这是全文的核心设计原则。作者的创新在于把这一软件工程常识首次显式落地为多智能体提示词优化的可强制执行接口,并给出形式化保证。
研究动机
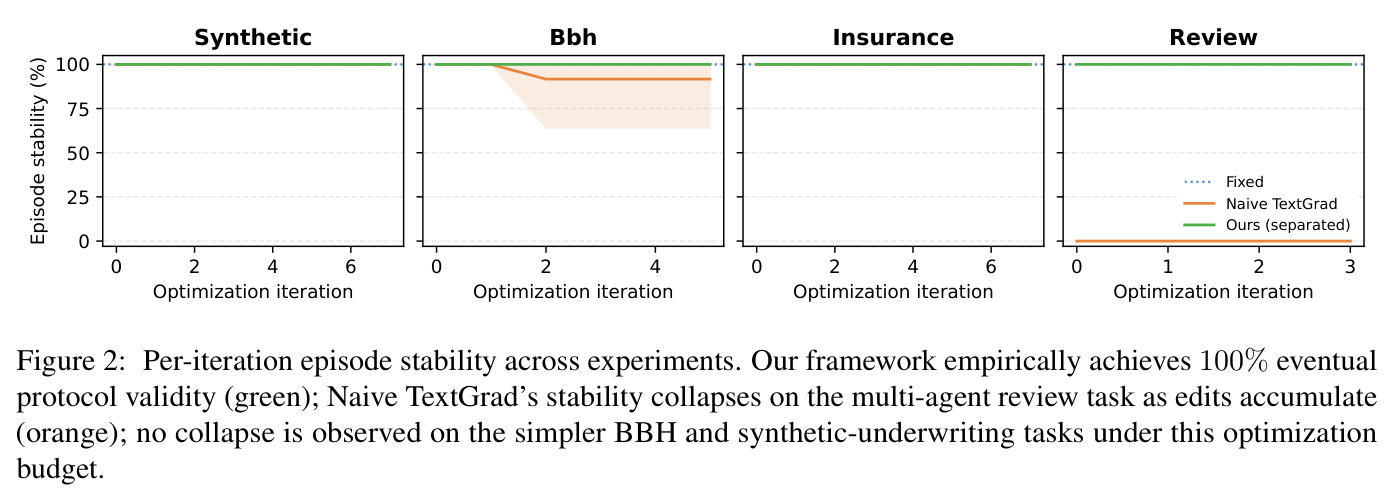
多智能体 LLM 系统中,每条提示词同时承担两个角色:一是指导生成任务相关内容(解释、摘要、批评),二是规定程序依赖的执行协议(输出格式、路由命令、终止信号)。例如 leader 智能体被要求输出含 action 和 target_agent 字段的 JSON,由 Python 控制器解析后决定下一个执行的工人。现有提示词优化方法把整条提示词当作可编辑文本,一次旨在提升内容质量的改写可能顺手删掉或改写格式指令。后果不是答案变差,而是执行链路断裂:消息解析失败、路由到不存在的智能体、程序彻底崩溃。论文实测:在 MARG 评论生成流水线上,naive TextGrad 改坏内联 JSON 指令后,可用输出在优化过程中跌至 0%(episode 稳定性 0%);在行业验证核保任务上稳定性也仅 56.7%。附录 G 的优化日志显示,5 轮迭代后优化器干脆删除了整个 JSON 格式块,或把 target_agent 字段名改得无影无踪。
本文的目标是本文目标是设计一种抽象,使多智能体系统既能保留自然语言通信的表达力和端到端提示词优化的收益,又能让路由、格式、终止等执行接口对“提示词漂移”免疫。具体包括四件事:把执行关键协议表示为类型化、运行时校验的程序对象,并置于优化器不可触碰的冻结槽位;形式化由此获得的程序安全性质(协议稳定性引理);在 Python 库 cdsep 中实现这一可强制执行的接口;在 BBH 推理、MARG 评论生成、合成核保与行业验证核保四类任务、三个 LLM 家族上实证验证:协议最终有效率达到 100%,同时任务性能稳定超过 Fixed 提示与 DSPy 系基线。
与已有工作不同的是,已有工作分两条线,都没堵住这个洞。提示词优化线(APE、OPRO、TextGrad、DSPy、SAMMO、GEPA)把提示词当可编辑参数,一般不保证优化后的提示词仍满足外部解析器或路由器的契约;DSPy 的签名虽有结构化约束,但只作用于框架内部,编译后的程序仍可能破坏外层控制器。约束生成线(PICARD、LMQL、Outlines、XGrammar、instructor)在解码或 API 层强制输出格式,却不控制“优化器可以编辑哪些提示词字段”。本文的独特切入是把编译器的语言/元语言分离、网络协议的包头/载荷分离这一经典软件工程原则,显式落地为多智能体提示词优化的可执行约束:schema 脚手架进冻结槽位、路由只读已校验控制对象,并给出引理级别的形式化保证和逐组件消融验证。
核心方法
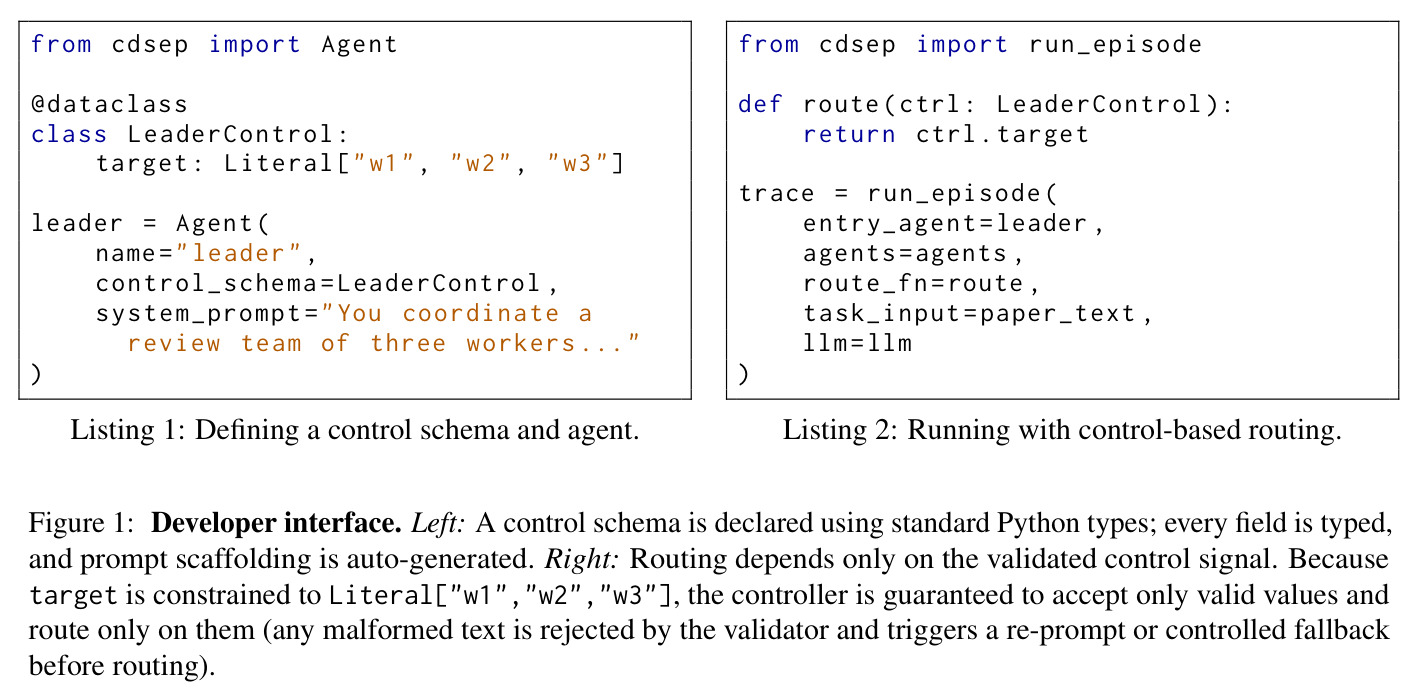
直觉:智能体输出的读者有两类——程序控制器读协议,其他智能体和优化器读内容——那就让两类信息走两条通道。技术上,论文把智能体 $i$ 在步骤 $t$ 的输出表示为二元组 $y_t^i = (c_t^i, m_t^i)$:$c_t^i$ 是控制流对象,由类型化 schema $S_i$(Python dataclass/Pydantic,枚举字段用 Literal 封闭集合)定义,承载路由目标、动作标签、终止信号;$m_t^i$ 是自由文本数据流消息,承载实质性任务内容。控制器只根据通过校验的 $c_t^i$ 做执行决策,绝不解析 $m_t^i$;优化器只能编辑数据通道的提示词。schema 脚手架由框架自动生成并放进优化器无法读写的冻结提示词槽位;解析或校验失败时有界重试(最多 2 次)或回退到合法默认控制。智能体仍可交换丰富的自然语言消息、交互图仍可依赖智能体决策,整体效果是:策略可优化,协议不可破坏。
核心创新是把“协议”从提示词文本中剥离出来,物化为一个优化器无法访问的类型化程序对象(冻结 schema 槽位 + 运行时校验 + 只读控制对象的路由函数)。与已有方法的本质区别在于安全性的来源:TextGrad、DSPy 等依赖优化器“自觉”保持格式指令,逐样本反馈一旦诱导它改写格式就会崩塌;本文的保证是构造性的——协议根本不在可编辑面上,优化器无论怎么改,都只能改变“在协议内如何行动”(选哪个合法动作、何时停止),不能改变协议本身(schema 字段、取值集合、校验逻辑全部固定)。按作者的说法,这把灾难性失败(崩溃、非法路由)转化为可度量、可继续优化的普通任务失败,实现了稳定性与任务质量的解耦。
方法步骤详情
流程分七步。(1) 开发者声明控制 schema,如 LeaderControl 含 $action \in \{send, stop\}$ 与 $target\_agent \in \{worker\_1, ..., none\}$ 的 Literal 字段。(2) 框架自动生成 schema 脚手架(JSON 指令与示例),放入优化器不可读写的冻结槽位。(3) 每步控制器按路由函数选中智能体,LLM 返回候选二元组 $(\hat{c}_t^i, \hat{m}_t^i)$。(4) 用 schema $S_i$ 校验 $\hat{c}_t^i$:解析或校验失败则重试至多 2 次,仍失败则回退到合法默认控制对象或受控失败,绝不把非法控制当合法使用。(5) 路由函数签名形如 route(ControlType) -> NextAction,只读 $c$ 不读 $m$,返回下一智能体名或 terminate。(6) 通过校验的 $(c_t^i, m_t^i)$ 记入交互轨迹,供后续智能体与优化器观察。(7) 每轮 episode 后,优化器拿到任务级损失与逐样本反馈,只改写数据通道提示词,迭代 $K$ 轮(BBH 6 次、评论 3 次、核保 8 次)。
技术新颖性
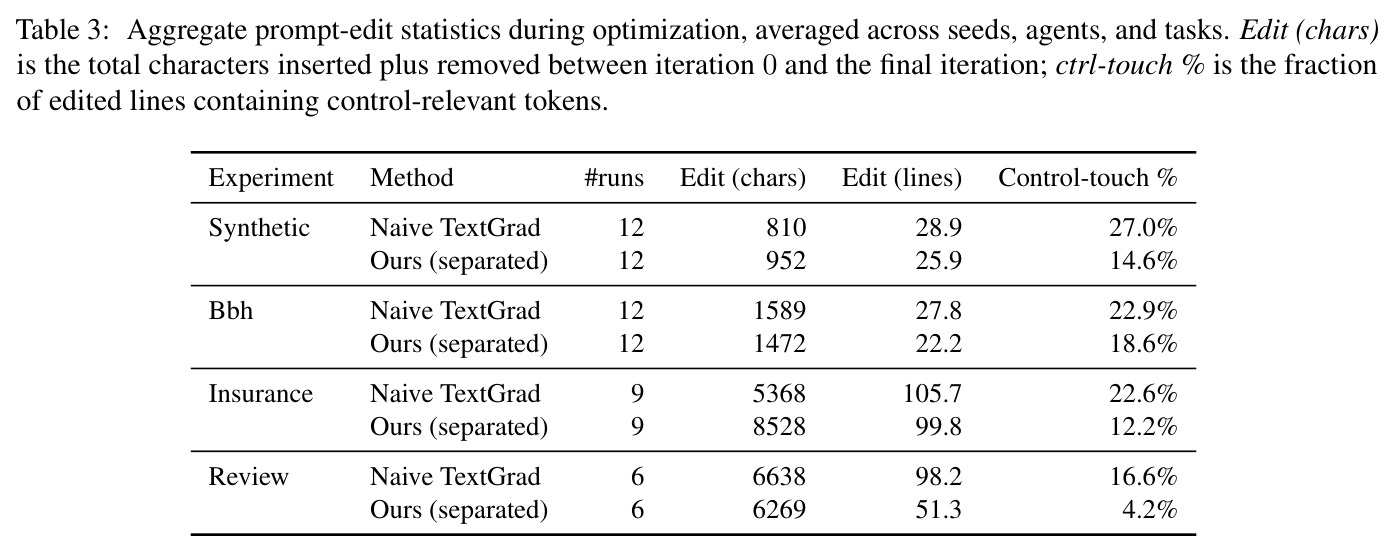
新颖性有四点。其一,问题被显式命名并量化:论文首次把“提示词优化破坏多智能体协议”作为独立失败模式研究,用稳定性指标和逐迭代曲线刻画其发生过程,Table 3 显示 naive 优化器 16.6% 的编辑行触碰控制面(JSON、字段名、输出格式等 token),是本文方法(4.2%)的近 4 倍。其二,保证是形式化的:引理 1 用三个条件——C1 路由只接受类型化控制对象、C2 schema 脚手架位于优化器不可读写的冻结槽位、C3 解析/校验失败时有界重试或回退——证明任意提示词与输入下,episode 轨迹中不出现任何未处理的解析、校验或路由违规;三条件恰好对应消融实验的三个组件。其三,与 DSPy 签名不同,schema 隔离在优化器不可达的槽位且路由只消费已校验对象;与约束解码不同,本文控制的是“哪些提示词字段可被编辑”而非解码过程本身,二者互补。其四,提供了可强制执行的 Python API(cdsep),把惯例升级为程序接口。
实验结果
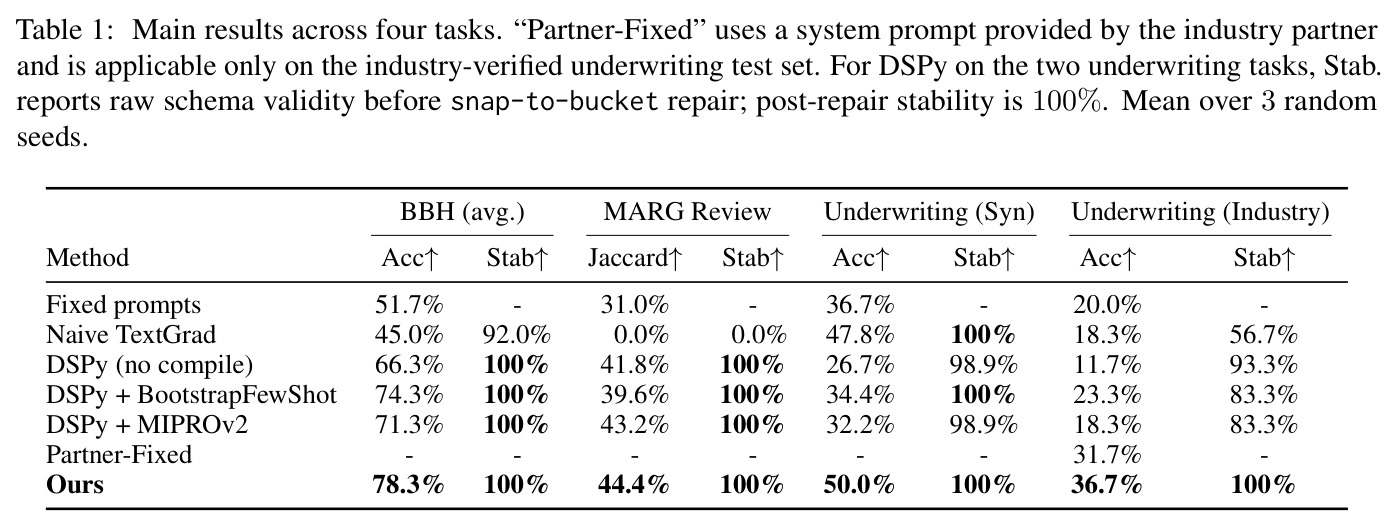
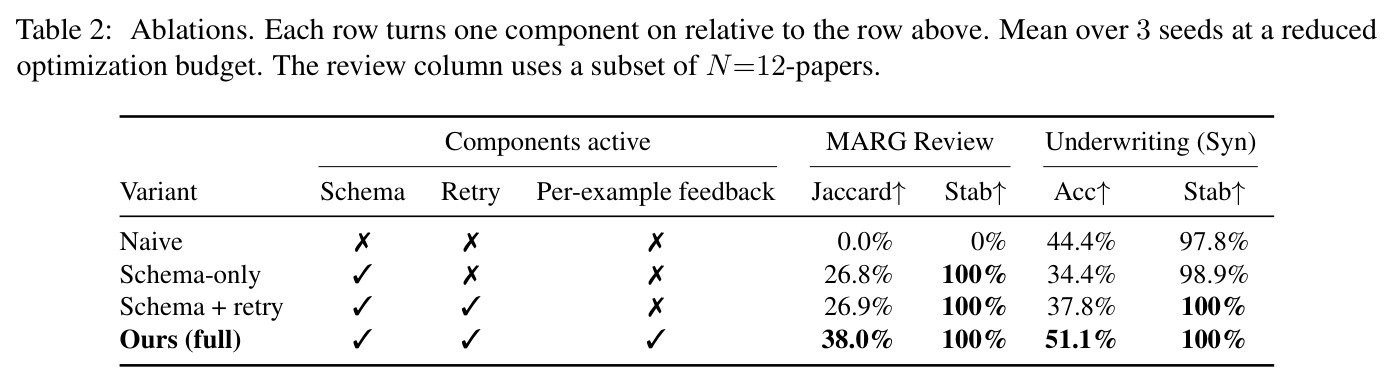
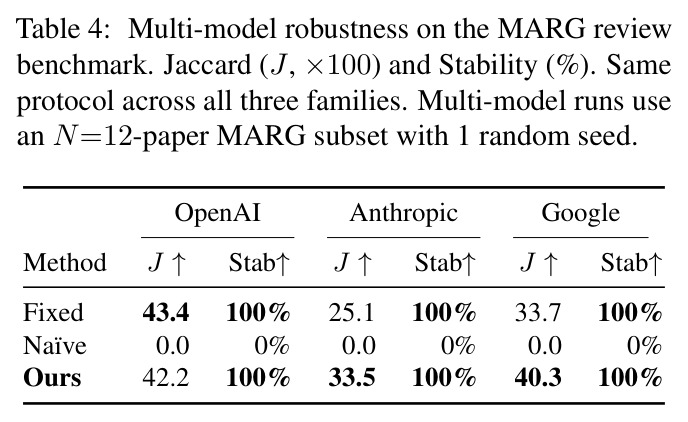
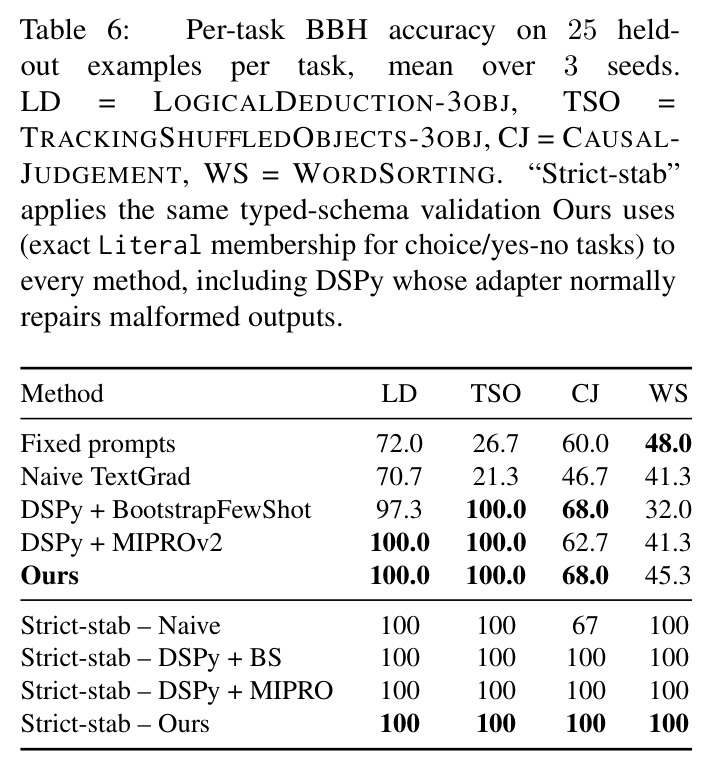
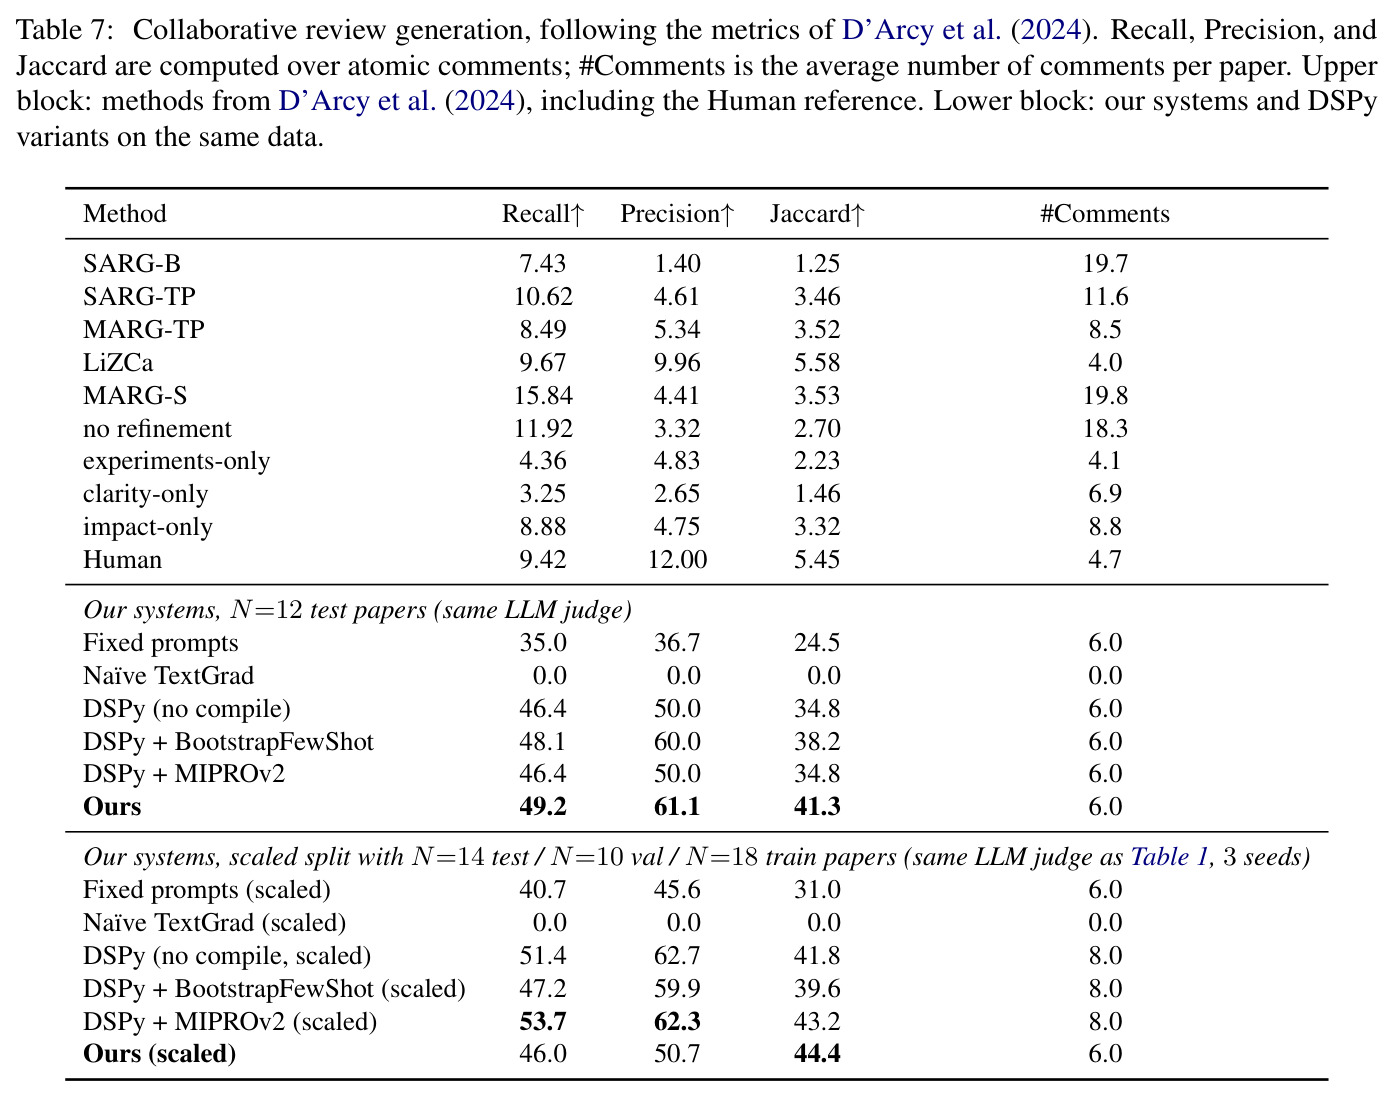
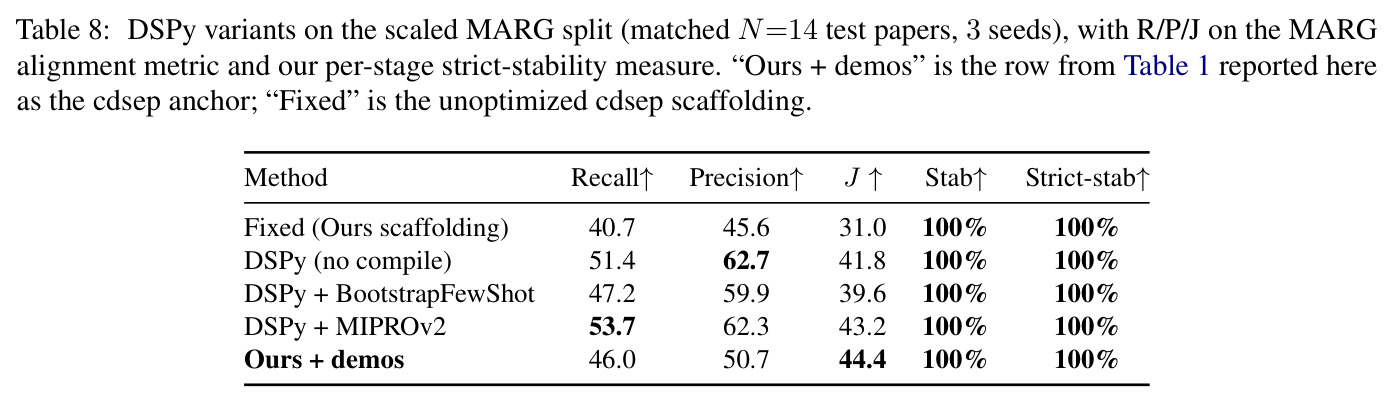
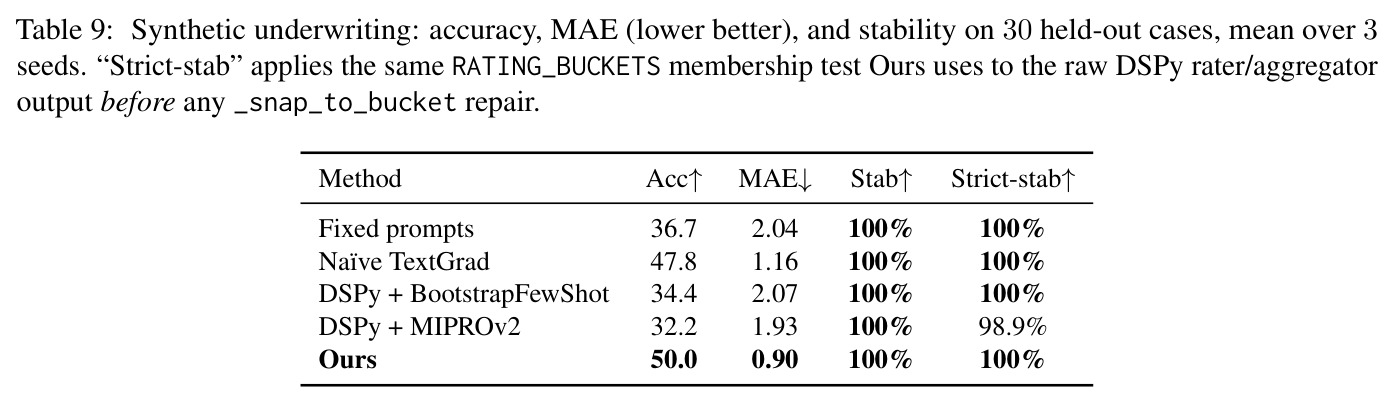
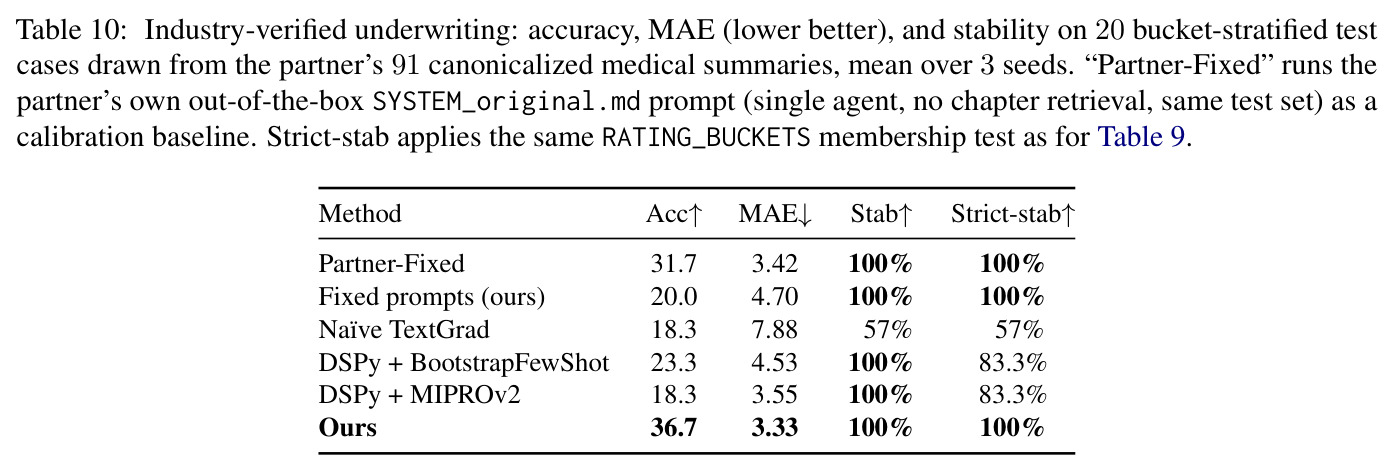
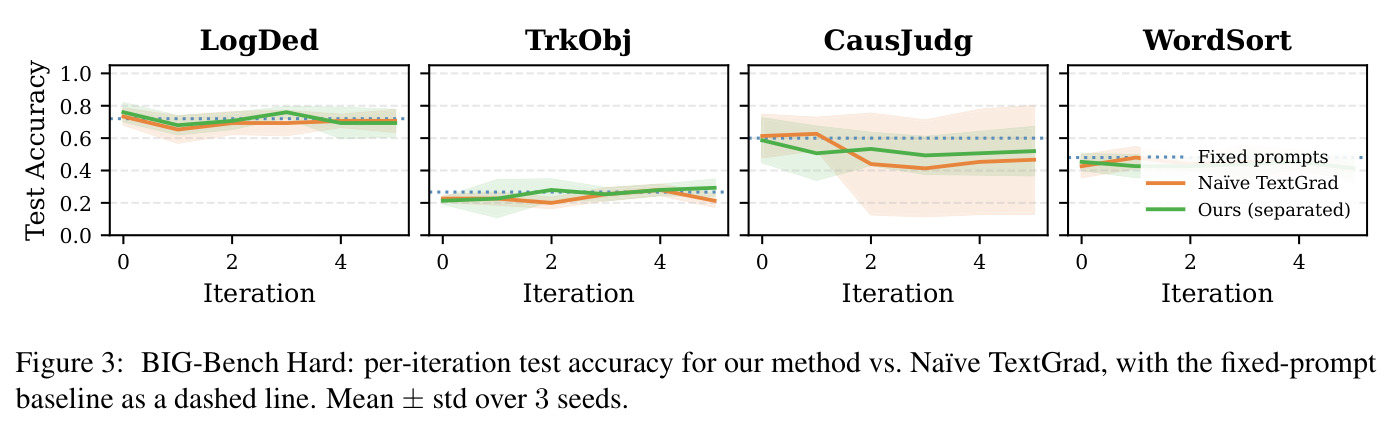
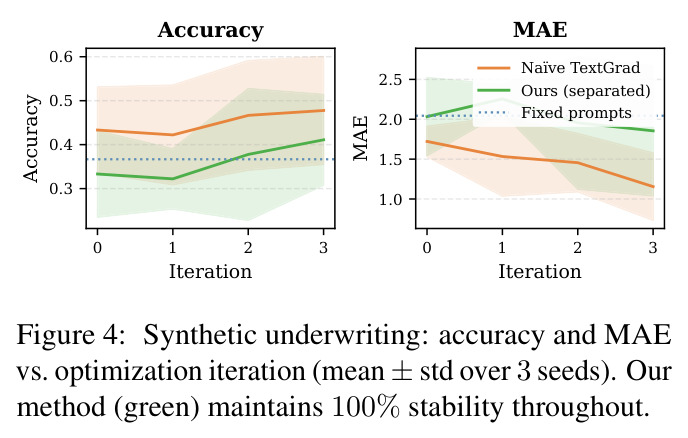
主实验(Table 1,3 seeds 均值)显示方法在四个任务上全部领先且协议稳定性 100%。BBH 平均准确率 78.3%,超最佳 DSPy 基线 BootstrapFewShot 的 74.3% 与 Fixed 的 51.7%,naive 仅 45.0%;逐子任务 LD 100%、TSO 100%、CJ 68.0%、WS 45.3%。MARG 评论生成 Jaccard 44.4,超 MIPROv2 的 43.2 与 Fixed 的 31.0,naive 崩至 0.0(稳定性 0%)。合成核保准确率 50.0%、MAE 0.90,优于 naive 的 47.8%/1.16 与 Fixed 的 36.7%/2.04。行业验证核保 36.7%,比合作方专家提示 Partner-Fixed(31.7%)高 5 个百分点,naive 仅 18.3%、稳定性 56.7%。消融(Table 2)表明:schema 脚手架是稳定性主因(评论任务 0%→100%);解析重试补齐最后约 1%(核保 98.9%→100%);逐样本反馈是质量主因(评论 Jaccard 26.9→38.0,核保 37.8→51.1)。多模型实验(Table 4)中,OpenAI/Anthropic/Google 三家族下本文方法均 100% 稳定,Jaccard 为 42.2/33.5/40.3,naive 三家族全部 0% 稳定。DSPy 在行业任务的严格 schema 有效率仅 83.3%,说明其 snap-to-bucket 事后修复掩盖了原始非法输出。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BBH 四任务平均(单智能体推理) | Accuracy | 78.3% | DSPy + BootstrapFewShot 74.3%(Fixed 51.7%,Naive TextGrad 45.0%) | +4.0 个百分点 |
| MARG 评论生成(leader-worker 多智能体) | Jaccard(LLM 裁判对齐) | 44.4 | DSPy + MIPROv2 43.2(Fixed 31.0,Naive 0.0) | +1.2,并在稳定性上避免完全崩塌 |
| MARG 评论生成 | Episode 稳定性 | 100% | Naive TextGrad 0% | +100 个百分点,消除协议崩塌 |
| 合成核保(extractor→rater→aggregator 三智能体链) | Accuracy / MAE | 50.0% / 0.90 | Naive TextGrad 47.8% / 1.16 | +2.2 个百分点,MAE 降低 0.26 |
| 行业验证核保(91 份合作方医学摘要,20 分层测试例) | Accuracy | 36.7% | Partner-Fixed 31.7%(DSPy + BootstrapFewShot 23.3%) | +5.0 个百分点 |
| 行业验证核保 | Episode 稳定性(含严格 schema 校验) | 100% | Naive TextGrad 56.7%;DSPy 严格校验 83.3% | 唯一同时达到 100% 稳定与最高精度的配置 |
局限与改进
作者承认的局限:稳定性不等于正确性,协议有效不保证语义正确或事实准确;MARG 评测依赖 LLM-as-judge,继承裁判模型固有偏差(论文以全程固定 gpt-5.4-mini 作裁判缓解跨条件差异);schema 需预先声明,不支持动态创建智能体或运行时演化;因裁判从 GPT-4 换成 gpt-5.4-mini,本文 MARG 绝对 Jaccard 与已发表数值不可直接比较。我的补充观察:测试集很小——BBH 每任务仅 25 例、行业核保每 seed 仅 20 例、多模型实验只用 12 篇论文且单种子,MARG 上对 MIPROv2 的领先(44.4 vs 43.2)很可能在噪声范围内,OpenAI 家族子集上 Fixed(43.4)甚至高于 Ours(42.2);naive TextGrad 基线未加任何格式保护,略显“稻草人”;优化引擎只测了 TextGrad 风格,未验证与 GEPA、OPRO 的组合;重试机制带来额外延迟与 token 开销;协议保证只覆盖解析/校验/路由,不覆盖“合法但错误”的路由决策质量。
独立分析的弱点
独立分析四点弱点。其一,评测规模与统计功效不足:行业任务每 seed 仅 20 例、3 seeds,36.7% 对 31.7% 的领先缺少显著性检验,MARG 的 +1.2 Jaccard 更是边缘优势;改进方向是扩充分层测试集并报告置信区间或做配对检验。其二,把复杂性从提示词调优转移到了 schema 设计:12 章/28 章医学分类学、Literal 枚举都要领域专家手工维护,冷启动成本高,且 schema 质量直接决定系统上限;可探索从历史交互日志自动归纳 schema 候选的方法。其三,保证只作用于语法层:一个通过校验但语义错误的路由(例如总是把任务派给同一位工人)不会被任何机制拦截,性能仍会静默退化;可为控制通道引入策略级反馈,或对路由分布施加约束与监控。其四,对比设置欠公允:DSPy 的输出修复机制(snap-to-bucket)被用来指责其“掩盖”非法输出,但更公平的做法是对 DSPy 也施加同等的冻结槽位改造;另外最多 2 次重试的预算是手工设定的,如何随模型能力与协议复杂度自适应未被讨论。
未来方向
作者明确提出的方向:把控制-数据流分离扩展到动态智能体创建与运行时 schema 演化场景;与现有优化器组合——论文声称本框架与 MIPROv2、GEPA 等互补,可在程序边界强制控制通道有效性;用语法约束解码(Outlines、XGrammar)实现控制通道的生成,进一步压低重试率。基于本文成果可延伸的研究:一是 schema 自动合成与版本管理,从失败轨迹中挖掘应纳入封闭集合的新取值,降低专家维护成本;二是把分离原则推广到工具调用、MCP 类接口等更广义的 LLM-程序边界;三是在核保、评审等高风险领域引入人在回路与公平性审计(作者在伦理声明中已提示提示词优化可能放大底层模型与数据的偏见);四是建立语义层保证,例如对路由策略收敛性或数据消息质量下界的理论分析;五是研究重试预算、模型能力与协议复杂度之间的最优分配策略。
复现评估
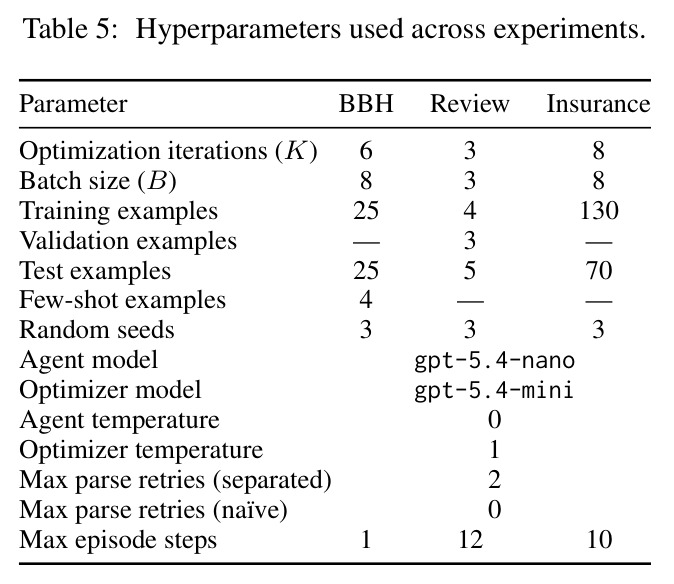
复现条件整体较好。代码以 MIT 协议开源(github.com/yuntian-group/cdsep),完整 leader-worker 流水线少于 40 行 Python,库含 77 个单元/集成测试(约 1 秒跑完),要求 Python ≥ 3.10、pydantic ≥ 2.0。BBH 与 MARG/ARIES 语料公开。全部实验无需本地 GPU,仅调用商业 API,单台 Linux 服务器即可;头部 MARG 实验(3 轮迭代、3 seeds、gpt-5.4-nano 智能体 + gpt-5.4-mini 优化器)API 开销约 3 美元,确定性调用有磁盘缓存。超参数完整公开(Table 5:K=6/3/8,批大小 8/3/8,温度 0/1,分离模式最多重试 2 次)。障碍有二:行业验证核保的 91 份摘要与合作方手册不随代码再分发,需单独授权才能复现 Table 10;模型为闭源 API 版本,供应商更新后结果可能漂移。综合评定:公开任务部分复现难度为入门到中等,行业部分基本无法独立复现。
论文图表
用 cdsep 完整实现 leader-三 worker 评论生成流水线:dataclass 定义 LeaderControl(action: Literal["send","stop"]、target_agent: Literal["worker_1".."none"])与 WorkerControl,route 函数只根据控制对象返回 terminate 或目标工人,run_episode 一次调用完成整条流水线,总共不足 40 行 Python。
证明框架的表达力与轻量性——完整多智能体流水线代码量极小且协议保障内建于接口,是评估工程可用性的关键材料。