EM²Mem:面向大语言模型的事件中心多模态记忆框架 EM^2Mem: Event-Centric Multimodal Memory for Large Language Models
把异构多模态证据在构建期对齐到事件锚点,用事件级记忆细胞替代孤立片段,实现高效可溯源的长视频问答。
前置知识
检索增强生成(RAG)
在 LLM 生成答案前,先从外部知识库检索与问题相关的证据片段并拼进上下文。典型流程是“查询→向量/关键词检索→证据拼接→生成”,让模型不必把所有知识压进参数或上下文窗口。VideoRAG、HippoRAG、LightRAG 等把该思路扩展到视频与图结构记忆。
EM²Mem 的推理阶段本质是一次事件级 RAG 读出,理解它与标准 RAG 的差异——检索单位是完整事件细胞而非文本块——是读懂其实验设计与效率分析的前提。
长视频问答(Long-video QA)
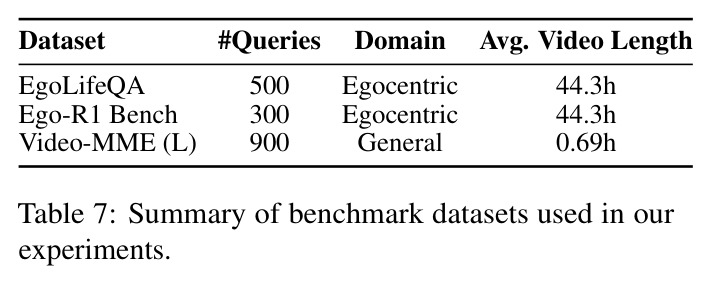
评估模型回答关于几分钟到几十小时视频问题的任务:证据在时间轴上稀疏分布,且跨越画面、语音转录、OCR 等多种模态。由于任何上下文窗口都装不下整段视频,通常必须借助外部记忆或检索机制。EgoLifeQA 等第一视角基准的视频长达 44.3 小时。
本文的问题设定与三个评测基准都来自这一任务,所有指标(分类准确率、严格事件级召回、延迟)都需要在该任务背景下理解。
情节记忆与语义记忆
认知科学中的记忆二分:情节记忆存储具体经历(何时何地发生了什么),语义记忆存储从中抽象出的长期规律(习惯、偏好、稳定关系)。HippoMM、HippoRAG 等记忆系统借鉴这一划分来组织存储。
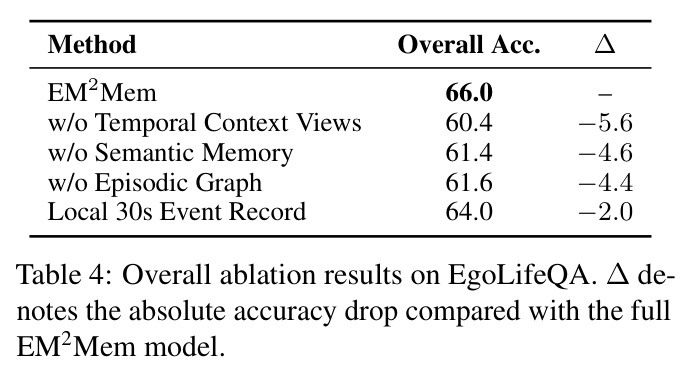
EM²Mem 的双层图结构——情节图 $G_E$ 连接具体事件、语义图 $G_S$ 存放长期事实——直接对应这一区分,消融实验也分别验证了两者的贡献。
事件认知(Event Cognition)
心理学理论(Zacks、Radvansky 等)认为人类会把连续的感知流离散化为有边界的事件单元来编码、检索与更新,事件边界通常对应目标或场景的显著变化。
这是本文最核心的设计灵感:把“事件”当作记忆的索引单位而非普通视频时间段,理解它才能理解 align-then-retrieve 范式的动机。
多尺度时间聚合
对同一视频在不同时间粒度(如 30 秒/3 分钟/10 分钟/1 小时)上分别建立摘要:短粒度保留细节,长粒度保留全局脉络,检索时同时利用多个粒度的信号来回答不同时间跨度的问题。
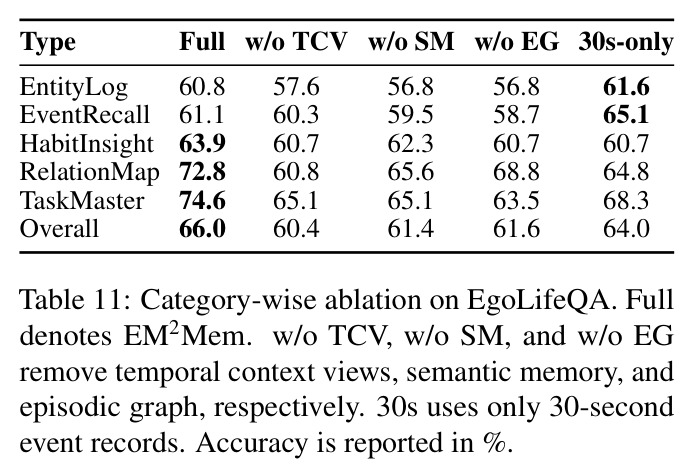
消融显示去掉时间上下文视图损失最大(−5.6 点),多尺度视图是 EM²Mem 支撑跨事件、长程推理的关键组件。
倒数排序融合(RRF)
一种无需调参的多路检索融合方法:每个通道(向量、关键词等)给出独立排序,文档的融合得分是其各通道排名倒数之和 $\sum_r \frac{1}{k+r}$,从而把多路检索结果合并成单一列表。
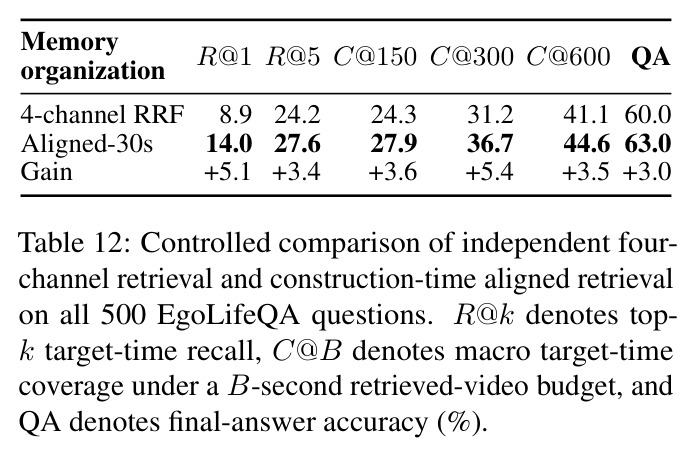
附录 Table 12 用 4 通道 RRF 代表“检索期融合”作对照,证明 EM²Mem 的优势并非来自更多检索通道,而是来自构建期的证据绑定。
研究动机
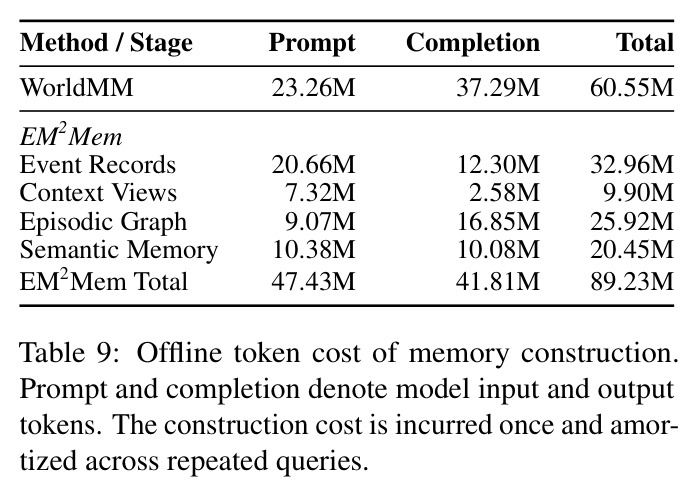
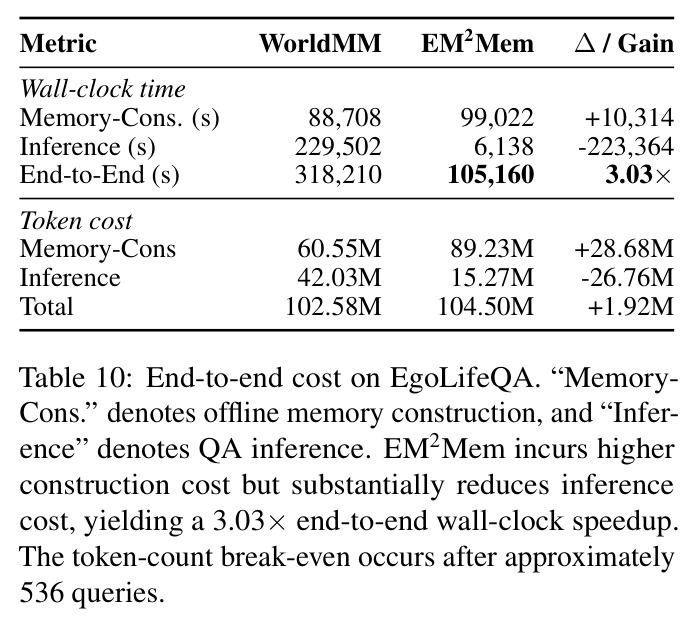
现有长视频问答的记忆系统几乎都是“片段中心”的:它们把视频压缩成单一模态的可检索单元——字幕、关键帧、转录片段、摘要、嵌入向量或知识图谱三元组(如 VideoRAG、HippoRAG、HippoMM、WorldMM)。这类单元虽然可搜索,却不可直接用于生成:用户的问题通常指向事件、行为和时序关系,而库里只有孤立的帧、句子和边。于是系统陷入“检索后再对齐”(retrieve-then-align)瓶颈——先取回零散片段,再让 LLM 在推理时重建缺失的跨模态与时间绑定,而此时上下文预算最紧张、归因也最难。以 EgoLifeQA 为例,视频是长达 44.3 小时的一周第一视角录像,证据稀疏、时间上相距甚远;最强基线 WorldMM 需要五轮迭代检索,平均单查询延迟高达 459 秒,500 题推理消耗 42.03M token,效率与可扩展性同样堪忧。
本文的目标是本文的目标是把多模态记忆的检索单元从“孤立片段”重构为“事件”:在记忆构建阶段就把异构证据(字幕、转录、关键帧、结构化字段、多尺度时间上下文、图关系与来源信息)绑定到共享的事件锚点上,形成即取即用、可溯源的记忆细胞;再辅以事件链接的情节图与语义图,支持跨事件关系和长期规律的推理。量化的目标是在三个长视频问答基准上同时超越最强记忆基线 WorldMM 的准确率、证据定位精度(严格 30 秒事件级召回)与推理效率(单查询延迟、token 成本),并用控制变量实验验证“构建期统一对齐优于检索期融合”这一核心假设。
与已有工作不同的是,本文的独特之处在于换了一个提问方式:不问“该存多少信息”,而问“如何组织异构证据才能与提问和作答方式对齐”。作者借鉴事件认知理论(Zacks 等),把事件视为大脑组织感知、语言、行动与时间边界的天然单元,进而提出把事件锚点当作“语言可寻址的记忆索引”而非普通时间段,并以 align-then-retrieve(先对齐后检索)取代主流的 retrieve-then-align(先检索后对齐):把跨模态对齐从推理期前移到构建期。更难得的是,与共享大量组件的 WorldMM 不同,作者设计了控制变量实验——在相同的 6,057 条 30 秒底层记录上,对比四通道 RRF 检索期融合与构建期绑定(Aligned-30s)两种索引方式——从而把收益干净地归因到“记忆的组织方式”本身,而非额外的多尺度、图或语义组件。
核心方法
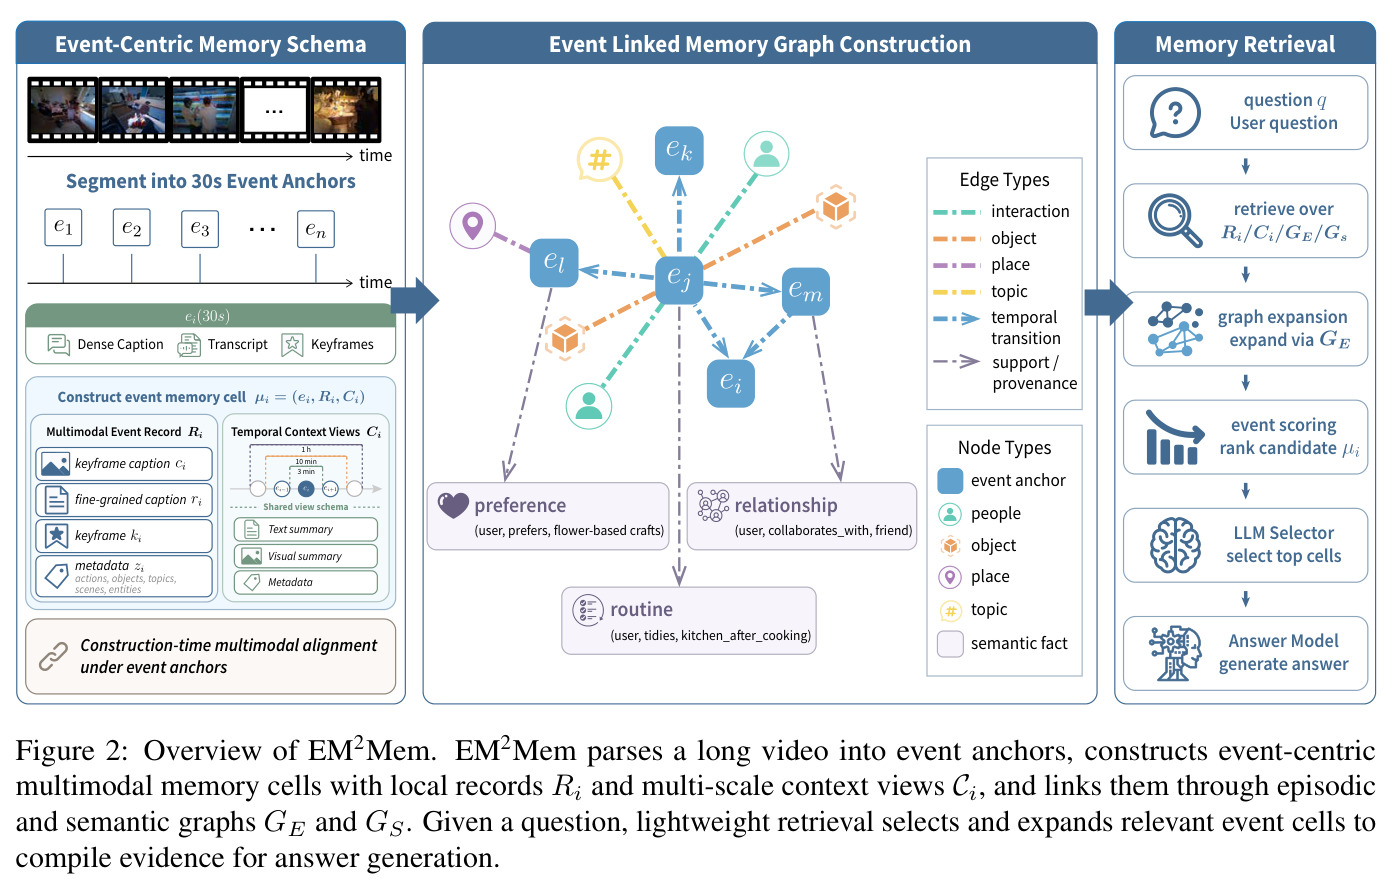
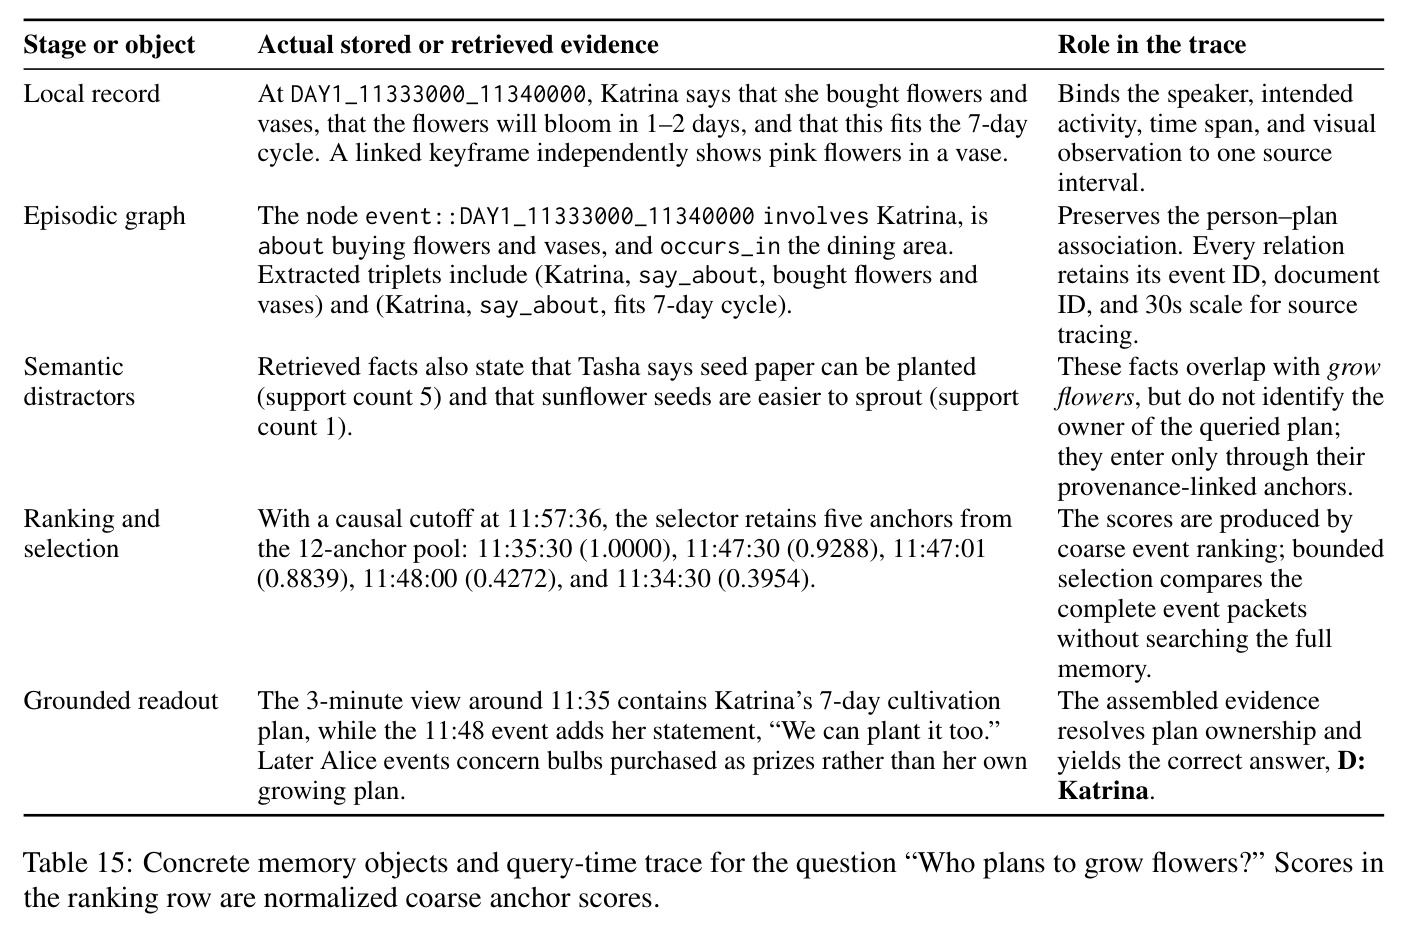
直觉上,人脑以事件为单位组织经历,问题也以事件为粒度提出,那么记忆最好同样以事件为粒度存储。技术路线分三步。第一步,把长视频切成约 30 秒的基底段,为每段分配事件锚点 $e_i = (i, \tau_i^s, \tau_i^e)$——它只是一个时间地址而非记忆内容,充当异构证据的统一索引键。第二步,构建以锚点为中心的事件中心多模态记忆细胞 $\mu_i = (e_i, R_i, C_i)$:局部记录 $R_i$ 存放关键帧字幕、转录、代表性关键帧与结构化元数据(动作、物体、话题、场景、实体);多尺度时间上下文视图 $C_i$(3 分钟/10 分钟/1 小时)把相邻事件聚合成叙事与视觉摘要。第三步,建两张轻量图:情节图 $G_E$ 记录实体关系与相邻事件的时间转移,语义图 $G_S$ 沉淀习惯、偏好等长期事实。推理时执行轻量的事件级读出:多信号加权打分→LLM 选择器精选 5 个事件锚→每个附最多 3 张关键帧→编译成紧凑证据视图→生成答案。整个过程免训练,仅靠现成 MLLM 与提示工程组装。
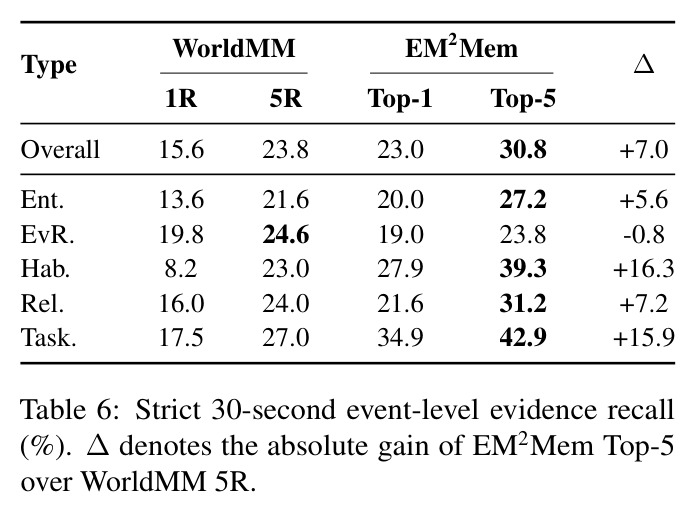
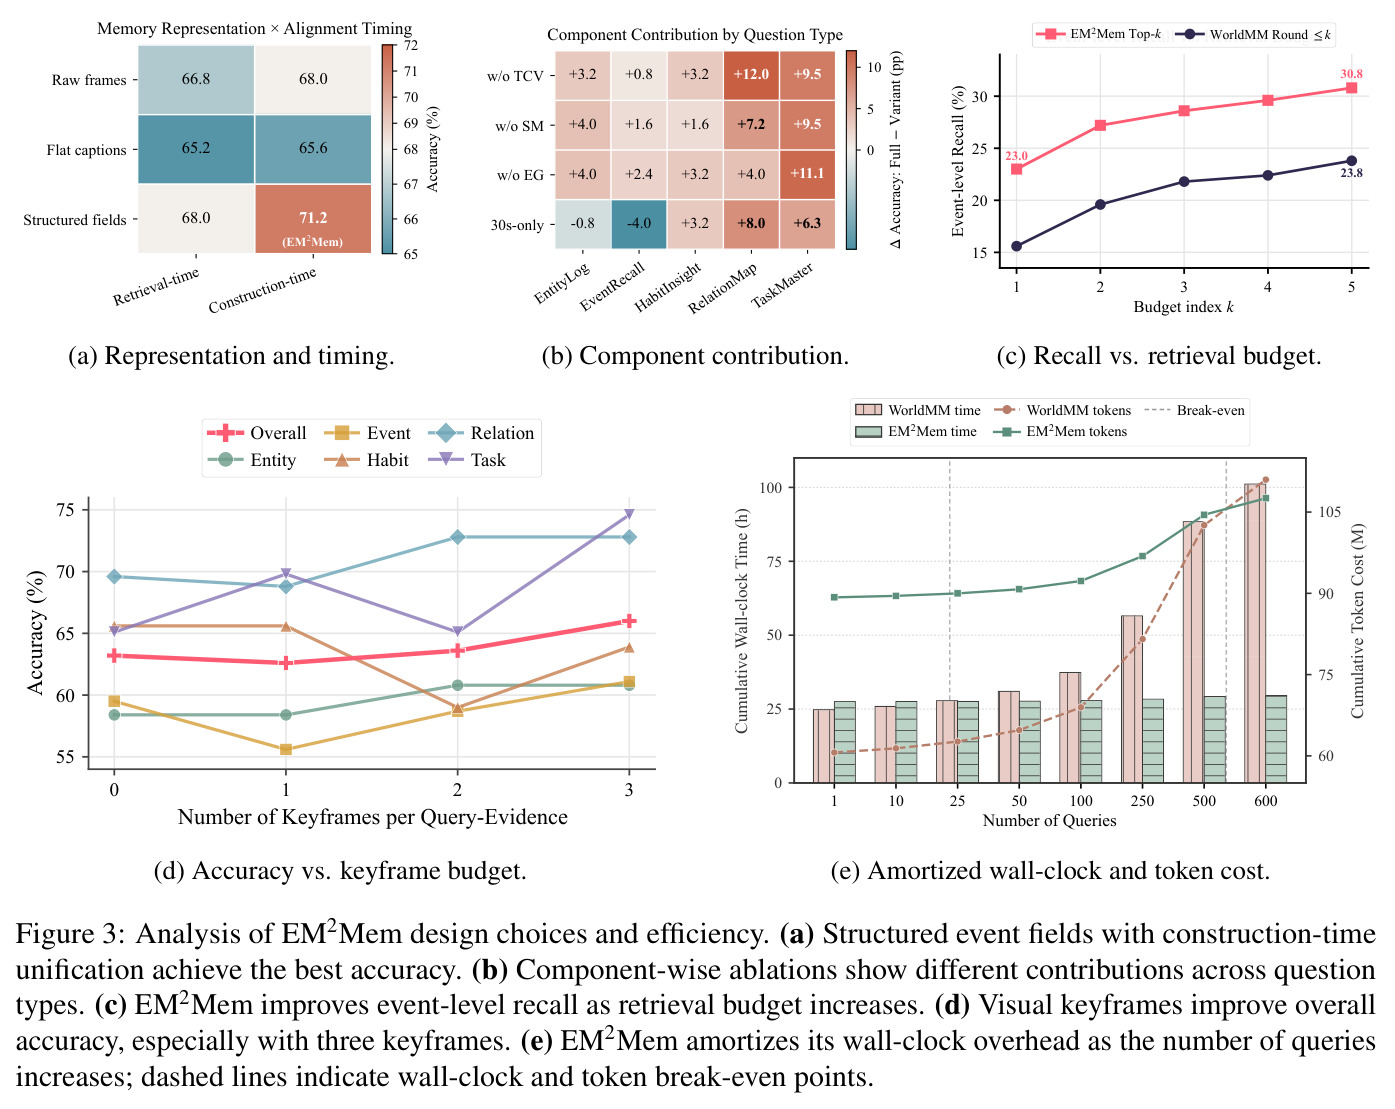
核心创新是“事件锚点作为语言可寻址索引 + 构建期统一绑定”。已有系统(WorldMM、HippoMM、VideoRAG 等)按式 (1) 把视频压缩成模态特异的可搜索单元 $u_j^m = (s_j^m, e_j^m, p_j^m, \tau_j, m, \ell_j)$,检索之后再靠 LLM 重新拼装跨模态关系;EM²Mem 则把字幕、转录、关键帧、类型化结构字段、多尺度摘要、图关系和来源信息在索引之前就绑定进同一个事件细胞,使检索单位从“片段”变成“携带完整证据链的事件”。由此带来一个重要性质:作答阶段单遍检索即可逼近基线五轮迭代检索的证据定位水平(Top-1 召回 23.0% vs WorldMM 5R 的 23.8%),相当于把多轮 agent 检索的复杂度折叠进了离线构建。另一个关键设计是把结构化字段当作“可回答接口”:显式的实体、动作、场景字段为 LLM 提供了跨模态对齐的锚点,比原始帧更易检索,比扁平字幕更易归因。
方法步骤详情
(1) 事件锚定:视频切为 30 秒基底段,得锚点 $e_i=(i,\tau_i^s,\tau_i^e)$。(2) 事件记录构建:GPT-5-mini 分文本、视觉两路解析,生成细粒度描述与物体、动作、场景等类型化字段,得 $R_i=(c_i,r_i,k_i,z_i,\tau_i)$。(3) 时间上下文视图:按 3 分钟/10 分钟/1 小时等尺度把相邻记录聚合为文本摘要 $u^{text}$、视觉摘要 $u^{vis}$ 与元数据。(4) 图构建:情节图抽取带事件 ID 溯源的三元组并连接相邻事件的时间转移;语义图用 LLM 合并相似度大于 0.6 的三元组。(5) 检索打分:候选事件得分由局部记录(权重 1.00)、各尺度视图(0.65/0.45/0.30)、情节图候选(5 个)与语义事实(8 个,一跳衰减 0.60)加权。(6) LLM 选择器:先推断七类问题族(行动归属、计划意图等),再选出 $K_{sel}{=}5$ 个互补事件锚,要求至少一条证据直接支撑问题谓词。(7) 编译与作答:每个选中事件附最多 $K_V{=}3$ 张关键帧,组装证据视图 $E_q$ 供作答。
技术新颖性
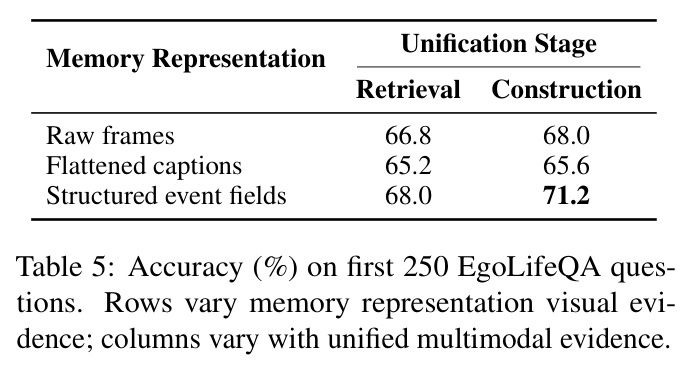
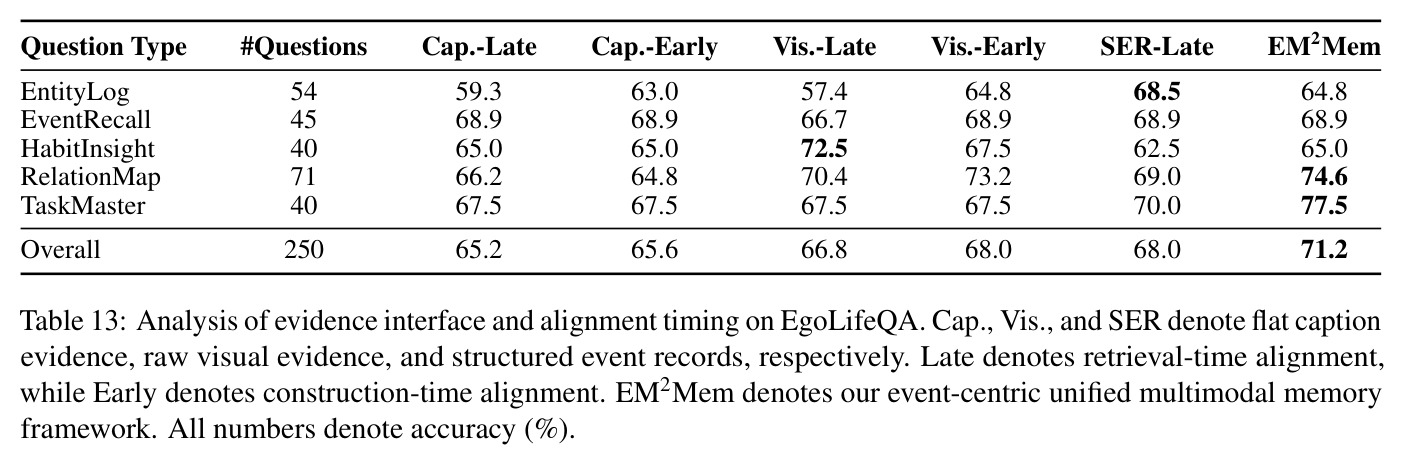
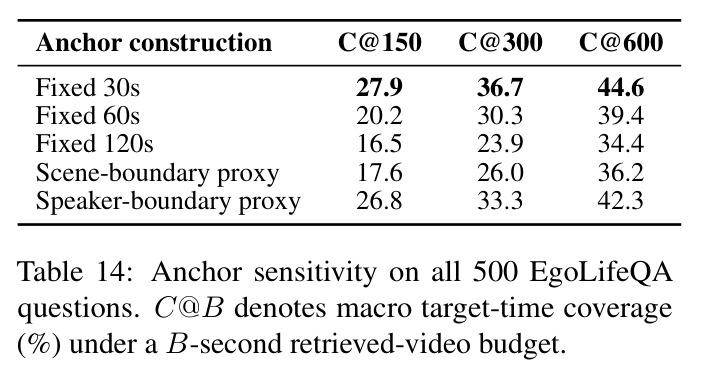
新颖性体现在四个层面。范式层面:align-then-retrieve 把跨模态对齐从推理期前移到构建期;控制变量实验(相同证据、相同模型,4 通道 RRF 对比 Aligned-30s)显示仅改变索引组织方式即可把 R@1 从 8.9% 提到 14.0%、300 秒预算覆盖率提升 5.4 点(McNemar $p=0.0003$),说明收益来自记忆结构本身而非附加组件。表示层面:结构化事件字段充当视觉观察与自然语言问题之间的“可回答接口”,结构化字段+构建期对齐达到 71.2% 准确率,优于原始帧 68.0% 与扁平字幕 65.6%。索引层面:事件锚点被明确定位为时间地址而非语义边界,作者实测固定 30 秒粒度的覆盖率优于 60 秒/120 秒窗口及场景、说话人自适应边界(C@300 为 36.7%,对比 23.9%–33.3%),并诚实报告身份自适应边界在第一视角视频中彻底失效(6 个主角被跟踪成 6,130 个 ID)。工程层面:完全免训练,仅靠提示工程与现成 MLLM 组装,即可同时改善精度、效率与归因三项指标。
实验结果
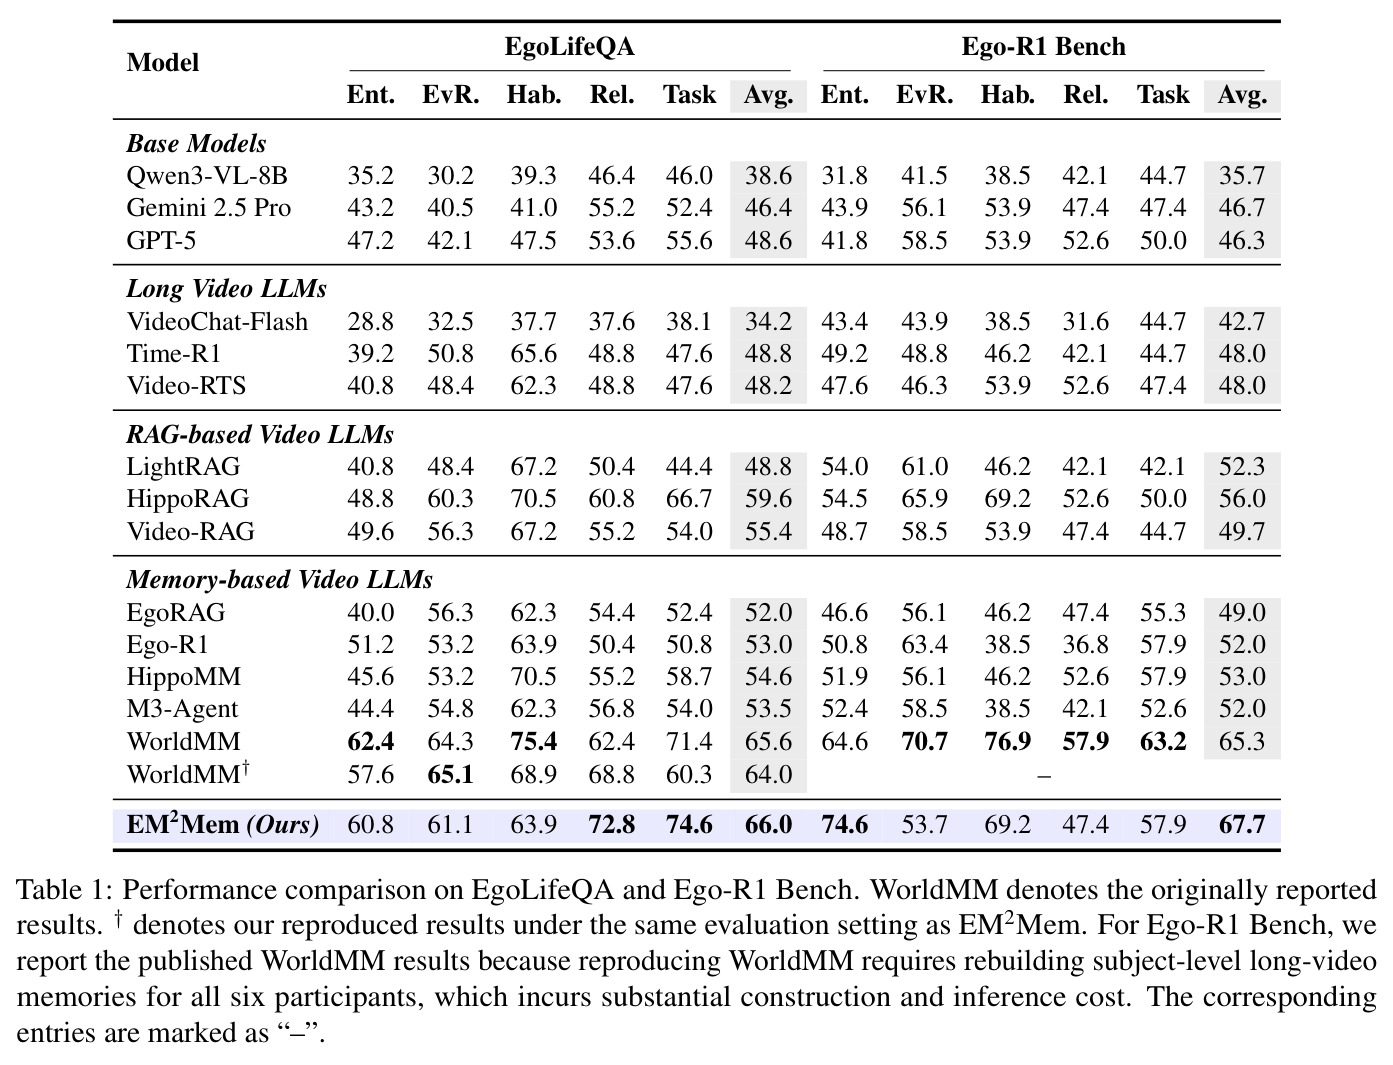
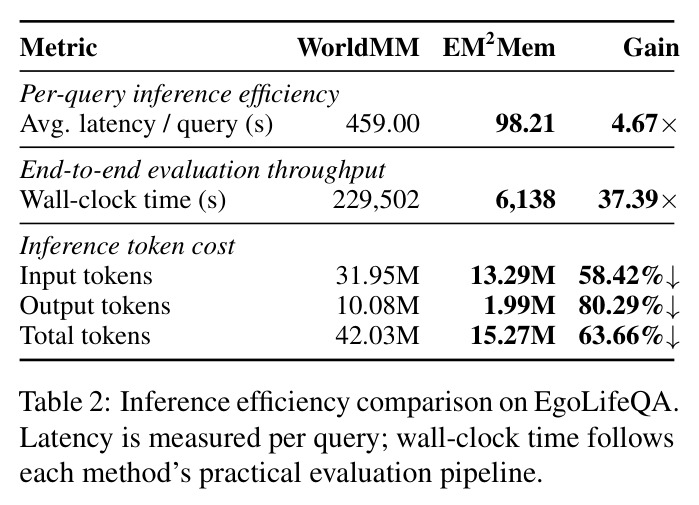
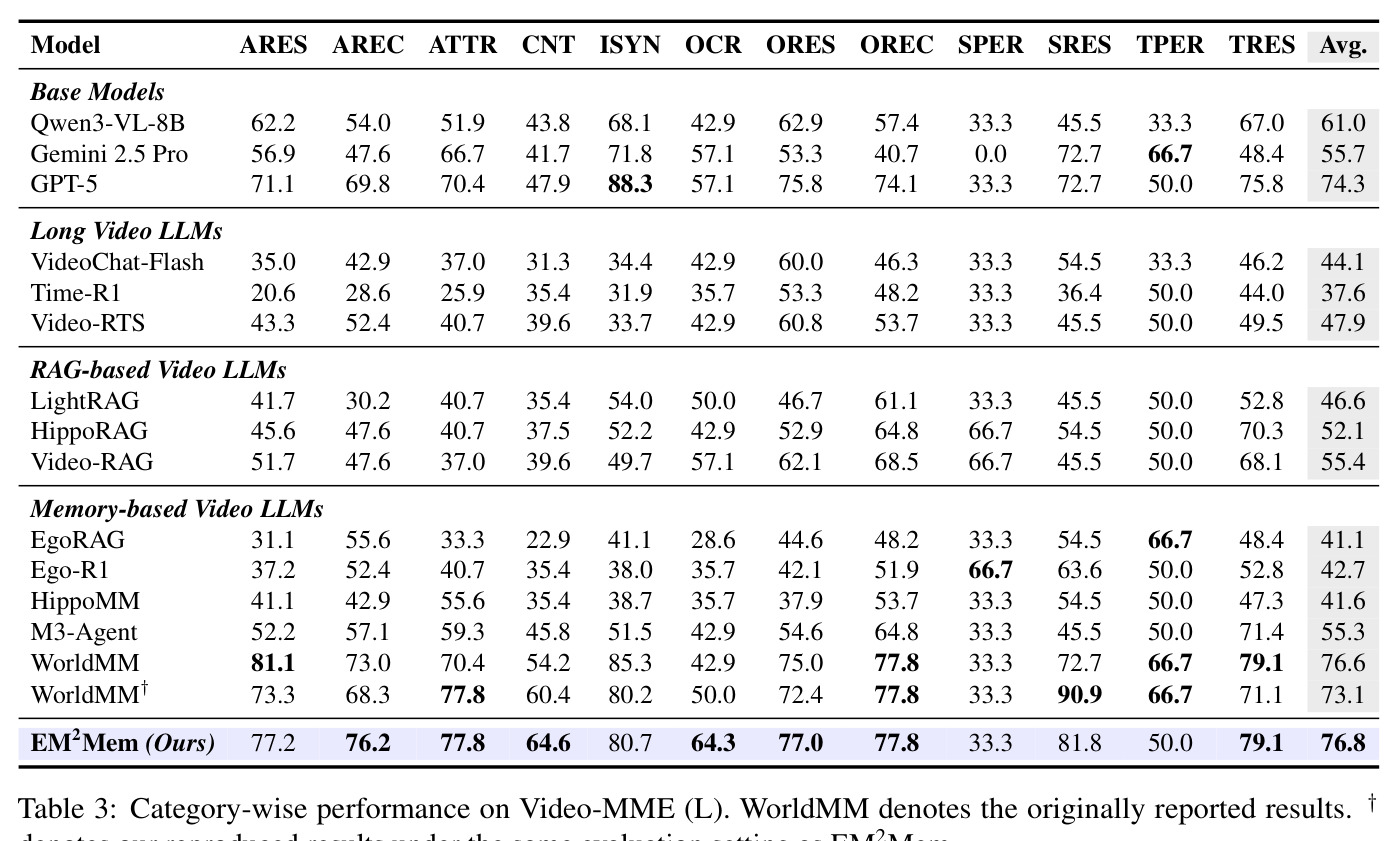
主实验(Table 1/3):EM²Mem 在 EgoLifeQA 平均准确率 66.0%(WorldMM† 64.0%,+2.0),Ego-R1 Bench 67.7%(WorldMM 65.3%,+2.4),Video-MME (L) 76.8%(WorldMM† 73.1%,+3.7),超 GPT-5 直接作答与 14 个基线。效率(Table 2):延迟 459.00s→98.21s(4.67×),墙钟 229,502s→6,138s(37.39×),推理 token 42.03M→15.27M(−63.66%);含构建的端到端 318,210s→105,160s(3.03×),墙钟盈亏平衡约 23–29 次查询、token 约 536 次。消融(Table 4):去时间上下文视图 −5.6、语义记忆 −4.6、情节图 −4.4、仅 30 秒记录 −2.0。分析(Table 5/6):结构化字段+构建期对齐 71.2% 最优;严格事件级 Top-5 召回 30.8%,超 WorldMM 五轮检索 7.0 点;关键帧 0→3 张提升 63.2%→66.0%。
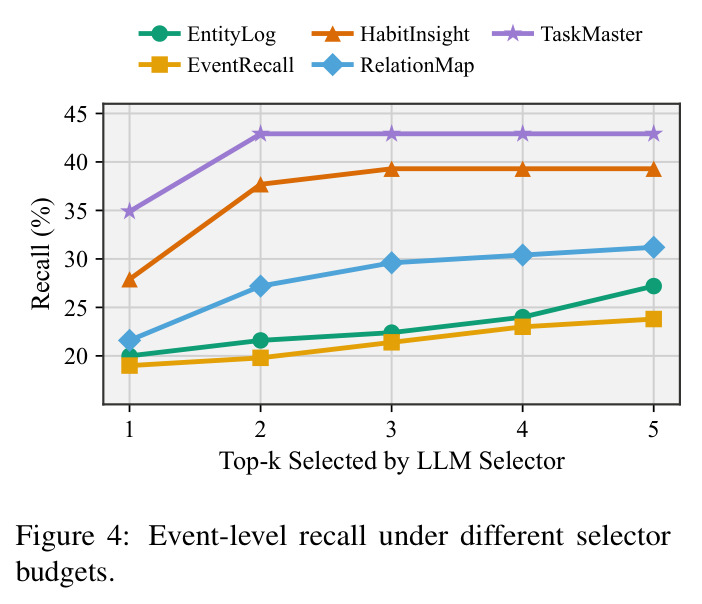
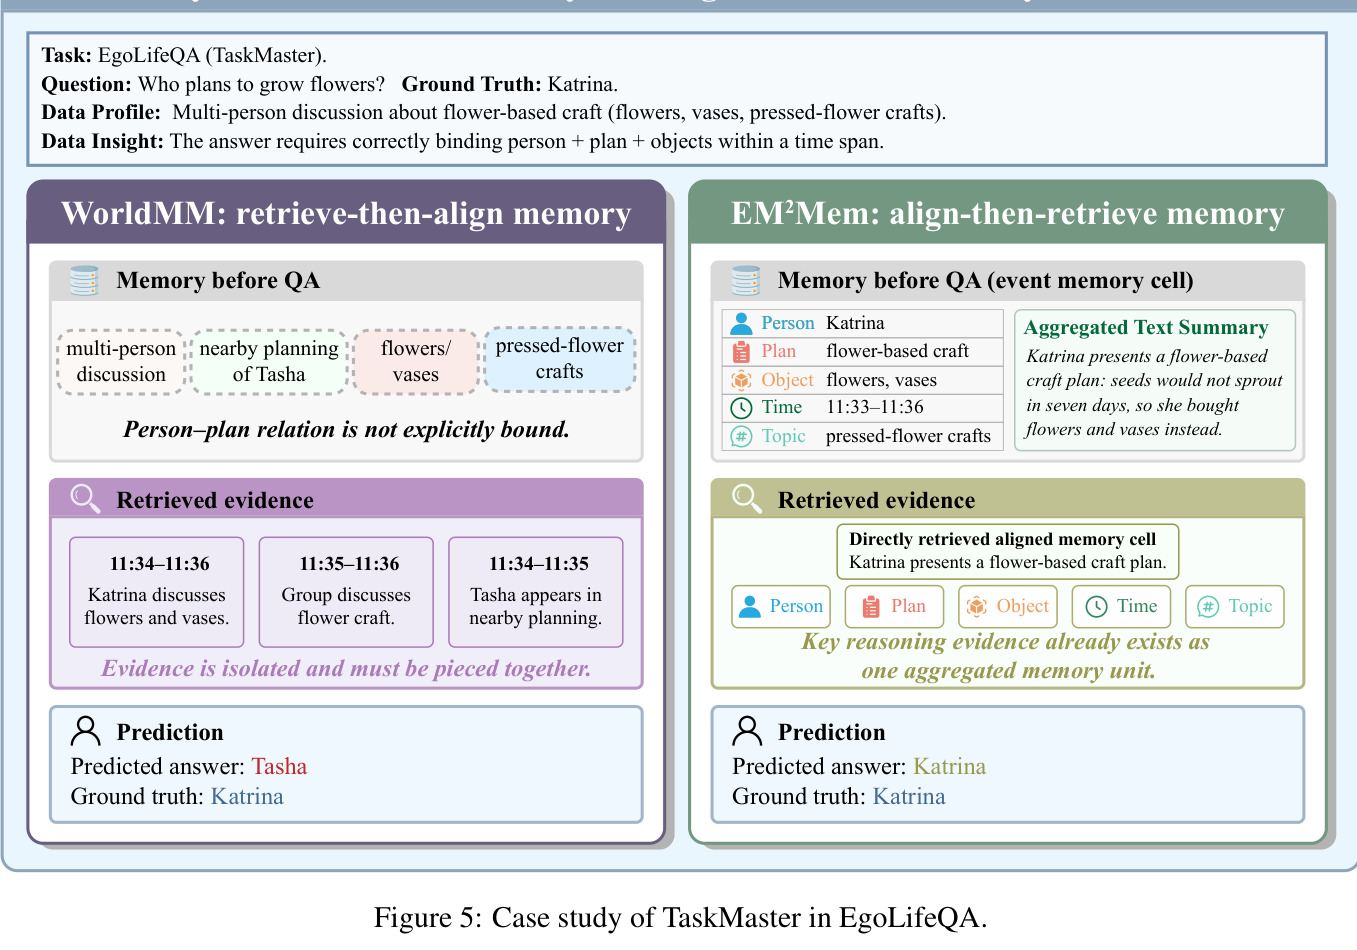
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| EgoLifeQA 长视频问答(500 题,44.3 小时第一视角视频) | 平均准确率 (%) | 66.0 | WorldMM†(同设置复现)64.0 | +2.0 |
| Ego-R1 Bench 超长第一视角推理(300 题) | 平均准确率 (%) | 67.7 | WorldMM(已发表结果)65.3 | +2.4 |
| Video-MME (L) 通用长视频理解(900 题,>30 分钟视频) | 平均准确率 (%) | 76.8 | WorldMM†(同设置复现)73.1 | +3.7 |
| EgoLifeQA 单查询推理效率 | 平均延迟 (s) | 98.21 | WorldMM 459.00 | 4.67× 加速 |
| EgoLifeQA 推理 token 成本(500 题) | 总 token (M) | 15.27 | WorldMM 42.03 | −63.66% |
| EgoLifeQA 严格 30 秒事件级证据定位 | Top-5 召回 (%) | 30.8 | WorldMM 五轮迭代检索 23.8 | +7.0 |
局限与改进
作者承认的局限:(1) 结构化记忆以视觉保真度换取可检索性,文本化会丢失小物体、颜色、布局与细微视觉状态等像素级细节;(2) align-then-retrieve 并不完全彻底——最终作答仍依赖少量关键帧,部分跨模态对齐留在推理期,可能引入模态偏差;(3) 框架依赖上游 MLLM 与视觉工具,字幕、物体抽取与元数据归一化的错误会传播进事件细胞和图;(4) 计算被前移到构建期,适合“一次构建、多次查询”,不适合实时或一次性场景。我的补充观察:全流程依赖闭源 GPT-5/GPT-5-mini,成本高且受 API 版本漂移影响;严格事件级 Top-5 召回仅 30.8%,意味着约七成问题的金标准证据段未被取回,证据定位的绝对水平仍低;EventRecall 类问题上召回反而下降 0.8 点,说明局部化问题仍适合迭代式字幕检索;EgoLifeQA 仅评测 A1_JAKE 单一主体流,跨主体泛化未知;三个基准全部是选择题,开放生成与精细时间定位能力未被验证;与已发表 WorldMM 数字对比时,WorldMM 在若干习惯、时序与合成推理类目上仍更强。
独立分析的弱点
独立分析可见的弱点:其一,视觉信息瓶颈是结构性缺陷——所有视觉证据在构建期被压成文本字段,仅靠 3 张关键帧兜底,对需要精细空间关系、颜色对比或画面文字推理的问题会系统性受损(附录 Table 13 也显示原始视觉证据在 HabitInsight 上反而最好,72.5%),改进方向即作者提到的粗到细两阶段记忆:结构化字段负责检索,命中后保留候选段的原始帧或高分辨率裁剪用于验证。其二,融合权重(1.00/0.65/0.45/0.30、衰减 0.60)是手工设定的,没有敏感性分析,跨域可能失效,可用验证集拟合或学习式打分替代。其三,构建成本高:一个 44.3 小时视频需 89.23M token、约 27.5 小时构建,低频查询用户无法摊销,可用本地小模型构建记录、仅选择与作答调用强模型。其四,第一视角视频上传闭源 API 存在隐私风险,与论文伦理声明强调的行为画像风险相悖,值得推出本地化部署版本。其五,评测集中在选择题,事件级召回绝对值(Top-5 30.8%)仍有很大提升空间,可将锚点边界学习化或引入分层候选扩展。
未来方向
作者提出的方向:探索粗到细的多模态记忆——结构化字段支撑事件级检索,同时保留更细粒度的视觉证据用于作答期验证。基于其成果可延伸的方向包括:(1) 可学习的事件分割,把固定 30 秒窗口替换为目标导向或模型学到的边界(Table 14 显示场景/说话人代理边界尚不可用,学习式方法值得尝试);(2) 在线流式构建:当前是离线批处理,可改为增量事件绑定以支持持续的生活记录与机器人第一视角流;(3) 记忆维护机制——过期、合并、删除与用户知情同意,呼应伦理声明中对行为画像与监控滥用的警示;(4) 把 LLM 选择器的七类问题族先验变成可训练的检索策略,例如用强化学习优化选择器;(5) 跨视频、跨主体的共享语义记忆与个性化;(6) 把事件中心范式推广到开放域生成问答、时间定位与 agent 任务轨迹记忆——作者团队同期的 LightMem-ego、MobileMem 即在此方向延伸。
复现评估
代码与 prompt 承诺开源(github.com/zjunlp/LightMem),附录 B 给出完整实现细节,附录 B.3 与 Figures 6–19 公开了记忆构建、LLM 选择与答案生成的全部提示模板,可复现性设计较好。数据全部公开:EgoLifeQA A1_JAKE 主体流(500 题、44.3 小时视频)、Ego-R1 Bench(300 题)、Video-MME (L)(900 题)。主要障碍是成本与算力:记忆构建与推理依赖闭源 GPT-5-2025-08-07 与 GPT-5-mini-2025-08-07,构建一个基准的记忆约 89.23M token 并耗时 99,022 秒(约 27.5 小时),检索端另需 2×A100 40GB 做嵌入存储与 8 worker 并行推理,500 题评测再消耗 15.27M token。流程免训练、组件清晰、prompt 齐全,工程复现难度中等,但预算敏感——API 花费约百美元量级起,随视频规模与题量线性增长;论文同时提供 WorldMM† 的复现配置,便于公平对照。
论文图表
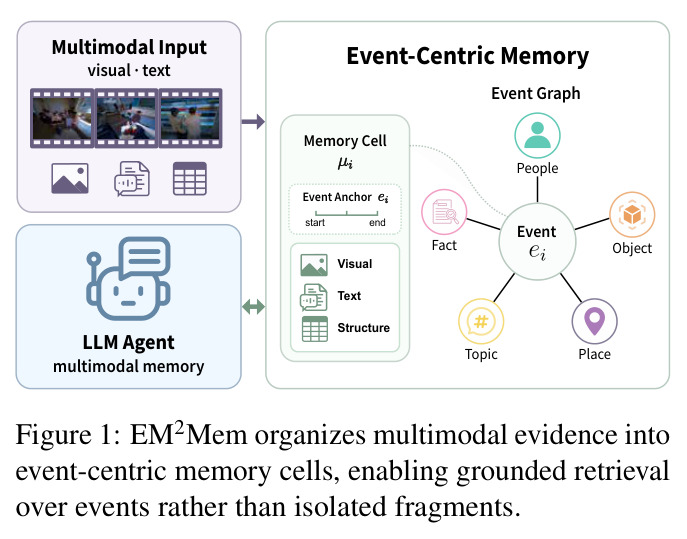
对比示意:传统方法把视觉、文本、结构证据分别存成孤立可检索片段;EM²Mem 则把它们绑定到事件锚点上形成记忆细胞,从而支持以事件为粒度的落地检索。
一图点明论文核心主张:记忆的组织单位(片段 vs 事件)决定了检索到的证据是否“可直接用于生成”,是全文动机的可视化浓缩。