群体自适应裁剪策略优化 Group Adaptive Clipping Policy Optimization
按组内答对数自适应调整裁剪边界,让稀有正确样本保留梯度,pass@1 与 pass@k 双升
前置知识
RLVR(可验证奖励的强化学习)
用自动验证器(数学答案校验、单元测试等)对模型生成的完整回答打 0/1 二元奖励,再用 PPO/GRPO 式策略梯度直接最大化期望奖励 $J(\theta)=\mathbb{E}[R(x,y)]$ 来后训练大语言模型,无需训练奖励模型,是当前推理模型训练的主流范式。
本文的方法、理论推导和全部实验都建立在 RLVR 设定上,GAPO 就是对 RLVR 中裁剪机制的改造,二元奖励是闭式裁剪公式成立的前提。
重要性采样比率(IS ratio)与 PPO 裁剪
IS 比率 $\rho_i=\pi_\theta(y_i|x)/\pi_{\theta_{old}}(y_i|x)$ 度量新旧策略对同一条回答的概率之比,即策略一次更新内的漂移幅度。PPO 类算法用固定区间 $[1-\epsilon,1+\epsilon]$ 对其裁剪,截断过大的更新以近似信赖域,防止策略崩坏。
GAPO 的全部创新就是把统一固定的上裁剪阈值换成随优势变化的函数,理解 IS 比率的含义是读懂动机和公式的基础。
GRPO 与组统计量 c
GRPO 对同一 prompt 采样 k 个 rollout,以组内奖励均值作基线计算优势;二元奖励下组内有 c 个正确时,正确回答的优势为 $A_i=(k-c)/k$,无需价值网络。c 从 1 到 k-1 天然形成从稀有高优势(难题)到富余低优势(简单题)的谱系。
c 是 GAPO 自适应裁剪公式的唯一输入,整个方法被归纳为按 c 索引的闭式阈值,是贯穿全文的核心统计量。
信赖域与反向 KL 散度
信赖域方法约束每次更新后新策略与旧策略的偏离以保证单调改进。反向 KL $D_{KL}(\pi_\theta\Vert\pi_{\theta_{old}})$ 下,带拉格朗日乘子 $\lambda$ 的约束优化经变分法解出逐点最优策略 $\pi^*(y|x)\propto\pi_{old}(y|x)\exp(A/\lambda)$,即最优 IS 比率随优势指数缩放。
本文裁剪公式正是把这个信赖域最优 IS 比率取对数并线性化推导出来的,是理解方法理论根基(式 5-11)的必要背景。
pass@1 与 pass@k
pass@1 是单次采样的平均正确率,对应部署时的实际表现;pass@k 是每题采样 k 次至少一次正确的比例,反映能力上限和解空间多样性。RLVR 训练常出现 pass@1 上升而大 k 下 pass@k 相对基座退化的多样性坍缩现象。
现有探索性方法直接优化 pass@k 往往牺牲 pass@1;本文的核心卖点是直接优化 pass@1 的同时保住 pass@k,二者的张力是理解论文动机的关键。
研究动机
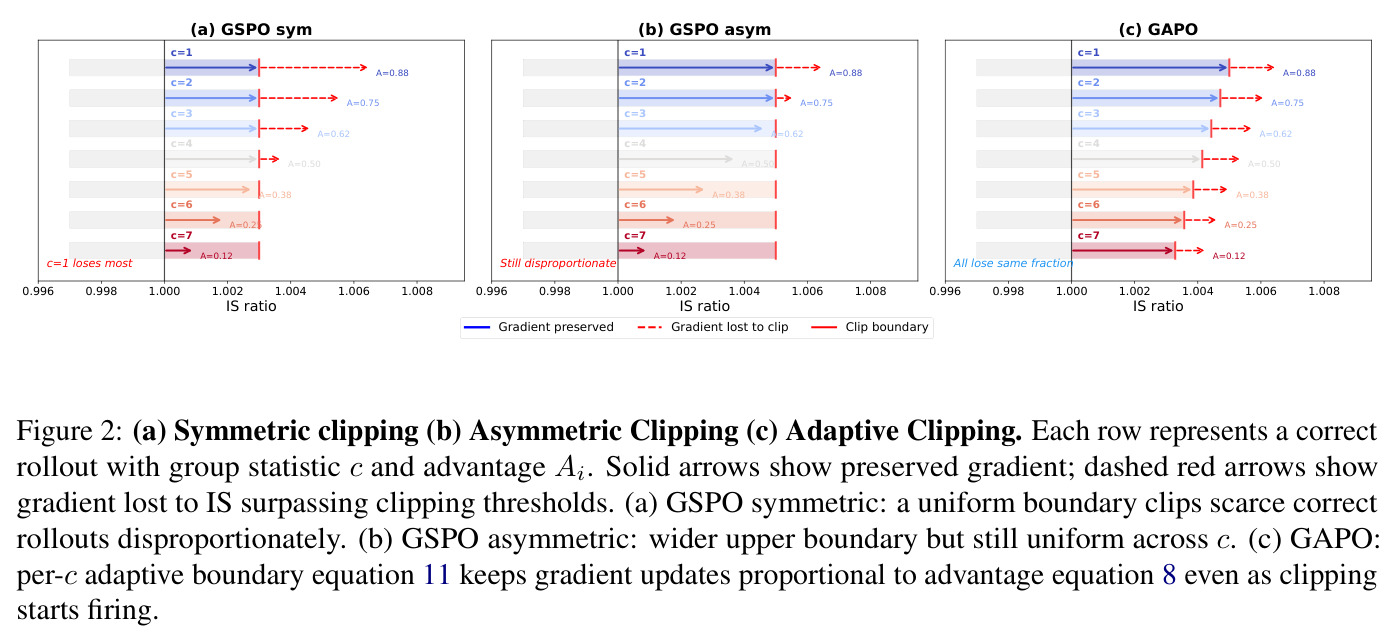
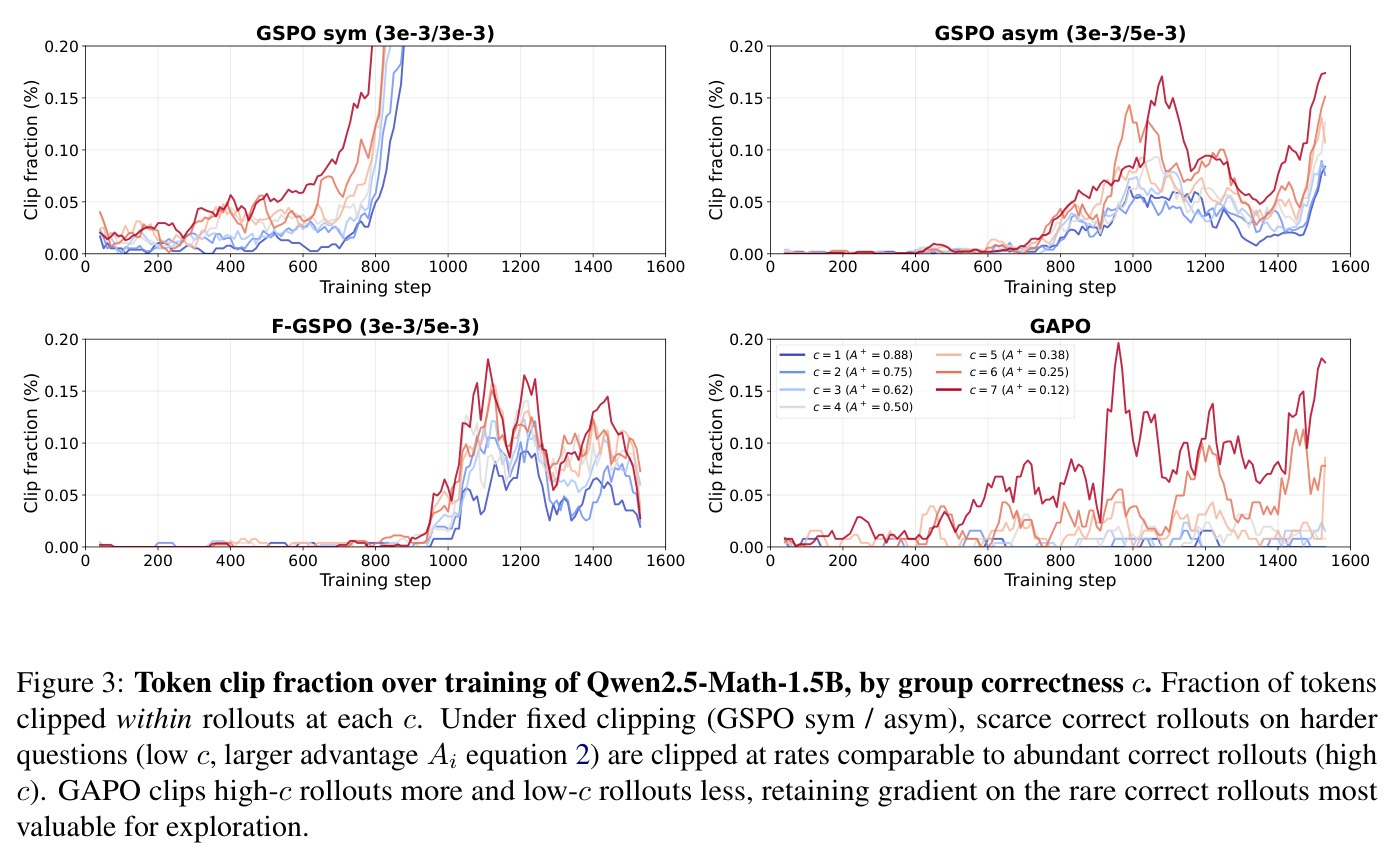
组相对 RLVR 方法(GRPO、GSPO、DAPO)对同一 prompt 采样 k 个 rollout,按组内正确数给优势:k=8 时只有 1 个正确回答(c=1)的优势为 $A_i=(k-c)/k=0.88$,而有 7 个正确(c=7)的优势仅 0.12,天然形成从稀有高优势到富余低优势的谱系。作者观测到两个规律(Figure 1):其一,无论算法如何,稀有正确 rollout(c 小、来自更难的题)的 IS 比率一致更高;其二,在裁剪启动前这些 rollout 的 IS 比率增速不低于简单题 rollout。这意味着高优势样本会最先撞上裁剪边界,而一旦启用统一的固定边界 $[1-\epsilon,1+\epsilon]$,两类 rollout 被裁剪的比例却相当(Figure 3)。结果是系统性错配:携带最强探索信号、代表攻克新题能力的稀有正确样本被不成比例地压制,而大量冗余的简单题正确样本却获得同等更新余量,探索梯度在训练中后期被持续抹平,固定裁剪基线的 pass@256 甚至在训练后期坍缩。
本文的目标是本文目标是设计一个即插即用的裁剪策略:在完全保留标准 PPO/GSPO 代理目标、奖励定义和优势计算(不做任何奖励整形、优势整形或组内 std 归一化)的前提下,把每条 rollout 的裁剪阈值改造成优势的函数——学习信号越强的样本获得越大的更新余量,优势小的样本被更紧地约束在信赖域内。作者还附加了三条工程约束:不直接优化 pass@k 而是继续直接优化部署指标 pass@1、不引入 pass@1 漂移或多样性副作用、不新增超参数。由于 RLVR 的二元奖励把优势压缩为 $k-c$ 这几个离散档位,自适应阈值可以由组统计量 c 以闭式直接索引,直接复用现有固定裁剪调好的区间端点即可部署。
与已有工作不同的是,面对裁剪压制探索的现象,已有两条主流路线:一是 DAPO 式的 clip-higher,统一放宽上裁剪界;二是 F-GRPO/F-GSPO 等优势整形($\tilde{A}_i=(1-c/k)^\gamma A_i$)以及直接优化 pass@k 的一类方法。作者指出统一放宽没有触及要害——问题不在裁剪边界的绝对宽度,而在它在不同优势 rollout 之间的均匀性,必须改变的是不同组成功率之间的相对裁剪宽度;而整形与 pass@k 路线已被观察到会引入 pass@1 漂移、推理时 pass@k 虚高或多样性方面的副作用。GAPO 的独特切入是理论先行:从单 prompt 反向 KL 信赖域出发严格推导出最优 IS 比率 $\rho_i^*\propto\exp(A_i/\lambda)$ 随优势指数缩放,据此把裁剪阈值本身设计成优势(经 c 索引)的闭式函数,而非启发式地改写损失或奖励。
核心方法
直觉是信赖域预算应按学习信号分配:优势越大的 rollout 越值得被推得更远。技术上,先把策略改进界(Schulman et al. 2015,反向 KL 方向同样成立)写成单 prompt 的约束优化 $\max_\theta\mathbb{E}_i[\rho_i A_i]$ s.t. $\mathbb{E}_i[D_{KL}(\pi_\theta\Vert\pi_{\theta_{old}})]\le\delta$;再用拉格朗日乘子法和 Euler–Lagrange 方程解出最优目标策略 $\pi_\theta^*(y|x)\propto\pi_{\theta_{old}}(y|x)\exp(A(x,y)/\lambda)$,即最优 IS 比率 $\rho_i^*\propto\exp(A_i/\lambda)$——把比率推过这个点,要么违反信赖域,要么以牺牲其他回答的概率为代价过度集中概率,因此裁剪应在 $\rho_i^*$ 处触发,即 $\epsilon_{hi}(i)\ge\exp(A_i/\lambda)-1$。最后利用 RLVR 中 $\epsilon\sim10^{-3}$、$\lambda\sim10^3\gg A_{max}$ 的量级做一阶线性化 $\exp(A_i/\lambda)\approx1+A_i/\lambda$,化简为随组内答对数 c 线性变化的闭式裁剪规则,这就是 GAPO。落到实现上,这个规则的行为非常直观:一条 rollout 的优势越大(组内答对数越少、题目越难),其上裁剪阈值就越高,策略被允许把它推得离旧策略越远;反之优势小的冗余正确样本会被更早截断,把信赖域预算省下来留给真正有信息量的样本。值得注意的是,GAPO 并不直接把 IS 比率优化到理论最优值 $\rho_i^*$,而是把裁剪触发点对齐到它,因此计算上只多了一步查表式的阈值计算。整套推导依赖的假设很少:策略改进界的反向 KL 对称性来自全变差距离的对称性,线性化的合理性来自 RLVR 社区沿用 GSPO 的小裁剪尺度,这让方法可以直接嵌进 verl 等现有训练框架。
核心创新是把裁剪阈值本身从超参数升级为优势(经由组统计量 c)的函数:$\epsilon_{hi}(c)=\epsilon_{lo}+(\epsilon_{hi}^{max}-\epsilon_{lo})\cdot\frac{k-c}{k-1}$,即 c=1 的稀有正确 rollout 获得最大上界 $\epsilon_{hi}^{max}$,$c\to k$ 的富余正确 rollout 被压缩到下界 $\epsilon_{lo}$,错误 rollout 因负优势不触及上界而恒用 $\epsilon_{lo}$。它与已有方法的本质区别有两点:与 DAPO 的 clip-higher 只统一放宽上界不同,GAPO 改变的是不同 c 档位之间的相对裁剪宽度,直接对齐信赖域最优 IS 比率随优势的缩放关系;与 F-GRPO 等优势/奖励整形改写损失函数不同,GAPO 的代理目标原封不动,仍然直接优化 pass@1,只是每个 rollout 的信赖域余量不同。作者强调这是首个由信赖域最优 IS 比率闭式导出、而非启发式设定的自适应裁剪规则。
方法步骤详情
第一步:对每个 prompt $x$ 从 $\pi_{\theta_{old}}$ 采样 $k=8$ 个 rollout,验证器给 0/1 奖励;按 Dr.GRPO 惯例不做组内 std 归一化,正确 rollout 的优势为 $A_i=(k-c)/k$。第二步:以 c 为索引计算该组正确 rollout 的上裁剪阈值 $\epsilon_{hi}(c)=\epsilon_{lo}+(\epsilon_{hi}^{max}-\epsilon_{lo})\cdot\frac{k-c}{k-1}$:c=1 取最大值 $\epsilon_{hi}^{max}$,c 越大阈值越低,$c\to k$ 趋向下界;错误 rollout 恒用 $\epsilon_{lo}$。第三步:计算 GSPO 式序列级 IS 比率 $s_i(\theta)=\left(\frac{\pi_\theta(y_i|x)}{\pi_{\theta_{old}}(y_i|x)}\right)^{1/|y_i|}$(逐 token 比率的几何平均),代码任务改用 token-IS。第四步:代入损失 $L_{GAPO}=\mathbb{E}_h\max_i\left[-A_i s_i(\theta),-A_i\,\text{clip}(s_i(\theta),1-\epsilon_{lo},1+\epsilon_{hi}(c_i))\right]$,按 token 求和除以总 token 数聚合;端点 $(\epsilon_{lo},\epsilon_{hi}^{max})$ 直接沿用固定裁剪调好的取值(Qwen 数学实验 3e-3/5e-3,蒸馏模型 7e-5/3e-4),无新增超参数。每一步的输入输出都很明确:第二步的输入只是整数 c 与两个既有超参端点,输出是标量阈值,因此整个方法在分布式实现里只是一次按组归约加一次逐 rollout 的阈值替换;第三、四步与 GSPO 完全一致,唯一的差异点在 clip 函数的右端点由常数变成 $1+\epsilon_{hi}(c_i)$。从行为上看(Figure 3):训练中 GAPO 对 c=1、c=2 这类低 c 组的 token 被裁比例明显低于固定裁剪基线,而对高 c 组更高——相当于把固定裁剪均摊给所有 rollout 的裁剪预算,重新集中到携带探索信号的正确样本上。整个流程不需要奖励模型、不需要额外的优势整形参数,也不改变奖励定义,因此在工程上可以认为是 GSPO 训练循环里的一行改动。
技术新颖性
技术新颖性体现在三点。其一,理论闭环:以往的自适应裁剪(如 Adaptive PPO, Chen et al. 2018)是启发式的,本文首次从反向 KL 信赖域的变分最优解严格推出裁剪应发生在 $\rho_i^*\propto\exp(A_i/\lambda)$ 处,再论证 RLVR 常用的 $\epsilon\sim10^{-3}$ 尺度下 $\lambda\sim10^3$,线性化的相对误差仅 2–13%,把指数规则严格化简为 c 的线性函数,并且偏保守(仍在信赖域内)。其二,正交性与即插即用:GAPO 不改序列级/token 级 IS 的选择、不改优势计算、不改损失形状,只替换每 rollout 的裁剪门限一行代码,可与 GSPO、Dr.GRPO 等任意底座组合。其三,探索与部署指标的兼容机制:它不重写奖励或优势,因此避免了 pass@k 训练路线的 pass@1 漂移;通过不对称地保留稀有正确样本的梯度,维持 IS 比率与优势的高相关,从机制上阻止训练后期的多样性坍缩,这是 F-GRPO 等整形方法靠改写优势间接实现的。
实验结果
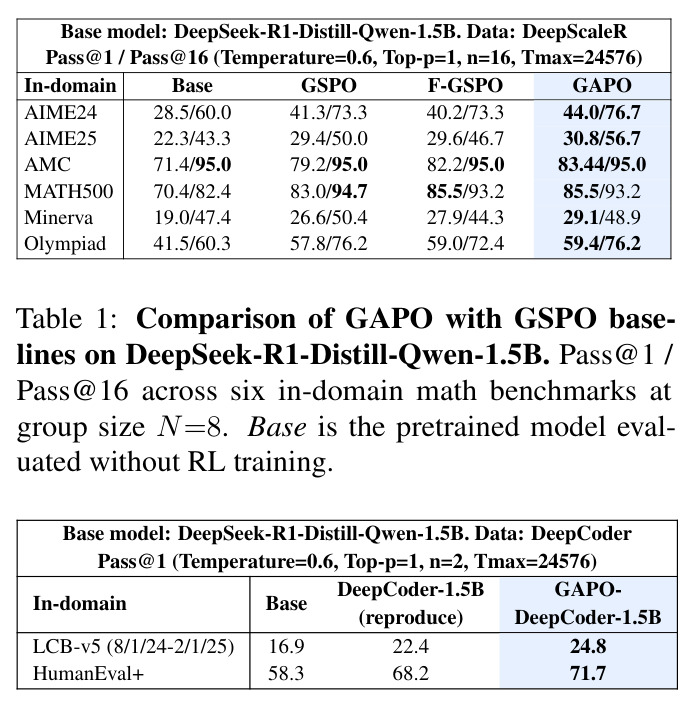
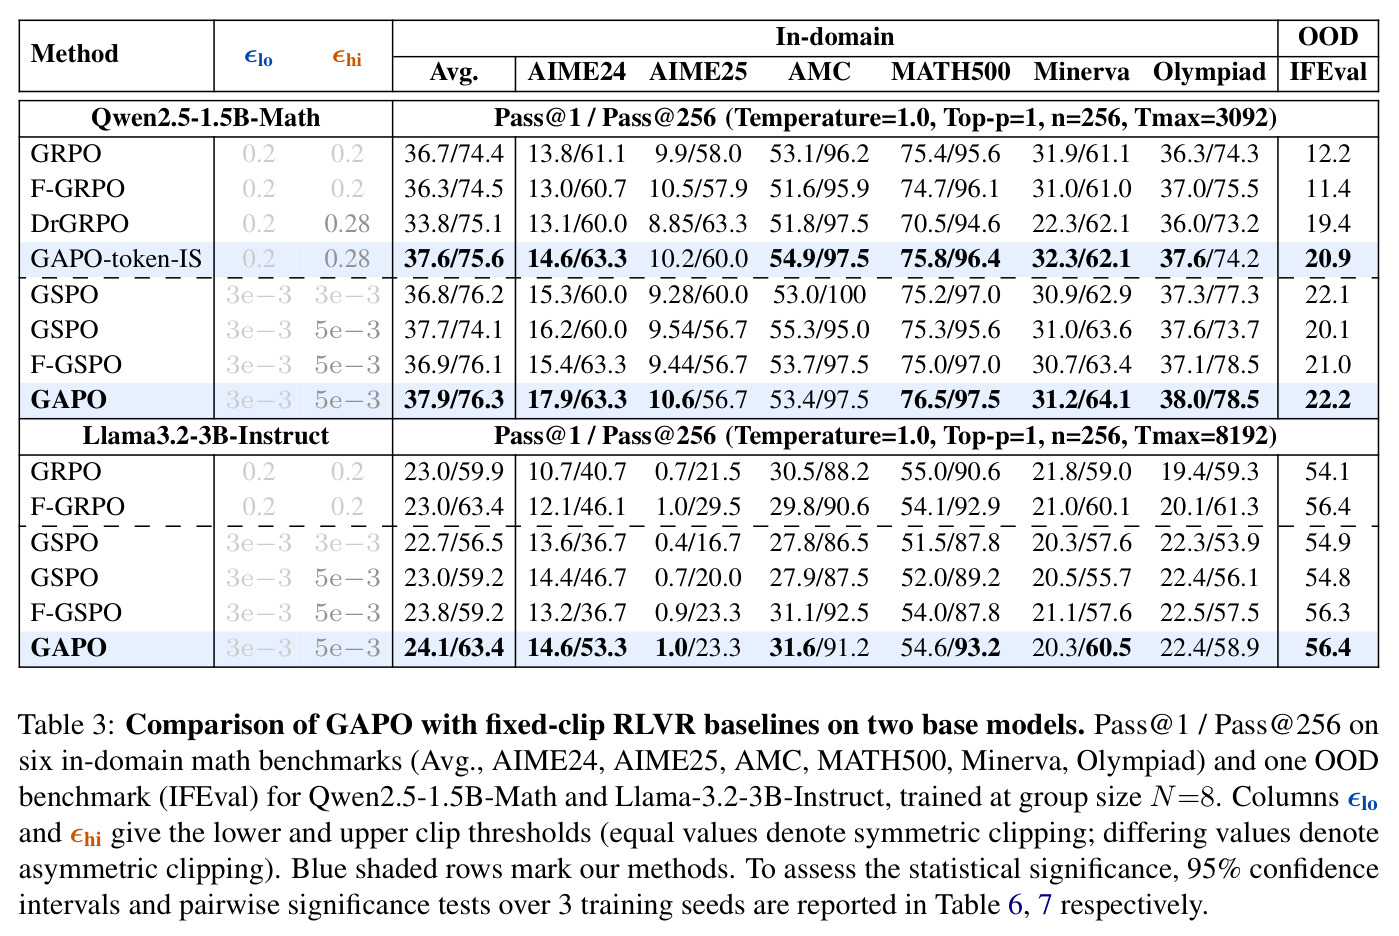
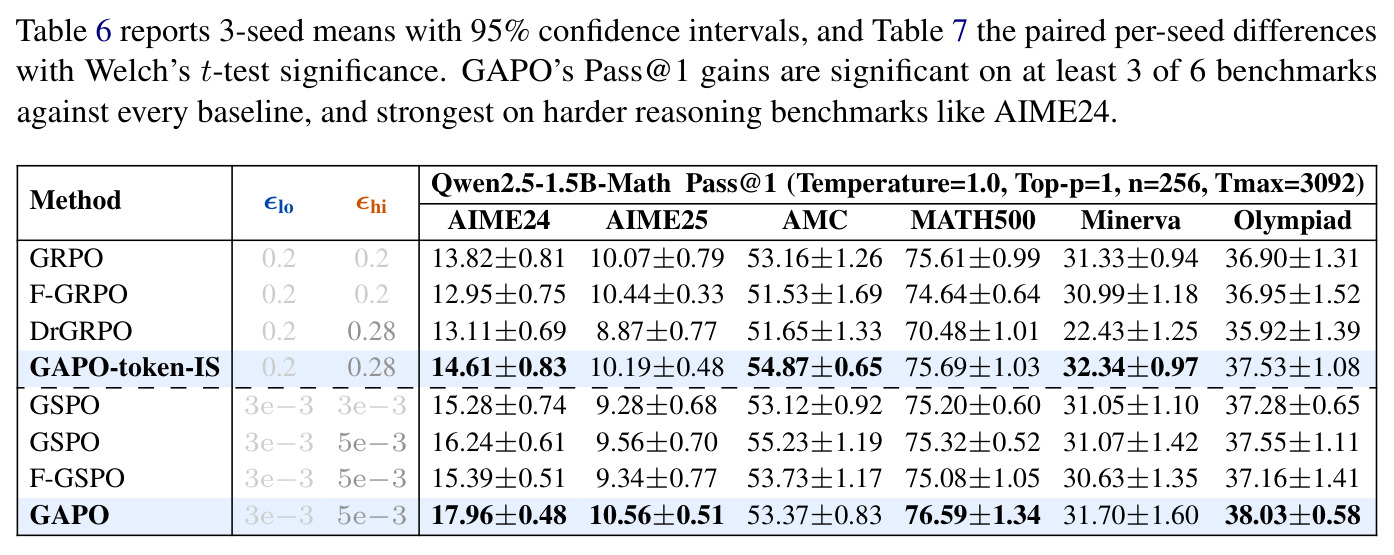
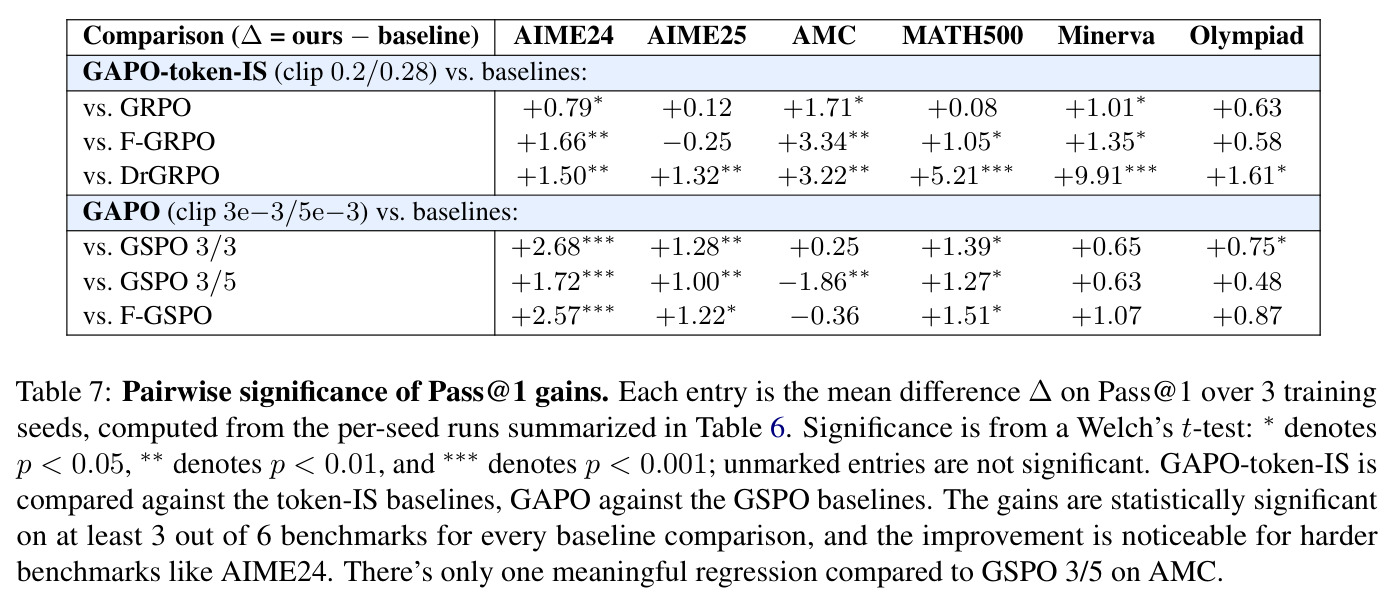
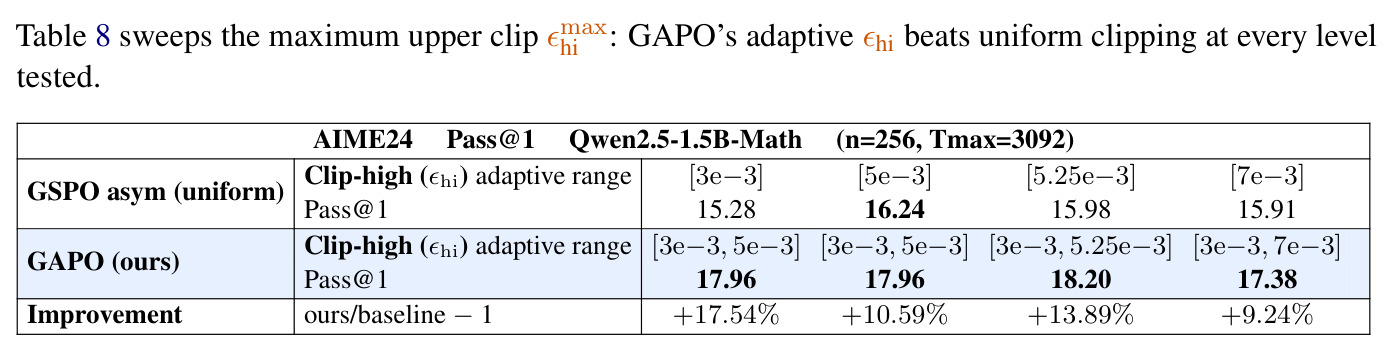
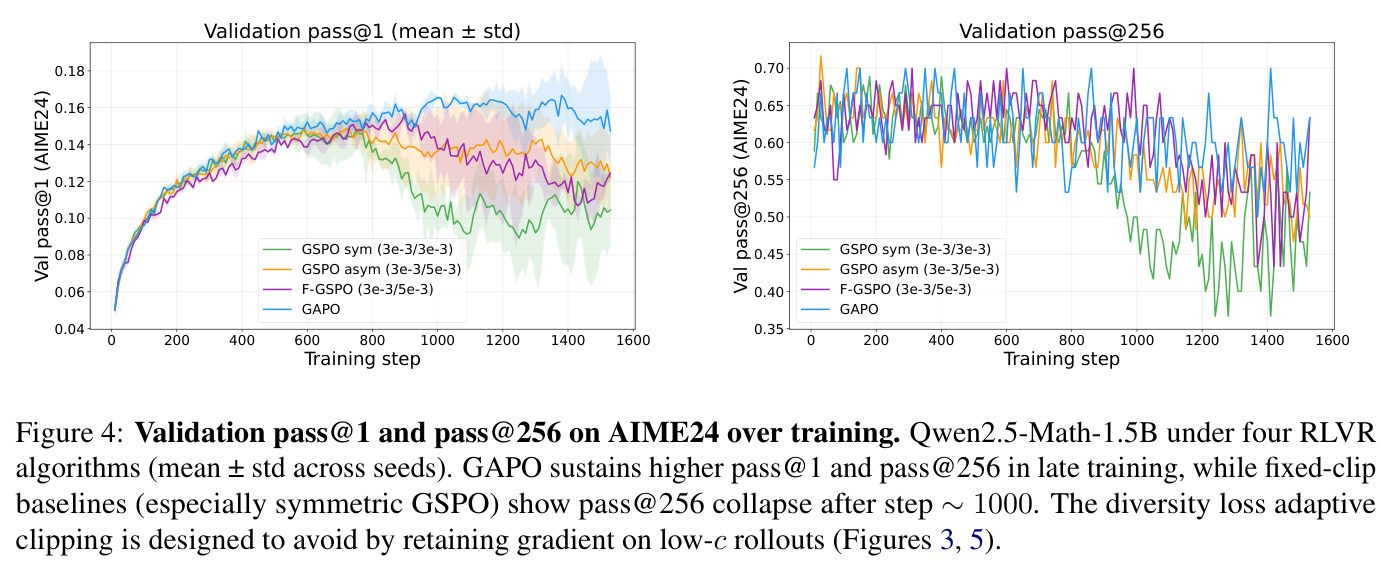
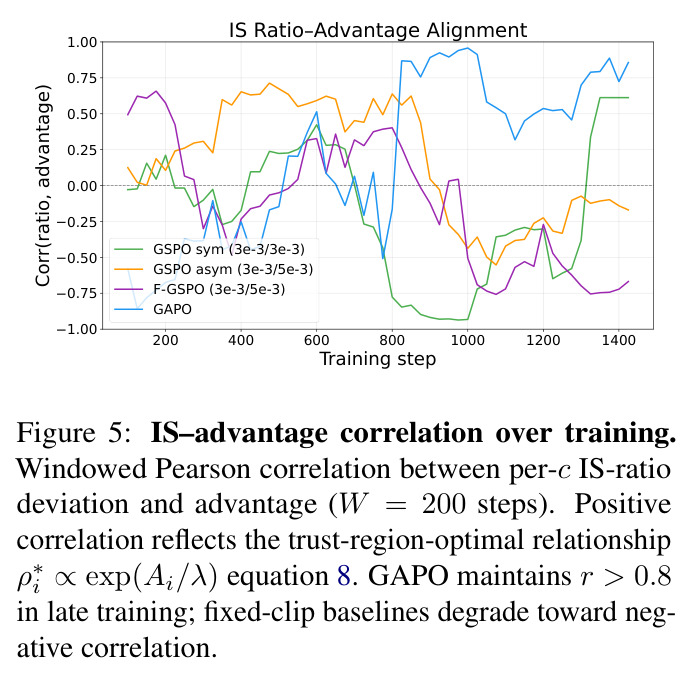
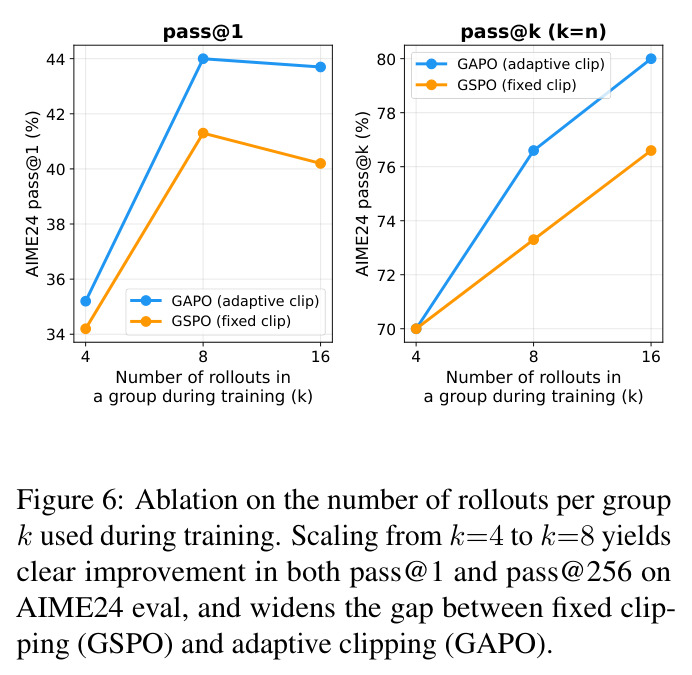
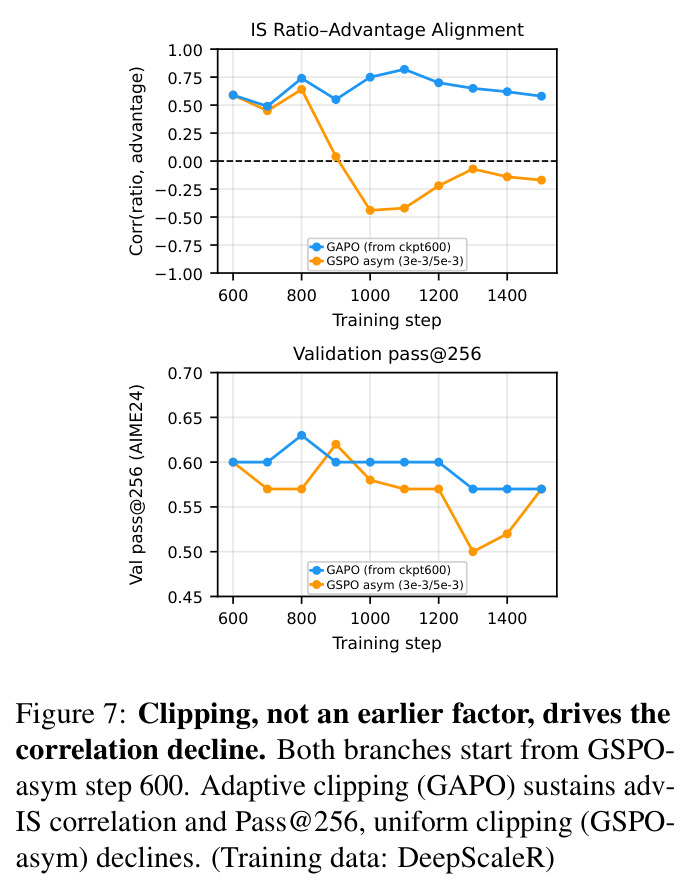
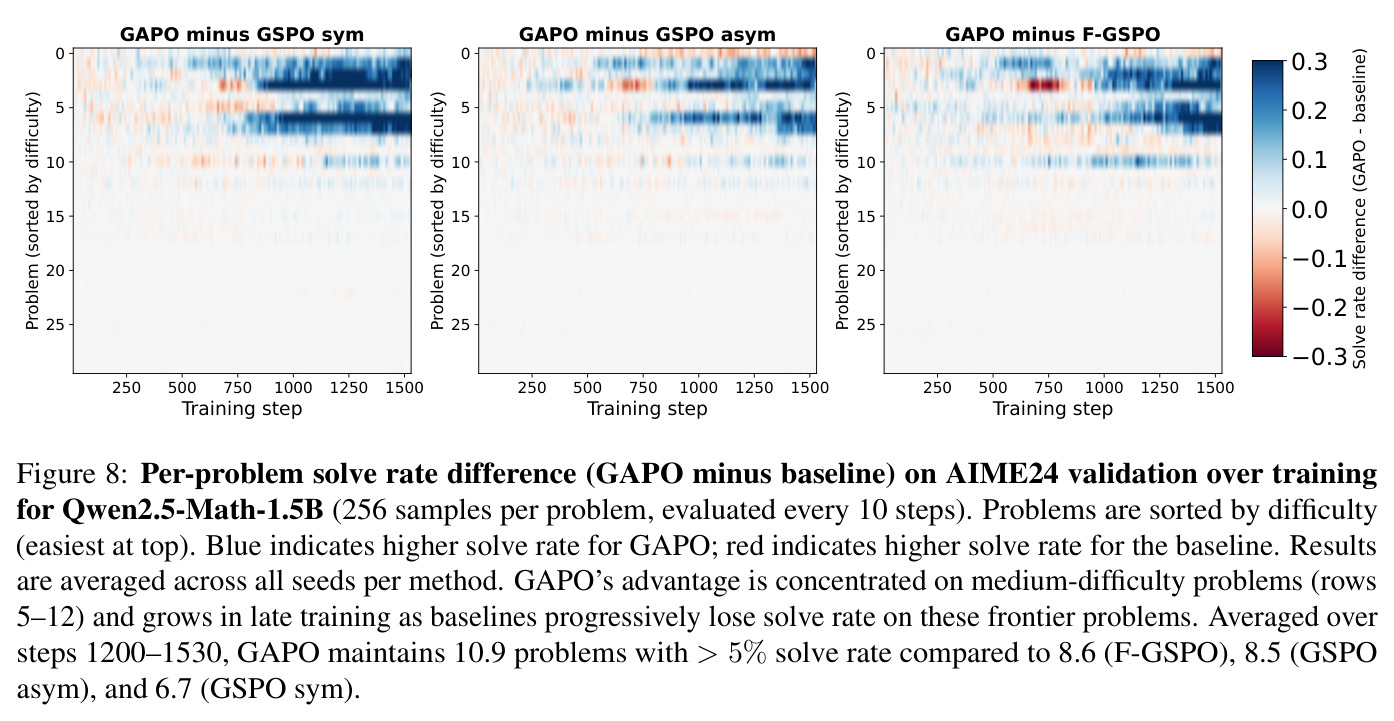
训练动力学(Qwen2.5-Math-1.5B):固定裁剪下低 c 与高 c rollout 的 token 被裁比例相近(Fig 3),IS 比率–优势相关性在 step 600 后坍缩为负,GAPO 全程维持 $r>0.8$(Fig 5);GSPO asym 的 pass@256 在约 step 1000 后坍缩,GAPO 持续走高(Fig 4)。主基准:DS-R1-Distill-Qwen-1.5B 上六个数学基准全部领先或持平(Table 1),AIME24 44.0/76.7(对 GSPO +2.7/+3.4);Qwen2.5-Math-1.5B 平均 pass@1/pass@256 37.9/76.3 最佳,AIME24 pass@1 17.9 对 GSPO asym 16.2(Table 3);Llama-3.2-3B 平均 24.1/63.4 最佳,IFEval 56.4 并列最佳。代码(Table 2):LCB-v5 从 22.4 提到 24.8,HumanEval+ 从 68.2 提到 71.7。消融:seq-IS 优于 token-IS(AIME24 17.9 对 14.6),k 4→8 拉大差距,$\epsilon_{hi}^{max}$ 各档 GAPO 均胜 +9.2%~+17.5%(Table 8)。显著性(Table 7):对每个基线至少 3/6 基准显著,AIME24 对 GSPO 3/5 +1.72(p<0.001),仅 AMC 回归 −1.86。Fig 8:GAPO 后期保有 10.9 道 >5% 通过率题(基线 6.7–8.6);Fig 9:基线某题仅 3 个正确生成,GAPO 28 个且含三条不同推理路径;Fig 7 的 ckpt600 干预证明裁剪本身是基线退化的主因。横向看所有实验有一个一致的模式:GAPO 的增益随题目难度递增——AIME24/25 这类基座通过率低的竞赛题上提升最大,MATH500、AMC 等较易基准上趋于持平甚至小幅回落,IFEval 这一分布外指令跟随探针则不退化,说明释放的更新余量确实流向了模型尚未掌握的题目而非已有能力。三个训练动力学指标(被裁比例、IS-优势相关性、pass@256 轨迹)在时间轴上互相印证:先是固定裁剪破坏比率-优势对齐,随后多样性坍缩、pass@256 下坠,而 GAPO 阻断了这条因果链。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理(DS-R1-Distill-Qwen-1.5B,AIME24) | pass@1 / pass@16 | 44.0 / 76.7 | GSPO 41.3 / 73.3 | +2.7 / +3.4 |
| 数学推理(DS-R1-Distill-Qwen-1.5B,AIME25) | pass@1 / pass@16 | 30.8 / 56.7 | GSPO 29.4 / 50.0 | +1.4 / +6.7 |
| 数学推理(Qwen2.5-Math-1.5B,AIME24) | pass@1 | 17.9 | GSPO asym (3e-3/5e-3) 16.2;F-GSPO 15.4 | +1.7(对 GSPO 3/5);3 种子下 +1.72,p<0.001 |
| 数学推理(Llama-3.2-3B-Instruct,AIME24) | pass@1 / pass@256 | 14.6 / 53.3 | GSPO asym 14.4 / 46.7 | pass@256 +6.6 |
| 代码生成(DeepCoder-1.5B 配方,LiveCodeBench v5) | pass@1 | 24.8 | DeepCoder 复现 22.4(基座 16.9) | +2.4 |
| 代码生成(HumanEval+) | pass@1 | 71.7 | DeepCoder 复现 68.2(基座 58.3) | +3.5 |
| OOD 指令跟随(Qwen2.5-Math-1.5B,IFEval) | pass@1 | 22.2 | GSPO 3/5 为 20.1 | +2.1;token-IS 变体 20.9 对基线 11.4–19.4 |
局限与改进
作者承认的局限:只自适应上界 $\epsilon_{hi}$,作用于负优势(错误)rollout 的下界 $\epsilon_{lo}$ 全程固定,按任务难度联合自适应错误样本惩罚余量留作未来工作;理论推导是单 prompt 精确的,而式 5 的 KL 约束实际在批上取平均,拉格朗日乘子 $\lambda$ 原则上应跨 prompt 共享,文中将其当作全局常数处理,推导与实现存在真实差距(尽管经验相关性很高);另外用经验期望替代最坏情况最大值,这一点承袭 PPO 只保证经验意义上的界。我补充观察:主表多为单种子运行(仅 Qwen2.5-Math 设置有 3 种子),而 AIME24/25 每年只有 30 题,pass@1 的评估方差不可忽略;收益集中在 AIME24/25 等低通过率基准,AMC 等较易基准对 GSPO 3/5 出现 −1.86 的显著回归;线性化论证依赖 $\epsilon\sim10^{-3}$ 的序列级尺度,在 token-IS($\epsilon\sim0.2$)域公式只是保守近似(2–13% 相对误差),是否仍最优未验证;实验限于 1.5B–3B 模型,更大规模未验证。
独立分析的弱点
第一,单 prompt 推导与批级约束的落差:$\lambda$ 全局共享意味着难题组与简单组实际上在挤占同一份信赖域预算,更精确的做法是按 prompt 或按组求解 $\lambda(x)$,这是公式层面最直接的改进方向。第二,下界固定:错误 rollout 的惩罚余量不随难度变化,而难题上错误样本占绝对多数(c 小意味着大量错误 rollout),$\epsilon_{lo}$ 如何影响探索行为缺乏研究,可尝试按 $|A_i|=c/k$ 对称地自适应下界。第三,线性插值形状未必最优:收益集中在难题、易基准反而回归,说明 $(k-c)/(k-1)$ 的线性插值对中等 c 段可能不是最优形状,可探索凸/凹插值或按全局通过率校准阈值。第四,评估稳健性:AIME 每年仅 30 题、主表单种子,低通过率基准上的 1–3 个点差异接近噪声边缘,应扩大种子数与题目池。第五,未验证与 DAPO 动态采样、熵正则等探索技术的叠加效应,组合收益未知。
未来方向
作者明确提出:联合自适应错误 rollout 的信赖域余量,研究其基于任务难度对探索行为的间接影响。基于本文成果可延伸的方向包括:把 $\lambda$ 从全局常数推广为按 prompt/组自适应的乘子,弥补批级 KL 约束的理论差距并给出批级单调改进的近似条件;将 GAPO 与 pass@k 目标结合——GAPO 既保持多样性又直接优化 pass@1,可能天然适合作为 pass@k-aware 混合目标的基座;推广到过程奖励模型(PRM)或多轮 agent RLVR,那里奖励非二元、组统计量 c 不再自然存在,需要连续优势下的自适应裁剪版本;与 DAPO 的动态采样、clip-higher、CISPO 的梯度保留机制做系统消融;以及在更大模型和更长的 rollout(agentic 任务)上检验 $\epsilon\sim10^{-3}$ 尺度假设是否仍然成立。
复现评估
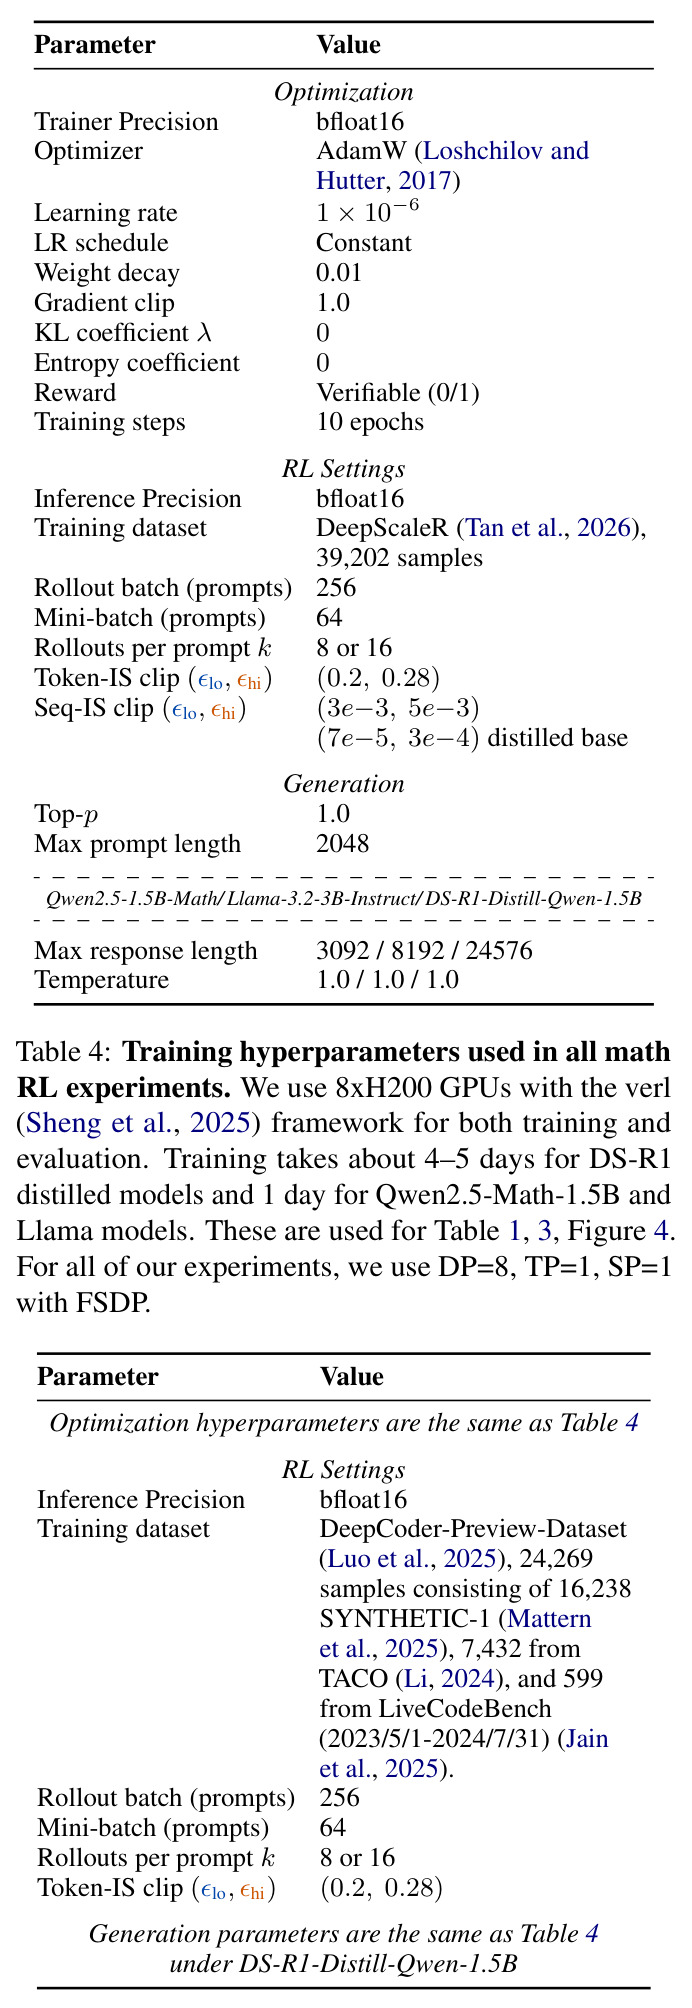
复现条件很好:代码已开源(github.com/Sheng-J/GAPO);训练数据全公开(DeepScaleR 39,202 样本;DeepCoder 组合 24,269 样本);评测基准与三个基座模型(Qwen2.5-Math-1.5B、Llama-3.2-3B-Instruct、DS-R1-Distill-Qwen-1.5B)均公开可得。算力门槛适中:8×H200 + verl 框架,Qwen/Llama 约 1 天,DS-R1 蒸馏模型($T_{max}=24576$)4–5 天;超参在 Table 4/5 完整给出(AdamW、lr 1e-6 恒定、KL 系数 0、k=8 等)。方法实现只是把固定裁剪阈值替换为按 c 索引的闭式公式,无新增调参。主要成本在 RLVR 训练的工程复杂度与 rollout 采样开销;主表为单种子,对照时建议参考 Table 6 的 3 种子均值与 95% 置信区间。总体复现难度中等,有 RLVR 训练经验的团队可复现。此外,论文对稳健性做了超出 RLVR 惯例的补充:3 种子的显著性检验(Table 6/7)与裁剪宽度的超参扫描(Table 8)都公开了完整数字,可以用来校准自己复现时的预期偏差;基线(GRPO、Dr.GRPO、GSPO、F-GRPO/F-GSPO)均为公开方法,DeepCoder 配方亦开源,对照实验可完全重跑。
论文图表
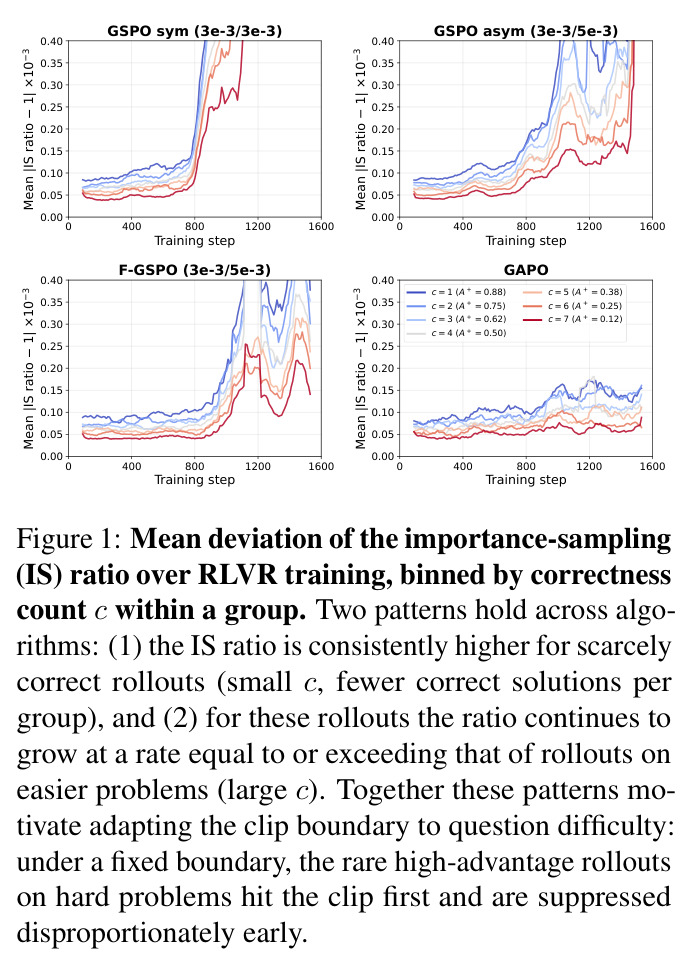
在 Qwen2.5-Math-1.5B 的 RLVR 训练中,按组内正确数 c 分桶统计 IS 比率的平均偏差随训练步数的变化。四个子图(GSPO 对称、GSPO 非对称、F-GSPO、GAPO)呈现一致规律:c=1(A+=0.88)的稀有正确 rollout 的 IS 比率始终最高且持续增长,c=7(A+=0.12)的富余正确 rollout 比率最低。
这是全文的经验动机:证明问题不是裁剪宽度不够,而是高优势稀有样本在固定边界下最先撞界、被过早压制,直接引出自适应裁剪的设计。
展示 AIME24 芯片放置题的三条正确推理路径(行/列染色推导、网格分块、交替模式),均得 902。该题基线 GSPO 仅 3 个正确生成,GAPO 有 28 个,且在 pass@1 峰值附近采样出三条概念切入不同的正确推理路径。
定性展示自适应裁剪保留的解模式多样性,直观解释了 pass@k 不退化的机制。
代码域结果:DeepCoder 配方复现得到 LCB-v5 22.4、HumanEval+ 68.2;叠加 GAPO(token-IS,$\epsilon_{hi}^{max}\in[0.2,0.28]$)后提升到 24.8 与 71.7。
展示方法跨出数学域、在代码 RLVR(不同 IS 尺度与数据分布)上的可迁移性。
代码 RL 实验配置:DeepCoder-Preview-Dataset 24,269 样本、优化超参同 Table 4、token-IS 裁剪 (0.2, 0.28)、k=8/16、Tmax=24576。
代码实验的复现依据,说明代码域采用的 IS 尺度与数学域不同。