WHALE:权重与执行框架交替联合优化的简洁配方 WHALE: A Simple Recipe for Joint Harness-Weight Optimization
交替执行权重微调与可执行框架搜索,让智能体的模型与外壳代码协同进化
前置知识
Harness(执行框架)
智能体系统中包裹模型的可执行代码,决定哪些观测进入上下文、工具如何暴露与调用、执行错误如何处理、交互何时终止,涵盖系统提示词、工具 schema、上下文管理、解析与终止逻辑。它与模型权重 $\theta$ 共同诱导轨迹分布 $\pi_{\theta,h}(\cdot|x)$,是本论文要优化的第二根支柱。
本文的核心主张是智能体性能由权重与 harness 联合决定,全文优化的对象就是 harness 代码本身;不理解这个概念,就无法理解搜索空间以及'框架主导/权重主导'两种瓶颈形态。
在线拒绝采样微调(RSFT)
一种无需策略梯度的在线自训练方法:用当前模型对每个提示采样 $G$ 条轨迹,只保留通过二值验证器($R=1$)的轨迹,对其中的模型生成 token 做监督学习,损失为 token 归一化的对数似然。采样与训练交替进行,每步更新后的权重会同步给 rollout worker,属于 RAFT/ReST/RFT 这一族方法。
RSFT 是 WHALE 权重更新阶段的实例化算法,理解其'只用自己验证通过的成功轨迹做 SFT'的机制,才能看懂它与 harness 搜索如何通过共享的轨迹分布耦合。
Meta-Harness(MH)
对可执行 harness 程序的迭代式'提议—评测—选择'搜索:proposer(本文用 Claude Opus 4.7)通过文件系统工具检查存档中各 harness 的聚合得分、逐题结果与轨迹日志,提出 $M$ 个候选 harness;每个候选在训练子集上评测打分,接受存档中最高分者;后续提议可基于全部历史工件改进任何旧候选或回退到早期设计。
它是 WHALE 框架搜索阶段的实例化算法,论文的自适应停止规则、rollout 预算核算等设计都围绕其提议—评测循环展开。
mean@k 评估指标
每个测试样例独立采样 $k$ 条轨迹,取平均通过率作为该样例的分数。mean@8 即每题采 8 条轨迹计算平均正确率,比单次 pass@1 更稳定地反映系统在任务上的期望表现;论文所有测试结果都以 best-so-far 的 mean@8 报告。
论文全部实验结论(如 WHALE 在 SearchQA 上 48.34% vs 基线 38.29%)都以 mean@8 表达,不掌握该指标就无法正确比较各方法与各调度。
交替优化(坐标下降视角)
处理耦合问题 $\max_{\theta,h} J(\theta,h)$ 的经典策略:每次只更新一个变量、固定其余变量,把联合问题分解为一系列条件更新。由于 $J$ 通常不可分离,一方的更新会改变另一方所面对的优化景观,因此每次该走多大步长、何时切换,成为新的调度问题。
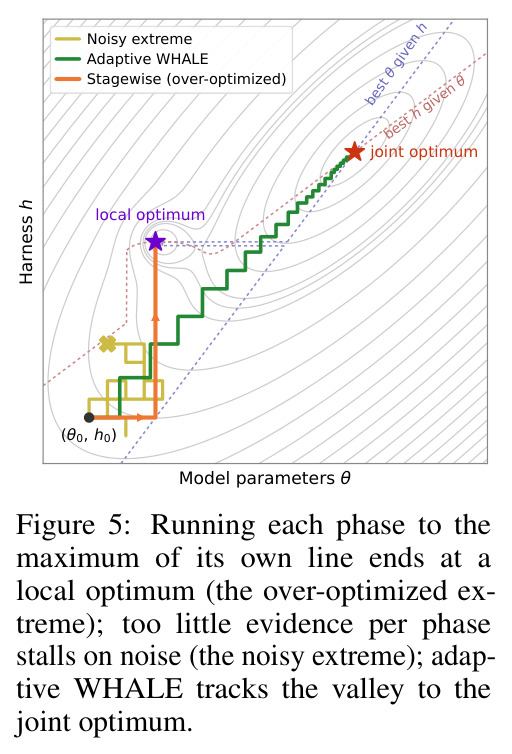
WHALE 正是把权重与 harness 的联合适配当作坐标下降来调度,'每个阶段跑多久再切换'是全文的核心研究问题,图 5 的两个失败极端都源于此。
Fast–Slow Training(FST)
先前的联合适配方法(Tiwari et al., 2026):同时优化模型权重与上下文侧变量,但后者被限制为文本形式的系统/用户提示词,不涉及可执行代码。本文将其改造为对照实现:沿用与 WHALE 相同的更新方法(RSFT)与调度,只把搜索空间限制在初始 harness $h_0$ 的系统与用户提示上。
它是隔离'全 harness 搜索 vs 仅 prompt 搜索'表达力差异的关键基线,WHALE 对其领先 4.15–13.00 个百分点,这一差距直接度量了可执行 harness 层面的价值。
研究动机
智能体系统的性能由模型权重 $\theta$ 与执行框架 $h$ 联合决定,但实践中二者几乎总是分开优化,只动一侧就会被冻结的另一侧卡住。论文给出的例子非常具体:SearchQA 的基线框架 $h_0$ 每次只允许 2 轮助手发言、只返回 1 篇截断到 200 token 的文档,多跳问题需要的第二跳信息根本进不了上下文,更强的权重也无济于事;反过来,更好的检索也无法帮助一个不会综合证据的模型。Math 域的失败更极端:基座模型在 AIME 题上用散文推理 20,035 个字符直至 8,192 token 上限被截断,验证器连 $\boxed{}$ 里的最终答案都提取不到;Chess 域 2,048 条基线 rollout 中有 2,025 条在同一 token 上限处截断,平均生成 8,112 个助手 token。此前的联合适配方法(如 FST、P$^2$O)虽然同时调整权重与上下文,但把上下文侧变量限制在文本提示词,覆盖不了工具接口、查询后处理、上下文管理、错误处理与终止策略这些可执行 harness 层面——于是无论先优化哪一侧,瓶颈都会随训练在两个组件之间漂移,单侧优化的收益很快被封顶。
本文的目标是本文的目标是针对给定任务分布同时优化模型权重与完整可执行 harness,即求解 $\max_{\theta,h} J(\theta,h)$,其中 $J(\theta,h)=\mathbb{E}_{x\sim P}\,\mathbb{E}_{\tau\sim\pi_{\theta,h}(\cdot|x)}[R(x,\tau)]$,$R$ 是稀疏的轨迹级二值验证器(只有最终结果正确才得 1 分)。比目标函数更重要的是方法论目标:回答'两个组件应如何协调'这一调度问题——每个阶段应积累多少证据才能把真实改进从噪声中区分出来,又要在何时停下以避免对将来会变化的对方过优化。作者希望给出一个模块化、可与任意权重更新算子和框架搜索算子组合的配方(WHALE),并用受控、预算匹配的实验回答三个问题:联合优化是否优于单侧优化;全 harness 搜索是否比仅 prompt 搜索带来额外收益;以及阶段切换时机能否仅凭训练信号自动决定。
与已有工作不同的是,本文的独特切入有三点。第一,把联合适配明确建模为交替优化(坐标下降):权重与 harness 通过轨迹分布 $\pi_{\theta,h}$ 耦合,并行运行两个更新会让每次更新面对一个移动的靶子、混淆信用分配,而交替执行让每次更新都相对于固定的对方进行——这个经典优化视角此前从未被用于'权重 × 可执行代码'的组合。第二,上下文侧变量从文本提示扩展到完整可执行 harness:已有联合方法(Soylu 2024、FST 2026、P$^2$O 等)只调 prompt,而近年 ADAS、AFlow、Meta-Harness 等工作证明工具接口、编排、记忆等非 prompt 选择能大幅改变固定模型的行为,但没有人把框架搜索与权重训练放进同一个循环里协调。第三,通过把 FST 改造为'相同更新方法 + 相同调度、仅把搜索限制在系统与用户提示'的对照实验,作者第一次在预算匹配条件下隔离了搜索空间表达力本身的贡献,并借此发现了 harness 主导与权重主导两种瓶颈域,以及'小幅权重更新可以解锁原本无效的框架搜索'这一催化现象。
核心方法
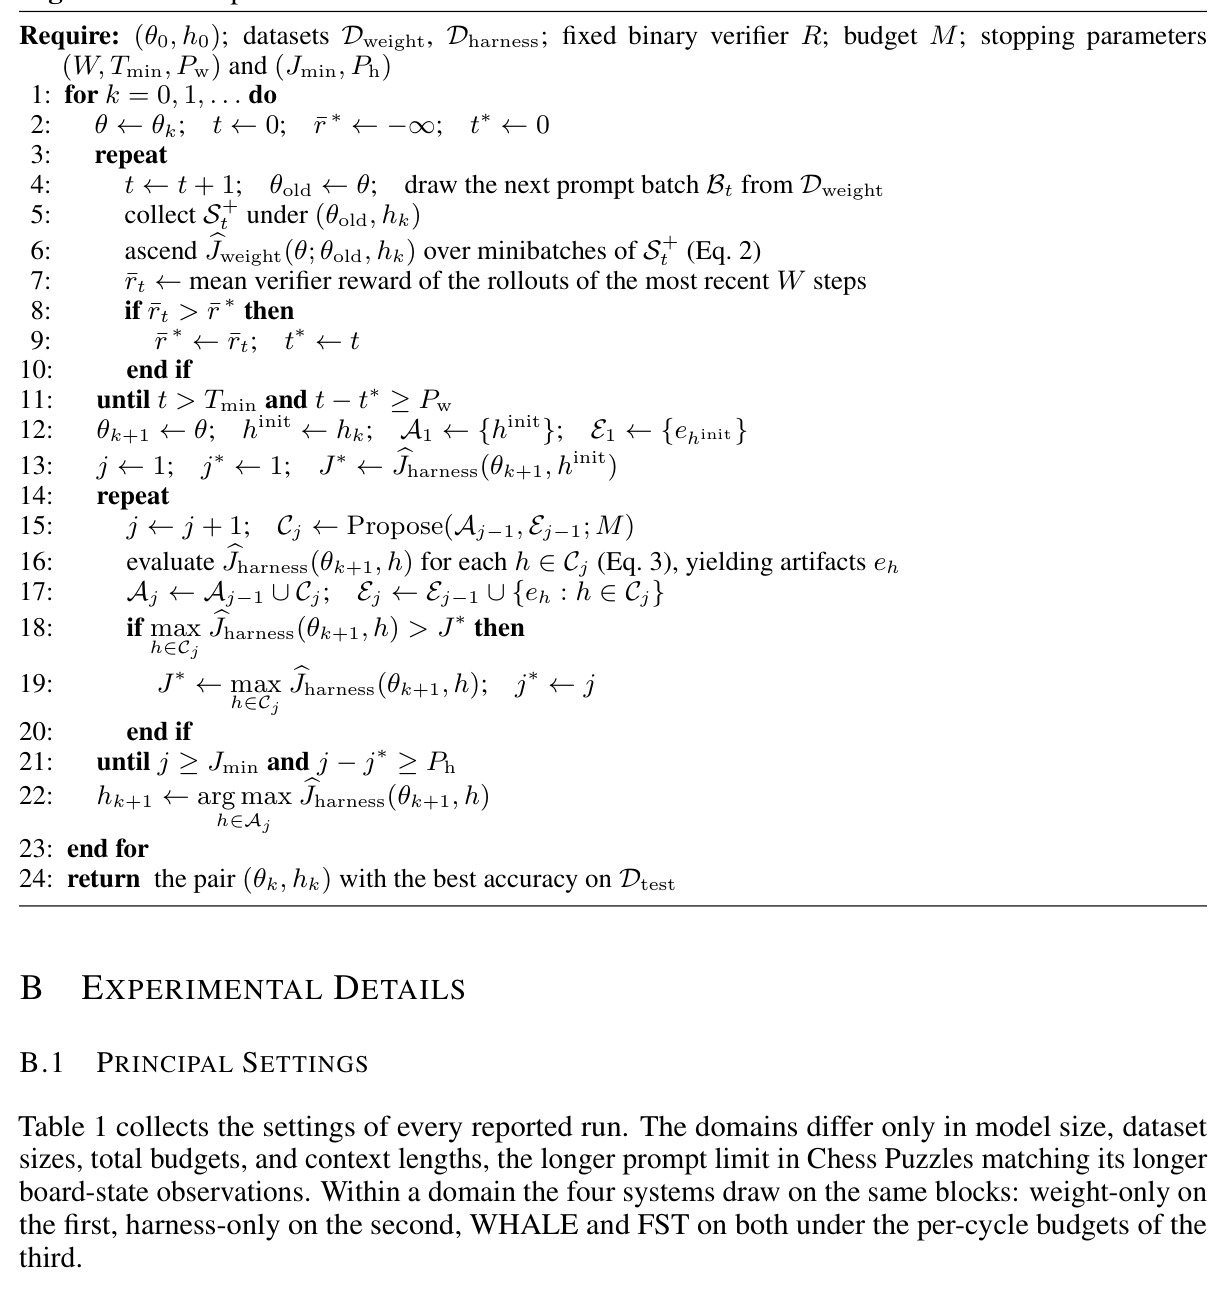
WHALE 的直觉很朴素:既然事先不知道瓶颈在权重还是框架,就用小步交替让双方共同适应,每次只动一个、固定另一个。形式化地,从初始对 $(\theta_0,h_0)$ 出发,第 $k$ 个循环执行两个条件更新:先做 $\theta_{k+1}=\text{ModelUpdate}(\theta_k; h_k, \mathcal{D}_{\text{weight}})$,再做 $h_{k+1}=\text{HarnessSearch}(h_k; \theta_{k+1}, \mathcal{D}_{\text{harness}})$,如此重复。两个算子只需黑盒接口、可任意替换;论文用在线 RSFT 实例化权重更新、用 Meta-Harness 实例化框架搜索。默认用跨循环共享的固定超参 $(E,I)$ 决定相位时长——每个周期训练 $E$ 个 epoch、搜索 $I$ 轮迭代,主实验取 $(0.6,6)$;自适应 WHALE 则去掉固定预算,用 patience 规则监控各阶段训练信号(权重阶段看滑动窗口平均奖励,搜索阶段看存档最优训练分),信号停止改善就切换。整个流程结束后返回测试准确率最高的 $(\theta,h)$ 对。
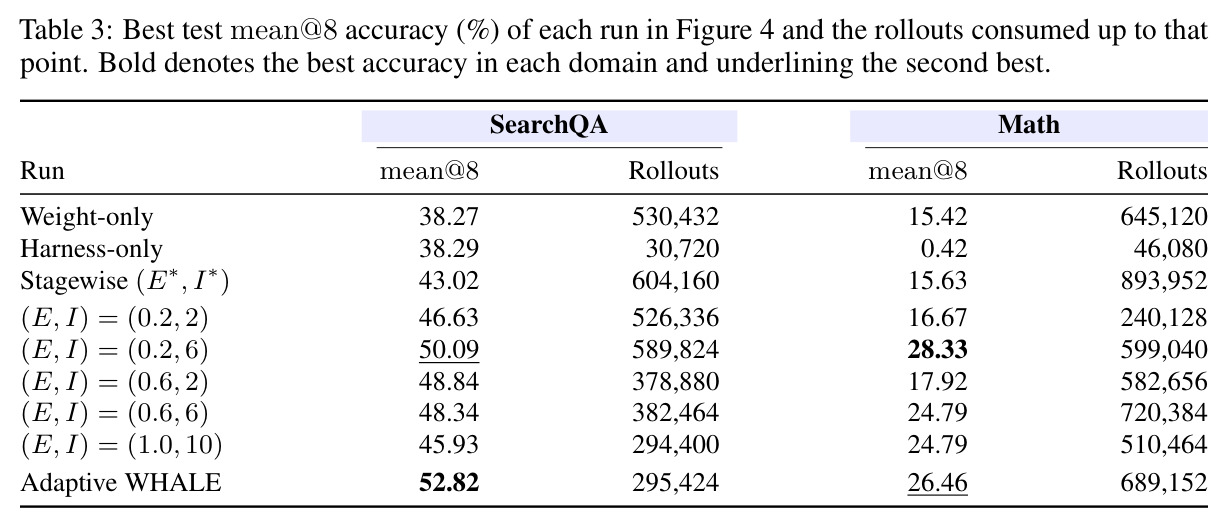
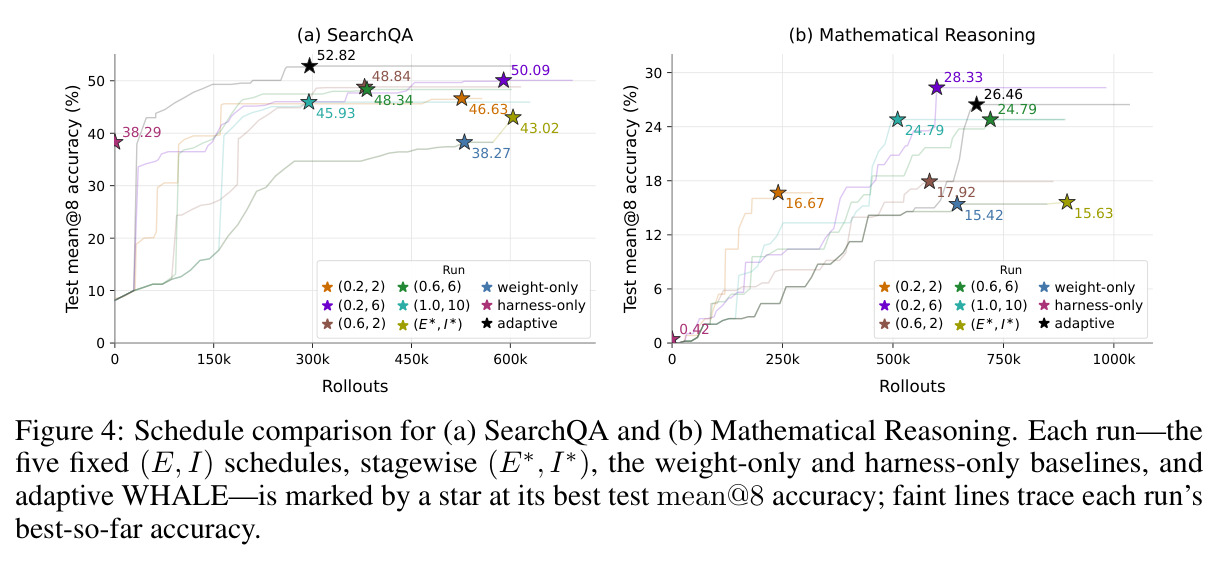
核心创新是把'权重 × 完整可执行代码'的联合适配做成小步交替,并论证为什么小步交替优于两侧各来一次大步的阶段式优化。关键概念是条件性过优化:$J(\theta,h)$ 不可分离,长时间的权重训练会把模型过优化到 $h_0$ 的行为上,等随后的框架搜索产出新 harness 时模型已经不适配;反过来,长时间框架搜索会把 harness 过优化到 $\mathcal{D}_{\text{harness}}$ 上——Math 域 60 轮迭代搜索的训练分持续上升,测试集却只比 weight-only 高 0.21 个百分点(15.63% vs 15.42%)。因此有效调度必须落在两个失败极端之间:证据太少是噪声极端(Math 的 $(0.2,2)$ 每周期只有 2 轮提议,偶然虚高的候选被接受后模型再去适配它,训练失稳中止);单阶段预算过大则滑向过优化极端($(0.2,6)\to(0.6,6)\to(1.0,10)$ 在 SearchQA 从 50.09% 降到 48.34% 再到 45.93%)。论文还识别出两种瓶颈域:SearchQA 是 harness 主导(框架搜索仅用 5.79% 的 rollouts 就追平权重训练的峰值),Math 是权重主导(框架搜索只有 0.42%,一次小幅权重更新才能解锁后续搜索的效力)。
方法步骤详情
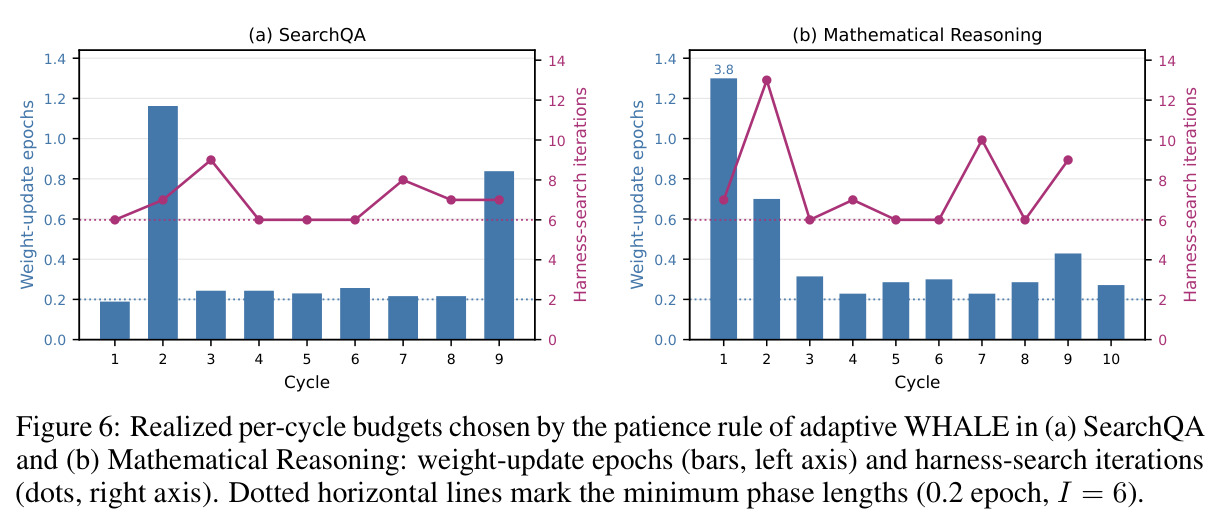
每个循环分两阶段。权重更新阶段:从持久采样器取 $\mathcal{D}_{\text{weight}}$ 的 $E=0.6$ 个 epoch,对每个 256 题的批次 $B_s$,用冻结副本 $\theta_{\text{old}}$ 在当前 $h_k$ 下每题采 $G=8$ 条轨迹,只保留验证器通过的 $(x,\tau)$ 构成 $S_s^+$,以学习率 $10^{-7}$、minibatch 64 做梯度上升,目标为 token 归一化对数似然 $\hat{J}_{\text{weight}}=\frac{1}{|I(\tau)|}\sum_{t\in I(\tau)}\log p_\theta(\tau_t\mid x,h,\tau_{<t})$,其中 $I(\tau)$ 是模型生成 token 的位置;每步更新后把新权重同步给 rollout worker 再采下一组。框架搜索阶段:以 $h_k$ 为种子初始化存档,跑 $I=6$ 轮迭代;每轮 proposer(Claude Opus 4.7)通过文件系统工具检视存档源码与轨迹工件,写出 $M=3$ 个候选 harness;每个候选在 $|\mathcal{D}_{\text{harness}}|=256$ 个样本上各跑 1 次 rollout 得到经验分 $\hat{J}_{\text{harness}}$,接受存档最高分者,后续提议可改进任何历史候选或回退。SearchQA/Math/Chess 分别完成 6/9/6 个循环。自适应版本把固定预算换成 patience 规则:权重阶段设最小相位长度 $T_{\min}$、平均窗口 $W$、耐心 $P_w$(均 0.2 epoch),滑动窗口平均奖励连续 $P_w$ 步未创新高即停;搜索阶段至少 $J_{\min}=6$ 轮,存档最优训练分连续 $P_h=2$ 轮未刷新即停;这些信号只来自训练数据,不用验证集。
技术新颖性
技术新颖性体现在四个层面。其一,优化对象:此前联合适配只覆盖'权重 + 文本 prompt'(Soylu 2024、FST 2026、P$^2$O 等),WHALE 首次把上下文侧变量扩展为完整的可执行 harness 程序——包括工具输入输出格式、工具反馈文本、停止准则与轮次分配;与 GEPA、ADAS 等纯框架优化也不同,那些方法固定模型不动权重。其二,协调机制:不并行、也不阶段式,而是小步交替,用坐标下降的条件更新规避非平稳对象造成的信用分配混淆,并以受控实验证明交替支配阶段式(SearchQA +5.32、Math +9.16 个百分点,且分别只用 stagewise 29%/49% 的 rollouts 就超过其终值)。其三,调度科学化:系统消融 $(E,I)\in\{(0.2,2),(0.2,6),(0.6,2),(0.6,6),(1.0,10)\}$,刻画噪声极端与过优化极端,并证明两个预算不可独立选择——Math 中 $E$ 从 0.2 升到 0.6 在 $I=2$ 时有益(16.67%→17.92%)、在 $I=6$ 时有害(28.33%→24.79%)。其四,自适应停止:仅用训练信号的 per-phase patience 规则即可自动落进手工调参找到的最优区间,在 SearchQA 上还以少 23% 的 rollouts 取得全场最佳 52.82%。
实验结果
主实验用同一调度 $(E,I)=(0.6,6)$ 在三个域上评测。SearchQA(Qwen3.5-2B):WHALE 48.34% vs harness-only 38.29%、weight-only 38.27%、FST 35.34%(test mean@8);Math(AIME 2024+2025):24.79% vs 15.42%/0.42%/17.92%;Chess(Qwen3.5-4B,Lichess):29.83% vs 22.17%/19.82%/25.68%。即对最强单侧基线领先 7.67–10.05 个百分点,对 FST 领先 4.15–13.00 个百分点,并且在全部 10 个子 benchmark(7 个 QA 数据集、AIME24/25、Lichess)上都最优。瓶颈分析揭示两种域形态:SearchQA 是 harness 主导,harness-only 仅用 30,720 次 rollouts(weight-only 530,432 次的 5.79%)就追平其峰值,检索准确率从 26.88% 提到 60.61%,WHALE 进一步到 65.41%;格式合规上 weight-only 峰值 97.07%、harness-only 99.98%,而答案提取上权重占优(79.93% vs 57.28%)。Math 是权重主导:harness-only 只有 0.42%,weight-only 把截断率从 95.83% 压到 30.83%;但 WHALE 第一循环的搜索阶段用 4,608 次 rollouts 把格式准确率从 0.83% 提到 4.38%(+3.54 点),而 harness-only 花 46,080 次 rollouts 才 +0.63 点——小幅权重更新解锁了搜索效力。调度消融中 $(0.2,6)$ 最强(SearchQA 50.09%、Math 28.33%),加大预算单调变差($(1.0,10)$ 降至 45.93%/24.79%),$(0.2,2)$ 在 Math 因噪声失稳被中止;阶段式优化只有 43.02%/15.63%,被 $(0.6,6)$ 以 5.32/9.16 点优势支配。自适应 WHALE 在 SearchQA 取得全场最佳 52.82%(比最佳手工调度 +2.73 点、比 $(0.6,6)$ +4.48 点,rollouts 少 23%),Math 达 26.46%(比 $(0.6,6)$ +1.67 点、rollouts 少 4%,但比最佳手工调度低 1.87 点);其实现的相位中位数为 0.24/0.29 epoch、每周期 7 轮搜索,最长延展到 1.16 epoch 与 13 轮,恰落在消融识别的最优区间内。
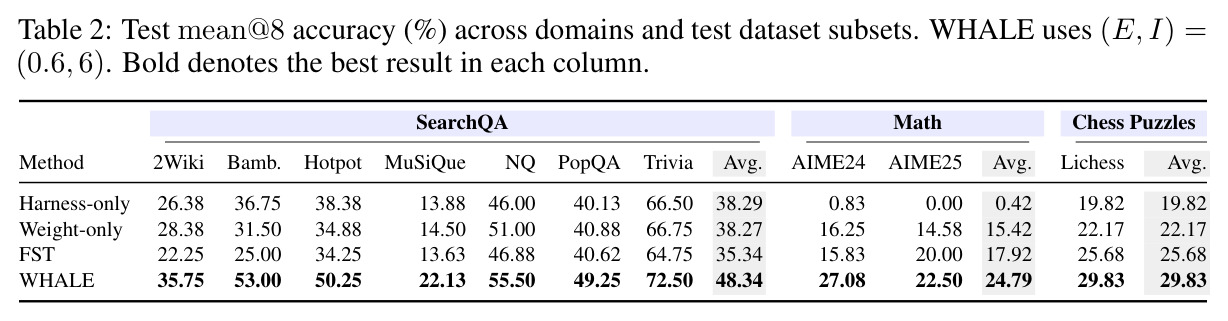
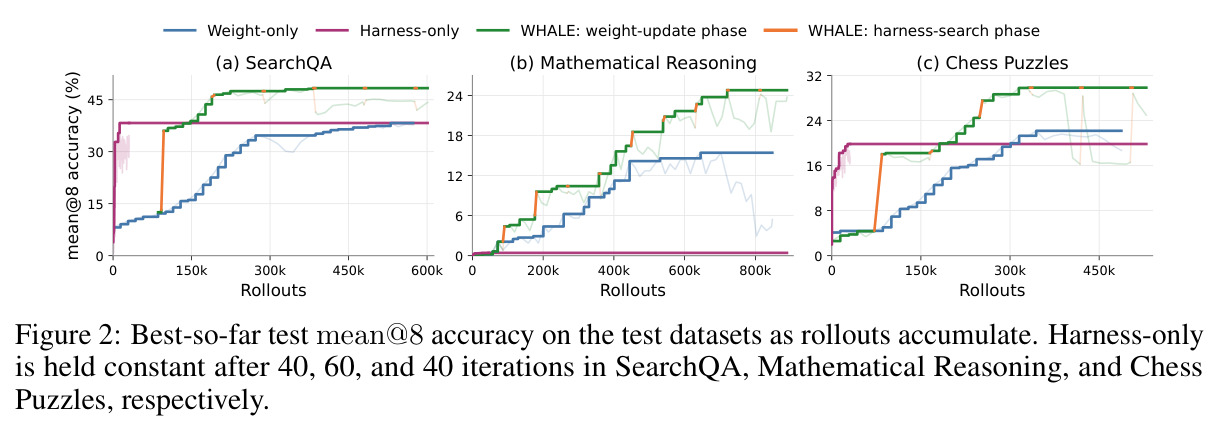
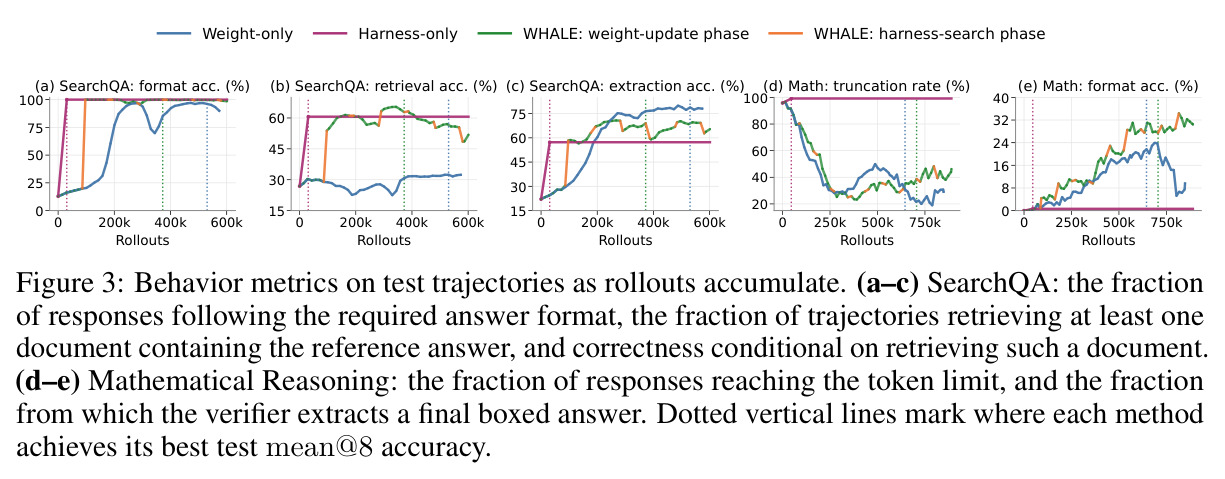
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SearchQA(7 个 QA 数据集汇总,Qwen3.5-2B) | test mean@8 (%) | 48.34(最佳调度 (0.2,6) 达 50.09,自适应 WHALE 达 52.82) | weight-only 38.27;harness-only 38.29;FST 35.34 | 较最强单侧基线 +10.05,较 FST +13.00;自适应版本较最强单侧基线合计 +14.53,且比 (0.6,6) 少 23% rollouts |
| Math(AIME 2024 + 2025,Qwen3.5-2B,代码执行) | test mean@8 (%) | 24.79(最佳调度 (0.2,6) 达 28.33,自适应 WHALE 达 26.46) | weight-only 15.42;harness-only 0.42;FST 17.92 | 较最强单侧基线 +9.37,较 FST +6.87;较失活的 harness-only 高出逾 24 个百分点 |
| Chess Puzzles(Lichess 256 题,Qwen3.5-4B) | test mean@8 (%) | 29.83 | weight-only 22.17;harness-only 19.82;FST 25.68 | 较最强单侧基线 +7.67,较 FST +4.15 |
| 阶段式(stagewise)联合优化对照,SearchQA / Math | test mean@8 (%) 与 rollout 效率 | 48.34 / 24.79,且分别在 stagewise 全程 29% / 49% 的 rollouts 处就超过其最终值 | stagewise (E*,I*)=(2.7,32) 得 43.02;(4.3,33) 得 15.63 | +5.32 / +9.16 个百分点,同时显著更省 rollouts |
局限与改进
作者承认并在文中给出的边界:实验规模有限(仅 Qwen3.5-2B/4B,三个域);框架搜索的 proposer 计算(Claude Opus 4.7 会话)不计入 rollout 预算,因此 SearchQA 上'5.79% rollouts 追平'的比较对搜索侧略有利;自适应规则在 Math 上比最佳手工调度低 1.87 个百分点,说明仅靠训练信号的 patience 未必能恢复最优调度。我自己的观察还有几点:其一,Algorithm 1 最终返回'在 $\mathcal{D}_{\text{test}}$ 上准确率最高的 $(\theta_k,h_k)$',全文以 best-so-far 曲线报告,存在测试集选择偏差,实际部署必须改用留出验证集;其二,FST 对照被重写过——用 RSFT 替换其强化学习更新、用受限 MH 替换其反思式 prompt 进化,并非原始实现,与 FST 的差距不能完全归因于搜索空间差异;其三,论文未报告多种子方差或显著性检验,mean@8 上一两个点的差距在小模型上可能不稳健;其四,$|\mathcal{D}_{\text{harness}}|=256$ 的评分集很小,框架搜索可能过拟合这个子集(作者也用类似逻辑解释 stagewise 搜索在 Math 上的失效);其五,三个域都是短 horizon、验证器廉价的任务,长周期软件工程类任务的候选 harness 评估成本结构完全不同,结论外推性存疑。
独立分析的弱点
独立分析的弱点:第一,测试集选择问题——best mean@8 既是报告口径又是返回准则,工程落地需改为验证集或训练信号选择,否则会有虚高,改进方向是引入小规模验证集并把它纳入自适应停止规则。第二,proposer 与 judge 都依赖闭源前沿模型(Claude Opus 4.7 做提议、GPT-5.4-mini 做 SearchQA 判分),其 API 成本与延迟未出现在任何预算口径中,且 judge 的评分噪声会直接污染 RSFT 的训练信号与候选排序;可蒸馏开源 proposer,或用多数投票/规则校准 judge。第三,交替循环的稳定性没有理论保障:$J(\theta,h)$ 不可分时坐标下降可能循环震荡,Math $(0.2,2)$ 的失稳即是征兆,可引入信任域机制或对相位长度做置信区间检验后再切换。第四,每个域的 harness 搜索空间(允许改什么、禁止改什么)仍是手工定义的,Chess 域甚至禁止 harness 生成或替换着法——这个'元空间'本身未被优化,让搜索空间随训练自动扩展是自然的改进。第五,三个域都使用稀疏二值结果奖励;在过程奖励或稠密反馈场景下,RSFT 只学满分轨迹的设定与框架搜索的分工可能完全不同,方法在那种环境下的表现未知。第六,实验未报告种子方差,且 Chess 域用 4B 模型而其他域用 2B,跨域对比的严格性略打折扣。
未来方向
作者明确提出的方向:用其他权重更新算法(如策略梯度/GRPO)与其他框架搜索方法实例化两个黑盒算子;把研究扩展到更大模型和更多领域;更宏观地,把模型与其 harness 当作一个联合训练的系统而非两个分别工程化的工件。基于本文成果还可延伸:其一,把'短框架搜索作为权重训练前的低成本瓶颈诊断'形式化——论文已观察到 SearchQA 上搜索以 5.79% rollouts 追平权重峰值、Math 上搜索失效预示需要先动权重,这可以做成自动决定先优化哪个组件的元控制器;其二,两阶段的并行/异步化,用稍微过期的模型或 harness 换取吞吐,同时监控偏差是否可控;其三,为交替过程建立收敛性或稳定性分析,刻画 $J$ 的非可分程度与最优相位长度的关系;其四,跨任务的 harness 迁移与复用——搜出的 harness 能否在同域新任务上冷启动,省去每个任务从零搜索的开销;其五,把 harness 搜索空间本身参数化并学习(决定向搜索器暴露哪些钩子),以及研究 proposer 能力(模型大小)与搜索质量的标度关系。
复现评估
复现条件较好:代码已在 GitHub 开源(github.com/krafton-ai/WHALE),三个域的数据全部公开(HotpotQA、Natural Questions、2WikiMultiHopQA、Bamboogle、MuSiQue、PopQA、TriviaQA、DAPO-Math-17K、AIME 2024/2025、Lichess puzzle 数据库),基座模型 Qwen3.5-2B/4B 为开源权重;论文附录给出了完整的算法伪代码(Algorithm 1/2)、超参总表(Table 1)、各域初始 harness 与搜索空间定义、以及 SearchQA 的完整 LLM judge 提示词,透明度很高。主要门槛在算力与 API:训练是在线 rollout 密集型流程,主实验消耗数十万次 rollouts(仅 weight-only 在 SearchQA 就约 53 万次),需要能同时承担推理采样与 SFT 训练的 GPU 集群;框架搜索依赖 Claude Opus 4.7 做 proposer(每轮 3 个候选、每周期 6 轮以上),SearchQA 验证器还要调用 GPT-5.4-mini 判分,这两项是持续的 API 开销。总体属于中等复现难度:有开源代码与数据支撑,完整复现三域主表估计需要多卡 GPU 运行数天加可观 API 费用;只复现单域(如 SearchQA)或先跑 harness-only 基线则门槛低得多。
论文图表
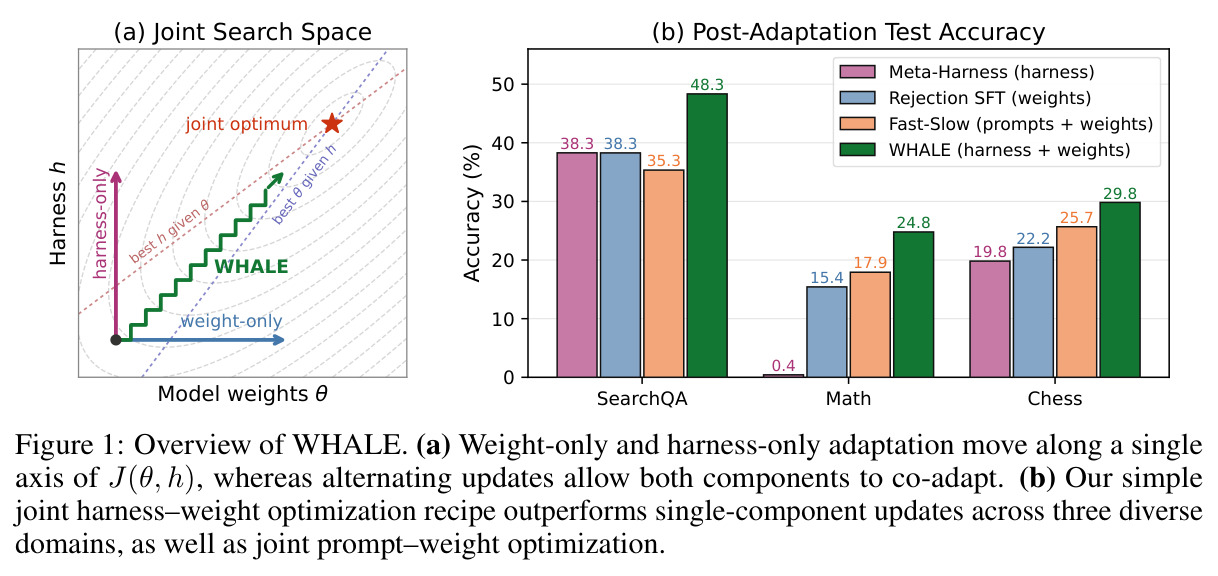
(a) 以权重 $\theta$ 为横轴、harness $h$ 为纵轴画出联合目标 $J(\theta,h)$ 的等高线示意:weight-only 与 harness-only 只能在单一轴线上移动,各自把自己那条轴推到极大就停在局部最优点;WHALE 的交替更新让两个分量沿山谷共同走向联合最优。(b) 三个域上的柱状对比:SearchQA 上 WHALE 48.3% vs weight-only 38.3%、harness-only 38.3%、FST 35.3%;Math 上 24.8% vs 15.4%/0.4%/17.9%;Chess 上 29.8% vs 22.2%/19.8%/25.7%。
一图概括全文的核心论点(单轴优化停在局部最优、交替才能共适应)与主要结果量级,是快速理解论文价值的最优入口。