MULTI3IR:多视角、多领域、多模态信息检索基准 MULTI3IR: A Benchmark for Multi-perspective Multi-domain Multi-modal Information Retrieval
构建10.5万条多视角多模态检索基准,用噪声注入法SPIN大幅提升视角覆盖。
前置知识
稠密检索(Dense Retrieval)
把查询和文档用同一个(多模态)编码器映射为向量,按内积或余弦相似度排序召回,即 $D^*(k)=\mathrm{Top\text{-}k}_{d\in C} f(Q)^\top f(d)$。相比 BM25 等词法匹配,它能捕捉语义相似性,是当前多模态检索的主流范式。本文的三个骨干 MM-Embed、GME-Qwen2、Qwen3-VL 全部是稠密多模态检索器。
全文的任务定义、覆盖率指标和 SPIN 的推断流程都建立在稠密检索的向量相似度框架之上。
多向量检索(Multi-vector Retrieval)
为一条查询生成多个嵌入向量,每个向量独立检索后再合并结果,以覆盖嵌入空间中彼此分散的相关文档,代表工作有 ColBERT、poly-encoders。本文的 LLM-Expansion(生成多条改写查询)与 ARE(自回归生成多向量)都属于此类;SPIN 同样输出 $m$ 个向量并用 Round Robin 合并。
SPIN 本质上是一种免文档标注的多向量训练方法,需要对照既有做法才能理解其优势。
InfoNCE 对比损失
检索微调最常用的对比目标:拉近正样本对、推远批内其他样本作负样本,形式如 $-\log \frac{e^{\mathrm{sim}(q,d^+)/\tau}}{\sum_{d'} e^{\mathrm{sim}(q,d')/\tau}}$。本文的 fine-tuned Naive 基线就用它配合批内负样本训练。
SPIN 的 noisy-OR 损失是针对多对多集合对齐设计的替代方案,理解 InfoNCE 的一对一假设才能看出二者的本质差别。
参数高效微调(PEFT)
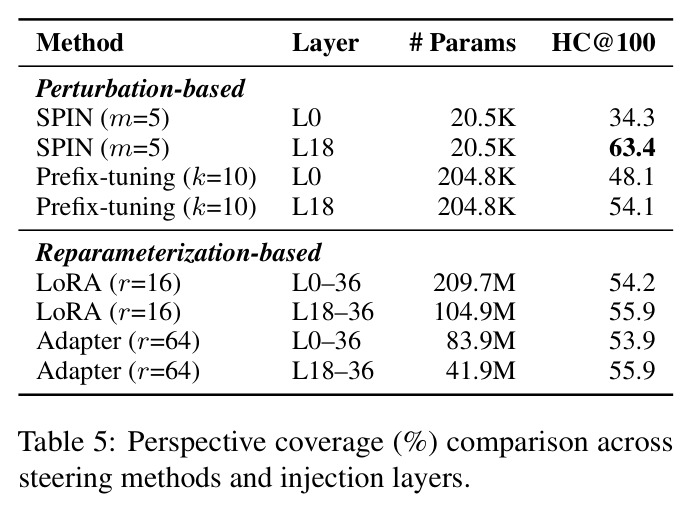
冻结大模型权重、只训练少量新增参数的微调范式,包括 LoRA(低秩分解更新权重)、prefix-tuning(可学习软前缀)、adapter(插入小模块)等。本文将 SPIN 与这些方法直接对比:SPIN 只训练约两万个噪声向量参数,而 LoRA 需要上亿参数。
论文从 PEFT 视角论证 SPIN 的参数效率,Table 5 的对比实验是关键证据。
Round Robin 轮询聚合
把 $m$ 个查询向量各自的排名列表按轮次交错合并:每轮依次取各列表的第 $r$ 名文档、跳过重复项,直到凑满 $k$ 条。它无需调权重即可公平覆盖各视角,是本文 oracle、基线与 SPIN 推断的默认融合策略。
无论诊断实验还是最终检索,都要靠它把多个向量独立检索的结果合成一个最终排序。
中间层表征(Intermediate-layer Representations)
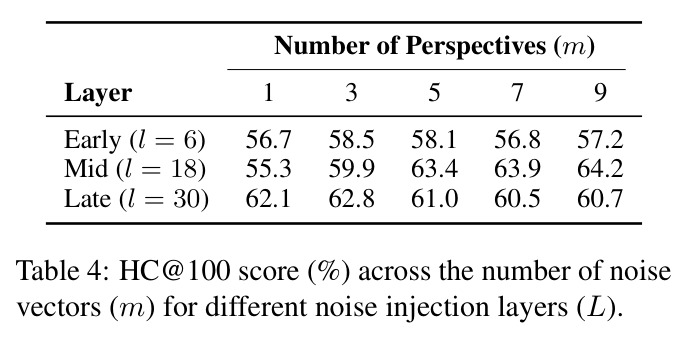
Transformer 各层隐状态的语义并不相同:已有研究(Skean et al., 2024/2025)表明中间层保留更丰富、更多样的语义信息,而最后一层趋向收敛到单一主导解释。SPIN 正是利用这一性质,在第 $l=L/2$ 层注入噪声来改变最终嵌入的方向。
注入层的位置是 SPIN 成败的关键,Table 4 与 Table 5 的层位置消融必须借助这一概念来解读。
研究动机
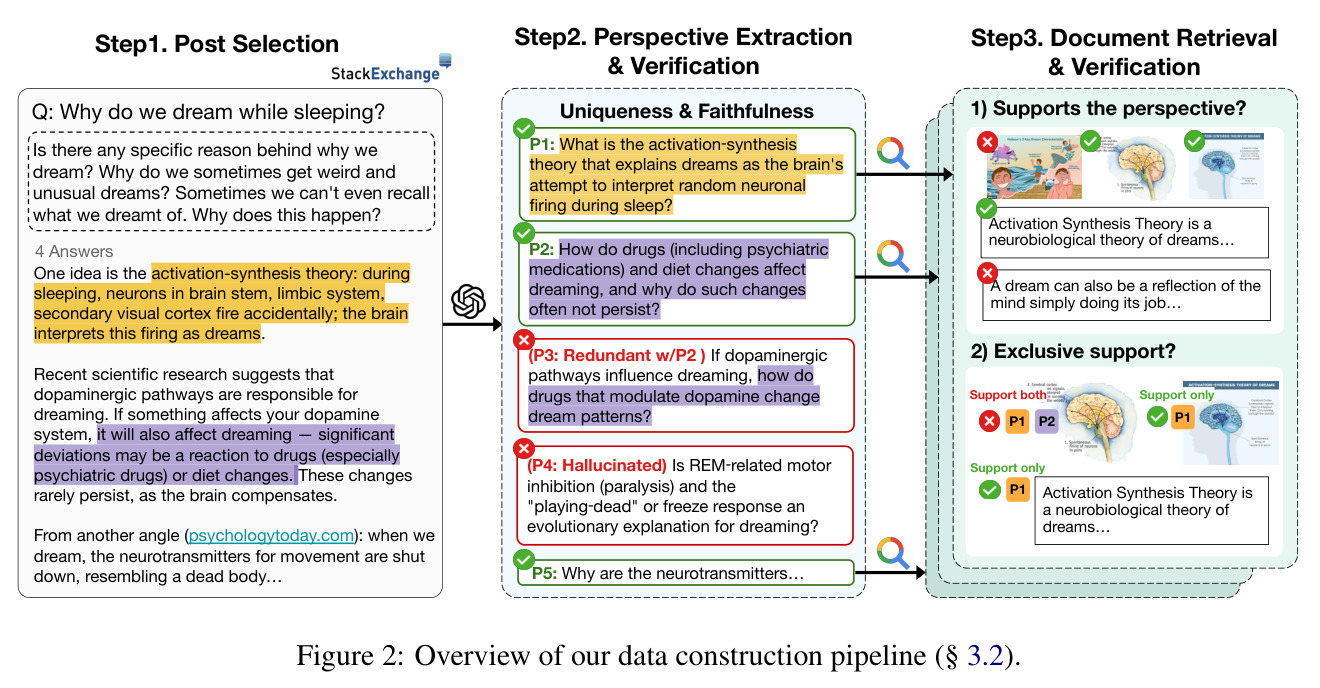
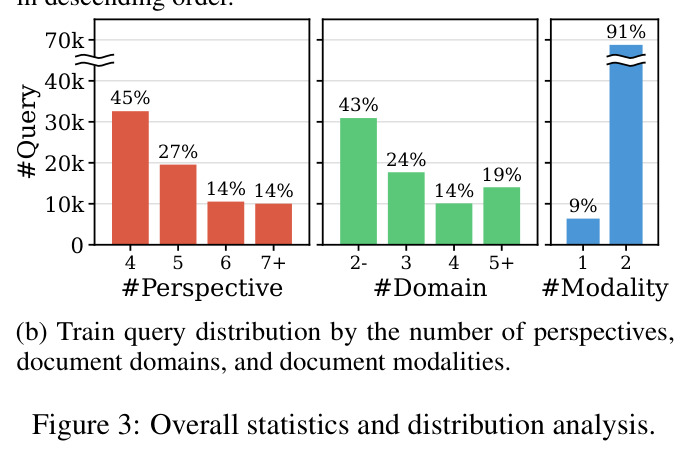
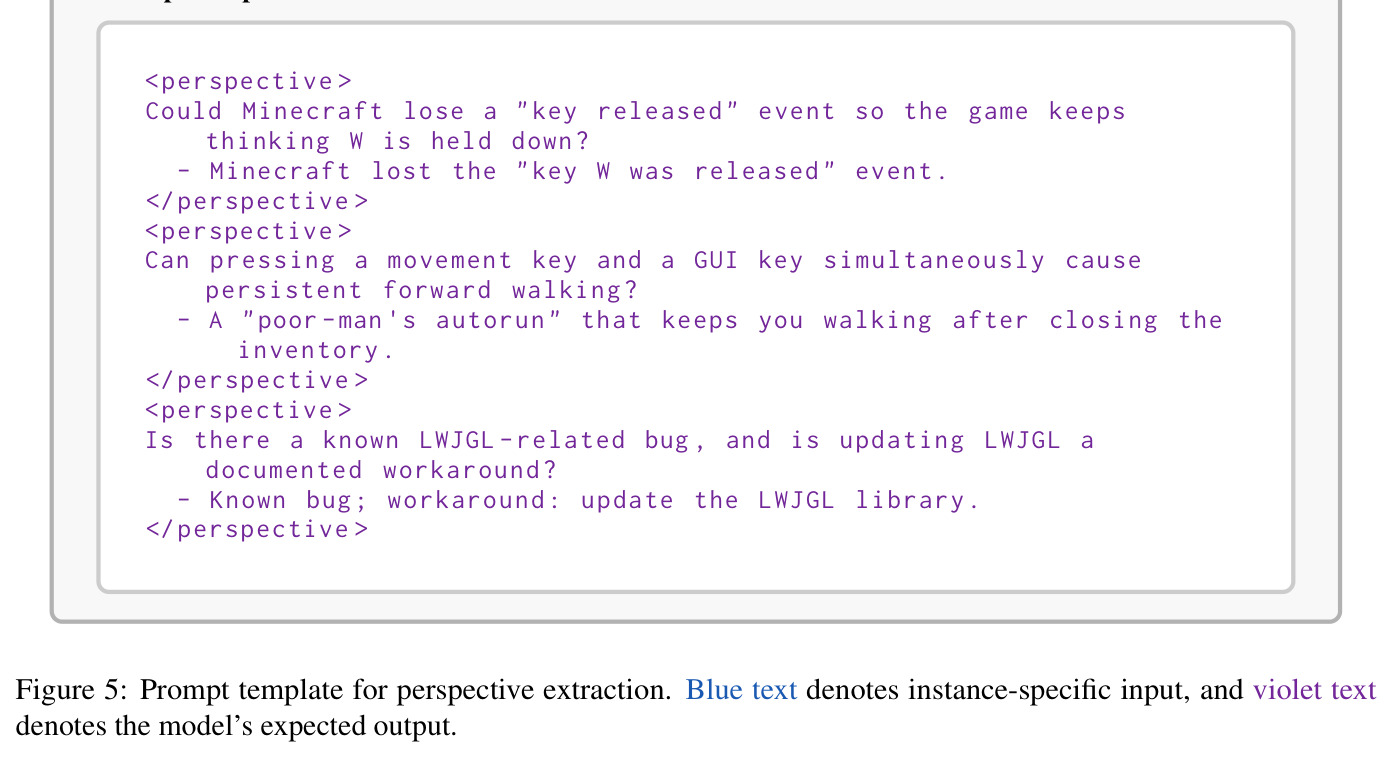
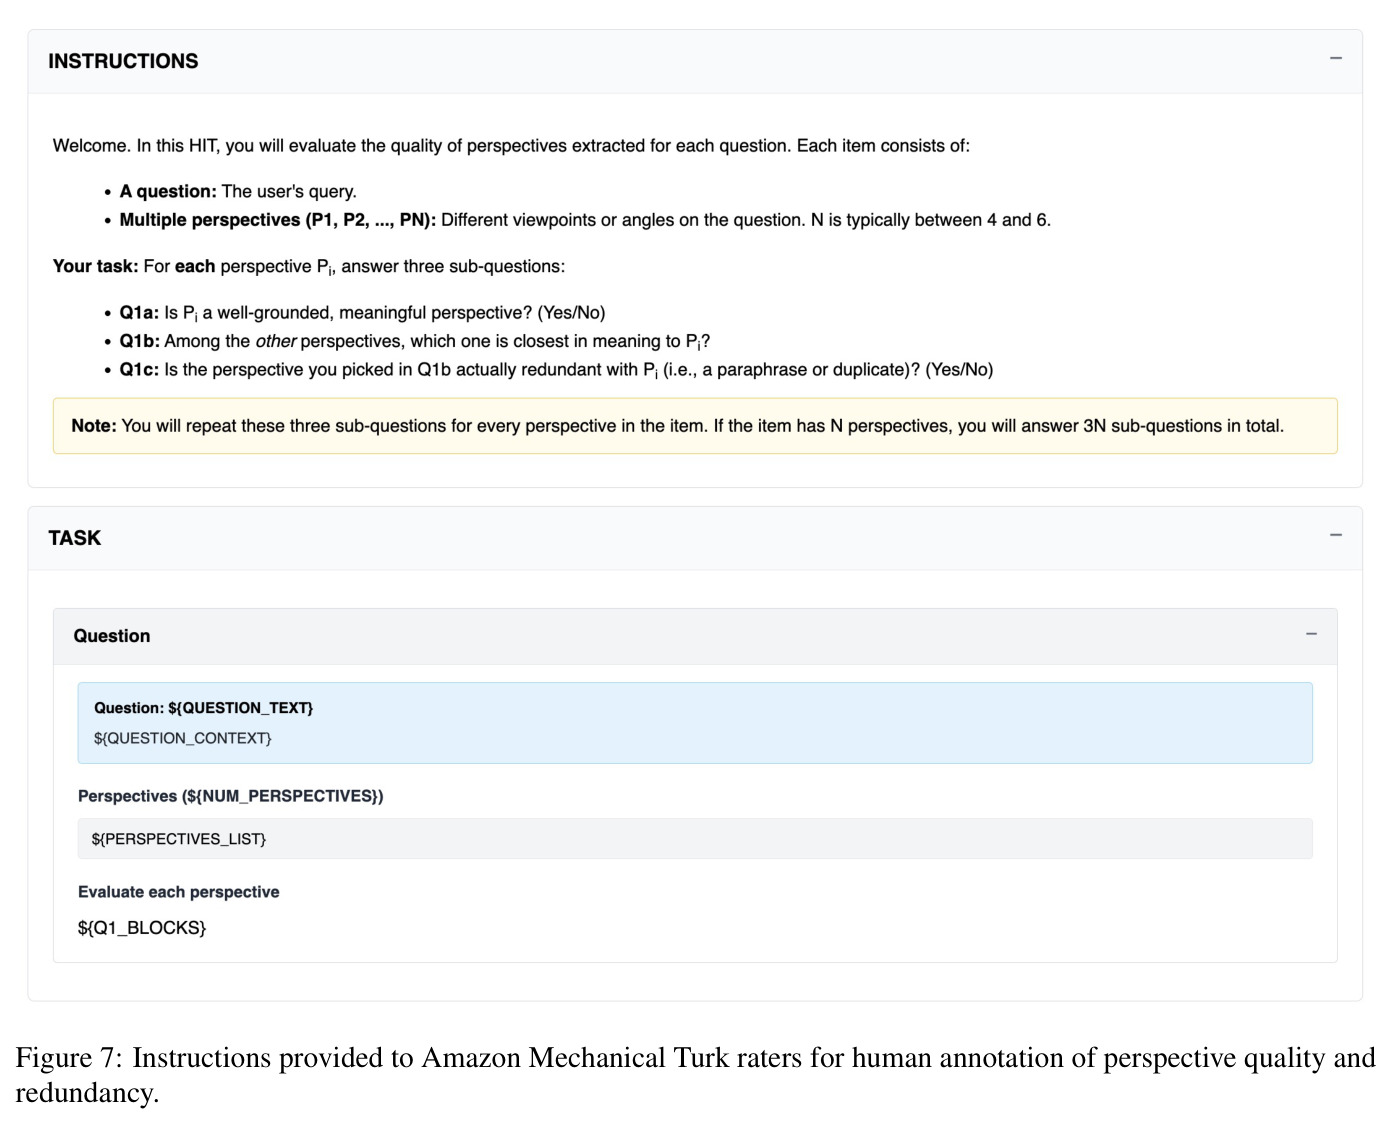
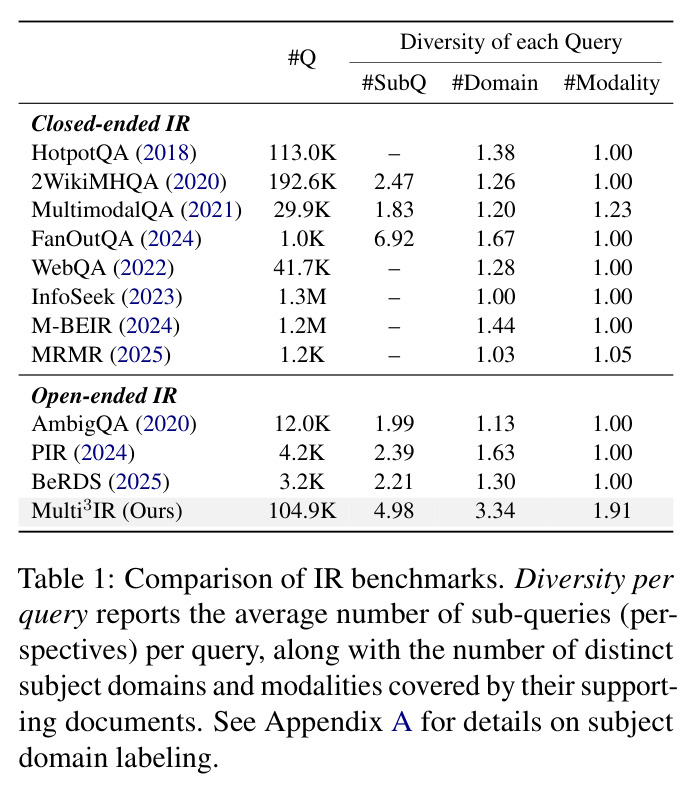
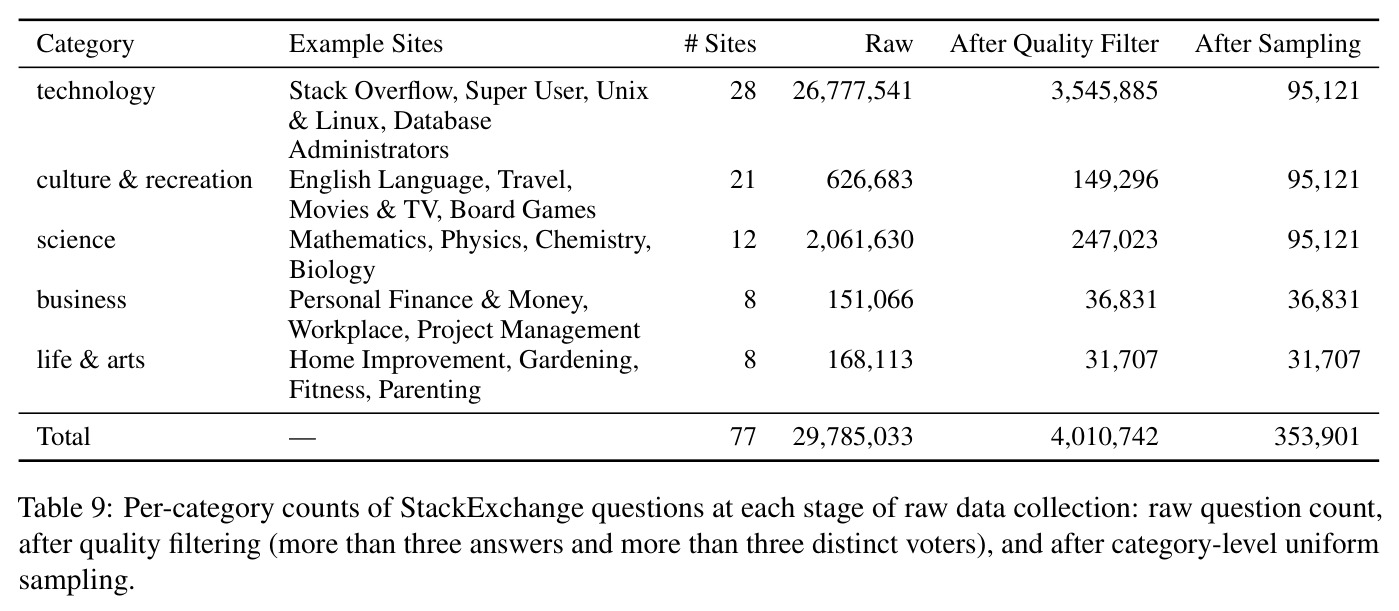
现有 IR 评测以封闭式查询为主:有唯一标准答案,支持文档集中在单一领域和模态。作者对主流基准的统计(Table 1)显示,HotpotQA(113.0K 查询)平均每题只需 1.38 个子查询、1.38 个领域、1.00 种模态;WebQA、InfoSeek、M-BEIR 等多模态基准的模态多样性也只有 1.00–1.44;即便是开放式的 AmbigQA、PIR、BeRDS,平均领域数也仅 1.13–1.63、模态数几乎全为 1.00。而真实的信息需求往往开放:例如“为什么蓝色食物这么少?”隐含生物学(蓝色色素在自然界稀缺)、心理学(人对蓝色食物的感知)、化学(烹饪中颜色变化)等多个视角,需要跨领域、跨模态的证据才能全面回答。方法侧同样有短板:查询扩展要在推断时为每条查询调用一次外部 LLM;多向量检索(如 ARE)的训练则依赖昂贵的文档级相关性标注。初步实验还表明,现有多模态检索器对开放式查询存在明显的“单一视角偏差”——top-20 结果几乎全落在最主导的视角上。
本文的目标是本文目标分两层。评测层:构建一个专门衡量“视角覆盖(perspective coverage)”的大规模基准 MULTI3IR,让每条开放式查询平均需要覆盖约 3.34 个学科领域和 1.91 种模态,从而量化现有检索器在全面性、多样性上的短板;配套定义 Hard Coverage(严格命中标注支持文档)与 Soft Coverage(LLM 判定语义支持)两类指标。方法层:提出 SPIN,在不修改冻结检索器权重结构的前提下,只用轻量的视角描述标注(完全不需要文档相关性标签),把一条开放式查询展开成 $m$ 个视角感知的嵌入向量,使每个视角至少召回一篇支持文档的比例大幅提升,并能零样本迁移到 PIR、BeRDS 等未见过的开放式检索基准。
与已有工作不同的是,本文的独特切入角度有三点。其一,数据来源上利用 Stack Exchange 多答案社区问答的自然结构:一个问题天然聚集多个视角的社区回答,回答中被引用的外部链接天然提供视角对应的证据文档,绕开了人工构造多视角查询与标注的高成本。其二,诊断上把“单一视角偏差”的瓶颈明确定位在查询嵌入而非文档空间——Figure 4 显示,改用 oracle 视角描述作查询并用 Round Robin 合并后,原本漏检的文档即可被召回,这直接指引方法设计面向“改造查询端嵌入”。其三,方法上不走权重重参数化(LoRA/adapter/prefix-tuning)或推断时 LLM 改写(query expansion)的老路,而是在冻结编码器的中间层隐状态上直接注入可学习的噪声向量,用视角描述做监督信号,实现参数与标签的双轻量。
核心方法
直觉上,一条开放式查询像一束白光,现有检索器把它压缩成单个嵌入向量,只能照亮最主导的视角;SPIN 想做的类似棱镜分光——用一组可学习的噪声向量在编码器内部把同一查询“折射”成 $m$ 个方向各异的嵌入,各自负责一部分视角。技术路线分三步:先做诊断实验,证明瓶颈在查询嵌入(用 oracle 视角描述当查询就能找回漏检文档,见 Figure 4);然后冻结检索器全部权重,仅在中间层 $l=L/2$ 注入 $m$ 个可学习噪声 $\varepsilon$:把噪声加在该层隐状态 $h^l$ 上再走过剩余层,得到 $m$ 个“导向嵌入”;训练时用同一冻结编码器编码视角描述得到目标嵌入集合,以 noisy-OR 概率覆盖损失对齐两组向量集合。推断时 $m$ 个导向嵌入各自独立执行最大内积检索,再用 Round Robin 交错合并成最终 top-$k$,全程不需要任何 LLM 调用。
核心创新是把“多视角检索”转化为“冻结模型内部的向量导向(steering)”问题。与已有方法的本质区别有三:(1) 相比 ColBERT/ARE 等多向量检索,SPIN 不改模型结构、不需要文档级相关性标签、推断时只做一次前向——噪声在潜空间中加性注入,而 ARE 需要逐向量串行自回归生成,开销大得多;(2) 相比 prefix-tuning/LoRA 等权重重参数化,SPIN 扰动的是中间层隐状态——因为中间层保留更丰富的语义而最后一层已坍缩到单一解释,这一选择带来 Table 5 中 7.5 分的 HC@100 领先和超过三个数量级的参数节省;(3) 训练目标用 noisy-OR 概率化的集合覆盖(多对多),避免匈牙利匹配的一对一硬分配:正向损失只要求每个视角目标被至少一个导向向量覆盖,负向损失要求所有导向向量拒绝来自其他查询的批内负视角。
方法步骤详情
训练过程对应 Algorithm 1,只更新噪声向量、完全冻结编码器。输入为冻结编码器 $M$($L$ 层)、72K 训练查询及其视角描述集 $P_n$、可学习噪声集 $E=\{\varepsilon_1,\dots,\varepsilon_m\}$($m=5$,初始化 $N(0,0.01^2)$,总参数约两万)。对每条查询:① 前向到中层 $l=0.5L$(Qwen3-VL 第 18 层、MM-Embed 第 18 层、GME 第 14 层)得隐状态 $h^l=M_{0\to l}(q)$;② 对每个 $\varepsilon$ 计算剩余层输出 $M_{l\to L}(h^l+\varepsilon)$,得 $m$ 个导向嵌入集 $S_n$——每个向量被期望对齐一个视角方向;③ 用 $M$ 编码视角描述得目标嵌入集 $T_n$;④ 把余弦相似度概率化 $p_s(t)=\sigma((\cos(s,t)-b)/\tau)$,$\tau=0.1$、$b=0.5$;⑤ 最小化 $\mathcal{L}=\mathcal{L}_{pos}+\mathcal{L}_{neg}$:正向用 noisy-OR 保证每个视角目标被至少一个导向向量覆盖,负向惩罚导向向量与批内其他查询视角的相似。优化用 AdamW、batch size 32,学习率按骨干取 3e-4/1e-2/1e-3。推断时(式 2–4):101 万文档嵌入预先算好并冻结,每个导向嵌入独立执行最大内积检索,再经 Round Robin 每轮依次取各列表第 $r$ 名、跳过重复,直至凑满 $k$ 条。
技术新颖性
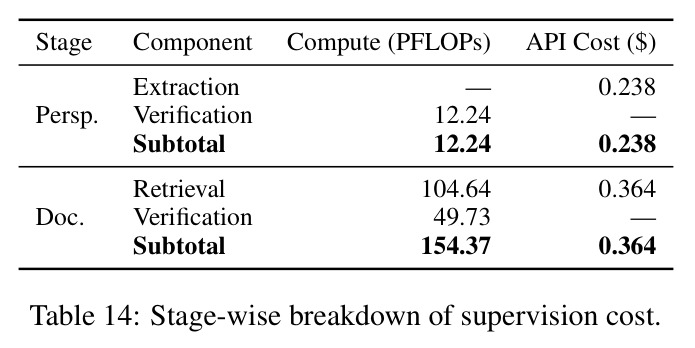
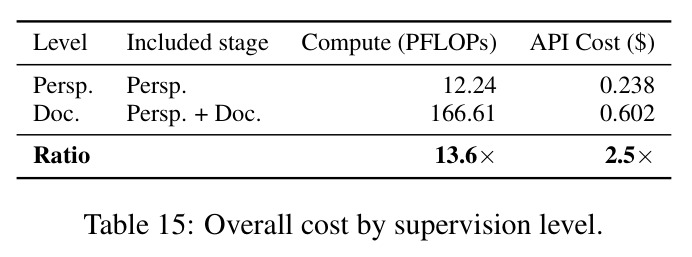
技术新颖性体现在四个层面。监督信号层面:把监督从“查询—支持文档”降为“查询—视角描述”,标注成本下降一个数量级(Table 15:文档级监督比视角级监督多 13.6 倍本地算力、2.5 倍 API 开销),这是区别于 ARE、fine-tuned Naive 等文档监督法的根本点。架构层面:在冻结模型的中间层隐状态上加性注入噪声,属于扰动型(perturbation-based)导向而非权重型(reparameterization-based)适配;消融显示扰动法从中层注入获益巨大(SPIN +29.1 分),而 LoRA/adapter 仅 +1.7~+2.0 分。损失设计层面:noisy-OR 覆盖损失把集合对齐松弛为概率覆盖问题,天然适配“多视角—多文档”的多对多结构,避免匈牙利匹配的组合开销与武断的一对一分配。系统层面:训练后推断零额外 LLM 调用、单卡 GPU 即可训练,与查询扩展方法每查询一次 LLM 调用的推断开销形成鲜明对比。
实验结果
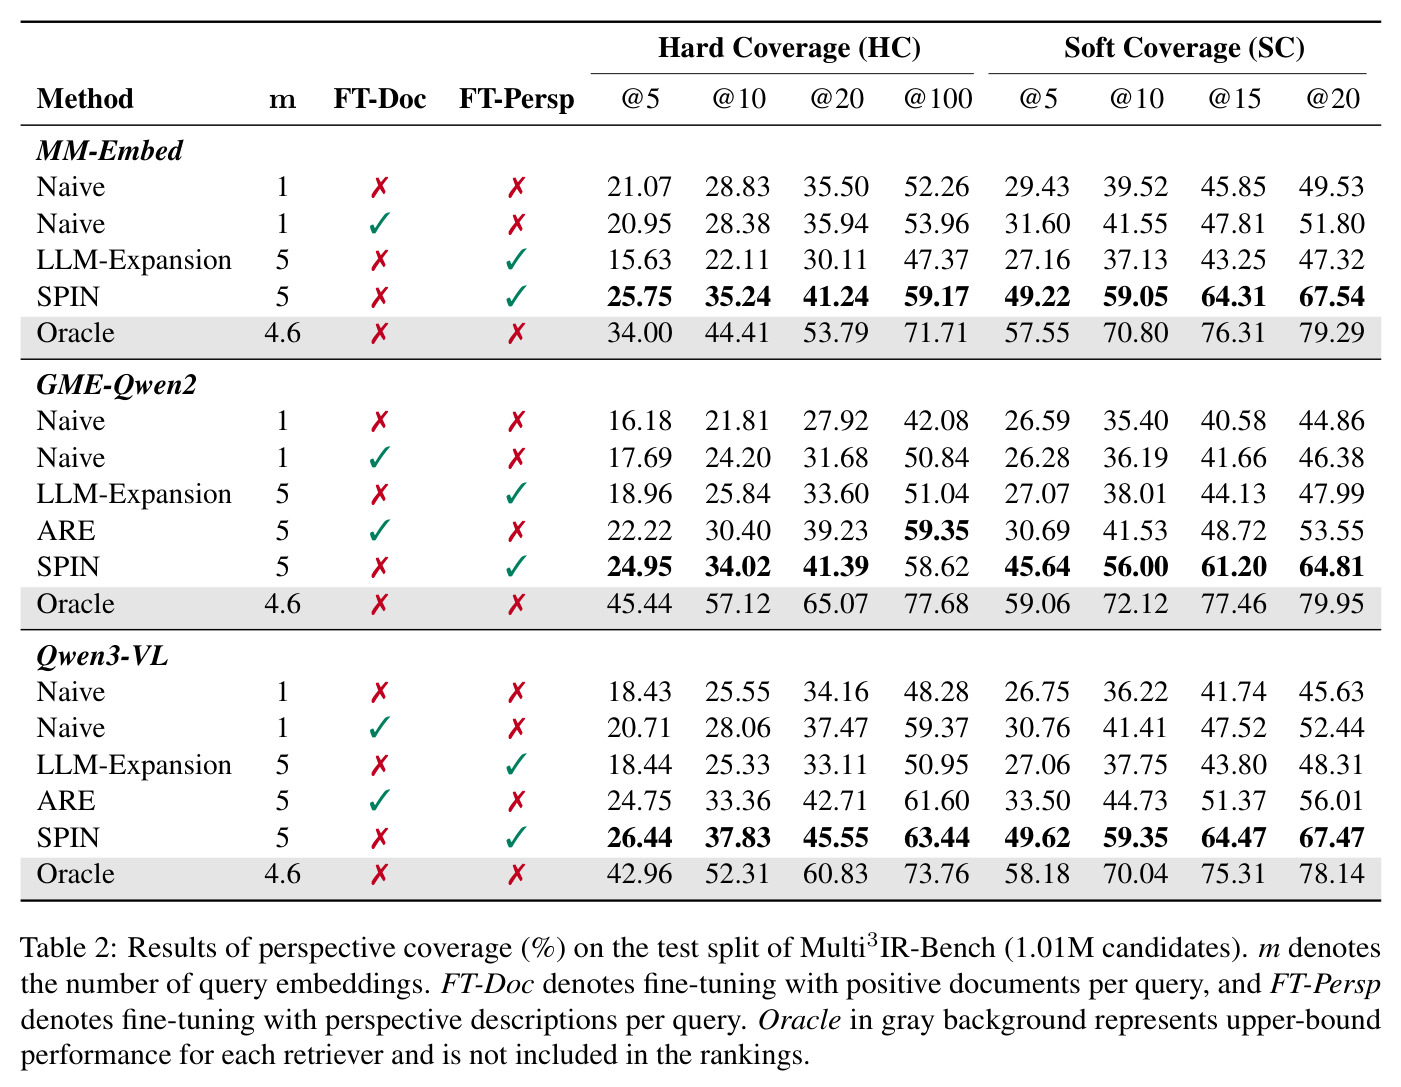
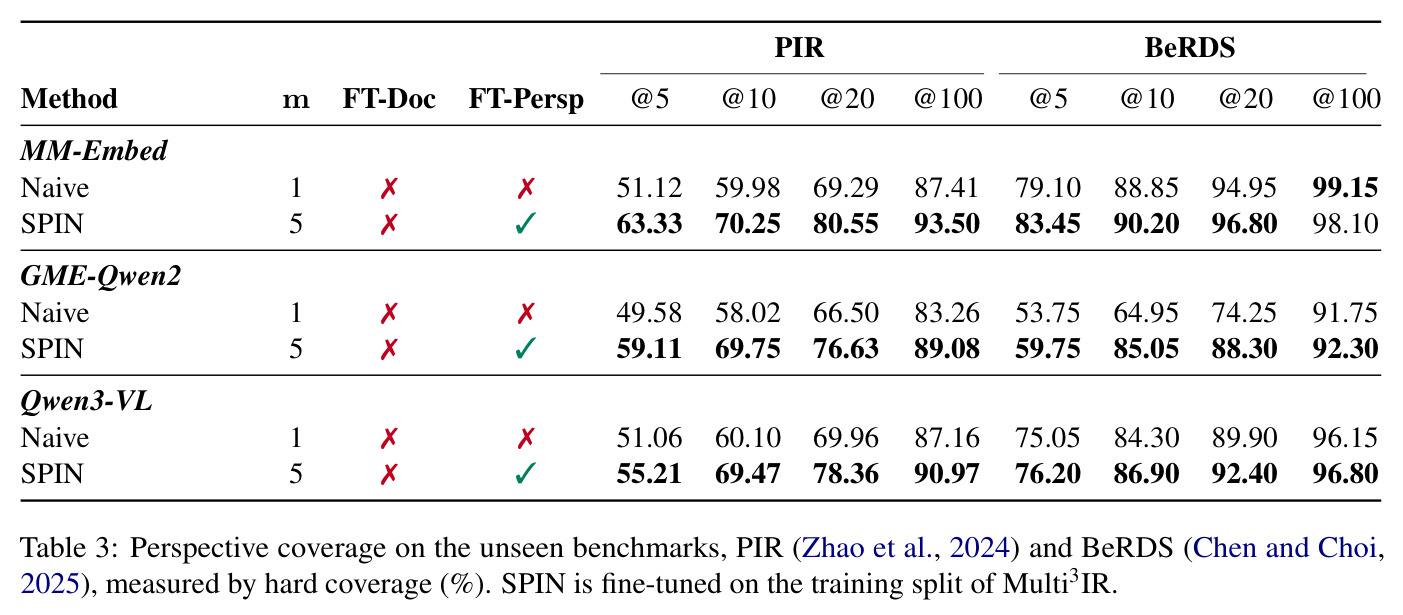
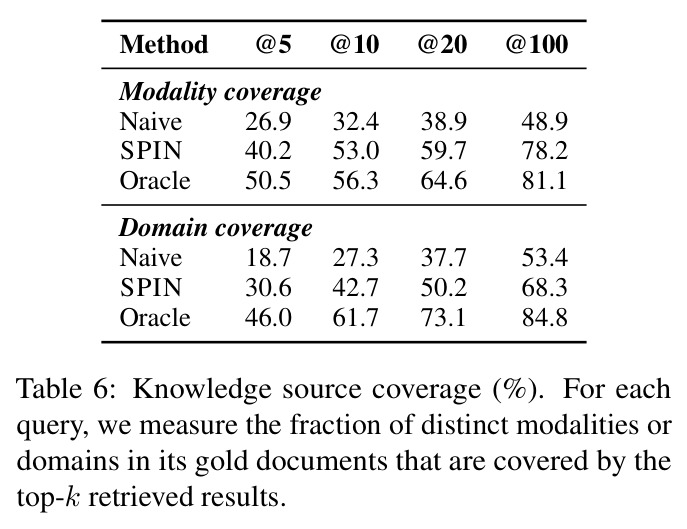
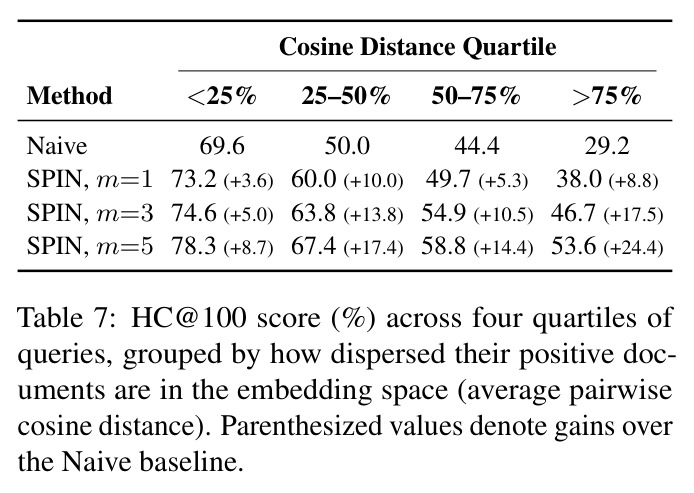
核心发现有五点。(1) 单一视角偏差普遍存在:零样本 Naive 在 MULTI3IR 测试集(101 万候选文档)上最高仅 28.83 HC@10、39.52 SC@10(MM-Embed),距 oracle(以视角描述作查询,$m\approx4.6$)在 HC@10 上差 15.58–35.31 分,且 $k=100$ 时仍差 19.45–35.60 分,说明失败源于查询理解而非召回深度。(2) SPIN 大幅领先:Qwen3-VL 上 HC@10 从 25.55 提至 37.83、SC@10 从 36.22 提至 59.35;HC@100 上三个骨干均创非 oracle 最佳(59.17/58.62/63.44)。(3) 监督类型比监督数量重要:同为 $m=5$,SPIN 比 LLM-Expansion(微调 Qwen3-4B 生成改写查询)高 8.18–13.13 HC@10、17.99–21.92 SC@10,而后者甚至低于 Naive 基线,说明多向量本身无益、必须显式训练对齐视角;SPIN 还比文档级监督的 ARE 高 3.62–4.47 HC@10、约 14.5 SC@10。(4) 零样本迁移有效:PIR 上 HC@10 提升 9.37–11.73 分,BeRDS 上 GME-Qwen2 暴涨 20.10 分(64.95→85.05)。(5) 消融证实中层注入是关键(HC@100 63.4,对比晚层 60.7、早层 57.2),文档越分散增益越大(最分散四分位 +24.4);模态覆盖近乎饱和(78.2 vs oracle 81.1,关闭 91% 差距),领域覆盖仅关闭 35–47%(68.3 vs 84.8)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MULTI3IR 视角覆盖(Qwen3-VL 骨干) | HC@10 | 37.83(SPIN) | 25.55(Naive 零样本) | +12.28 |
| MULTI3IR 视角覆盖(Qwen3-VL 骨干) | SC@10 | 59.35(SPIN) | 36.22(Naive 零样本) | +23.13 |
| MULTI3IR 视角覆盖(MM-Embed 骨干) | HC@10 | 35.24(SPIN) | 22.11(LLM-Expansion,同为 m=5) | +13.13 |
| MULTI3IR 视角覆盖(GME-Qwen2 骨干) | HC@10 | 34.02(SPIN) | 30.40(ARE,文档级监督多向量) | +3.62 |
| PIR 零样本迁移(GME-Qwen2) | HC@10 | 69.75(SPIN) | 58.02(Naive) | +11.73 |
| BeRDS 零样本迁移(GME-Qwen2) | HC@10 | 85.05(SPIN) | 64.95(Naive) | +20.10 |
| 参数效率对比(Qwen3-VL,中层注入) | HC@100 | 63.4(SPIN,20.5K 参数) | 55.9(LoRA r=16,104.9M 参数) | +7.5,参数少约三个数量级 |
局限与改进
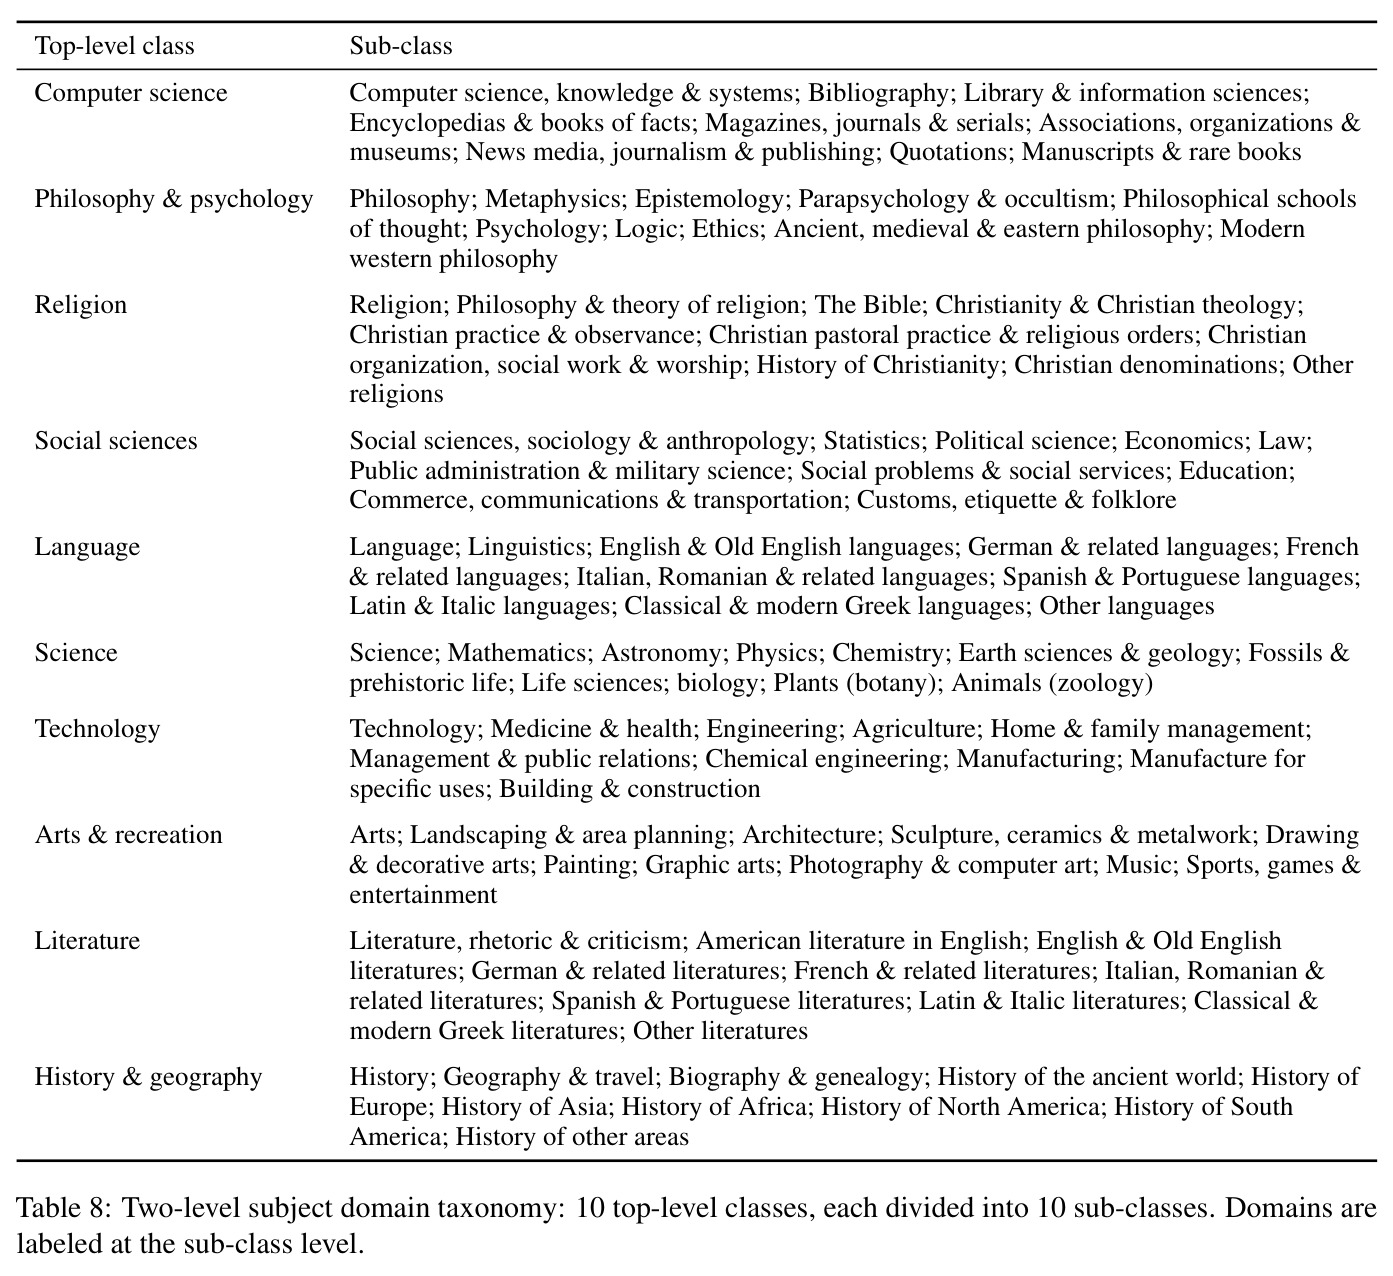
作者承认三点局限:视角数随查询变化(平均 4.97)而 SPIN 用固定 $m$;未联合利用视角描述及其支持文档做训练;自动流水线(GPT-5-mini 抽取、Qwen3-VL-30B 验证)可能残留 LLM 偏差,影响绝对分数。我补充几点:(1) 领域覆盖远未解决——$k=100$ 时只关闭 35–47% 的 naive-to-oracle 差距(68.3 vs 84.8),导向向量主要学到话题/模态多样性而非学科多样性;(2) 独占性过滤丢弃了 32.7% 的文档(同时支持兄弟视角者被剔除),任务可能比真实信息需求更苛刻;(3) 人工校验的测试集仅 1.0K 查询、4.8K 视角,HC 依赖标注文档可能漏掉未标注证据,SC 因 API 成本只测到 $k=20$;(4) 语料为英文 Stack Exchange,领域偏斜(57.7% 文档落入“其他”类、计算机类占 19.5%),跨语言与长尾领域泛化未知;(5) 主结果来自单次运行,未报告方差与显著性。
独立分析的弱点
独立分析的弱点:① 固定 $m=5$ 与平均 4.97 个视角失配——两视角查询会塞入冗余向量,七视角查询则覆盖不足,改进方向是用轻量回归头或基于覆盖置信度的停止准则自适应选择 $m$;② Round Robin 将各列表等权交错,忽略视角难度与检索置信度差异,可按每个导向向量的覆盖概率加权合并;③ 领域导向能力弱(Table 6),可在训练中引入领域标签作附加监督,或对目标嵌入做领域去相关;④ 训练只对齐视角描述嵌入、完全没用支持文档,白抛掉了已有证据,可设计视角级与文档级的联合损失;⑤ 自动验证器召回率不高(Qwen3-VL fully-only 标准 0.62),漏检会系统性缩小候选池,可用多验证器集成或更大规模人工抽检校准;⑥ 实验仅覆盖三个 7–8B 级多模态骨干,方法对更小/更大模型、纯文本检索器乃至重排序器的适用性有待验证。
未来方向
作者明确提出的方向包括:开发按查询自适应选择视角向量数 $m$ 的机制;联合利用视角描述与支持文档的训练目标;学习领域感知(domain-aware)的导向向量以弥补领域覆盖短板。基于本文成果还可延伸:把中间层导向思想迁移到重排序器与生成式检索;在 RAG 系统中把视角覆盖作为端到端答案多样性与忠实度优化的中间目标;将基准扩展到中文等多语言社区问答(如知乎、Stack Exchange 各语言分站)及更多模态(视频、表格、代码);研究导向向量在不同查询间的可组合性与可解释性(它们是否对应可命名的学科子空间);从理论上刻画“中间层语义更丰富”与加性扰动可控性之间的关系;并在观点搜索、文献综述、多学科会诊等真实场景中评估视角感知检索的下游价值。
复现评估
复现条件总体良好。数据与代码开源(github.com/seokwon99/Multi3IR);原始数据来自公开的 Stack Exchange dump(archive.org),文本候选来自 C4,图像来自 Google Image Search(经 Serper API,需付费 key)。构建成本透明且低廉:视角抽取加验证仅需 12.24 PFLOPs 本地算力与约 0.24 美元 API 费,完整的文档级监督也不过 166.61 PFLOPs 与 0.60 美元;但全流程串联了 GPT-5-mini、Qwen3-VL-30B、Bespoke-MiniCheck-7B、EAI-Distill-0.5b 等多个模型,环境与提示词的编排步骤较多。训练门槛很低:SPIN 只训练约两万参数,单张 A6000 48GB 即可(对比 Naive 微调需 4 卡 FSDP);评测需预计算 101 万文档嵌入(Qwen3-Embedding-4B + vLLM),Soft Coverage 依赖 GPT-5-mini API 且只测到 $k=20$。整体难度中等:算力门槛低,主要工作量在多模型流水线的复刻与 API 细节。
论文图表
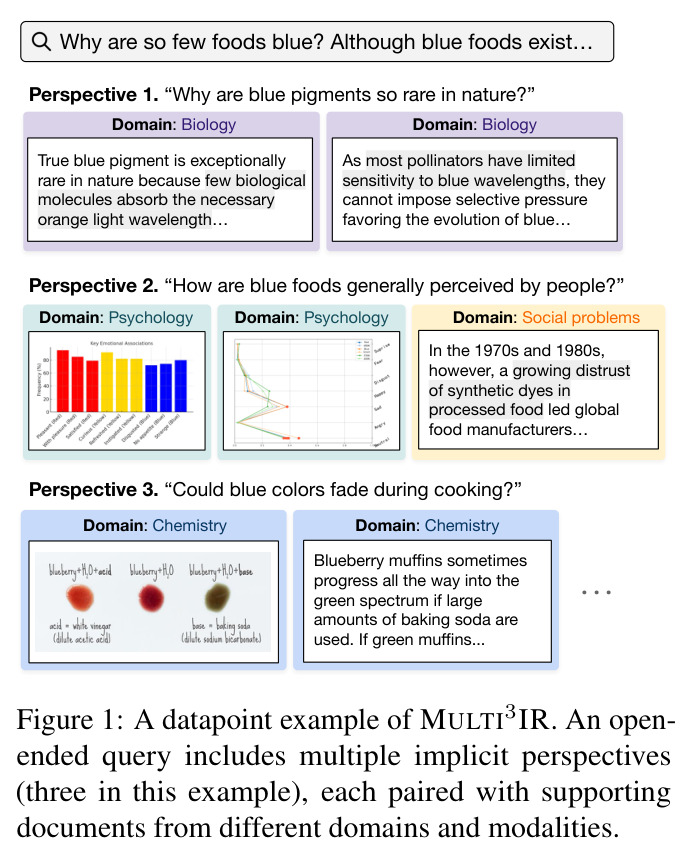
以“为什么蓝色食物这么少?”为例展示一个数据点:同一查询配有三个视角子问题(生物学:蓝色色素在自然界稀缺;心理学:人对蓝色食物的感知;化学:烹饪中的颜色变化),每个视角都对应来自不同学科领域、文本或图像模态的支持文档。
直观定义了“多视角、多领域、多模态”的任务形态,是理解全文评测目标的起点。
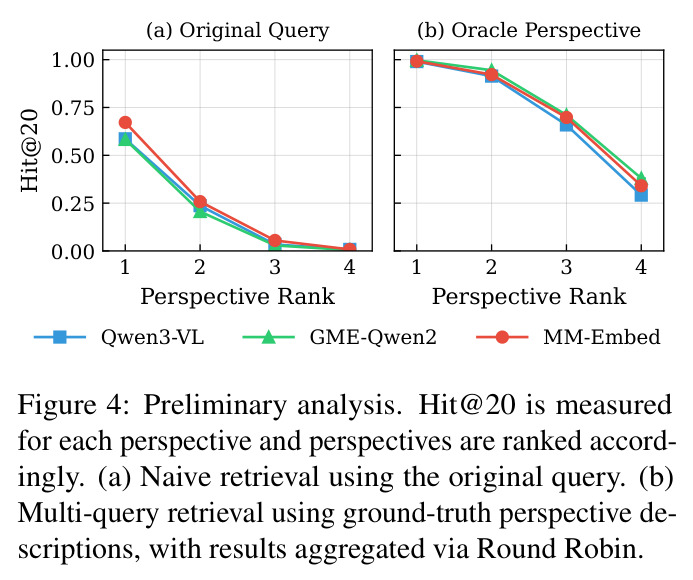
诊断实验:按视角命中难度排序绘制 Hit@20。(a) 直接用原始查询检索时,非主导视角的命中率显著跌落;(b) 改用 oracle 视角描述作查询并经 Round Robin 合并后,各视角命中率整体抬升且分布更均衡。
证明单一视角偏差的瓶颈在查询嵌入而非文档空间,是 SPIN 方法设计的直接动机。