用扎根理论大规模分析智能体行为:AutoTraceGT 多智能体编码流水线 Using Grounded Theory for Agent Behavior Analysis at Scale
把扎根理论自动化为多智能体流水线,从智能体轨迹归纳行为模式并验证理论饱和
前置知识
扎根理论(Grounded Theory)
社会科学中一种归纳式定性研究方法,由 Glaser 与 Strauss 于 1967 年系统提出。研究者不预设假设,而是从原始资料出发逐条标注意义(开放式编码)、跨资料归类联结(主轴编码)、最终整合为理论叙事(理论/选择性编码),类别完全从数据中涌现并随新数据不断修订。
本文的全部贡献就是把这套六十年历史的方法论自动化为多智能体流水线,不理解扎根理论就无法理解流程设计与评估逻辑。
理论饱和(Theoretical Saturation)
扎根理论的终止准则:当继续采样新数据不再产生新类别、新模式只被既有类别吸收时,归纳即告饱和。传统上依赖研究者主观判断,本文将其操作化为可计算判据——连续 $W$ 轮新增类别数 $a_t < \epsilon$ 即停止。
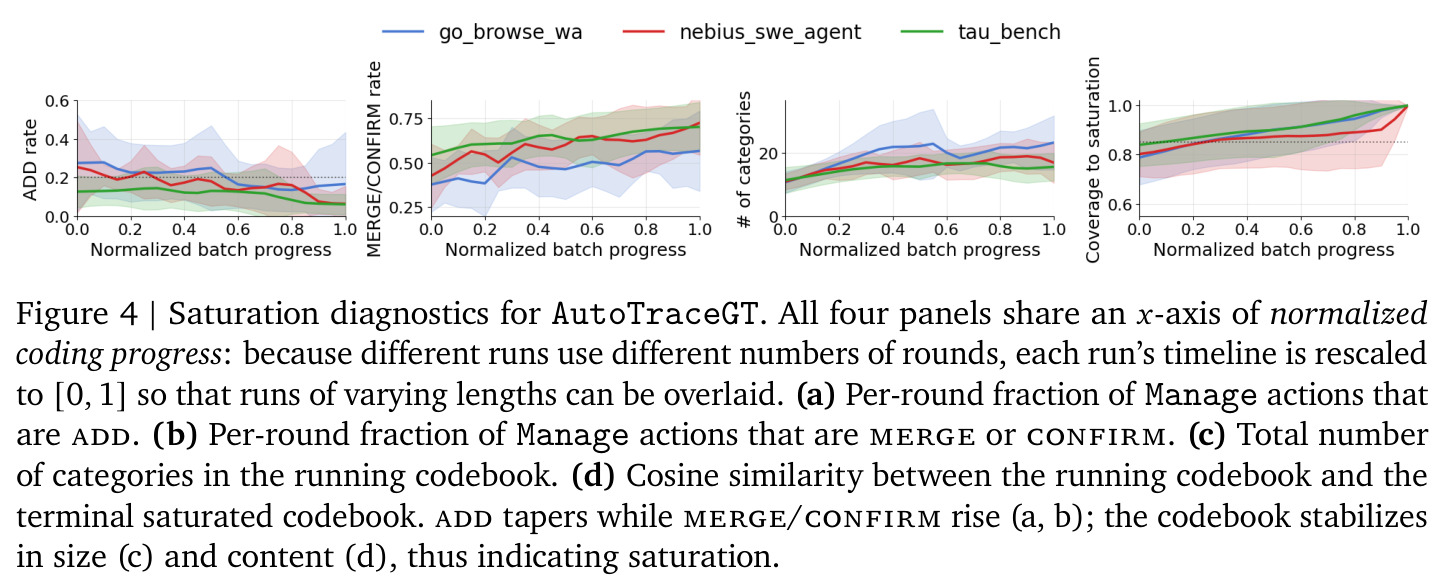
这是 AutoTraceGT 的算法停止条件,也是它区别于现有工作固定轮数做法的核心卖点,Figure 4 的四条诊断曲线都在实证验证它。
LLM 智能体轨迹
LLM 智能体与环境多步交互的完整记录,通常包含规划文本、工具调用(如 click、fill、bash)、环境观察返回和反思修订,单条可达数百步,终点带成败标签。分析智能体真实行为即是对这类轨迹做行为级归纳。
轨迹是本文的分析对象:六个数据集(SWE-Agent、Tau-Bench、Go-Browse、ALFWorld、GAIA、WebShop)共 7500 多条轨迹构成全部实验材料。
恒常比较(Constant Comparison)
扎根理论的核心操作:每采集一批新数据,就把其编码结果与既有编码册对照,决定是新增类别、合并进已有类别、拆分还是标记冲突,类别因此随数据持续演化。本文把它实现为 Manage 智能体的 add/merge/split/flag 动作集与只增不改的版本化修订日志。
理解 Manage 的合并优先策略与可审计性主张都必须先懂这个概念,它是整个流水线跨轮次记忆的来源。
MCC(马修斯相关系数)
面向不平衡二分类的综合指标,同时考虑混淆矩阵四个象限,取值 $[-1,1]$,0 等于随机预测。失败轨迹通常远少于成功轨迹,因此失败检测任务常用 MCC 而非准确率,本文搭配 ROC AUC 一起报告。
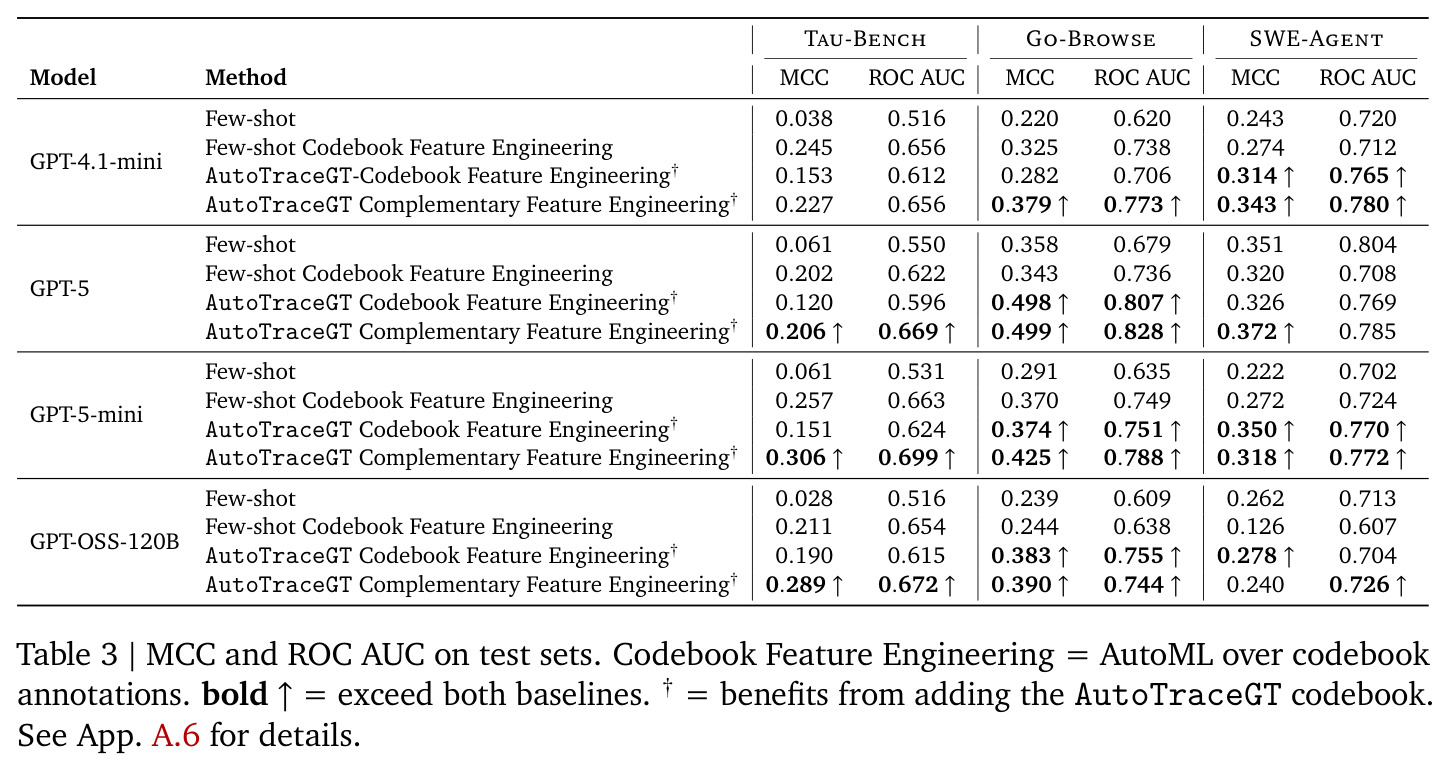
Table 3 的下游失败预测实验以 MCC 和 ROC AUC 为主指标,读懂结论优劣必须知道 MCC 对类别不平衡的鲁棒性。
研究动机
现有智能体行为分析困在两个方法学困境之间。其一是轻量量化元数据:轨迹长度、动作计数、token 消耗、任务成败等指标易于大规模统计,但对问题求解过程是盲的——论文开篇的例子中,WebArena 智能体执行了 47 个动作(8 次 bash、12 次文件编辑、3 次重试、1842 个 token)后以 failed 退出,仅凭这张统计表完全回答不了为什么失败。其二是人工分析:可解释但昂贵,面对动辄数百步的轨迹难以扩展,例如 MAST 靠人工分析 150 多条多智能体轨迹才归纳出 14 种失败模式,AgentErrorTaxonomy 也依赖专家手工标注。折中方案——基于专家预定义行为模式构建分类器——又过于僵硬,无法泛化到新任务和涌现行为。ML 社区因此缺乏一套既可扩展、可泛化,又能解释智能体到底在做什么的行为研究方法论。
本文的目标是本文的目标是把社会科学中已有六十年历史的扎根理论系统地引入机器学习,作为分析 LLM 智能体行为的新方法论,并构建 AutoTraceGT——首个端到端自动化扎根理论流水线。具体而言:对包含数千条轨迹的语料执行归纳式编码,让行为编码册从数据本身涌现而非来自先验假设;以理论饱和作为有原则的数据驱动停止准则,即当连续多轮采样不再产生新类别时终止;同时保留从原始轨迹、步骤级引文证据、概念编码、行为类别到最终理论叙事的完整可审计链条。作者在六个轨迹语料库、四个骨干 LLM 上系统验证四件事:编码册能否稳定复现、能否覆盖人工失败分类册中的失败模式、能否恢复先前专家的理论叙述、以及能否作为演绎特征空间支撑下游失败预测。
与已有工作不同的是,LLM 辅助定性分析已有先行工作,但存在两个关键缺口。第一,扎根理论的多阶段结构很少被端到端保留:AcademiaOS 的跨阶段编排能力有限;LOGOS 干脆用语义聚类取代了主轴编码和选择性编码,丢掉了方法论赖以成立的角色分化分析立场——开放式编码关注单条数据内部,主轴编码跨数据联结,理论编码全局综合,三者立场不同,不能合并成一个聚类步骤。第二,理论饱和这一扎根理论自身的终止准则从未被实证检验:现有流水线要么跑固定轮数,要么人为设定迭代次数,产出的编码册究竟反映了概念覆盖的完备还是任意的停止点并不清楚。本文的独特切入点是把完整的扎根理论循环算法化:三个角色专门化的编码智能体加一个编码册管理器,用新增类别数衰减这一可计算信号实证验证饱和,并将规模扩展到 7500 多条轨迹。
核心方法
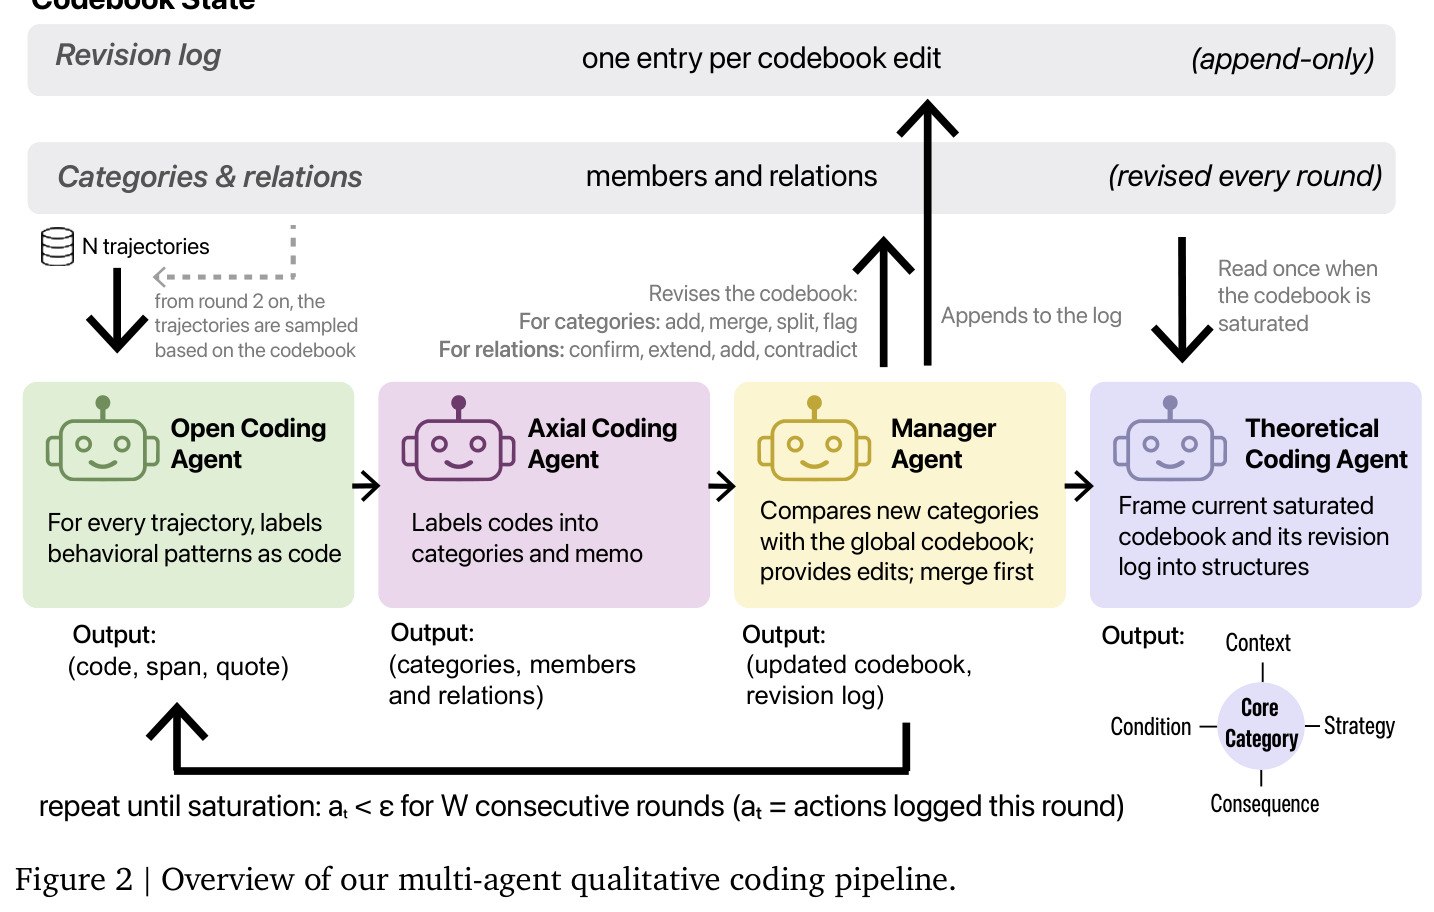
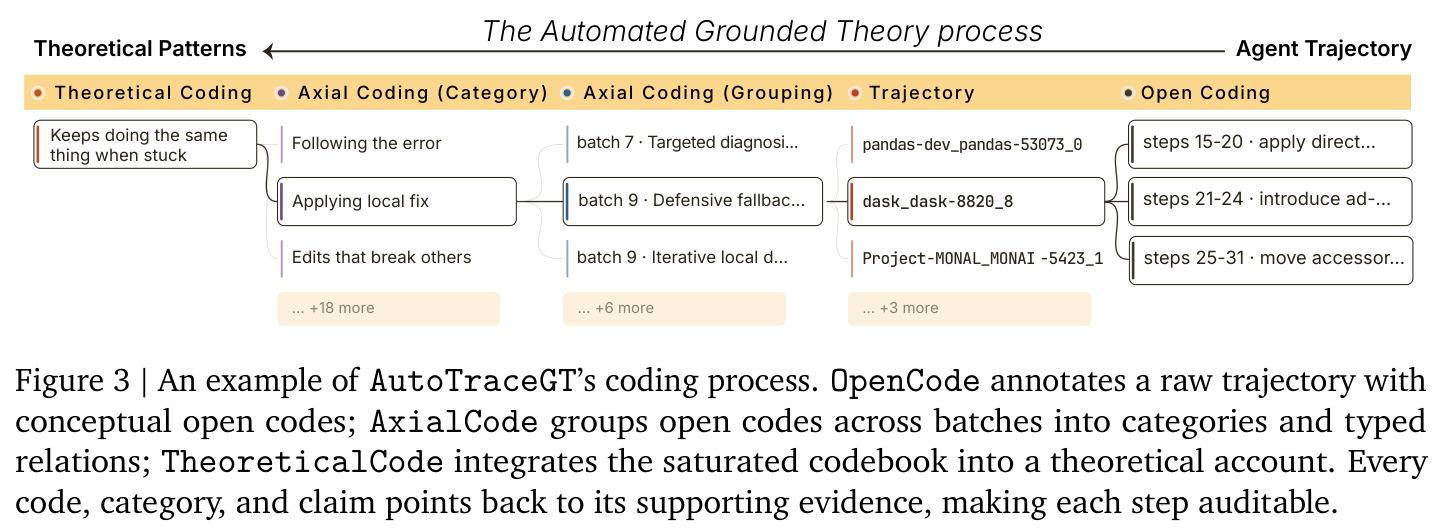
直觉上,AutoTraceGT 让一组 LLM 智能体分别扮演定性研究团队中的不同角色,按扎根理论的流程协作做研究。技术路线是在三个尺度上分层压缩语义:单条轨迹尺度由 OpenCode 做开放式编码,把每条轨迹标注为一串 (code, span, quote) 三元组——2 到 5 个词的概念编码、发生的子步骤区间、以及原文引文证据;批次尺度由 AxialCode 做主轴编码,把一批已编码轨迹中的概念编码聚合为带定义和支持证据的行为类别,以及类别间的类型化关系;全语料尺度由 TheoreticalCode 在饱和后把编码册综合为以核心类别为中心的理论叙事。与之正交的 Manage 智能体充当编码册管理器,每轮将新的主轴产出与运行中的编码册做恒常比较与修订。整个流程按算法 1 迭代:每轮按采样策略从轨迹池抽取一批,重复直到新增类别数 $a_t$ 连续 $W$ 轮低于阈值 $\epsilon$。实验覆盖 6 个数据集、7500 多条轨迹、4 个骨干模型。
核心创新在于把扎根理论的四个方法论支柱算法化为多智能体协作协议。第一,归纳性:类别必须从数据中涌现,OpenCode 被明确要求抽象行为模式(如诊断环境约束、在验证障碍前坚持)而非复述表层工具调用,这与单次 prompt 枚举失败模式有本质区别。第二,恒常比较:新数据不断对照既有编码册修订,Manage 采用合并优先策略,把每轮新类别归入 add/merge/split/flag 四种动作、关系归入 confirm/extend/add/contradict,全部追加进只增不改的版本化修订日志 $L_t$。第三,有原则的停止准则:定义第 $t$ 轮新增类别数 $a_t$,当连续 $W$ 轮 $a_t < \epsilon$ 时判定饱和,取代现有工作的固定轮数。第四,可审计性:每个类别、每条理论断言都通过成员指针链接回支持它的具体轨迹与步骤引文。对比 MAST 用人工在 150 多条轨迹上归纳 14 种模式,本文把同一方法论自动化并扩展到数千条轨迹。
方法步骤详情
算法 1 的流程如下。输入为 $N$ 条轨迹池、批大小 $B$、采样策略 $\pi$、饱和阈值 $\epsilon$ 与稳定窗口 $W$。先初始化空编码册,之后每轮:用条件于当前编码册的采样策略抽取 $B$ 条轨迹,使采样主动探测未覆盖行为;OpenCode 将每条轨迹的消息序列分块逐块编码,跨块携带段记忆保持连续性,输出自适应数量的 (code, span, quote) 记录;AxialCode 将本批编码聚为类别——各带文本定义、支持记录集合、由轨迹终态聚合的状态标签 $\sigma \in \{succ, fail, both\}$——和类型化关系,并输出主轴备忘录;Manage 将产出与版本化状态 $K_t = (C_t, R_t, L_t)$ 调和,逐类别与逐关系选择动作写入修订日志,统计本轮新增类别数 $a_t$;连续 $W$ 轮 $a_t < \epsilon$ 即终止。最后 TheoreticalCode 仅依据饱和编码册 $K_T$ 与修订日志产出核心类别 $c^*$ 与叙事 $\mathcal{N}$。
技术新颖性
技术新颖性可从三个对照看清。与单次 prompt 枚举路线(让 LLM 一次性列出失败模式)相比,本文实现了数据驱动的迭代归纳,类别在恒常比较中演化且有实证饱和信号,而非一次成型的先验清单。与 AcademiaOS(跨阶段编排有限)和 LOGOS(用语义聚类替代主轴与选择性编码)相比,本文首次端到端保留三阶段结构,每个阶段都是角色专门化的独立智能体,保持了方法论要求的差异化分析立场。与 AgentErrorTaxonomy、MAST 等人工或半自动失败分析相比,本文把归纳过程完全机器可读化:编码册状态、每一步 add/merge/split/flag 动作、每次关系确认或矛盾都记录在只增日志中,理论演化史可回放。此外,把理论饱和操作化为可计算的 $a_t < \epsilon$ 判据,并用饱和诊断曲线(add 衰减、merge/confirm 上升、类别数平台化、与终端编码册余弦相似度趋近 1)实证验证,这在已有扎根理论自动化工作中是没有的。编码册还能复用为演绎特征空间做下游失败预测,实现归纳与演绎的闭环。
实验结果
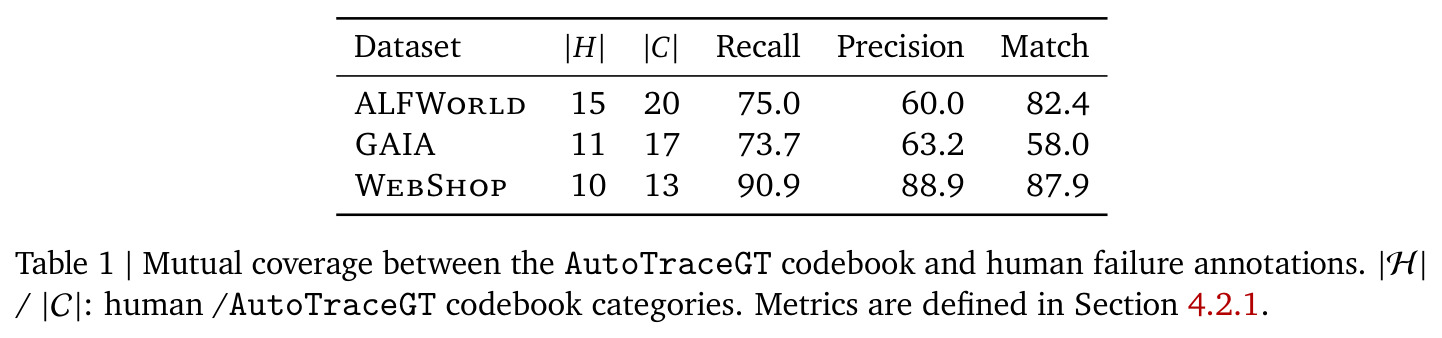
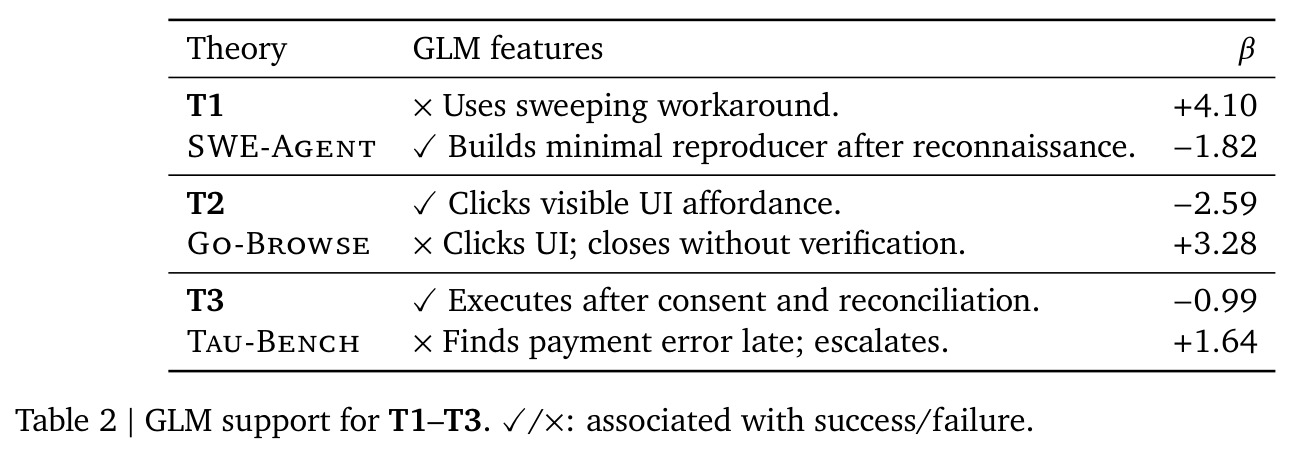
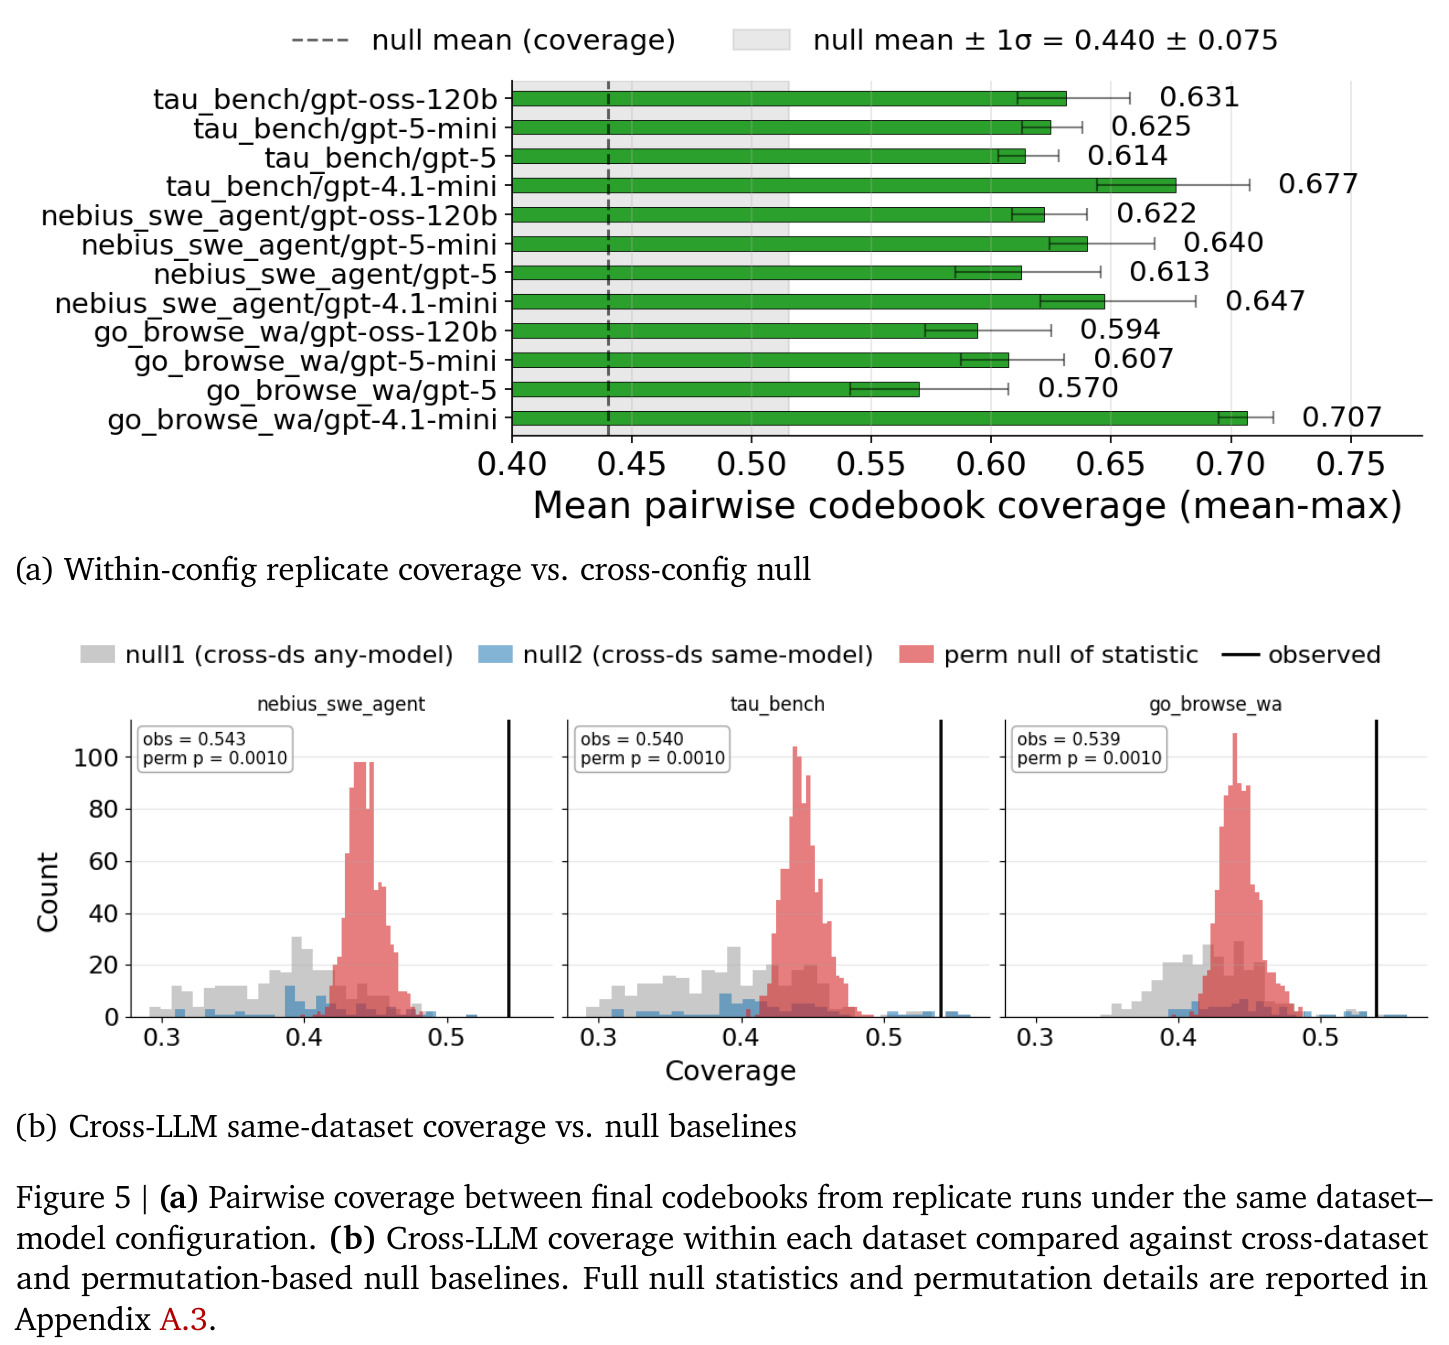
RQ1 过程可靠性:饱和诊断一致显示 add 动作随进度衰减、merge/confirm 占比上升、类别数趋于平台、与终端编码册余弦相似度趋近 1(Figure 4)。同配置三次独立运行的编码册相似度显著高于跨配置(Mann–Whitney $U$ 检验 $p < 10^{-20}$),且全部超过数据导出的可复现阈值;固定数据集换骨干模型时,跨 LLM 覆盖率在所有数据集上高于打乱数据的零假设(置换检验均 $p < 0.001$),说明归纳的是数据自身行为结构而非模型先验(Figure 5)。RQ2 产物质量:与人工失败分类册互覆盖(Table 1)达 ALFWorld recall 75.0%/轨迹匹配 82.4%、GAIA 73.7%/58.0%、WebShop 90.9%/87.9%,且 recall 可高于 precision,说明还发现了人工遗漏的模式。理论叙事独立收敛于前人专家的级联错误论。下游失败预测(Table 3)中 GPT-5 在 Go-Browse 上互补特征 MCC 0.499/ROC AUC 0.828,远超 few-shot 的 0.358/0.679;GLM 分析(Table 2)显示不验证即宣布完成是强失败信号($\beta=+3.28$),而单纯点击 UI 反而与成功相关($\beta=-2.59$)。
局限与改进
作者承认的局限:饱和准则目前只统计新增类别数,未纳入类别内例证密度与类别间关系稳定性,算法停止规则与方法论意义上的饱和仍有距离;正文未给出 $\epsilon$、$W$ 的具体取值。我自己观察到的局限:其一,覆盖率与轨迹匹配评估依赖 GPT-5 作为 LLM 判官,判官可能偏好 AutoTraceGT 产出的流畅宽泛类别,存在循环性风险,且未报告人机一致性校验;其二,下游预测结果并不稳定,例如 GPT-OSS-120B 在 SWE-Agent 上互补特征 MCC 仅 0.240,低于 few-shot 直接预测的 0.262,说明代码册特征并非处处有效;其三,三个带结果标签的语料只有成败标签而没有行为层面的 ground truth,可复现性检验用的是自参考的余弦相似度,依赖嵌入模型选择;其四,数千条轨迹的逐块多智能体编码 token 成本可观,论文未报告任何计算开销;其五,类别状态标签只聚合轨迹终态,无法刻画中途从成功滑向失败的行为转折。
独立分析的弱点
独立分析几个弱点。第一,LLM 判官的循环性:用 GPT-5 判断 AutoTraceGT 代码册是否覆盖人工失败推理,而代码册由同族的 GPT-5-mini 生成,同系模型可能在措辞与概念上相互对齐,导致覆盖率被高估;改进方向是引入多名人类专家盲评或换用异构判官并报告一致性。第二,采样策略 $\pi$ 条件于当前编码册,可能形成确认偏误闭环——早期类别引导后续采样,边缘行为永远进不了批次,导致过早饱和;改进是强制保留一定比例的随机或多样性采样。第三,$a_t$ 判据对 $\epsilon$ 敏感且只看新增,类别拆分与关系矛盾恰恰发生在理论剧变期却被忽略;改进是把关系修正率纳入饱和信号。第四,代码册特征是固定长度二值向量,丢弃了步骤时序与频次信息,这可能是部分配置(如 GPT-OSS-120B 在 SWE-Agent MCC 0.240)不敌基线的原因;改进是加入时序特征或频率计数。第五,理论叙事只在三个基准上与一篇前人专家分析做了收敛性对照,验证样本过少,需要在全新领域做预注册式独立验证。
未来方向
作者明确提出两个方向:一是设计更丰富的饱和准则,同时考虑每个类别内部的例证密度和类别之间关系的稳定性,让算法停止规则更贴近方法论本意;二是把代码册用于下游训练与评估,包括构建针对性训练数据、识别应强化或抑制的行为、设计行为感知的评估指标、以及构建过程级奖励信号。基于成果还可延伸:把代码册当作过程奖励模型的标注骨架,用归纳出的行为类别自动生成步骤级奖励;做跨模型的行为指纹比较——同一任务上不同骨干 LLM 的编码册差异可量化模型行为风格;将流水线改造为在线流式版本,在智能体部署期间持续归纳新出现的失败模式并触发告警;对关键类别做反事实干预实验(如强制智能体插入验证步骤)以验证理论类别与成败的因果联系;以及把方法扩展到多模态轨迹(computer use 的屏幕截图序列)与多智能体协作轨迹,检验 MAST 式交互失败能否被自动归纳。
复现评估
复现条件较好。代码已开源(GitHub: ZhuoranLu/Qual-Agent-Behavior-Analysis),论文声称所有中间产物机器可读、可审计,修订日志结构明确。六个数据集全部公开:Tau-Bench、Go-Browse、SWE-Agent 各采样 2000 条带结果标签的轨迹;ALFWorld、GAIA、WebShop 使用 Zhu et al. (2025) 公开的人工失败标注(每基准约 500 条专家编码轨迹)。算力方面以 API 调用为主,骨干模型为 GPT-4.1-mini、GPT-5、GPT-5-mini、GPT-OSS-120B,主要成本在主流程编码加上逐轨迹一次的 GPT-5 判官调用,单数据集配置估计需数百万 token;但正文未报告 $\epsilon$、$W$、$B$ 等超参取值与每轮运行的轮数、时长和费用,需查附录或代码仓库。下游部分依赖 FLAML AutoML,环境标准。总体复现难度中等:方法论流程清晰,但结果对超参和判官模型的敏感性未知,建议先用单数据集小规模试跑再扩展。
论文图表
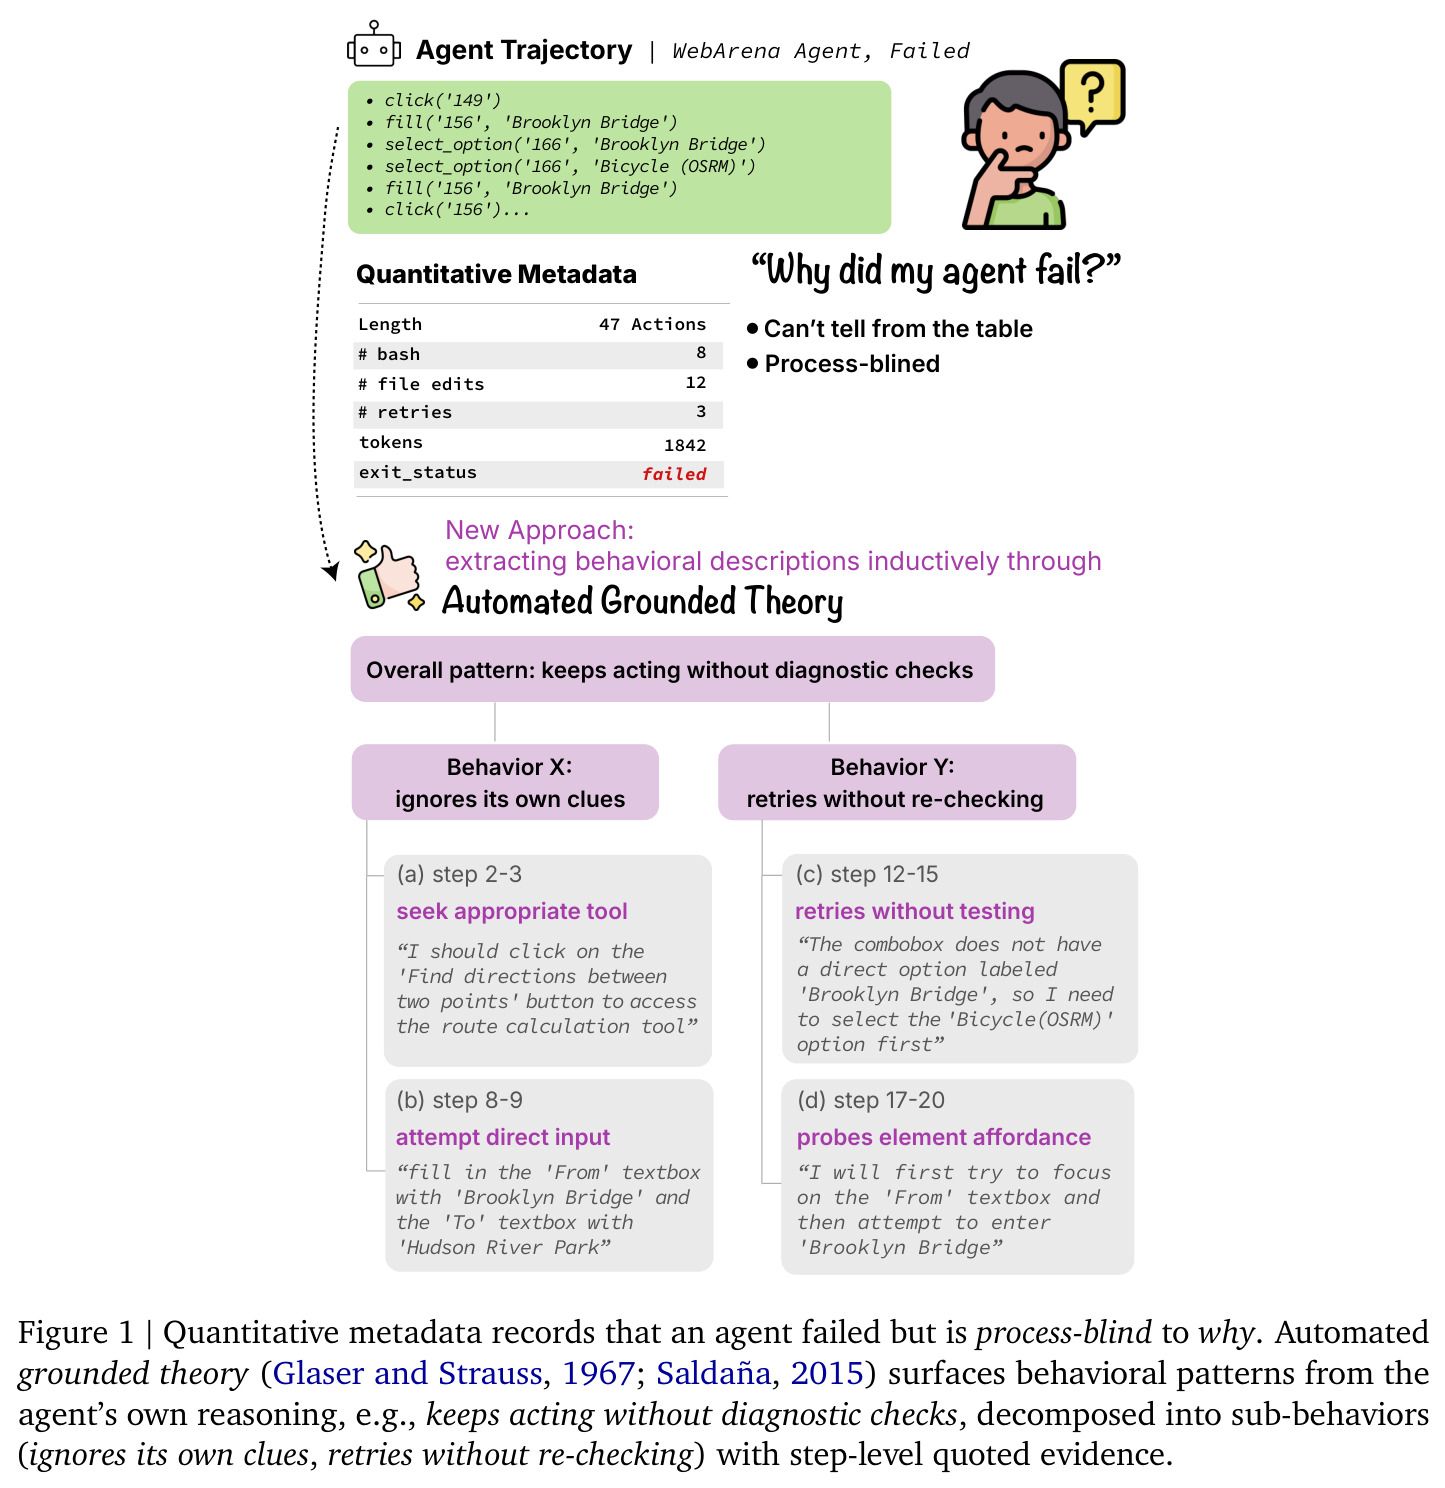
以 WebArena 一条失败轨迹为动机示例。左侧量化元数据表只记录 47 个动作、8 次 bash、12 次文件编辑、3 次重试、1842 个 token 和 exit_status=failed,无法回答用户为什么我的智能体失败了;右侧展示自动扎根理论如何从智能体自身推理中归纳出总体模式持续行动而缺少诊断性检查,并分解为忽视自身线索、重试前不复查等子行为,每个子行为附带步骤区间(如步骤 8-9、17-20)与原文引文。
一图道出论文动机:过程盲的元数据为何不够、扎根理论产出长什么样,是理解全文问题定义的入口。