SnapBench:面向移动端拍图问答(Snap-and-Ask)多模态检索的鲁棒性基准 SnapBench: Benchmarking Snap-and-Ask Multimodal Retrieval for Mobile Interactions
首个成对式拍图问答检索基准:图像退化最伤检索、粗文本反而拖累、双模态退化超可加
前置知识
双塔编码器与晚期融合
CLIP/SigLIP 类模型用两个独立编码器分别把图像和文本映射到同一向量空间,相似度就是向量内积;当查询同时含图和文时,联合得分用固定权重线性组合,例如 $s_{joint} = (s_{img} + s_{text})/2$,这个权重对所有查询统一、推理时不可调。
SnapBench 评测的 16 个模型中有 4 个属于这一类,「固定融合无法按查询调整模态权重」正是全文的核心论点,理解晚期融合才能理解 MOOR 到底在修什么。
VLM 嵌入模型
以 Qwen3-VL-Embedding、GME、Jina-V4 为代表,用视觉语言模型把图像与文本在一次冻结前向中编码成统一嵌入,图文之间的加权是隐式烘焙在网络权重里的,用户无法在推理时显式控制。
这是本文评测的第二类范式。论文证明无论显式(双塔)还是隐式(VLM 前向)融合,都同样缺乏模态校准,说明这是一个跨架构的通病而非某类模型的缺陷。
Recall@1 与难负样本
R@1 是检索返回的第一条结果恰好正确的比例,是移动端最敏感的指标(用户只看第一条)。难负样本是同类别、视觉相近但并非目标实体的干扰项,用来区分「识别到具体实体」和「只认出大类」。
SnapBench 平均每查询 4.77 个正例、3.50 个难负例;coarse-text drag 现象的机制正是粗粒度问题(这是什么花?)同时抬高了樱花、玉兰等同类难负的得分,稀释了强视觉排序。
成对(paired)评测协议
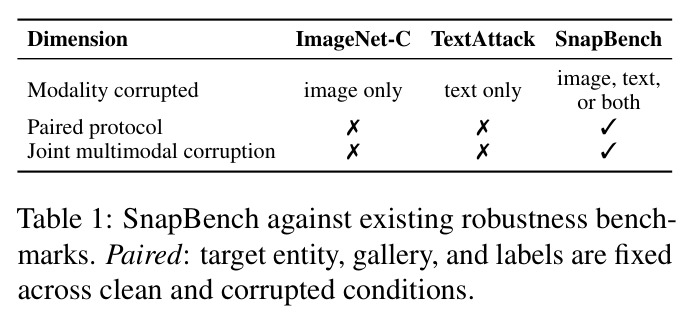
clean 与 corrupted 输入共享同一目标实体、同一候选库和同一标注,性能差 ΔR@k 只归因于退化本身,而不混杂测试实例难度的变化。ImageNet-C、TextAttack 这类基准每换一种扰动就换一批实例,做不到这一点。
这是 SnapBench 与既有鲁棒性基准的本质区别(Table 1),也是「联合退化超可加性」能够被测量的前提——没有配对设计,观测到的降幅无法和加性预测严格对比。
嵌入白化(whitening)
用候选库的统计量(均值、方差)对嵌入空间做标准化再重新归一化,缓解各向异性带来的 hubness 问题——即少数向量成为过多查询最近邻的病态现象。
MOOR 的第一步就是 gallery 侧白化,让四条相似度路径的得分可比;消融显示去掉白化 CLIP 系模型掉 0.8 到 1.5 分,而 VLM2Vec 系因数值问题跳过白化仍能涨分。
超可加交互效应
定义交互项 $γ_{int} = d_{IT} - (d_I + d_T)$,其中 $d_I$、$d_T$、$d_{IT}$ 分别是仅图像退化、仅文本退化、两者同时退化造成的 R@1 降幅。正值(超可加)意味着联合退化比两种单模态退化之和更糟。
这是论文发现三的核心量化工具:16 个模型平均 $γ_{int} = +7.6$ 分,说明单模态压力测试无法预测联合退化 regime,鲁棒性必须配对联合评估。
研究动机
拍图问答(snap-and-ask)已是移动 AI 最高频的入口之一:用户对着物体拍照并问「这是什么」。但真实输入远非干净。作者从生产图文检索服务抽样 5,000 条真实上传记录做试点分析:完全干净的仅 29.4%,70.6% 存在问题——仅图像侧退化占 23.5%、仅文本侧占 12.4%、双侧都有占 34.7%;图像问题中 Degrade 类(模糊、暗光、压缩)占 38.4%,Remove(裁剪、降采样)占 24.6%,Add(水印、界面元素)占 17.3%。而现有基准评估不了这种场景:MS-COCO、Flickr30K 等图文检索基准用干净的描述性 caption 测对齐,问题形式与移动端短问题完全不同;ImageNet-C、TextAttack 等鲁棒性基准在施加扰动时会更换测试实例,把「实例难度」和「退化敏感度」混在一起,无法回答「同一张拍图、同一候选库下,一条水印会改变多少检索行为」。此外,FashionIQ、CIRR 等组合检索基准的文本是修改指令,而拍图问答的文本是关于图中实体本身的粗问题,两者检索意图不同。
本文的目标是本文目标是构建并开放首个成对式(paired)拍图问答检索鲁棒性基准 SnapBench,并据此定位失效模式、验证校准假设。具体有三点:(1) 数据上,提供 1,145 条「拍图+短问题」查询和 9,085 个条目的实体感知 gallery,其中含 5,462 个正例(平均每查询 4.77 个)与 4,005 个同类难负例(平均 3.50 个),全部经 10 名标注员按 4 维 0-3 分量表人工标注;(2) 评测上,在目标实体、gallery、标注完全不变的前提下实例化 53 种受控退化条件(45 种图像侧、8 种文本侧),系统评测覆盖双塔与 VLM 嵌入两类范式的 16 个模型;(3) 方法上,提出一个无需训练的自适应融合基线 MOOR,用以检验「固定融合缺乏模态校准」是否是这些失效的共同根因,为后续系统提供诊断探针。
与已有工作不同的是,独特切入在于「同一意图的多种观测」这一成对设计:clean 与每种 corrupted 变体共享同一查询内容、同一 gallery 与同一标注,因此每个指标差都纯粹归因于伪影本身,而不像 ImageNet-C 那样把标签难度和退化敏感度混在一起(作者还用 2,000 对事后标注证明未判定正例对 Δ 的影响恰好为零)。这带来两个只有此设计才能支撑的增量:其一,SnapBench 是唯一同时支持图像、文本与双模态联合退化的检索基准(Table 1),使「超可加性」现象首次可测;其二,作者提出并命名了一个新失效模式 coarse-text drag(粗文本拖累)——在同类难负池里融合「这是什么花」式的粗问题反而稀释强视觉排序——这是「信息越多越好」直觉在检索里的反例,此前没有基准能把它隔离出来。
核心方法
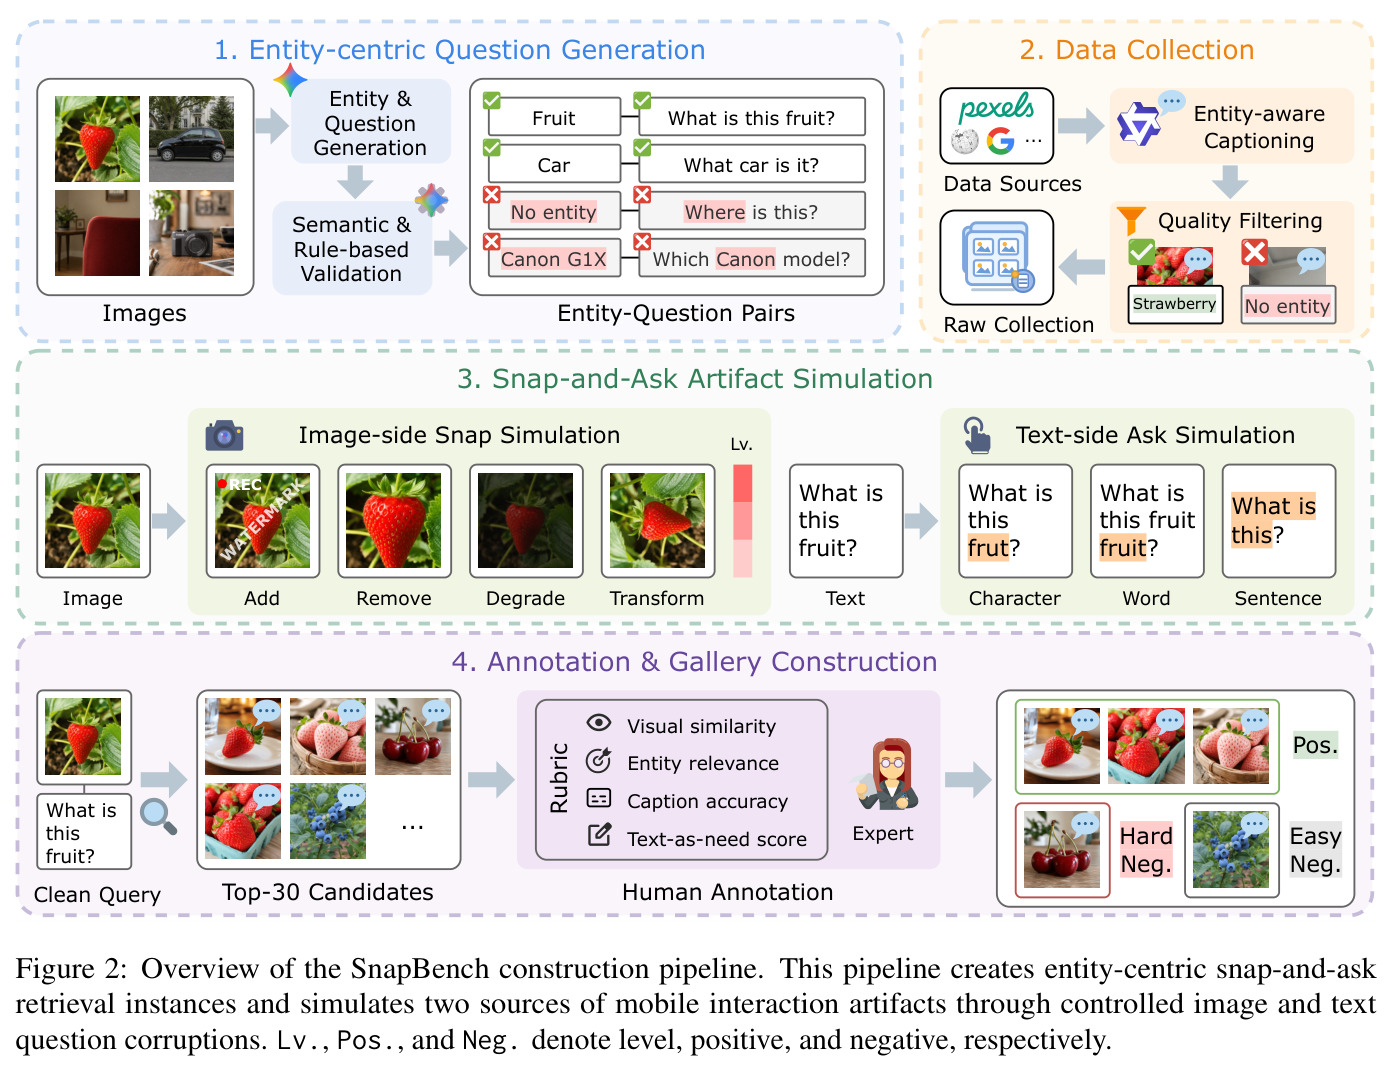
直觉上,拍图问答里两条通道的可靠性天然不对称:图像承载判别性证据(花瓣形状、车灯轮廓),文本只表达粗粒度意图(「这是什么花?」),且可靠性随查询剧烈变化——照片糊了需要文本兜底,文本太粗需要图像定夺。但现有系统无论双塔的显式晚期融合 $s_{joint} = (s_{img} + s_{text})/2$,还是 VLM 嵌入模型冻结前向中的隐式加权,都是全局固定权重,无法按查询调整。技术路线分两步:第一步构建 SnapBench,通过四阶段流水线(实体中心问题生成、数据收集、确定性伪影模拟、人工标注与 gallery 构建)把「实体中心 + 易带伪影」两个特性操作化,最终得到 1,145 查询、9,085 gallery、53 种受控退化条件;第二步提出 MOOR(Modality-anchored, Outlier-aware, Optimal Reweighting),一个 training-free 的融合适配器,仅从冻结编码器自身产出的四条相似度得分分布中估计每条查询的模态可靠性并重加权,不改架构、不增参数,作为固定融合失配的诊断探针。
核心创新有二。其一是成对协议的评测学设计:伪影只施加在查询侧、gallery 与标注冻结,使退化影响被干净隔离,每个 ΔR@k 都可归因。其二是 MOOR 的「以编码器自身输出为可靠性信号」:以白化后的图像-图像路径 $s^{II}$ 为锚定排名,对每条涉及文本的辅助路径($s^{TT}, s^{IT}, s^{TI}$)计算与其的 Pearson 秩一致性 $r_{ab}$,再用钟形门 $g_{ab} = max(0, r_{ab})^2 · max(0, 1 - r_{ab})^2$ 加权——门在 $r=0.5$ 处取峰值,同时压制「无信号」($r$ 趋近 0)与「完全冗余」($r$ 趋近 1)的路径,最后乘以各自得分方差并做归一化加权和。与 EviRank 等引入额外证据的重排序不同,MOOR 不抽证据、不学参数、不访问模型内部;与固定 $1/2$ 平均的本质区别是权重成为每条查询的函数。oracle 分析显示每查询最优融合权重均值聚在 [0.52, 0.58] 但标准差达 0.086 到 0.138,证明「固定权重失配」是跨 16 个模型的普遍缺陷而非个别架构问题。
方法步骤详情
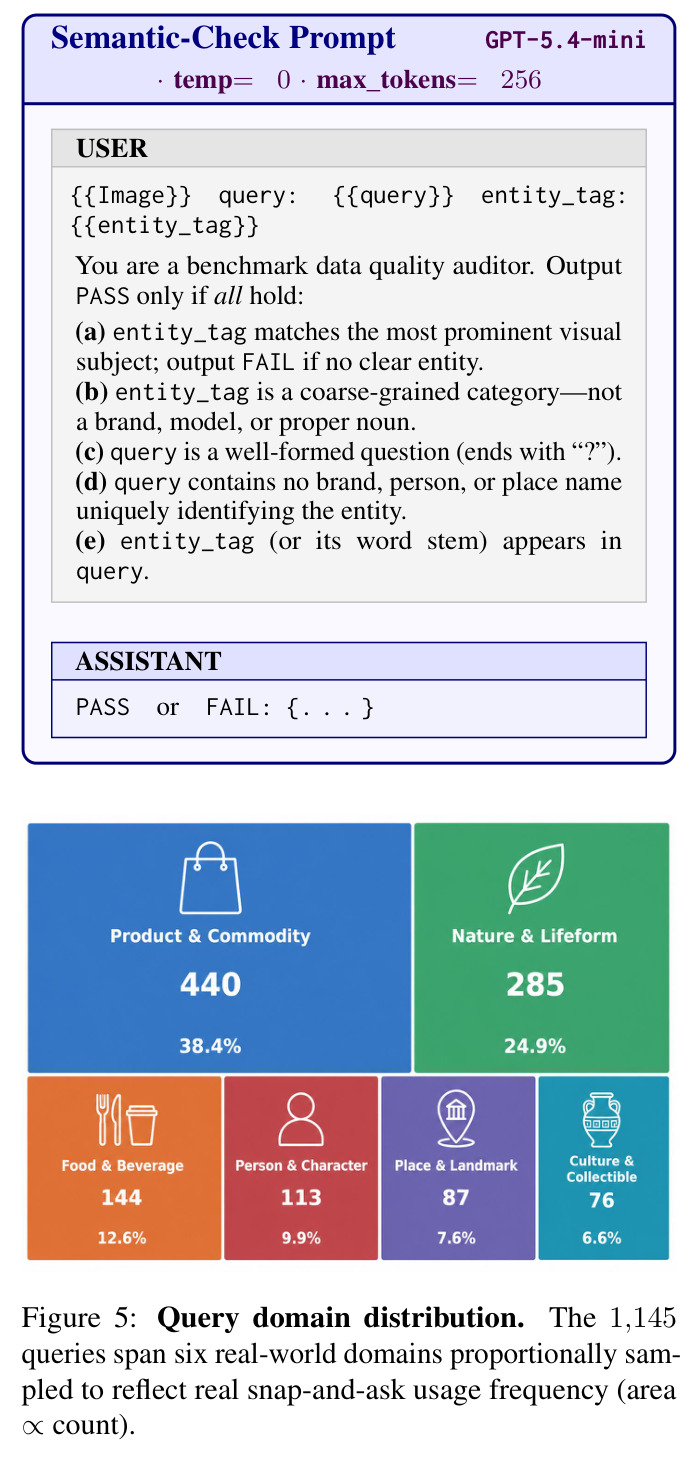
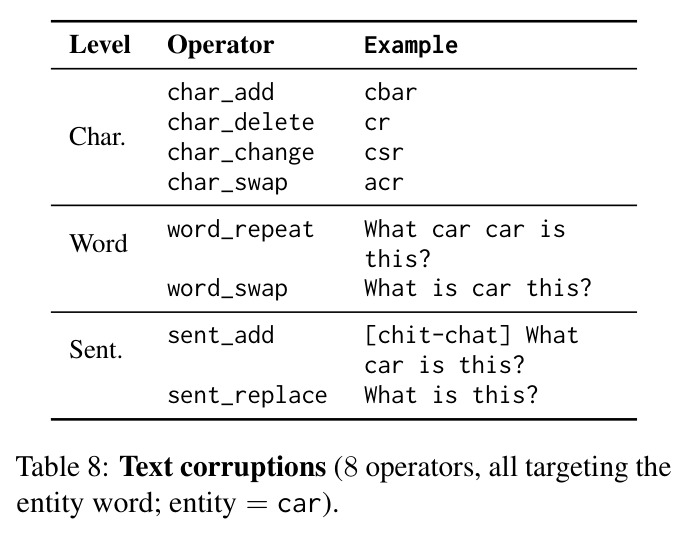
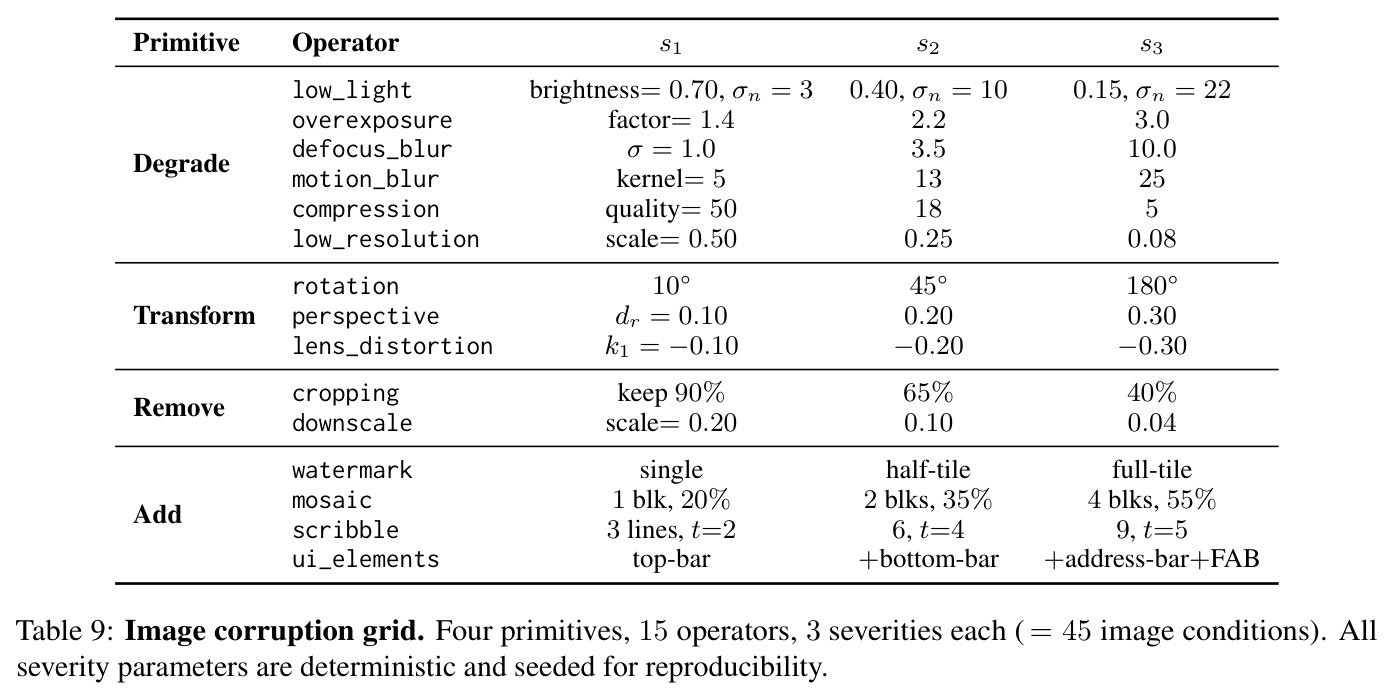
构建分四阶段。(1) 实体中心问题生成:人工筛图(200 张样本三人独立审核一致性 96%)后,Gemini-3-Flash 为每图生成粗粒度实体标签(plant 而非 rose)与一句短问题;过 4 条规则校验(问号结尾、单句、无中文字符等)与 GPT-5.4-mini 只读语义审核(通过率约 98.2%,拒绝过细实体标签和泄露品牌/人名/地名的查询),失败自动修复至多 3 轮,1,150 候选最终产出 1,145 条查询(产率 99.6%)。(2) 数据收集:从近 $10^8$ 规模的私有图池(公开网页来源、版权过滤与感知哈希去重、与查询集严格不重叠)采样 gallery,用私有微调的 Qwen-VL caption 模型生成实体感知描述。(3) 伪影模拟:图像侧 4 原语(ADD/REMOVE/DEGRADE/TRANSFORM)15 算子乘 3 强度共 45 条件,如 low_light 亮度从 0.70 降到 0.15、cropping 保留面积从 90% 减到 40%、JPEG 质量从 50 降到 5;文本侧 8 个规则算子覆盖字符/词/句三级(QWERTY 邻键替换、词序交换、把问题缩为「What is this?」)。(4) 标注与 gallery:每查询取 top-30 候选,10 名标注员按视觉相似、实体相关、caption 准确、意图相关 4 维打分(0-3)聚合为意图条件 fitness:等于 0 剔除、等于 1 记难负、大于等于 2 记正例;标注员需通过 3,000 题校准(准确率至少 90%),20-30% 提交被复查,终审通过率 95%。评测时 16 个模型跑 5 种检索模式(IT→IT、I→I、I→IT、T→T、T→IT),主指标 $R@1$,gallery 嵌入每模型预计算一次。MOOR 推理五步:gallery 统计白化(去 hubness)→ 计算四条相似度路径 → 钟形秩一致性门控 → 门乘方差的权重 → 归一化加权和输出融合得分。
技术新颖性
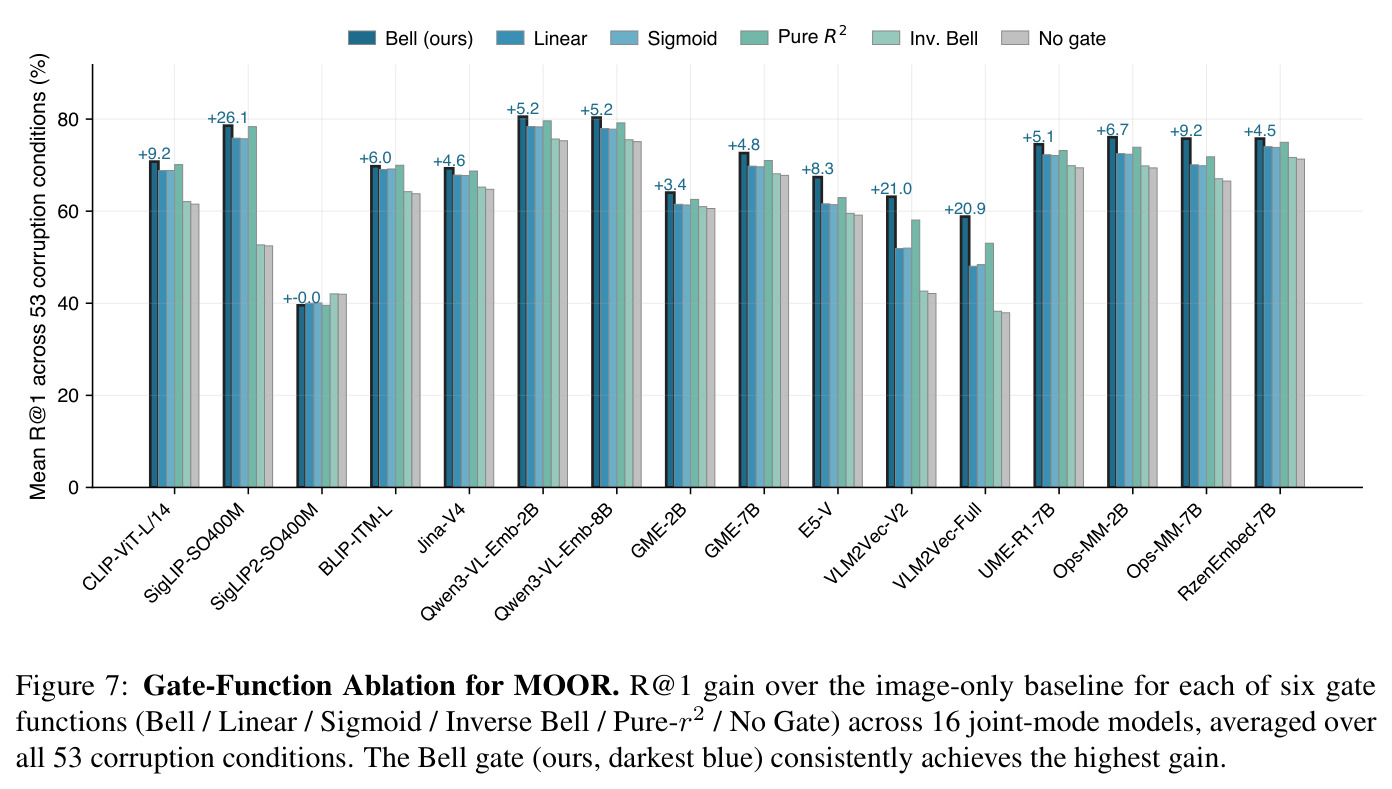
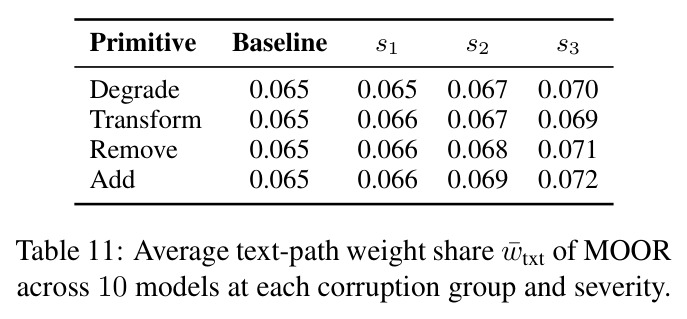
新颖性体现在四个层面。(1) 协议层面:成对 Δ 评测把鲁棒性评估从分布级比较细化为逐查询配对比较,ΔR@k 对基线难度不敏感,这是与 ImageNet-C/TextAttack 的根本差异,也使「联合退化是否可加」第一次成为可测量的问题。(2) 现象层面:首次在检索中量化联合退化的非可加性,定义交互项 $γ_{int} = d_{IT} - (d_I + d_T)$,并发现单模态压力测试结果无法预测联合 regime,直接挑战了「分别测图像和文本鲁棒性就够」的惯常做法。(3) 机制层面:MOOR 证明无需任何训练,仅凭冻结编码器得分分布的统计量(秩一致性乘方差)就能逼近 oracle 融合;钟形门「既滤无信号也滤冗余」的非单调形状是关键——换成线性、sigmoid 或无门只收回约一半增益。(4) 自校正机制:干净输入时辅助路径与锚的秩相关高达 $r ≈ 0.8$,门压到 $g ≈ 0.016$;图像退化使相关性降到互补峰值 $r ≈ 0.5$,门升到 $g ≈ 0.063$,文本路径权重份额随退化严重度单调上升(0.065 到 0.072),相当于无参数地学会了「图像失效时才听文本」。
实验结果
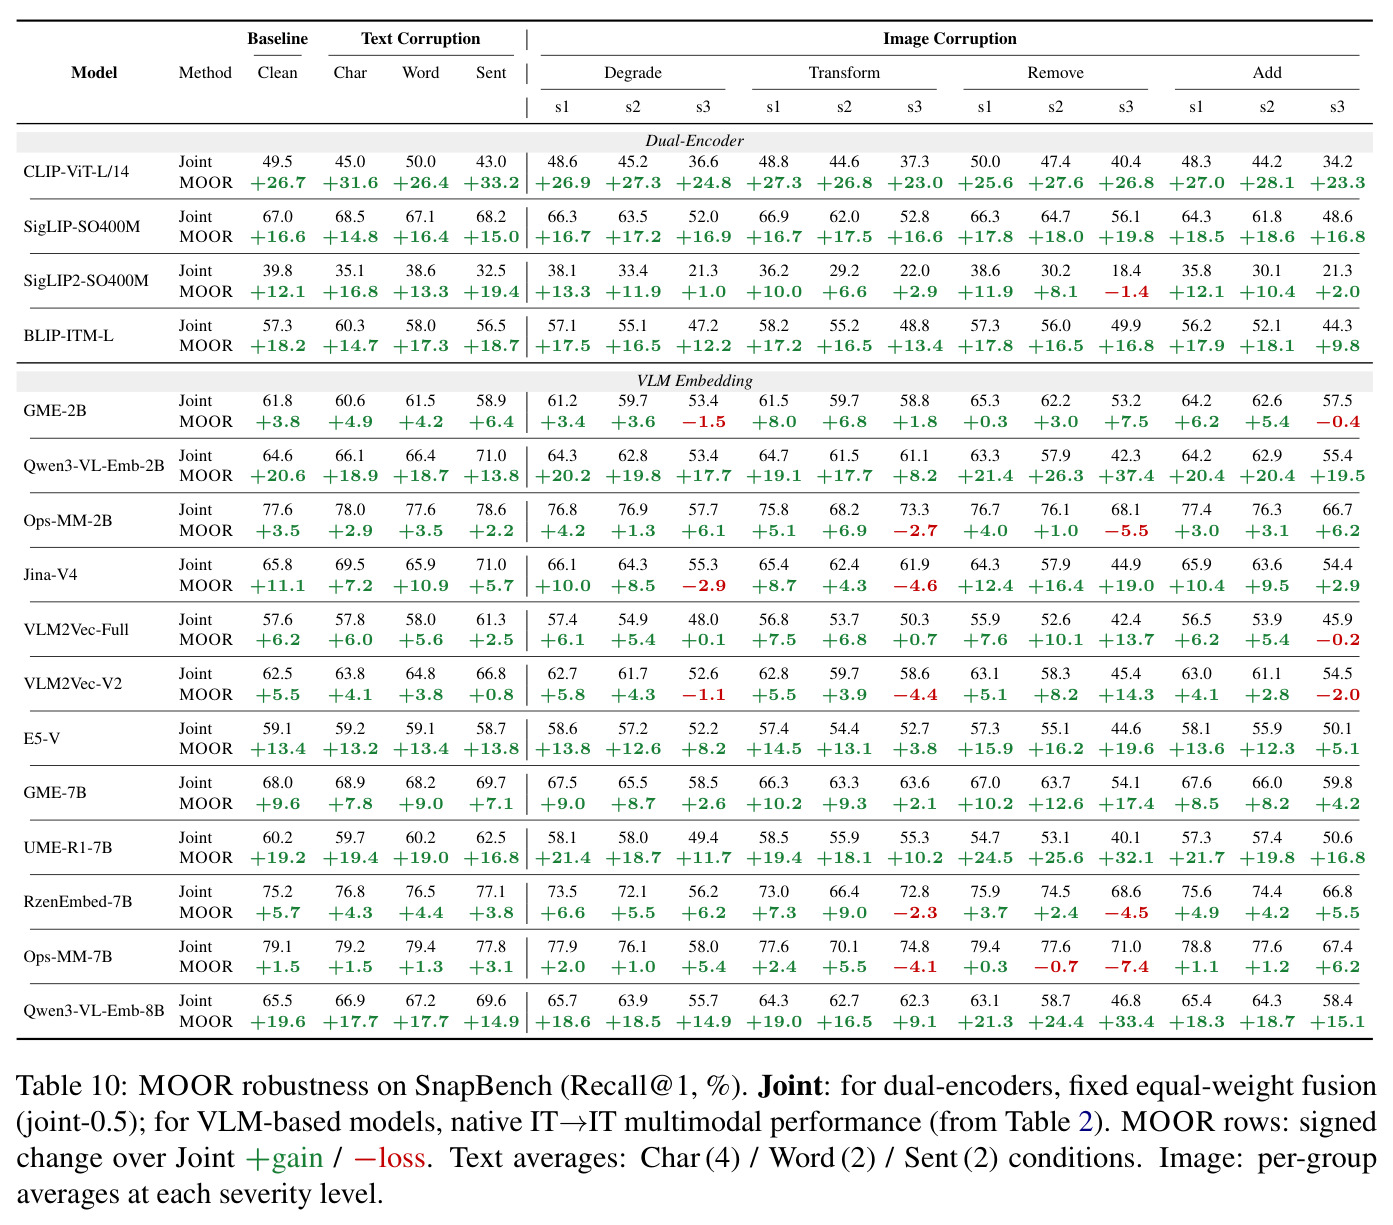
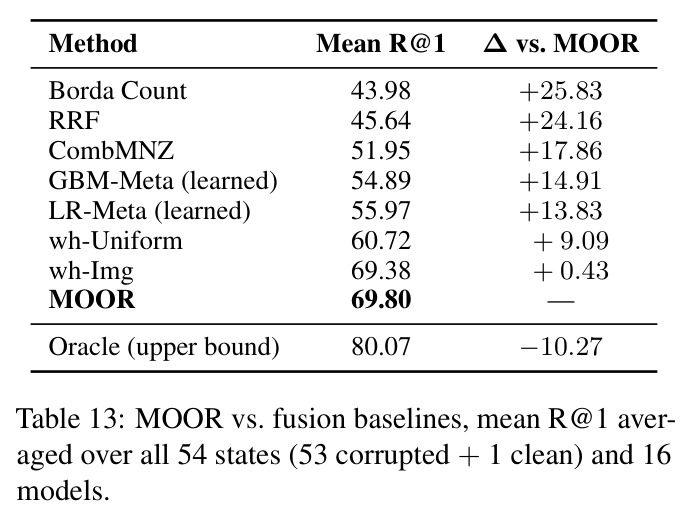
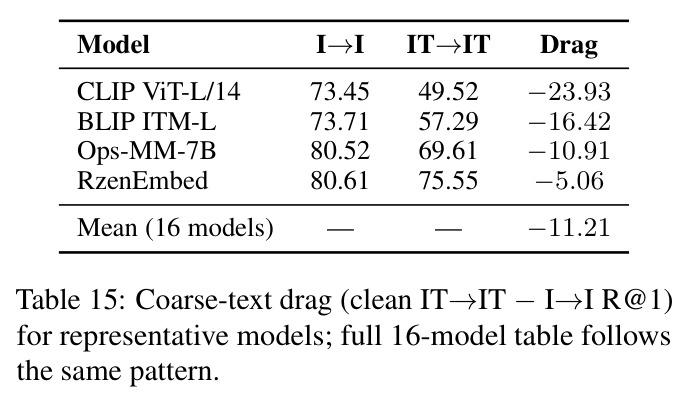
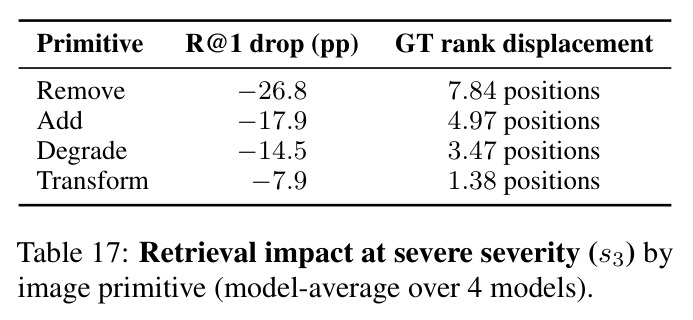
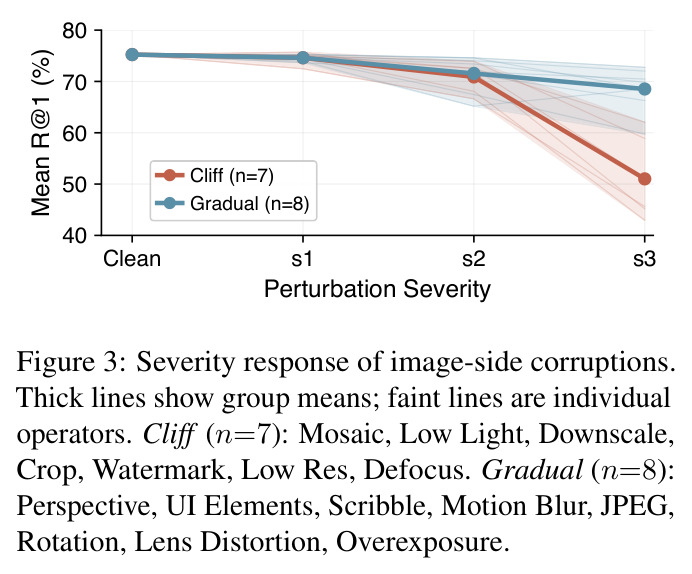
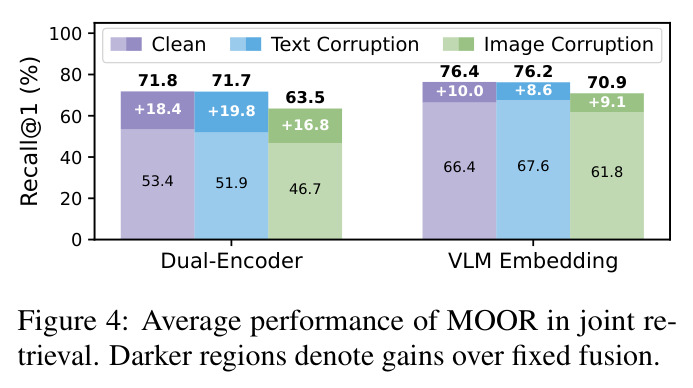
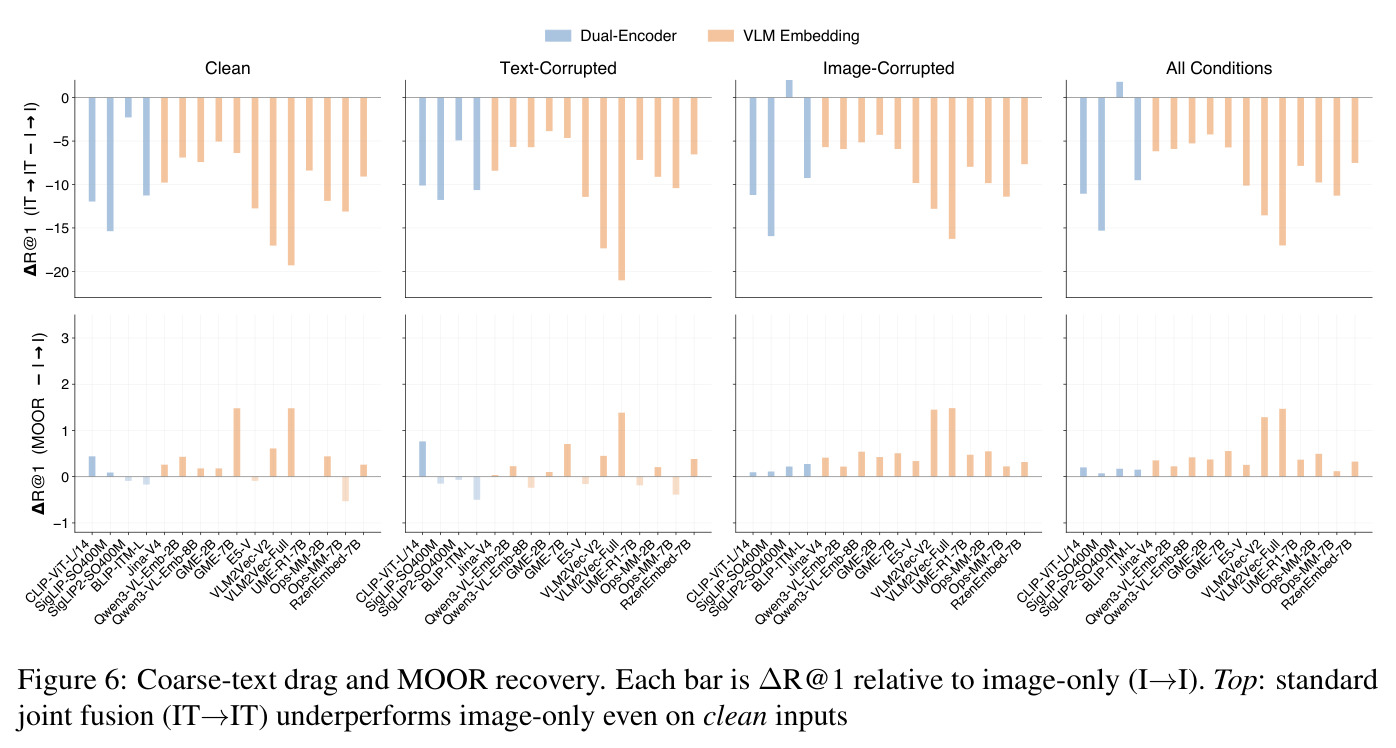
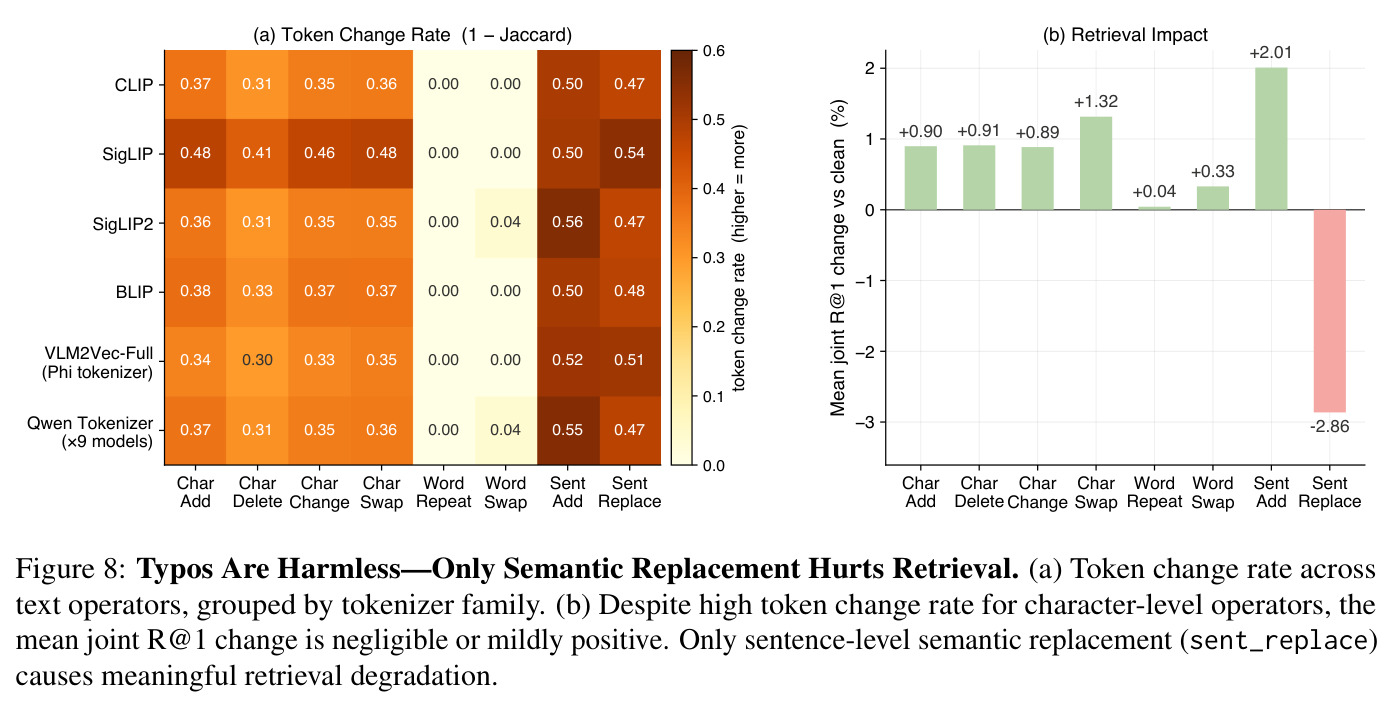
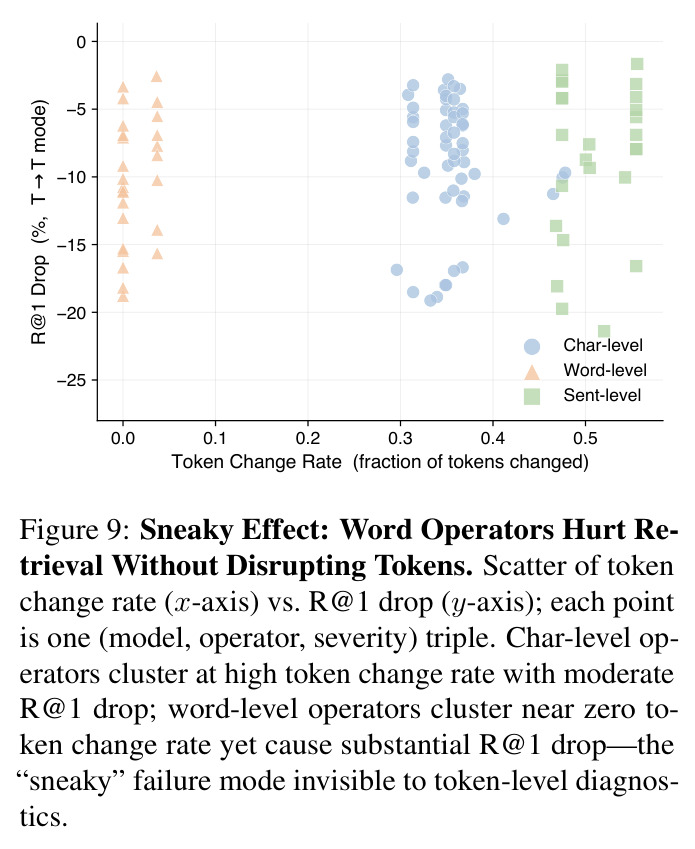
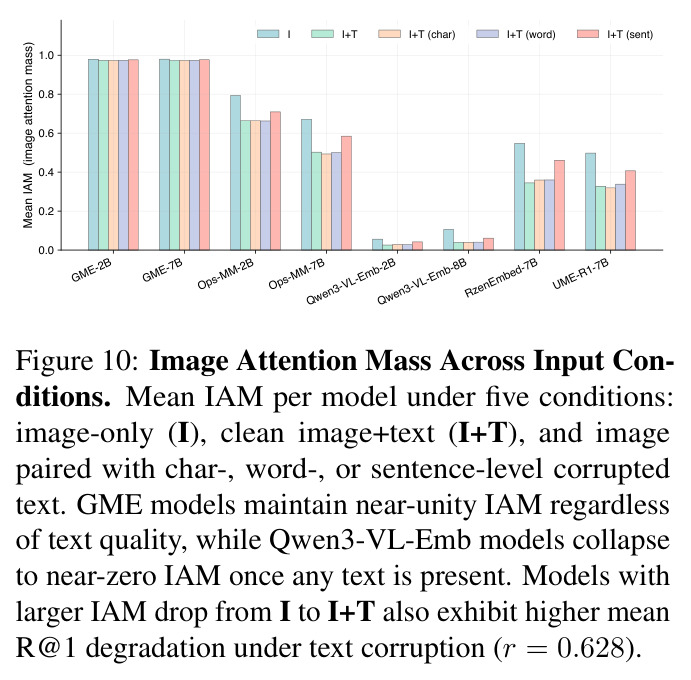
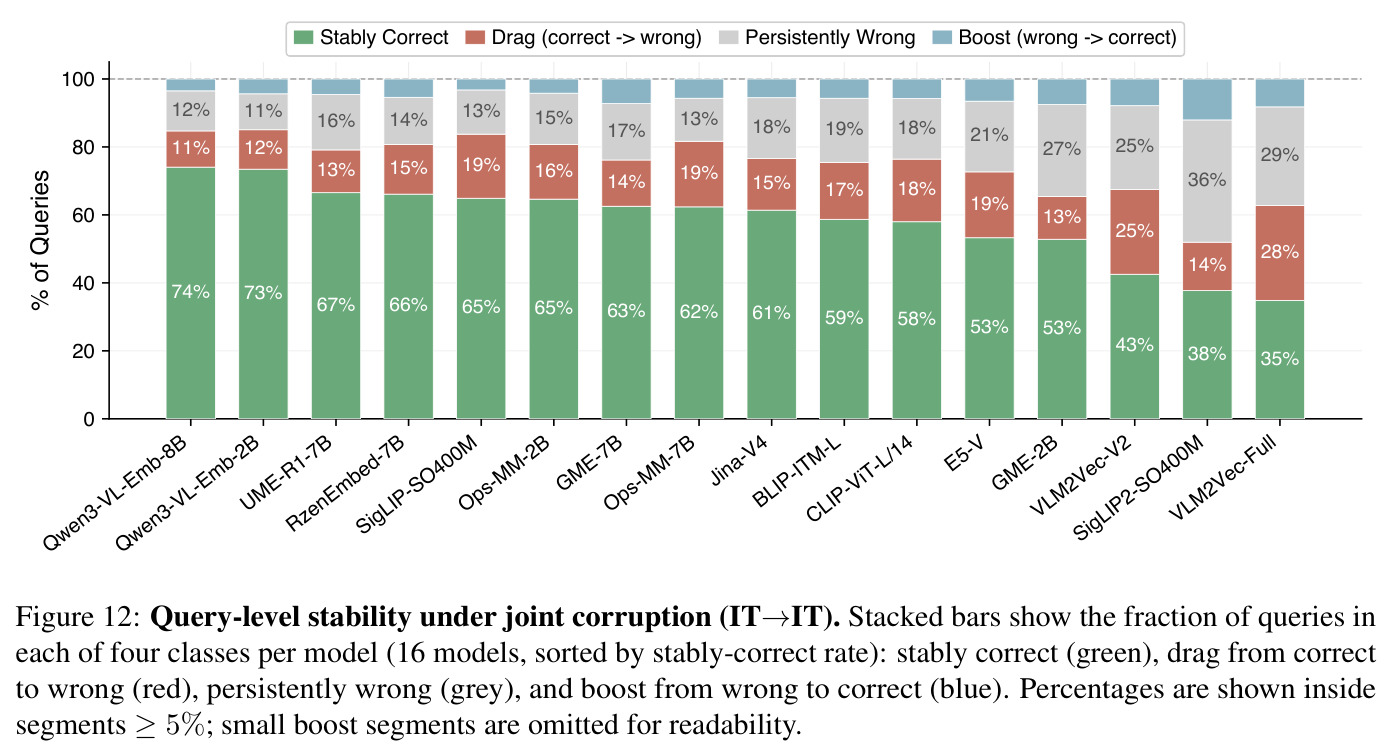
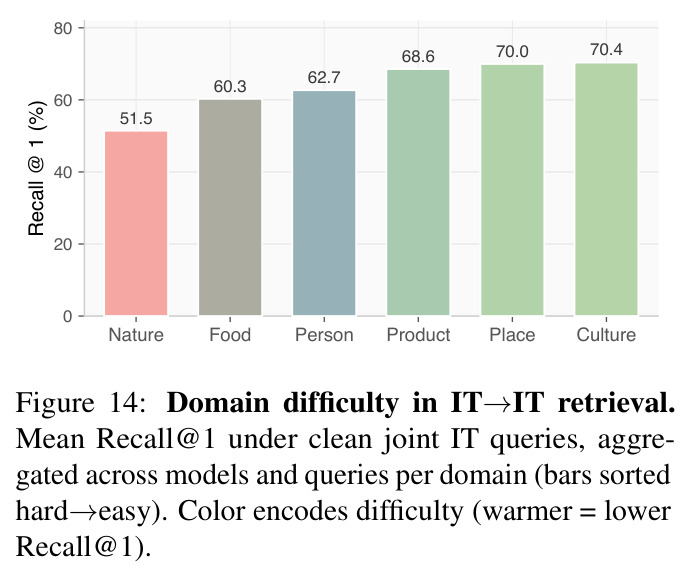
评测 16 个模型得到三大失效模式加一个解法。(1) 图像退化伤害最大且呈剂量效应:16 模型平均 R@1 从 clean 的 63.2 降至 57.9(-5.3 分),三个严重度下分别 -0.8、-3.8、-11.2 分;最高严重度下 remove 最狠(-16.3),其后 degrade -12.5、add -10.9、transform -5.2,说明裁剪、降采样、水印这类遮蔽实体的操作最致命;严重 remove 时正确答案的排名平均后移 7.84 位。7 个算子呈「悬崖式」响应(低强度无恙、临界点突崩),均值指标会掩盖移动端高风险区。干净 R@1 从 39.8(SigLIP2-SO400M)到 79.1(Ops-MM-7B),无一超 80;VLM 嵌入平均比双塔高约 13 分,但干净成绩不预测鲁棒性。(2) 文本退化的「稳定」是假象:char/word/sent 三级退化均值 63.5、63.7、63.9,几乎不动——因为固定融合下文本通道本来就贡献很小。真正的问题是 coarse-text drag:联合检索(IT→IT)比纯图像检索(I→I)平均低 11.21 分(CLIP 达 -23.93);在 GME-7B 上把「What flower is this?」换成实体标签「A tulip.」,拖累从 -7.68 收窄到 -0.17(消除 97.8%),证明罪魁是粗粒度而非文本通道本身;在 69 条文本关键查询的子集上拖累显著缩小(GME-2B 归零)。错别字基本无害(token 改动率与掉分的相关性仅 r=0.040),sent_replace 语义替换才真正有害;word 级算子是「隐形杀手」:几乎不改 token 却显著掉分。注意力证据:GME 系列图像注意力质量约 0.98(图像主导),Qwen3-VL-Emb 一加文本就塌到约 0.03(文本主导),IAM 降幅与掉分相关 r=0.628。(3) 联合退化超可加:6 组配对条件下平均观测降幅 13.6 分,远超加性预测的 6.0,平均交互项 +7.6 分;GME-2B/7B 的 δ 超 +30,而 Ops-MM 与 VLM2Vec 系反而亚可加,模型间差异巨大。(4) MOOR 验证校准假设:双塔组平均 clean 53.4 提升到 71.8(+18.4),文本退化下 +19.8、图像退化下 +16.8;VLM 嵌入组提升 +8.6 到 +10.0;54 个状态乘 16 模型的平均 R@1 达 69.80,超过全部融合基线(Borda 43.98、RRF 45.64、CombMNZ 51.95、学习型 LR-Meta 55.97、wh-Uniform 60.72、wh-Img 69.38),在多数模型上收回 oracle(80.07)差距的 40-60%。真实性检查:在 200 条新真实上传上预注册的 3 项预测全部成立——模型排序与合成条件的 Spearman ρ=0.83(p<0.01),47 条双侧退化真实查询的平均交互项 +6.2,确认合成结论可迁移到生产环境。
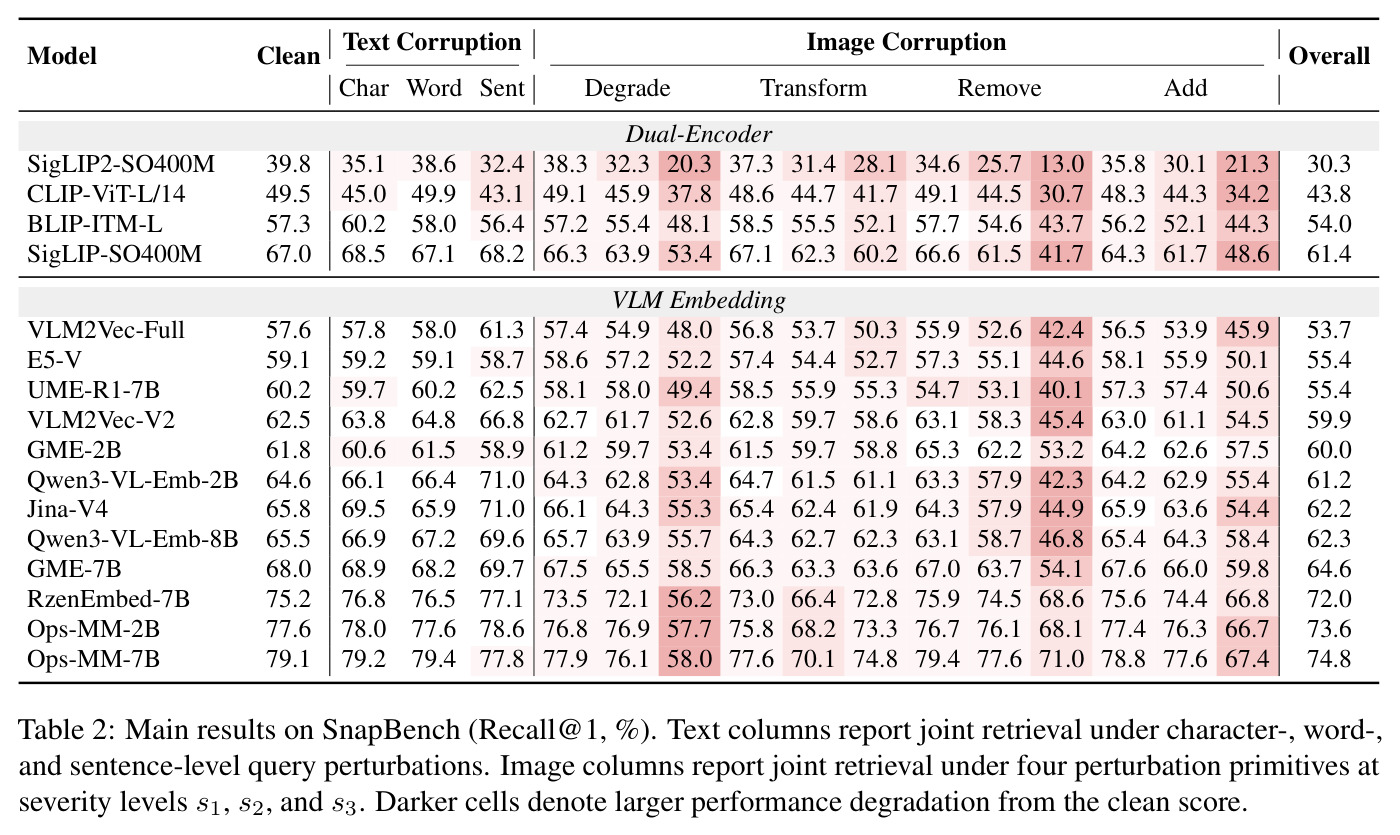
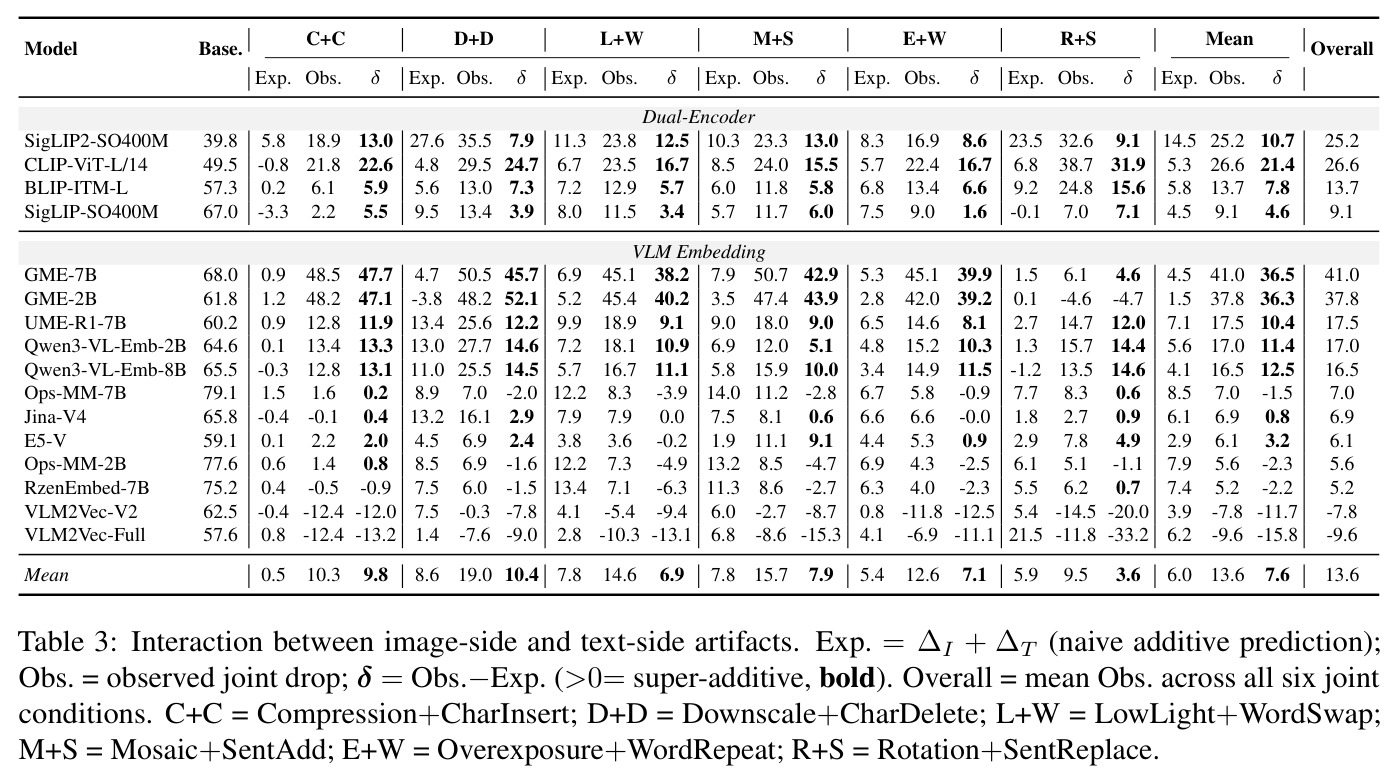
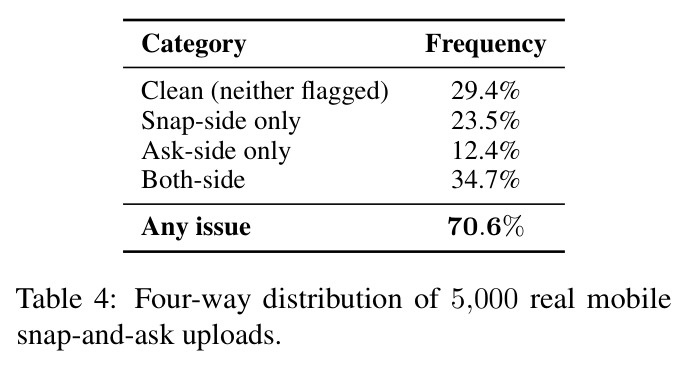
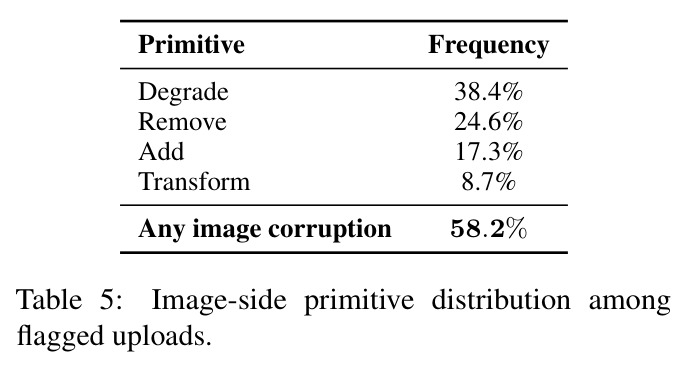
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 干净联合检索(IT→IT,1,145 查询 / 9,085 gallery) | Recall@1 (%) | 最高 Ops-MM-7B 79.1;VLM 嵌入类整体领先 | 最低 SigLIP2-SO400M 39.8;无模型超过 80 | VLM 嵌入平均比双塔高约 13 分,头部仍有 20 分以上差距 |
| 图像退化下的联合检索(15 算子 × 3 强度 = 45 条件) | R@1 均值降幅 | 平均从 63.2 降到 57.9;s1/s2/s3 分别 -0.8/-3.8/-11.2;s3 下 remove -16.3 最重 | clean 输入 63.2 | transform 最耐(s3 仅 -5.2),因其保住实体身份;严重 remove 使 GT 排名后移 7.84 位 |
| 文本退化下的联合检索(8 算子,字符/词/句三级) | R@1 均值 | char 63.5 / word 63.7 / sent 63.9 | clean 63.2 | 波动不足 1 分,但属「文本欠利用」假象而非鲁棒 |
| 联合检索 vs 纯图像检索(coarse-text drag) | clean IT→IT 减 I→I 的 R@1 差 | 16 模型平均拖累 -11.21 分;GME-7B 用实体标签文本消除 97.8% 拖累(-7.68 到 -0.17) | I→I 纯图像检索(如 CLIP 73.45 vs IT→IT 49.52) | 文本关键子集(n=69)上拖累从 -10.06 缩至 -8.78,GME-2B 归零 |
| 图像+文本联合退化(6 组配对算子,16 模型) | 交互项 γ_int = 观测降幅 - 加性预测 | 平均观测降幅 13.6 分 vs 加性预测 6.0 分,γ_int = +7.6 | 朴素加性假设(d_I + d_T) | 超可加;GME-2B/7B 的 δ 超 +30,Ops-MM/VLM2Vec 系亚可加 |
| MOOR 自适应融合 vs 固定融合(54 状态 × 16 模型) | 平均 R@1 (%) | MOOR 69.80(双塔组 clean +18.4、文本退化 +19.8、图像退化 +16.8) | 最优固定融合 wh-Img 69.38;wh-Uniform 60.72;RRF 45.64;学习型 LR-Meta 55.97 | 对全部融合基线领先 0.42 至 24.2 分,收回 oracle 上界(80.07)差距的 40-60% |
| 真实上传验证(200 条生产环境新样本) | Spearman ρ / 交互项 γ_int | 模型排序 ρ=0.83(p<0.01);n=47 条双侧退化查询 γ_int=+6.2 | SnapBench 合成退化条件上的排序与结论 | 预注册的 3 项可证伪预测全部成立,合成结论可迁移到真实分布 |
局限与改进
作者明示三点局限:(1) 53 种退化条件是程序化合成的,追求因子化可控与可复现,但真实上传中噪声的联合分布(多种伪影共现)与本文的边际分布不同;(2) 规模取舍——1,145 查询、9,085 条 gallery 换来稠密正例(平均 4.77/查询)与紧凑的难负覆盖,绝对规模小于 web 级基准;(3) MOOR 在「双模态同等可靠或同等失效」的查询上按构造退回固定融合行为,无额外收益。我的补充观察:gallery 与查询图来自同一图池、caption 又由同类 VLM 生成,可能存在系统性风格偏置,模型或许部分在「匹配 caption 风格」而非纯视觉识别;协议只扰动查询侧不扰动 gallery,忽略了真实库内噪声(错误 caption、低质库存图);主文指标只有 R@1,未反映 top-k 体验与延迟约束——7B VLM 嵌入模型在端侧并不可行,缺效率-鲁棒性权衡;真实数据试点来自单一生产服务,域分布外推性未知;另外基准只含英文短问题,多语言与口语化长问题未覆盖。
独立分析的弱点
独立分析四点弱点。第一,MOOR 的「图像锚」假设:$s^{II}$ 永远充当参照系,但拍图问答中恰有图像彻底失效而文本携带判别线索的场景(用户打出型号词、书名),此时锚本身就是坏的,秩一致性门无从救起;改进方向是双锚互验,或按锚路径的方差/置信度自适应选择锚模态。第二,MOOR 是诊断探针而非终点:与 oracle 还差约 10.27 分,钟形门只有两个形状参数且超参在 10 倍范围内平坦;把秩一致性、方差等特征喂给一个轻量可学习的 query 条件门控,甚至直接蒸馏每查询 oracle 权重,应能进一步逼近上界。第三,合成-真实差距:真实上传往往模糊+暗光+水印共现,而基准逐算子独立施加;可利用已有 5,000 条真实上传拟合伪影共生分布,做组合采样或学习式退化生成,缩小边际分布与联合分布的缝隙。第四,评测面窄:只有 R@1、只有查询侧扰动、只有英文;应加入 R@k 与 MRR、gallery 双侧噪声协议、多语言口语问题,并补效率-鲁棒性帕累托分析——2B 与 7B 模型间仍有 1.2 分左右差距(Ops-MM-2B 73.6 vs Ops-MM-7B 74.8 总均值),参数量的边际收益值得系统量化。
未来方向
作者指明的方向是「面向拍图问答的模态校准」。基于本文成果可延伸:(1) 把校准信号接入训练——用逐查询 oracle 权重或 MOOR 门控值作为对比学习的样本权重,或在难例挖掘中优先挑选校准误差大的查询;(2) 生成式重排序:对 top-k 用 VLM 做证据校验(EviRank 一脉),在图像证据被破坏时用文本推理补位,与 MOOR 的分数级校准互补;(3) 查询实体化是廉价修复——「A tulip.」实验消除 97.8% 拖累,提示在检索前加一个 query rewriting / 实体链接模块的投入产出比极高,值得工程化;(4) 在线自适应:以真实上传流为输入做 test-time 校准,处理伪影共现与分布漂移;(5) 扩展协议到 gallery 双侧噪声、视频拍图、多轮追问对话式检索;(6) 域差异(nature 最难 51.5%,culture/place 超 70%)说明细粒度物种识别仍是开放难点,可结合检索增强知识注入或领域专精模型;(7) 把「悬崖式」退化响应建模为风险指标,为移动端做退化前置检测(拍片时提示用户重拍)提供依据。
复现评估
复现友好度高。代码与数据在 https://github.com/zrchen03/SnapBench 全量开放:1,145 查询、9,085 gallery、全部正例/难负标注与 53 条退化条件的确定性参数(附录给出完整参数网格与 seed),R@k 之外还固定了 gallery 顺序。16 个模型全部是公开权重(CLIP/SigLIP/BLIP、GME、Qwen3-VL-Emb、Jina-V4、Ops-MM、RzenEmbed、UME-R1、E5-V、VLM2Vec),gallery 嵌入每模型只需离线计算一次;双塔模型单卡即可推理,7B VLM 嵌入需要较大显存但可批量离线跑。评测流程无训练、纯检索打分,工程量主要在复现 53 个退化算子(参数已给全)。两个小缺口:原始图池与私有 Qwen-VL caption 模型不公开,问题生成管线依赖 Gemini-3-Flash 与 GPT-5.4-mini 闭源 API——但成品数据已发布,不影响评测复现,只影响从零重建同类基准;另外 gallery 图像按 research-only 许可发布、禁止商用再分发,产业界直接使用受限。整体难度评级:低到中,一台多卡服务器数天内可复现全部主表。
论文图表
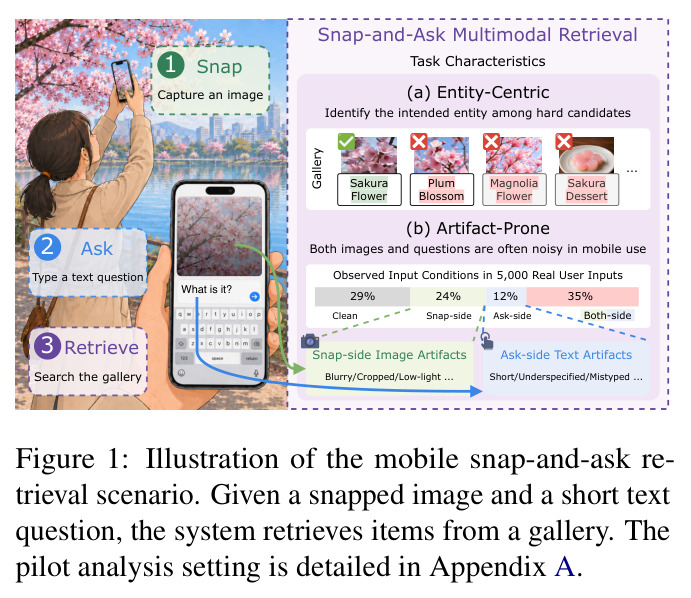
左侧展示拍图问答三步流程(拍照→提问→检索库);右侧给出任务特性:实体中心(樱花/玉兰/桃花等难候选间辨别意图实体)与易带伪影——基于 5,000 条真实用户输入的试点分析显示 Clean 仅 29%、Snap 侧 24%、Ask 侧 12%、双侧 35%。
一图定义了整个任务形态和动机:读者 30 秒内即可理解 snap-and-ask 是什么、为什么真实输入噪声大、以及为什么需要专门基准。