锁在入口、敞开在内:RLVR 收窄解空间的位置 Locked at the Entrance, Open Inside: Where RLVR Narrows the Solution Space
RLVR的多样性坍缩集中在解题入口:模型不再发起替代解法,但给定入口仍能顺利执行
前置知识
RLVR(可验证奖励强化学习)
用程序可自动判定的结果奖励(如数学答案对错)对大模型做策略梯度训练(PPO、GRPO 等),是 o1/R1 类推理模型的标准后训练范式。奖励只看最终答案、不监督中间过程,模型通过反复采样成功轨迹来强化自身行为,形成 on-policy 的采样—强化循环。
本文研究的正是 RLVR 训练的副作用——解空间收窄。理解 on-policy RL 中'梯度正比于采样频率'的循环,是理解'为什么入口最先坍缩'的理论前提。
pass@k 与解空间覆盖率
pass@k 是从 $n$ 次采样中抽 $k$ 次至少一次成功的无偏估计,衡量单次或少量采样的成功率;解空间覆盖率 $\mathrm{Cov}$ 定义为模型命中的独立合法解法数除以求解器枚举出的全部合法解法数,衡量策略输出支持的广度。
论文用 pass@1 上升与 Cov 下降的反向关系定义'精度—广度权衡',全文所有实验(训练轨迹、干预、跨规模)都围绕这两个量展开。
熵坍缩 / 分布锐化
on-policy RL 会强化高频成功模式:被采样到的正确解法获得正梯度,未被访问的等效解法逐渐失去概率质量,策略分布熵持续下降,输出坍缩到少数模式。这直接削弱 self-consistency、 Best-of-N、树搜索等依赖多样性的测试时扩展技术。
本文不止确认坍缩存在,还要回答坍缩发生在推理轨迹内部哪个位置;'first-calculation 熵'就是其在不可枚举的数学基准上使用的核心代理指标。
Teacher forcing 与 NLL 对比
不让模型自由生成,而是把固定文本逐 token 喂给模型并读取其对每个 token 的对数似然(负对数似然,NLL)。对比两个 checkpoint 在同一段文本上的 per-token NLL,可以精确定位训练前后概率质量从哪里搬走、搬到哪里。
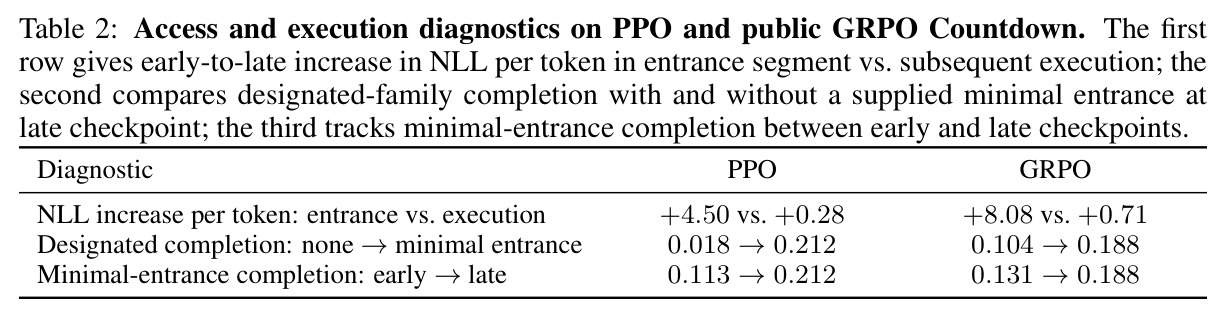
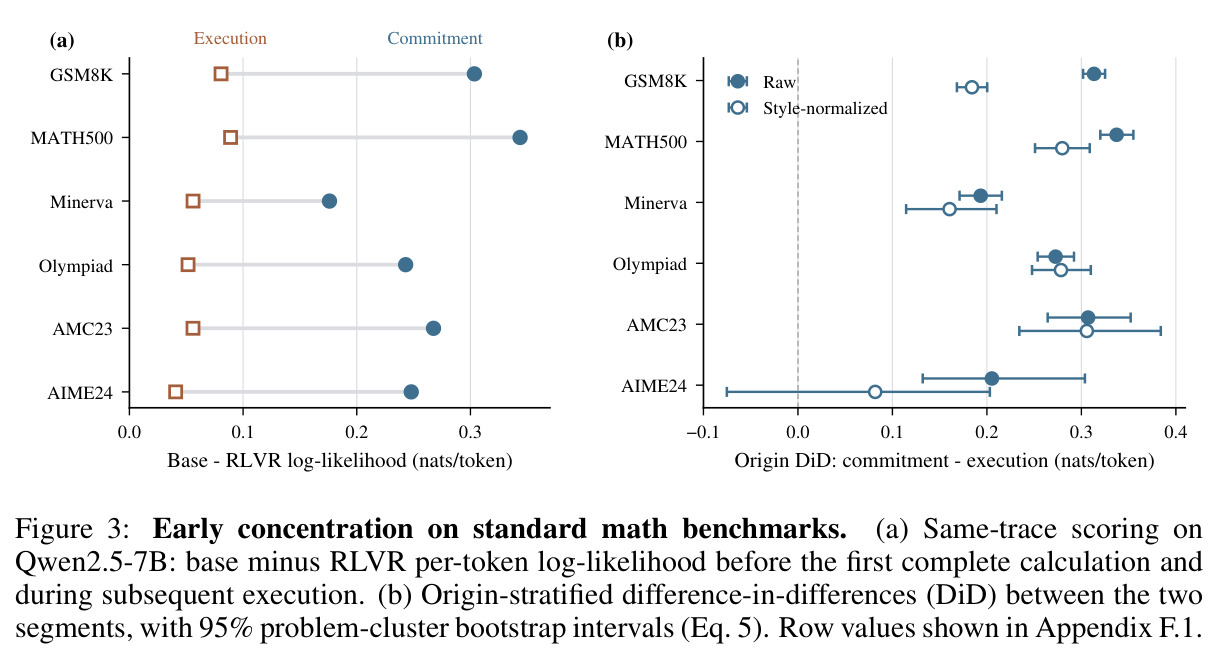
论文用它把每条解法轨迹切分为'入口段'(第一个算子之前)与'执行段'(之后),得到 16×/11× 的似然位移差异,是'广度丢在门口'这一核心结论的关键证据。
Countdown 任务与入口族
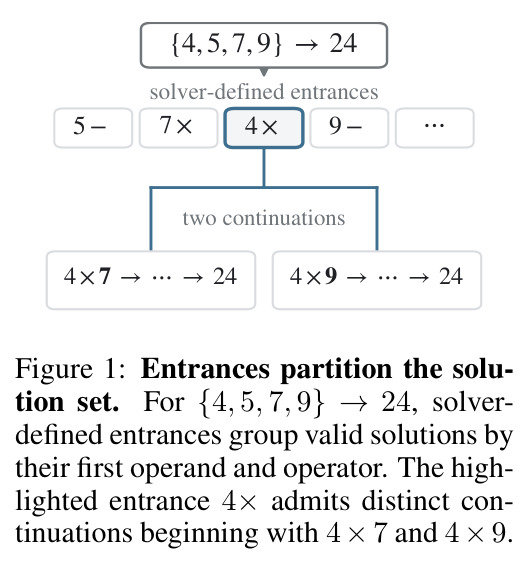
Countdown 给定目标数和 3–4 个操作数,要求用 $\{+,\times,-,\div\}$ 把每个数恰好使用一次凑出目标。其合法表达式可被符号求解器完全枚举;按首个'操作数+算子'组合分组,得到互斥的'入口族'(如 $4\times$、$9-$),是解空间的第一层分叉。
可枚举性提供了完整分母,使'从未访问某解法族'(访问失败)与'访问后没算出来'(执行失败)首次可被严格区分——这是全文实验设计的基石。
权重插值与检查点采样
对同一模型在不同训练阶段的参数做逐层线性插值(model soup 类方法),或在推理时把采样预算分配给多个历史 checkpoint(时间集成),是恢复后训练所遗忘能力、找回多样性的常用手段。
论文发现'晚 checkpoint 的 20–28 层与早 checkpoint 权重插值'是恢复广度的最优干预之一,并据此为这类方法提供了机制解释:它们专门重开了休眠的入口分支。
研究动机
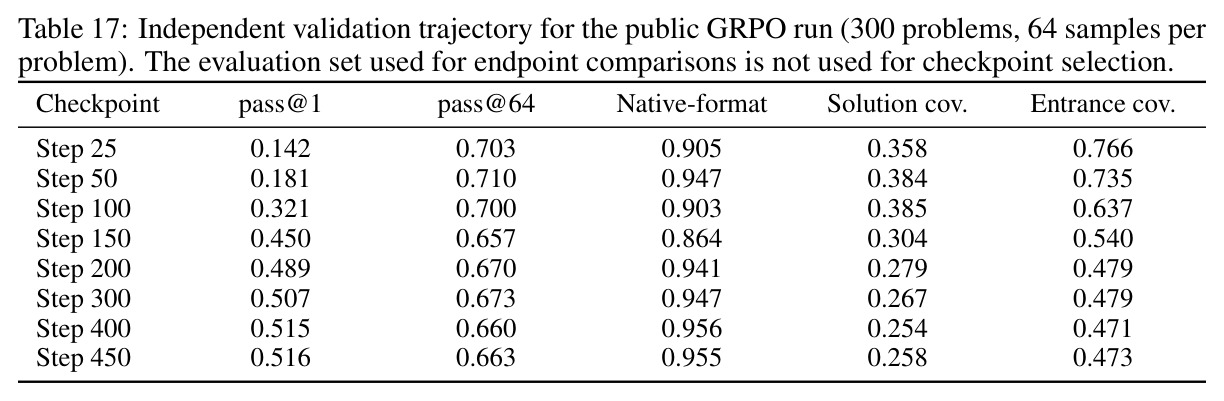
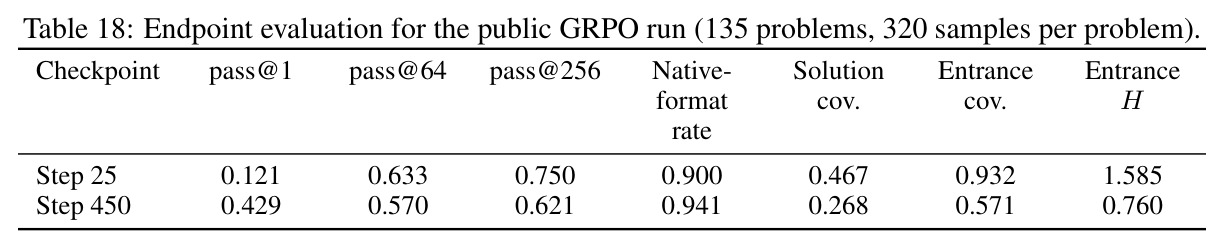
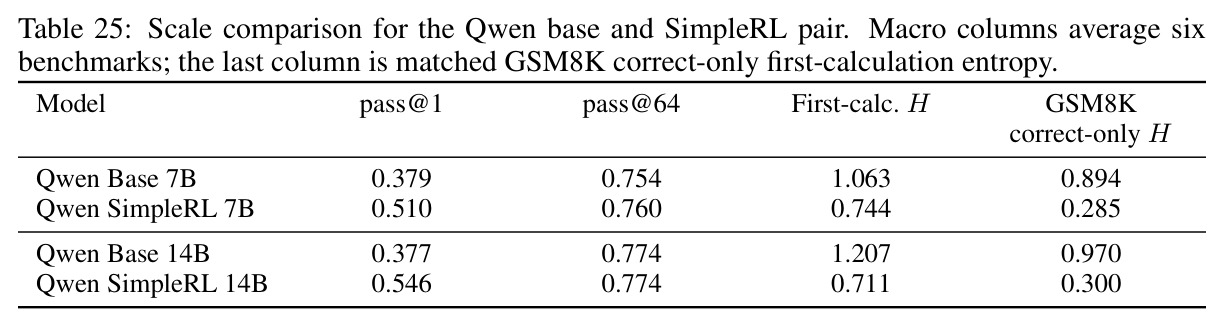
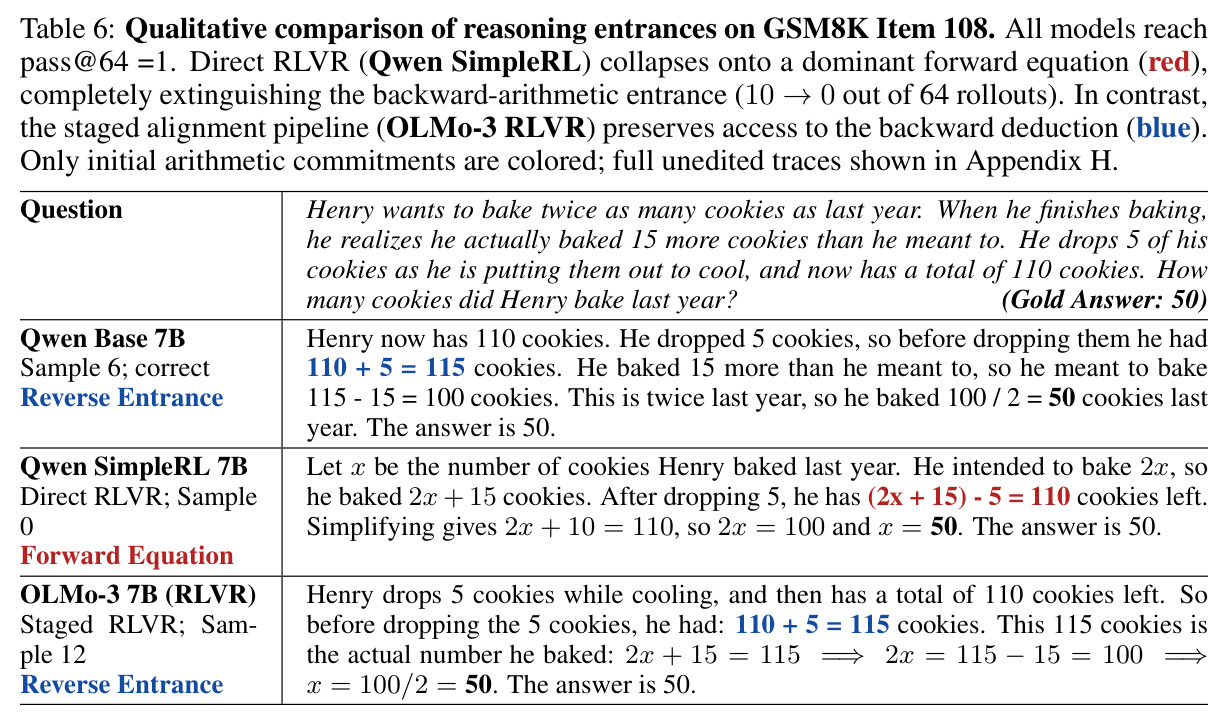
RLVR 已成为引出复杂数学推理的标准范式,单样本精度提升显著:文中 PPO 在 Qwen2.5-3B 上把 pass@1 从 base 的 0.001 拉到 0.32 左右,公开 GRPO 检查点从 0.121 升到 0.429。但测试时扩展技术(重复采样、self-consistency、验证器引导搜索)依赖候选轨迹的多样性,而已有研究(Yue et al. 2025、Wu et al. 2025 等)表明 post-RLVR 策略的答案支撑急剧收窄、推理多样性严重退化——例如 7B 模型 RLVR 后 pass@64 几乎不动(0.754→0.760),重复采样的边际收益被大幅削减。更关键的是,现有改进尝试(奖励塑形、探索奖励、修改 rollout 目标)都在'盲打':没有人知道有效解法究竟在轨迹内部的哪个位置丢失。现有评估要么统计最终答案的簇数、要么对采样轨迹聚类,把两种本质不同的失败混为一谈——模型可能永远不发起某条有效解法路径(访问失败),也可能发起了但中途算错(执行失败)。这两种失败需要完全不同的修复机制,不先分开诊断就无法对症下药。
本文的目标是本文的目标是定位而非缓解:在一个解空间可以被完全枚举的任务里,精确追踪 RLVR 训练过程中每一条合法解法路径的命运,回答'概率质量从哪里搬走'。具体拆成三个问题。第一,确认精度—广度权衡是否跨算法(自训 PPO 与公开 GRPO)、跨 checkpoint 持续存在,并排除'模型只是忘了难题'的幸存者偏差解释——为此作者在两个 checkpoint 都能解出的固定题目子集上追踪解法叶的更替。第二,把解空间按入口族分解后,用因果手段判断广度损失是访问失败还是执行失败:teacher-forced 似然剖面定位位移集中区,最小入口前缀钳制(clamp)实验和失败轨迹嫁接检验休眠分支的可执行性。第三,验证定位结论的普适性:在不同规模(3B/7B/14B)、六大数学基准(GSM8K、MATH500、Minerva Math、OlympiadBench、AMC23、AIME24)和不同训练管线(直接 RLVR、蒸馏后 RL、SFT–DPO–RLVR 阶梯、多解 SFT 对照)上检验'入口优先坍缩'是否成立,并据此设计能恢复广度而不牺牲精度的干预。
与已有工作不同的是,独特切入在于'用可枚举的 ground-truth 解空间做分母'。此前所有多样性分析都基于模型自己采样的轨迹聚簇(如 BODHI 的语义分支),原理上不可能发现模型完全不去的分支——而恰恰这些'灭绝分支'才是广度损失的存量。作者选择 Countdown 任务:符号求解器可以枚举全部合法表达式,按首个操作数—算子划成离散入口族(150 题共 379 个可行族,平均 2.53 族/题),于是'336/337 个族在两个独立的 512 样本中都不出现'这样的零访问事件可以被严格界定(95% Clopper–Pearson 上界 0.0058)。第二个独特性是干预式因果探测:入口前缀由求解器合成(如 'Let me try: 4 *'),经互信息可预测性门控验证不含任何下游提示信息,clamp 它就能把执行能力从访问中剥离——这是观察性聚类做不到的。第三,作者给出 on-policy 梯度的一阶代理分析 $\partial J_x/\partial u_b = q_b(\mu_b - \bar\mu)$:梯度正比于当前访问率 $q_b$,从理论上预言入口必然是坍缩的第一现场。
核心方法
直觉上,一次解题像进房间:先选门(入口,即第一个具体算式),再在屋里走(后续算术步骤)。RLVR 之后屋里的路都还能走,但模型不再推某些门了。技术上,作者把 Countdown 实例的解空间组织成决策树:深度为 1 的分支是入口族,叶子是完全枚举的规范化解法集 $S(x)$(对 + 与 × 做交换/结合规范化)。通过族 $b$ 解题的概率被分解为 $\pi_\theta(\text{solve via } b \mid x) = \pi_\theta(B = b \mid x)\cdot\pi_\theta(\text{valid completion} \mid x, B = b)$,前者是访问、后者是执行。测量上:自由采样的覆盖率 $\mathrm{Cov}(x, Y_{1:n}) = |\{s \in S(x) \text{ 被命中}\}|/|S(x)|$(每题 320 个 rollout)度量访问;把生成 clamp 到求解器构造的入口前缀(只含第一个操作数和算子,如 '4 *')后测指定族完成率,度量条件执行能力。诊断上:teacher-forced NLL 在第一个算子处切分两段,对比训练前后 per-token 位移;再做失败轨迹嫁接和灭绝族恢复实验。最后在三个层面做恢复实验——权重空间(层插值)、解码(logit 混合、调温)、测试时预算分配(按可行入口均匀分配 rollout)——理论预测是:只有重开入口的干预才应该在不动精度的情况下恢复广度。
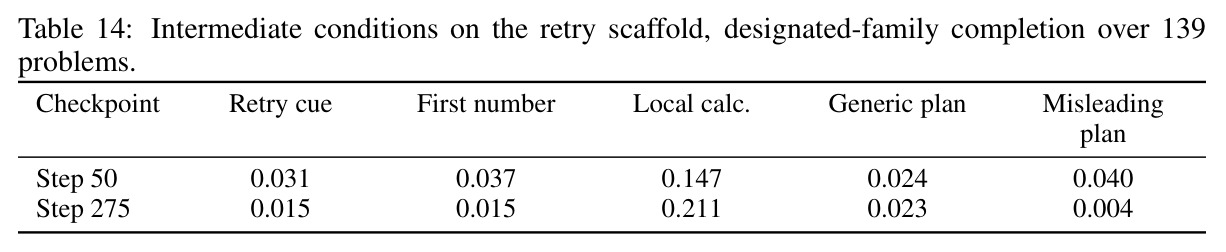
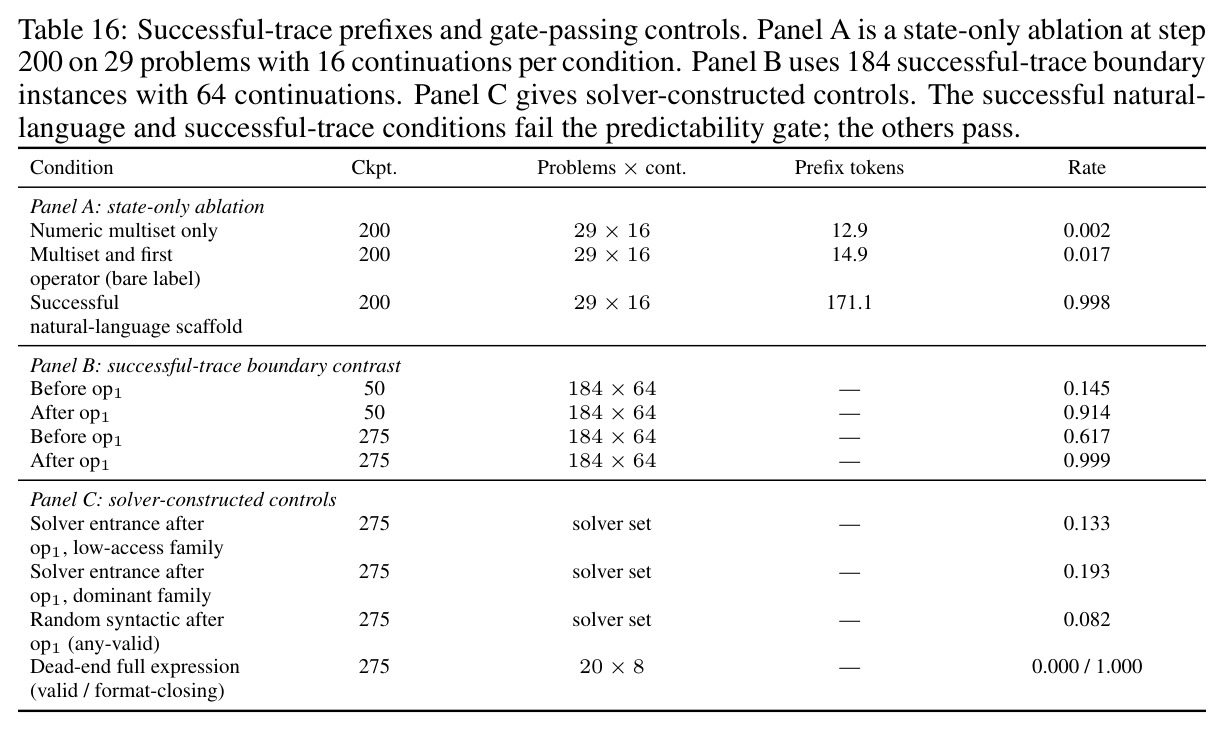
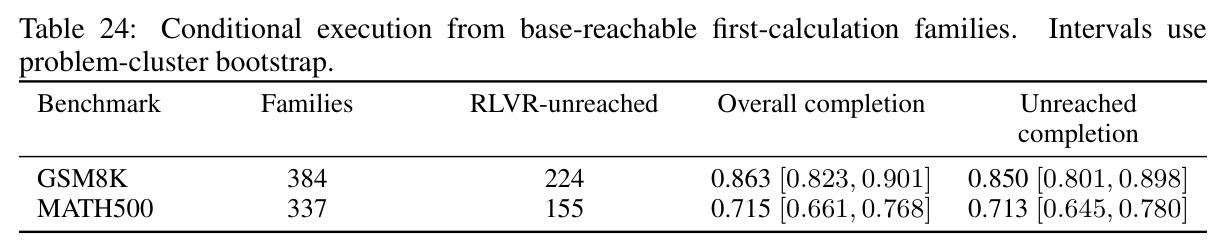
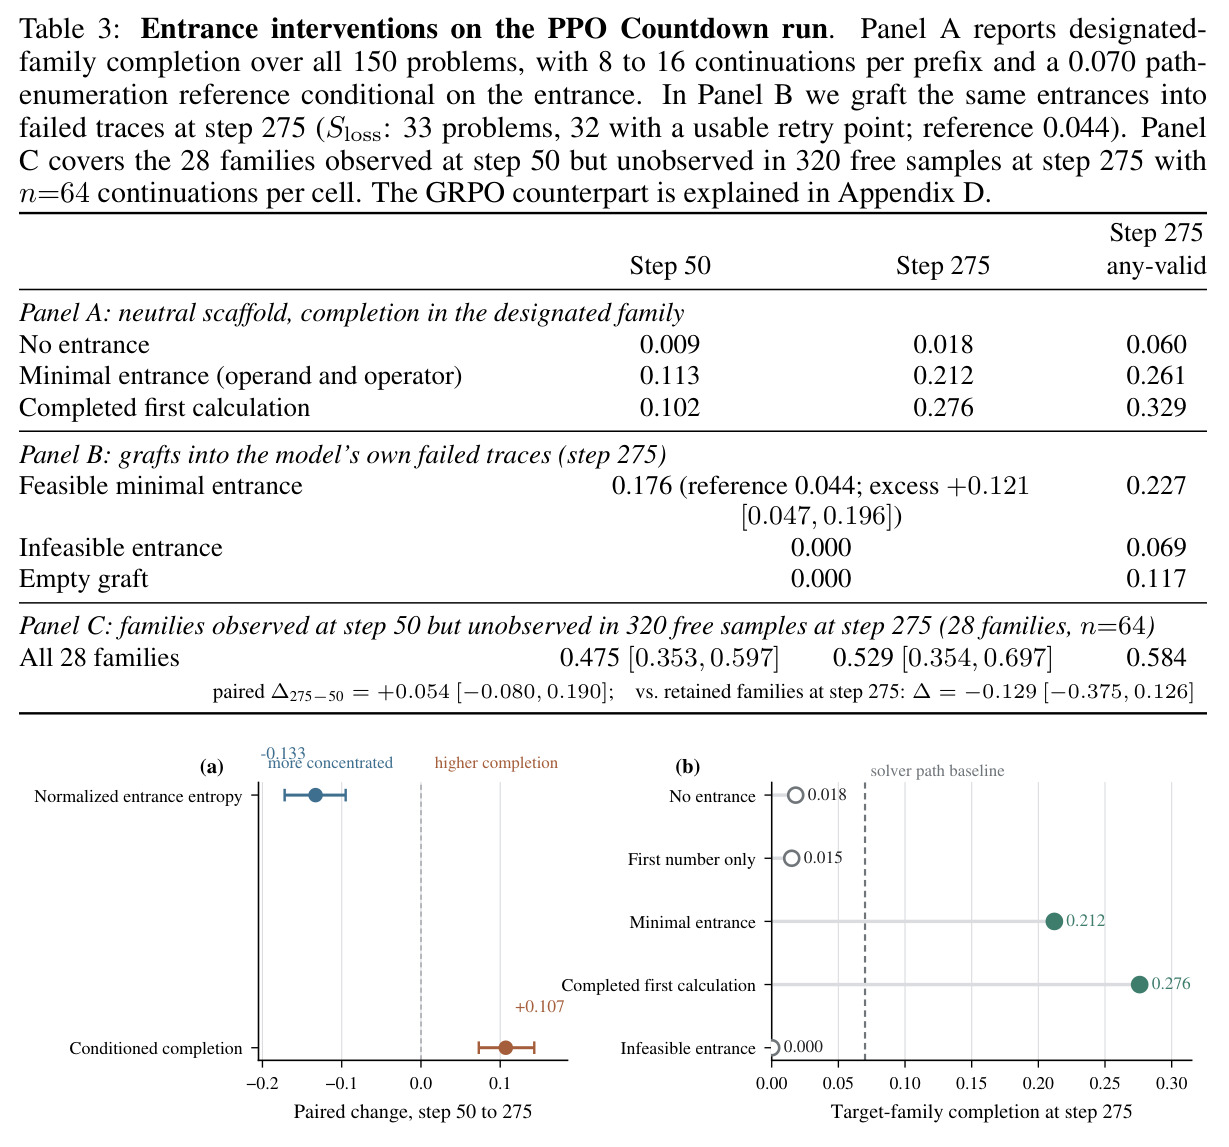
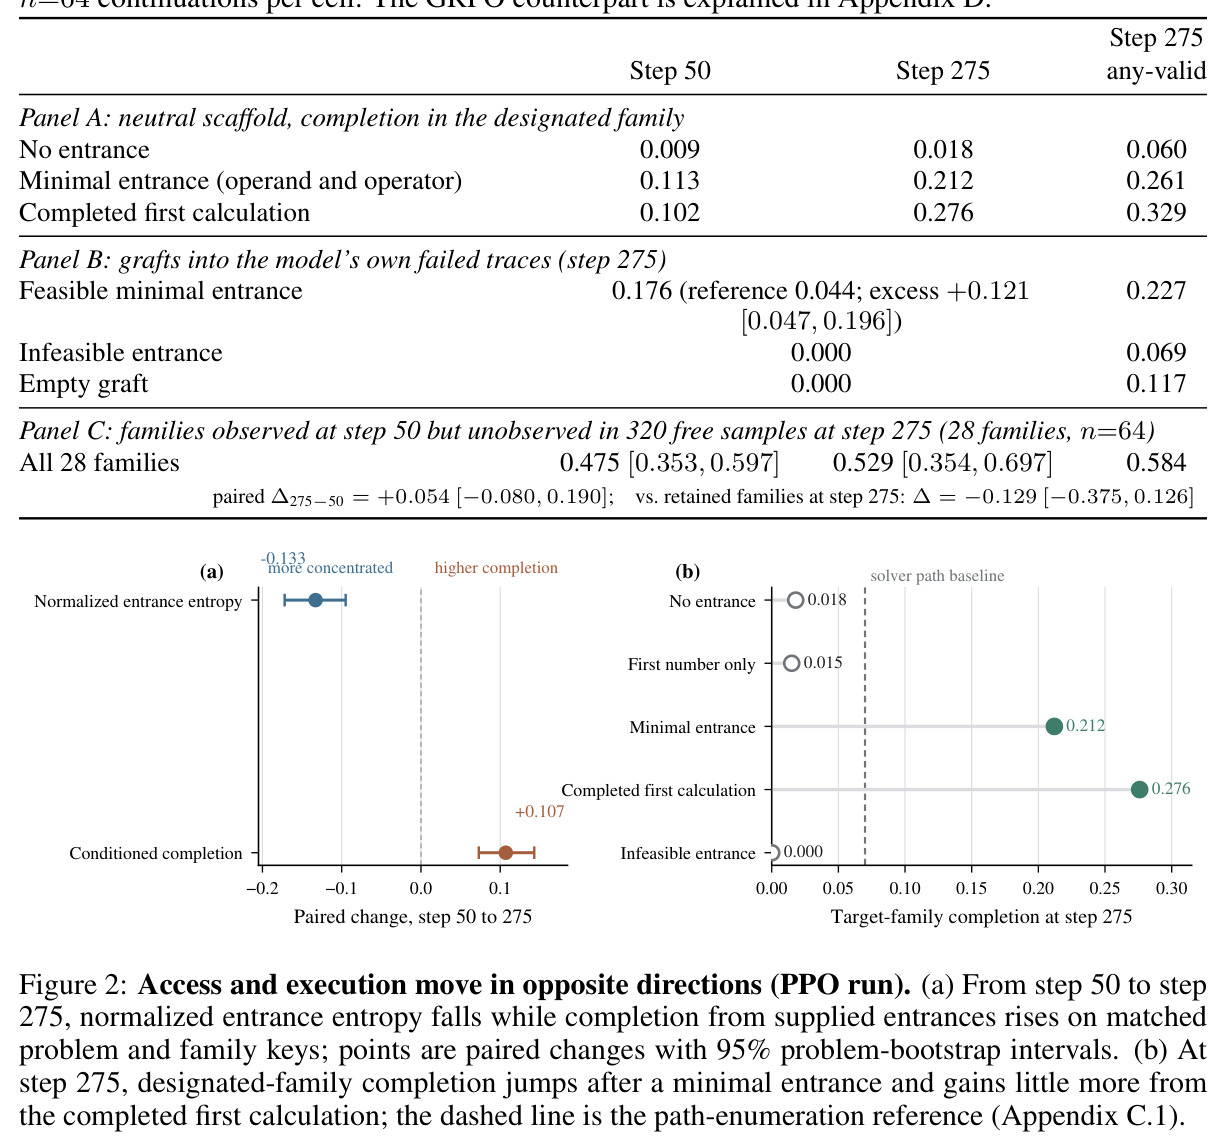
核心创新是'访问—执行分解 + 完全枚举分母'的组合。与已有工作的本质区别有三。其一,此前工作只能刻画被采样到的语义分支,本文的入口族划分覆盖包括模型从未访问的灭绝族在内的全部合法分支,使'广度损失'第一次有了无损的分母——320 个样本中零出现、但 clamp 后完成率高达 0.529 的'休眠分支'就是只能在这个框架下被识别的对象。其二,执行能力第一次被作为反事实量来测量:$\hat{E}^{do}(b \mid x) = \pi_\theta(\text{valid completion} \mid x \oplus e_b)$,通过 clamp 求解器入口前缀直接干预,而非观察模型自己选的路径;配合梯度化对照(只给第一个数字 0.015、给最小入口 0.212、给完整首算式 0.276、给误导性计划 0.004),证明有效成分恰是'固定第一个算术动作'这一信息。其三,作者用同一框架为已知的经验现象给出统一机制解释:checkpoint 采样与权重插值之所以恢复多样性,是因为它们专门重开了休眠的入口分支,而非泛泛的'参数平均正则化'。
方法步骤详情
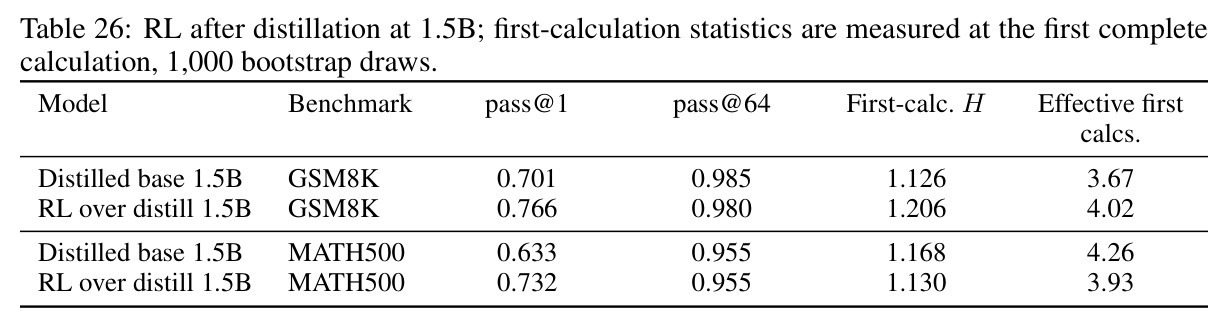
第一步,训练与数据。自训 PPO 管线沿用 TinyZero 框架在 Qwen2.5-3B 上训练(2×RTX 4090,AdamW actor 学习率 $10^{-6}$、critic $10^{-5}$,rollout 温度 1.0,每 25 步存档,得到 step 25–275 共 11 个检查点);第二条独立管线用公开的 TRL GRPO 检查点序列(Qwen2.5-3B-Instruct,step 25→450)。评测集从公开 50k 训练超集按'排序输入+目标'语义键过滤,得到严格不相交的 150 题(PPO)/135 题(GRPO)。第二步,解空间枚举。符号求解器生成每个可行实例的全部合法表达式并规范化得到叶集 $S(x)$,独立枚举器在 500 个保留实例上零差异验证;按首算子(算子类)与首操作数—算子对(入口族)分层。第三步,广度度量。每题 320 个独立 rollout(T=0.7,top-p=0.9),计算 $\mathrm{Cov}(x, Y_{1:n})$ 与语料级均值,无偏 pass@k 估计器报精度,2000 次 bootstrap 给置信区间。第四步,定位诊断。对 1530 对求解器构造的合法续写做 teacher forcing,按第一个算子切分入口段/执行段,对比 step 25 与 275 的 per-token NLL;token 级归因找最大下降位置;再做三组 clamp 实验:干净脚手架上的指定族完成率、把入口嫁接进模型自己的失败轨迹、对 step-50 可见而 step-275 灭绝的 28 个入口族的恢复测试。第五步,恢复干预。在 50 题校准集调参、100 个 held-out 题上配对比较七种干预:提示多样化、强制替换算子、仅答案段 logit 混合、高温解码(T=1.0)、推理段 logit 混合、20–28 层权重插值(晚 checkpoint 与 step-50 权重混合)、checkpoint 采样(64 样本预算均分给 step 50 与 275);另有按求解器可行入口均匀分配采样预算的测试时策略(token 预算配对)。第六步,泛化验证。在 GSM8K/MATH500/Minerva/OlympiadBench/AMC23/AIME24 上评估 Qwen2.5-7B/14B 的 Base–SimpleRL 对、R1-Distill-Qwen-7B 与 OLMo-3 的 SFT/DPO/RLVR 阶梯(每题 64 样本、T=0.6、16k token 上限),构造 first-calculation 熵、distinct-trace 率与同轨迹差中差 $\mathrm{DiD}_d = (C_{base,d} - E_{base,d}) - (C_{RLVR,d} - E_{RLVR,d})$;用 534 道四数字 Countdown 题做深度递增的执行压力测试;最后做多解 SFT 对照($k \in \{1,2,4,8\}$ 个示范解/题,LoRA rank 32)与剂量—响应实验。
技术新颖性
技术新颖性可从四个层面看。度量层面:以可枚举解空间为分母的覆盖率加入口族分层,把'推理广度'从模糊概念变成可审计的量;零访问判定经对半复分(337 个缺失族中 336 个在另一半仍缺失)与 Clopper–Pearson 上界(0.0058)加固,排除了采样噪声假象。因果层面:用互信息可预测性门控筛选实验前缀,确保入口 clamp 只提供'门牌号'而不泄露下游逻辑——从模型成功轨迹上截取的前缀因携带计划信息(teacher-forced 完成率高达 0.617/0.999)被淘汰出识别分析,这种对照设计在 prefix 干预文献中少见。理论层面:把 on-policy 压力形式化为一阶入口代理(被奖励组暴露概率 $p_b^+(G) = 1-(1-q_b\mu_b)^G$,梯度 $\partial J_x/\partial u_b = q_b(\mu_b - \bar\mu)$),预言访问比条件执行收缩得更快,并被精确 Shapley 分解定量印证(解概率变化中 34.5% 归因访问重分配、65.5% 归因条件执行改善)。解释层面:为权重插值、checkpoint 集成、prefix 引导等孤立技巧提供了统一的机制解释——它们都在'入口'这一处起作用,从而把经验技巧收敛为一条设计原则:正则化与测试时扩展应对准初始决策边界。
实验结果
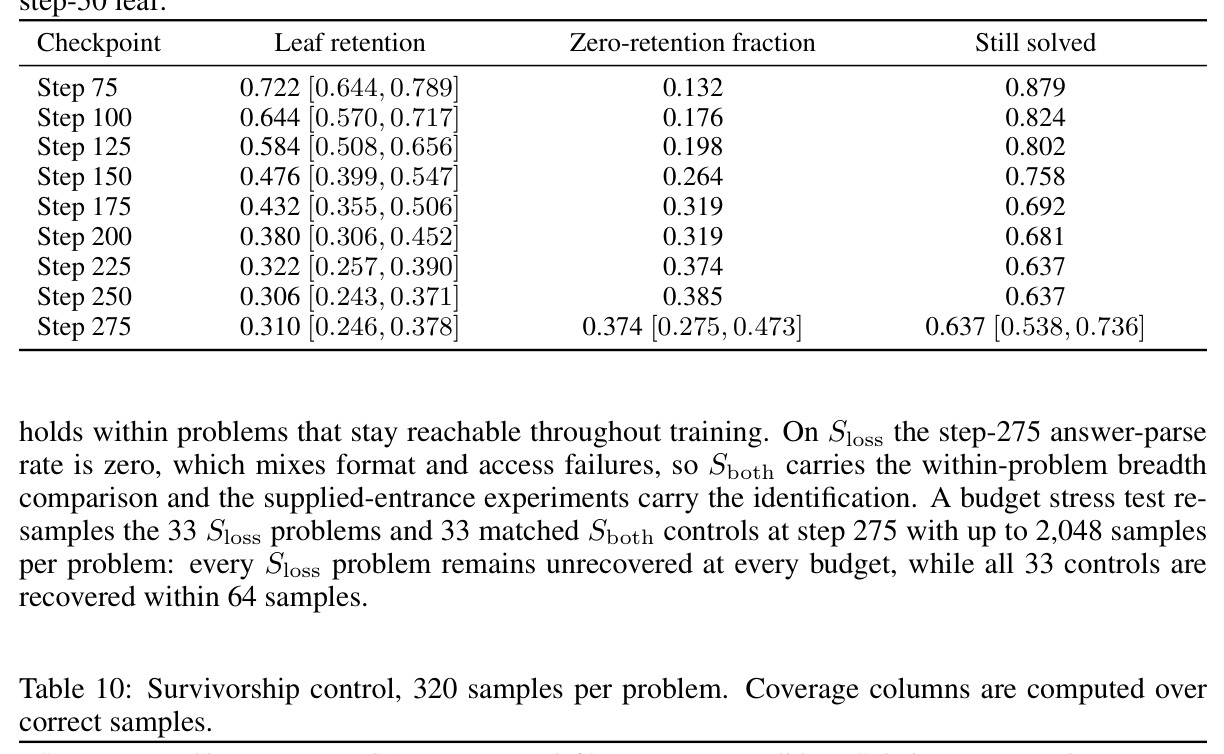
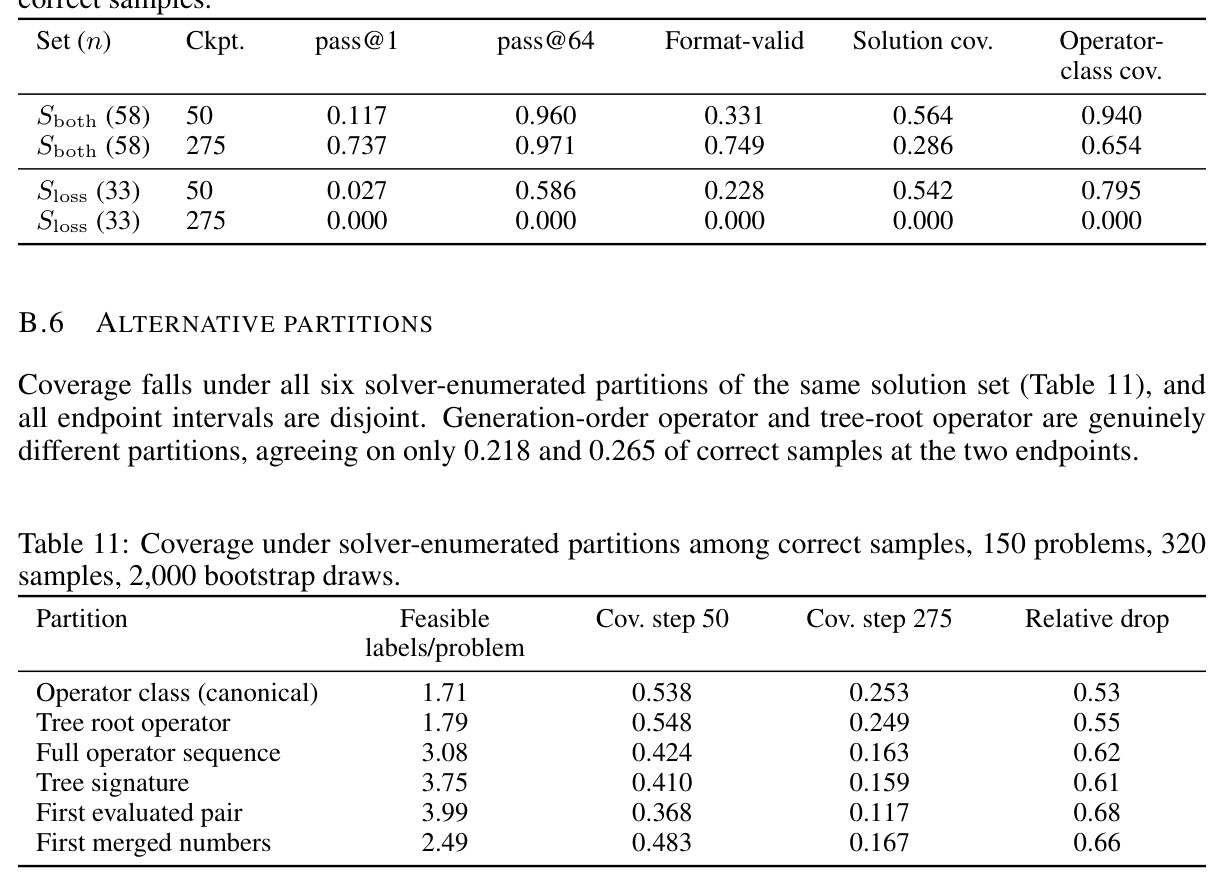
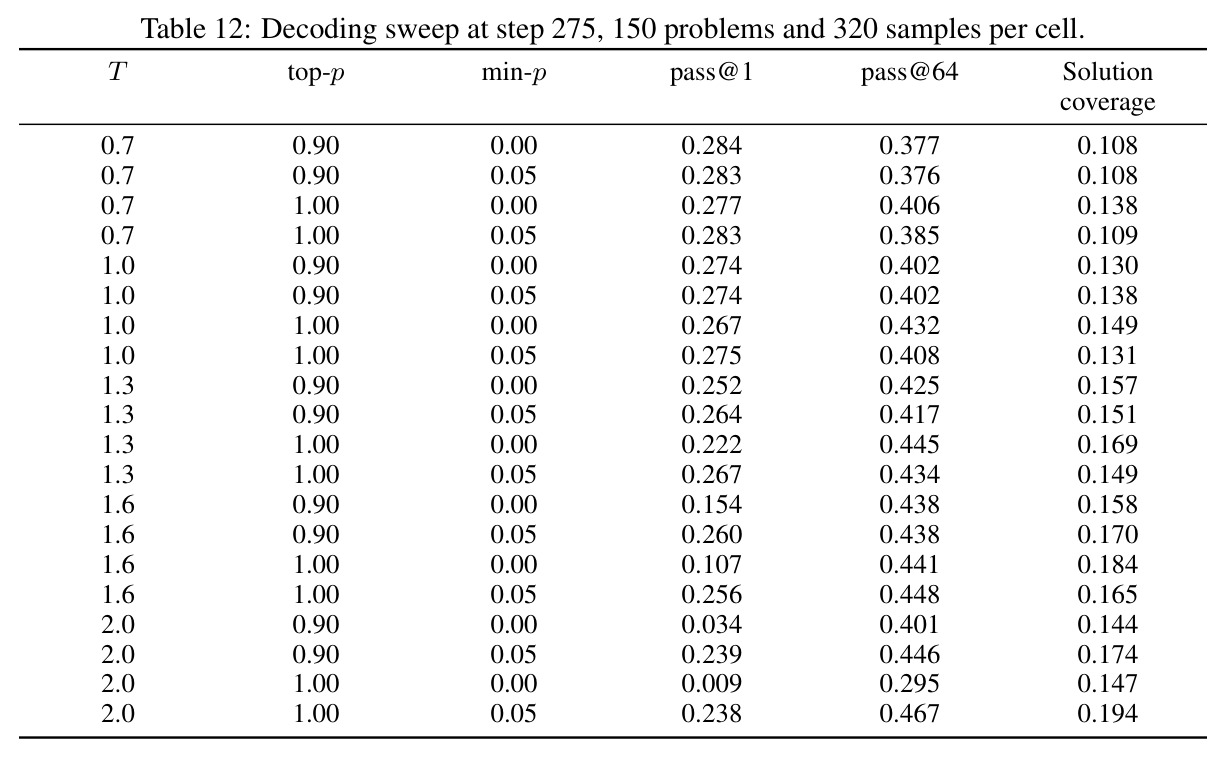
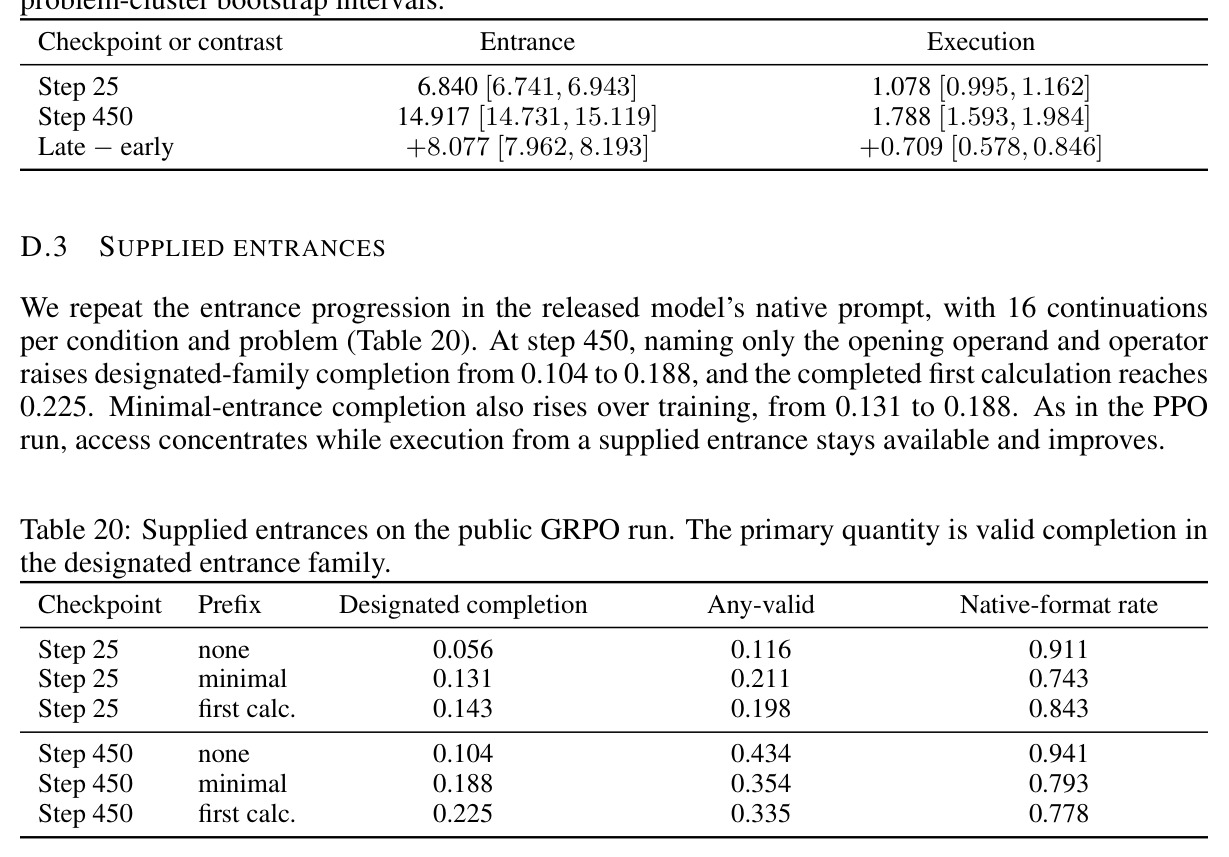
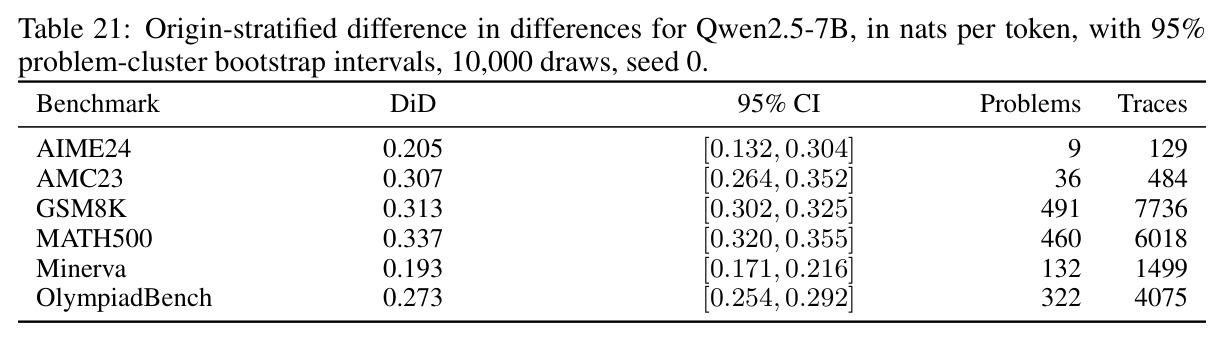
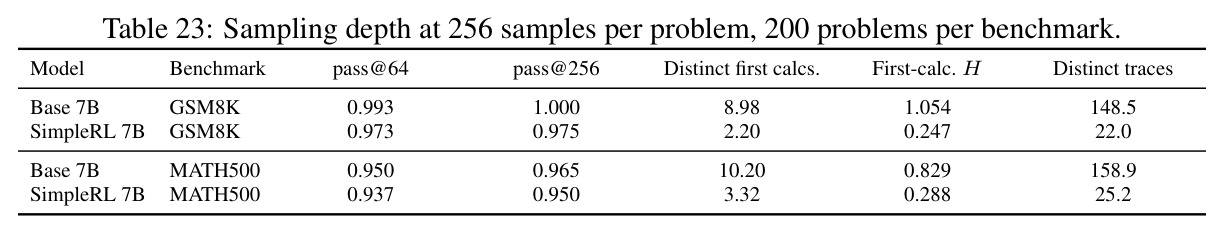
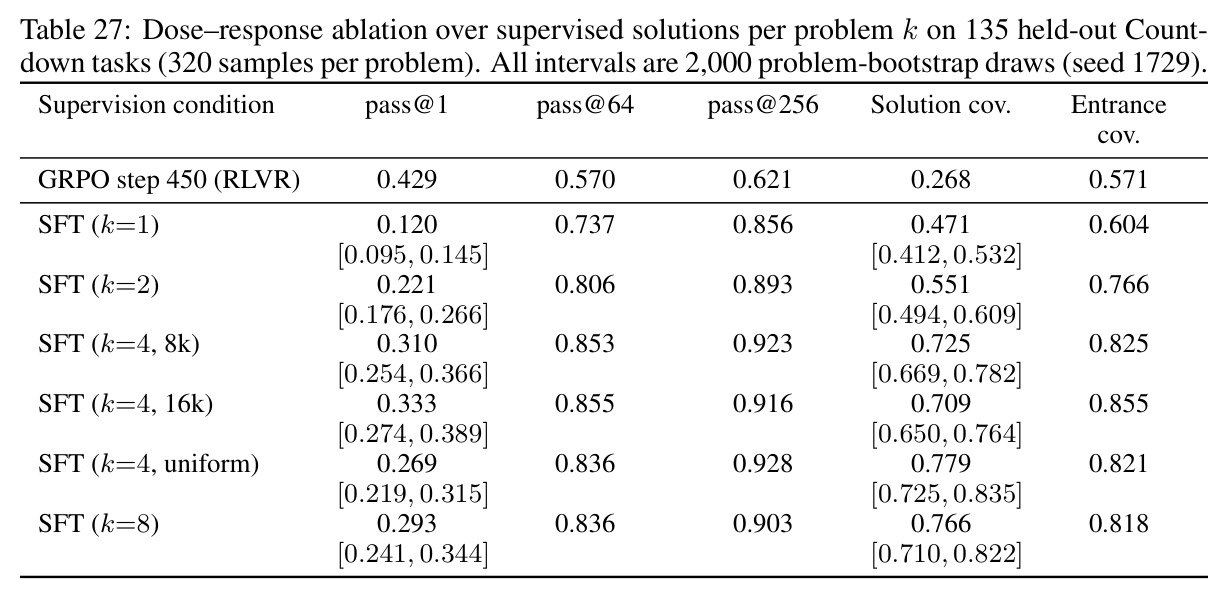
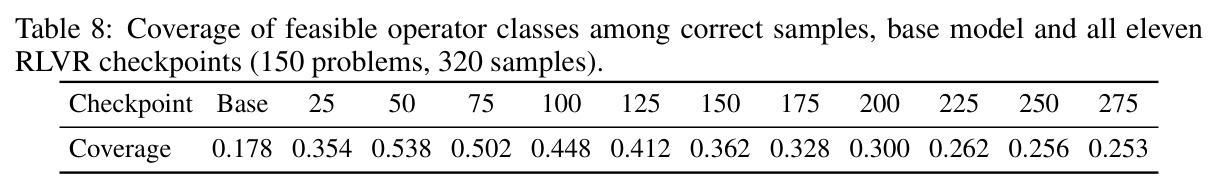
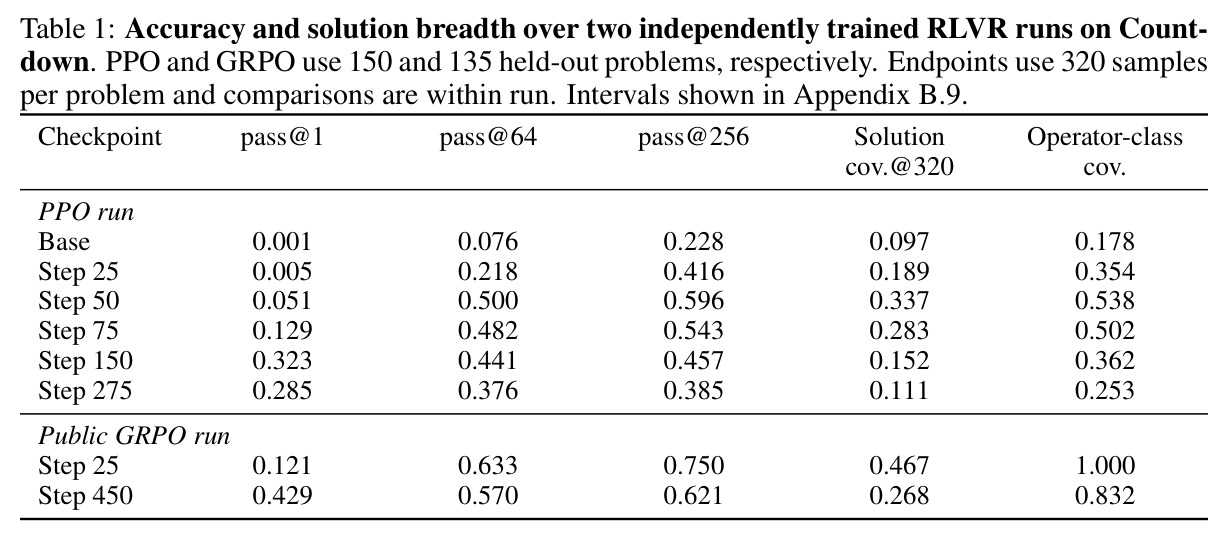
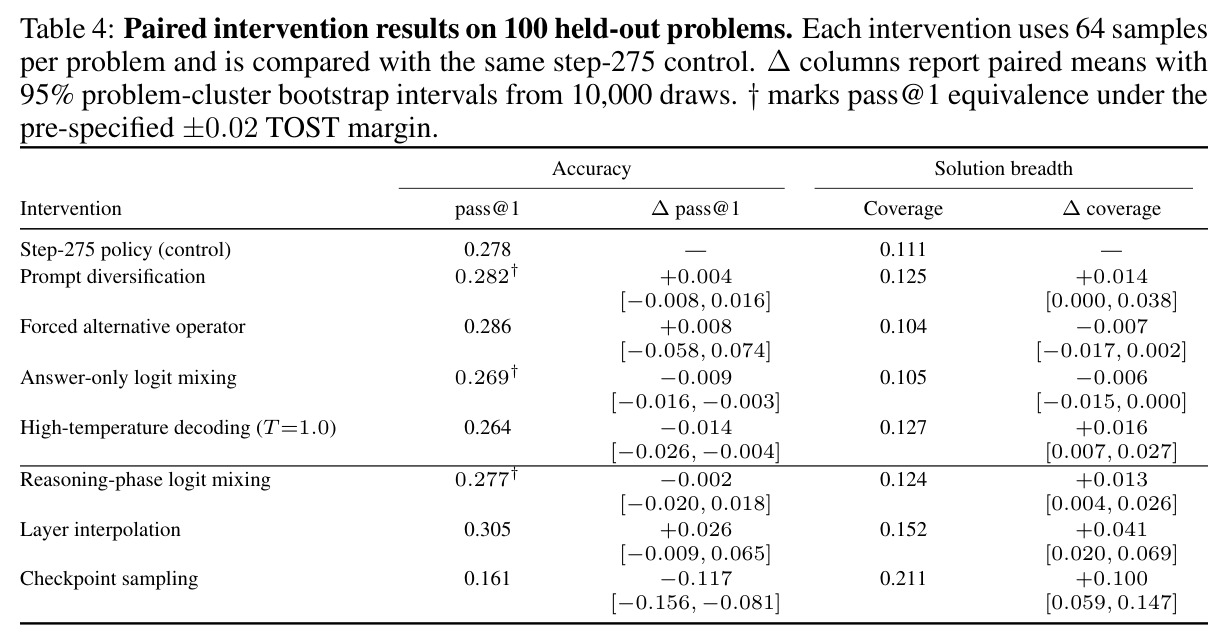
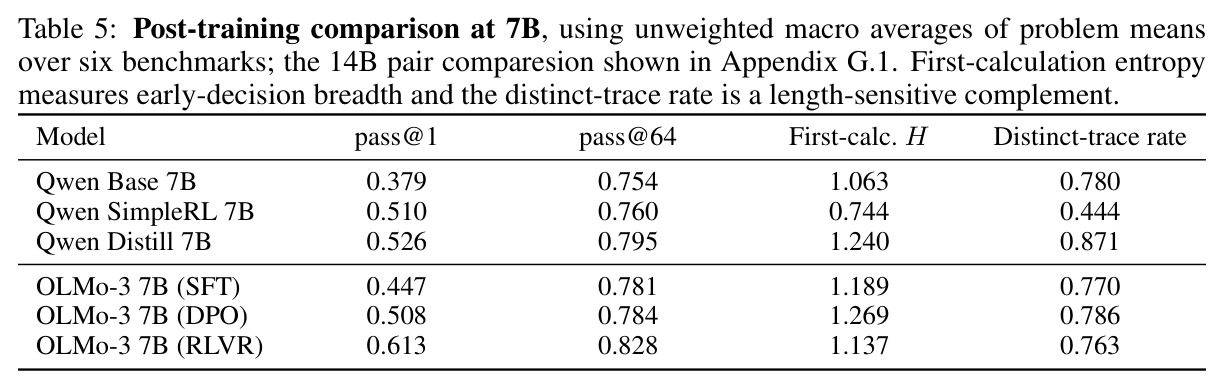
第一,精度—广度权衡跨算法成立。PPO:pass@1 从 step 50 的 0.051 涨到 step 150 的 0.323(相对 base 的 0.001 超 50 倍),而 320 样本解覆盖率从 0.337 崩到 0.111(−67%);GRPO:pass@1 从 0.121 涨到 0.429,覆盖率 0.467→0.268(−43%),合法解中的入口族覆盖从 0.932 降到 0.571,入口香农熵从 1.585 掉到 0.760 nats。第二,幸存者对照排除'遗忘难题'解释:在 58 道两个检查点都能解出的题上,覆盖率仍从 0.564 跌到 0.286;step-50 发现的合法解法叶只有 31% 在 step-275 再现(题目保留率 64%);33 道'丢失'的题在 2048 采样/题的预算下仍无一恢复,说明 RLVR 只是把概率质量压缩到旧路径的子集上。第三,定位证据:1530 对 teacher-forced 续写显示入口段 per-token NLL 上升 4.50 nats [4.37, 4.62],执行段仅 0.28 [0.26, 0.30],16 倍差距;GRPO 上为 8.08 vs 0.71(11 倍);最大单 token 下降恰落在选定入口族的操作数 token(相对位置 −3 处 Δ+7.51)。第四,因果恢复:只给'操作数+算子'的最小入口前缀就把指定族完成率从 0.018 拉到 0.212(一个数量级以上;GRPO 为 0.104→0.188),与给出完整首算式(0.276)效率相当;嫁接进模型自己的失败轨迹仍达 0.176(超出 0.044 的路径枚举参考 +0.121);28 个灭绝族 clamp 后完成率 0.529,甚至高于 step-50 时的 0.475;配对数据显示入口熵下降 0.144 的同时,同一批前缀上的条件执行上升 +0.107 [0.073, 0.143]。第五,干预只有入口靶向有效:20–28 层权重插值把覆盖从 0.111 提到 0.152(相对 +37%)且 pass@1 反升至 0.305;推理段 logit 混合 +0.013;而提示多样化仅 +0.014(不显著)、强制算子 −0.007、仅答案段混合 −0.006、高温 T=1.0 虽 +0.016 但 pass@1 掉 0.014;checkpoint 采样 +0.100 但 pass@1 −0.117;入口预算分配 +0.077 覆盖、+0.430 个族,且在未坍缩的 step 50 上完全无效——印证了'只有坍缩发生后入口干预才有独特价值'的理论预测。第六,跨规模泛化:7B 上 first-calculation 熵 1.063→0.744(−30%),14B 上 1.207→0.711(−41%),而 pass@64 几乎不动(0.754→0.760;0.774→0.774);六个基准的同轨迹 DiD 全部为正(0.193–0.337 nats/token,置信区间均不含零),并经 19,941 条轨迹的盲测语义重切分确认非解析器伪影;256 采样深度下 SimpleRL 的 distinct traces 仅 22.0/25.2,对比 Base 的 148.5/158.9(GSM8K/MATH500)。第七,管线对照:OLMo-3 的 SFT→DPO→RLVR 阶梯把 pass@1 提到 0.613 同时熵保持 1.137(SFT 起点 1.189);R1-Distill-Qwen-7B 精度与广度双高(pass@1 0.526、熵 1.240);多解 SFT 在 pass@1=0.333 时覆盖 0.709,是同精度 GRPO 检查点(0.268@0.429)的 2.6 倍,且 k=1→8 呈单调剂量响应 0.471→0.766;但从此 SFT 继续训练 500 步 GRPO,rollout 熵又跌到 0.085 nats——说明坍缩是 on-policy 强化动力学的产物,且会卷土重来。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Countdown(PPO 自训管线,150 题) | pass@1 / 解覆盖率@320 | step 150: pass@1 0.323;step 275: 覆盖率 0.111 | step 50: pass@1 0.051、覆盖率 0.337(base pass@1 0.001) | pass@1 提升 50 倍以上,但覆盖率下降 67% |
| Countdown(公开 GRPO 管线,135 题) | pass@1 / 解覆盖率@320 | step 450: pass@1 0.429、覆盖率 0.268、入口熵 0.760 nats | step 25: pass@1 0.121、覆盖率 0.467、入口熵 1.585 nats | pass@1 增至 3.5 倍,覆盖率下降 43% |
| 六大数学基准 7B(Qwen Base vs SimpleRL) | pass@1 / first-calculation 熵 | SimpleRL 7B: pass@1 0.510、熵 0.744 nats | Base 7B: pass@1 0.379、熵 1.063 nats | pass@1 +13%,熵 −30%(pass@64 仅 0.754→0.760) |
| 六大数学基准 14B(Qwen Base vs SimpleRL) | pass@1 / first-calculation 熵 | SimpleRL 14B: pass@1 0.546、熵 0.711 nats | Base 14B: pass@1 0.377、熵 1.207 nats | pass@1 +17%,熵 −41%(pass@64 持平 0.774) |
| Countdown 恢复干预(100 题,step-275 策略) | 解覆盖率 / pass@1 | 20–28 层权重插值:覆盖率 0.152、pass@1 0.305 | step-275 原策略:覆盖率 0.111、pass@1 0.278 | 覆盖率相对 +37%,pass@1 同时 +0.026(不损失精度) |
| Countdown 训练范式对照(135 题) | 解覆盖率@320 / pass@1 | 多解 SFT(k=4):覆盖率 0.709、pass@1 0.333 | GRPO step 450:覆盖率 0.268、pass@1 0.429 | 同等精度档位下覆盖率提升至 2.6 倍 |
局限与改进
作者承认或文中可见的局限:Countdown 的入口之后只剩 6–10 个 token 的下游计算,'入口主导'部分是任务结构的产物;作者在 534 道四数字题上诚实展示了长视野下执行成为复合的第二瓶颈(深度×晚检查点交互 $\gamma = -0.0152$ [−0.0224, −0.0080])。数学基准上没有完全枚举,只能靠 first-calculation 熵、distinct-trace 率和 DiD 等结构代理,外部效度依赖这些代理的有效性。幸存者分析中 $S_{loss}$ 集(33 题仅在 step 50 可解)在 step-275 的答案解析率为 0,格式失败与访问失败混在一起,只能由 $S_{both}$ 承载组内比较。可恢复性是分级的而非二元的:训练分布更深的尾部(800 题池的 276 个零访问 cell)平均 clamp 完成率只有 0.087,远低于曾经高访问的族(0.529)。我自己的观察:其一,层插值等恢复实验只在 3B Countdown 上做了完整配对验证,7B/14B 上没有复制;其二,PPO 训练只有单 seed(seed 1),结论对种子扰动的稳健性未知;其三,最好的无损干预也只把覆盖恢复到 0.152,离 step-50 的 0.337 还差很远,'恢复'更多是原理验证而非实用方案;其四,pass@64 在标准基准上几乎不降(0.754→0.760),说明该现象对实际 self-consistency 的伤害目前主要体现在更难的任务与更大采样深度上,论文没有给出'多样性损失→最终测试时扩展收益损失'的直接量化,价值论证略偏间接。
独立分析的弱点
第一,外部效度绑定在 Countdown 上:可枚举性是整套方法的根基,但数学推理、代码生成等真实场景不可枚举,只能退回代理指标,'入口'在开放域的对应物(首次方法选择?首次公式设定?)界定较主观。改进方向:构造其他可枚举域(24 点变体、正则表达式构造、有限状态机合成)检验入口现象的普适性。第二,恢复手段的部署门槛高:层插值与 checkpoint 采样都需要保存并访问完整训练历史,入口预算分配需要外部求解器枚举可行入口,两者在开放域都不可得。改进:用模型自生成样本估计入口分布,或训练轻量'入口提议器'替代求解器。第三,单 seed 与单模型家族:PPO 只有 seed 1,主实验集中在 Qwen2.5 家族,缺少跨家族(Llama、OLMo 的 Countdown RL)验证。第四,剂量—响应实验的 SFT 对照在数据构造上(入口多样性轮转采样)与标准 RL 不同,混杂了数据覆盖率因素,'on-policy vs off-policy'的因果归因不够干净。第五,论文没有量化在标准基准(如 AIME24 这类难题)上入口坍缩对真实测试时扩展(best-of-N + 验证器)收益的净损失,而这是社区最关心的实际代价。第六,276 个深层零访问 cell 仅 0.087 的完成率提示'灭绝'有不可逆成分,文中未追踪可恢复性随训练步数的衰减曲线。
未来方向
作者指出的方向:有效的测试时扩展与训练正则必须对准初始决策边界——'可扩展的推理不仅要能走完选定的路,还要让通往替代解法的门保持敞开'。可以延伸的具体方向:其一,训练时入口熵正则——对 first-calculation token 施加熵 bonus,或利用文中式 (4) 的梯度结构对低访问可行族设计优先采样/探索奖励,从源头上阻止 $q_b$ 的雪崩式衰减;其二,搞清 SFT–DPO–RLVR 阶梯为何能保熵(是数据分布覆盖还是更新几何差异),设计最小代价的对齐课程,例如'多解 SFT 预热 + 熵受控 RLVR';其三,入口分配策略的开放域版本:用自一致性簇中心或轻量分类器近似入口族,替代不可得的求解器;其四,把访问—执行分解搬到 agent 与工具调用轨迹上(第一次 API/工具选择即'入口');其五,理论上把一阶代理推广为多步坍缩动力学,预测坍缩沿深度传播的时序,并与熵正则的放置位置联动;其六,系统研究灭绝分支可恢复性的衰减规律(0.529 vs 0.087 的分级现象),确定'保种'干预的最佳时机窗口。
复现评估
复现条件良好。代码已开源(GitHub: ershiyidian/early-branch-locking);GRPO 部分直接用公开的 Qwen-2.5-3B-R1-countdown 检查点序列,无需自训;PPO 训练在双 RTX 4090(消费级硬件)上即可完成,配置完整给出(TinyZero/VERL 栈、AdamW actor lr $10^{-6}$、160 prompts/迭代、每 25 步存档);Countdown 数据来自公开 50k 集合,语义键过滤规则明确;符号求解器与独立枚举器需要自行实现但算法直白(回溯枚举 + 交换/结合规范化)。评测协议细节充分:温度、top-p、采样数(Countdown 320/题、数学基准 64/题、token 上限)、bootstrap 次数(2000/1000/10000)与随机种子(seed 0、1729 等)都有交代,甚至包括预注册的 SFT checkpoint 选择规则。SFT 对照用 LoRA(rank 32、α=64、lr $10^{-4}$、2 epochs)双卡可训。主要成本在评测算力:多 checkpoint × 320 rollouts × 150 题的 Countdown 评测,以及 7B/14B 模型 16k 上下文 × 64 采样的基准评测,单机数天量级。总体复现难度:中等偏低。论文诚实度高——置信区间齐全、阴性结果(提示多样化无效等)如实报告、对照组设计完整。
论文图表