超越视觉相似性:面向知识型视觉问答的实体对齐检索 Beyond Visual Similarity: Entity-Aligned Retrieval for Knowledge-Based Visual Question Answering
首个MLLM嵌入检索器KBMR:用实体语义对齐替代CLIP视觉相似性,检索R@1最高提升14.7%
前置知识
KB-VQA(知识型视觉问答)
KB-VQA 要求模型回答涉及外部知识的问题,如“这座酒店目前归谁所有”“这种蔬菜常用于哪个菜系”。答案无法仅凭图像推断,必须先从维基百科等知识库检索相关证据,再基于证据生成答案。这类问题通常涉及长尾、细粒度实体,是检验多模态模型世界知识的核心基准。
本文的全部动机与实验都围绕 KB-VQA 展开,理解“检索是流水线第一环、候选池质量决定答案上限”这一设定,是读懂论文改进动机的前提。
CLIP 式双塔检索
CLIP 用图像编码器和文本编码器分别把两种模态映射到共享嵌入空间,训练时用对比学习拉近配对样本。检索时将查询与库内条目分别独立编码(双塔结构),再用余弦相似度做近邻搜索。优点是可离线建库、检索极快,缺点是相似度只反映表层视觉/语义相关性。
现有 KB-VQA 系统的第一阶段检索几乎全部采用 CLIP 范式,本文正是针对“CLIP 相似度≠实体语义相关性”这一根本缺陷提出替代方案,必须理解其工作机制才能领会论文的批判点。
RAG(检索增强生成)
检索增强生成先从外部知识源检索与查询相关的内容,再把这些证据拼入大模型的上下文,让模型基于证据作答,从而弥补参数化知识过时或缺失的问题。在多模态场景下,检索对象可以是与查询图像指向同一实体的百科条目及配图。
KBMR 定位为 KB-VQA RAG 流水线的第一阶段检索器,论文通过“只换检索器、其余组件不动”来隔离其贡献,理解 RAG 的分阶段结构才能正确解读 Table 1 的即插即用实验。
困难负样本挖掘(Hard Negative Mining)
对比学习中,与正例随机配对的负样本往往太容易区分,训练信号微弱。困难负样本指在当前表示空间中与查询高度相似、容易混淆的负例,训练时加入它们能迫使模型学到更细粒度的判别边界。挖掘方式通常是用现有编码器检索 Top-k 相似但非配对的样本。
KBMR 的关键创新之一就是“语义化”的困难负样本构造:不只按视觉相似度挑负例,还用 MLLM 判别器的连续权重来过滤伪负例并分层采样,这是理解 Section 3.4 的基础。
KL 散度与对称 KL 蒸馏
KL 散度 $D_{KL}(p\|q)$ 衡量两个分布的差异,不对称性导致“正向”与“反向”KL 的优化行为不同:正向 KL 倾向模式覆盖,反向 KL 倾向模式寻求。把两者取平均构成对称 KL,可以同时推动概率质量走向正确目标并防止分布过锐、训练不稳,常用于知识蒸馏中对齐教师与学生分布。
KBMR 的连续语义蒸馏损失 $L_{CSD}$ 就是对称 KL:让学生检索器的相似度分布去拟合判别器诱导的软先验分布,读懂该损失需要掌握 KL 散度的方向性含义。
LoRA 与 DeepSpeed ZeRO
LoRA 冻结预训练权重、只训练注入各层的低秩矩阵(本文 rank=16),使 7B 级 MLLM 的微调显存和存储大幅下降。DeepSpeed ZeRO 把优化器状态、梯度和参数分片到多卡,本文用 ZeRO stage-2 切分优化器状态与梯度。两者结合让 8 张 A100 就能微调 7B 多模态模型。
评估复现成本时需要知道训练配置:论文用 LoRA+ZeRO-2 在 8×A100(80GB) 上训练 5000 步,这是判断“我能不能复现”的直接依据。
研究动机
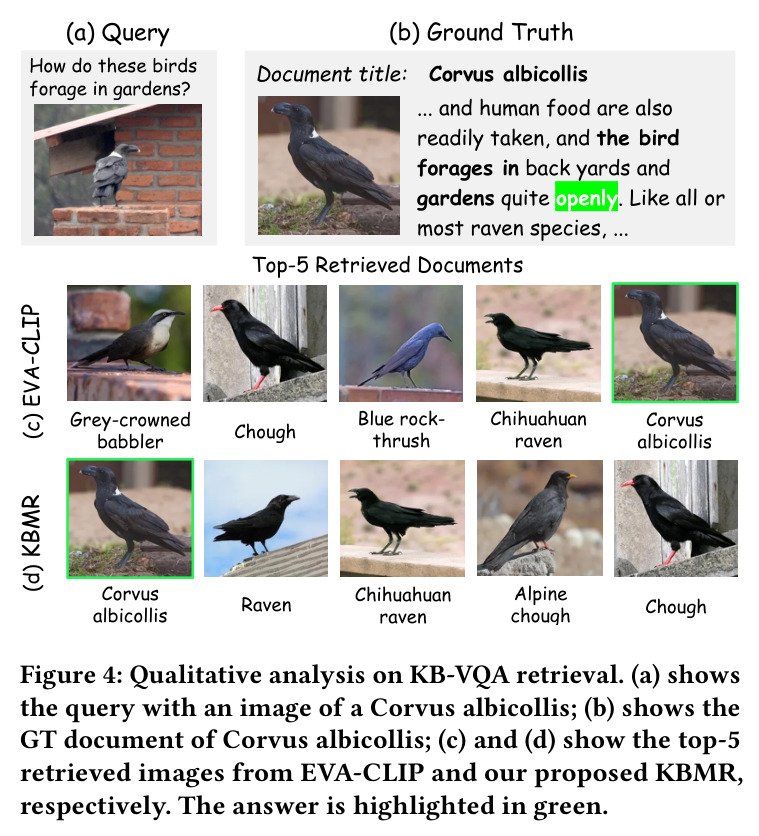
知识型视觉问答(KB-VQA)要求模型回答涉及长尾实体的问题,例如“这家酒店目前归谁所有”或“这种蔬菜属于哪个菜系”,答案无法仅凭图像推断,必须从维基百科规模的外部知识库检索证据。现有系统(如 EchoSight 等)几乎清一色采用 CLIP 式双塔编码器做第一阶段检索:把查询图像和知识库候选图像分别编码,按向量相似度取 Top-k。问题在于 CLIP 度量的是表层视觉相似,而非实体身份一致性。论文指出,维基百科语料中同一实体(如同一座酒店)会因拍摄视角、年代、风格不同呈现巨大外观差异,而不同实体(两家外观相近的酒店、多种羽色相近的鸟)反而高度相似,形成“视角不一致”与“实体混淆”两类失败模式。数据上,E-VQA 基准上最强 CLIP 检索器 EVA-CLIP-8B 的 R@1 仅为 13.3;Figure 4 的白颈渡鸦(Corvus albicollis)案例中,EVA-CLIP 返回的多是灰冠鸦、红嘴山鸦等视觉相近但语义不符的鸟种,正确文档仅排第 5 位,下游模型因此引用错误证据、给出错误答案。
本文的目标是本文的目标是打破 KB-VQA 流水线中“第一阶段检索受制于 CLIP 表示空间”这一根本瓶颈,训练首个以多模态大语言模型(MLLM)为基础的嵌入检索器 KBMR,使检索相似度与“查询图像和候选证据是否指向同一实体”这一实体级语义相关性对齐。具体目标有三:其一,让检索器在大视角与外观变化下仍能识别同一实体,同时在视觉高度相似的干扰实体之间保持可分性;其二,解决维基百科规模检索中监督信号噪声大的难题——不能依赖僵硬的 0/1 二元标签,而要利用困难负样本邻域内细粒度的语义结构;其三,训练出的检索器必须即插即用,在不改动 EchoSight、ReflectiVA、MMKB-RAG、OMGM 等下游系统其余组件的前提下直接替换原检索器,抬升端到端问答精度。
与已有工作不同的是,此前对检索质量的改进几乎都发生在“检索之后”:Wiki-LLaVA 用分层检索下钻到段落,ReflectiVA 用自反思 token 判断检索必要性并过滤证据,Wiki-PRF 通过工具驱动的查询改写与聚合提升证据质量,OMGM 编排多粒度多模态信息做重排——但候选池仍由 CLIP 式检索器生成,整条流水线的上限被 CLIP 范式锁死。另一条相关路线是通用多模态嵌入工作(E5-V、VLM2Vec、GME、MM-Ret),它们用 MLLM 产出嵌入,但目标是桥接图文模态鸿沟、返回“大致相关”的内容,并未针对“精确锁定查询实体”这一 KB-VQA 特有需求训练,论文实验显示其零样本嵌入(R@1 仅 6.1-7.4)甚至常弱于强 CLIP 检索器。KBMR 的独特切入在于:(1) 在检索器层面替换,而非在检索器之上堆叠后处理模块;(2) 引入 MLLM 语义判别器对每个查询-候选对给出连续实体一致性分,把“判断是否同一实体”这种需要世界知识的能力蒸馏进检索器嵌入空间;(3) 用分布级软监督替代刚性二值对比学习。
核心方法
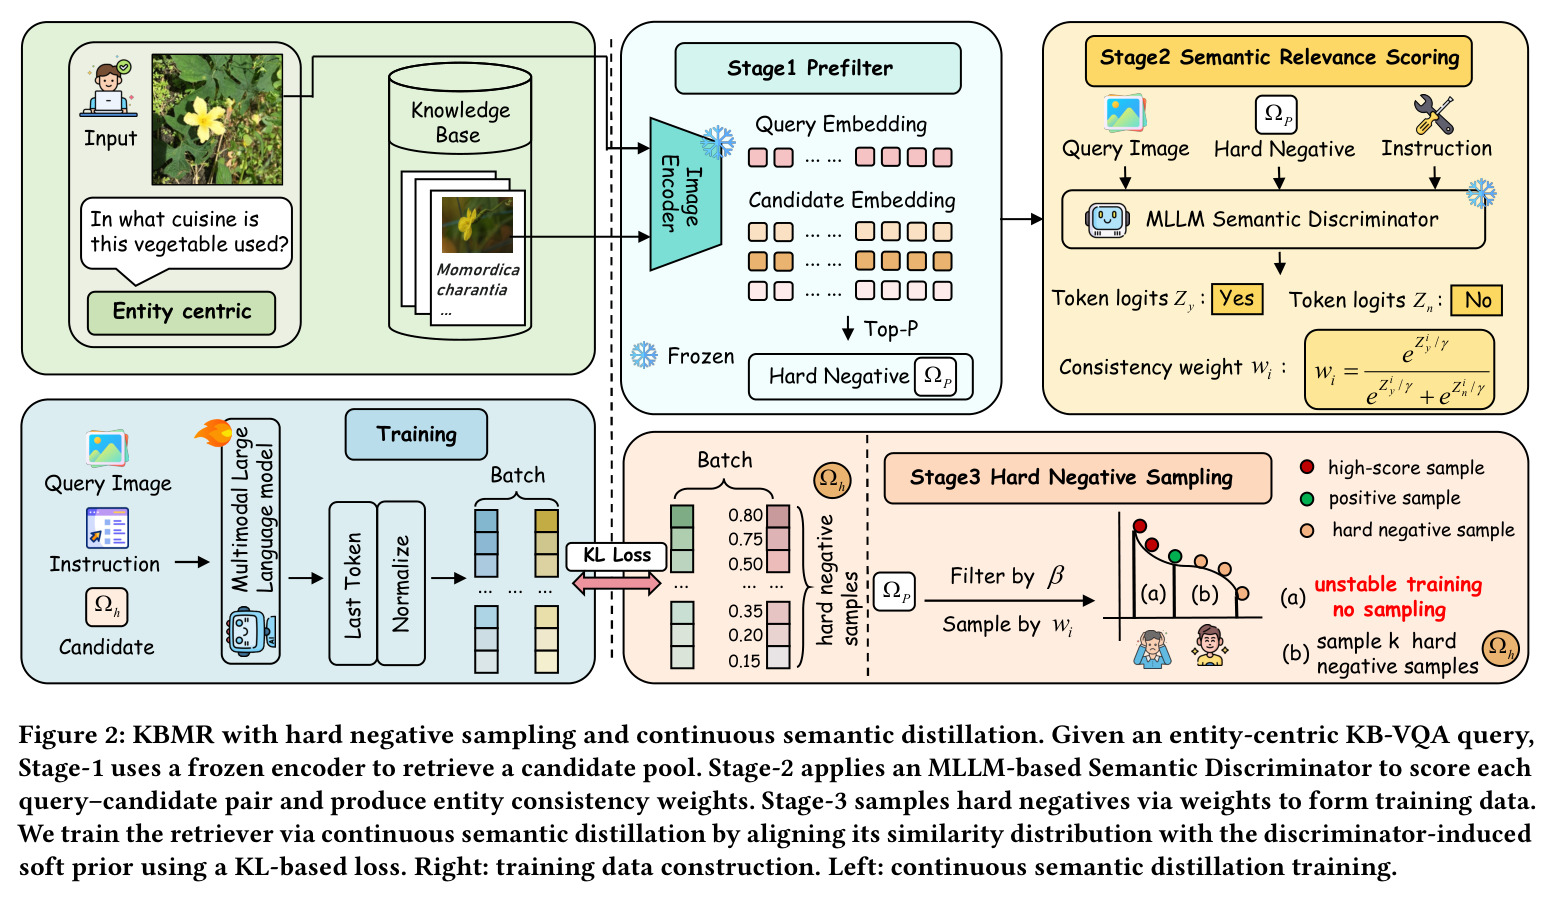
直觉上,KBMR 要回答的是“两张图是否指向同一个实体”,而不是“两张图看起来像不像”。为此它把嵌入空间从 CLIP 的像素级匹配空间换成 MLLM 的自回归语义空间,并引入一个“语义判别器”当老师,把实体级判断能力蒸馏给检索器。技术路线是三个阶段加一个训练目标:Stage-1(预筛)用冻结的 EVA-CLIP-8B 对查询图像与全库候选图像编码,按余弦相似度取 Top-50 构成潜在困难负样本池,完成快速粗筛;Stage-2(语义相关性打分)用 MLLM 语义判别器对每个查询-候选对判断是否同一实体,从 Yes/No token 的 logits 经校准缩放得到连续实体一致性权重;Stage-3(困难负样本采样)依据权重先过滤掉语义上仍然高度相关的“伪负例”,再按权重分层采样出 8 个困难负样本构成训练数据;最后用连续语义蒸馏目标训练可训练的 MLLM 检索器,使其在候选集上的相似度分布与判别器诱导的软先验分布对齐(对称 KL 损失)。推理时不引入任何额外开销,仍是一次快速的向量相似度检索。
核心创新有两点。第一,用 MLLM 自回归语义嵌入替代 CLIP 双塔表示:给定指令 “ Summary above image in one word:\n”,MLLM 把图像内容与语言指令统一进同一自回归语义空间,取最后一个 token 的隐层状态作为检索嵌入,这种表示模态鸿沟小、携带概念级语义,能在大视角外观变化下保持实体身份,而 CLIP 只能捕获表层视觉相似。第二,也是最本质的区别——把训练目标从“刚性一对一对比学习”换成“分布级连续语义蒸馏”:标准对比学习把目标候选当作唯一正例、其余候选一律当作负例(one-hot 标签 $W_c=\{1,0,\ldots,0\}$),但 KB-VQA 的困难负样本并非同等无关——有的视觉相似却语义错配,有的仍与查询实体共享部分语义。KBMR 用 MLLM 判别器对 Yes/No 两个 token 的 logits 做校准的 logit 缩放,得到连续权重 $w_i=\sigma((z_i^y-z_i^n)/\gamma)$,再 softmax 归一化成软语义先验 $s_q$,让检索器的相似度后验 $p_q$ 去拟合它。这样高一致性候选获得更大先验质量、语义错配者被抑制,模型同时学到对目标候选的判别力与邻域内的语义结构,提供比 0/1 标签更稳定的监督信号。
方法步骤详情
完整流程分五步。第一步(嵌入抽取):可训练的 MLLM 检索器(Qwen2-VL-7B 或 LLaVA-OneVision-7B)以 “ Summary above image in one word:\n” 为指令编码图像,取最后一个 token 隐状态归一化后作为嵌入。第二步(粗筛):冻结的 EVA-CLIP-8B 编码查询与全库候选,排除正例后按余弦相似度取 Top-50 构成潜在困难负样本池 $\Omega_p=\mathrm{Rank}_{50}(\cos(e_q,e_c))$。第三步(判别器打分):语义判别器(Qwen2.5-VL-7B)按指令“判断候选与查询是否同一实体,是则回答 Yes,否则回答 No”逐一打分,从 logits 计算权重 $w_i=\exp(z_i^y/\gamma)/(\exp(z_i^y/\gamma)+\exp(z_i^n/\gamma))$,其中 $\gamma$ 控制权重平滑度。第四步(困难负样本采样):以查询-正例权重定义阈值 $\alpha=w_{q,c_t}-\beta$,剔除权重超过 $\alpha$ 的候选以避免把语义仍然相关的样本误当负例;剩余候选按权重分成四个难度层,每层随机抽 2 个凑成 8 个困难负样本,不足 8 个则复制补齐,无合格候选则丢弃该样本。第五步(连续语义蒸馏训练):检索器在候选集上产生后验 $p_q(j)=\mathrm{softmax}(\mathrm{sim}(e_q,e_j)/\tau)$,判别器权重经 softmax 得先验 $s_q(j)$,最小化对称 KL $L_{CSD}=\mathbb{E}_q[\frac{1}{2}(D_{KL}(p_q\|s_q)+D_{KL}(s_q\|p_q))]$。训练采用 LoRA rank 16 + DeepSpeed ZeRO-2,8×A100(80GB),图像缩放至 336×336,累积 batch 1024,600k 样本训练 5000 步,$k=8$,$\gamma=1.1$。
技术新颖性
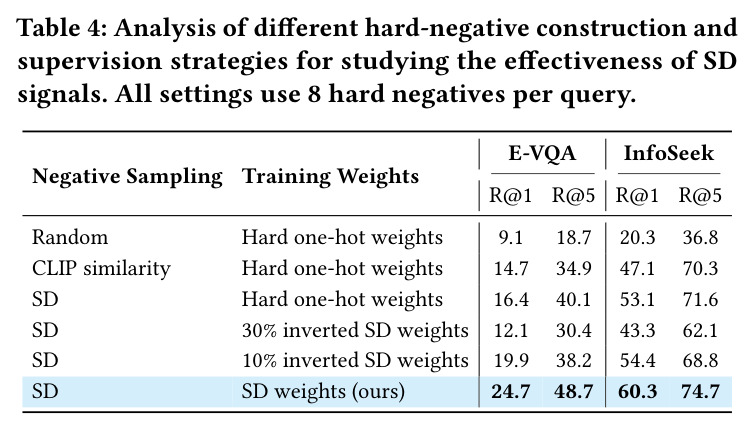
技术新颖性体现在四个层面。(1) 任务层面首创:这是第一个把 MLLM 本身用作 KB-VQA 检索器的工作,此前 MLLM 只出现在检索后处理或答案生成环节。(2) 监督信号转变:从离散 one-hot 对比标签转为判别器诱导的连续软分布,相当于把“同一实体判断”这种需要世界知识的能力作为教师信号蒸馏进检索器——消融实验显示,仅把 SD 软权重换成 one-hot,E-VQA R@1 就从 24.7 跌到 16.4,而在 SD 采样下把权重反转 10%/30% 更是掉到 19.9/12.1,直接证明增益来自软监督携带的语义结构而非仅仅更好的负样本。(3) 负样本构造语义化:负样本不再按视觉相似度盲目挑选,而是先用权重阈值 $\alpha$ 过滤“伪负例”,再按连续权重分四个难度层采样,兼顾信息量与多样性。(4) 目标函数设计:对称 KL 中正向项把概率质量推向语义正确候选,反向项防止分布过锐、优化不稳,使蒸馏在判别性与平滑性间取得平衡;整个方法与下游流水线解耦,只换检索器即可让多种异构系统受益。
实验结果
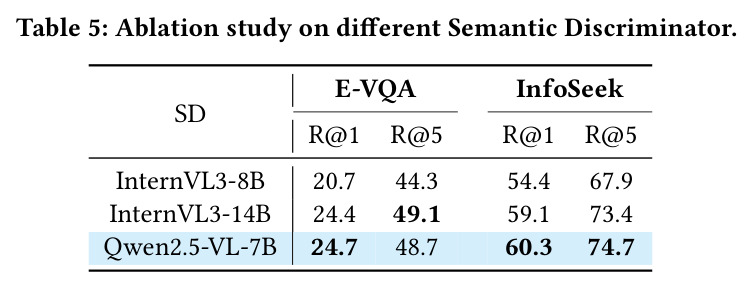
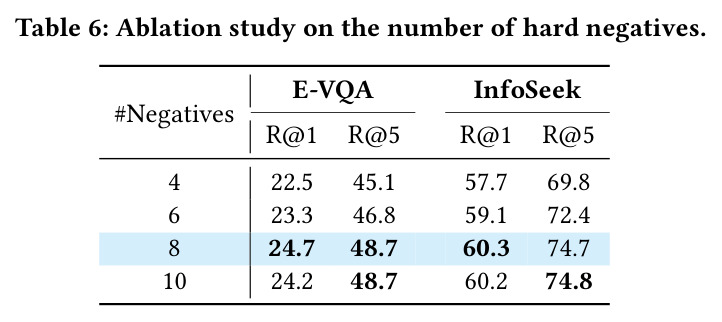
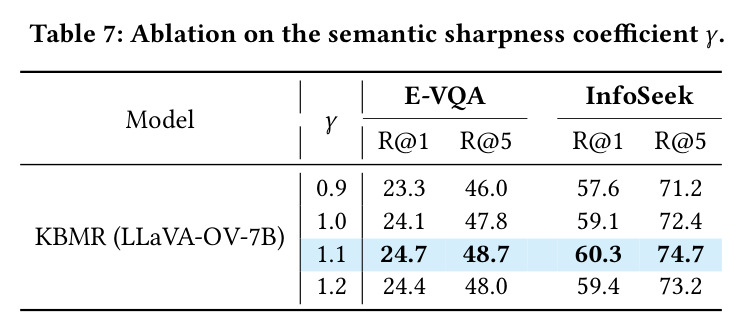
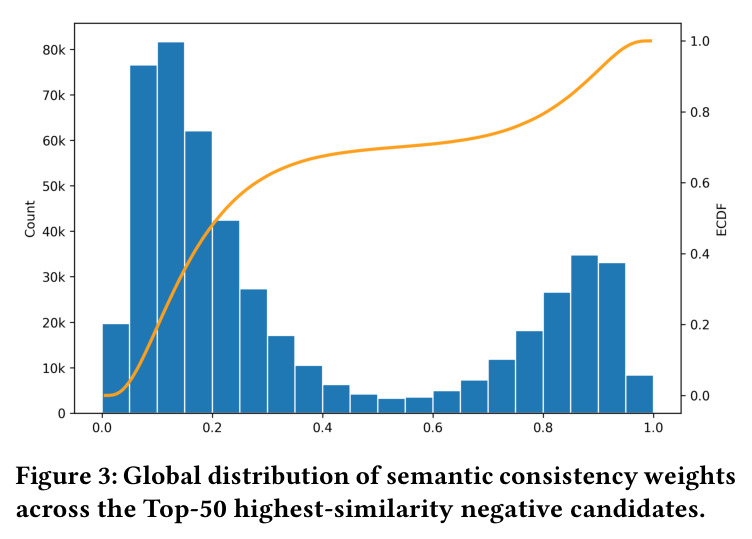
检索方面(Table 2):KBMR(LLaVA-OV-7B) 在 E-VQA 上 R@1/R@5/R@10/R@20 = 24.7/48.7/52.4/55.0,比最强 CLIP 检索器 EVA-CLIP-8B(R@1 13.3)高 11.4,比最强 MLLM 检索器基线 MM-Ret(11.9)高 12.8;在 InfoSeek 上为 60.3/74.7/79.6/84.4,比 EVA-CLIP-8B(45.6)高 14.7(即论文宣称的最大 +14.7% R@1),比 MM-Ret(41.3)高 19.0。值得注意的是,零样本 MLLM 嵌入很弱(Qwen2-VL-7B 仅 6.1、LLaVA-OV 7.4),说明必须经过实体对齐训练才能激活 MLLM 表示。端到端问答(Table 1):只替换检索器、其余不动,五个系统全线提升——EchoSight† 单跳 19.1→26.7(+7.6),EchoSight‡(带重排)42.0→51.3(+9.3),ReflectiVA 28.0→34.7(+6.7),MMKB-RAG 39.7→47.3(+7.6),OMGM 49.7→55.0(+5.3);InfoSeek 上 MMKB-RAG All 36.4→45.7(+9.3),最终刷新 SOTA:E-VQA 54.7、InfoSeek 50.8。OK-VQA(Table 3):检索伪召回 R@5 从 OMGM 的 73.4 提升到 80.4,VQA 分数 66.6→79.3(+12.7)。消融(Table 4):随机负样本+one-hot 仅 9.1 R@1,SD 采样+SD 软权重达 24.7;权重反转 10%/30% 后掉到 19.9/12.1;在 1 万正对+1 万负对的成对评测中,SD 的 AUC 达 0.91,显著高于线性缩放后的 CLIP 相似度(0.79)。判别器消融(Table 5):Qwen2.5-VL-7B(24.7/60.3)优于 InternVL3-14B(24.4/59.1)和 InternVL3-8B(20.7/54.4)。负样本数(Table 6)从 4 增到 8 持续提升(22.5→24.7)、到 10 饱和;$\gamma$(Table 7)在 1.1 最优。Figure 3 显示 Top-50 高视觉相似候选中大量权重偏低且分布连续,验证 MLLM 判别在混淆邻域内仍有效;Figure 4 定性案例中 KBMR 把正确文档从第 5 位提到第 1 位。
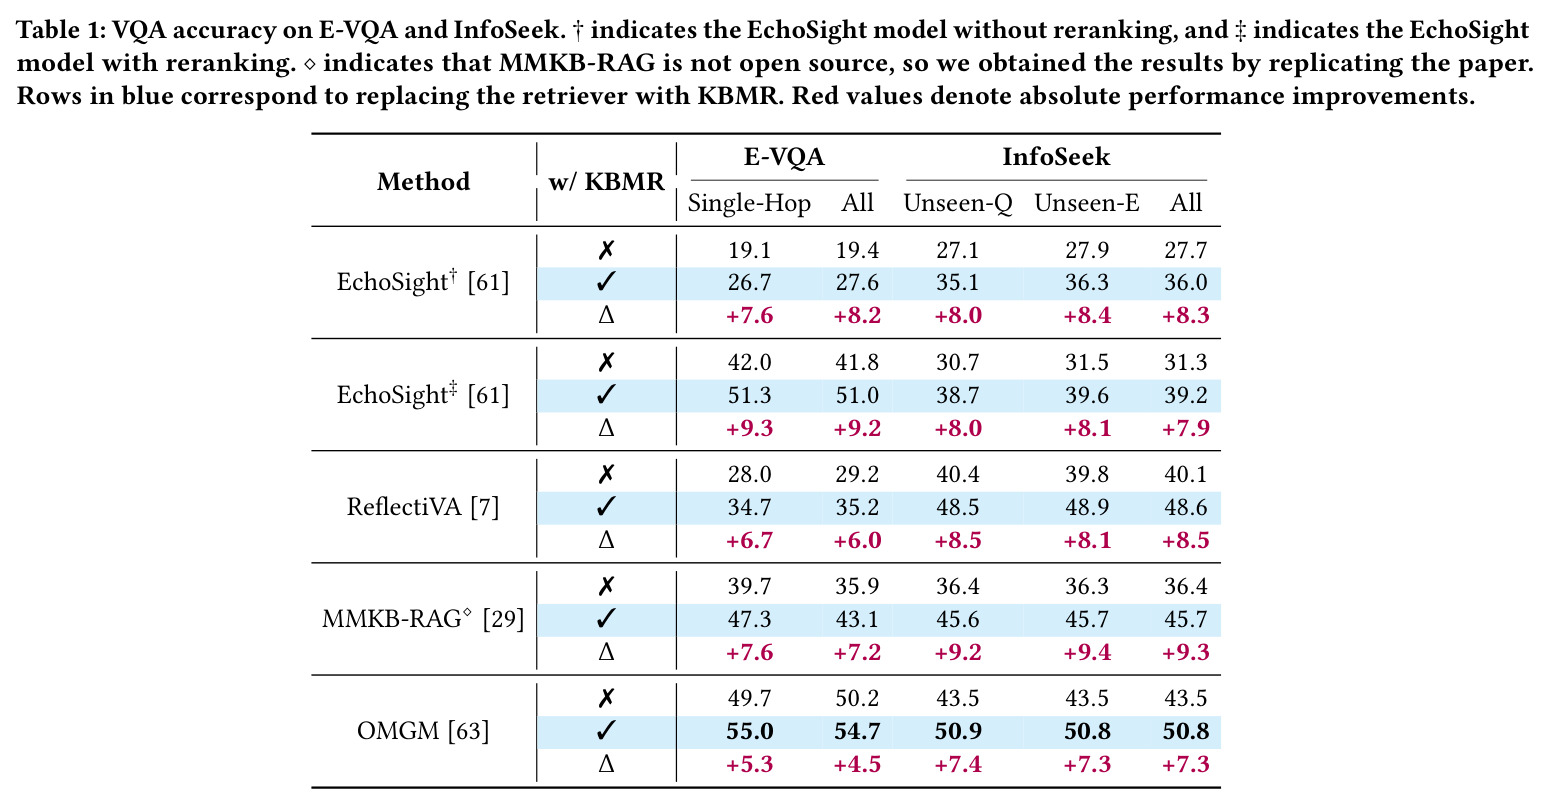
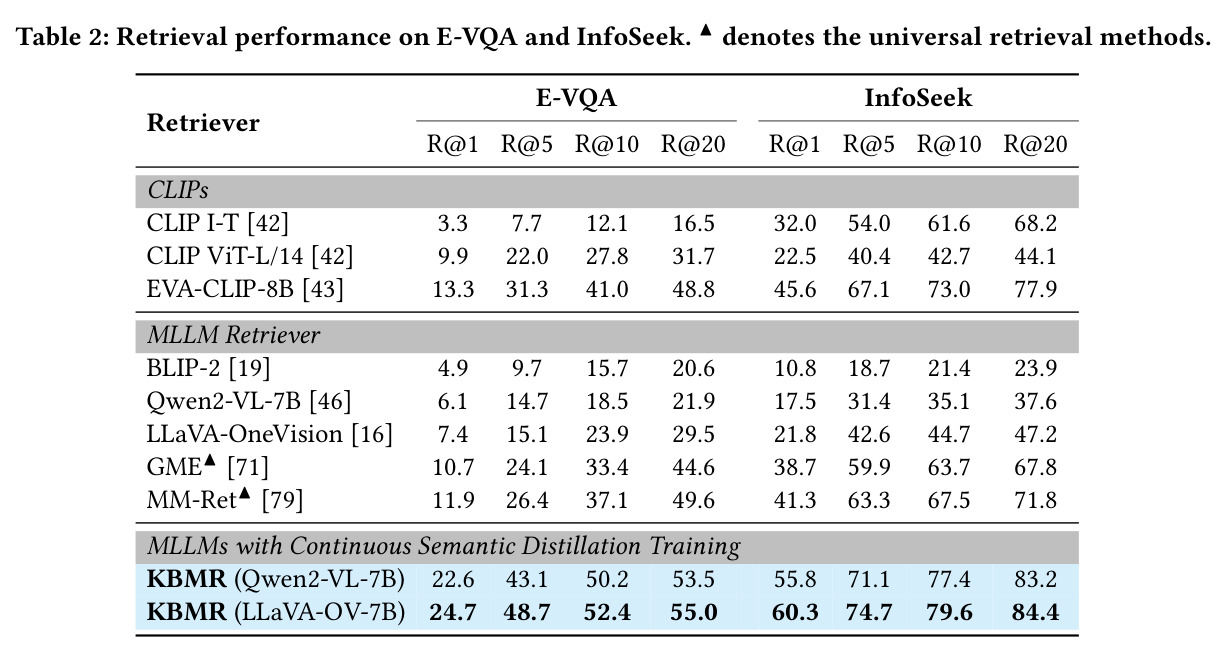
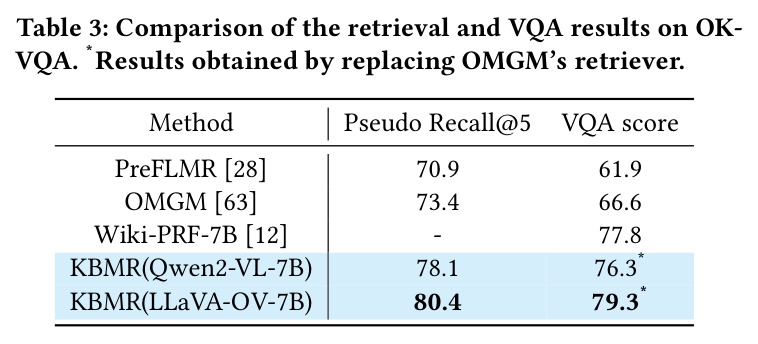
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| InfoSeek 一阶段检索 | R@1 | 60.3(KBMR, LLaVA-OV-7B) | 45.6(EVA-CLIP-8B) | +14.7 |
| E-VQA 一阶段检索 | R@1 | 24.7(KBMR, LLaVA-OV-7B) | 13.3(EVA-CLIP-8B);11.9(MM-Ret) | +11.4 / +12.8 |
| OK-VQA 端到端问答 | VQA score | 79.3(OMGM 换用 KBMR 检索) | 66.6(OMGM 原检索) | +12.7 |
| InfoSeek 端到端问答(All) | VQA accuracy | 50.8(OMGM+KBMR) | 43.5(OMGM) | +7.3 |
| E-VQA 端到端问答 | BEM | 55.0(OMGM+KBMR) | 49.7(OMGM) | +5.3 |
| E-VQA 端到端问答(带重排) | BEM | 51.3(EchoSight‡+KBMR) | 42.0(EchoSight‡) | +9.3 |
局限与改进
作者承认或可从文中直接提炼的限制包括:判别器并非完美——Figure 3 显示高视觉相似候选中仍存在权重较高的难例,说明 MLLM 也判别不了部分同貌实体;负样本数超过 8 后收益饱和(Table 6 中 10 个负样本不再提升);$\gamma$ 过小会使权重过锐退化为二值标签、过大则过度平滑削弱对比(Table 7),超参需要调节;MMKB-RAG 闭源,Table 1 中其基线结果系作者按论文复现(⋄ 标注),OK-VQA 上的 VQA 分数也是把 KBMR 检索结果插入 OMGM 流水线测得(* 标注),并非全开源复现。我自己的观察还有五点:其一,训练数据构建依赖 EVA-CLIP-8B 粗筛加 Qwen2.5-VL-7B 逐对打分,为每条查询生成 50 个候选的监督信号,成本远高于普通对比学习,扩展到更大知识库时代价线性增长;其二,检索嵌入只用图像(指令不含问题文本),同一图像在不同问题下无法差异化检索;其三,判别器对长尾实体的世界知识有限,其打分的系统性偏差会被蒸馏固化进检索器;其四,评测知识库为 100K 维基条目,真正的全量维基百科(数百万条)下的索引与召回未验证;其五,仅在三个英文基准上评测,跨语言与跨域泛化未知。
独立分析的弱点
独立分析几点弱点。第一,数据构建管线昂贵:每条查询需要 EVA-CLIP 编码全库、再由 Qwen2.5-VL-7B 对 50 个候选逐对推理,600k 训练样本意味着约三千万次 MLLM 打分,中小团队难以复制;改进方向是把 SD 蒸馏成轻量判别器(1-2B 级)或对近邻查询复用打分缓存。第二,图像单模态检索:嵌入指令不含问题文本,无法区分同一实体的不同信息需求,也无法利用问题中的线索消歧;可引入问题条件化嵌入或“先粗检索、再按问题精排”的两段式方案。第三,教师偏差风险:SD 是 Qwen2.5-VL-7B,对稀有实体的判断本身可能出错,蒸馏会把这类系统性错误固化进检索器;可用多判别器集成、或与类别标签等元数据交叉验证来纠偏。第四,“剔除权重超过阈值 $\alpha$ 的候选”隐含假设查询-正例权重可靠,但当正例本身难以辨认(权重低)时 $\alpha$ 随之偏低,可能保留伪负例污染监督;可改用候选间相对排序或不确定度加权替代绝对阈值。第五,推理端需用 7B MLLM 对全库建索引,100K 条目尚可接受,百万级条目需要嵌入量化、视觉 token 剪枝或蒸馏出小检索器才能实用。
未来方向
作者提出或暗示的方向包括:把 KBMR 与更强的重排与推理模块组合(Table 1 显示带重排的 EchoSight‡ 增益依然显著,说明两级互补而非重复);扩展到更多基准与更大规模知识库。基于本文成果可自然延伸的研究方向:(1) 教师蒸馏——把 Qwen2.5-VL-7B 判别器蒸馏成小型专用打分模型,同时服务于训练数据构建和推理期重排,摊薄两端的成本;(2) 问题条件化检索——把问题文本拼入嵌入指令或引入跨模态组合检索,提升多意图、细粒度查询的精度;(3) 迭代式自训练——用训练好的 KBMR 重新挖掘困难负样本、循环蒸馏,逐步逼近判别器性能上界;(4) 与强化学习结合——以端到端 VQA 答对率为奖励微调检索器,弥合“分布拟合”与“最终答案正确”之间的目标偏差;(5) 多粒度知识单元——从实体级文章下沉到段落、表格、信息框字段,支持更精细的证据定位;(6) 在线更新与增量索引,适应知识随时间演化的特性;(7) 可解释检索——利用 MLLM 的语言能力输出检索理由,辅助下游模型甄别证据、抑制幻觉。
复现评估
复现条件较为友好,但算力门槛不低。代码已开源(https://github.com/realHarryX/KBMR);三个评测基准全部公开:E-VQA、InfoSeek(基于 OVEN 的维基实体,知识库为 100K 维基条目)和 OK-VQA(MS COCO 图像);训练数据为从三者训练集抽取的 600k 样本。算力方面,论文使用 8×NVIDIA A100(80GB),但 LoRA rank 16 + DeepSpeed ZeRO-2 大幅降低显存需求,训练仅 5000 步、图像统一缩放到 336×336、累积 batch 1024,学习率 1e-4(Qwen2-VL)/2e-5(LLaVA-OV)。若采用 LoRA 加梯度累积,单机 4×A100 或高端消费级显卡(拉长训练时间)有希望完成主实验;真正的瓶颈在数据构建阶段——EVA-CLIP-8B 全库编码与 Qwen2.5-VL-7B 的数千万次逐对打分是主要成本。难度评估:完整复现 Table 2/3 主结果约需数天数据构建加数天训练,属中高难度;若只在子集知识库上做消融验证,难度可显著下降。另需注意 MMKB-RAG 闭源,对照实验需按论文自行复现。
论文图表
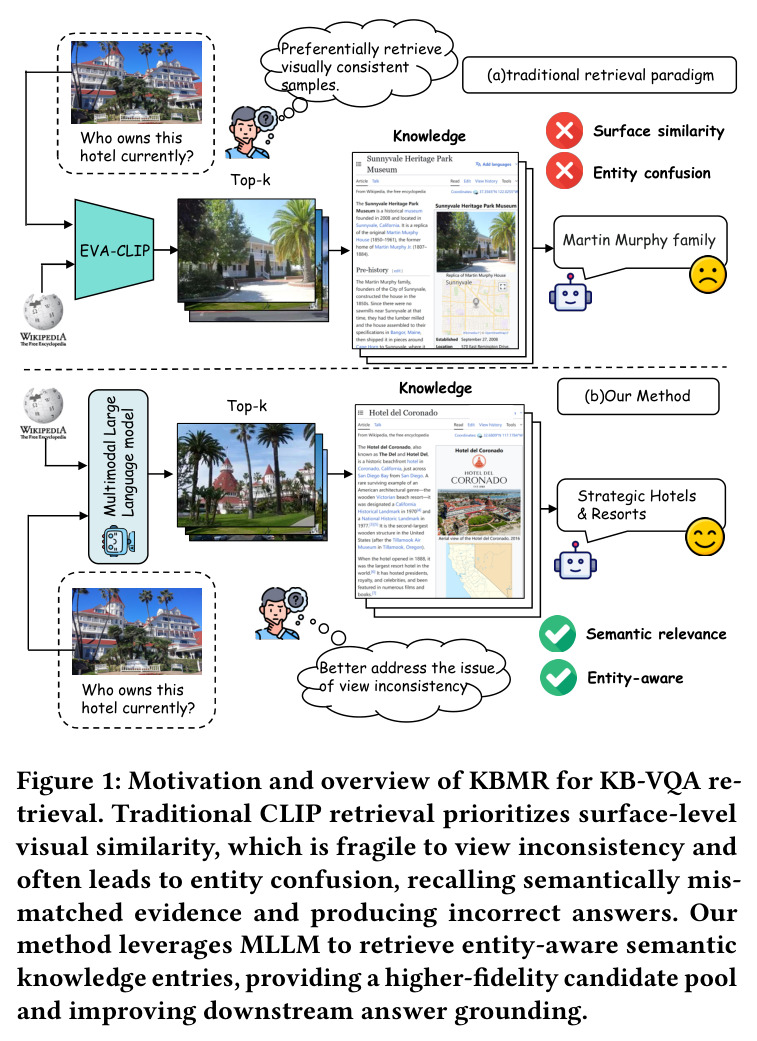
以上下两条对照展示动机与总览:(a) 传统 CLIP 检索范式——对“这家酒店目前归谁所有”的查询,EVA-CLIP 按表层视觉相似取 Top-k,结果因视角不一致召回错误证据、产生实体混淆,给出错误答案;(b) 本文方法——MLLM 检索器按实体级语义相关性取 Top-k,在同一酒店跨视角、跨年代外观变化下仍命中“Martin Murphy family / Hotels & Resorts”等正确知识条目。
一图点明全文核心论点:KB-VQA 检索的本质是实体身份匹配而非视觉相似匹配,并直观呈现“视角不一致”与“实体混淆”两类 CLIP 失败模式及 KBMR 的解决思路。