机构报纸流水线:从历史报纸扫描件中提取数十亿高质量token Institutional Newspapers Pipeline: Deriving billions of high quality tokens from historical newspapers
模块化流水线将147万张历史报纸扫描转化为163亿token的开放数据集
前置知识
OCR(光学字符识别)
把扫描图像中的文字自动转成机器可读文本的技术。传统引擎(如Tesseract)按'检测文本行→逐字符识别'两步走,输出带词级置信度和词级边界框;新一代视觉语言模型(VLM)则像'看图写作'一样直接生成文本,能应对弯曲、噪点、装饰性字体,但可能产生幻觉或陷入无限重复同一token的循环。
论文的核心产出就是OCR文本(163亿token),整条流水线都围绕'如何大规模获得高质量OCR'设计,双引擎策略、图像分辨率钳制、token-loop后处理等决策都需要OCR背景来理解。
视觉语言模型(VLM)与幻觉
VLM是同时接收图像与文本输入的生成式模型。本文用它做crop级OCR,选用的dots.mocr仅3B参数。幻觉指模型生成图像中不存在的内容;论文展示了一个'有益幻觉'的例子——VLM从受损扫描中补全了缺失字母——但也可能凭空虚构文字或无限重复token(token loop)。
理解论文为何把整页OCR拆成crop级、为何同时保留Tesseract输出作为对照、为何要做token-loop清除后处理,都取决于对VLM失效模式的认知。
目标检测与YOLO
目标检测任务在图像中定位物体,输出矩形边界框加类别标签。YOLO系列是单阶段实时检测器,一次前向传播同时预测所有框和类别。本文用系列中最大的YOLO26x(55.7M参数)把整版报纸切成内容块(crop),用较小的YOLO26m-cls(11.6M参数)做crop图像分类。
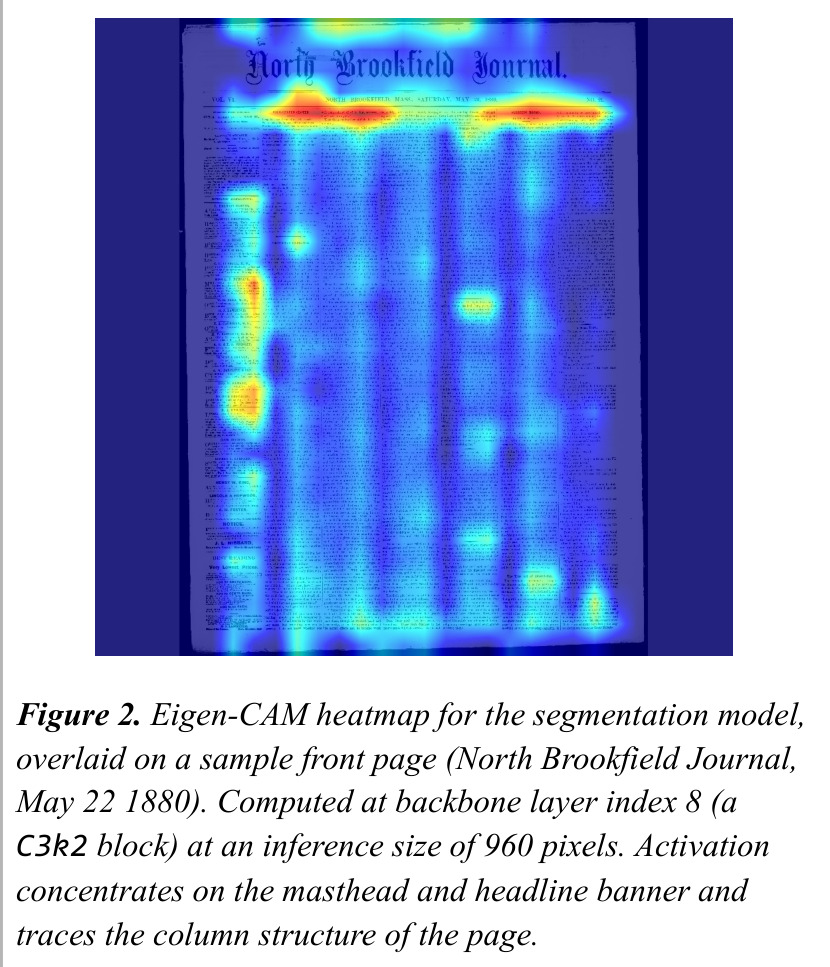
版面分割是流水线第一步,其训练配置(960px输入)、推理阈值(置信度0.6、IoU 0.15)和Eigen-CAM可解释性分析都建立在这个模型族之上。
IoU、NMS与mAP
IoU(交并比)等于两框交集面积除以并集面积,衡量预测框与真值框的重合程度;非极大值抑制(NMS)按IoU阈值删除高度重叠的冗余框。mAP@50是IoU阈值取0.5时的平均精度均值,mAP@50-95则对0.5到0.95的多个阈值取平均,是更严格的指标。
分割模型的评估结果(mAP@50=0.955、mAP@50-95=0.901)和它特意压低的NMS阈值0.15都需要这些概念才能正确解读。
静态嵌入与Model2Vec
静态嵌入给每个词一个固定向量,不经过Transformer注意力计算,推理极快、内存极小。Model2Vec通过蒸馏把transformer模型压成静态词向量(如potion-base-32M),可再微调为分类器。本文用它微调出crop文本分类器,并生成256维文本嵌入。
它是论文'节俭计算'策略的核心组件,也是理解文本分类器为何在视觉类目上弱于图像分类器(纯文本信号缺失)以及嵌入局限的关键。
零样本文本分类
零样本分类无需为目标任务训练:把'文本-标签'对构造成自然语言推理(NLI)的蕴含判断,模型输出每个标签的蕴含概率。本文用ModernBERT-large-zeroshot-v2.0给每个crop在12个主题标签上打分并保留完整排序。
主题检测一节的所有结论——平均置信度0.65、离散度大、top1-top2分差0.457——都直接源于NLI打分机制区别于常规softmax分类的特性。
HDBSCAN聚类
基于密度的层次聚类算法,无需预先指定簇的数量,能发现任意形状的簇并把离群点标记为噪声。本文用它按x中心坐标把窄crop聚集成'栏',从而以极低的计算成本推断报纸版面的阅读顺序。
阅读顺序检测是流水线中最非常规的一步,作者用它替代LayoutReader等昂贵的transformer方案,是理解其成本取舍的核心。
Kendall's τ 秩相关系数
比较两个序列的元素对顺序一致性:顺序一致的对记正分、逆序的对记负分,取值范围-1到1。它不要求元素处在完全相同的位置,只看整体先后关系是否正确。
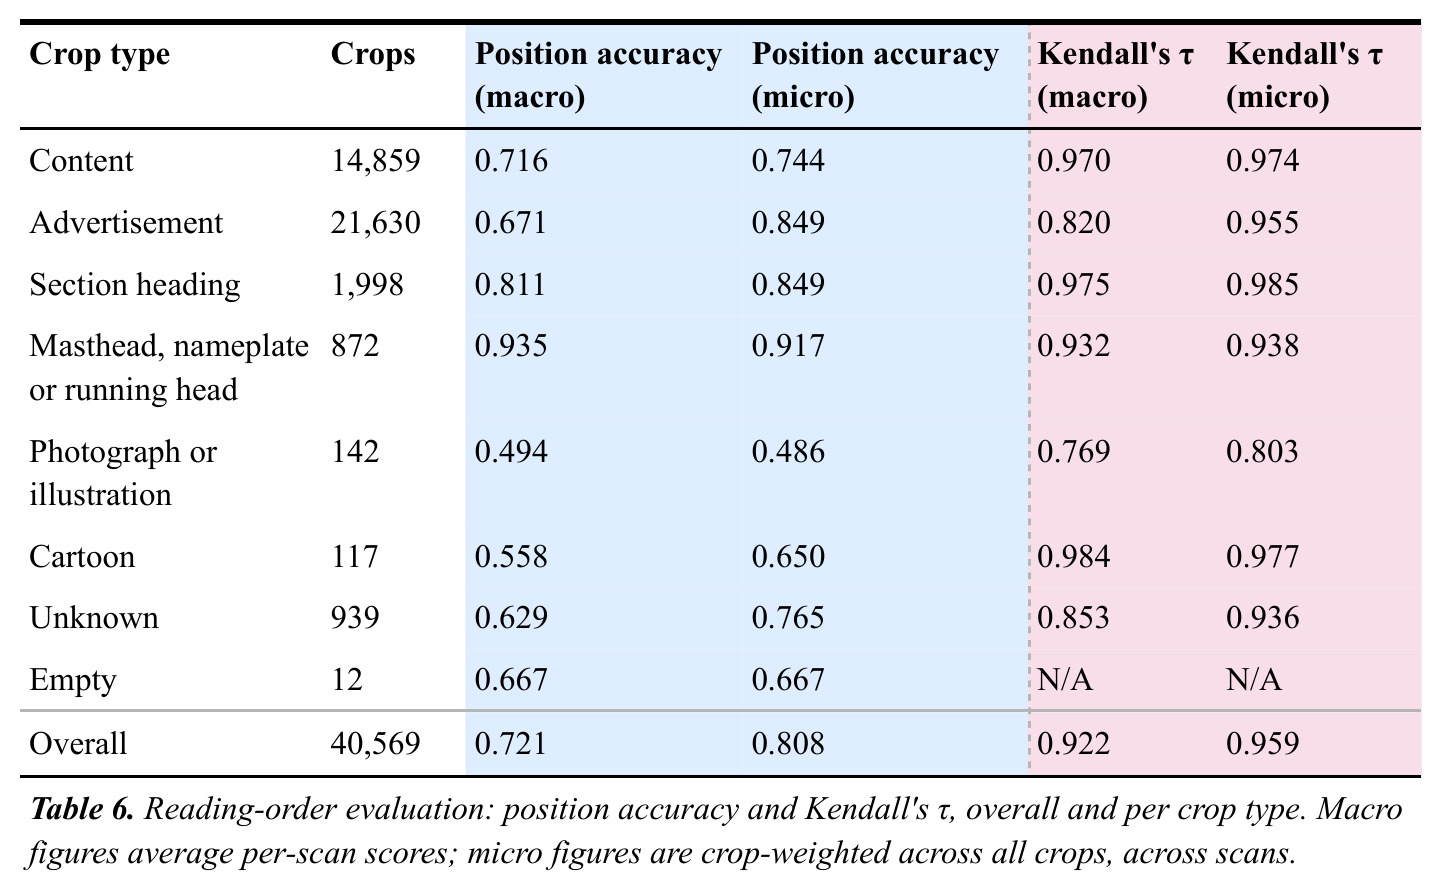
论文用位置准确率(要求索引完全正确,macro 72.1%)和Kendall's τ(只看顺序,0.922/0.959)双重评估阅读顺序,τ的解释是理解'大体顺序对、个别位置偏'这一结论的关键。
研究动机
历史报纸是人类公共生活最密集的记录之一,但计算化访问极其困难。其版面密度高且不规则:正文按多栏排版,穿插装饰性大字标题、表格和密集广告,通用OCR和文档解析工具难以正确切分与识别;扫描件质量参差不齐,19世纪纸张老化进一步拉低识别率。虽然各国图书馆投入巨大精力数字化馆藏——如美国国会图书馆的Chronicling America、欧洲的Europeana Newspapers和法国国家图书馆的Gallica——但多数提取出的文本质量低到只能当作不可靠的关键词索引:用来定位原始页面扫描图供人工阅读,而无法直接支撑计算分析和挖掘。与此同时,LLM预训练需要海量高质量数据,预训练数据的性质与质量直接影响模型的行为与能力,高质量报纸语料被视为改善AI'数字食谱'的重要来源(同期Talkie-LM项目专门用1931年前数据训练模型即为例证),却因提取困难而长期缺位。
本文的目标是论文的目标是与波士顿公共图书馆(BPL)联合设计并实际运行一条生产级流水线,对其馆藏中1,473,635张公有领域报纸扫描件(1795–1930年出版)实现'原子级'理解:把每版页面切分为有意义的最小内容单元(crop),对每个crop产出边界框、双引擎OCR文本、类型标签、阅读顺序索引、命名实体、主题标签、语言与文本统计指标,以及文本/图像嵌入向量,并以开放数据集形式发布——共83,147,041个crop、163亿o200k_base token。同时要求每一步保持可解释、可独立评估和可替换,整个流水线在计算上足够节俭、能在工作站级硬件上运行,使其他知识机构能用同样的方法处理自己的馆藏。
与已有工作不同的是,本文的切入角度与Newspaper Navigator、American Stories等先行工作不同。那些工作用CNN在整版扫描上联合做检测加分类,本文刻意把'分割'与'分类'解耦:内容与广告crop在整版中占绝对多数,联合训练会造成严重类别不平衡、浪费有限标注;分开后各步骤可用不同信号单独优化。分类阶段进一步把文本与图像两个小分类器的预测按规则融合,解决单一信号无法可靠判断的难例。OCR阶段放弃'整页喂给VLM'的捷径——密集页面会导致准确率下降并诱发重复循环、前沿API成本高达每百万输出token 15到50美元——改为crop级双引擎OCR。贯穿始终的是'节俭计算'理念:全部自用模型参数量在3B以下(多数在11.6M至55.7M),最终在单个GPU节点上完成全库处理。
核心方法
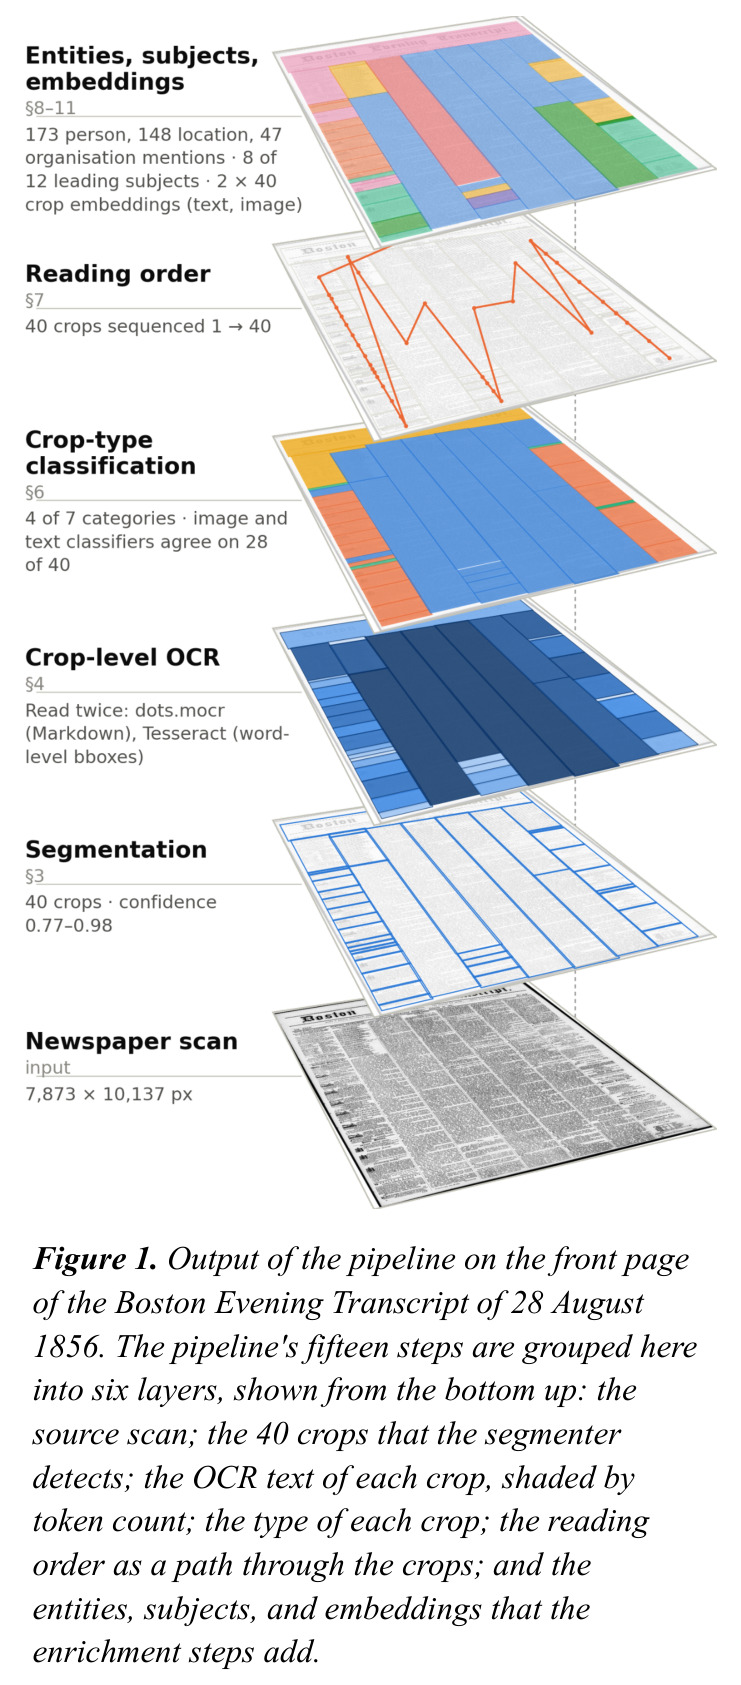
直觉上,流水线把一张报纸版面当作层层信息叠加:先找出页面上的内容积木(crop),再为每块积木读出文字、判断类型、排出顺序、抽取实体和主题,最后为检索预计算向量。技术上共15步、按6层组织:(1) 以200期一批检索扫描并缓存,让IO与计算重叠;(2) 用YOLO26x检测crop边界框;(3–4) 对每个crop分别用Tesseract 5和dots.mocr(3B参数VLM)做双OCR;(5–7) 用YOLO26m-cls图像分类器与Model2Vec微调的文本分类器做crop类型分类并按规则融合;(8) Flair ner-fast命名实体识别;(9) ModernBERT-large-zeroshot-v2.0在12个主题标签上零样本打分并保留完整排序;(10) HDBSCAN聚栏推断阅读顺序;(11–15) token计数、Lingua语言检测、PyICU文本分析、词表匹配、DINOv2-small与potion-multilingual双嵌入。所有结果以每扫描一行、crop为列表列的Parquet格式发布,用户可按层取用。
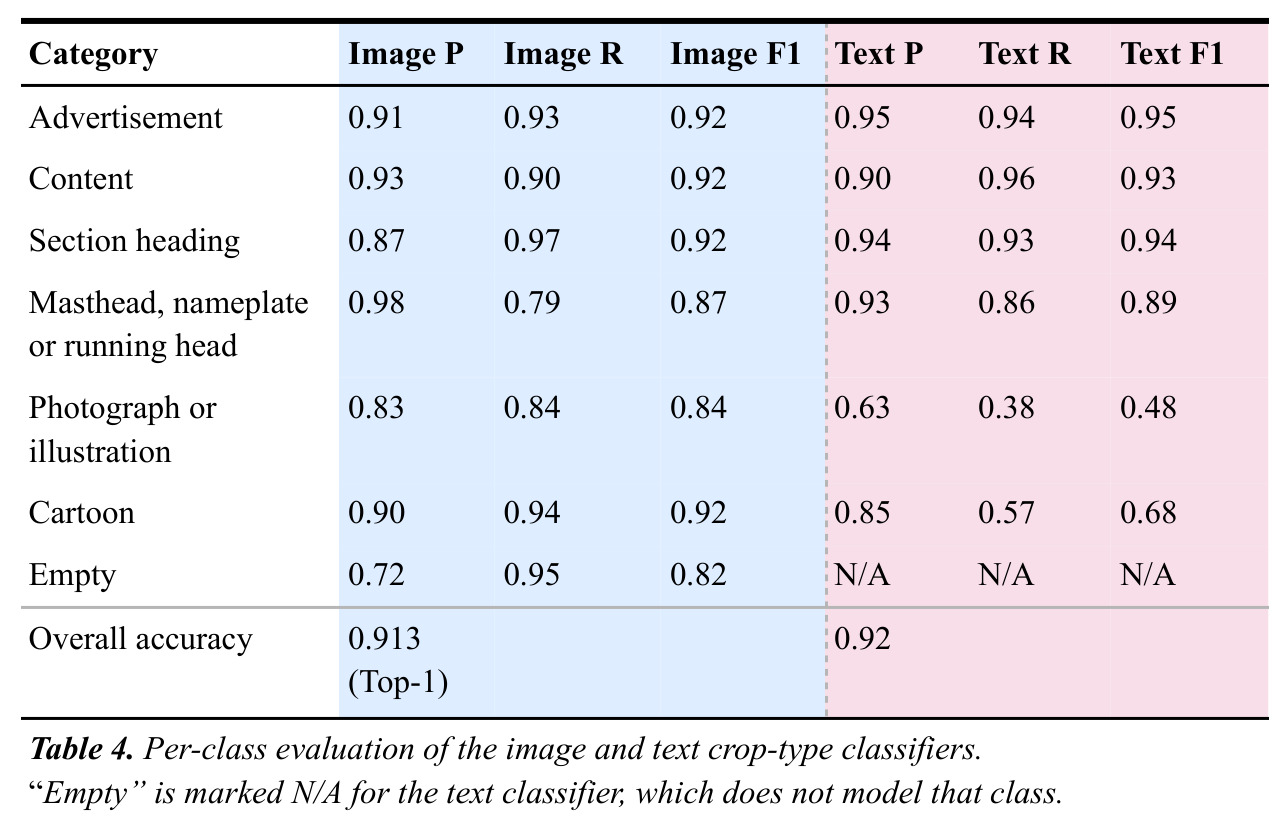
核心创新是'原子化+解耦+多信号融合'的设计模式。其一,原子单元是crop而非文章或版面:标题不与所辖文章分离、以视觉为主的广告自成一块,这让下游可按需重组语义单元。其二,分割与分类解耦,规避了全页联合检测加分类的类别不平衡(广告和内容crop占绝对多数),让1,020张扫描、47,485个框的有限标注发挥最大价值。其三,crop类型由图像分类器(YOLO26m-cls)和文本分类器(Model2Vec微调)独立预测后融合:两者在视觉类目上高度互补——照片/插图类$F_1$为0.84对0.48、漫画0.92对0.68——融合规则还把两路原始预测一并发布,用户可自定义决策。其四,双OCR平行保留:Tesseract几乎不幻觉且输出词级框、兼容AltoXML等图书馆系统,dots.mocr能恢复密集、装饰性和受损文本,两份文本都进入数据集供下游选择,这在同类数据集中很少见。
方法步骤详情
步骤1:按200期一批检索扫描并缓存,使取件解码与计算重叠。步骤2:在960px下用YOLO26x(55.7M参数)检测crop,丢弃置信度<0.6的检测并以IoU阈值0.15做NMS;训练集为1,020张扫描、47,485个框。步骤3:Tesseract 5在缩至1.5MP的crop上OCR,输出词级框。步骤4:dots.mocr经vLLM跑在8块L40S上,图像钳制在0.25–1MP并双缓冲批处理。步骤5–7:图像分类器(768px、7类、188,477条自动标注)与文本分类器(6类、185,900条标注)分别预测,按'最高置信度优先、视觉类目图像分类器优先'融合。步骤8:Flair NER,置信度≥0.85,仅保留PER/LOC/ORG并去重。步骤9:零样本输出12主题完整排序。步骤10:HDBSCAN按x中心把窄crop聚成栏,宽crop归入上方内容最多的栏,栏间从左到右、栏内自上而下。步骤11–15:token计数、语言检测(低置信或短文本回退期级元数据)、文本分析、词表匹配、384维图像加256维文本嵌入。最后做去连字符、Markdown规范化和token-loop清除。
技术新颖性
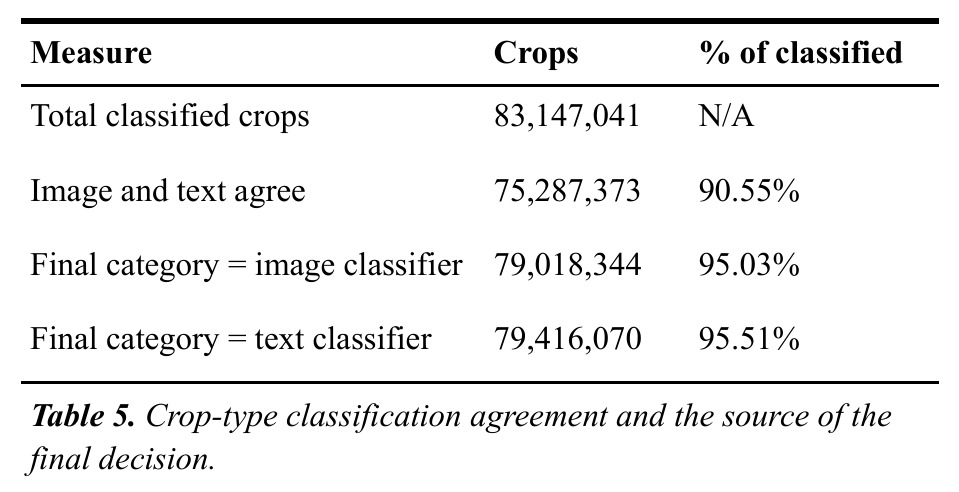
单看每个组件都不新——YOLO、Tesseract、VLM OCR、Model2Vec、HDBSCAN、Flair、零样本分类全是现成技术。论文的新颖性在系统层面的组合与约束下的取舍。与Newspaper Navigator/American Stories的端到端CNN检测加分类相比,'分割-分类解耦+双信号融合'是对标注稀缺与类别不平衡的针对性设计,并用两分类器90.55%的一致率实证了两路信号不可互相替代。与LayoutReader等transformer阅读顺序方案相比,HDBSCAN加规则的方案把该步骤成本压到每批200期仅1.13分钟,代价是放弃复杂版面。与olmOCR等整页VLM OCR相比,crop级推理规避了密集页面上的退化重复循环,且双引擎输出互为参照。最有说服力的是成本账:同等163亿token若调用前沿VLM API约需25万至80万美元,本流水线租用硬件约2.5万美元,降低约90%–97%。此外,'大模型自动标注+人工抽检(600条标注上严格口径91%、标准口径94.50%准确率)+小模型蒸馏'的数据生产范式,对标注预算有限的机构具有可复制的方法论价值。
实验结果
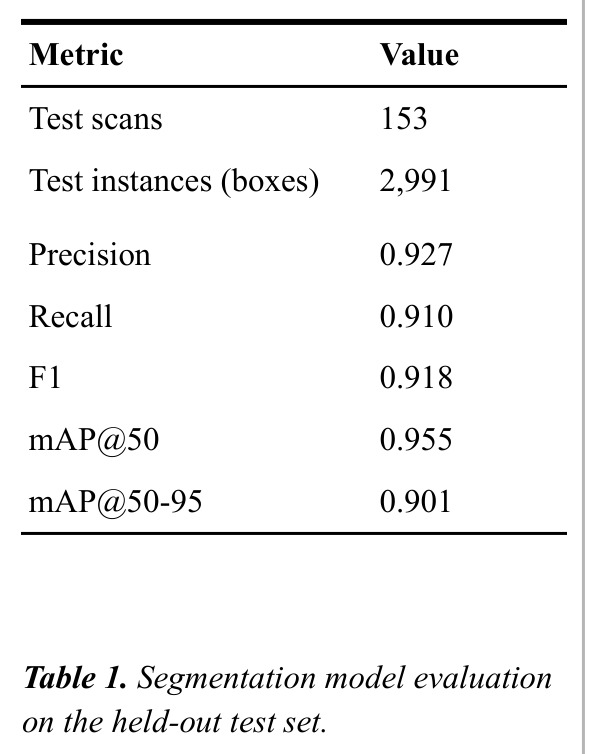
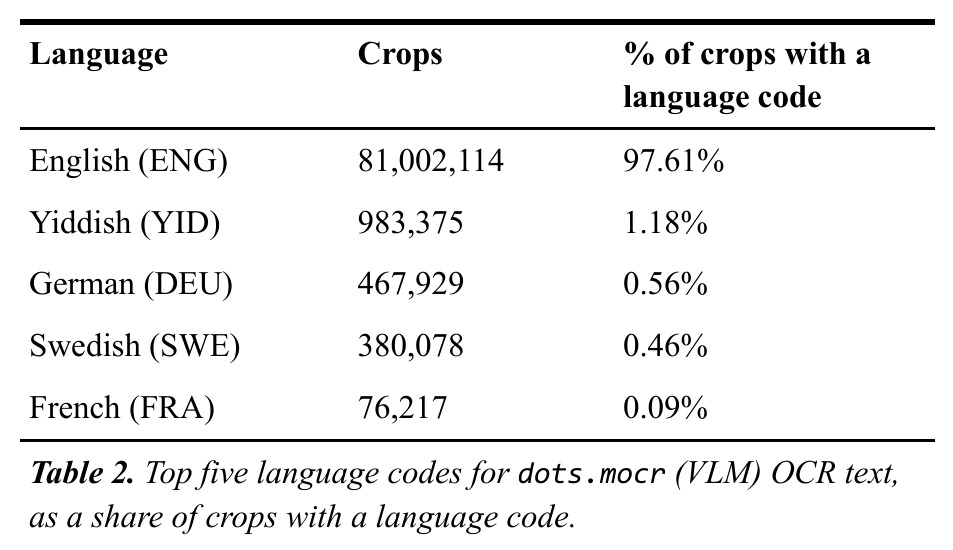
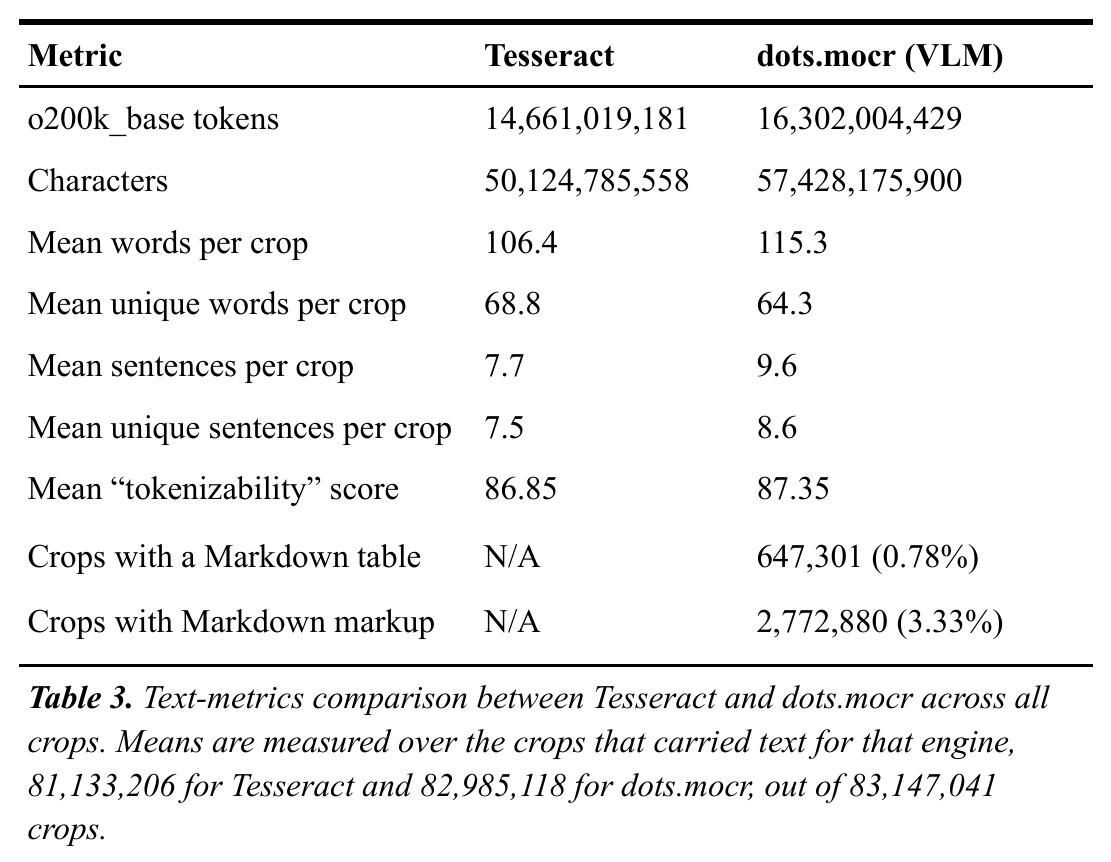
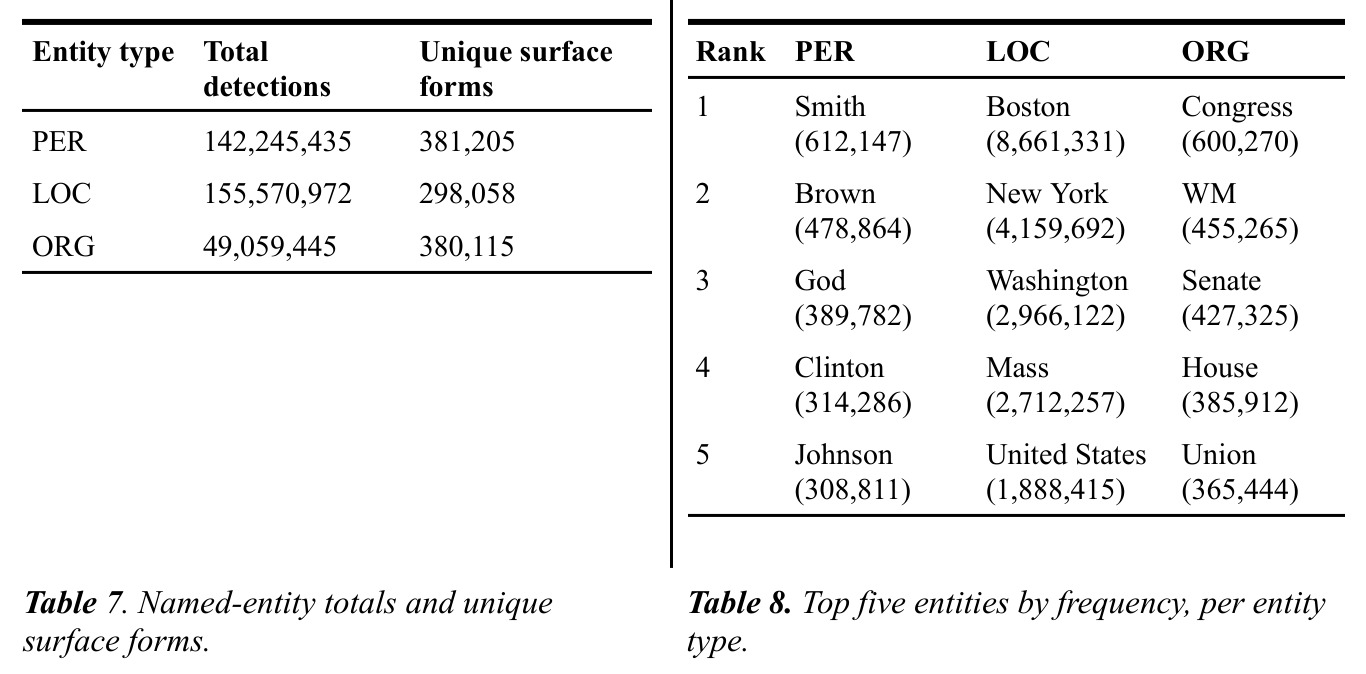
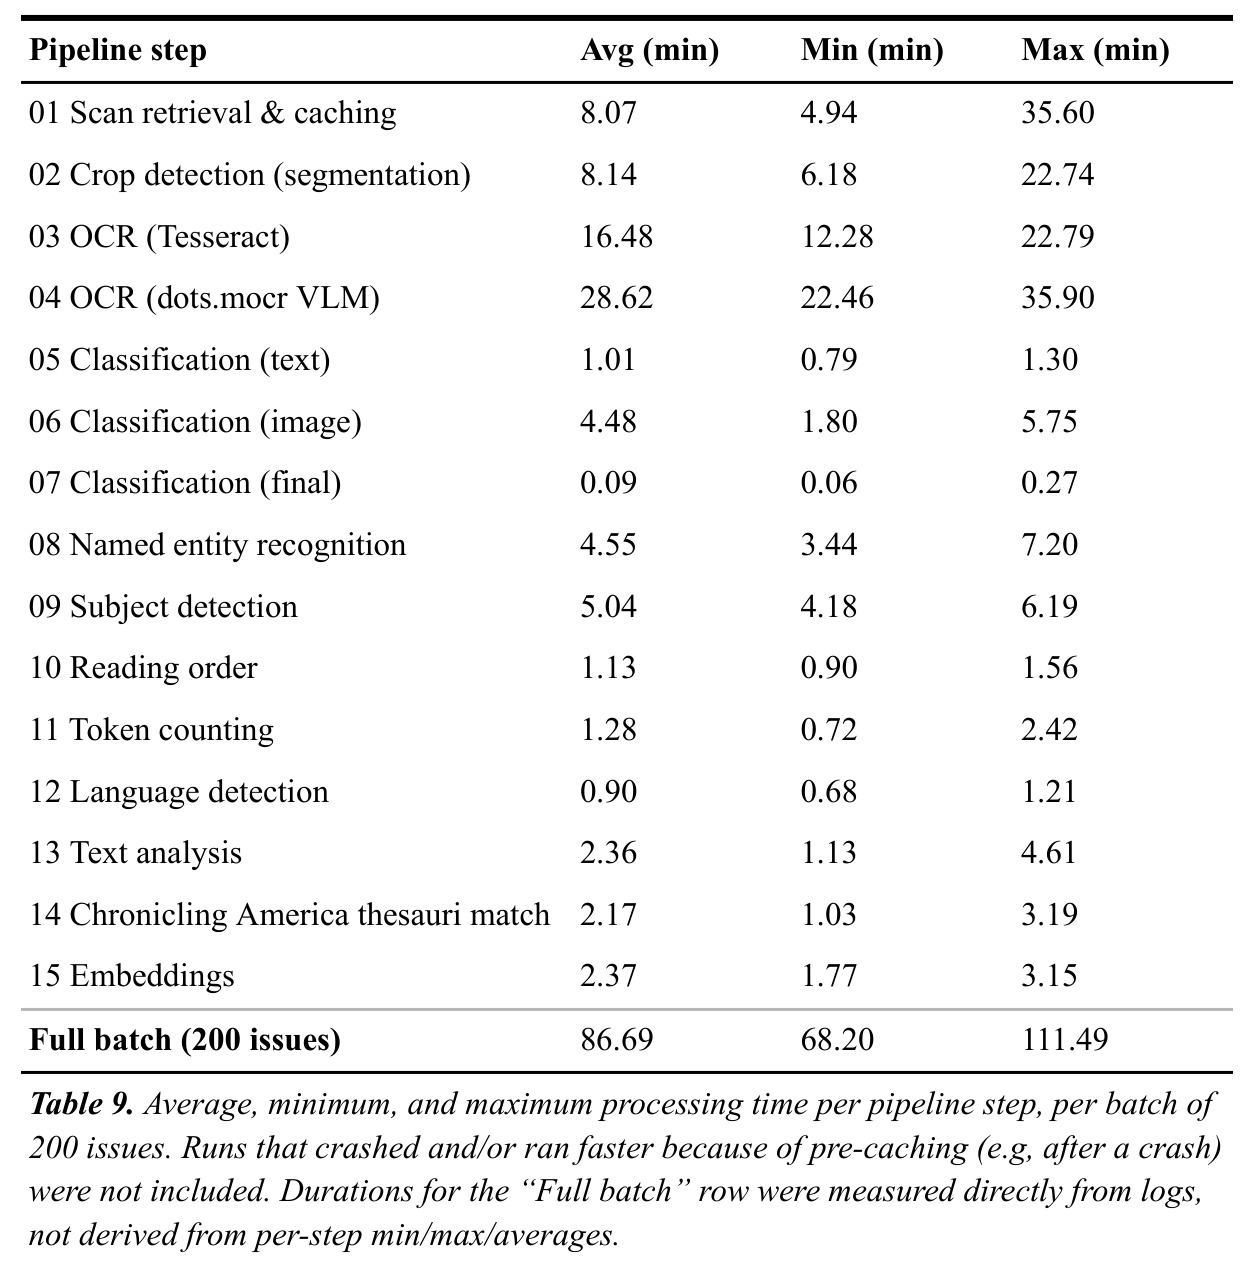
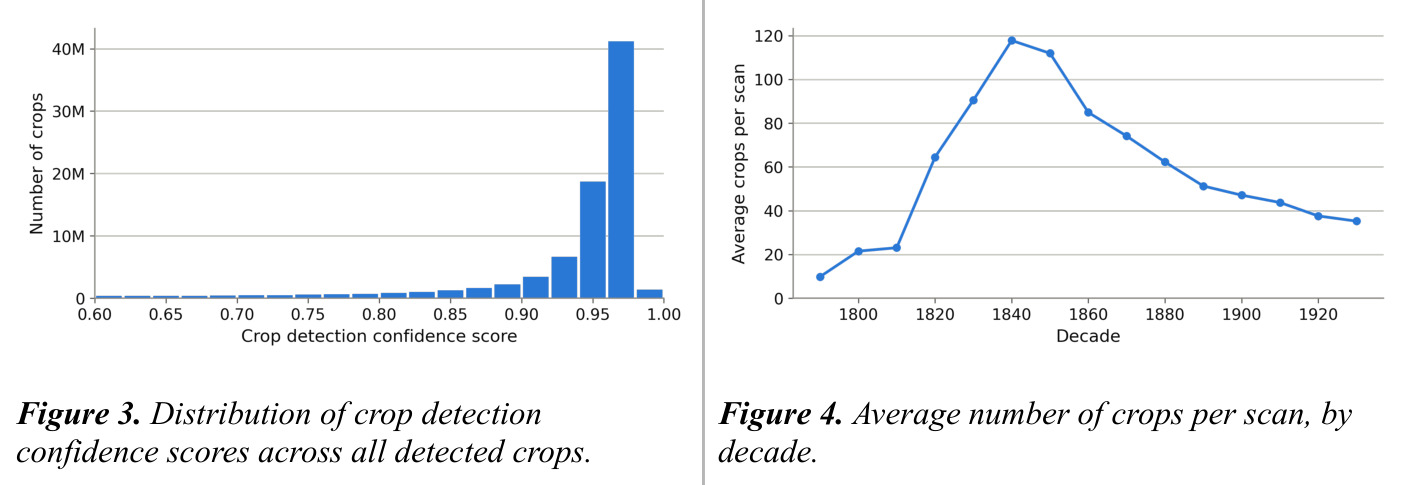
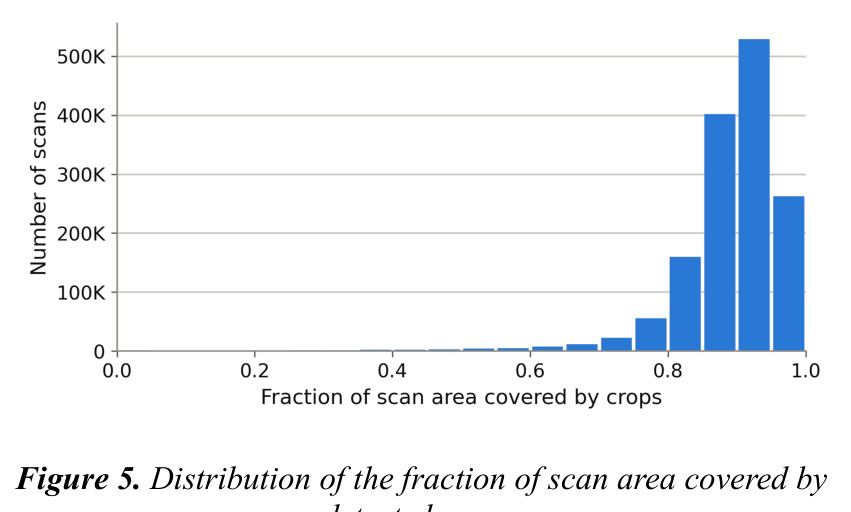
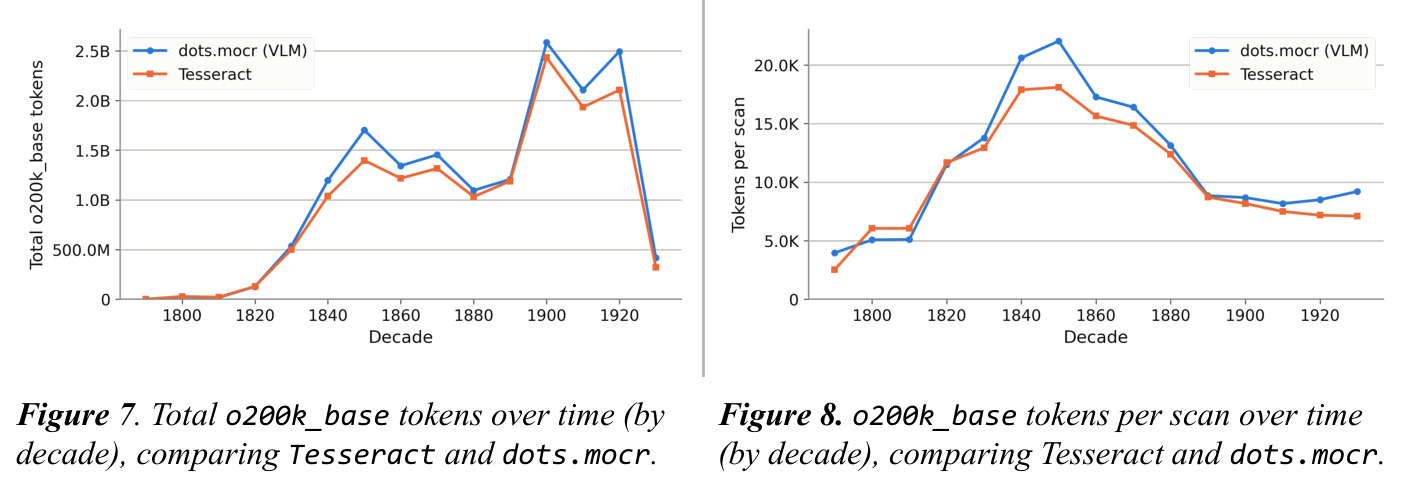
分割:153张测试扫描(2,991框)上$F_1=0.918$、mAP@50=0.955、mAP@50-95=0.901;全库检出83,147,041个crop(均值56.4/版),覆盖89%版面。OCR:dots.mocr产出163.0亿token、574.3亿字符,高于Tesseract的146.6亿和501.2亿,平均9.6句对7.7句;但Tesseract独特词更多(68.8对64.3),系字符噪声产生伪词。语言:99.81%的crop有语言码,英语97.61%,共73种。分类:两分类器一致率90.55%,图像分类器在照片类$F_1$ 0.84(文本仅0.48)、漫画0.92(0.68);广告crop居首但内容类贡献多数token。阅读顺序:位置准确率72.1%(macro)/80.8%(micro),Kendall's $\tau$ 0.922/0.959。NER:1.556亿地名、1.422亿人名、4,910万机构名。主题:平均top-1置信度0.65,top1-top2分差0.457。成本:每批200期平均86.69分钟,OCR约占一半;全库租用算力约2.5万美元。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 报纸版面分割(153张测试扫描,2,991个框) | mAP@50 / mAP@50-95 / F1 | 0.955 / 0.901 / 0.918 | 无外部基线(自训练YOLO26x,未与Newspaper Navigator等方法直接对比) | —(论文以绝对指标证明可用性) |
| crop级OCR产出(全库,83.1M个crop) | o200k_base token总数 / 字符总数 | 163.0亿 / 574.3亿(dots.mocr) | 146.6亿 / 501.2亿(Tesseract 5) | token +11.2%,字符 +14.6% |
| 照片/插图crop分类 | F1 | 0.84(YOLO26m-cls图像分类器) | 0.48(Model2Vec文本分类器) | +75%(视觉类目上图像信号决定性更强,是融合设计的依据) |
| 漫画crop分类 | F1 | 0.92(图像分类器) | 0.68(文本分类器) | +35.3% |
| 阅读顺序检测(723张标注扫描,40,569个crop) | 位置准确率 macro/micro;Kendall's τ | 72.1% / 80.8%;0.922 / 0.959 | 纯规则方法(早期原型,作者评估不满意后放弃) | 定性:以每批1.13分钟的极低成本达到可用精度 |
| 163亿token的OCR总成本(全库估算) | 美元 | 约 $25,000(自建/租用8×L40S节点,约1,650小时) | $250,000–$800,000(前沿VLM API,$15–50/百万输出token) | 成本降低约90%–97% |
局限与改进
作者承认的局限:模型与流程均针对BPL馆藏调试,对版面或语言差异大的其他馆藏可能失效;HDBSCAN阅读顺序依赖分栏结构假设,对非严格分栏版面不适用;NER用现成模型,历史人名易超出分布、受OCR噪声影响,还可能把贬损词汇误标为人名,故仅作实验性输出;零样本主题置信度离散度大(各标签标准差0.08–0.23),不能按字面信任;嵌入模型是通用型,专门任务需自换模型;词表匹配自称'朴素'。我补充的观察:(1) 全文没有OCR字符错误率(CER/WER)评估——没有人工ground truth,token更多不等于更准,'有益幻觉'与凭空虚构无法系统区分,这是数据集质量主张的最大缺口;(2) 分割与阅读顺序的评估集偏小(153/723张扫描),且阅读顺序参考答案由早期版本算法预标注再人工修正,可能引入锚定偏差;(3) crop类型标注依赖单一VLM(Qwen3-VL-30B),其系统性偏差会传导给两个下游分类器;(4) 广告占crop数近六成但token贡献低,若用于LLM预训练需认真设计采样与去重,论文未讨论token级质量过滤。
独立分析的弱点
第一,OCR质量不可证:建议抽样构建ground truth计算CER/WER,或用合成退化扫描做受控评测,并为每个crop发布OCR置信度代理指标。第二,阅读顺序在广告类(macro 0.671)和视觉类(照片0.494、漫画0.558)上明显偏弱,且完全没有跨crop的文章级关联——一篇跨栏连载文章被拆成互不链接的多块:可训练轻量transformer排序头,或增加crop间文章链接预测任务。第三,单一VLM自动标注的偏差风险:可用2–3个异构VLM集成投票,把低一致性样本送入人工队列形成主动学习闭环。第四,VLM幻觉目前仅有正则后处理和token-loop清除:可加一个基于Tesseract与VLM输出差异的异常检测器,输出逐crop风险分供下游过滤。第五,多语言报纸(意第绪语98.3万crop)未经专门验证,dots.mocr在非拉丁字母上的表现未单独报告:应按语言分层抽样评测。第六,数据集以版面为行、crop为列表列,83.1M crop的检索不便:可发布预建向量索引、文章级重组视图或示例查询。以上每条都有明确杠杆,工程量可控,适合社区接续。
未来方向
作者明确提出的方向:(1) 专门为历史报纸crop训练小型OCR VLM,目标是比dots.mocr更小、更准、更不易token-loop,这是他们认为的最大瓶颈;(2) 持续修订模型与方法,在不同图书馆合作伙伴的不同馆藏上重复实验,检验并扩大泛化性;(3) 为复杂/非分栏版面引入transformer阅读顺序模型;(4) 进一步压缩流水线计算足迹。基于本文成果可自然延伸:把163亿token接入LLM预训练并做数据消融——类似Talkie-LM用1931年前数据训练'时代语言模型'的思路——量化历史报纸语料对模型历史知识与语言风格的影响;利用双OCR系统性差异训练post-OCR纠错模型;基于384维图像嵌入研究版面演进与广告视觉风格的数字人文课题;组合NER、主题、词表匹配构建面向研究者的时间序列实体图谱;对647,301个含Markdown表格的crop做结构化数据抽取(股票行情、船期、体育比分等历史数据库)。
复现评估
开源程度很高:流水线代码在GitHub,模型、数据集与训练配置在Hugging Face合集(每个模型附args.yaml超参),数据集附完整字段清单(Appendix E)和Agent Skill文件,自动标注提示词全文公开(Appendix B)。数据层面,1,473,635张扫描以WEBP q70内嵌于Parquet分片(每片250个扫描、zstd压缩),全部crop级输出随行发布。算力需求:原作者使用单节点(8×NVIDIA L40S、256核、768GB内存),租用估算约2.5万美元/1,650小时;设计目标兼容工作站级硬件但吞吐会显著下降。复现门槛不在算力而在人力标注:分割需1,020张扫描的框标注(含模型辅助迭代),阅读顺序需723张扫描的人工校对,自动标注还需获取Qwen3-VL-30B(FP8)。总体判断:只用现有模型做推理相当容易;完整复现全流程(含标注)为中等难度,需要GPU资源和数据工程能力。
论文图表
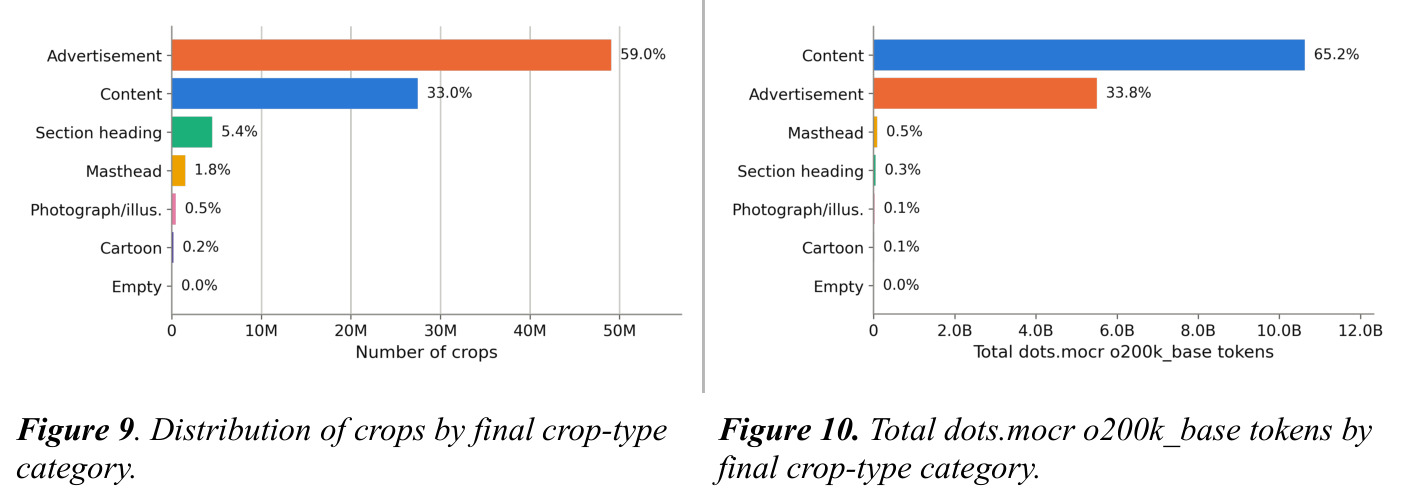
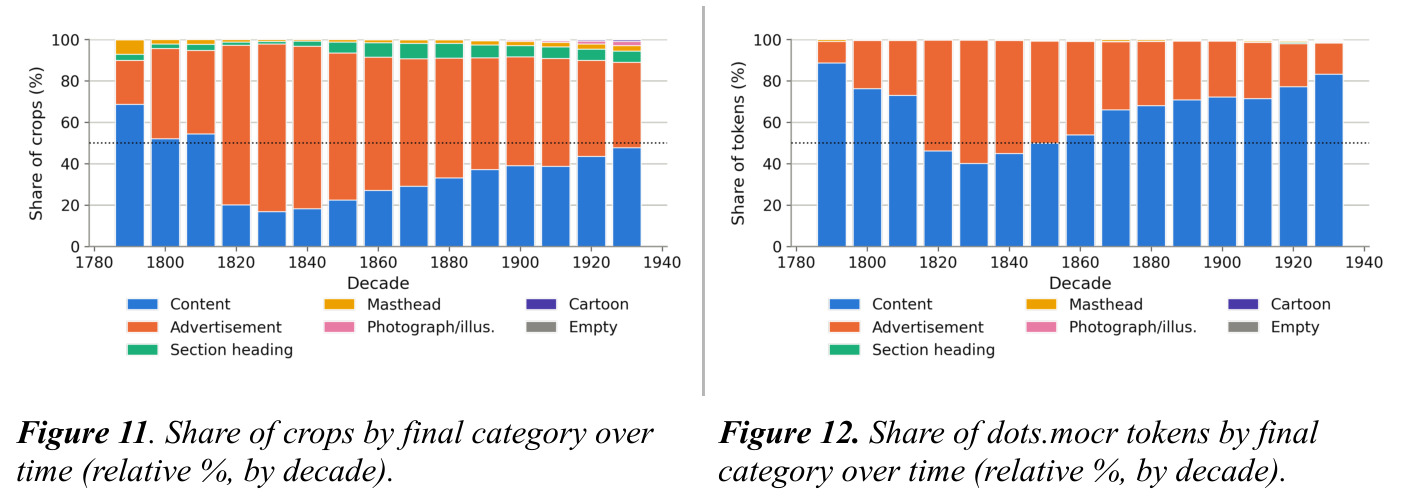
各类型crop占比随年代的相对变化:多数年代中广告crop数量超过内容crop。
与Figure 13共同支撑'广告日益视觉化'的版面演变分析。
各类型token占比随年代变化:内容类在几乎所有年代都贡献多数token。
展示语料构成的纵向稳定性,说明该模式不是个别年代的特例。
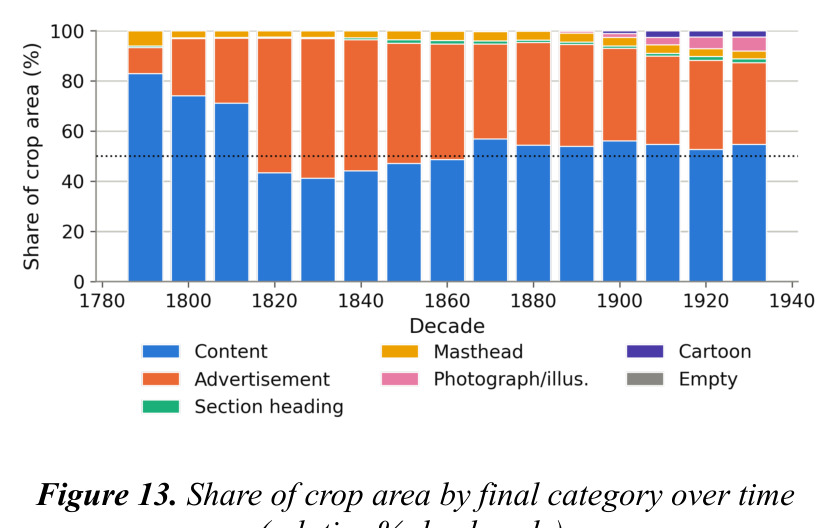
各类型面积占比按年代变化:1860年代前广告的面积份额与token份额大致相当;1870年代起广告面积显著超过其token贡献,到1920年代差距扩大到约15个百分点。
定量呈现'广告逐渐视觉化'的趋势,是论文中最有数字人文研究价值的发现之一。
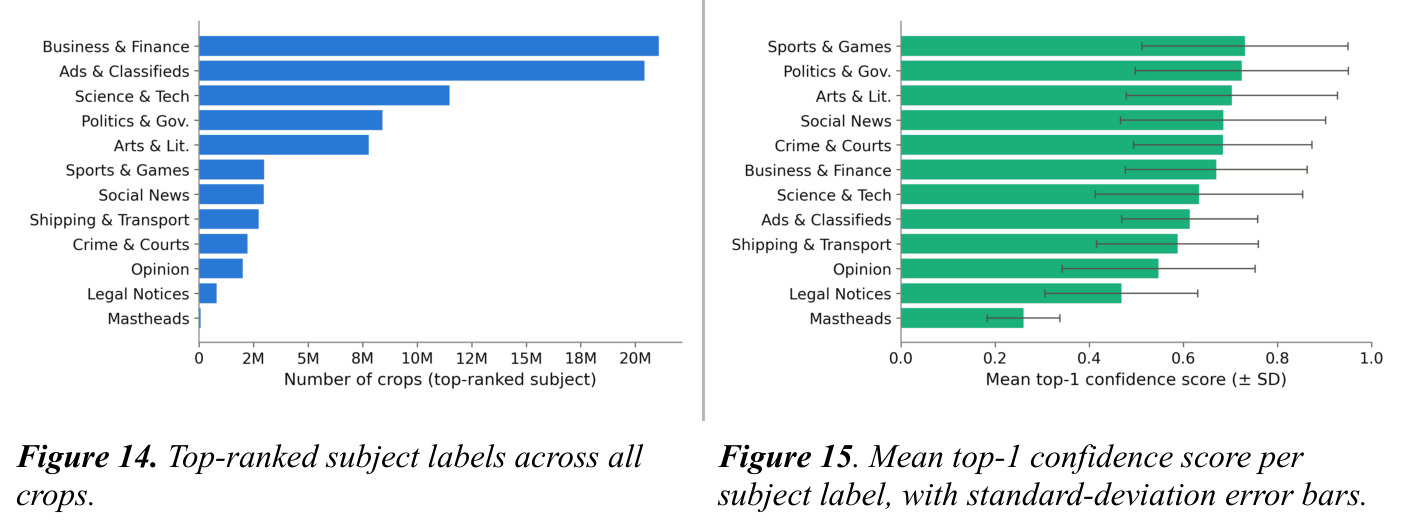
全库top-1主题分布:'商业、金融与市场报告'和'商业广告与分类广告'居前,其后是'科学、技术、健康与农业'、'政治、国际关系与政府'。
展示主题检测层的宏观产出,其中两个标签与crop类型在设计上重叠,作为独立校验信号。
82,985,966个有主题预测的crop中,平均top-1置信度0.65,但各标签标准差从0.08到0.23不等:边界清晰的主题(体育、政治)置信度高,宽泛或残留类目(法律公告、报头)置信度低。
支撑该输出'实验性'的定位,提醒用户必须使用完整分数分布而非单一标签。
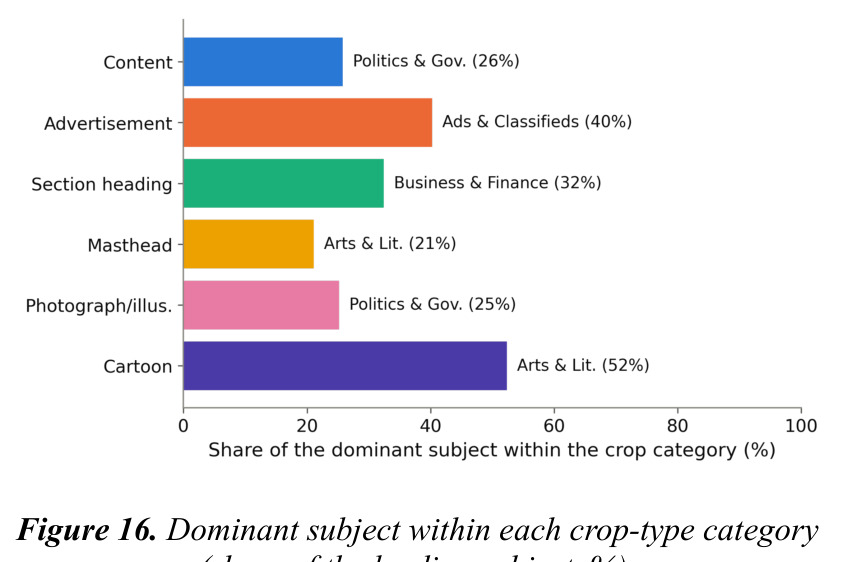
每个crop类型内部的主导主题:广告crop压倒性地对应商业主题,内容crop分散在各类新闻主题上。
交叉验证主题信号与crop类型分类的一致性,说明两条独立管线给出的证据互相吻合。
用Qwen/Qwen3-VL-30B-A3B-Thinking-FP8给crop自动打类型标签的完整提示词:定义了7个类别及判别准则(如文章标题归Content、选举广告归Advertisement、仅含文字的crop不能是照片等),并要求只返回类型名。
自动标注是两个分类器共188,477/185,900条训练数据的来源,提示词是复现训练集的关键细节。
按预测类别分解的两个分类器平均置信度:'内容/广告/栏目标题/报头'均在0.9左右及以上,'照片/漫画/空'明显偏低(图像分类器0.679–0.838),两个分类器在同一批类目上同时示警。
显示模型'自知不确定'的区域,与Table 4的低F1类目互相印证,可指导下游设定过滤阈值。
15步在每批200期上的耗时:dots.mocr OCR平均28.62分钟、Tesseract 16.48分钟,合计约占86.69分钟全批时长的一半;其余13步多在几分钟以内(如文本分类1.01分钟、阅读顺序1.13分钟)。
量化了计算瓶颈(VLM OCR)与'节俭计算'设计的成效,也是估算全库成本2.5万美元的依据。
100张随机抽样扫描的四边未覆盖边距:左边平均3.06%、上2.57%、右3.63%、下3.14%(像素均值228–302px);包含全部crop的包络平均覆盖88.02%版面。
解释Figure 5中约11%未覆盖面积的来源——主要是物理空白边距而非漏检,补全分割召回论证。
按类目的分类器置信度分解:内容0.950/0.957、广告0.963/0.978、栏目标题0.896/0.938、报头0.948/0.935;照片0.719/0.705、漫画0.838/0.742明显偏低;图像分类器'空'类0.679为最低,文本分类器'空'类1.000±0.000是规则产物而非测量值。
与Table 4的低F1类目互相印证:两个分类器在同一批视觉类目上同时表现出低置信,为下游过滤提供量化依据。
数据集完整字段清单:每行一个扫描,crop级字段为列表列并按阅读顺序排列;含来源后缀约定(_src来自馆藏、_ext外部获取、_gen流水线生成、_exp实验性),逐字段列出类型与功能(如crop_vlm_ocr_gen、crop_tesseract_ocr_gen含词级框、384维图像嵌入与256维文本嵌入等)。
使用、查询与复现该数据集的必备参照,也界定了哪些字段是实验性的。