Architect-Ant:面向建筑平面图的可编辑自动家具布置 Architect-Ant: Editable Automatic Furnishing of Architectural Floor Plans
从505张真实户型图SFT加GRPO规则奖励,直接生成可编辑家具布局并转3D场景
前置知识
GRPO 与 Dr. GRPO
GRPO(Group Relative Policy Optimization)是一种免价值网络的强化学习算法:对同一输入采样一组响应(本文每房间16个),用组内平均奖励作基线计算每个响应的相对优势,再做策略梯度更新,省去 PPO 的 critic。Dr. GRPO 变体进一步去掉逐组方差归一化,并用固定 token 数(本文1024)而非响应长度归一损失,避免长响应被系统性压低优势。
本文第二阶段训练完全建立在 Dr. GRPO 之上,只有理解组相对优势、KL 正则(系数0.001)与固定 token 归一化,才能读懂其训练配方和消融结果。
R1-Zero 式结果监督(outcome supervision)
DeepSeek-R1-Zero 证明:可以不给任何推理示范,只用基于规则的最终答案奖励做强化学习,模型会自发涌现推理能力。奖励只施加于解析出的最终结果,中间思维链不直接得分,模型自行发展解题策略。
本文把这一原则从数学推理迁移到家具布置:奖励 $R(r,y;x)=R(y;x)$ 只看最终 DSL 布局的 LRS,推理块无直接监督,这是理解其训练目标设计的关键。
LoRA 低秩适配微调
LoRA 冻结预训练权重 $W$,旁路注入低秩分解 $W + BA$(其中 $B\in\mathbb{R}^{d\times r}$、$A\in\mathbb{R}^{r\times k}$、秩 $r\ll d$),只训练少量新增参数,大幅降低显存与存储开销。本文对 Gemma-4-31B-it 的语言部分做 LoRA、冻结视觉编码器,且卧室/卫生间/厨房/客厅每个房间类型各训练一个独立适配器。
读懂 SFT 与 GRPO 阶段'每房间类型一个适配器'的设计、以及训练成本分析都依赖对 LoRA 机制的理解。
布局 DSL 与序列化表示
DSL 指领域特定语言。本文把一个布局表示为序列 $L=\{(c_i, x_i, y_i, w_i, h_i)\}_{i=1}^n$:对象类别 $c_i$ 加左上角坐标 $(x_i,y_i)$ 与宽高 $(w_i,h_i)$,单位为米、相对房间左上角、$y$ 轴向下。这种角点表示紧凑且对象级可编辑,包含、重叠、净空等约束可直接由坐标计算,也便于解析失败检测。
它同时是模型的输入输出接口、SFT 的监督目标和 LRS 的解析对象,贯穿数据、训练、评估、3D 转换全流程。
布局质量指标 COL+ / OOB / FUN+ / 可达对
COL+ 是类别感知过滤后涉及非法碰撞的对象比例——排除椅子推入桌下、地毯垫床下、水槽嵌柜内等有意重叠;OOB 是越出房间边界的对象比例;FUN+(功能完备率)衡量房间所需功能(睡觉、洗涤、做饭等)被'被容纳且可达'的对象支持的比例;Acc. pairs 衡量相关家具与门之间互相保持可达的比例。
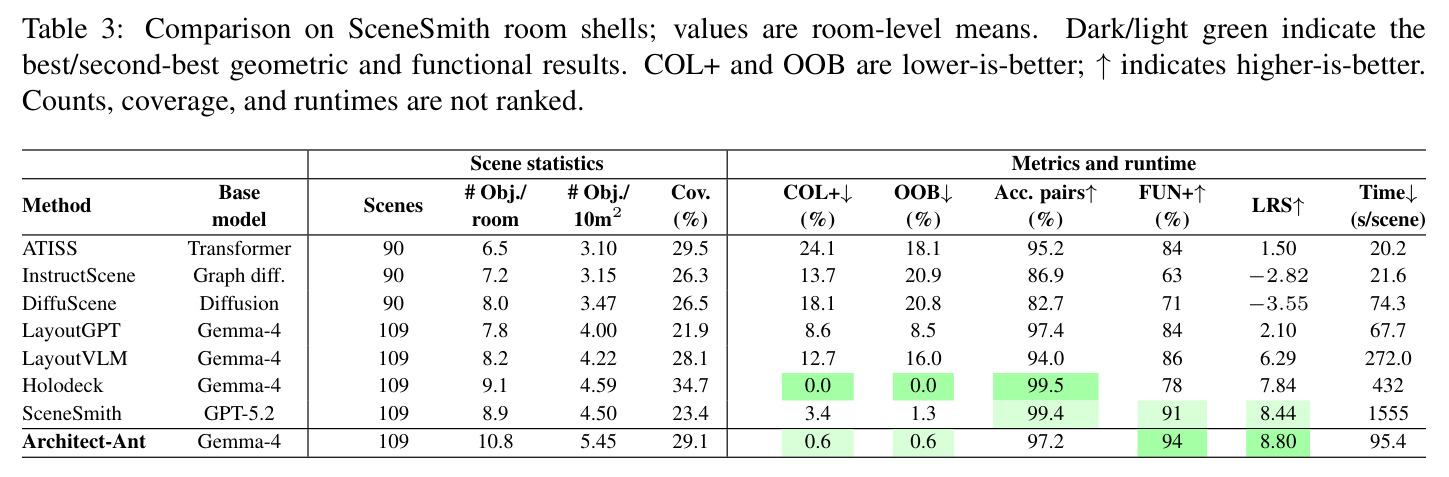
Table 3 的主结果全部由这些指标构成:例如 Holodeck 的 COL+/OOB 为 0.0% 但会堵门窗,不理解定义就无法解读'低碰撞不等于好布局'这一核心论点。
研究动机
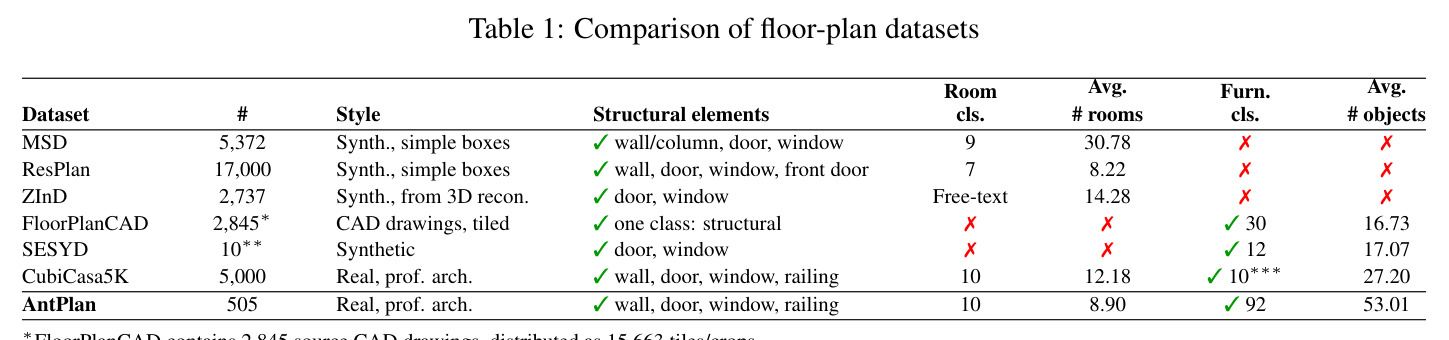
自动家具布置长期受制于两个瓶颈。其一是数据:现有 2D 户型数据集要么是合成数据——MSD(5,372 张)和 ResPlan(17,000 张)由简单盒子构成、完全没有家具标注;要么虽有真实专业图纸但类别太粗——CubiCasa5K(5,000 张)只有 10 个家具类、平均每图 27.2 个对象,连电器都不区分;3D 场景数据集(3D-FRONT、HSSD 等)投影成 2D 后也无法反映专业图纸的墙体、门窗、栏杆等构造规范。其二是约束满足:布置不只是家具放得进房间——床不能堵门、厨房电器和工作台面要构成可用组合、门窗必须保持可达,这些要求相互耦合,移动一个对象可能修好一处又破坏另一处。近年 agentic 方法(如 SceneSmith 的 planner–designer–critic 循环)靠迭代推理修正布局,但每轮 refinement 都推高成本:SceneSmith 默认每个 agent 预算高达 1,000 轮,估计每场景约 1,555 秒,难以实用。
本文的目标是本文要回答一个核心问题:能否让预训练模型直接从真实专业图纸中学会专业布置知识,在不依赖昂贵迭代式 agentic 推理的前提下,一步生成满足几何与功能约束的布局?具体目标有三:第一,构建 AntPlan 数据集——505 张真实专业住宅图纸,覆盖 92 个家具类、10 类住宅房间、平均每图 53.01 个密集家具标注,家具类别数远超现有数据集(CubiCasa5K 的 10 类);第二,提出 Architect-Ant 框架:用可编辑的坐标式 DSL 表示布局,先监督微调学习专业布置模式,再用基于规则奖励的 GRPO 强化学习优化布局质量;第三,保证生成结果保持对象级可编辑,并能直接转换为带家具的 3D 场景,服务房产可视化、室内设计与建筑工作流。
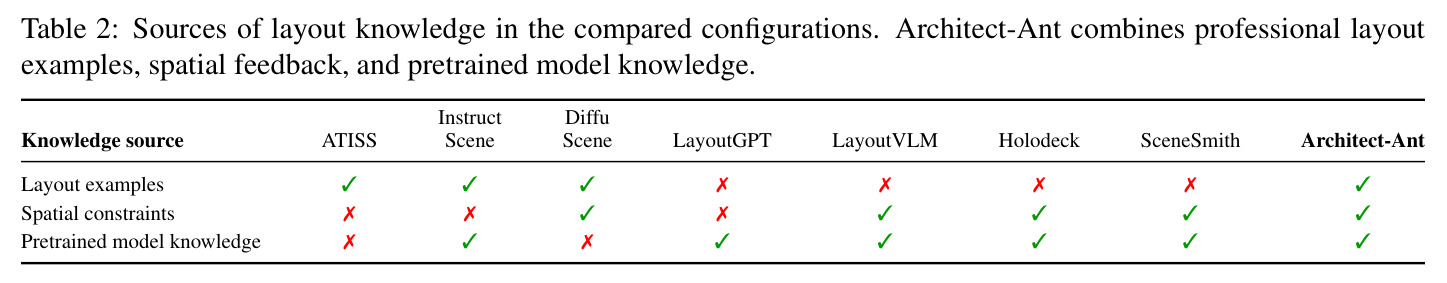
与已有工作不同的是,布置知识有三个互补来源:布局数据提供示例、显式空间约束使几何功能需求可计算、预训练模型贡献语义与语境知识。已有方法要么只用其一(ATISS、DiffuScene 只用数据;LayoutGPT 零样本只用预训练模型),要么在推理时组合——Holodeck 靠搜索、LayoutVLM 靠约束程序优化、SceneSmith 靠多轮 critique 修订,代价都是推理慢、成本高。本文的独特切入是把三种知识全部前移到训练阶段融合:用 AntPlan 真实图纸做 SFT,用从专业布局中校准出的 Layout Rule Score 做 GRPO 奖励,并遵循 R1-Zero 的结果监督原则——奖励只施加于最终布局、不规定中间推理轨迹,让模型自行发展满足空间需求的策略。LRS 的规则参数、类别集合与豁免都从 AntPlan 标注校准,不要求复现某个特定参考布局。
核心方法
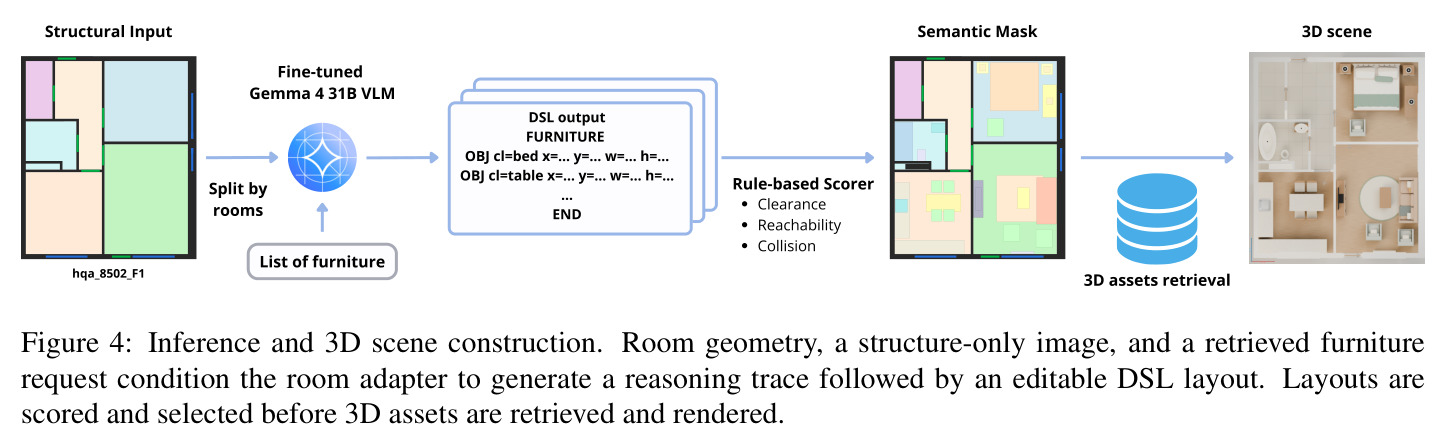
直觉上该方法像'先模仿、再应试':先让模型在 505 张真实专业图纸上模仿设计师的布置(SFT),再用一个确定性'阅卷老师'——Layout Rule Score(LRS)——给模型自己生成的布局打分,通过 GRPO 把分数变成改进信号。技术上,布局表示为可编辑序列 $L=\{(c_i, x_i, y_i, w_i, h_i)\}_{i=1}^n$,即类别加左上角坐标与宽高、单位米。骨干是 Gemma-4-31B-it 多模态模型:第一阶段用 LoRA 微调语言部分(视觉编码器冻结),训练目标是 token 级交叉熵、只含最终 DSL 布局、无推理轨迹;第二阶段是 Dr. GRPO 风格训练,每房间采样 16 个响应、每批 8 个房间共 128 个 on-policy rollout,奖励为最终布局的 LRS 加少量辅助项(尺寸偏差、门控同类相似度、响应有效性),共训练 15 次更新、学习率 $2\times10^{-5}$、KL 系数 0.001(对冻结基座正则)。推理时对每个房间按 LRS 排序候选直接择优,无任何模型自评修订回路,随后检索 3D 资产渲染成场景。
核心创新是把'布局数据 + 空间规则 + 预训练知识'三者在训练期而非推理期融合,并以结果级监督取代过程监督。与 SceneSmith 等依赖推理时 critique-修订循环的方法有本质区别:Architect-Ant 推理时直接生成候选、按原始 LRS 排序,没有迭代修正回路,因此每房间仅需约 95.4 秒。LRS 是确定性、房间感知的规则评分:$S(L;x)=10-\sum_k p_k(L,x)$,从 10 分起步、按违反的规则实例扣分、下界无界,共实现 33 类规则,覆盖房间包含、墙体重叠穿越、门窗阻挡、非法家具重叠、库存不匹配、可达性,以及电器安装、厨房操作列、工作区、焦点座位、窗户遮挡、墙面贴合、洁具—家具关系等房间特定功能关系,并保留地毯铺床下、水槽嵌柜内等类特定豁免;典型验证房间需 50–200 次谓词评估。GRPO 遵循 R1-Zero 原则只奖励最终布局,配合 Dr. GRPO 的去方差归一化与固定 1024 token 损失归一,让推理自由生长而不被规定。
方法步骤详情
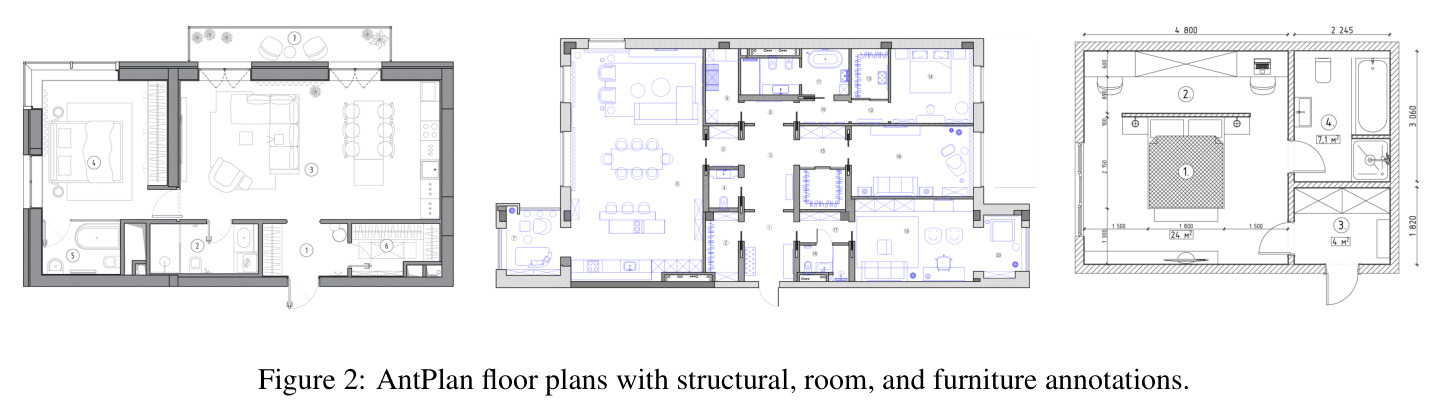
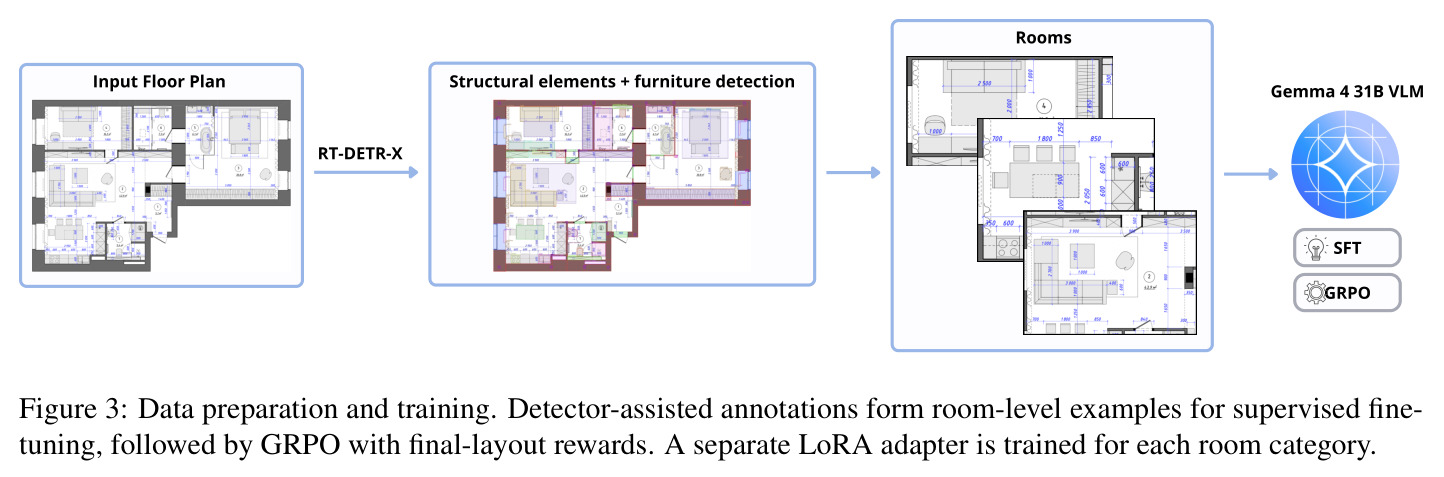
第一步数据构建:用在 CubiCasa5K 上训练的 RT-DETR-X 检测墙、门、窗、栏杆,房间标签人工分配;家具检测器从手工标注子集自举后推广到其余图纸,再经人工复核,得到 505 张图纸、92 类家具、平均 53.01 对象/图的 AntPlan;实验子集含 2,259 个训练房间和 243 个验证房间,同一图纸的房间不跨集。第二步输入编码:文本给出房间尺寸、结构元素和家具请求(类别、数量、大致尺寸),视觉输入为不含目标家具的结构-only 栅格图。第三步 SFT:对语言模型做 LoRA、冻结视觉编码器,损失只算在家具 DSL 和结束符 token 上,prompt、图像与 padding 位置掩码。第四步 GRPO:奖励 $R(r,y;x)=R(y;x)$ 只由解析出的最终布局决定;优势按房间组均值中心化、以池化标准差缩放并裁剪到 $[-2,2]$;无解析家具的答案给固定负奖励。第五步推理:检索同类型相似尺寸训练房间的标注构造家具请求,每请求采样 5 个布局、共 20 个候选取 LRS 最高者。第六步 3D 化:按类别尺寸检索资产、贴合 footprint、由墙体与家具关系推断朝向并保留资产高度。
技术新颖性
技术新颖性体现在四个层面。其一,数据层面:AntPlan 是首个在真实专业建筑图纸上提供 92 类密集家具标注的数据集,填补了'真实图纸 + 细粒度家具'的空白(对比 CubiCasa5K 的 10 个粗类别、FloorPlanCAD 的 30 类 CAD 符号)。其二,训练范式层面:将 R1-Zero 的结果监督原则从文本推理迁移到空间布局生成——奖励只看最终 DSL 布局、推理无直接监督,让模型自发发展空间策略,这与需要 prescribed reasoning traces 或推理时迭代修订的方法截然不同。其三,奖励工程层面:LRS 把 33 类几何与功能规则(含房间特定策略和类特定豁免)转化为可计算标量奖励,参数从专业标注校准而非对齐某个参考布局,属于 outcome-level 的领域规则奖励设计。其四,训练技巧层面:完整采用 Dr. GRPO 的去方差归一化、固定 1024 token 损失归一、冻结基座的 KL 正则,并把推理 token 与布局 token 一起接受优势更新。相比 OptiScene 的偏好优化,本文用标量规则奖励直接优化,信号更透明可控。
实验结果
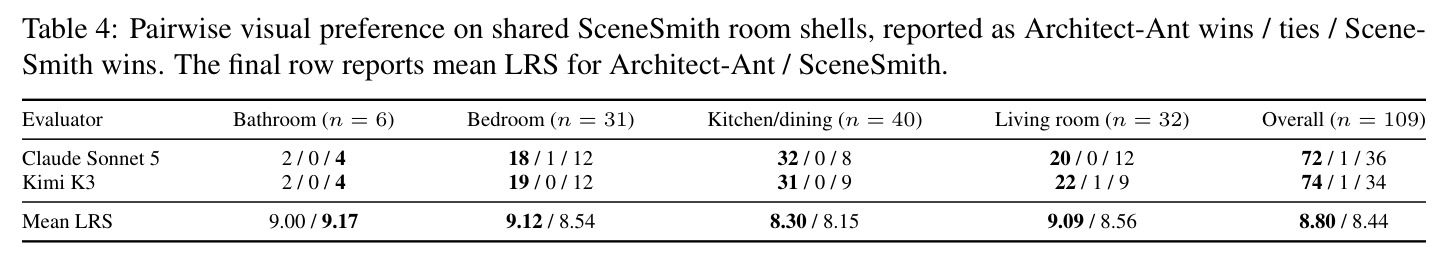
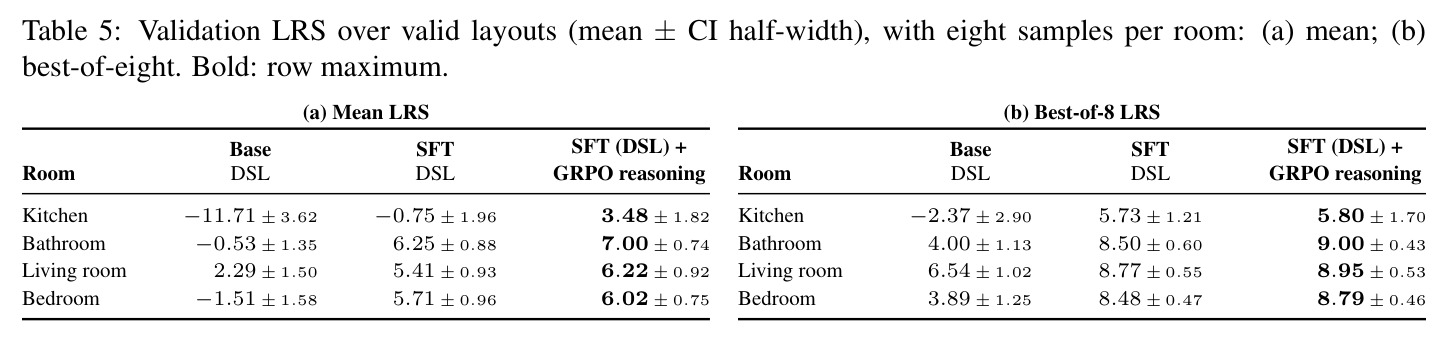
在 109 个 SceneSmith 房间壳(31 卧室、32 客厅、27 餐厅、13 厨房、6 卫生间)上,Architect-Ant 取得最高 LRS 8.80(SceneSmith 8.44、Holodeck 7.84)和最高功能完备率 FUN+ 94%(SceneSmith 91%),碰撞率 COL+ 与越界率 OOB 均仅 0.6%(对比 LayoutGPT 的 8.6%/8.5%),可通达对象对 97.2%(最高为 Holodeck 的 99.5%);每房间 10.8 个对象、覆盖率 29.1% 均为最高,说明几何干净并非靠稀疏布局换取。效率上约 95.4 秒/房间,比 SceneSmith 的 1,555 秒快约 16 倍,也远快于 Holodeck(432 秒)和 LayoutVLM(272 秒)。VLM 视觉偏好测试中,Claude Sonnet 5 在 72/109、Kimi K3 在 74/109 个房间更偏好本文方法,厨房/餐厅最强(32/40 与 31/40),但卫生间 SceneSmith 以 4/6 反超。消融(243 个验证房间、每房间 8 样本)显示 SFT→SFT+GRPO 使均值 LRS 从厨房 $-0.75$ 升至 3.48、卫生间 6.25→7.00、客厅 5.41→6.22、卧室 5.71→6.02,best-of-8 亦全面提升;未经训练的基座直接输出 DSL 在厨房低至 $-11.71$,证明 SFT 与 GRPO 缺一不可。
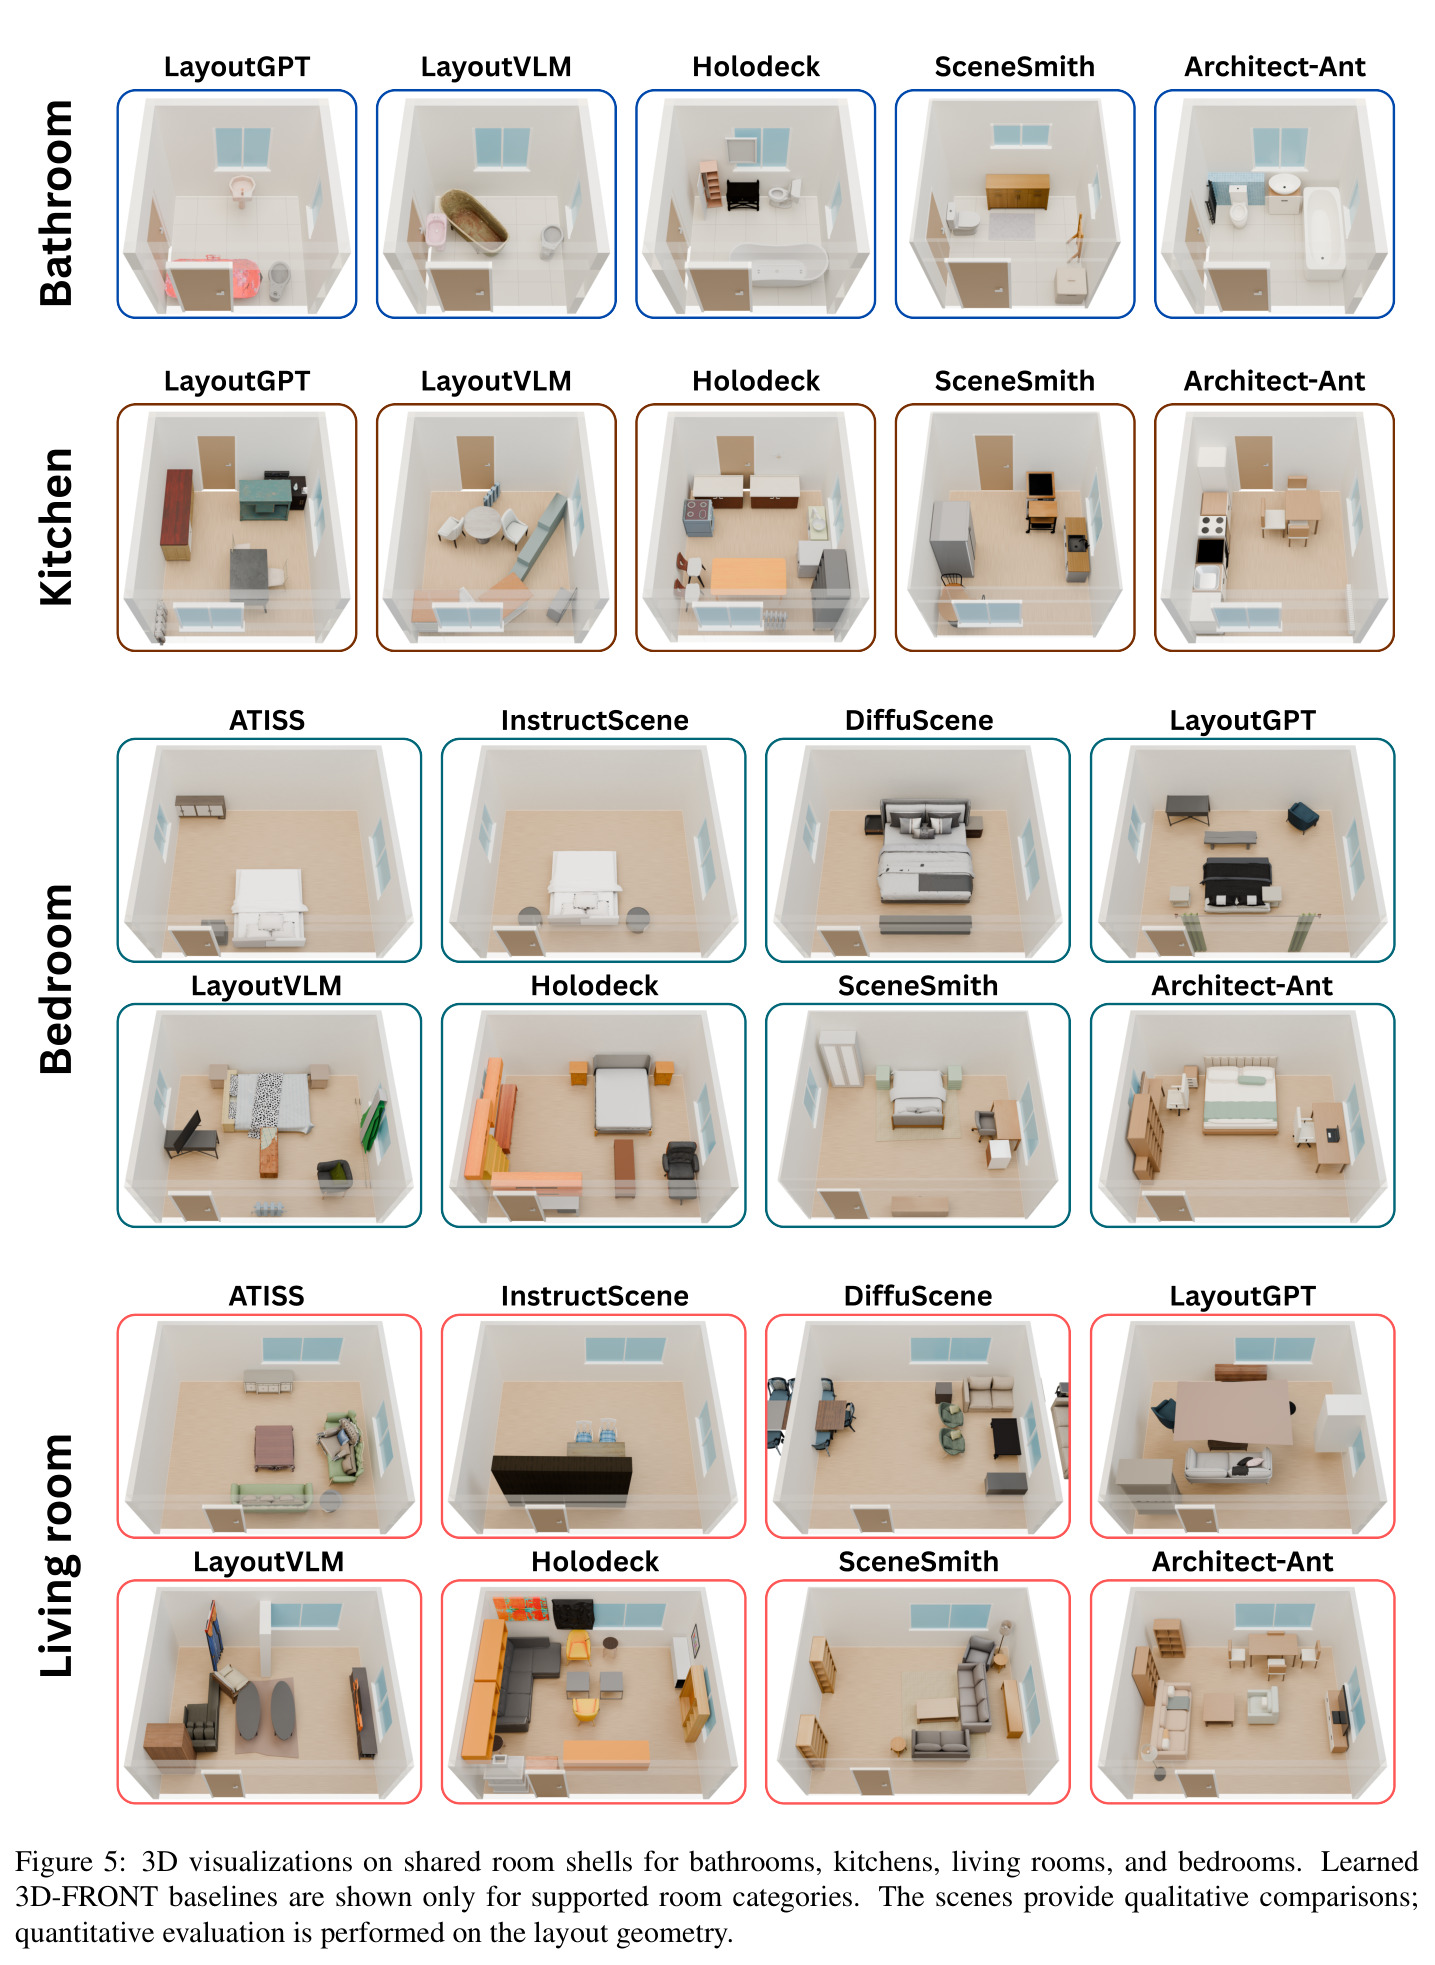
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SceneSmith 房间壳家具布置(109 房间) | LRS 布局规则得分(越高越好) | 8.80 | SceneSmith 8.44 / Holodeck 7.84 / LayoutVLM 6.29 | 较最强基线 SceneSmith +0.36,较基于同骨干的 Holodeck +0.96 |
| SceneSmith 房间壳家具布置 | FUN+ 功能完备率 | 94% | SceneSmith 91% / LayoutVLM 86% / ATISS 84% | +3 个百分点,所有方法中最高 |
| SceneSmith 房间壳家具布置 | COL+ 类别感知非法碰撞率(越低越好) | 0.6% | SceneSmith 3.4% / LayoutGPT 8.6% / InstructScene 13.7% | 接近零碰撞,仅高于刻意稀疏布置的 Holodeck(0.0%) |
| SceneSmith 房间壳家具布置 | 推理时间(秒/场景,越低越好) | 95.4 | SceneSmith 1555(归一化估计)/ Holodeck 432 / LayoutVLM 272 | 比 SceneSmith 快约 16 倍 |
| 双 VLM 匿名视觉偏好(109 房间 A/B 对比) | 偏好胜场 | Claude Sonnet 5: 72 胜 / Kimi K3: 74 胜 | SceneSmith 分别 36 / 34 胜(各 1 平局) | 约 2:1 的整体偏好优势,厨房/餐厅最强(32/40、31/40) |
| AntPlan 验证集(243 房间,均值 LRS) | 厨房房间 SFT→SFT+GRPO | -0.75 → 3.48 | 基座直接 DSL 输出 -11.71 | GRPO 阶段 +4.23,SFT+GRPO 较基座 +15.19 |
局限与改进
作者明确承认:LRS 只度量其编码的几何与功能属性,不衡量美学、也不保证 3D 完全可用;满分 10 分只表示'未违反已编码规则'而非理想布局;分数下界无界,极端负值难以解读。评估设置上,主表只保留 SceneSmith 中属于本文 53 类评估分类的资产,餐厅房间借用厨房的 LoRA 设置,ATISS/InstructScene/DiffuScene 只覆盖 90 个房间壳且得不到目标壳几何,比较并非完全对齐。我的观察:训练用 LRS、主指标也是 LRS,存在自评循环风险,虽有双 VLM 偏好旁证,但卫生间仅 6 个样本且 SceneSmith 以 4/6 逆转;92 类家具却按四类房间各挂一个独立 LoRA,跨类型泛化与全屋多房间联合布置未验证;家具请求来自相似房间检索而非用户意图,真实设计场景的指令服从能力未知;朝向由启发式推断而非模型预测,复杂布局下可能出错;2,259 个训练房间相对 92 类家具仍偏小,长尾类别覆盖存疑。
独立分析的弱点
弱点一:LRS 的 33 类规则由人工设计并从 AntPlan 校准,规则之外的质量维度(美学、风格一致性)无法被奖励捕捉,模型可能对规则过拟合甚至钻空子,改进方向是在规则奖励之外加入可学习偏好模型或可微规则损失。弱点二:每个房间类型单独训练一个 LoRA 适配器,新增房间类型(书房、储物间)需重新收集数据并训练,工程成本高,可改为统一的类型条件化单模型。弱点三:数据管线依赖检测器自举加人工复核,505 张图纸的标注成本高且可能有系统性检测偏差(小件家具漏标、检测器继承 CubiCasa5K 域偏差),可用主动学习或更强开放词汇检测器降低人工量。弱点四:家具请求来自相似房间检索而非用户需求,落地时用户往往想指定'双人床加书桌',需要研究指令条件化生成与约束遵守。弱点五:best-of-n 选择依赖每房间 20 个候选的 LRS 排序,房间更复杂、规则断言数超过现有 50–200 次范围时评分器可扩展性未讨论。弱点六:评估的几何指标全部在 2D 投影上计算,资产高度、吊灯与吊柜等 3D 冲突完全不可见。
未来方向
作者提出的方向:把框架扩展到更多对象与场景属性、更丰富的几何、更详细的空间关系,同时保持结构化、可编辑的生成。基于本文成果可自然延伸:其一,全屋级联合布置——当前按房间独立生成,可引入跨房间约束(动线、户型级功能分区),用图结构或自回归房间序列建模;其二,交互式编辑工作流——DSL 天然对象级可编辑,可做局部修改后用 LRS 做局部重排,形成人机协同设计工具;其三,把 LRS 式规则奖励范式迁移到其他结构化空间生成任务,如电路板布局、仓储货位、舞台与展厅布置;其四,奖励端加入可学习的美学信号与 3D 可用性检查(净空、人形导航网格),弥补纯 2D 规则盲区;其五,统一多房间类型单模型并支持自然语言家具指令,向真实室内设计产品演进;其六,先在大量合成图纸上预训练再以 AntPlan 精调,缓解真实专业数据稀缺;其七,研究 GRPO 奖励与推理长度的关系——本文推理自由生长,但更长推理是否持续带来更高 LRS 值得系统分析。
复现评估
复现难度中等偏高。数据侧:AntPlan 依赖在 CubiCasa5K 上训练的 RT-DETR-X 检测器、自举的家具检测器和人工复核,505 张图纸的标注工作量大;正文未明确说明数据集与代码是否开源,是复现的最大不确定因素。规则侧:LRS 的 33 类完整定义、阈值与可达性构造在附录 C,训练超参在附录 B,但规则引擎的具体实现代码是关键瓶颈——重写并重新校准 33 类规则工作量可观。算力侧:基座为 Gemma-4-31B-it 加 LoRA(视觉编码器冻结),GRPO 每步 128 个 rollout、共 15 次更新,评估在两张 NVIDIA H100 80GB 上进行(所有候选生成与场景构建计入 95.4 秒),训练所需总显存未明说,估计需要多卡 H100 级资源。若作者放出 AntPlan 与 LRS 实现,规则评估是确定性 Python 逻辑、复现可行性高;否则需按附录重建整套标注管线和规则库,适合有较强工程团队跟进。
论文图表
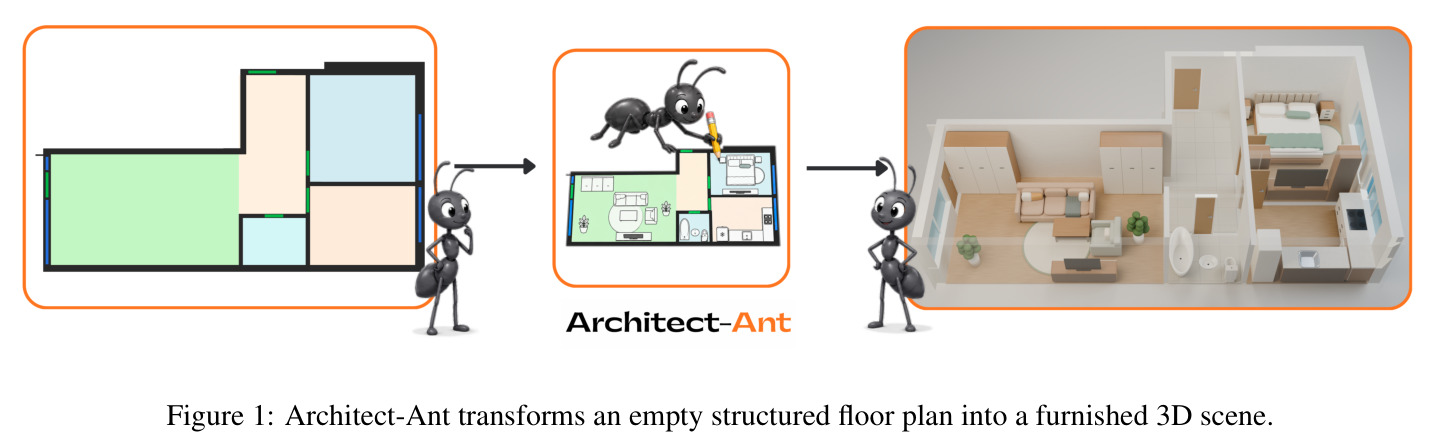
开篇总览图:左侧是空的结构件户型图(墙、门、窗、栏杆),经 Architect-Ant 生成家具布局后转换为右侧带家具的 3D 场景,右上角标注任务域标签 [cs.AI]。
一图概括全文任务定义与最终交付物:从结构化 2D 户型到可编辑布局再到 3D 场景,是向读者建立整体直觉的第一入口。