LongR:用密集效用奖励释放长上下文推理能力 LongR: Unleashing Long-Context Reasoning via Reinforcement Learning with Dense Utility Rewards
以相对信息增益密集奖励与思考-阅读交错机制强化长上下文推理
前置知识
可验证奖励强化学习(RLVR)与 DAPO
RLVR 指不训练奖励模型,而用规则直接验证输出(如答案是否正确、格式是否符合 $\langle think\rangle...\langle/think\rangle$ 结构)来给奖励。DAPO 是其中的代表算法,对同一问题采样一组(rollout)回答,用组内相对优势替代价值网络,并采用 clip-higher 等技巧稳定训练。本文以 DAPO 为主干算法,并验证 GSPO、CISPO 同样适用。
LongR 的整个训练框架建立在 DAPO 之上,所有增益都是在 DAPO 基线之上叠加出来的,不理解组相对优势机制就无法理解奖励如何作用于策略。
稀疏奖励问题(Reward Sparsity)
outcome-only 奖励只在整条回答末尾给一个标量(答对/答错)。在长上下文任务中,推理链横跨数万 token 的搜索空间,末端的单一信号传回早期证据定位步骤时梯度几乎消失,模型学不到“去哪里找证据”,只能做表面关键词匹配。
这正是本文要解决的核心痛点:LongR 的全部贡献都是围绕“如何在不引入可被 hack 的奖励模型的前提下把奖励变密”展开的。
点态信息增益(Pointwise Information Gain)
信息论中衡量“知道 $c$ 之后对事件 $s$ 的不确定度下降多少”的量,点态版本即 $\log \frac{P(s|c)}{P(s)}$。本文用它来定义“模型引用的这段文字是否真的来自文档、是否与问题相关”:若上下文真的支持该片段,条件似然会显著高于无条件先验似然。
LongR 的密集奖励 $r_{ctx}$ 就是归一化的点态信息增益,理解它是理解方法核心的第一步。
负对数似然(NLL)
语言模型对序列 $s=(x_1,...,x_T)$ 的平均 NLL 定义为 $L(s|\mathrm{ctx}) = -\frac{1}{T}\sum_{t=1}^{T} \log \pi_{\mathrm{ver}}(x_t|x_{<t}, \mathrm{ctx})$,数值越低表示模型越能预测这段文本。NLL 之差是互信息的标准代理指标。
验证器对所有引用片段分别计算“无条件 NLL”和“以问题+文档为条件的 NLL”,两者之差经归一化后就是密集奖励,公式细节全在 NLL 上。
冻结验证器(Frozen Verifier)
一个参数固定、不参与梯度更新的小语言模型(本文用 Qwen3-4B),仅在训练时对引用片段做前向打分。因为不更新参数,它不会被策略“讨好”而漂移,避免了学习型奖励模型的 reward hacking 与协同进化开销。
LongR 与 EAPO 等黑盒代理奖励的本质区别就在于奖励来自这个白盒冻结模型,论文还专门消融了验证器规模(1.7B/4B/32B)。
课程学习(Curriculum Learning)
把训练任务按难度(此处为文档长度 $L_m = \min(L_{max}, L_0 \cdot 2^m)$)从易到难分阶段呈现:先在 16K 上下文学会核心技能,再扩到 32K。每阶段固定训练步数,逐步提升而不直接暴露最长样本。
LongR 完全不使用长上下文专用 SFT 演示数据,“边想边查”行为纯靠 RL 从通用数据涌现,课程设计是这种渐进涌现能稳定发生的关键。
长上下文评测基准
LongBench v2:真实场景长文多选题,按难度(Easy/Hard)和长度(Short <32K / Medium 32-128K / Long >128K)划分;RULER:合成任务测试有效上下文窗口,含大海捞针(NIAH)、变量追踪(VT)、多跳问答(QA);InfiniteBench:超长文异构任务(检索、摘要、中英 QA、多选推理)。
论文所有结论都以这三个基准上的具体数字呈现,看懂表格需要知道每个基准考什么、指标是什么。
研究动机
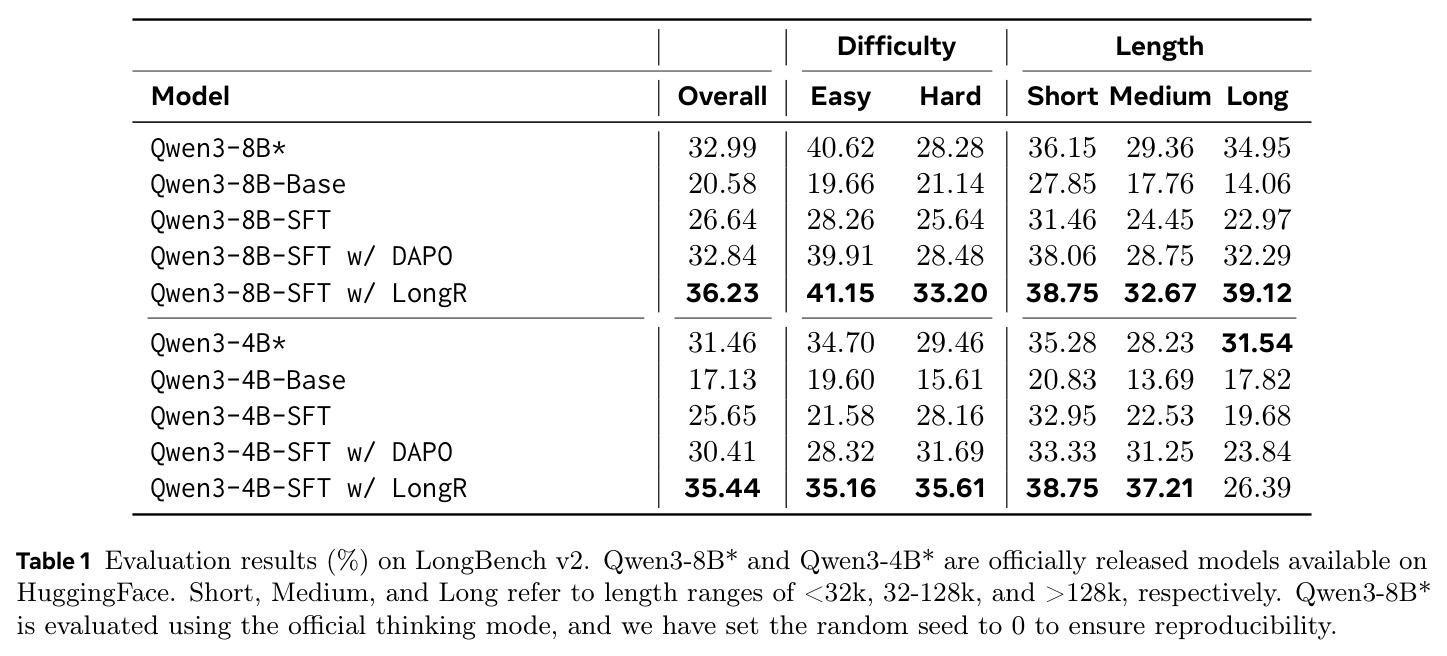
强化学习驱动数学推理已经成熟,但把它搬到长上下文场景——长对话理解、结构化数据分析、仓库级代码——时,仅靠 outcome-only 的稀疏奖励收益有限:LongRLVR 指出长推理链下末端单一信号对“证据定位”的梯度几乎消失,模型学会的是表面查询匹配而非真正阅读文档。LongRLVR 的补救是把文档预切分成离散块、让策略输出块 ID,但这有两个结构缺陷:(1) 信息完整性风险——刚性切块可能割裂证据,且需人工构造特殊格式数据,偏离主流后训练分布和自然用户查询;(2) 打断推理流——“查找”与“推理”被解耦成离散标签生成,破坏自然语言思维链。另一条路是学习型奖励(如 EAPO 训练黑盒代理给证据打分),但不稳定且需昂贵的奖励-策略协同进化。作者实测印证了稀疏奖励的局限:Qwen3-8B SFT 后 LongBench v2 仅 26.64%,outcome-only DAPO 提到 32.84%,Hard 子集 25.64→28.48、Long 子集 22.97→32.29,提升有限。
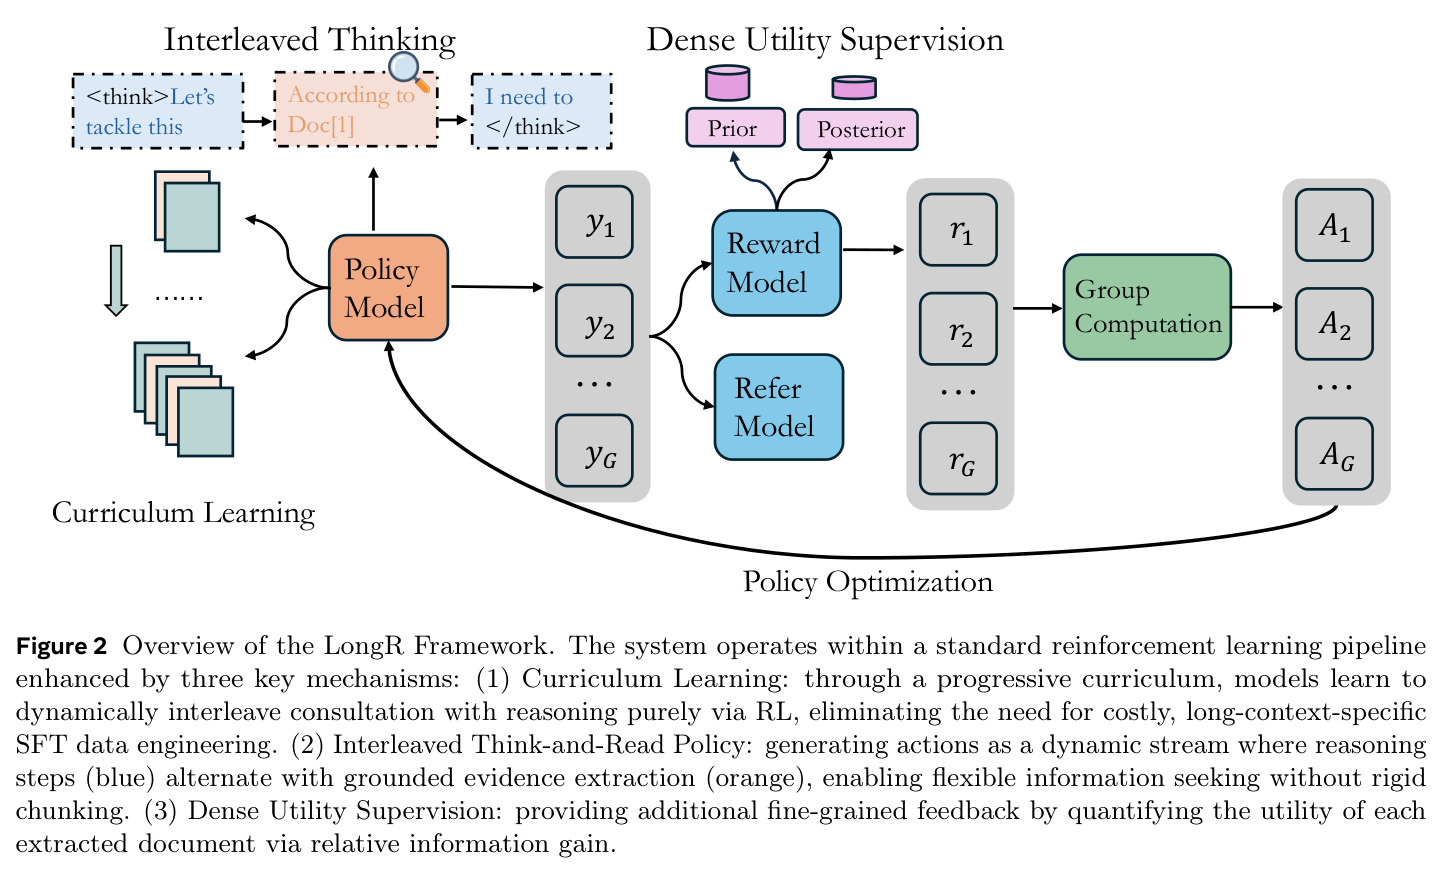
本文的目标是本文的目标是构建一个完全不依赖文档切块、不依赖长上下文专用标注数据、严格运行在标准自回归生成之内的长上下文 RL 框架 LongR。具体拆成三个子目标:(1) 设计动态“Think-and-Read”机制,把证据查找以内联引用的形式直接织入思维链,让模型像人一样边推理边查阅原文;(2) 提出免标注的上下文密集奖励——用相对信息增益量化模型所引证据的信息效用,弥补稀疏结果奖励在长上下文中的信号缺失;(3) 用长度渐进课程让“边想边查”模式从通用易得的数据中通过纯 RL 涌现,无需构造任何“先查阅后推理”的演示数据。量化目标是:在 LongBench v2 上取得约 9% 的整体提升,并在 RULER、InfiniteBench 上展示泛化性,同时兼容 DAPO、GSPO、CISPO 等多种 RL 算法。
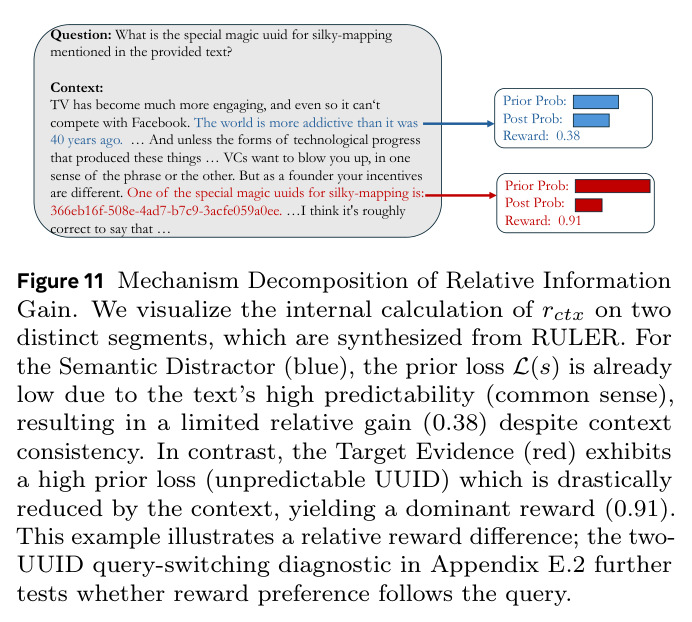
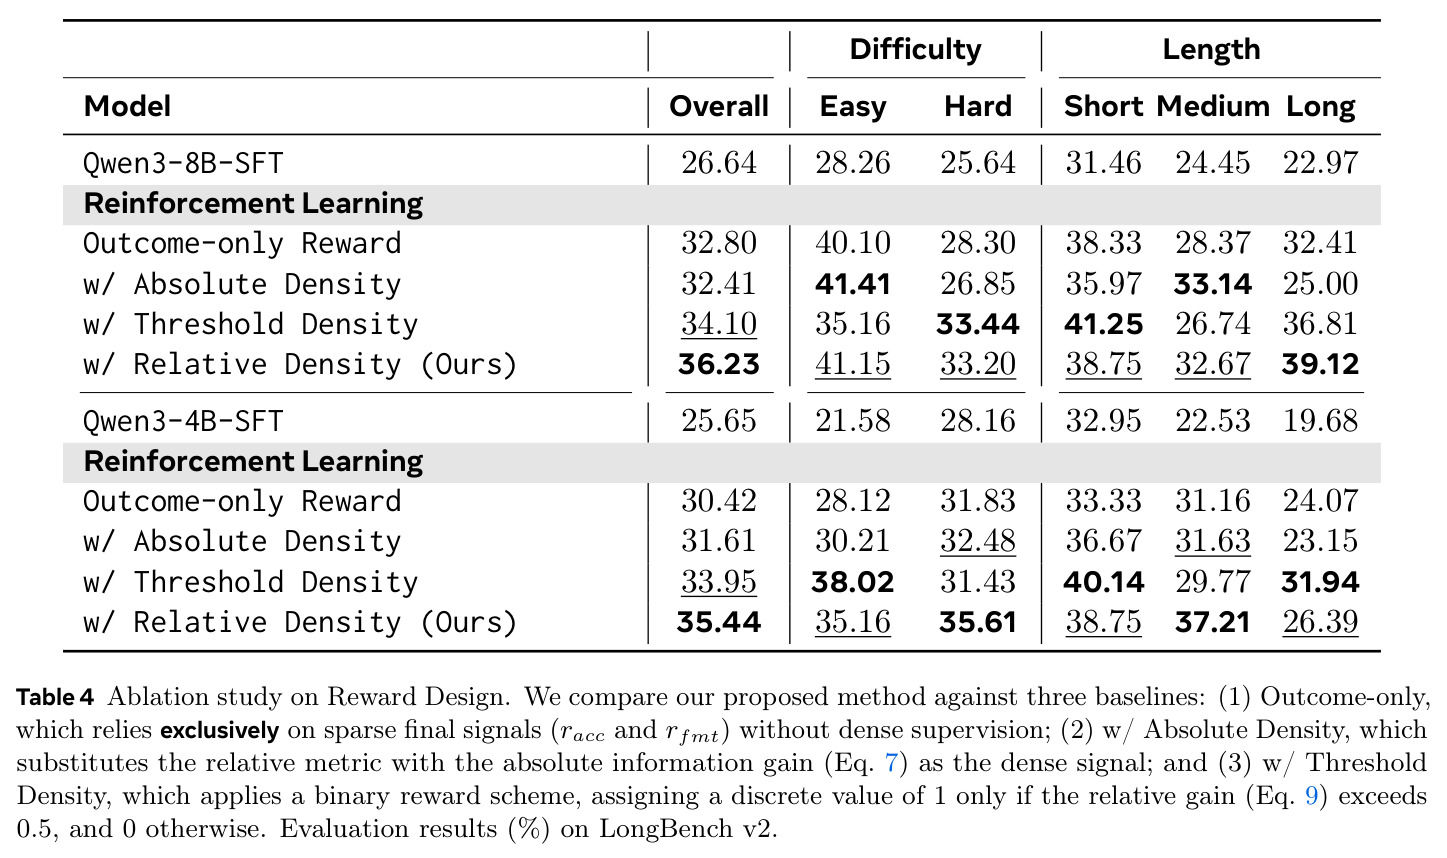
与已有工作不同的是,本文的独特切入点是把“模型是否真的读了文档”转化为一个可计算的概率问题:如果引用片段 $s$ 真的是支撑答案的文档内容,那么以(问题 $x$、文档 $c$)为条件时 $s$ 的 NLL 应显著低于无条件先验 NLL。基于这一视角,奖励设计成相对信息增益 $r(s,x,c) = 1 - L(s|x,c)/L(s)$——一个白盒、免标注、免训练的信息论指标,只需冻结的 Qwen3-4B 验证器做一次前向即可打分。这与两条已有路线形成鲜明对照:对 LongRLVR,LongR 不改变动作空间(引用是自然语言而非块 ID),保住了数据完整性和思维链连贯性;对 EAPO,LongR 不训练任何黑盒奖励代理,从根上规避了 reward hacking 的参数漂移与协同进化成本。更关键的是“相对化”这步归一化:消融实验显示绝对信息增益(32.41)反而不如纯结果奖励(32.80),只有除以先验不确定度的相对版本(36.23)才能既防作弊又有细粒度区分度。
核心方法
直觉上,人类读长文档时会边读边摘录关键句,LongR 把这一行为嵌进生成过程:系统提示要求模型在 $\langle think\rangle$ 内推理,遇到相关信息用方括号逐字引用原文,最后在 $\langle answer\rangle$ 作答。训练分两阶段:冷启动用 2 万条 AM-DeepSeek-R1-0528-Distilled 通用指令样本做 SFT(LLaMA-Factory,峰值学习率 2e-5、warmup 0.03、序列 16384、900 步),只注入领域知识和 $\langle think\rangle$ 结构,不含长上下文专用数据。随后用 verl 跑 DAPO 强化学习,总奖励 $r_{total} = r_{fmt} + r_{acc} + r_{ctx}$:格式奖励 1.0、答案正确 2.0、上下文密度奖励 $r_{ctx}$ 由冻结的 Qwen3-4B 验证器对每条引用计算相对信息增益后取平均。数据沿用 MemAgent 方式按长度合成(16K/32K 各 1000 条),第二阶段混入 DocQA-RL-1.6K。课程分两阶段,上下文上限从 16K 增到 32K,每阶段 100 步、常数学习率 1e-6、batch 8、rollout 16、最大输出 4096、Ulysses 序列并行 2,训练在 16 张 NVIDIA H20 141GB 上完成。
核心创新是把“引用片段的条件似然变化”作为是否真正利用文档的可计算代理。冻结验证器对 $T$ 个 token 的引用段计算 $L(s|\mathrm{ctx}) = -\frac{1}{T}\sum_{t=1}^{T}\log \pi_{\mathrm{ver}}(x_t|x_{<t}, \mathrm{ctx})$,先验 $L(s)$(不带问题与文档)与后验 $L(s|x,c)$ 之差为绝对信息增益,再除以先验做尺度不变归一化:$r(s,x,c) = \frac{L(s)-L(s|x,c)}{L(s)} = 1 - \frac{L(s|x,c)}{L(s)}$。轨迹级奖励取所有唯一引用的平均,$K=0$ 时置 0。与已有方法的本质区别有三:奖励来自冻结验证器的似然而非学习型奖励模型,无被策略“讨好”而漂移的风险;相对化后奖励有上界 1 且不受文本固有复杂度影响——常识句先验 NLL 本就低、即使上下文相关增益也小,UUID 类高熵片段被文档命中后奖励高达 0.91,天然过滤“抄长文刷分”;引用是内联自然语言而非离散块 ID,不破坏标准自回归生成和主流后训练分布。
方法步骤详情
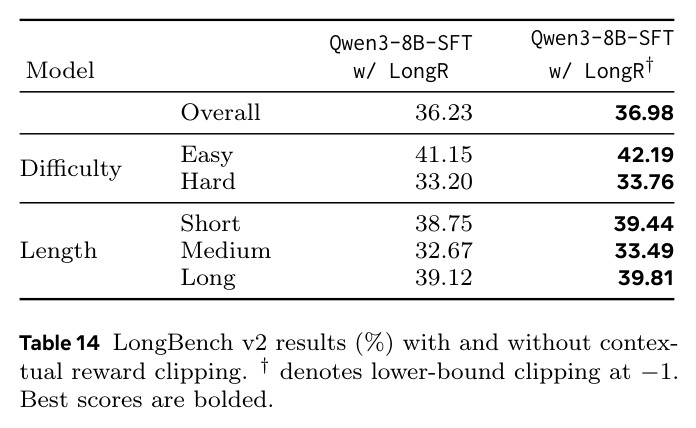
流程六步。第一步 SFT 冷启动:输入 2 万条 AM-DeepSeek-R1-0528-Distilled 指令样本,输出掌握 $\langle think\rangle...\langle/think\rangle\langle answer\rangle...\langle/answer\rangle$ 结构的初始策略,LLaMA-Factory 训 900 步。第二步交错生成:rollout 时套用 Figure 4 提示模板,要求模型在思维链中找到相关内容就用方括号逐字引用原文。第三步引用抽取:按附录 B 的确定性规则从方括号 [...] 解析出 $K$ 条引用段 $s_1,...,s_K$ 并去重。第四步验证器打分:冻结 Qwen3-4B 对每条引用分别算无条件 NLL $L(s)$ 与条件 NLL $L(s|x,c)$,得 $r(s,x,c)=1-L(s|x,c)/L(s)$。第五步聚合与总奖励:$r_{ctx}$ 取平均,$r_{total}=r_{fmt}+r_{acc}+r_{ctx}$(权重 1.0/2.0),进入 DAPO 组相对优势计算(rollout 16)。第六步课程推进:阶段 $m$ 的上限 $L_m=\min(L_{max}, L_0\cdot 2^m)$,16K→32K 各训 100 步,第二阶段加入 DocQA-RL-1.6K;附录 I 还给出下界裁剪变体 $r_{clip}=\max\{-1,r\}$,把 Overall 从 36.23 提到 36.98。
技术新颖性
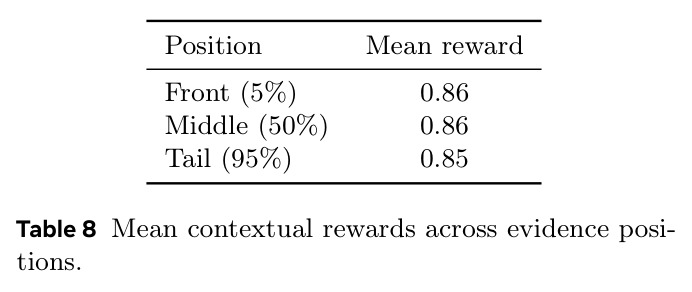
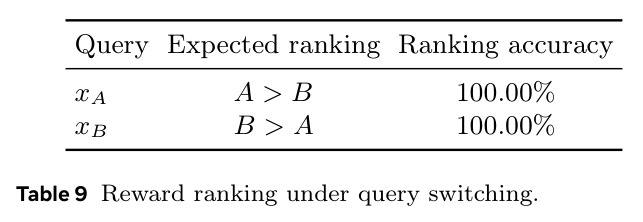
新颖性有三层。其一,动作空间不变:引用以自然语言内联在思维链中,而 LongRLVR 需要预切块和离散块 ID 输出,附带人工数据构造开销;LongR 的“Think-and-Read”模式无需任何长上下文专用 SFT 演示,纯靠 RL 从通用数据涌现。其二,白盒信息论奖励:相对信息增益由冻结验证器一次前向算出,不训练奖励模型,与 EAPO 的黑盒代理(需昂贵的奖励-策略协同进化循环)形成方法论对照,也延续了 DeepSeek-R1 以来“可验证奖励防 hacking”的思路,只是把可验证信号从最终答案扩展到中间证据。其三,归一化设计本身有独立价值:消融证明 Absolute Density(32.41,低于 outcome-only 的 32.80)会被策略用冗长怪异引用抬高先验熵来作弊,Threshold Density(34.10)一刀切无法区分中等相关与精准证据,只有 Relative 版本(36.23)兼得防作弊与细粒度区分——且该奖励对证据位置(前/中/尾平均 0.86/0.86/0.85)不敏感、查询切换排名准确率 100%,信号质量扎实。
实验结果
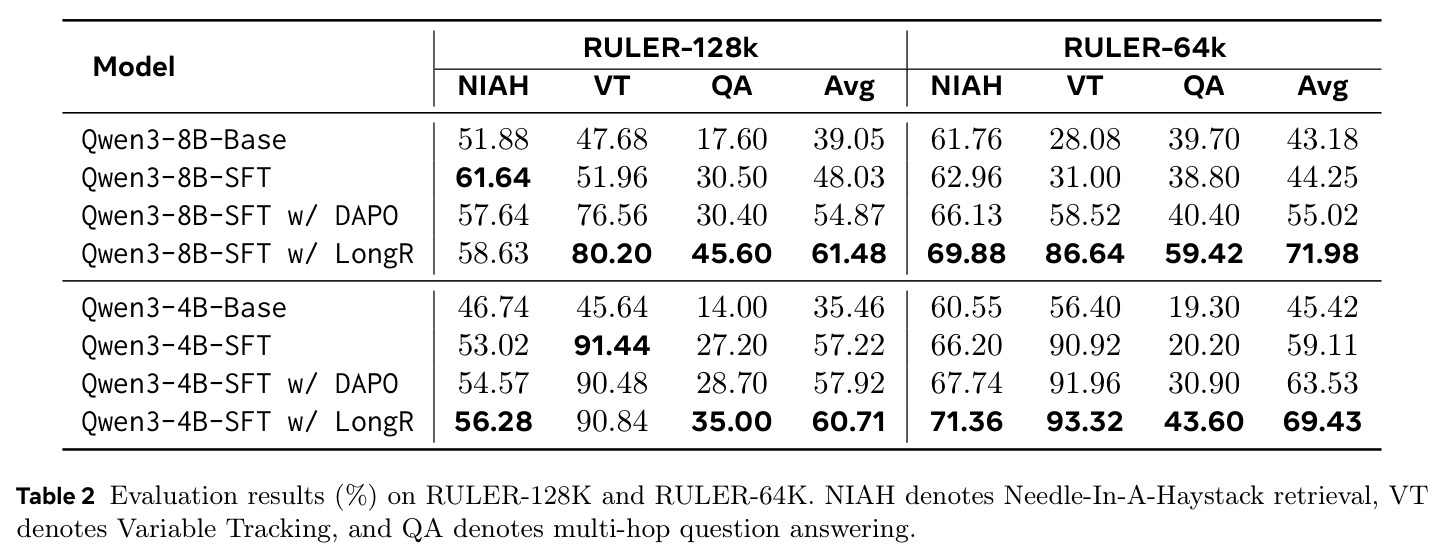
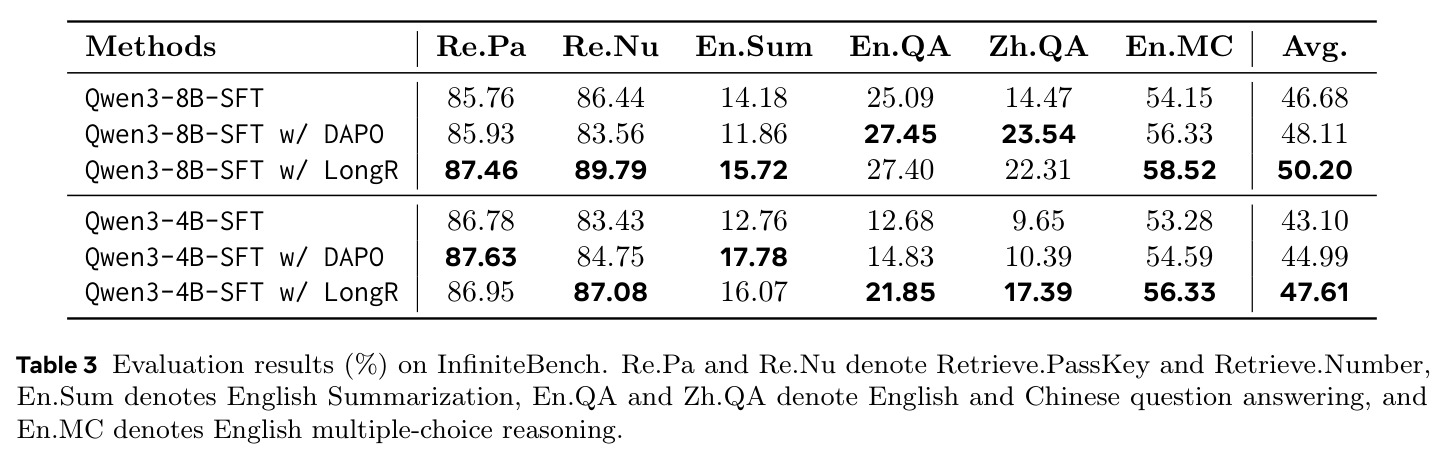
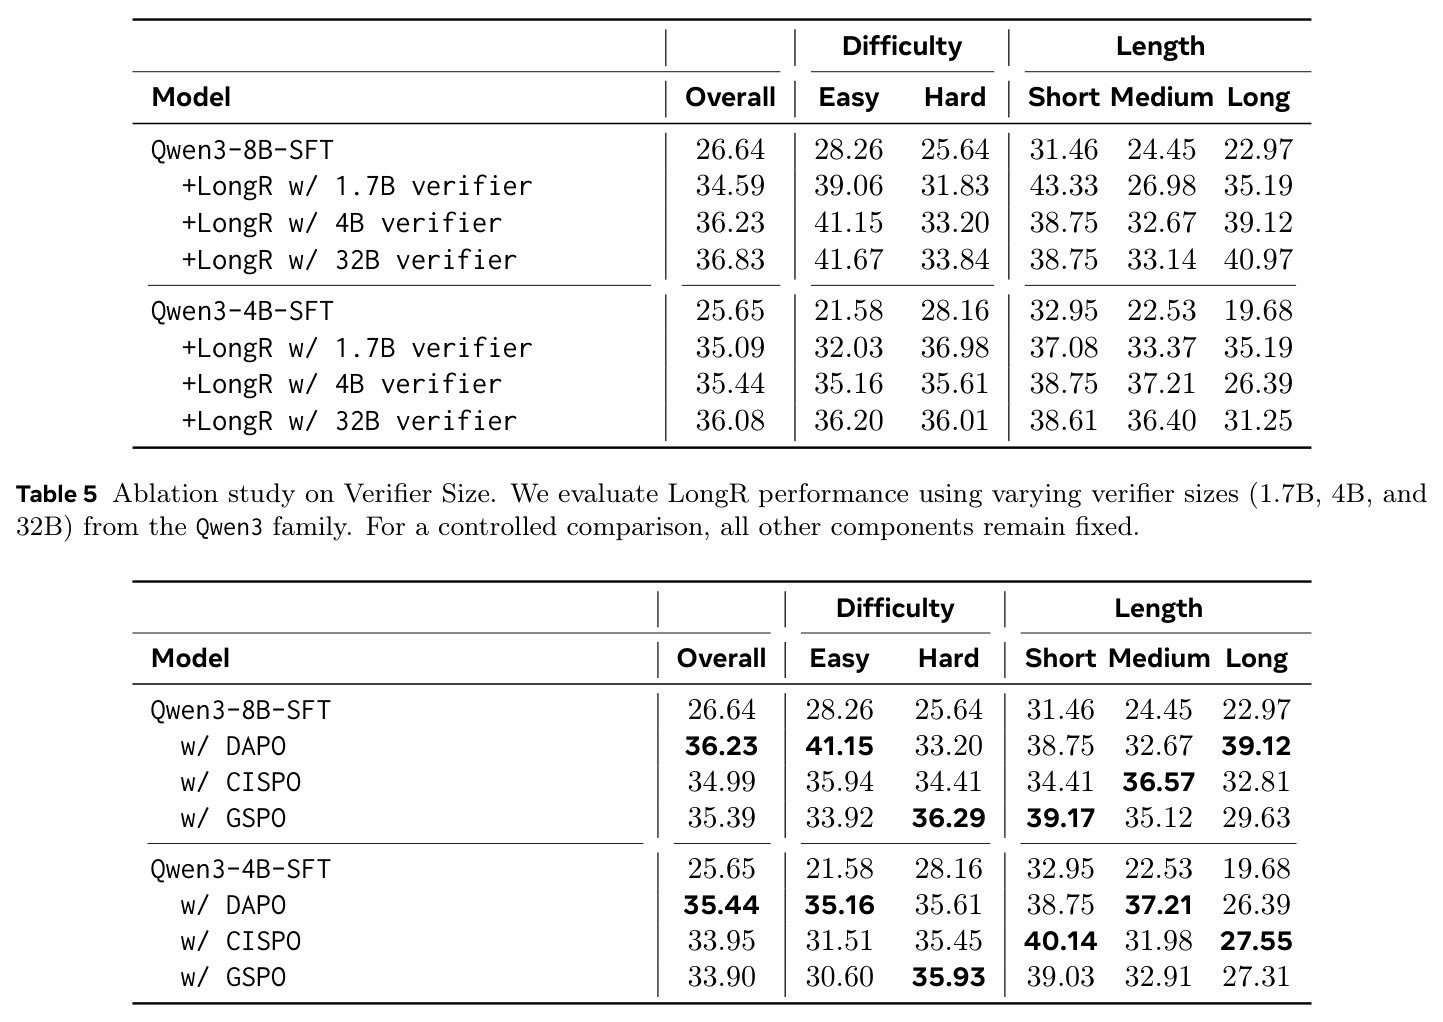
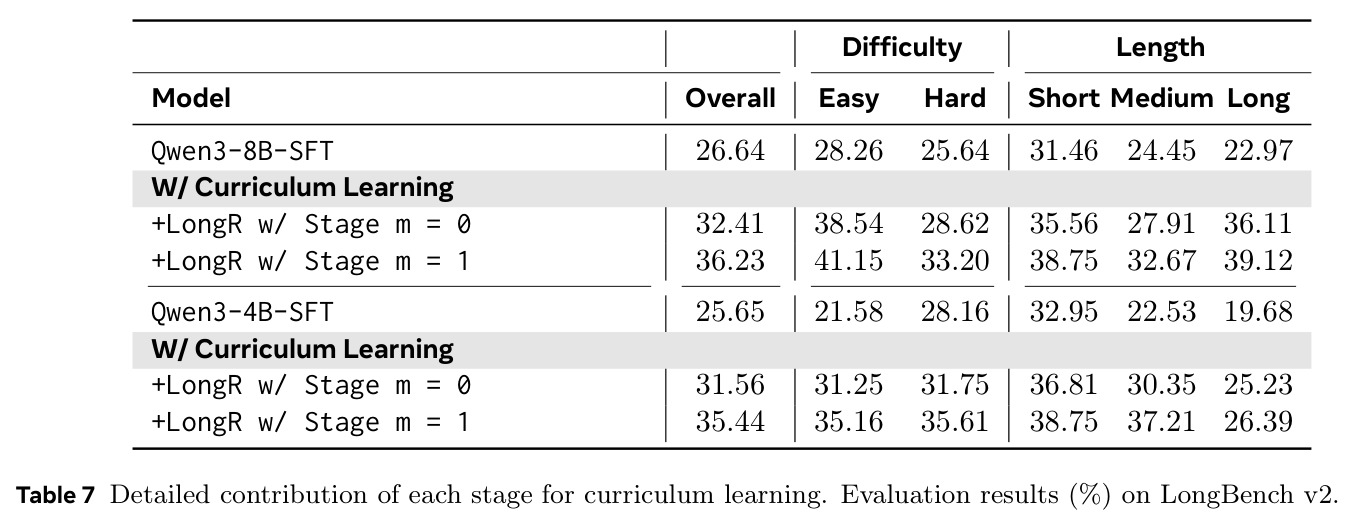
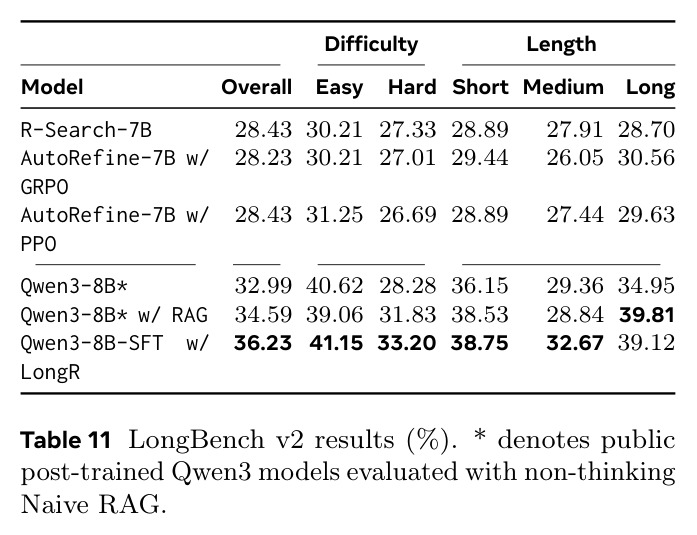
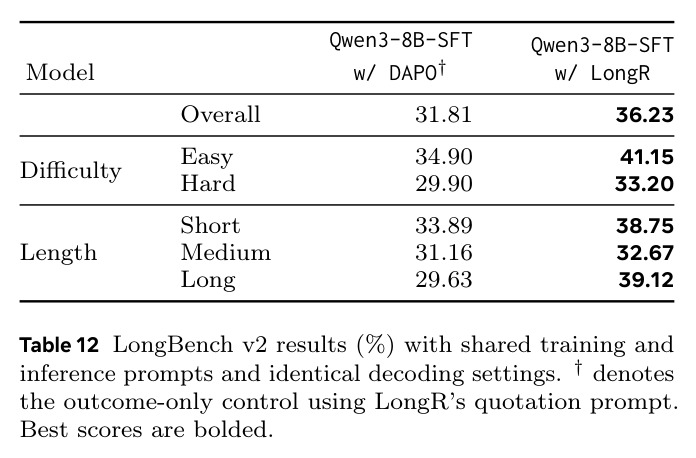
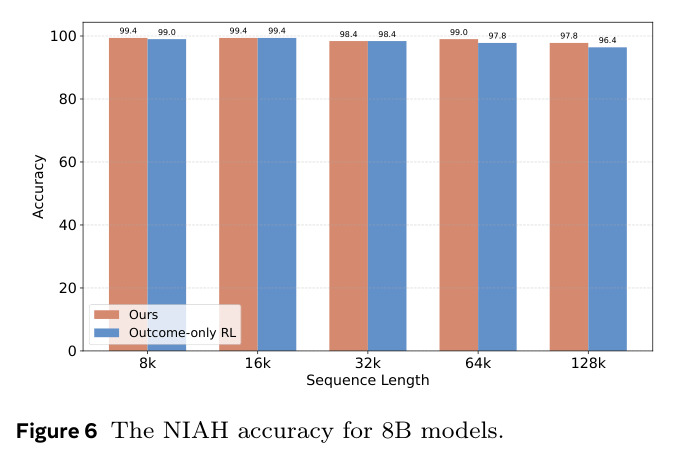
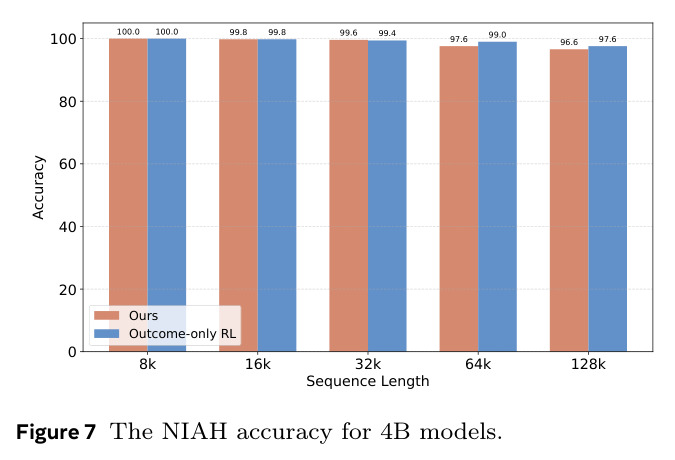
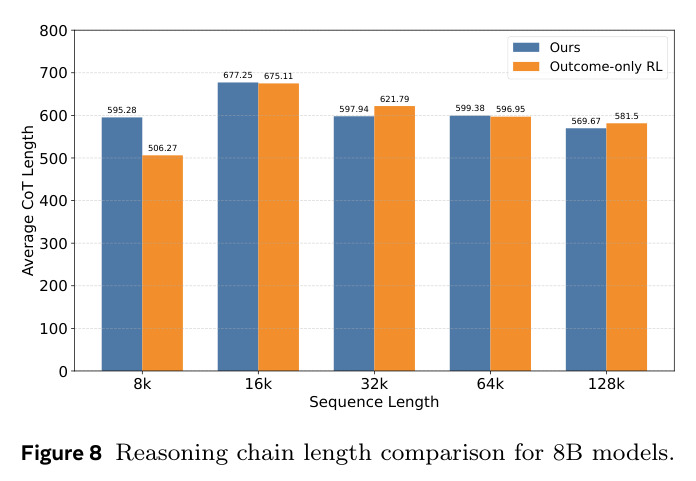
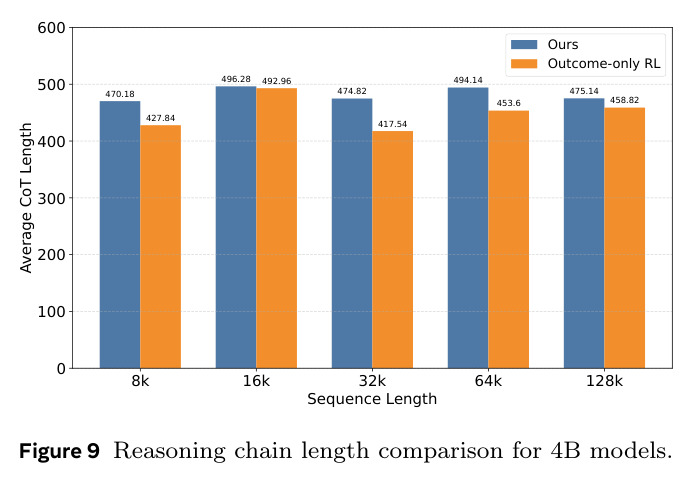
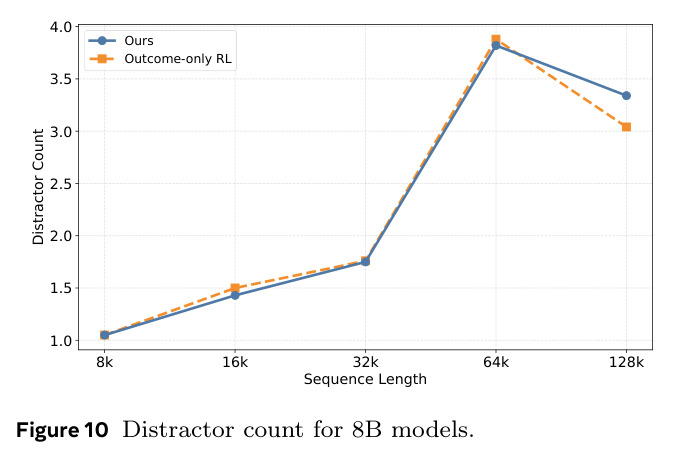
核心结果分五块。主结果:LongBench v2 上 Qwen3-8B 从 SFT 的 26.64 提到 36.23(较 outcome-only DAPO 32.84 再加 3.39),Qwen3-4B 从 25.65 到 35.44(较 DAPO 30.41 加 5.03);提升集中在难例——8B Hard 25.64→33.20、Long(>128K)22.97→39.12。泛化:RULER-128K/64K 上 8B 平均 61.48/71.98,较 DAPO 加 6.61/16.96(QA 30.40→45.60,VT 58.52→86.64),4B 为 60.71/69.43;InfiniteBench 上 8B 平均 50.20(SFT 46.68)、4B 47.61(43.10),4B En.QA 12.68→21.85。消融:奖励设计上 Relative(36.23)>Threshold(34.10)>Outcome-only(32.80)>Absolute(32.41);验证器规模 1.7B/4B/32B 对应 34.59/36.23/36.83,4B 是性价比拐点;RL 算法上 DAPO 36.23、GSPO 35.39(Hard 最佳 36.29)、CISPO 34.99(Medium 最佳 36.57);课程两阶段贡献 32.41→36.23。对照实验:同引用提示下去掉密集奖励仅 31.81(低 4.42),说明增益来自奖励而非提示;LongR 也优于 Naive RAG 增强的 Qwen3-8B*(34.59)及 R-Search-7B(28.43)、AutoRefine-7B(28.23-28.43);三个解码种子 36.23/37.77/35.79(均值 36.60±1.04),下界裁剪变体达 36.98。行为上:NIAH 推理链长度与 baseline 持平甚至更短,干扰引用计数相当,查询切换排名准确率 100%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LongBench v2(Qwen3-8B,多选长文理解) | Overall 准确率 (%) | 36.23(SFT w/ LongR) | SFT 26.64;SFT w/ DAPO 32.84 | 较 SFT +9.59,较 outcome-only DAPO +3.39 |
| LongBench v2(Qwen3-4B) | Overall 准确率 (%) | 35.44(SFT w/ LongR) | SFT 25.65;SFT w/ DAPO 30.41 | 较 SFT +9.79,较 DAPO +5.03 |
| LongBench v2(8B,Long >128K 子集) | 准确率 (%) | 39.12 | SFT 22.97;官方 Qwen3-8B* 34.95 | 较 SFT +16.15 |
| RULER-128K(Qwen3-8B,NIAH/VT/QA 平均) | 平均分 (%) | 61.48 | SFT w/ DAPO 54.87 | +6.61(QA 子任务 30.40→45.60) |
| RULER-64K(Qwen3-8B) | 平均分 (%) | 71.98 | SFT w/ DAPO 55.02 | +16.96(VT 58.52→86.64) |
| RULER-128K / 64K(Qwen3-4B) | 平均分 (%) | 60.71 / 69.43 | SFT w/ DAPO 57.92 / 63.53 | +2.79 / +5.90 |
| InfiniteBench(Qwen3-8B,6 子任务平均) | 平均分 (%) | 50.20 | SFT 46.68;SFT w/ DAPO 48.11 | 较 SFT +3.52(En.MC 54.15→58.52) |
| InfiniteBench(Qwen3-4B) | 平均分 (%) | 47.61 | SFT 43.10;SFT w/ DAPO 44.99 | 较 SFT +4.51(En.QA 12.68→21.85) |
| LongBench v2 vs 检索增强(8B) | Overall 准确率 (%) | 36.23(LongR) | Qwen3-8B* 32.99;+Naive RAG 34.59;R-Search-7B 28.43;AutoRefine-7B 28.23-28.43 | 较最强 RAG 基线 +1.64 |
| 同提示 outcome-only 对照(8B) | Overall 准确率 (%) | 36.23(含密集奖励) | 31.81(同引用提示、仅格式+答案奖励) | +4.42,分离出奖励本身的贡献 |
局限与改进
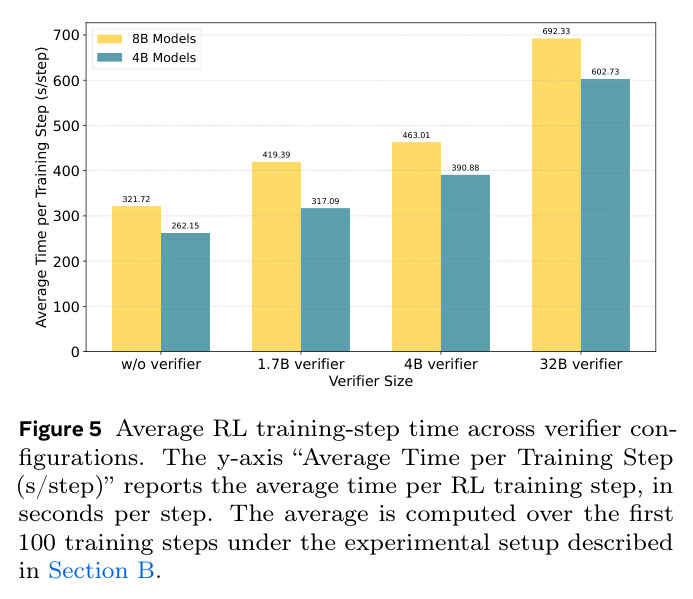
作者承认的局限:受算力约束,RL 训练上下文只到 32K(两阶段各 100 步),更长上下文留待未来,Long 子集(>128K)的 39.12 属于零样本泛化而非训练所得;此外奖励公式对 $L(s)\to 0$ 的零分母情形未定义,附录 I 的下界裁剪 $r_{clip}=\max\{-1,r\}$ 只是缓解。我的观察:(1) 相对信息增益理论上下界无界,极端负奖励放大训练方差——裁剪带来 +0.75 说明问题真实存在,但未设为默认;(2) 验证器是 4B 小模型,概率估计在代码、法律等专业领域可能失准,位置无偏性只在通用语料上验证;(3) 引用抽取完全依赖方括号格式,格式崩溃时 $K=0$、$r_{ctx}=0$,“不引用”不受任何惩罚,模型可能退化为凭参数知识作答;(4) 验证器前向使每步训练时间明显增加(Figure 5 显示 8B 策略各配置约 262-692 秒/步);(5) 实验仅覆盖 Qwen3 4B/8B,未验证更大规模或非 Qwen 系模型;(6) 评测以 QA/多选为主,摘要与开放式生成任务权重小,密集奖励对其有效性未知。
独立分析的弱点
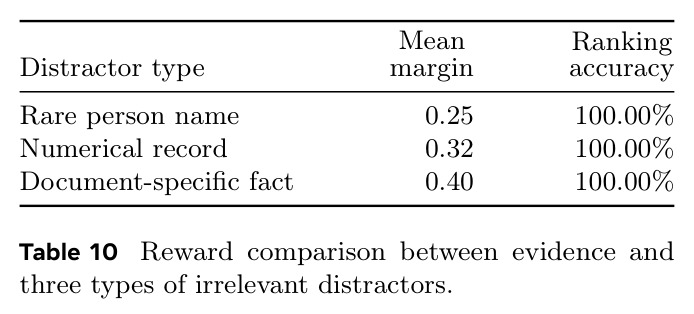
第一,奖励的可利用面:相对信息增益偏爱“高先验熵且被文档命中”的片段,模型可能引用与问题无关但稀有的内容(随机 UUID、罕见人名)刷分——作者的查询切换与三类干扰项实验(奖励边际 0.25-0.40、排名准确率 100%)证明了区分度,但只覆盖人工构造的干扰类型,“相关但不必要”的证据如何被打分仍不清楚。改进:把 $r_{ctx}$ 与答案正确性做乘性耦合(答错时清零引用奖励),或引入查询条件下的对比项。第二,$K=0$ 时 $r_{ctx}=0$ 不惩罚“完全不引用”,长训后策略可能退化为不查阅。改进:对长上下文样本设最低引用数,或对无引用答对的样本施加负向偏置。第三,验证器与策略的分布漂移:策略持续演化,4B 验证器的估计偏差可能累积。改进:用策略历史快照集成打分或周期性校准。第四,32K 训练上限使 >128K 收益全靠外推。改进:配合序列并行与激活检查点把课程推到 128K。第五,逐字引用对表格、代码、非英语文本不友好。改进:改用段落定位符或编辑距离容忍的模糊匹配。
未来方向
作者提出的最直接方向是把 RL 训练从 32K 扩展到更长的上下文。在此基础上有若干自然的延伸:其一,把相对信息增益奖励迁移到 agentic 与检索场景——工具返回结果、检索段落同样可以用“条件 NLL 下降”打效用分,从而统一 LongR 与 RAG 的奖励设计;其二,利用不同 RL 算法的互补性,CISPO 在 Medium 长度(36.57)和 GSPO 在 Hard 难度(36.29)上各有最佳表现,可按样本难度/长度路由训练目标;其三,把下界裁剪(36.98 优于未裁剪的 36.23)设为默认并研究更稳健的有界变体,如按批次统计量做 z-score 归一;其四,验证器规模消融显示 1.7B→32B 增益快速饱和(34.59→36.83),说明可以用蒸馏或早退进一步压缩打分开销,甚至训练专用的小验证器;其五,将 Think-and-Read 内联引用扩展成结构化定位输出(引用 ID、段落坐标),使其可对接自动事实核查与引用校验;最后,在仓库级代码、多文档综述等更贴近真实工作负载的任务上验证密集效用奖励,因为当前评测仍以 QA/多选为主。
复现评估
复现友好度较高。组件全公开:SFT 用 LLaMA-Factory、RL 用 verl、评测用 vLLM,底座与验证器是 HuggingFace 上的 Qwen3-4B/8B(消融另用 1.7B/32B),数据集 AM-DeepSeek-R1-0528-Distilled 与 DocQA-RL-1.6K 可公开下载,长度合成数据沿用 MemAgent 构造方式。附录 B 给出完整超参:SFT 峰值学习率 2e-5、warmup 0.03、序列 16384、900 步;RL 学习率 1e-6、batch 8、rollout 16、最大序列 32768、最大输出 4096、Ulysses 序列并行 2、奖励权重 $r_{fmt}=1.0$、$r_{acc}=2.0$、两阶段课程各 100 步(16K→32K);提示模板在附录 A 原文给出,引用抽取是确定性方括号解析,验证器打分是纯前向、可离线缓存。主要门槛是算力:原始配置需 16 张 NVIDIA H20 141GB;若缩到 4B 模型 + 16K 上下文,单机 8 卡 A100/H100 量级可行。正文未附官方代码仓库链接,奖励计算与课程调度需按附录自行实现,总体难度中等,建议先复现 Table 4 的奖励消融作为验收标准。
论文图表
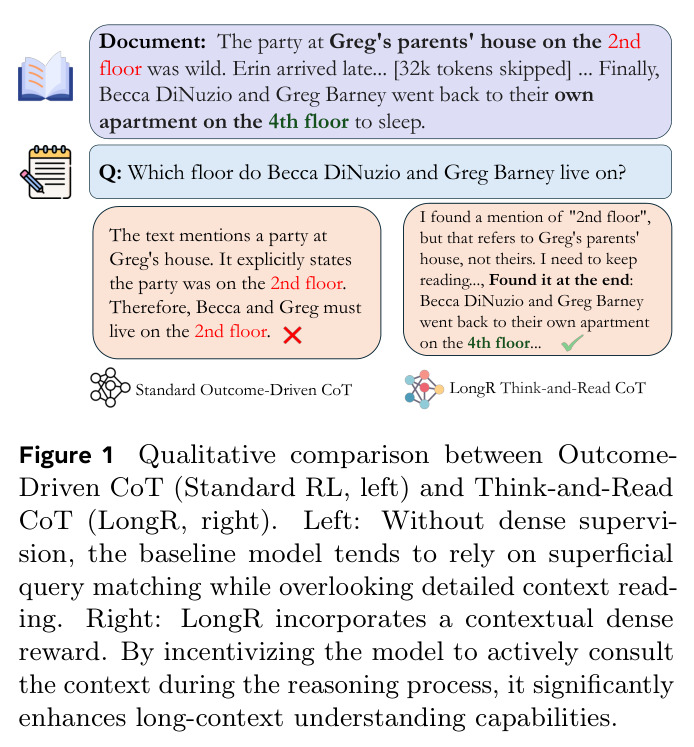
一个 32K token 的叙事理解例子:问题问 Becca DiNuzio 和 Greg Barney 住几楼。左侧标准 outcome-driven CoT 只做表面查询匹配,看到“Greg's parents' house on the 2nd floor”就把 2nd floor 当成答案;右侧 LongR 的 Think-and-Read CoT 边推理边引用,读到结尾“回到 4 楼自己的公寓”后答对 4th floor。
一眼看懂密集奖励带来的行为差异:没有密集监督时模型靠关键词匹配蒙答案,有了 $r_{ctx}$ 模型学会真正读到文末证据,这是全文动机最直观的展示。
outcome-only 基线使用的系统提示:要求严格按 $\langle think\rangle...\langle/think\rangle\langle answer\rangle...\langle/answer\rangle$ 输出,但不要求引用任何文档证据。
它是 Table 12 共享提示对照实验中控制变量的关键:LongR 与它的唯一差别是是否要求并奖励引用,用于证明增益来自奖励而非提示措辞。
LongR 的系统提示模板:要求模型在思维链中找到相关内容时用方括号逐字引用原文,再基于引用证据推理作答,输出必须包在 $\langle think\rangle$ 与 $\langle answer\rangle$ 标签内,并给出示例格式。
引用格式是整个奖励机制的前提——验证器打分完全依赖从方括号中确定性抽取的片段,理解该模板才能理解奖励如何落地。
在 DAPO/CISPO/GSPO 三种算法下套用同一 LongR 配方:8B 为 36.23/34.99/35.39,4B 为 35.44/33.95/33.90,均大幅高于 SFT 基线,各算法在不同难度/长度分项上各有最强项。
证明方法与具体 RL 优化器解耦——增益来自奖励设计而非某个算法的巧合,提高了结论的普适性。
同一 LongR 检查点在解码种子 0/1/42 下 Overall 分别为 36.23/37.77/35.79,均值 36.60±1.04,各分项标准差约 0.87-1.21。
给出结果方差的量级,说明主表数字稳定且所有种子下的结果都明显高于对照的 31.81,结论不依赖单次幸运采样。