能量-Tweedie恒等式:从高斯噪声到吉布斯能量噪声的Tweedie公式推广 Energy-Tweedie: Score meets Score, Energy meets Energy
把Tweedie公式从高斯噪声推广到任意吉布斯能量噪声:得分=匹配评分规则在后验处的路径导数。
前置知识
Stein得分与得分匹配
Stein得分指概率密度对样本变量的梯度 $s_m(y)=\nabla_y\log m(y)$,它刻画密度上升最快的方向。得分匹配(Hyvärinen, 2005)利用分部积分,只从样本估计这个梯度场而无需知道归一化常数;去噪得分匹配(Vincent, 2011)则借助高斯加噪把得分估计转化为回归问题。现代扩散模型的核心就是用一个神经网络拟合并沿噪声水平积分这个得分场,再用Langevin等采样器反向生成。
本文恒等式的左边正是噪声边际的Stein得分,全部三个应用(得分估计、参数估计、扩散采样)都围绕它展开,不熟悉得分就无法理解论文在'估计什么'。
Tweedie公式
在加性高斯噪声 $Y=X+\epsilon,\ \epsilon\sim N(0,\Sigma)$ 下,Tweedie公式给出 $\mathbb{E}[X|Y=y]=y+\Sigma\,\nabla_y\log m(y)$,即MSE最优去噪器(后验均值)加上残差项就等于噪声边际得分的线性变换。它把经验贝叶斯、去噪和得分估计三条线焊在一起,是得分型扩散模型的理论基石之一。
本文的全部工作是把这条只对高斯成立的公式推广为对任意吉布斯噪声成立的'Energy-Tweedie恒等式',理解原公式才知道推广的对象和退化条件。
评分规则与能量得分
评分规则 $S(P,y)$ 评估'概率预测 $P$ 对真实值 $y$'的好坏:若真实分布在期望下唯一最小化期望得分则称严格proper(诚实报告)。核评分 $S_\rho(P,y)=\mathbb{E}_{Y\sim P}[\rho(Y,y)]-\tfrac12\mathbb{E}[\rho(Y,Y')]$ 由核 $\rho$ 诱导;取 $\rho=\|x-y\|^\beta$ 即能量得分 $ES_\beta$,是多变量概率预报最常用的评分规则之一,其第二项奖励预测分布保持不确定性。
本文恒等式的右边是'噪声势诱导的核评分在去噪后验处的路径导数',评分规则的proper性理论决定了用学习后验代入时训练目标是否诚实。
吉布斯分布(能量模型)
形如 $q_{E,c}(u)=Z_E(c)^{-1}e^{-cE(u)}$ 的分布,其中 $E:\mathbb{R}^d\to[0,\infty)$ 是对称、$E(0)=0$ 的噪声势,$c>0$ 是尺度参数,$Z_E(c)$ 是归一化常数。机器学习里统称能量模型:势能低的状态概率高。广义高斯族 $q(u)\propto\exp(-\lambda\|u\|_{\Sigma^{-1}}^\beta)$ 是其特例($\beta=2$ 退化为高斯,$\beta=1$ 为Laplace),Student-t分布也可以写成这种形式。
这是论文考虑的噪声族:噪声势 $E$ 同时决定加噪分布和匹配的评分规则,是整个'能量遇见能量'对应的枢纽。
路径导数(stop-gradient)
记号 $\nabla_y^{PD}$ 表示'固定测度的梯度':对函数关于 $y$ 求导,但不对依赖 $y$ 的概率测度(如后验 $P(\cdot|Y=y)$)求导,实现上等价于对分布施加stop-gradient后求梯度:$\nabla_y^{PD}\,\mathbb{E}_{X\sim P}[f(y,X)]=\mathbb{E}_{X\sim P}[\nabla_y f(y,\mathrm{sg}(X))]$。该记号借自变分推断文献。
恒等式中后验本身依赖 $y$,若用普通全导数会把测度的变化也求进去;路径导数正是化解这一纠缠、使恒等式成立的关键操作。
条件负定(CND)核
对称核 $\rho$ 称为条件负定,若对所有 $n$、所有点 $z_1,\dots,z_n$ 和所有满足 $\sum_i a_i=0$ 的实系数 $a_i$,都有 $\sum_{ij}a_ia_j\rho(z_i,z_j)\le0$。Gneiting–Raftery的经典结果:核评分proper当且仅当核是CND;严格proper当且仅当诱导的广义能量距离具有强负型(只在两分布相等时为零)。例如 $\|x-y\|^\beta$ 在 $\beta\in(0,2]$ 时CND。
论文Prop 4.2证明匹配评分规则的诚实性由噪声势单独决定,CND正是判定工具:广义高斯在 $\beta\in(0,2]$ proper、$\beta\in(0,2)$ 严格proper。
研究动机
连接去噪、经验贝叶斯与得分型生成的经典桥梁是Tweedie公式:在加性高斯噪声 $Y=X+\epsilon$ 下,后验均值 $\mathbb{E}[X|Y=y]$ 是MSE最优去噪器,且 $\mathbb{E}[X|Y=y]=y+\Sigma s_m(y)$ 把去噪与噪声边际的Stein得分 $s_m(y)=\nabla_y\log m(y)$ 一一绑定。这条对应只在高斯噪声下自然:一旦噪声非高斯——真实传感器噪声常见重尾(Student-t类)或各向异性相关,稳健建模偏好Laplace类分布——后验均值就不再是得分自然暴露的对象,经典公式失效。现有应对各有缺口:Noise2Score等Tweedie型去噪方法仍局限于高斯或已知噪声;未知噪声参数估计通常只估一个标量噪声水平并固定各向同性高斯假设(SURE/UNSURE一类);重尾扩散($\alpha$-stable Lévy过程、$\alpha$-stable DDPM、Student-t扰动)只改造前向加噪与反向采样器,没有对应的得分恒等式;而评分规则扩散(RML、DDSR)分别用祖先采样和DDIM式机制,恰恰缺少NCSN/SMLD式的得分采样视角。
本文的目标是本文的目标是把'高斯噪声—后验均值—平方损失—Tweedie公式'这条经典对应链,整体升级为'吉布斯(能量)噪声—完整去噪后验—核评分规则—Energy-Tweedie恒等式'的分布级对应。具体拆成四个可交付结果:(1) 对任意可归一化的吉布斯噪声分布(Thm 4.1)给出噪声边际得分的恒等式,每个噪声势对应一条Tweedie式关系;(2) 由此得到一条'后验样本到得分'的估计路径——任何足够精确的去噪后验采样器都是得分估计器;(3) 提出带理论保证的M-估计方法,从带噪数据恢复吉布斯噪声的全部未知参数(尾形、尺度、协方差形状),而不止标量噪声水平;(4) 展示在噪声参数空间中沿用户自选路径做扩散式采样,为以评分规则训练的生成方法补上缺失的得分视角。
与已有工作不同的是,本文的独特切入是把去噪后验放进'评分规则'的透镜下观察。作者注意到核评分 $S_\rho(P,y)$ 中的核可以取成噪声势本身 $\rho(x,y)=E(y-x)$,然后在去噪后验 $P(X|Y=y)$ 处取路径导数(对 $y$ 求导但冻结测度,即实现上的stop-gradient),该导数恰好恢复噪声边际的Stein得分。这与Efron在指数族上导出的Tweedie矩公式不同:吉布斯分布在位置参数意义下一般不是指数族;也与Vincent的去噪得分匹配不同:后验路线不规定训练目标,任何通过分布匹配学到的后验模型都可直接代入。恒等式本身是代数性的、成立与否不依赖评分规则的proper性,而proper性由噪声势单独决定(Prop 4.2)——恒等式的有效性与训练目标的诚实性解耦,这一结构性洞察也是新的。
核心方法
直觉上,高斯Tweedie说的是'得分指向后验均值'。本文把'后验均值'这个标量摘要换成整个后验分布,把平方损失换成由噪声势诱导的核评分:对吉布斯噪声 $q_{E,c}(u)\propto e^{-cE(u)}$,定义差异 $\rho(x,y)=E(y-x)$,则 $-c$ 乘以该核评分在去噪后验处的路径导数就是噪声边际得分。技术路线三步:先把Fisher恒等式做符号替换 $\theta\to y$,得广义Tweedie公式 $s_m(y)=\mathbb{E}_{X|Y=y}[\nabla_y\log q(y-X)]$(Eq. 4);代入吉布斯噪声得 $s_m(y)=-c\,\mathbb{E}[\nabla_yE(y-X)|Y=y]=-c\,\nabla_y^{PD}\,\mathbb{E}[E(y-X)|Y=y]$(Prop 3.2);再与核评分的路径导数对比即得主定理。以广义高斯 $q(u)\propto\exp(-\lambda\|u\|_{\Sigma^{-1}}^\beta)$ 为例,恒等式化为 $s_m(y)=-\lambda\Sigma^{-1}\,\mathbb{E}[\|y-X\|_{\Sigma^{-1}}^{\beta-2}(y-X)\,|\,Y=y]$:$\beta=2$ 退化为经典Tweedie(均值寻找),$\beta=1$ 是指向后验几何中位数的Laplace情形,$1<\beta<2$ 在稳健性与距离敏感性之间插值。
核心创新是Energy-Tweedie恒等式(Thm 4.1)$s_m(y)=-c\,\nabla_y^{PD}\,S_\rho(P(X|Y=y),\,y)$,与已有方法的本质区别有三层。一是对象升级:'后验对象'从后验均值这一个矩升级为完整后验分布,而评分规则恰是衡量'分布对观测'差异的语言,因此对应关系从点态升级为分布级——高斯情形评分只锁死均值,非高斯情形锁死整个后验。二是算子升级:引入路径导数(fixed-measure梯度/stop-gradient),解决'对 $y$ 求导时后验测度本身也依赖 $y$'的纠缠,这一操作借自变分推断但从未用于Tweedie型恒等式。三是结构升级:每个噪声势 $E$ 自带一条Tweedie式关系和匹配评分规则,且恒等式代数成立、与proper性解耦——$S_\rho$ proper当且仅当 $\rho$ 条件负定(CND),严格proper当且仅当强负型(Prop 4.2)。广义高斯在 $\beta\in(0,2]$ proper、$\beta\in(0,2)$ 严格proper,且 $\beta=2$ 时能量距离塌缩为均值差,精确解释了高斯情形为何只钉住后验均值。
方法步骤详情
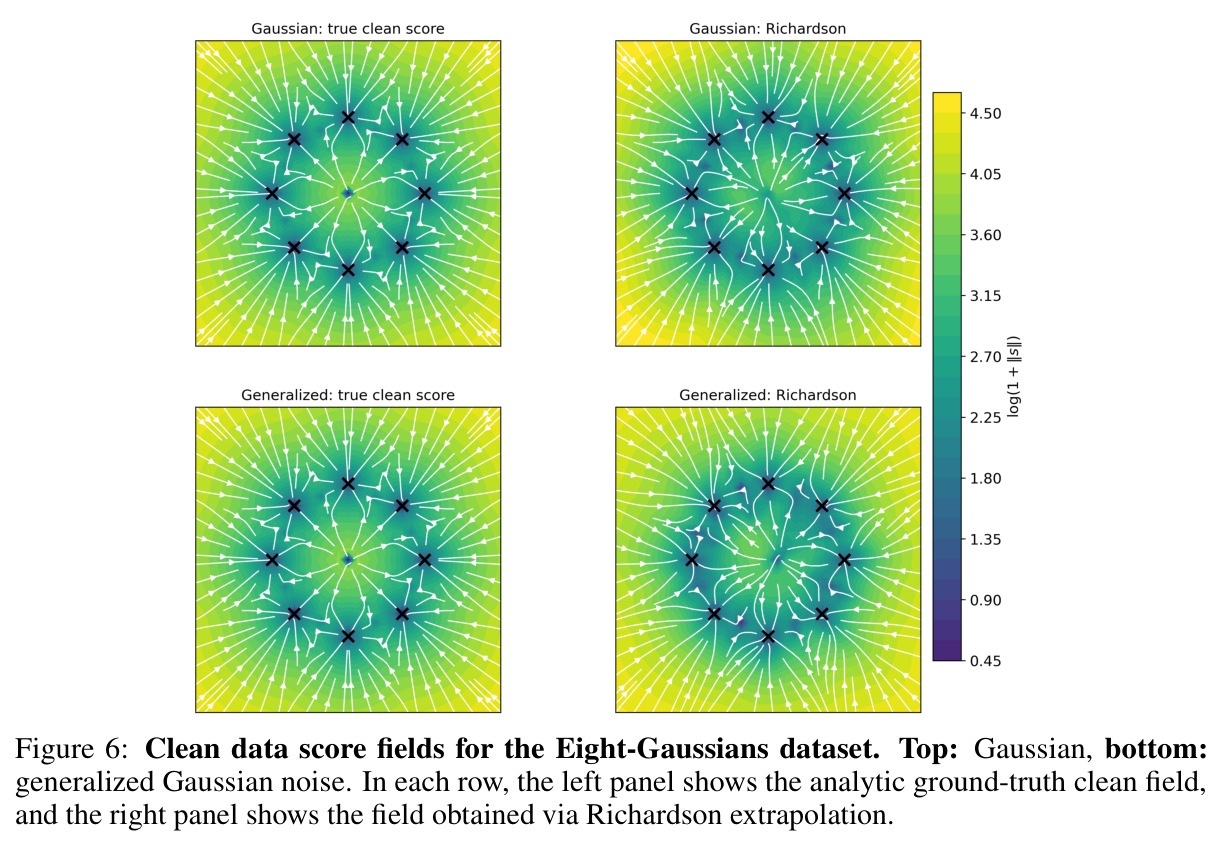
第一步(建模):设 $X\sim p$,加性噪声 $\epsilon\sim q_{E,c}$,$Y=X+\epsilon$;噪声势 $E$ 对称、$E(0)=0$,尺度 $c\in\Lambda_E$(归一化常数有限)。第二步(广义Tweedie):由Fisher恒等式得 $s_m(y)=\mathbb{E}_{X|Y=y}[\nabla_y\log q(y-X)]$。第三步(吉布斯代入,Prop 3.2,条件A1–A4):得 $s_m(y)=-c\,\mathbb{E}[\nabla_yE(y-X)|Y=y]$,即期望势的负路径梯度。第四步(主定理):以 $P=P(X|Y=y)$ 代入核评分 $S_\rho(P,y)$,得 $s_m(y)=-c\,\nabla_y^{PD}S_\rho(P,y)$。第五步(应用一·得分估计):从后验模型采 $N$ 个样本做蒙特卡洛估计(Eq. 23);或由clean–noisy对回归训练神经得分场 $s_\theta(y,\eta)$(ET-DSM,Eq. 25);小噪声极限 $\varepsilon\downarrow0$ 收敛到干净得分,Richardson外推(Eq. 26)把偏差阶提到 $O(\varepsilon^4)$。第六步(应用二·参数估计):以恒等式两侧失配为损失(Eq. 27/28)做M-估计;迹归一化 $\mathrm{Tr}(\Sigma)=d$ 解决尺度不可辨识(Thm A.1),$\lambda$ 有闭式剖面解(Eq. 30),Alg. 1实现,Prop A.2给出一致性。第七步(应用三·扩散):训练条件后验 $P_\theta(\cdot|Y,t)$(Eq. 31能量得分目标),沿噪声参数路径 $t\mapsto(\beta_t,\lambda_t,\Sigma_t)$ 用Eq. 32的得分跑退火Langevin。
技术新颖性
新颖性体现在四个层面。理论上:这是继Robbins、Efron之后首批覆盖'非指数族位置族'的Tweedie型恒等式——吉布斯噪声在未知位置参数意义下一般不是指数族,Efron的矩公式不适用,而本文对每个噪声势给出一条恒等式,并附Student-t例子说明均值不存在的重尾噪声也有严格proper的版本(Cor 4.4)。概念上:论文把两组同音异义词——Stein score与scoring rule、能量模型与能量得分——首次在定理层面焊接:噪声势 $E$ 同时定义加噪分布与匹配评分规则,'score meets score, energy meets energy'的字面游戏背后是真实的数学结构。方法论上:'后验样本→得分'是与Hyvärinen直接得分匹配、Vincent去噪得分匹配并列的第三条得分估计路线,不规定训练目标;噪声参数M-估计把'只能估标量噪声水平'的现状推进到估计完整五参数族(尾形 $\beta$、尺度 $\lambda$、SPD形状 $\Sigma$),并给出唯一可辨识性与一致性证明。实证上:它为评分规则扩散(RML、DDSR)补上了NCSN/SMLD式的得分采样视角,且噪声参数路径 $t\mapsto(\beta_t,\lambda_t,\Sigma_t)$ 成为采样时可自由设计的新自由度。
实验结果
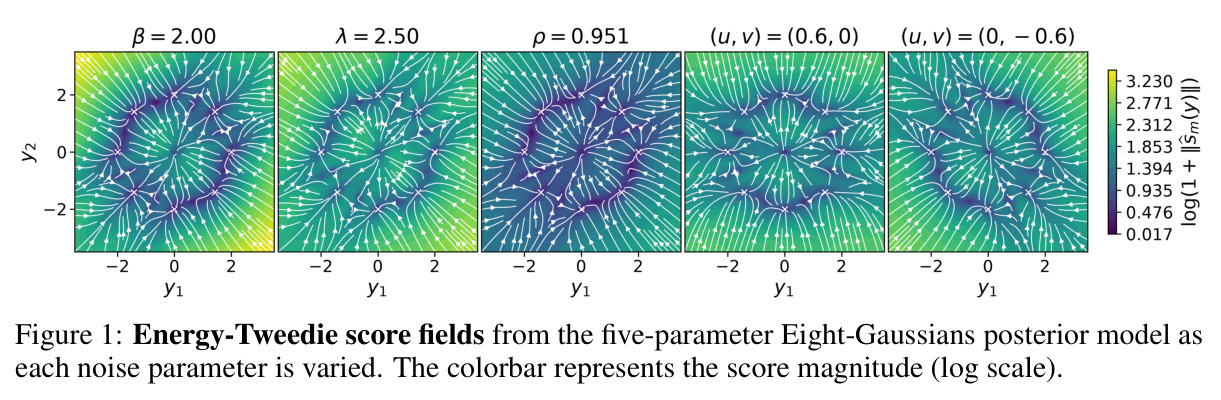
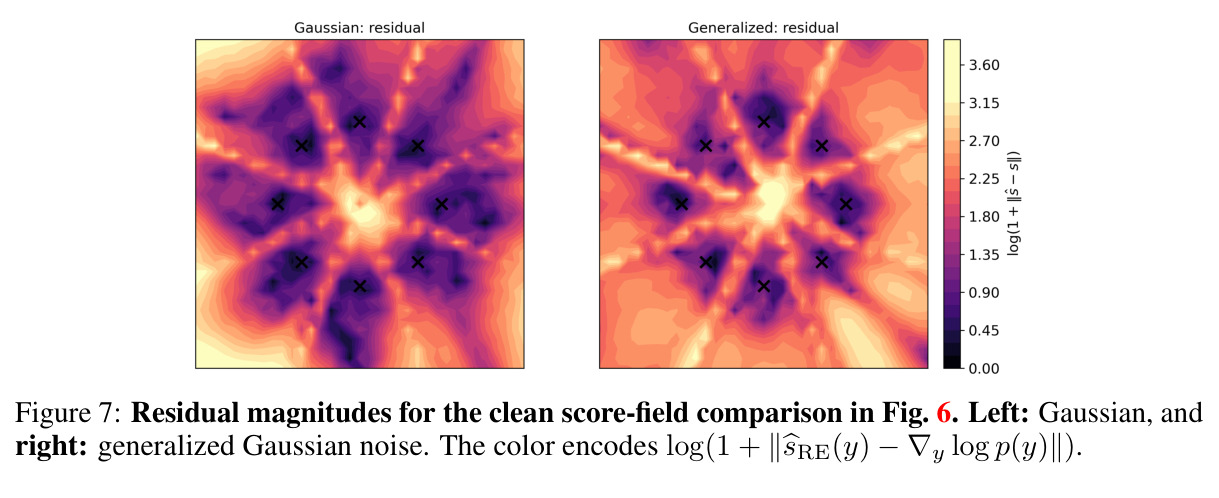
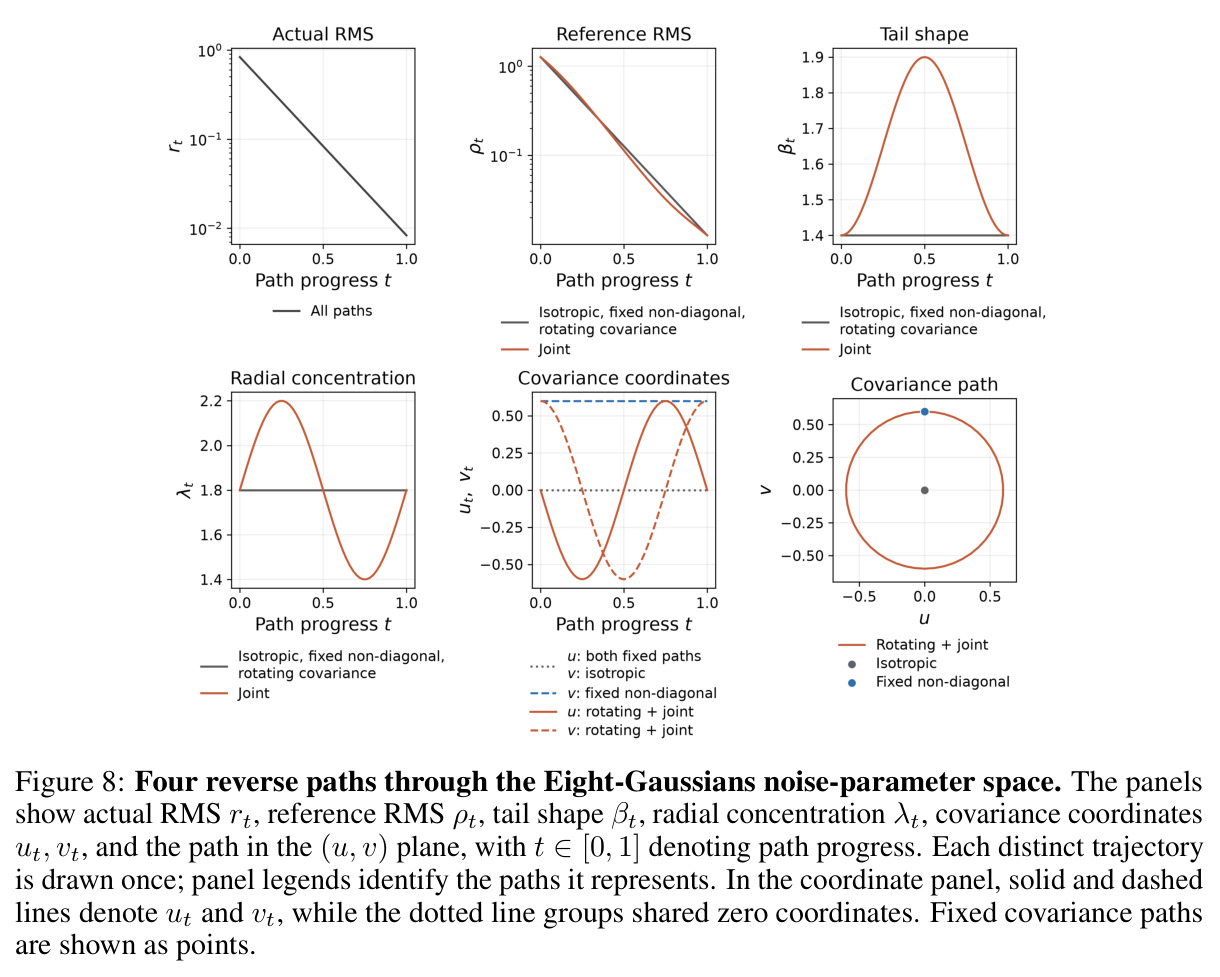
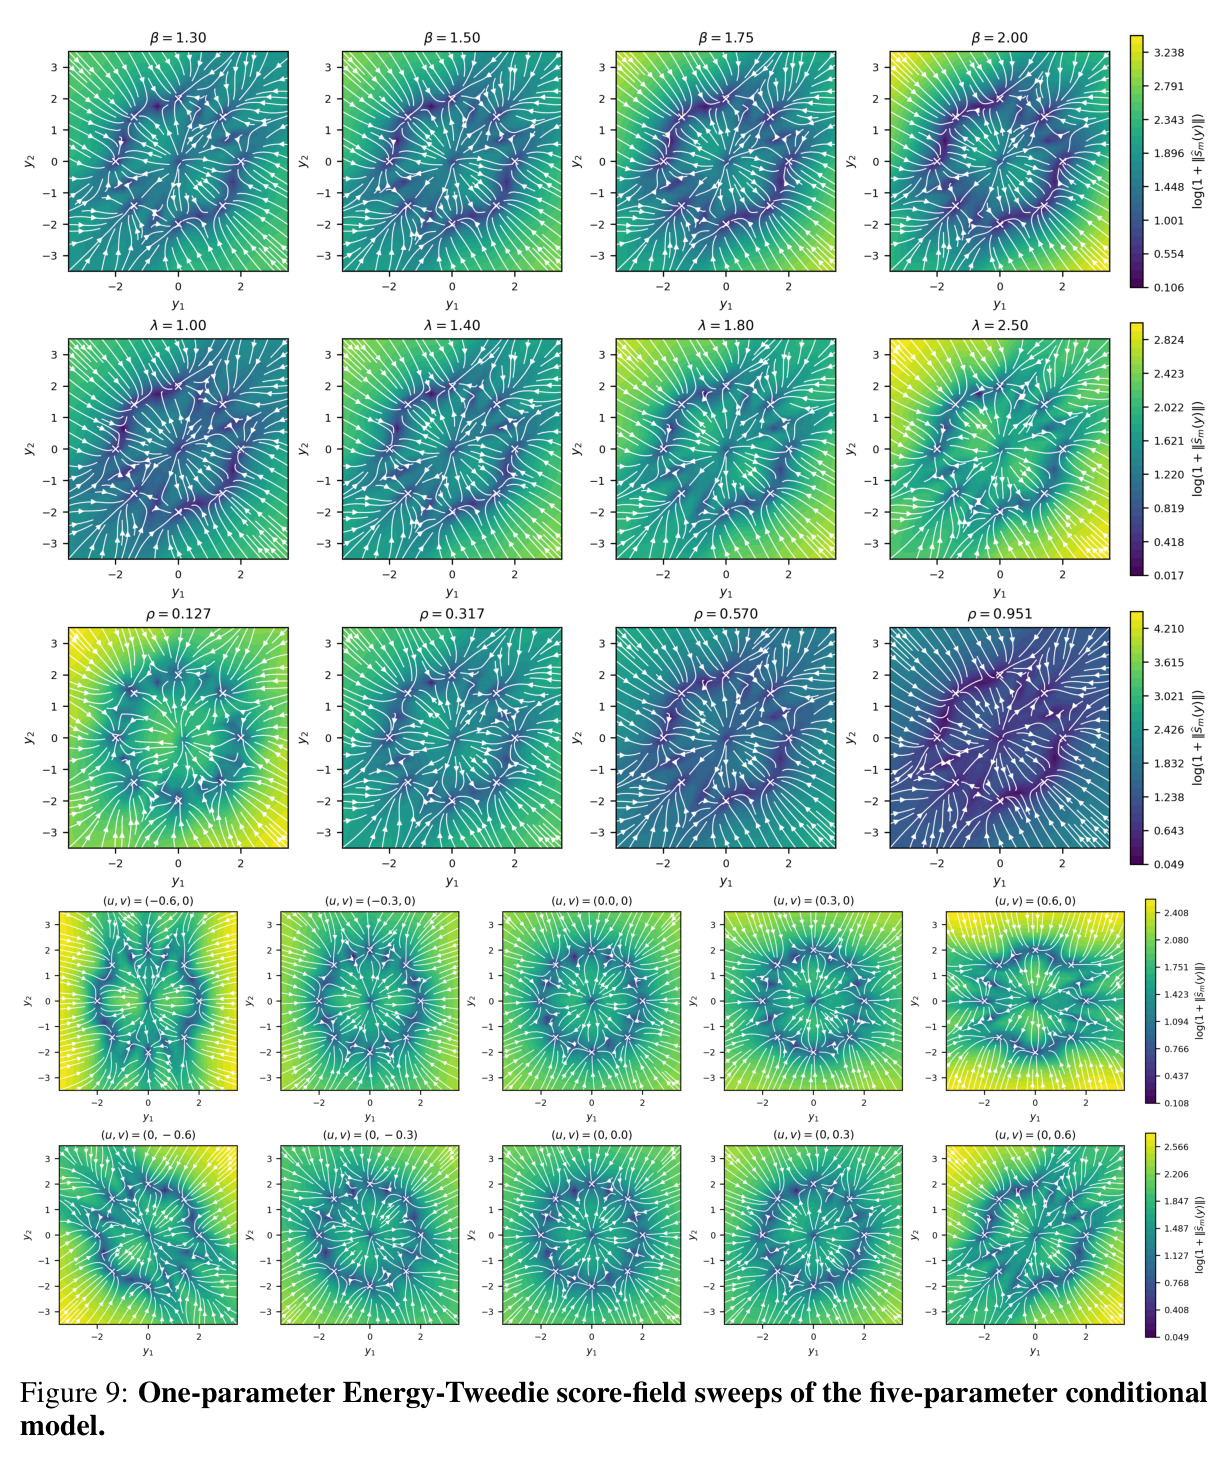
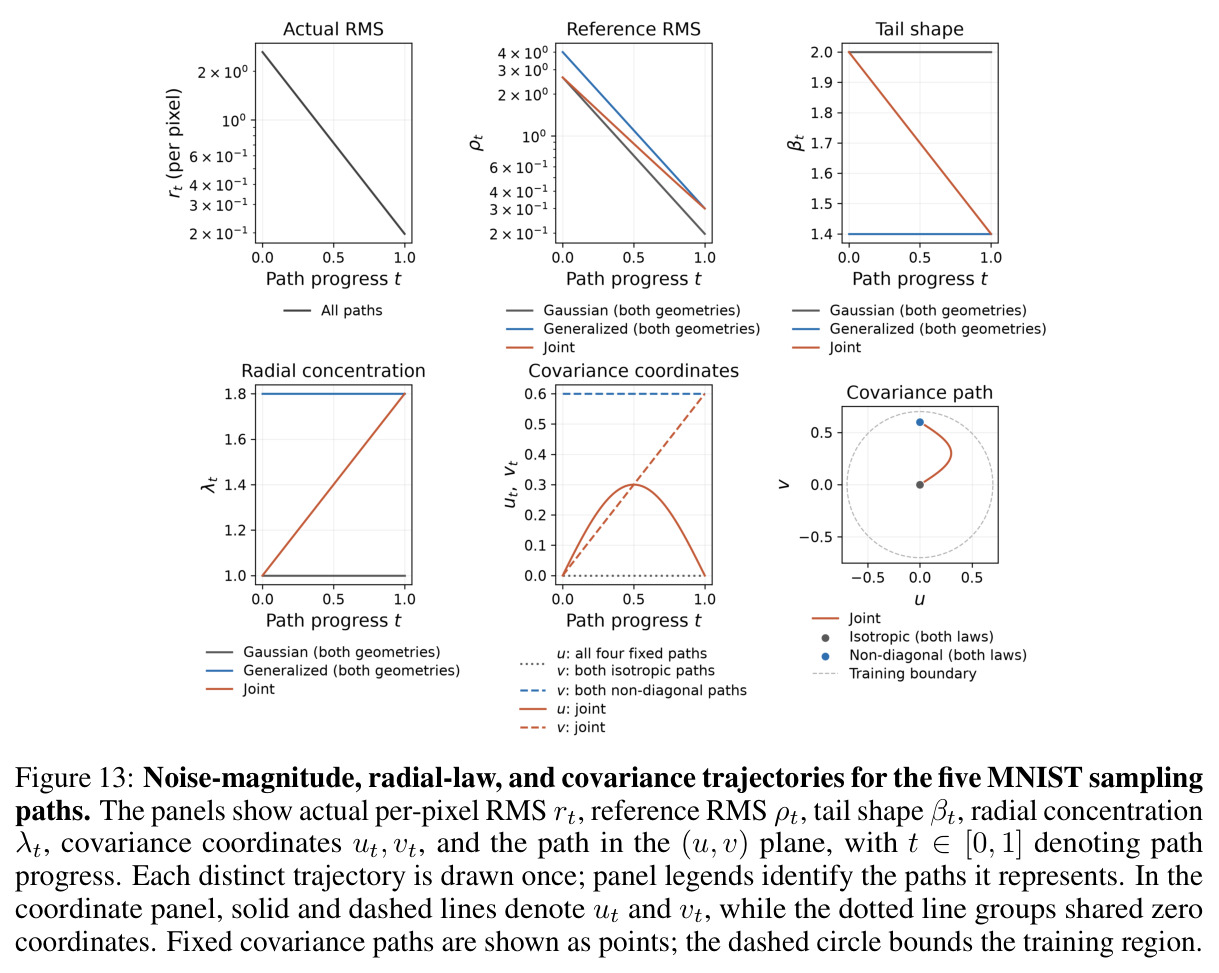
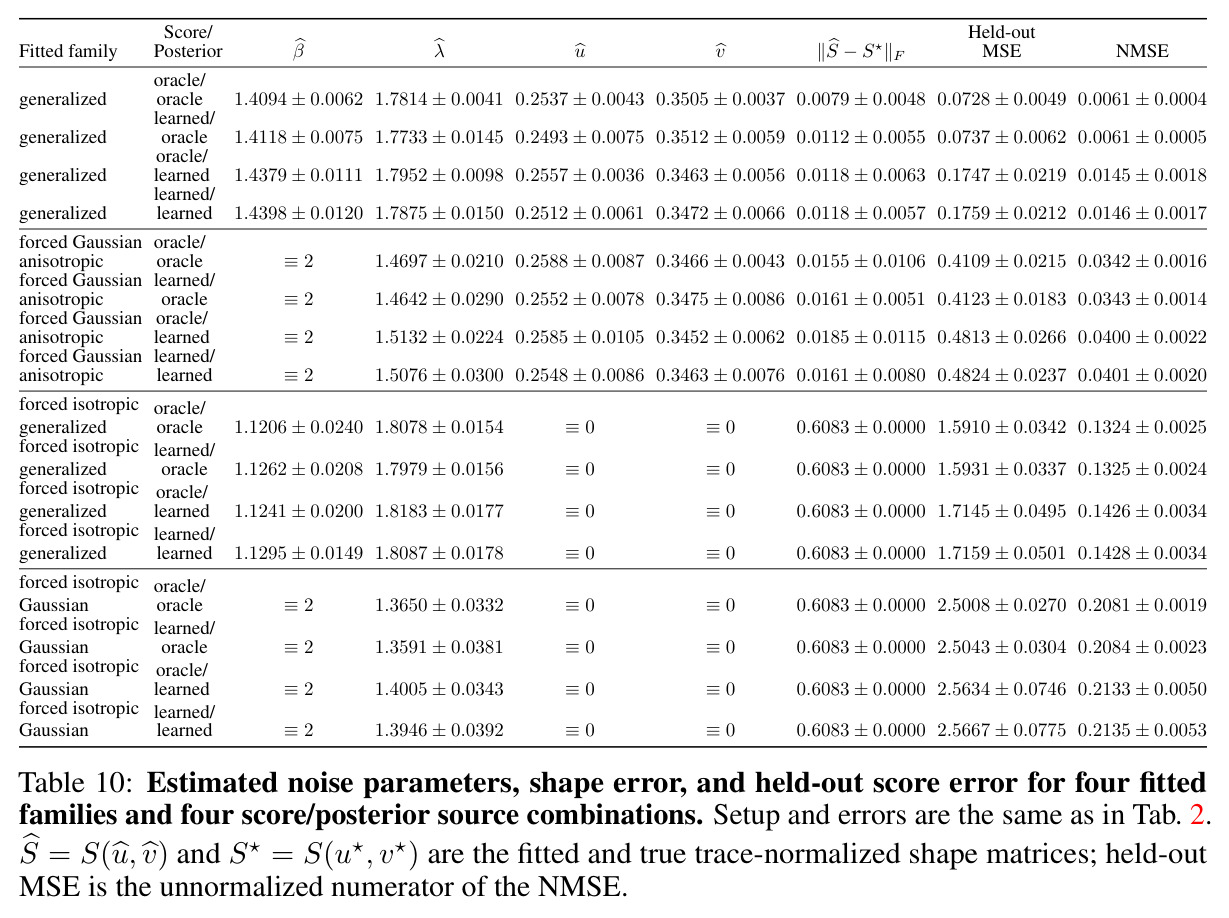
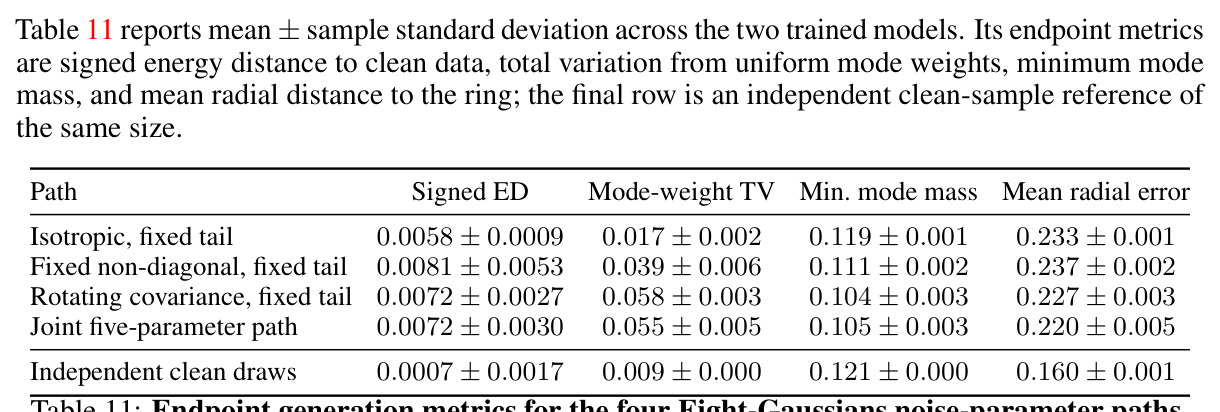
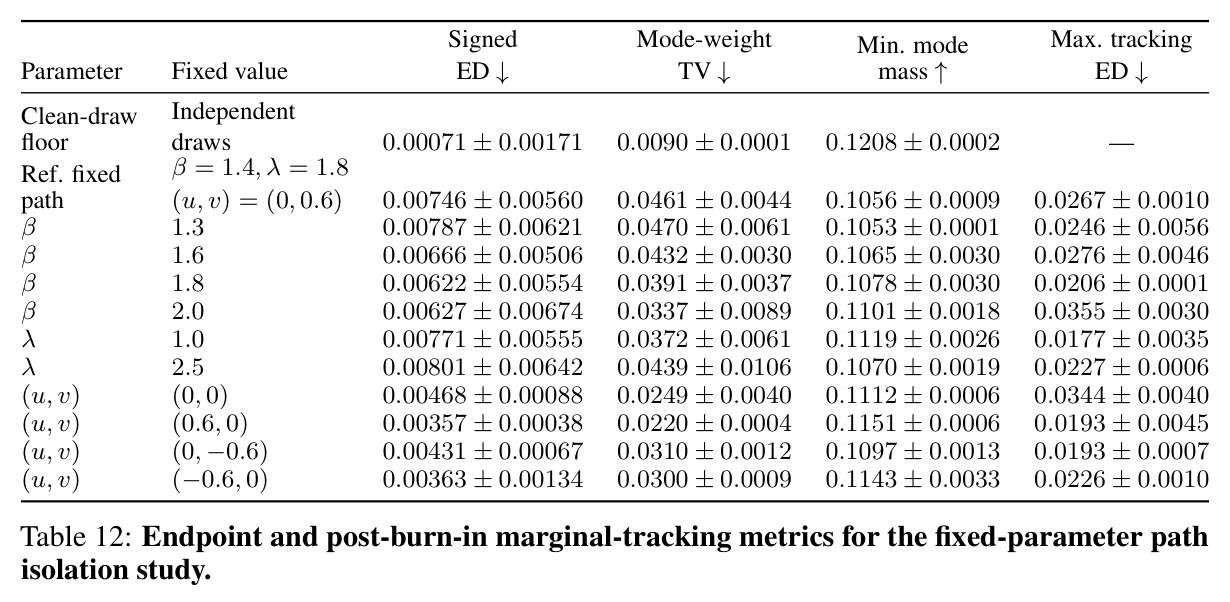
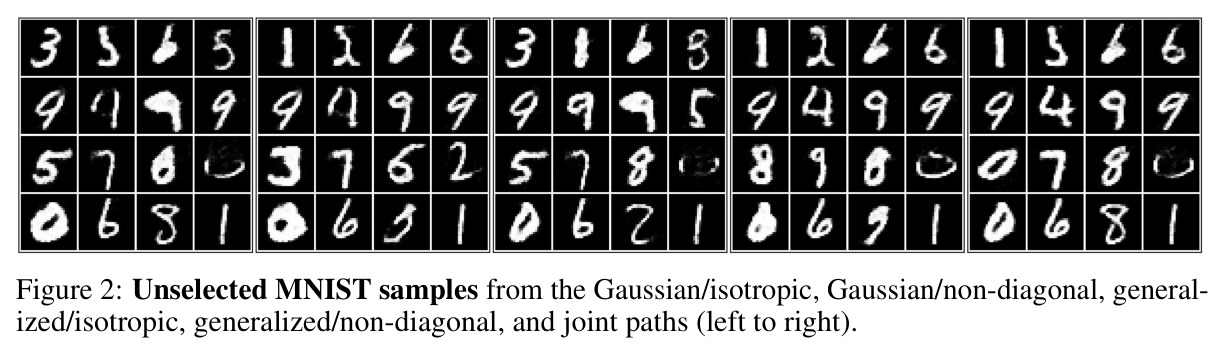
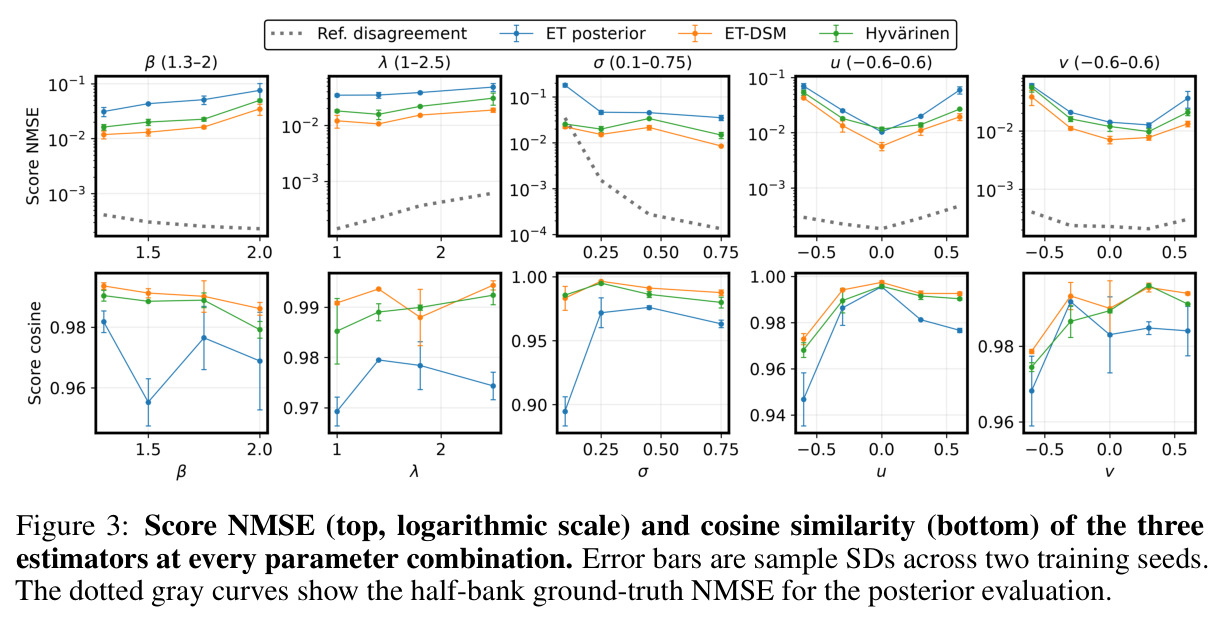
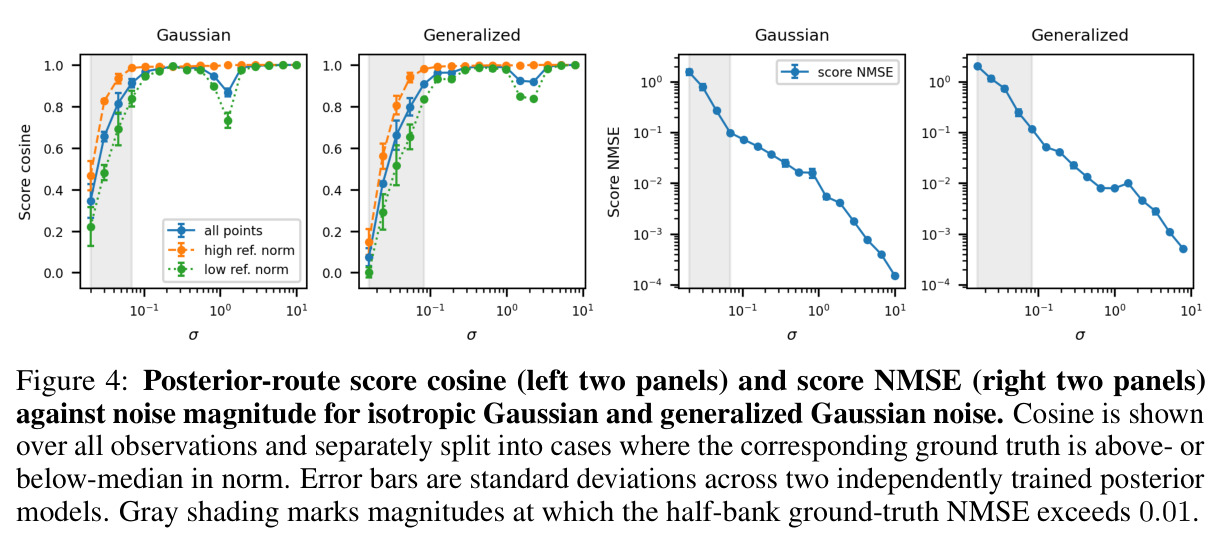
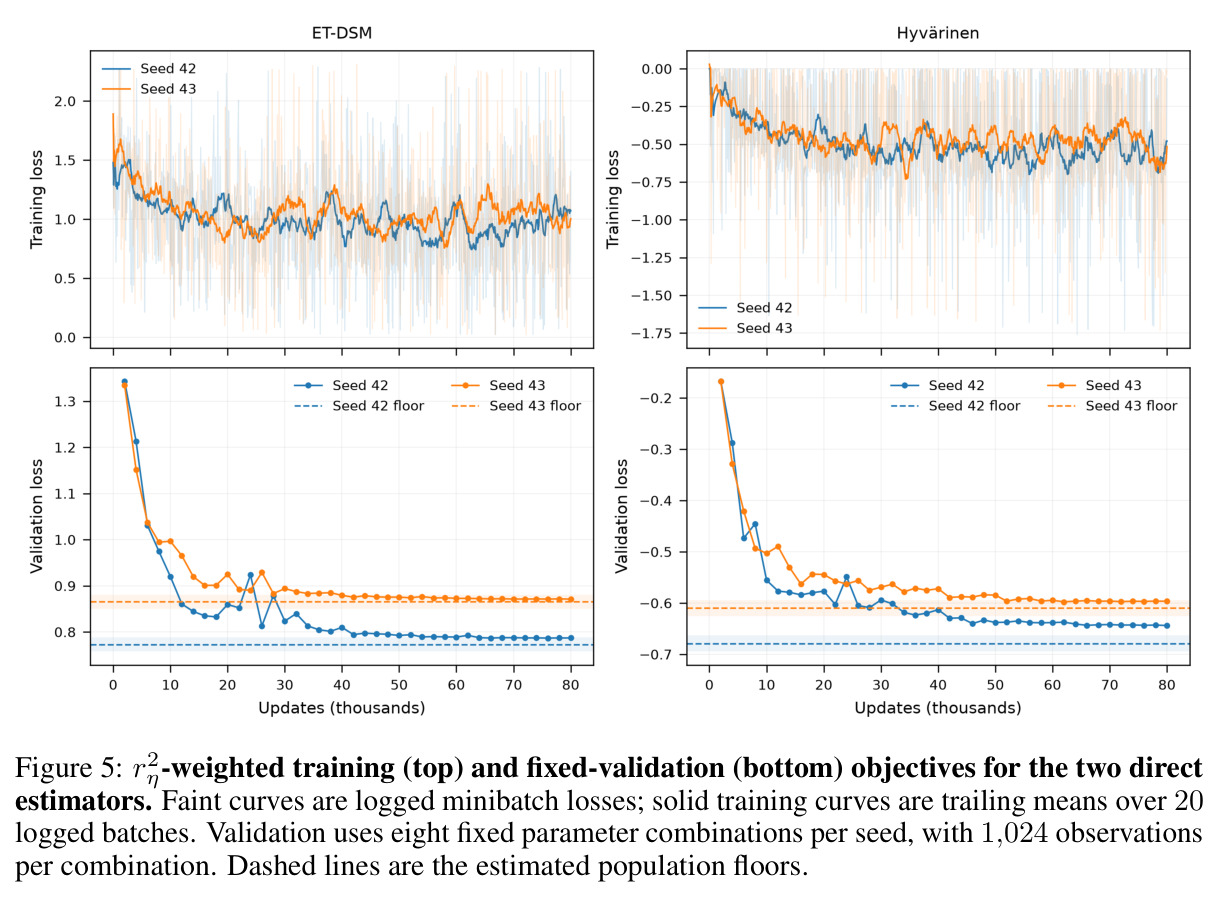
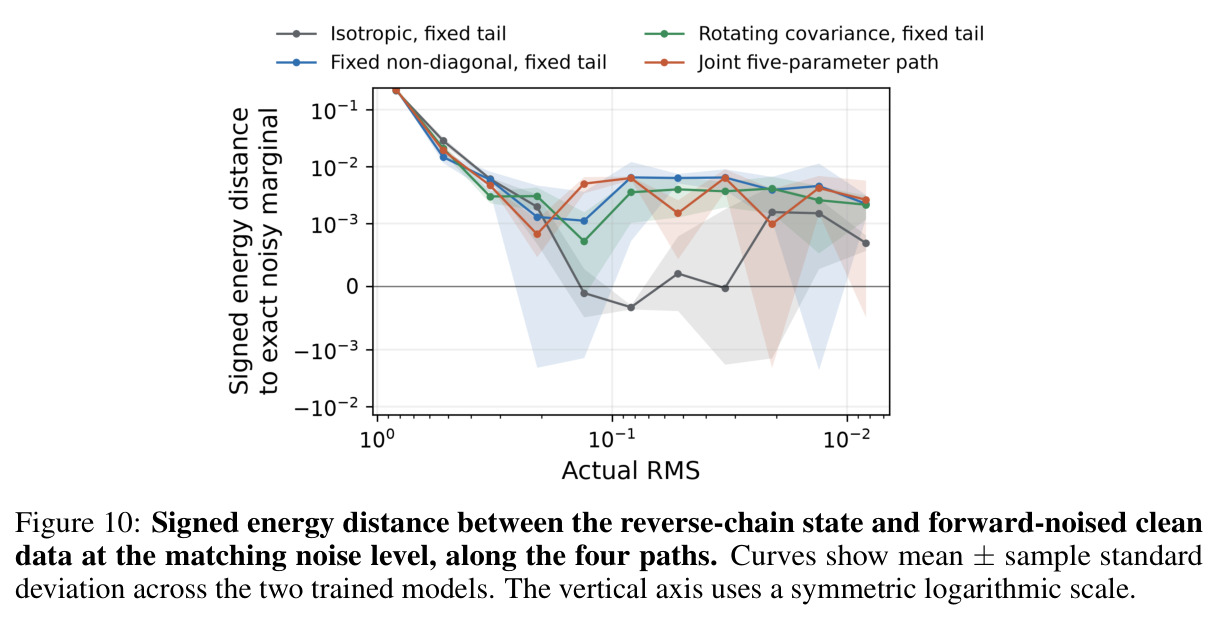
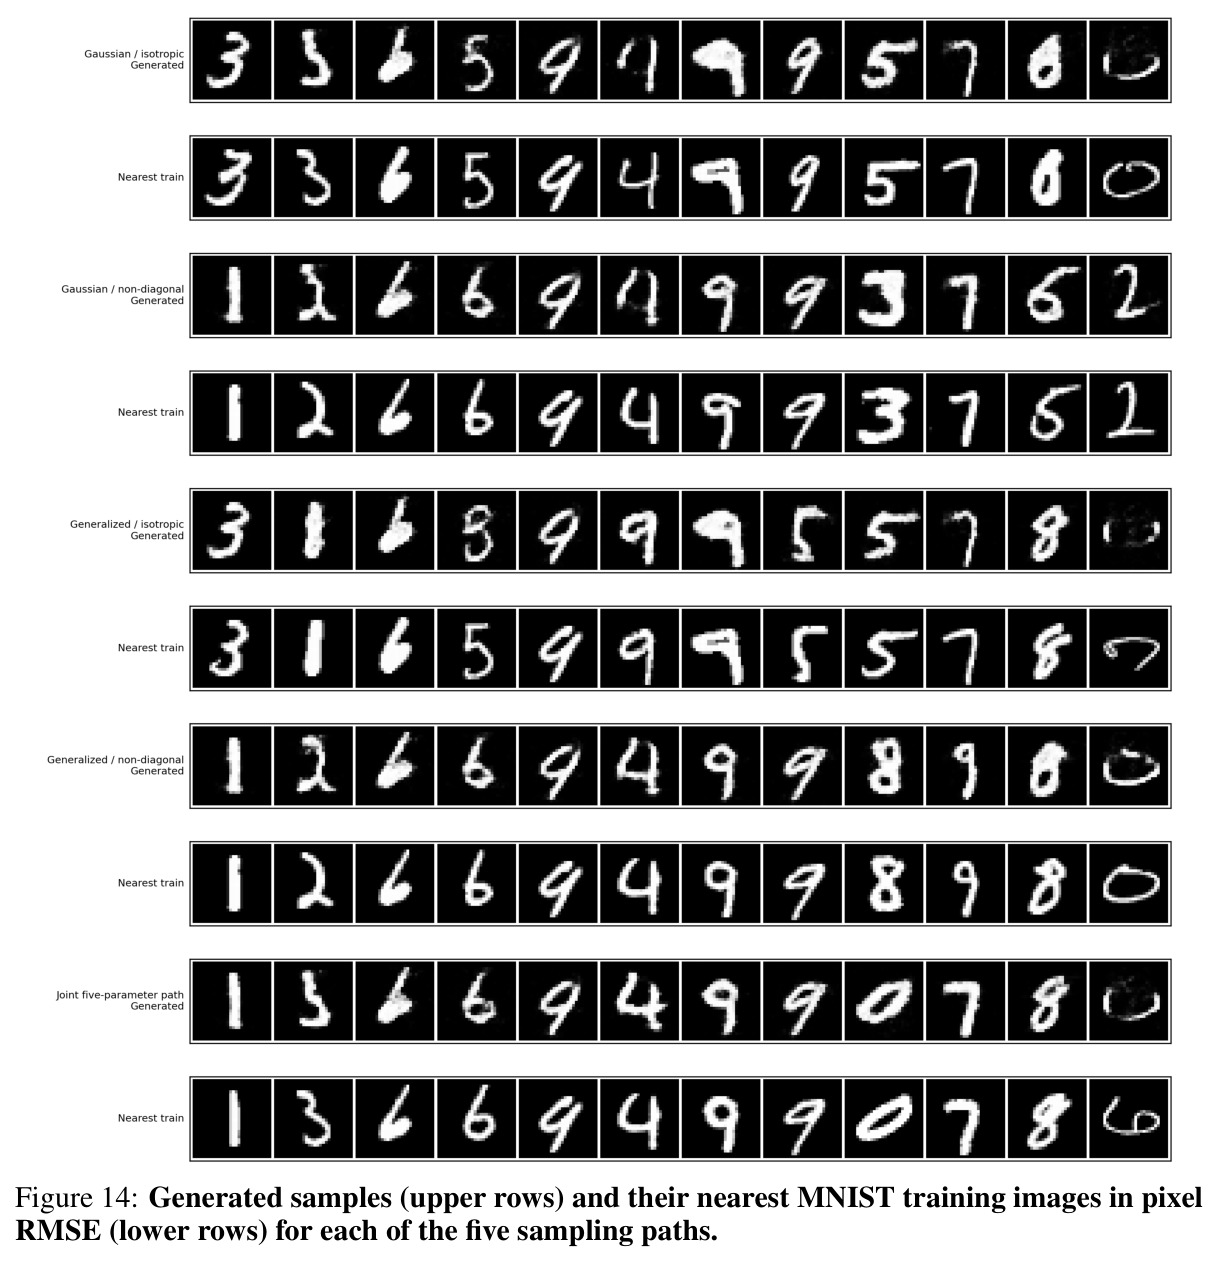
实验围绕广义高斯噪声、五参数 $\eta=(\beta,\lambda,\sigma,u,v)$ 展开。得分估计(Table 1,Eight-Gaussians,22个参数组合、16万粒子重要性采样真值,真值离散度NMSE仅0.0003–0.0092):ET后验路径NMSE 0.029–0.077、余弦0.951–0.982;ET-DSM 0.014–0.019/约0.990;Hyvärinen 0.022–0.027/约0.987;两个直接估计器验证损失距理论下限仅1%–5%,比较是保守的。Table 9分离偏置与方差:拟合 $a+b/N$ 得下限 $a=0.023$、斜率 $b=1.41$,$N=256$ 时NMSE 0.034、余弦0.980。参数估计(Table 2,真值 $(\beta^*,\lambda^*,u^*,v^*)=(1.4,1.8,0.25,0.35)$):全学习广义族恢复到 $(1.4398\pm0.0120,\,1.7875\pm0.0150,\,0.2512,\,0.3472)$,held-out NMSE 0.0146;三个误设族即便全用oracle组件也差2.3–14.2倍(强制高斯各向异性0.0342、强制各向同性广义0.1324、强制各向同性高斯0.2081),且误设呈现系统性补偿(压低 $\hat\lambda$ 或把 $\hat\beta$ 拖到约1.12);16行全表(Table 10)确认排序在全部四种来源组合下不变。扩散:Eight-Gaussians四条路径端点接近(Table 11),联合路径相对旋转协方差对照的配对差仅signed ED $0.00002\pm0.00030$,8个众数质量均>1%,反向链跟踪ED在 $r_t\le0.33$ 后近零(Fig 10)。MNIST(Table 13,每路径768张无筛选):广义/非对角路径在特征能量距离0.218 [0.186,0.324]、分类置信0.966、类别TV 0.085上全部点估计最优,高斯/各向同性0.574最差;真实-真实零参考0.015、95分位0.017;记忆检查:生成图到最近训练图RMSE 0.139–0.143,与真实留出图0.147相当,未见逐像素复制。
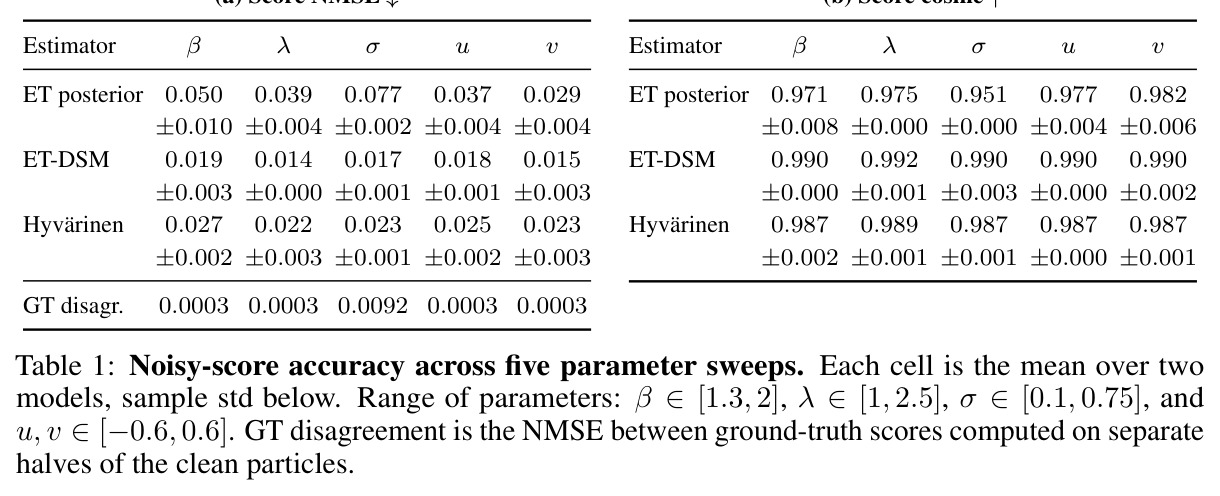
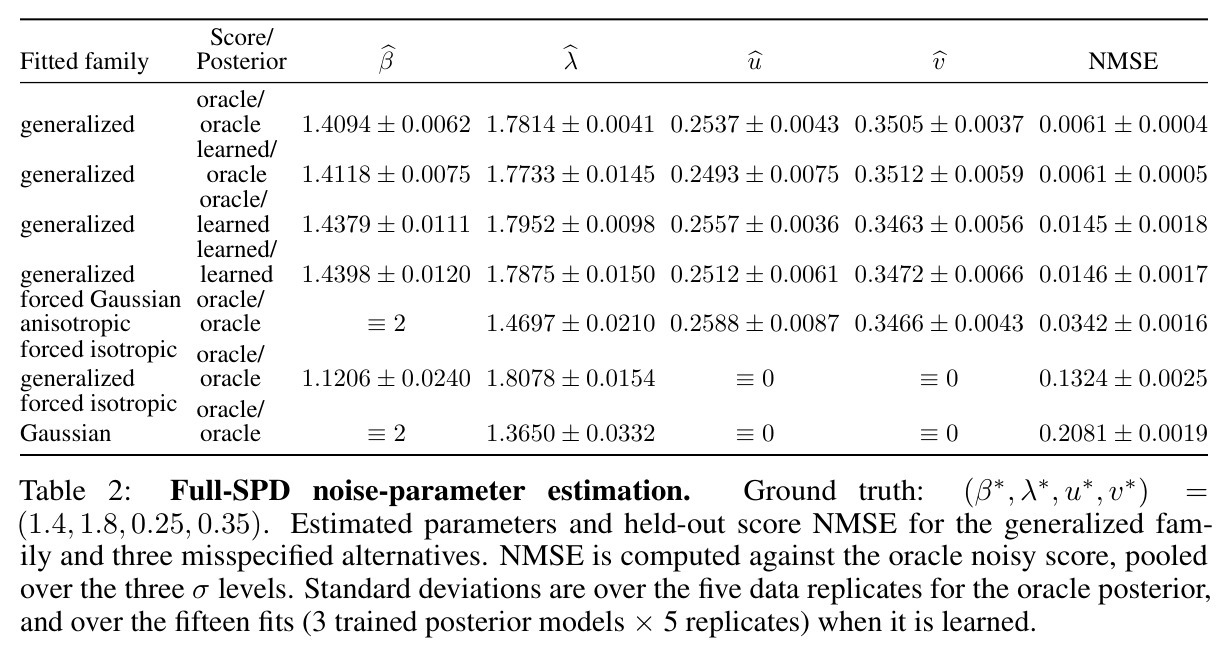
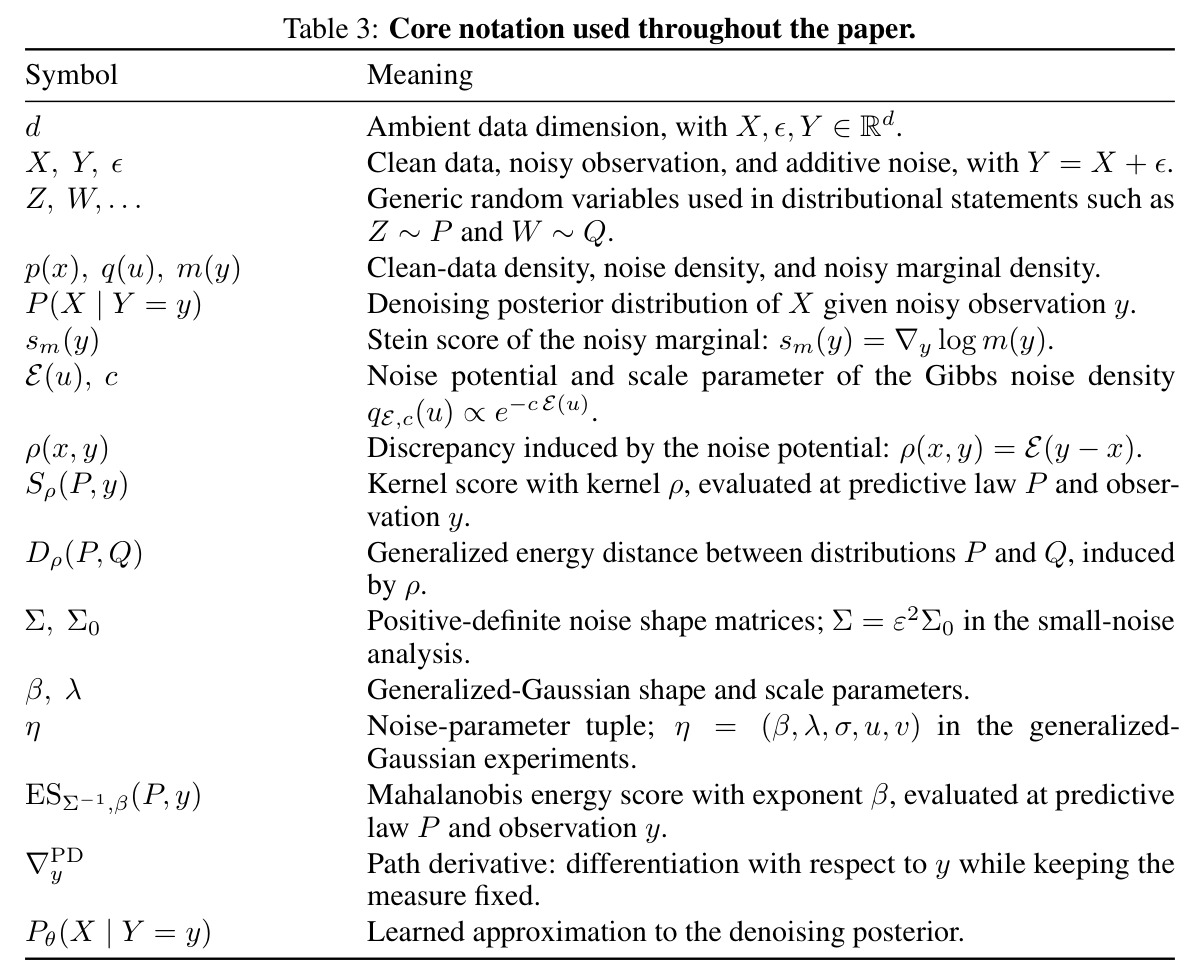
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 噪声得分估计(Eight-Gaussians,五参数扫描,192后验采样/观测) | 得分NMSE(越低越好,五次扫描均值范围) | ET后验路径 0.029–0.077 | Hyvärinen得分匹配 0.022–0.027;ET-DSM 0.014–0.019 | 直接法误差更低,但后验路线方向精度高(余弦0.951–0.982),且同一后验模型可复用于三个应用 |
| 噪声得分方向精度(同上设置) | 余弦相似度(越高越好) | ET后验路径 0.951–0.982 | ET-DSM 0.990–0.992;Hyvärinen 0.987 | 略低于直接法约1%–3%,作者归因于后验可能欠训练(保守比较) |
| 噪声参数估计(全SPD五参数联合,真值 $\beta^*=1.4,\lambda^*=1.8,u^*=0.25,v^*=0.35$) | held-out得分NMSE(对oracle噪声得分,三个噪声水平合并) | 全学习广义族 0.0146±0.0017,参数恢复至 (1.4398, 1.7875, 0.2512, 0.3472) | 强制各向同性高斯(oracle组件)0.2081;强制各向同性广义0.1324;强制高斯各向异性0.0342 | 误设族即便全用oracle组件,误差仍是全学习广义族的2.3–14.2倍 |
| MNIST生成(Energy-Tweedie扩散,5条噪声参数路径,每路径768张无筛选) | 特征能量距离(MNIST-12分类器倒数第二层256维特征,越低越好) | 广义/非对角路径 0.218 [0.186, 0.324] | 高斯/各向同性路径 0.574 [0.506, 0.711];真实-真实零参考 0.015(95分位0.017) | 在特征ED、分类置信(0.966)、类别TV(0.085)三个指标上点估计全部最优 |
| 后验采样预算敏感性(Eight-Gaussians,默认参数组合) | 得分NMSE 对后验样本数 $N$ | 拟合 $a+b/N$:下限 $a=0.023$,斜率 $b=1.41$;$N=256$ 时NMSE 0.034、余弦0.980 | $N=1$ 时NMSE 1.446、余弦0.574 | 方差项按 $1/N$ 衰减,剩余为不可约的后验近似偏置(两模型下限0.017与0.029) |
局限与改进
作者承认的局限:恒等式虽然一般,例子集中于广义高斯族;参数估计理论假设后验项正确设定且辅助得分估计器足够精确,放宽二者是未来方向;扩散方面未在大规模图像生成基准上验证。我自己的观察:(1) 后验路线存在不可消除的偏置下限($a=0.023$),来自学习后验的近似误差,且Eight-Gaussians后验模型训练用了224亿clean–noisy对,远超直接估计器的3.2768亿对,算力不对称使比较偏保守;(2) MC估计方差在 $\beta\le1-d/2$ 时可能发散(一维情形协方差可为无穷),低 $\beta$ 与低维组合需要小心;(3) MNIST评估用特征能量距离/置信度/类别TV而非社区标准FID,无法与现有方法直接横向对比;(4) 重要性采样真值在最小噪声尺度 $\sigma=0.1$ 处有效样本量中位数降至约1.1万、最小约4300,真值NMSE升至0.0092,最小尺度处的结论受真值精度限制;(5) $\beta>2$ 时评分不再proper,恒等式虽成立但训练侧失去诚实性保证;(6) 噪声须为可归一化、加性、与数据独立的吉布斯族,不覆盖乘性/变异噪声,也不覆盖噪声与信号相关的情况。
独立分析的弱点
弱点一:后验模型是计算瓶颈——三个应用共享一个后验网络固然优雅,但Five-parameter Eight-Gaussians后验训练耗224亿clean–noisy对,而只要得分的话直接法3.2768亿对就够;改进方向是摊销/蒸馏减小后验训练开销。弱点二:偏置下限 $a=0.023$ 表明 $N\to\infty$ 也无法消除模型误差;可用少量oracle后验样本估计残差并回归校正。弱点三:参数估计的可辨识性依赖卷积可辨识条件(本质要求数据特征函数无零点),对格点分布或支撑受限的数据失效,且一致性是渐近陈述;应给出有限样本误差界。弱点四:实验全部是二维合成数据与MNIST,尾形与各向异性的优势在真实噪声(sRGB传感器噪声、医学影像)上是否兑现未知;应补充CIFAR/ImageNet与真实盲去噪基准。弱点五:MNIST路径比较置信区间互相重叠(0.218 vs 0.247),768样本/路径不足以断言路径优劣。弱点六:$\beta\to2$ 时严格proper性退化、$\beta<1$ 时需数据密度局部有界,边界情形的数值稳定性值得单独分析。
未来方向
作者明确提出的方向:(1) 反问题——许多成像反问题方法消费噪声分布的得分,Energy-Tweedie无需高斯假设即可供给;(2) 测试时噪声分布漂移下的去噪——用Eq. 27的失配准则在线估计候选噪声参数。基于本文成果可以延伸的:(3) few-step生成——Martorella等已在ImageNet尺度显示沿调度调能量得分参数(尤其仅调 $\beta_t$)改善few-step采样,与本框架的参数路径结合是自然下一步;(4) $\alpha$-stable/Lévy等非吉布斯噪声是否存在类似恒等式,或对重尾族给出统一的'势→评分规则'字典;(5) $\beta\approx1$ 时得分直指数据流形中心的观察可与最优传输几何、Energy Matching、信息-估计度量结合,构造数据依赖的几何;(6) 将参数估计器用于盲去噪/自监督去噪(Noise2Noise类设定),或作为扩散模型前向过程的自动校准工具;(7) 理论上放宽后验正确设定假设,研究误设后验下恒等式估计量的稳健性与偏差传播;(8) Student-t版本(Cor 4.4)在金融、天体物理等天然重尾数据上的生成建模实验。
复现评估
复现条件很好。代码、配置、训练模型与复现说明已在 https://github.com/andleb/et 开源(NeurIPS清单第5条声明数据合成脚本与全部训练细节入库)。数据全部公开或合成(Eight-Gaussians与MNIST),无专有数据依赖。架构与训练预算完整披露(Table 14):如MNIST后验为16层、隐藏宽2560、每层 $Z=128$ 高斯噪声维的随机残差MLP,FiLM条件宽256,批1.536k,10万步,Adam+cosine衰减加500步warmup;得分估计MLP用AdamW 8万步、批4096、学习率 $10^{-3}\to10^{-5}$。真值构造(16万粒子重要性采样、半库NMSE、有效样本量报告)与统计协议(双训练种子、bootstrap置信区间、真实-真实零参考95分位)规范透明。正文未给出具体GPU型号/时长,但声明代码库文档化算力。难度评估:理论部分证明完整(附录含全部证明、记号表Table 3),可读性强;MNIST级实验单卡可行,但Eight-Gaussians五参数后验的224亿对训练在单卡上可能需要天级时间。总体属于可复现性优秀的'定理+受控实验'论文。
论文图表
MNIST定量评估:以公开MNIST-12分类器倒数第二层256维特征计算生成样本与2048张留出真实图像间的signed无偏能量距离,附分类置信与类别TV。广义/非对角0.218 [0.186,0.324]全部最优,高斯/非对角0.247次之,两条各向同性路径0.574/0.637最差,联合路径0.303居中;真实-真实参考0.015。
第三应用在真实数据上的主结果表:直接证明噪声参数路径是 consequential 的建模选择——同模型同预算下仅改变路径即可把特征ED相差2.6倍,同时给出零参考刻度(95分位0.017)帮助解读。
五个后验模型的架构与训练预算:层数 $L$、隐藏宽 $H$、每层噪声维 $Z$、FiLM条件宽、批大小与优化步数。例如MNIST为 $(16,2560,128)$、FiLM 256、批1.536k、10万步;训练目标为指数1的欧氏能量得分。
复现的关键工程信息:所有实验(得分估计、参数估计、两条扩散线)共享的后验模型规格都在此表,配合开源代码足以重建全部实验。