面向对话式推荐系统的零数据自举实证研究 An Empirical Study on Zero-Data Bootstrapping for Conversational Recommender Systems
无需对话语料,仅凭评论、元数据与协同信号主动选择并用LLM合成对话即可训练有效CRS
前置知识
对话式推荐系统(CRS)
通过多轮自然语言对话理解用户偏好并给出推荐的系统。经典做法是在 ReDial、INSPIRED 这类'用户请求+系统推荐'的对话语料上训练语言模型,让模型学会从对话上下文中推断目标条目并生成推荐列表。
本文研究的正是:当领域内完全没有这类对话语料时,如何从零造出可用的 CRS 训练数据。
合成数据自举(bootstrapping)
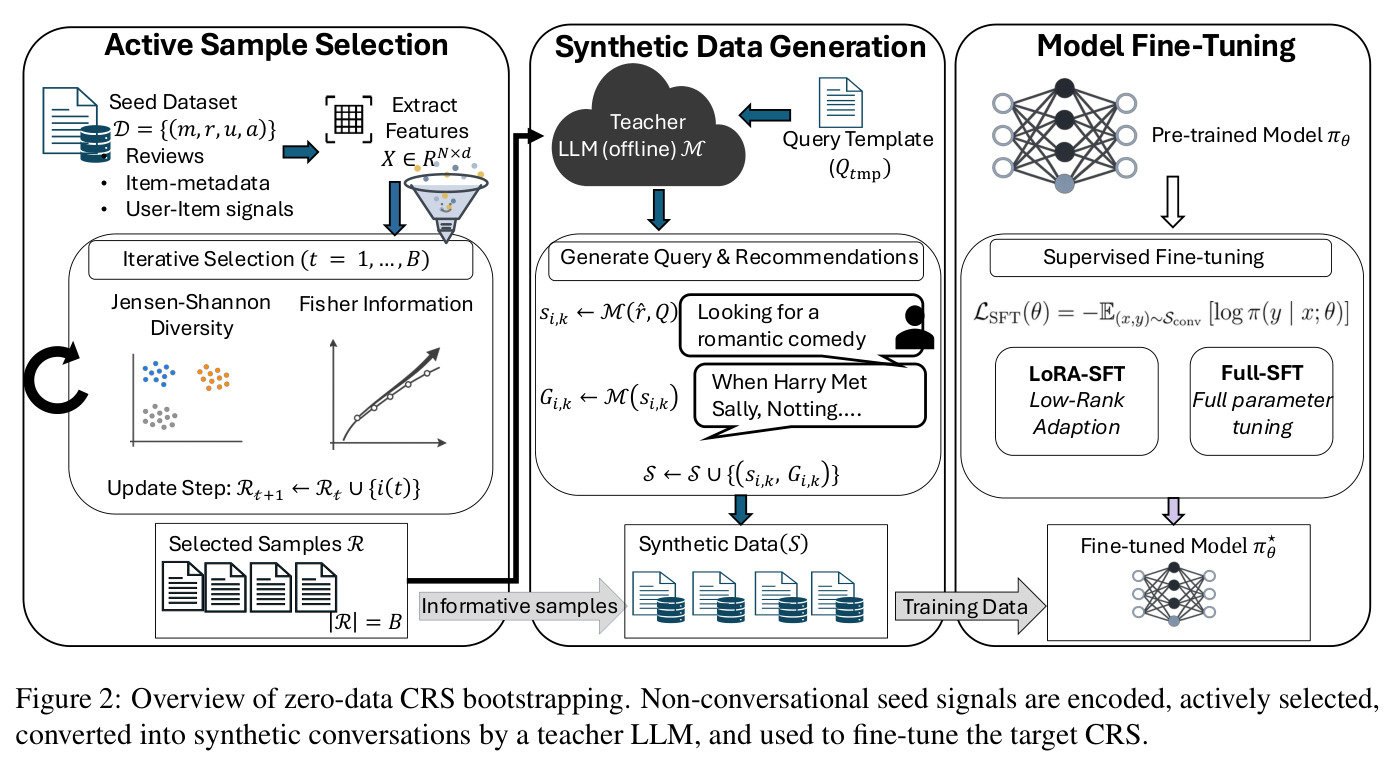
用一个强模型(教师,本文为 GPT-4o)从已有信号生成训练数据,再去微调一个更小的学生模型(本文为 1.5B–4B 的开源 LLM)。生成是一次性离线成本,推理阶段不再依赖教师,兼顾成本、隐私与可解释性。
整条流水线的本质就是合成数据自举,理解教师-学生分工才能看懂为何'接地'到领域信号如此关键。
Jensen-Shannon(JS)散度与软聚类
JS 散度是衡量两个概率分布差异的对称度量。本文先对样本嵌入做 K-means 软聚类,得到每个样本的簇隶属分布 $p_i$,再贪心选择使 $H(p_i)+\lambda\,\mathrm{JS}(p_i\|\bar{p}_t)$ 最大的样本:熵项偏爱簇边界样本,JS 项奖励相对已选集合的新颖性,对应子模覆盖目标。
JS 多样性是本文两个主动选择准则之一,决定哪些种子条目值得消耗昂贵的教师调用。
Fisher 信息与 D-最优设计
Fisher 信息刻画模型参数对数据的敏感度。在最后一层线性化近似下,信息矩阵为 $\Sigma_t=I_d+\sum_{j\in R_t}x_jx_j^\top$,贪心选择 $\arg\max_i \log(1+x_i^\top\Lambda_t x_i)$ 等价于 D-最优设计(最大化 log-det 增量、缩小参数置信椭球体积),可用 Sherman–Morrison 公式秩一更新避免反复求逆。
Fisher 准则是另一条选择路线,实验显示它有明显的长尾条目偏好,与 JS 形成互补。
LoRA 与全参数 SFT
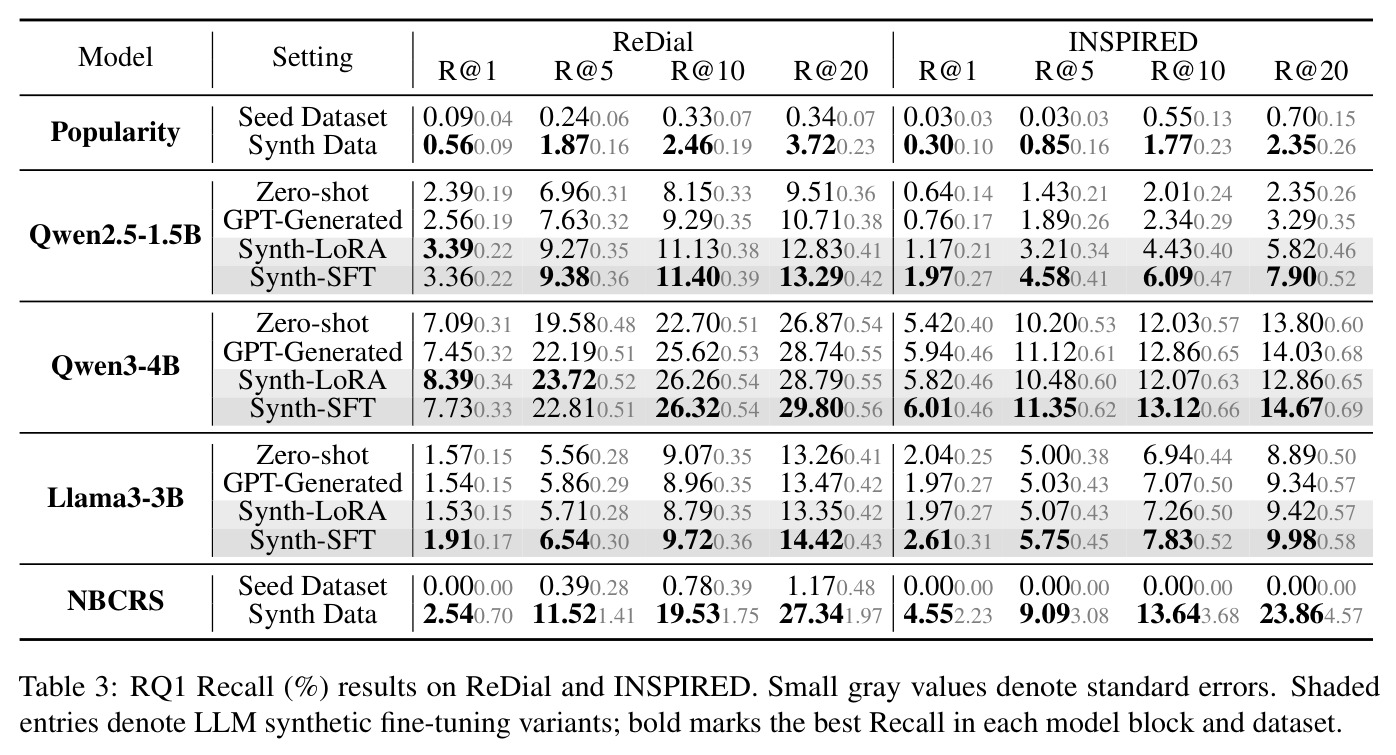
LoRA 只训练注入注意力层的低秩矩阵,参数高效但表达受限;全参数监督微调(Full-SFT)更新所有权重。本文发现合成数据场景下 Full-SFT 普遍更优,小模型差距最大(INSPIRED 上 Recall@1 提升 +207.8% 对 +82.8%)。
微调范式是论文的受控变量之一,直接影响'小模型能否吃下合成数据'这一结论。
Recall@k 与 NDCG@k
Recall@k 衡量真实目标条目出现在推荐列表前 k 位中的比例;NDCG@k 进一步按排名位置折算折扣增益,奖励把正确条目排得更靠前。二者在单一正确答案的评测里 Recall@1 与 NDCG@1 相同。
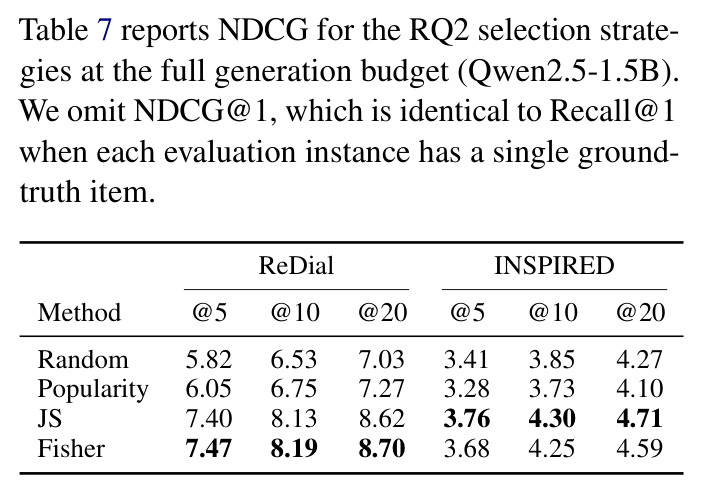
论文所有结论都用 Recall@k(k=1,5,10,20)报告,附录再用 NDCG 验证选择策略改善的是排名而非仅仅命中。
研究动机
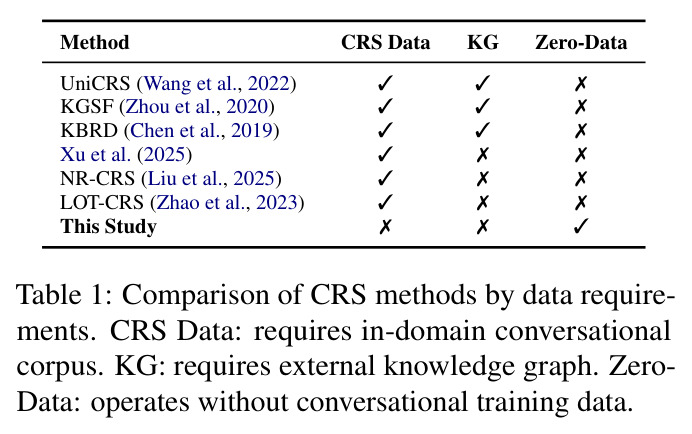
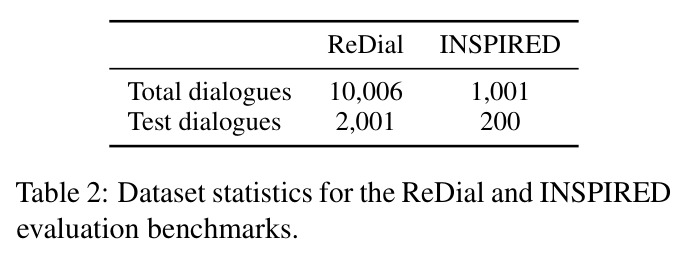
对话式推荐系统(CRS)的传统训练范式依赖大规模领域内对话语料:本文使用的 ReDial 有 10,006 条对话(测试集 2,001 条),INSPIRED 只有 1,001 条(测试集 200 条),而这类数据的获取正变得越来越困难——人工标注成本高昂,Reddit 等 API 收紧使真实推荐对话几乎无法收集,隐私合规也限制了对聊天记录的再利用。想把 CRS 部署到电影之外的新领域(图书、电商、音乐)时,往往根本没有对话数据可训练。另一条路是直接调用大模型做零样本推荐,但已有研究表明其存在可扩展性瓶颈、推理成本高、可解释性差和隐私风险,实践中很多团队更愿意部署可内部管理的小模型;而小模型的领域微调又绕不开对话数据,形成'没数据→不能微调→只能用贵的大模型'的死锁。已有的 LLM 数据增强方法(LOT-CRS、NR-CRS、Xu et al. 2025 等)都假设已存在领域对话语料,KGSF、KBRD、UniCRS 等则依赖外部知识图谱,均无法应用于对话数据完全缺失的场景。
本文的目标是本文要回答一个根本问题:LLM 能否仅凭非对话式的领域信号自举出有效的 CRS?作者将其形式化为'零数据 CRS'设置(Definition 1)——既没有领域内对话语料 $S_{\mathrm{conv}}$,也没有外部知识图谱,唯一可用的资源是条目评论 $\{r_i\}$、条目元数据 $\{m_i\}$ 与用户-条目协同交互 $\{u_i\}$,这些信号在几乎所有领域都现成可得。围绕该设置,论文构建了一条'选择—生成—微调'三阶段流水线,并设计四个研究问题做系统消融:RQ1,领域接地的合成数据能否支撑零数据 CRS;RQ2,信息论主动选择能否在固定教师预算下提升数据效率;RQ3,元数据与协同过滤信号能否改进样本选择质量;RQ4,合成数据与稀缺真实对话之间是替代还是互补。
与已有工作不同的是,本文的切入角度有两个独特之处。其一是视角转移:以往工作把'LLM 生成数据'当作在已有对话语料上的增强手段,本文首次把它当作从零构建对话监督的独立路径,并把'选择哪些种子条目去消耗昂贵的教师 LLM 调用'提升为生成算法的核心组成部分,而非可有可无的预处理细节。其二是方法迁移:主动学习领域的 Jensen-Shannon 多样性与 Fisher 信息准则此前从未被用于'从非对话信号中选择 CRS 合成种子'这一问题;论文不发明新准则,而是把两类互补的效用度量(分布覆盖 vs 参数级信息增益)放进同一受控实验框架,并进一步考察把元数据、协同信号混入嵌入后对选择质量的影响。Table 1 清晰显示了这一空白:本文是对比中唯一同时满足'不需要对话数据、不需要知识图谱'的方法。
核心方法
直觉上,用户的评论文本里已经埋藏着偏好表达的语言,元数据提供了品类与题材的结构信息,交互历史则浓缩了协同模式;LLM 真正要做的不是凭空编造对话,而是把这些'原料'忠实改写成训练可用的查询-推荐对。技术路线分三步:给定种子集 $\mathcal{D}=\{(m_i, r_i, u_i, a_i)\}_{i=1}^N$(来自 Amazon Reviews '23 电影电视类目)、目标模型 $\pi_\theta$、教师 LLM $\mathcal{M}$(GPT-4o)与预算 $B$,第一步用 $\pi_\theta$ 最后一层隐状态对每个种子样本做嵌入 $x_i\in\mathbb{R}^d$,按 Jensen-Shannon 多样性或 Fisher 信息准则贪心选出 $B$ 个信息量最大的条目;第二步对每个选中条目采样 5 个 Reddit 风格模板和 3 条评论,让 GPT-4o 生成一条用户查询 $s_{i,k}$,再对每条查询生成 20 个伪推荐目标 $G_{i,k}$,共得 $BK$ 个训练对,只需 $2BK$ 次离线教师调用;第三步用 LoRA 或全参数 SFT 在合成语料 $\mathcal{S}$ 上微调 $\pi_\theta$ 得到 $\pi_\theta^*$,推理阶段不再需要任何教师调用。整条流水线由 Algorithm 1 编排,生成细节在 Algorithm 2。
核心创新是'先选择、后生成'的无标签信息论选择机制。由于选择发生在任何训练目标存在之前,不确定性采样等依赖标签的准则不适用,作者改用两条互补的无标签原则:JS 多样性把嵌入空间做 K-means 软聚类,选择最大化 $i^{(t)}=\arg\max_i\, H(p_i)+\lambda\,\mathrm{JS}(p_i\|\bar{p}_t)$ 的样本(式 1,$\lambda=0.5$),熵项偏爱簇边界样本、JS 项奖励相对已选集合的新颖性,对应子模覆盖目标;Fisher 信息在最后一层线性化近似下维护 $\Lambda_t=(I_d+\sum_{j\in R_t}x_jx_j^\top)^{-1}$,贪心选择 $\arg\max_i \log(1+x_i^\top\Lambda_t x_i)$(式 2),等价于贪心 D-最优设计,优先补充参数层面的新方向。与已有方法的本质区别有二:其一,'接地'——合成查询必须从真实评论与元数据出发,而非让 GPT 自由发挥,实验显示朴素 GPT 生成在 INSPIRED 上 Recall@1 只有 0.76%,接地版达 1.97%;其二,领域信号不仅作为生成上下文,还作为选择信号参与打分。
方法步骤详情
流水线分五步执行。第一步编码:把条目元数据 $m_i$、评论 $r_i$、由交互历史导出的用户特征 $u_i$ 与条目标识 $a_i$ 拼接,经 $\pi_\theta$ 最后一层前向得到嵌入 $x_i$,整个过程只需一次嵌入前向、零教师调用。第二步选择(JS 版,Appendix A):K-means 聚出 $K$ 个簇心 $c_j$,按 $p_{ij}=\exp(-d(x_i,c_j))/\sum_k \exp(-d(x_i,c_k))$ 构造软隶属分布,首个样本取全局最大熵者,其后按式 (1) 迭代选样并更新 $R_{t+1}=R_t\cup\{i^{(t)}\}$ 直至 $|R|=B$。第二步选择(Fisher 版):初始化 $\Lambda_0=I_d$,每步取增量信息增益最大者,选中后用 Sherman–Morrison 秩一公式更新 $\Lambda_{t+1}$,无需重新矩阵求逆。第三步生成:对每个选中条目采样 5 个来自 Reddit 电影推荐讨论的风格模板 $Q\subset Q_{\mathrm{tmp}}$、每次采样 3 条评论 $\hat{r}\subset r_i$,提示 GPT-4o 生成一条用户查询 $s_{i,k}$;随后用固定推荐 prompt 要求教师给出恰好 20 个推荐标题 $G_{i,k}$,生成温度 0.8。第四步组织数据:每对 $(s_{i,k},G_{i,k})$ 存入合成集,$B$ 个条目 × 每条目 $K$ 条查询共 $BK$ 个训练对、$2BK$ 次教师调用。第五步微调:LoRA 与全参数 SFT 两种范式,学习率 $5\times10^{-6}$(RQ4 为 $1\times10^{-5}$)、batch 32、梯度累积 8,单张 48GB A6000 一次训练不超过 4 小时。
技术新颖性
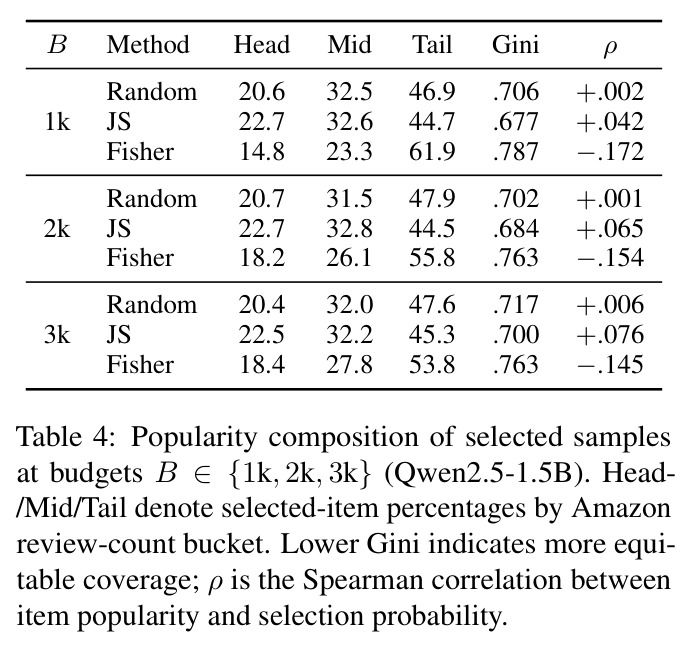
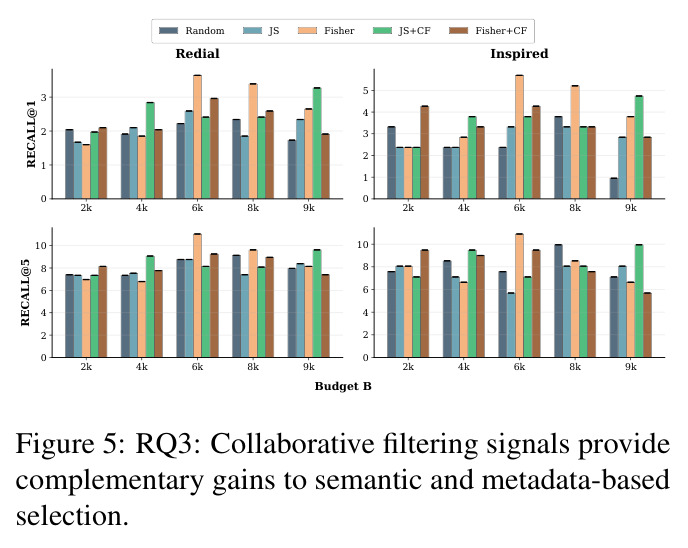
这篇论文技术上的新颖性不在提出新算法,而在三个'第一次'的组合。首先是设置的第一次:Table 1 显示它是对比方法中唯一同时不要求领域对话语料、不要求知识图谱的 CRS 方案,把 UniCRS/KGSF/KBRD(需对话+KG)与 LOT-CRS/NR-CRS/Xu et al.(需已有对话做增强)都排除在外,划出了全新的问题象限。其次是问题形式的第一次:把主动学习的样本选择从'标注预算分配'迁移到'合成数据生成预算分配',且种子完全无标签,只能依赖嵌入空间的几何结构(JS)与线性化参数信息(Fisher);附录 B 的诊断显示两者分工明确——Fisher 呈强长尾取向,选中样本中尾部条目占 53.8%–61.9%,选择概率与流行度的 Spearman 相关 $\rho=-.172$ 至 $-.145$,JS 则更贴近种子池分布($\rho=+.042$ 至 $+.076$)。第三是证据的第一次:系统证明选择信号本身(元数据、协同信号)独立于生成质量影响下游指标,且合成数据在低资源场景能反超真实对话——这些结论此前均无受控实验支持。作者也诚实地把贡献定位为'系统性实证研究'而非新准则。
实验结果
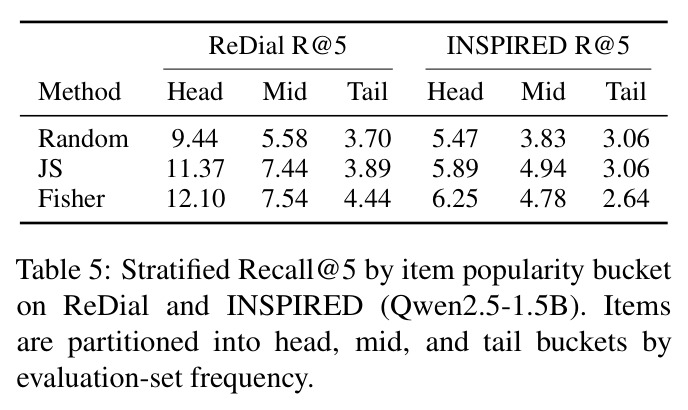
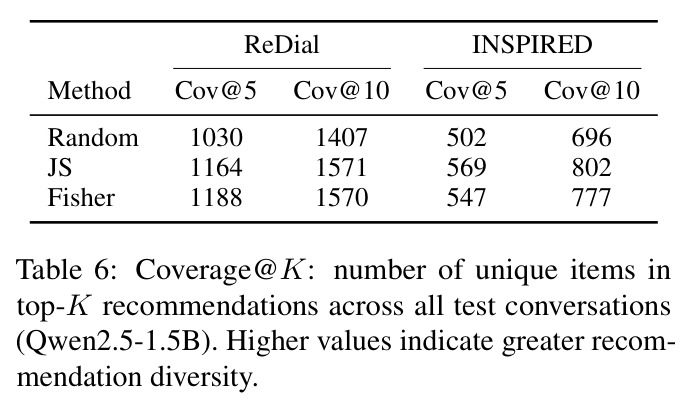
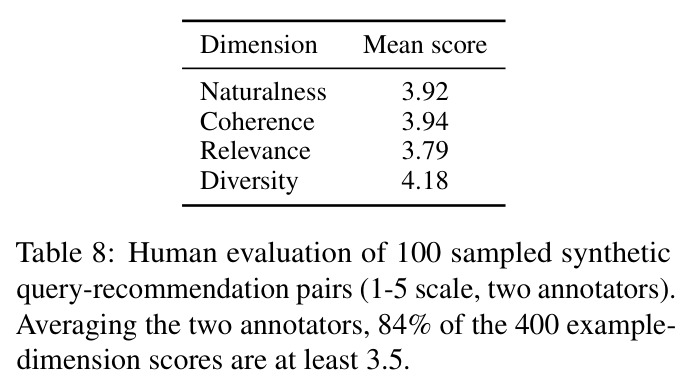
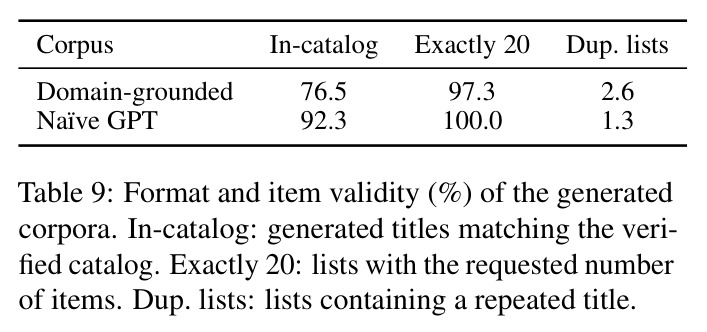
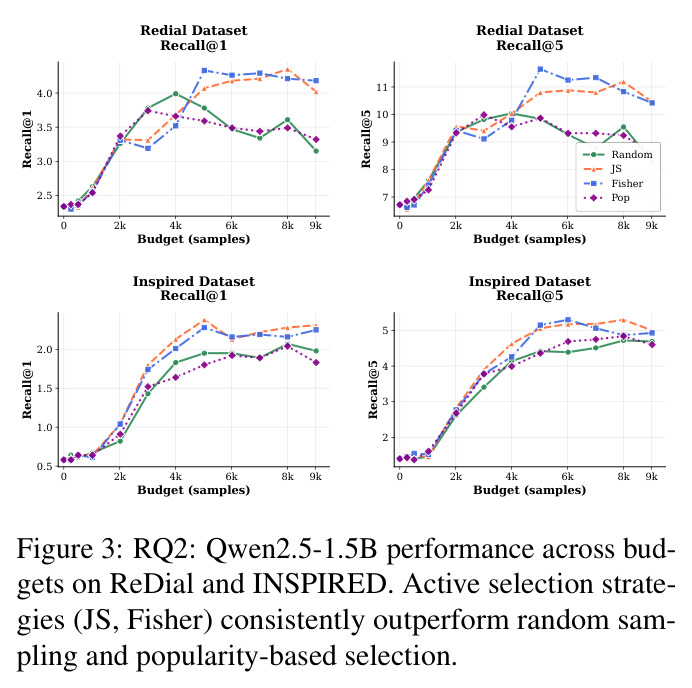
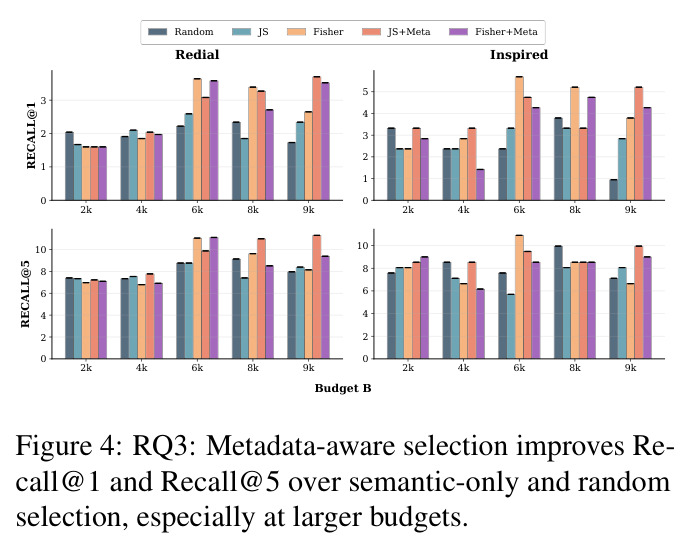
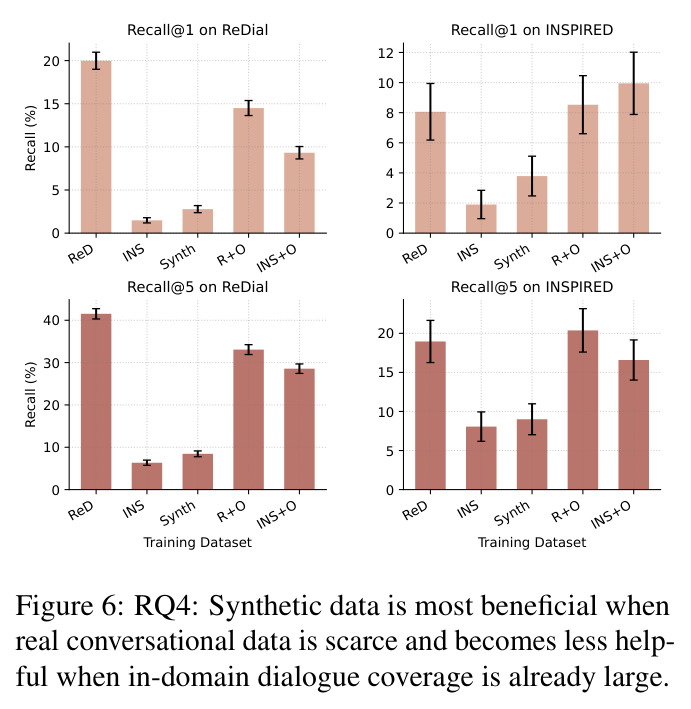
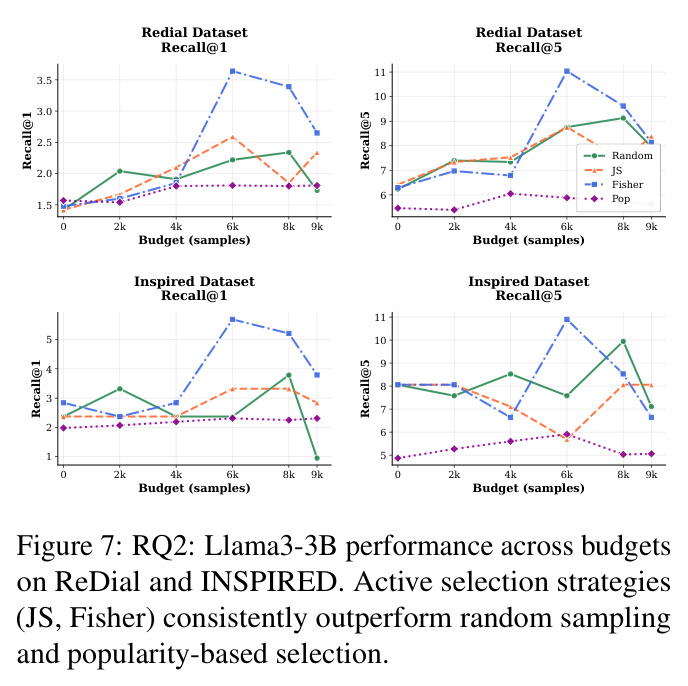
RQ1(Table 3):领域接地合成数据全面胜过零样本与朴素生成。Qwen2.5-1.5B 在 INSPIRED 上 Synth-SFT 的 Recall@1 达 1.97%,比 zero-shot 的 0.64% 提升 +207.8%,而朴素 GPT 生成数据仅 0.76%(+18.8%);ReDial 上为 3.36% 对 2.39%。小模型获益远大于大模型:Qwen2.5-1.5B 在 ReDial 上 Recall@1 提升 +41.8%(LoRA)/+40.6%(SFT),而 Qwen3-4B 仅 +18.3%/+9.0%;Full-SFT 总体优于 LoRA,小模型差距最大(INSPIRED 上 +207.8% 对 +82.8%),Llama3-3B 的 LoRA 有时甚至低于零样本而非全参数微调则稳定提升。非 LLM 的 NBCRS 用合成数据后 ReDial Recall@5 从 0.39 跃升至 11.52,INSPIRED 上从 0 升至 9.09,证明价值来自数据变换本身而非特定架构。合成语料人工评分四维(自然性 3.92、连贯性 3.94、相关性 3.79、多样性 4.18,满分 5)均接近 4,84% 的维度得分不低于 3.5;但朴素语料的目录命中率(92.3%)反而高于接地语料(76.5%)却下游更差,说明目录重叠不是监督有用性的指标。RQ2(Fig. 3、Fig. 7、Table 7):JS/Fisher 在全部预算上优于随机与流行度选择,流行度选择常输给随机;NDCG 保持同序(ReDial 上 Fisher NDCG@20 8.70 对 Random 7.03),说明主动选择改善的是排名位置。RQ3(Fig. 4、Fig. 5):元数据感知选择(JS+Meta/Fisher+Meta)一致提升且预算越大优势越明显;协同信号带来正交增益。RQ4(Fig. 6):在约 1k 对话的 INSPIRED 上仅用合成数据即反超真实 INSPIRED 训练集,混合训练(INS+O、R+O)进一步提升;ReDial 上真实数据仍有竞争力,合成数据略微拉低。附录 B:Fisher 把 ReDial 尾部 Recall@5 从 3.70 提到 4.44、头部从 9.44 提到 12.10;推荐唯一条目数 Coverage@5 从 Random 的 1030 提高到 Fisher 的 1188。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 零数据 CRS(INSPIRED,Qwen2.5-1.5B) | Recall@1 | 1.97%(Synth-SFT,领域接地合成数据) | 0.64%(zero-shot 提示);0.76%(朴素 GPT 生成数据) | 对 zero-shot +207.8%;对朴素 GPT 生成 +159% |
| 零数据 CRS(ReDial,Qwen2.5-1.5B) | Recall@1 | 3.39%(Synth-LoRA)/ 3.36%(Synth-SFT) | 2.39%(zero-shot) | +41.8%(LoRA)/ +40.6%(SFT) |
| 传统邻域 CRS(NBCRS,ReDial) | Recall@5 | 11.52%(合成对话数据训练) | 0.39%(原始非对话种子数据) | 约 29.5 倍 |
| 主动选择排序质量(ReDial,全生成预算,Qwen2.5-1.5B) | NDCG@20 | 8.70%(Fisher)/ 8.62%(JS) | 7.03%(Random)/ 7.27%(Popularity) | Fisher 对 Random +23.8% |
| 低资源真实对话对比(INSPIRED,约 1k 对话) | Recall@1 / Recall@5 | Synth(仅合成数据) | INS(真实 INSPIRED 训练集) | 合成数据单独反超真实对话(Figure 6),且 INS+合成 混合进一步提升 |
局限与改进
作者明确承认三点局限:实验仅覆盖电影域,迁移到音乐、电商等需要新的种子语料、生成模板与评测基准,跨域泛化留待未来;流水线依赖 LLM 合成数据,可能包含幻觉与风格伪影并传播给下游模型;生成质量依赖 prompt 设计,而论文未探索 prompt 优化。我自己的观察补充如下:其一,合成格式是'单条查询 + 20 个标题列表',并非真正多轮对话,缺少澄清、追问、负反馈等 CRS 的核心交互,训练出的模型是否具备多轮能力存疑;其二,Table 9 显示接地语料仅 76.5% 的生成标题在验证目录内,约四分之一无法核实,长尾条目的幻觉风险更高;其三,教师固定为 GPT-4o,其预训练知识可能把流行条目'泄漏'进合成数据,教师偏差未做消融;其四,INSPIRED 测试集仅 200 条对话,Table 3 中 NBCRS 等行的标准误高达 ±2–4 个百分点,小样本下的结论稳定性有限;其五,Recall@1 绝对值仍只有 1–8%,与实用推荐系统还有明显距离。
独立分析的弱点
第一,单轮格式的简化:合成对是'查询→20 推荐',模型学不到基于用户反馈修正推荐的多轮策略,改进方向是用用户模拟器做自我博弈,生成含澄清与反馈的多轮对话树。第二,目录外幻觉:76.5% 的目录命中率意味着训练目标里含大量不可验证标题,可能教坏模型的目标分布,改进方向是把生成改为检索增强——先从目录检索候选,再让教师从中选择与措辞,从源头保证目标合法。第三,预算饱和:Fig. 3 显示预算接近 9k 样本时各选择策略曲线趋平,说明固定准则的边际收益递减,可引入自适应停止准则或按不确定性分位数动态终止。第四,单域验证:电影域评论丰富、目录相对封闭,音乐/电商等目录庞大且评论稀疏的领域是否成立未知,需要跨域实验与模板自动化。第五,教师单一且闭源:GPT-4o 的知识与风格偏差未被控制,改进方向包括开源教师对比、多教师集成、以及与真实测试集做 n-gram/嵌入去污染检测。第六,相关性是人工评估中最低的维度(3.79),说明 20 个推荐里常混入松散相关条目,可用重排序或对比过滤提升目标纯度。
未来方向
作者提出的方向包括:把选择与自举机制推广到音乐、电商等其他领域(需重建种子语料、模板与基准);利用 prompt 优化提升生成质量。基于本文成果还可自然延伸:把 Fisher/JS 选择与真实用户在线反馈结合,形成'零数据冷启动 → 在线主动学习'的完整生命周期;探索检索约束下的多轮自我博弈生成,弥合单轮合成数据与真实 CRS 交互之间的差距;研究开源小教师与知识蒸馏的成本曲线,把 $2BK$ 次教师调用的费用降一个数量级;将 LLM-REDIAL 这类从用户行为日志大规模转化的语料与本文的域内自举结合,做'通用预训练 + 零数据域适配'的两阶段方案;以及为'元数据在大预算下更稳、Fisher 偏好长尾'等现象建立理论解释,例如把选择准则的收益与下游微调损失的变化联系起来。
复现评估
复现条件相当友好。代码已开源(anonymous.4open.science/r/zero_data_crs);种子数据来自公开的 Amazon Reviews '23 电影电视类目,评测基准 ReDial 与 INSPIRED 均为公开数据集;实现基于 PyTorch,单张 48GB NVIDIA A6000 即可,每次微调不超过 4 小时。论文给出关键超参(学习率 $5\times10^{-6}$、RQ4 为 $1\times10^{-5}$,batch 32,梯度累积 8,生成温度 0.8,$\lambda=0.5$)以及完整的 prompt 模板与生成示例(Box 1–4)。主要成本在生成阶段:每个配置需 $2BK$ 次 GPT-4o 调用,且实验网格涉及 3 个骨干模型 × 2 种微调范式 × 约 7 种选择条件 × 多个预算档位(最高 9k 样本),完整复现全部曲线的 API 费用与 GPU 时长不可忽视;人工评估部分(100 对、两名标注者)需额外人力。总体属于中等偏低难度:复现数量级与结论趋势容易,逐点对齐表格数值则可能受 API 版本漂移与随机种子影响。
论文图表
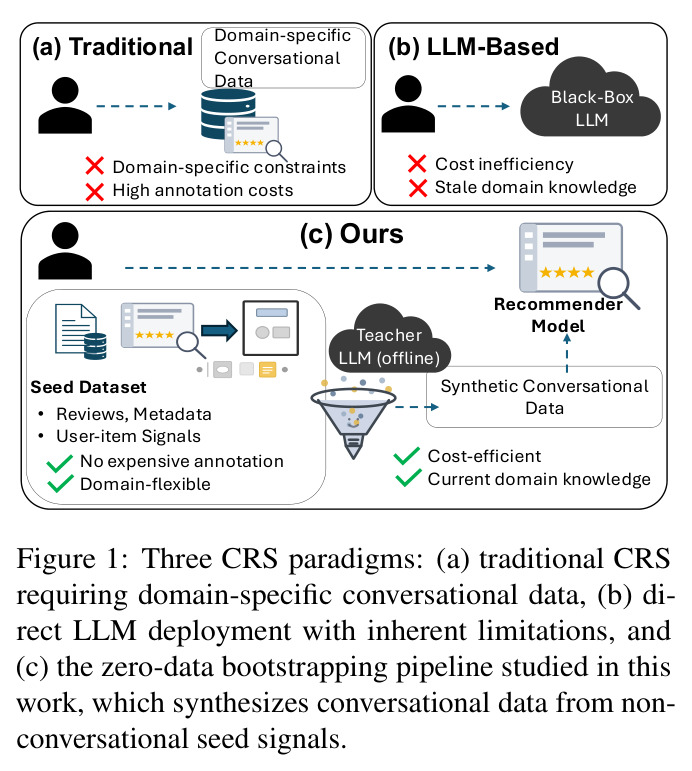
并排对比三种范式:(a) 传统 CRS 需要昂贵的领域内对话标注数据;(b) 直接部署 LLM 面临成本低效与领域知识过时等黑盒问题;(c) 本文的零数据自举路线,用评论、元数据和用户-条目信号作为增强信号,由离线教师 LLM 合成对话数据。
一张图讲清论文的问题定位与卖点:为什么前两条路走不通、第三条路如何同时规避数据稀缺与黑盒部署的缺陷。
流水线伪代码:输入种子集、语言模型、黑盒教师 LLM、查询模板与预算 B;先对每个样本用最后一层隐状态做嵌入,再执行选择(对应 2.3 节),随后生成合成数据(Algorithm 2),最后监督微调返回模型。
方法的精确形式化描述,配合 Figure 2 可完整还原实现细节。
生成伪代码:对每个选中条目采样 5 个风格模板,每条查询采样 3 条评论让教师生成查询,再让教师对每条查询生成 20 个推荐目标,最终输出带伪目标推荐的合成数据集。
明确生成阶段的输入输出与成本结构(BK 个训练对、2BK 次教师调用),是复现的关键。